GPT-6.1 Sol vs GPT-6 Sol : le comparatif avant de migrer
GPT-6.1 Sol ou GPT-6 Sol ? Comparez le coût du cache, les performances, le raisonnement et les appels d’outils pour décider si la migration vaut le coup.



GPT-6.1 Sol vs GPT-6 Sol : cette migration doit d’abord passer par les tests. Basculez les agents fondés sur l’API Responses qui réutilisent beaucoup le cache vers GPT-6.1 Sol, mais conservez GPT-6 Sol tant que les appels d’outils via Chat Completions ou le niveau de raisonnement none bloquent le changement. Les deux modèles coûtent $2 en entrée et $10 en sortie par million de tokens ; seule l’entrée mise en cache baisse, de $0.20 à $0.10.
GPT-6.1 Sol vs GPT-6 Sol : lequel choisir ?
Choisissez GPT-6.1 Sol pour une charge compatible avec l’API Responses qui réutilise de longs préfixes de prompt, ou si vous cherchez un meilleur candidat pour le code, l’utilisation d’un ordinateur, le traitement de documents et les tâches métier en plusieurs étapes. Restez sur GPT-6 Sol tant que votre application dépend des appels de fonctions dans Chat Completions ou de reasoning_effort: none. Il ne s’agit pas de simples différences de configuration : elles déterminent si vous pouvez seulement remplacer l’identifiant du modèle ou si vous devez revoir tout le chemin de requête.
La décision dépend directement de votre situation :
- Agent existant sur l’API Responses avec un effort medium ou supérieur : testez GPT-6.1 Sol dès maintenant. Son tarif de lecture du cache est plus bas et les premiers signaux sur ses capacités sont meilleurs.
- Appels d’outils via Chat Completions : ne commencez pas par remplacer l’identifiant du modèle. Migrez d’abord le parcours d’outils vers Responses, effectuez des tests de non-régression, puis comparez les modèles.
- Charge de travail avec un raisonnement
none: conservez GPT-6 Sol jusqu’à pouvoir accepter au minimumlow, sachant que GPT-6.1 Sol utilisemediumpar défaut. - Entrées et sorties majoritairement nouvelles : n’attendez aucune économie sur les tokens. Les tarifs de l’entrée fraîche, de l’écriture en cache et de la sortie sont identiques ; les capacités doivent donc justifier la migration.
La règle de décision est simple : ne migrez que si GPT-6.1 Sol améliore les résultats acceptés après validation de la compatibilité de l’appelant. Un cache moins cher est utile, mais un appel d’outil en échec, un niveau minimal de raisonnement différent ou une tentative supplémentaire peuvent vite absorber l’économie.
Prix de GPT-6.1 Sol vs GPT-6 Sol
GPT-6.1 Sol ne remporte la comparaison tarifaire que lorsque les requêtes lisent des données en cache. Les prix de l’entrée fraîche, de l’écriture en cache et de la sortie ne changent pas.
J’ai vérifié ces tarifs le 30 septembre 2026 sur les pages officielles d’OpenAI, à savoir celle de GPT-6.1 Sol et celle de GPT-6 Sol.
Ramené à 1,000 tokens, chaque modèle coûte $0.002 en entrée fraîche, $0.0025 pour une écriture en cache et $0.01 en sortie. Une lecture du cache revient à $0.0001 avec GPT-6.1 Sol et à $0.0002 avec GPT-6 Sol. À ces tarifs, aucun volume ne rend GPT-6 Sol moins cher : dès qu’un token est lu dans le cache, la facture penche en faveur de GPT-6.1 Sol ; sans aucune lecture, les modèles sont à égalité.
Prix du cache de GPT-6.1 Sol
Le tarif des entrées mises en cache baisse de 50%, mais le coût total d’une tâche diminue moins fortement, car une seule composante change. Une entrée mise en cache correspond à un préfixe de prompt inchangé que le modèle peut réutiliser. Le guide d’OpenAI sur le prompt caching précise que ce préfixe doit atteindre 1,024 tokens d’entrée visibles pour GPT-5.6 et les versions suivantes. Le maintien d’une session ne garantit pas que le cache sera utilisé.
La ligne consacrée à l’écriture en cache mérite également d’être lue avec attention. Il s’agit d’un tarif alternatif appliqué aux tokens d’entrée, et non de frais ajoutés à un autre coût d’entrée. Les deux modèles facturent $2.50 par million de tokens écrits. GPT-6.1 Sol modifie le prix des lectures ultérieures, pas celui de la création du préfixe réutilisable.
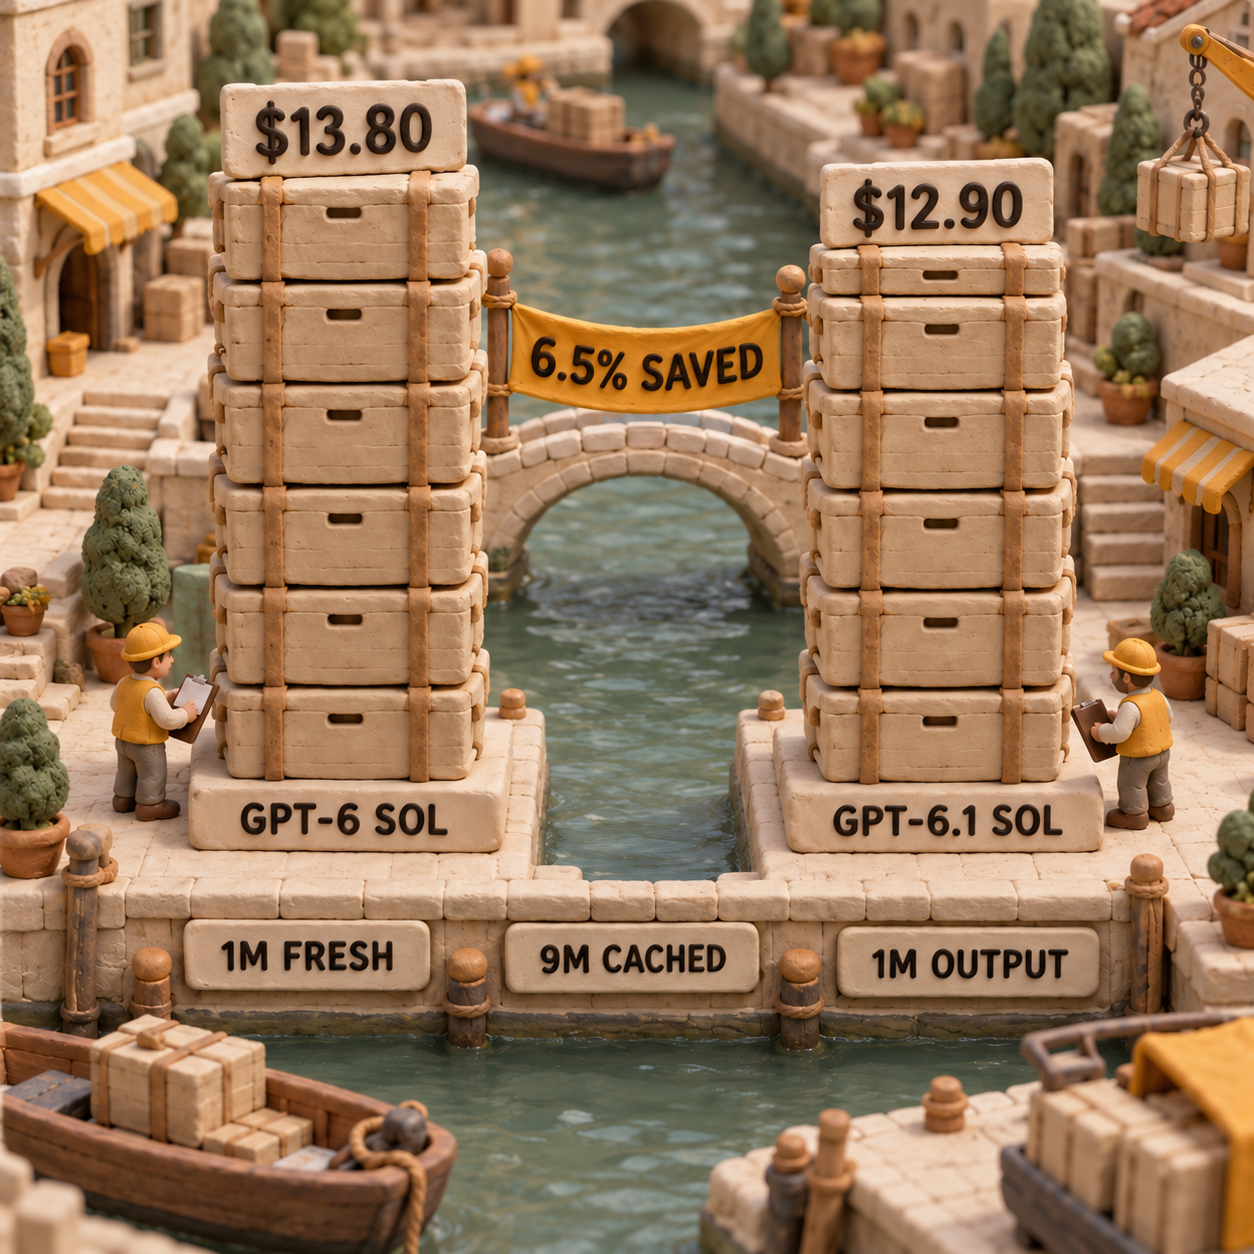
Prenons un lot à contexte court comprenant 1 million de tokens d’entrée fraîche, 9 millions de tokens d’entrée mis en cache et 1 million de tokens de sortie :
- GPT-6 Sol : (1 x $2.00) + (9 x $0.20) + (1 x $10.00) = $13.80
- GPT-6.1 Sol : (1 x $2.00) + (9 x $0.10) + (1 x $10.00) = $12.90
L’économie atteint $0.90, soit 6.5%, avant les écritures en cache et les frais d’outils. Il s’agit d’un calcul tarifaire, et non d’une charge réellement exécutée ou d’une facture observée.
L’exemple suppose aussi que chaque requête ne dépasse pas 272,000 tokens d’entrée. Au-delà de ce seuil, les deux pages de modèles indiquent que la requête entière est facturée à 2x pour l’entrée et le cache, et à 1.5x pour la sortie. Un lot peut totaliser des millions de tokens sans franchir le seuil s’il réunit de petites requêtes : celui-ci s’applique à chaque requête.
Pour un agent existant, commencez par mesurer les tokens cached_tokens et ceux écrits dans le cache au lieu de les déduire de la longueur du prompt. Le guide de diagnostic du prompt caching de GPT-6 aide à distinguer un faible taux d’utilisation du cache d’un problème de tarification du modèle.
Gagnant : GPT-6.1 Sol pour les charges qui exploitent beaucoup le cache. Égalité en l’absence de lectures du cache.
Benchmark de GPT-6.1 Sol
GPT-6.1 Sol arrive en tête sur les capacités mesurées au lancement, mais les résultats viennent d’OpenAI et non d’un comparatif indépendant. La nuance compte : prompt système, accès aux outils, niveau de raisonnement et politique de nouvelle tentative peuvent modifier à la fois le résultat et son coût.
Le rapport de lancement d’OpenAI fournit cinq indications utiles face à GPT-6 Sol :
- Code : GPT-6.1 Sol dépasse de 6.4 points de pourcentage le meilleur score de GPT-6 Sol sur DeepSWE v1.1, avec un niveau de raisonnement et un coût inférieurs.
- Workflows métier : il obtient 4.8 points de pourcentage supplémentaires sur AutomationBench 1.0.6 avec les mêmes réglages.
- Utilisation d’un ordinateur : il progresse de 7 points sur le jeu hors ligne OSWorld 2.0 au niveau d’effort maximal, pour moins de la moitié du coût par tâche.
- Workflows scientifiques : il fait plus que doubler le score de GPT-6 Sol sur Terminal-Bench Science 0.1 au niveau d’effort maximal, là encore pour moins de la moitié du coût par tâche.
- Exactitude factuelle : sur des prompts délibérément difficiles avec un faible niveau d’effort, la proportion de réponses contenant au moins une erreur factuelle passe de 11.4% à 7.7%, soit une baisse relative d’environ 32%.
Ces écarts sont encourageants, mais ils ne constituent pas un pourcentage d’amélioration universel. OpenAI précise que ses évaluations GPT ont été menées dans son environnement de recherche ou via son API et qu’elles peuvent différer de la production dans ChatGPT, puisque les prompts, les outils et les niveaux d’effort peuvent changer. Aucun benchmark indépendant à périmètre identique pour ces deux identifiants précis n’était disponible au 30 septembre 2026. Un score externe ne saurait donc remplacer un test sur votre propre charge.
Le lien entre chaque benchmark et les besoins d’un acheteur est plus étroit que le titre ne le suggère. DeepSWE concerne surtout une équipe qui confie à un agent des tâches de longue durée dans un dépôt. AutomationBench est pertinent pour les opérateurs qui enchaînent des outils de vente, marketing, support, finance ou RH. OSWorld importe lorsque le modèle pilote des applications. Aucun de ces tests ne prouve qu’un classificateur de support en deux étapes, une courte révision de texte ou votre base de code privée progressera.
Gagnant : GPT-6.1 Sol au vu des éléments actuels. Niveau de confiance : résultats déclarés par le fournisseur, en attendant des tests indépendants sur cette paire exacte.
Caractéristiques de GPT-6.1 Sol et GPT-6 Sol
Les deux modèles partagent presque tout leur cadre opérationnel. Chacun annonce une fenêtre de contexte de 1,050,000 tokens, une sortie maximale de 128,000 tokens, du texte et des images en entrée, du texte en sortie, les sorties structurées, le streaming et la même gamme d’outils dans Responses. D’après leurs pages respectives, aucun ne prend en charge l’audio ou la vidéo en entrée, ni le fine-tuning.
GPT-6.1 Sol fait passer la date limite documentée de ses connaissances du 20 avril au 30 avril 2026. Ces dix jours ne justifient pas une migration. Dans la plupart des systèmes en production, la qualité de la recherche d’information, le contexte privé et la fiabilité des outils pèseront bien plus lourd que ce léger décalage.
GPT-6.1 Sol : le nouveau candidat par défaut
GPT-6.1 Sol est le nouveau modèle d’OpenAI destiné aux tâches complexes, sous l’identifiant API exact gpt-6.1-sol. Il accepte les niveaux de raisonnement low, medium, high, xhigh et max, avec medium par défaut. Ses tarifs Standard par million de tokens s’élèvent à $2 pour l’entrée fraîche, $0.10 pour l’entrée mise en cache, $2.50 pour l’écriture en cache et $10 pour la sortie.
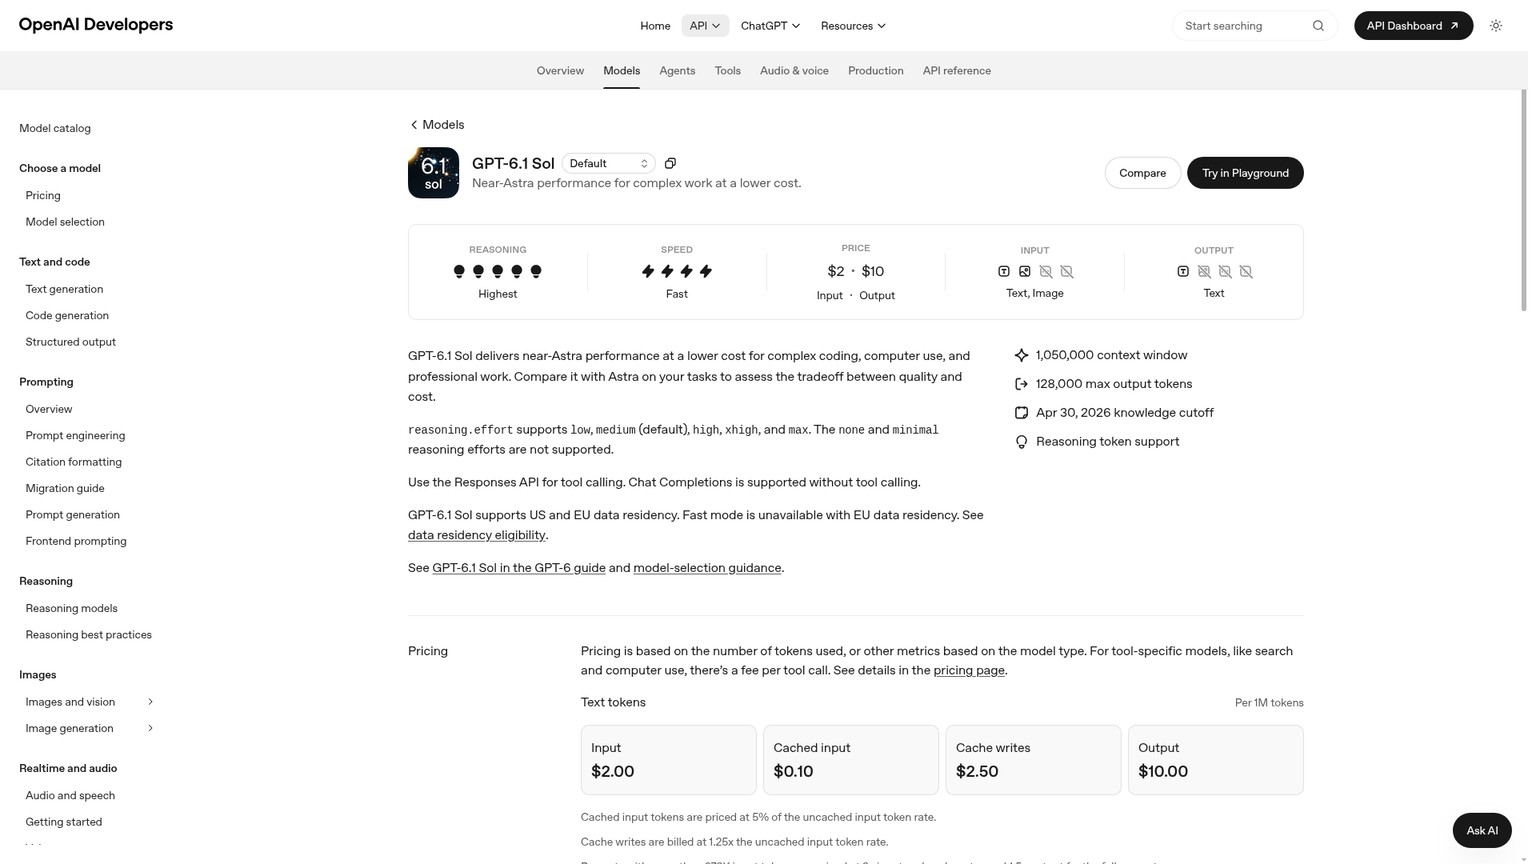
La page du modèle répertorie la recherche web, la recherche dans les fichiers, la génération d’images, l’interpréteur de code, le shell hébergé, apply patch, les skills, l’utilisation d’un ordinateur, MCP et la recherche d’outils via Responses. Optez pour ce modèle si ce parcours d’API vous convient déjà et si votre tâche ressemble aux cas où les signaux progressent : code, documents, utilisation d’un ordinateur ou workflows. Ne changez pas immédiatement de modèle par défaut si vous devez encore mener un test d’acceptation indépendant ou si votre application dépend d’un niveau de raisonnement supprimé.
GPT-6 Sol : le choix de la compatibilité
GPT-6 Sol reste disponible sous l’identifiant gpt-6-sol. Il prend en charge les niveaux de raisonnement none, low, medium, high, xhigh et max. Ses tarifs Standard par million de tokens restent fixés à $2 pour l’entrée fraîche, $0.20 pour l’entrée mise en cache, $2.50 pour l’écriture en cache et $10 pour la sortie.
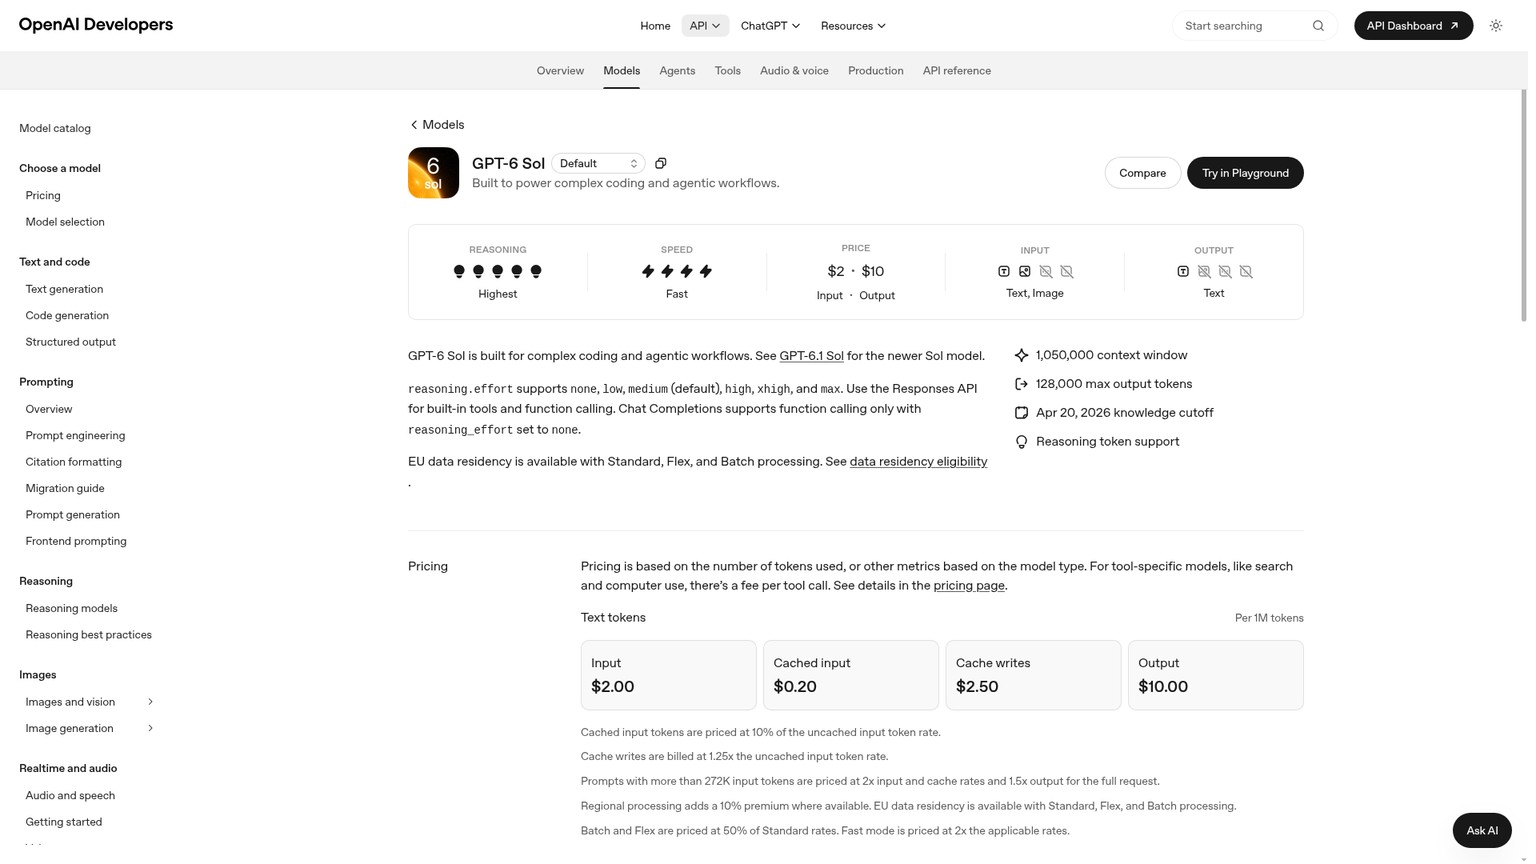
Dans Responses, sa gamme d’outils documentée correspond à celle du modèle plus récent. La différence pratique tient à sa porte de sortie historique : Chat Completions peut appeler des fonctions lorsque le niveau de raisonnement est réglé sur none. GPT-6 Sol l’emporte donc provisoirement pour une application stable qui n’a pas encore déplacé sa boucle d’outils vers Responses. En revanche, il n’est plus le moins cher dès que des lectures du cache entrent en jeu.
Gagnant : égalité sur le contexte, la limite de sortie, les modalités et les outils documentés dans Responses. GPT-6.1 Sol l’emporte sur la récence ; GPT-6 Sol sur la compatibilité historique.
Migration vers GPT-6.1 Sol : vérifiez d’abord la compatibilité
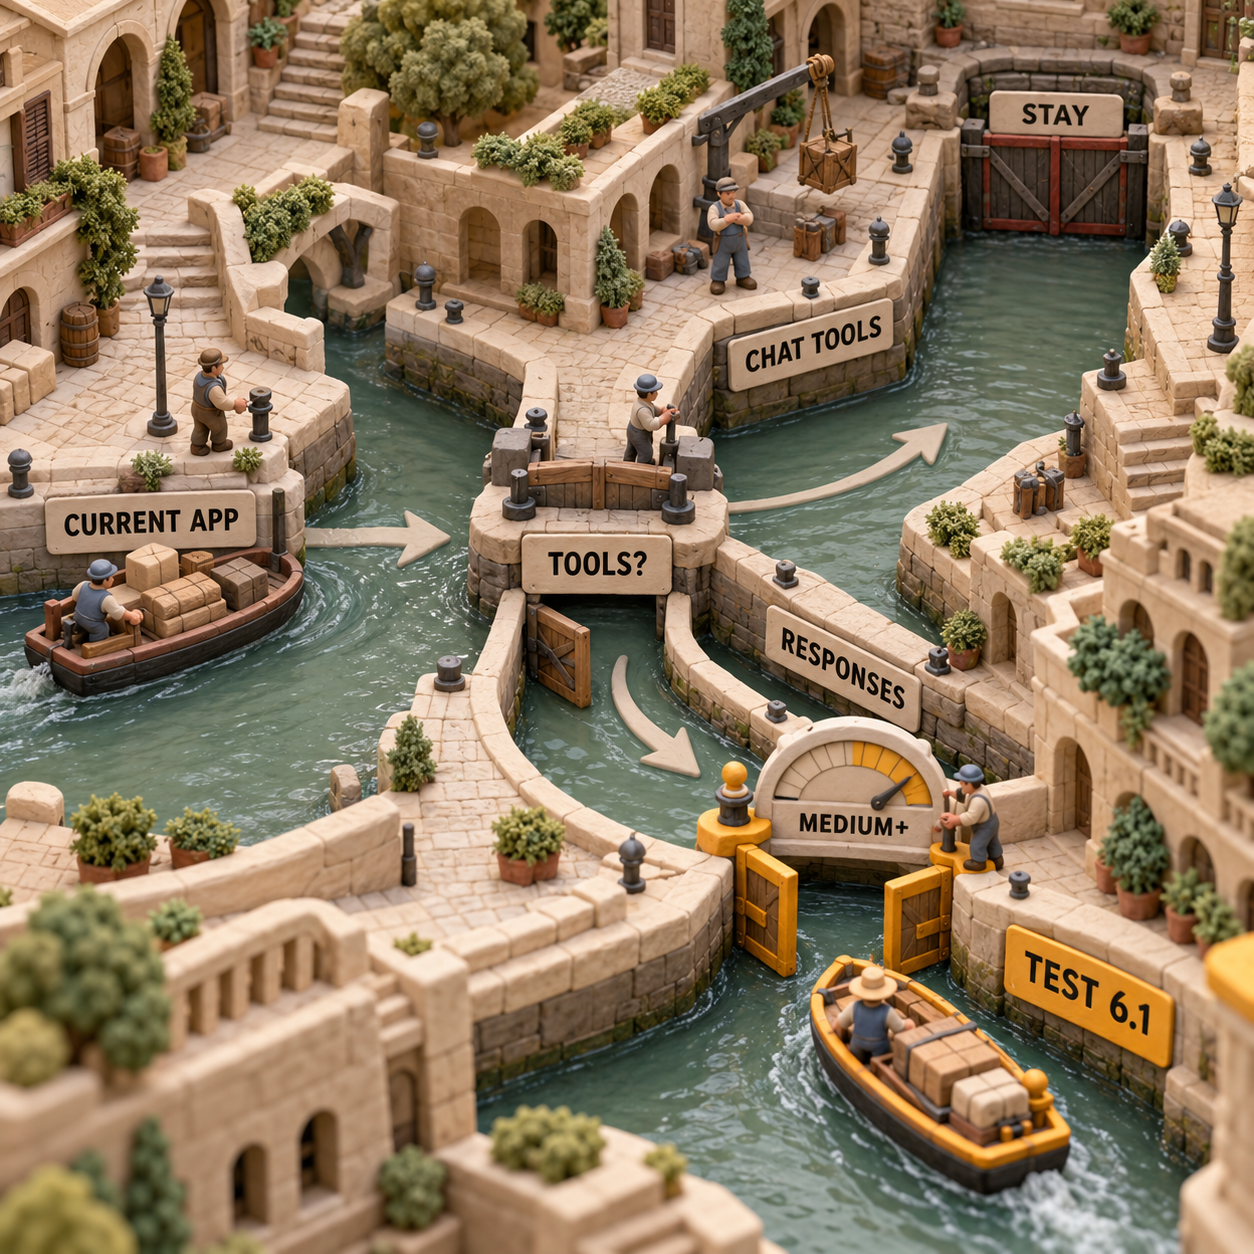
La migration vers GPT-6.1 Sol peut se limiter à une seule ligne uniquement si l’appelant utilise déjà Responses, évite none et minimal, et considère le comportement du modèle comme un élément à valider plutôt que comme un contrat interchangeable. Dans tous les autres cas, il faut d’abord migrer avant de pouvoir comparer les modèles.
Appels d’outils avec GPT-6.1 Sol
Avec GPT-6.1 Sol, les appels d’outils passent obligatoirement par l’API Responses. Chat Completions reste disponible pour les appels simples au modèle, mais pas pour invoquer des outils. GPT-6 Sol se distingue sur ce point : sa page autorise les appels de fonctions dans Chat Completions, uniquement lorsque reasoning_effort est réglé sur none.
Examinez chaque appel de fonction existant dans Chat Completions avant de modifier l’identifiant du modèle. La migration peut toucher la construction des requêtes, l’état de la conversation, le traitement des résultats d’outils, l’analyse des réponses, la logique de nouvelle tentative, le traçage et la stabilité du préfixe mis en cache. Une couche d’abstraction qui masque l’endpoint ne supprime pas ces différences : elle déplace seulement l’endroit où il faudra les tester.
Le raisonnement constitue un deuxième contrat. GPT-6.1 Sol ne prend en charge ni none ni minimal. Si une route en production utilise none pour réduire la latence, rendre la sélection d’outils plus déterministe ou maîtriser les coûts, le réglage valide le plus proche n’est pas forcément équivalent en pratique. Passez la route sur un niveau accepté et soumettez-la aux mêmes contrôles d’acceptation avant de comparer vitesse ou dépenses.
Qui ne devrait pas encore migrer ?
Ne changez pas encore le modèle par défaut si l’un de ces cas s’applique :
- Les appels d’outils passent toujours par Chat Completions.
- Une route utilise explicitement le raisonnement
noneouminimal. - La plupart des tokens facturés correspondent à des entrées fraîches et à des sorties ; les économies de cache sont alors négligeables.
- Le modèle actuel réussit déjà les contrôles d’acceptation métier et aucun progrès de GPT-6.1 Sol n’a encore été mesuré sur les mêmes cas de test.
- Un déploiement réglementé exige une analyse distincte du mode de traitement, de la résidence des données, des journaux et de l’évolution du comportement du modèle.
Il s’agit d’une dépendance au workflow, pas d’un verrouillage permanent auprès du fournisseur. Les noms des modèles sont proches, mais l’appelant peut dépendre d’un endpoint, d’un niveau minimal de raisonnement, d’un format de réponse et d’une boucle d’outils. Intégrez ce travail de validation au coût de la migration.
Gagnant : GPT-6 Sol pour un appelant aujourd’hui incompatible. GPT-6.1 Sol une fois l’appelant et les cas de test validés.
Exécutez cinq cas de test fixes avant de changer le modèle par défaut
Soumettez cinq cas de test fixes aux deux identifiants exacts, au niveau d’effort medium, avec les mêmes prompts, outils, contextes, limites de sortie et critères d’acceptation. Il s’agit d’un protocole d’évaluation proposé, pas d’un benchmark réalisé pour cet article.
Corriger un bug dans un dépôt
Fournissez aux deux modèles le même test en échec, le même état du dépôt et les mêmes outils autorisés. N’acceptez qu’un patch qui corrige l’échec visé sans casser la suite existante.
Refactoriser plusieurs fichiers
Utilisez une modification bornée qui traverse plusieurs fichiers, avec compilation, lint et tests comme critères de validation. Rejetez toute explication soignée si les vérifications du dépôt échouent.
Router une demande au support
Fournissez la même politique, le même message client et les mêmes outils de routage. Exigez la bonne file, la bonne priorité, les bons champs structurés et aucune action non autorisée.
Répondre en s’appuyant sur la politique
Demandez une réponse destinée au client, fondée sur le même ensemble de documents. N’acceptez que la conclusion attendue, les éléments de preuve cités et le bon comportement d’escalade.
Mener un workflow métier à terme
Utilisez la même tâche de consultation et de mise à jour en plusieurs étapes, avec une limite d’autorisation. Exigez la bonne séquence d’outils, l’état final attendu et le refus de toute étape non autorisée.
Consignez les sorties acceptées, la latence de bout en bout, les tokens d’entrée fraîche, d’entrée mise en cache, de raisonnement et de sortie, les frais d’outils et les nouvelles tentatives. Calculez ensuite le coût total par résultat accepté, et non par première réponse :
effective cost per accepted result = total model, retry, and tool spend / accepted outputs
Ce dénominateur peut inverser le verdict suggéré par le prix des tokens. Un modèle qui économise $0.90 sur un lot riche en cache, mais provoque un appel d’outil supplémentaire en échec, peut revenir plus cher. À l’inverse, un modèle au même prix sur les tokens frais peut être plus économique en production s’il évite des nouvelles tentatives.
Une disponibilité différente entre API, Work, Codex et Chat
GPT-6.1 Sol est accessible via l’API sous l’identifiant gpt-6.1-sol et, d’après l’annonce de lancement d’OpenAI, dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu. Au lancement, il n’était pas disponible dans le Chat ordinaire.
OpenAI indique également que GPT-6.1 Sol Ultrafast arrivera prochainement, avec une génération de tokens jusqu’à 8x plus rapide que la vitesse standard dans Codex. L’annonce ne publie aucun tarif pour Ultrafast : n’établissez donc pas de prévision de coûts à partir d’un multiplicateur non officiel.
L’utilisation de l’API est facturée séparément de l’abonnement ChatGPT. L’accès dans Work ou Codex ne transforme pas les tarifs API de $2 et $10 en quota inclus pour une application en production.
Questions fréquentes
Qu’est-ce que GPT-6 Sol ?
GPT-6 Sol est le modèle d’OpenAI conçu pour les tâches complexes de code et les workflows agentiques, sous l’identifiant API gpt-6-sol. GPT-6.1 Sol est la mise à niveau du 29 septembre 2026 : elle réduit le tarif des entrées mises en cache et modifie les conditions de compatibilité du raisonnement et des appels d’outils.
GPT Sol est-il vraiment meilleur ?
Il n’existe pas de pourcentage unique et honnête. OpenAI annonce pour GPT-6.1 Sol des gains de 6.4 points sur DeepSWE, 4.8 points sur AutomationBench et 7 points sur OSWorld face à GPT-6 Sol, dans des configurations précises. Vos propres tests fixes doivent déterminer si ces progrès se retrouvent sur votre charge.
Quelle version de GPT choisir ?
GPT-6.1 Sol est le meilleur modèle à tester pour les travaux compatibles de code et d’agents métier. GPT-6 Sol constitue le meilleur environnement temporaire si vous avez encore besoin des appels d’outils via Chat Completions ou du raisonnement none.
Quelles sont les fonctions et les prix des nouveaux modèles GPT-6 Sol et Luna d’OpenAI ?
Cette question concerne le choix initial dans la gamme. Le comparatif GPT-6 Sol vs Luna détaille leurs rôles et leur économie actuelle en matière de tokens ; cette page cherche uniquement à savoir si une charge Sol existante doit migrer vers GPT-6.1 Sol.
Quel GPT est le meilleur : Sol, Terra ou Luna ?
Aucun modèle ne gagne dans tous les cas. Faites correspondre le modèle à la difficulté de la tâche, à la latence et au coût par résultat accepté, puis évaluez les identifiants exacts que vous comptez déployer. Ce comparatif éclaire une migration de Sol à Sol, pas un choix entre Terra et Luna.
GPT-6 Sol est-il moins cher ?
Non, d’après les tarifs Standard documentés. GPT-6 Sol est à égalité avec GPT-6.1 Sol sur l’entrée fraîche, les écritures en cache et la sortie, tandis que GPT-6.1 Sol coûte moins cher sur l’entrée mise en cache : $0.10 contre $0.20 par million de tokens.
L’abonnement ChatGPT à $20 vaut-il son prix ?
Cette question relève d’un abonnement grand public, pas d’une comparaison tarifaire entre modèles API. Au lancement, GPT-6.1 Sol était proposé dans Work et Codex avec les offres payantes citées, mais pas dans le Chat ordinaire ; l’utilisation de l’API est facturée séparément.
GPT-5.6 Sol est-il meilleur que GPT-5 ?
Cette ancienne comparaison ne permet pas de trancher la migration actuelle. Pour un déploiement aujourd’hui, évaluez GPT-6.1 Sol et GPT-6 Sol avec le parcours d’API, le niveau de raisonnement, les outils et les contrôles d’acceptation réellement utilisés par l’application.
GPT-6 est-il performant ?
Les capacités de GPT-6 varient selon le modèle, la tâche, le niveau d’effort et la configuration des outils. GPT-6.1 Sol dispose de meilleurs résultats déclarés par le fournisseur que GPT-6 Sol sur plusieurs évaluations difficiles, mais un test privé fixe reste la réponse valable pour la production.
Quel est le nombre de paramètres de GPT-6.1 Sol et GPT-6 Sol ?
Les pages actuelles d’OpenAI ne publient ni le nombre de paramètres ni de poids téléchargeables pour ces modèles. Comparez plutôt les limites, les tarifs, le comportement de l’API et les résultats mesurés sur les tâches.
Ce qu’il faut faire dès lundi
Commencez par l’appelant, pas par le sélecteur de modèle. Recherchez dans le code et la configuration des workflows les appels de fonctions via Chat Completions ainsi que les valeurs none ou minimal de reasoning_effort. Si vous en trouvez, cadrez cette migration avant de changer le modèle par défaut.
Exécutez ensuite les cinq cas de test fixes sur gpt-6-sol et gpt-6.1-sol au niveau d’effort medium, avec les mêmes outils et contrôles. Comparez le coût par résultat accepté, la latence, l’utilisation du cache et les nouvelles tentatives. Déployez GPT-6.1 Sol sur les routes où il gagne ; laissez les autres sur GPT-6 Sol jusqu’à la disparition de l’écart de compatibilité ou de résultats.
Recevez la checklist de configuration de Claude Code et Codex avant de modifier le routage d’un modèle en production.
- Dernière mise à jour
- 30 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Claude Sonnet 5.5 : guide pratique, réglages et cas d’usage
Apprenez à utiliser Claude Sonnet 5.5, à régler son niveau d’effort et à migrer l’API grâce à des workflows fiables, des coûts réels et des garde-fous.28 sept. 2026AI
GLM-5.3-Flash ou Jev : quel modèle de décision IA choisir ?
Jev réduit le coût du routage texte, tandis que GLM-5.3-Flash gère les images. Comparez prix, latence, précision et contraintes avant de choisir.27 sept. 2026AI
Claude Opus 5.5 ou Opus 5 : prix, code et migration
Claude Opus 5.5 coûte moins cher, mais cinq changements d’API compliquent la migration. Comparez les prix, le code, le thinking et les critères de choix.23 sept. 2026AI
GPT-6 Sol ou Luna : quel modèle choisir ?
GPT-6 Sol ou Luna : comparez prix, usages, limites et coût par résultat accepté pour choisir le bon modèle sans payer 20× plus cher par défaut.23 sept. 2026AI
GPT-6 Luna gratuit : accès, limites et tarifs API
GPT-6 Luna gratuit à l’essai dans l’app desktop : découvrez les comptes compatibles, les limites connues, l’accès à Codex et les tarifs de l’API.22 sept. 2026AI
MiMo AI : comment utiliser Xiaomi MiMo V2.6 et son API
Testez MiMo AI dans Studio, choisissez la bonne clé et le bon modèle, puis lancez un premier workflow métier fiable avec l’API Xiaomi MiMo V2.6.22 sept. 2026AI
Comparatif MiMo V2.6 : Pro ou Flash, lequel choisir ?
Comparatif MiMo V2.6 Pro et Flash pour le code et les agents IA : réussite des tâches, coût des tokens, cache et cas où Pro justifie son prix.22 sept. 2026AI