Prompt caching GPT-6 : réduire les coûts sans rater le cache
Maîtrisez le prompt caching de GPT-6 : structurez les préfixes, diagnostiquez les échecs et réduisez le coût réel de vos agents en production.



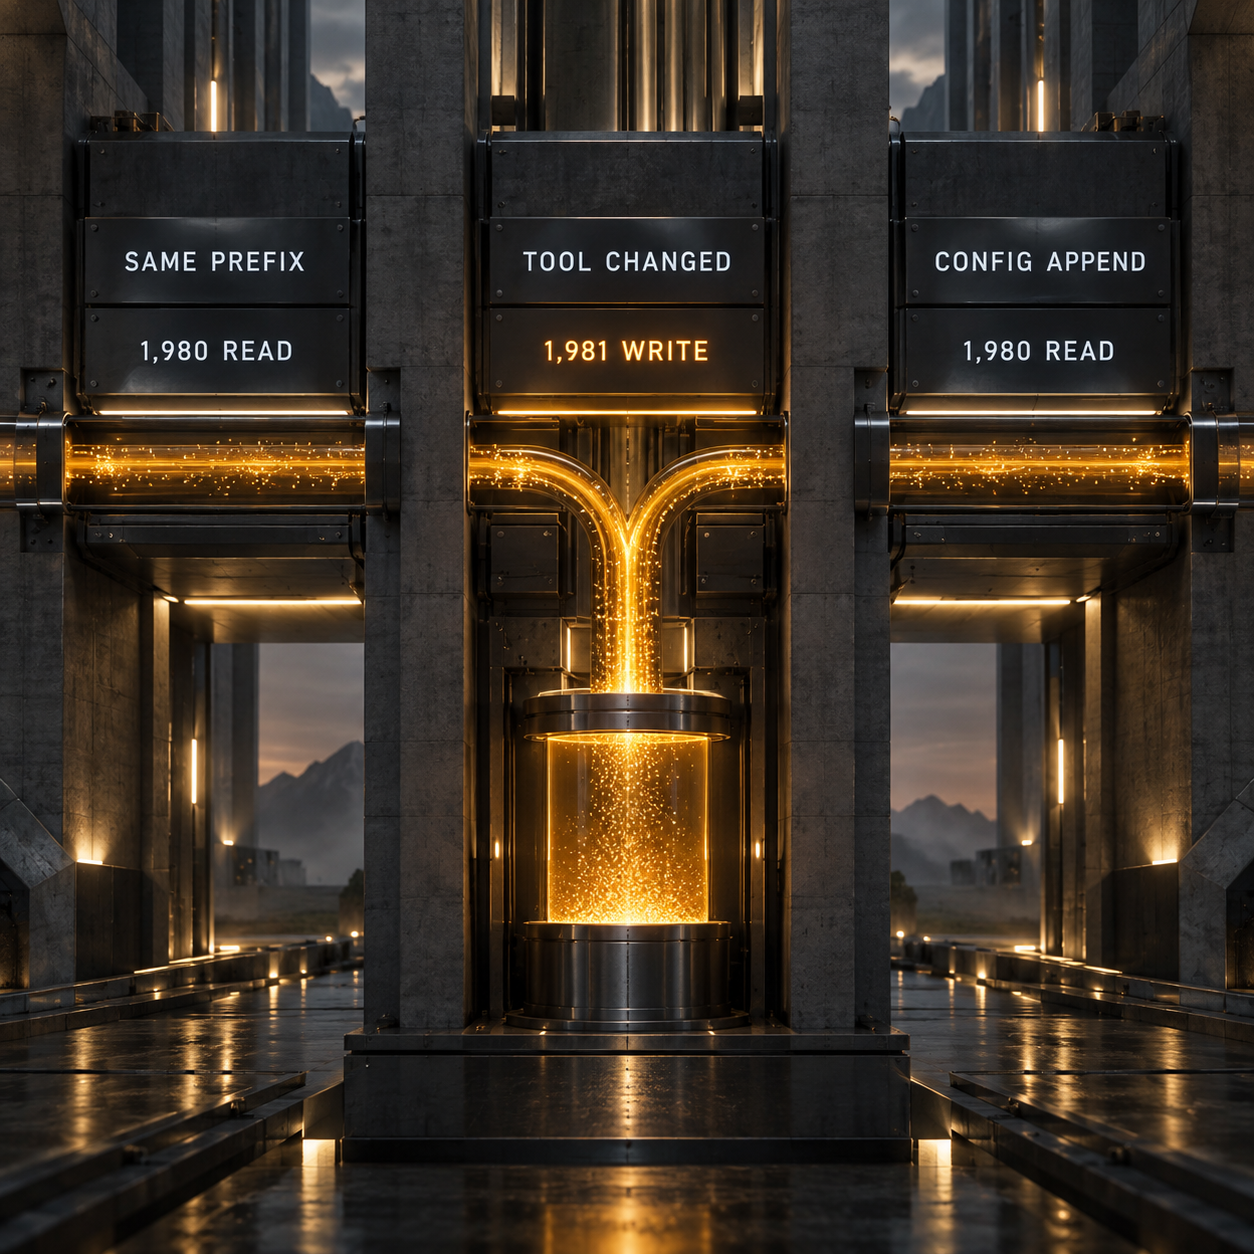
Le prompt caching rend un agent GPT-6 moins coûteux lorsque ses instructions récurrentes, ses outils et son contexte restent strictement identiques au début de chaque requête. Lors d’un test réel avec GPT-6 Sol, une répétition exacte a réutilisé 1,980 tokens en cache pour un coût de $0.000452. Modifier un seul nom d’outil a imposé une nouvelle écriture du préfixe et porté le coût à $0.0050085. Le tableau de bord et les diagnostics lancés le 22 septembre permettent de repérer cet écart avant qu’il ne gonfle la facture de production.
Prompt caching : contenu stable d’abord, variables à la fin
Le prompt caching, ou mise en cache des prompts, conserve l’état déjà calculé par le modèle pour un préfixe inchangé, c’est-à-dire le contenu placé au début d’une requête. Imaginez un atelier que l’on laisse prêt pour le lendemain : le manuel de procédures, les outils et l’assemblage en cours restent en place. L’équipe suivante reprend immédiatement, sans devoir tout réinstaller.
OpenAI stocke des tenseurs clé-valeur — l’état de travail du modèle — et non une copie du prompt. Le cache englobe tout le contexte rendu : les instructions OpenAI, les messages développeur, les définitions d’outils et l’historique de la conversation. Une requête ultérieure ne peut réutiliser ce travail que jusqu’à la première différence significative dans le préfixe rendu.
L’ordre des éléments influe donc directement sur le coût. Placez d’abord les règles stables, les documents de référence, les exemples et les définitions d’outils. Gardez les horodatages, identifiants de requête, données client et tâche du moment pour la fin. Modifier une ligne située tôt dans le prompt peut invalider tout ce qui suit.
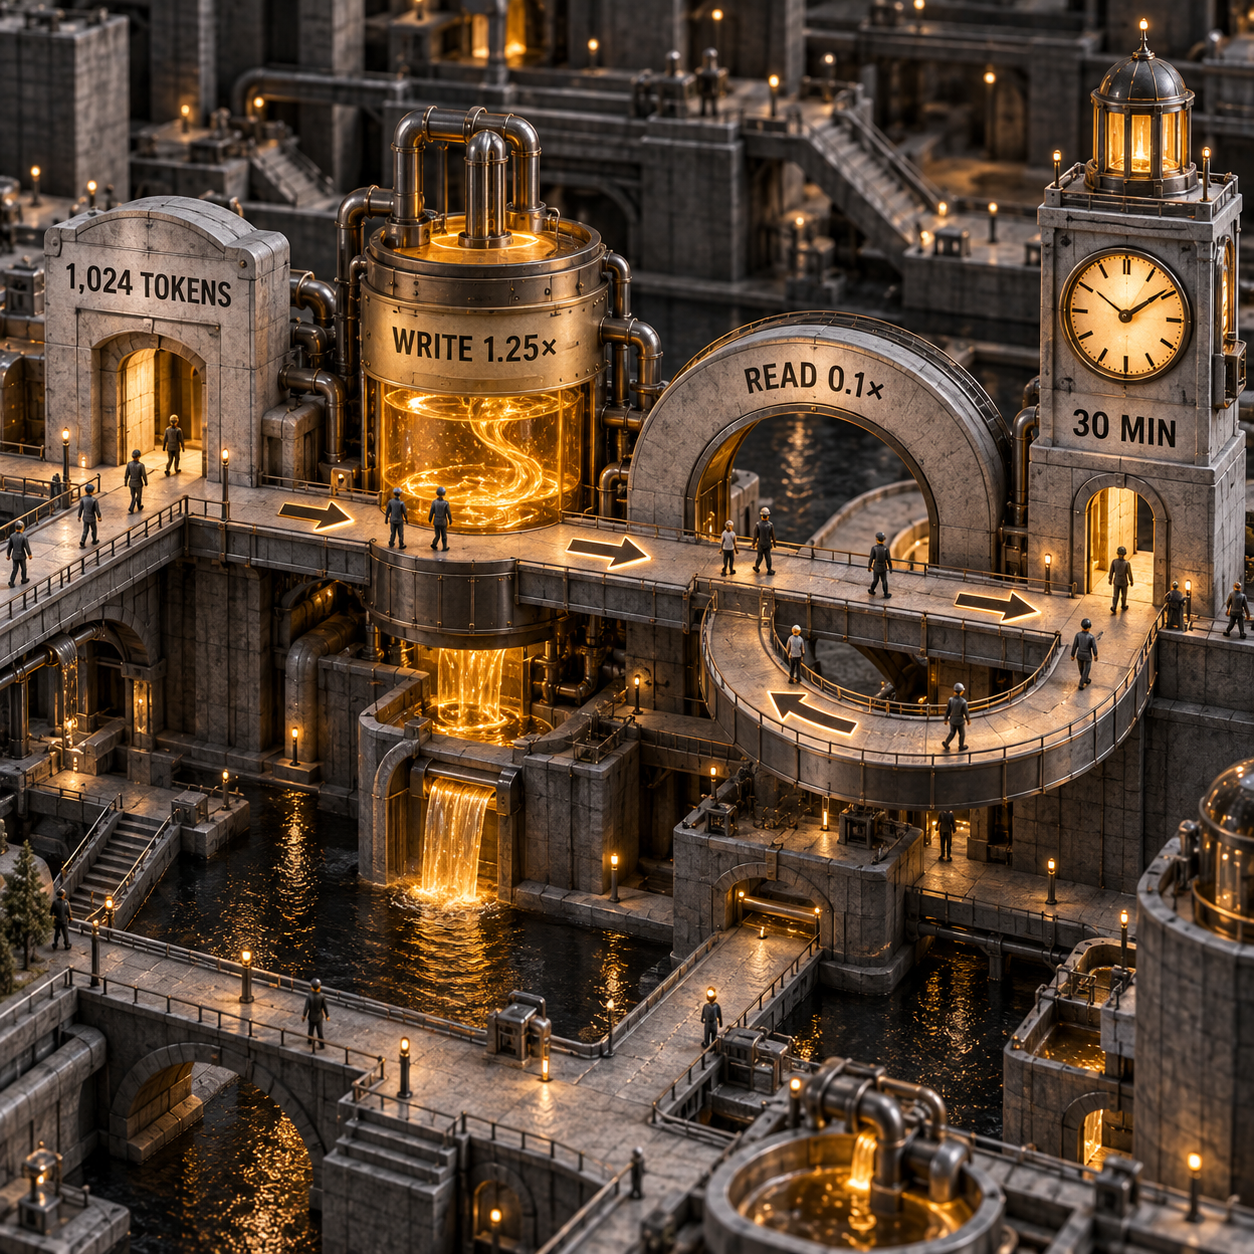
Le prompt caching est déjà actif sur les modèles compatibles. Avec GPT-5.6 et les versions ultérieures, un préfixe devient éligible à partir de 1,024 tokens d’entrée visibles. La première requête éligible écrit le préfixe au tarif de 1.25 fois celui d’une entrée ordinaire. Une requête identique le relit au tarif de 0.1 fois ce même prix. L’entrée reste éligible pendant au moins 30 minutes après sa dernière écriture ou réutilisation.
Il s’agit d’une réutilisation exacte du préfixe, pas d’une ressemblance sémantique. Deux règles équivalentes sur le fond mais formulées différemment près du début produisent deux entrées de cache distinctes. Il en va de même si vous modifiez le nom, la description, le schéma JSON ou l’ordre d’un outil, mais aussi le modèle, le format de sortie, le niveau de raisonnement ou la verbosité.
Ce qui a changé le 22 septembre
La nouvelle couche de pilotage compte davantage que le cache lui-même. La mise à jour publiée par OpenAI le 22 septembre ajoute un tableau de bord dédié au prompt caching, des diagnostics de comparaison entre requêtes et un moyen de modifier le niveau de raisonnement au fil d’une conversation GPT-6 sans casser le cache. OpenAI indique aussi que la famille GPT-6 obtient par défaut de meilleurs taux de réutilisation du cache.
Ces nouveautés ne doivent pas être confondues avec les mécanismes également disponibles sur GPT-5.6. Le guide actuel du prompt caching applique à GPT-5.6 et aux versions ultérieures le minimum de 1,024 tokens, le tarif d’écriture à 1.25×, le tarif de lecture à 0.1×, les points de rupture implicites et explicites, ainsi que le TTL de 30 minutes.
Le comparatif entre GPT-6 Sol et Luna aide d’abord à choisir le modèle. La mise en cache intervient ensuite. Un modèle moins cher avec un préfixe stable et un modèle plus coûteux avec un préfixe stable conservent le même arbitrage relatif.
Commencer par la mise en cache automatique
La mise en cache automatique est le bon point de départ : elle fournit une référence propre sans restructurer lourdement les prompts. Envoyez deux fois la vraie requête pendant la fenêtre active, conservez tous les champs sensibles au cache à l’identique, puis examinez la seconde réponse.
Deux champs suffisent à trancher la question de la facturation : usage.input_tokens_details.cached_tokens et cache_write_tokens. Un volume élevé de cached_tokens indique que la requête a réutilisé une entrée déjà traitée. Un volume élevé de cache_write_tokens signifie qu’elle a payé la création d’un nouvel état de cache. Les tokens d’entrée ordinaires correspondent au total des entrées, diminué de ces deux valeurs.
Le nouveau parcours de diagnostic relie désormais ces chiffres à leur cause :
- Enregistrez l’identifiant d’une réponse récente et terminée provenant de la même organisation.
- Ajoutez-le à
prompt_cache_options.comparison_response_iddans la requête actuelle. - Consultez
prompt_cache_diagnosticsdans la réponse. - Pour la facturation, fiez-vous aux champs d’usage et non aux estimations du diagnostic.
L’API Responses appelée directement peut renvoyer cache_hit, cache_miss, comparison_response_not_found ou unavailable. Quand le système de diagnostic l’identifie, une définition d’outil modifiée est classée tools_changed. Ces diagnostics fonctionnent au mieux de leurs capacités et ne remontent que la première cause classifiée : corrigez-la, puis relancez la comparaison.
Voici un script de test compact pour un appel direct à l’API. Le fichier de règles doit contenir assez d’informations stables et utiles pour dépasser le minimum de 1,024 tokens.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
Utilisez une référence récente. Les données de diagnostic expirent rapidement, et l’identifiant de comparaison sert uniquement à demander une explication. À lui seul, il ne recharge pas la conversation précédente et ne provoque aucun accès au cache.
Un échec de cache provoqué volontairement
Le test réel utilisait GPT-6 Sol, une politique de support synthétique de 1,635 mots, un outil de type fonction et la courte consigne Reply with exactly OK. Le modèle a répondu OK à chaque requête. Seule la structure sensible au cache a changé.
Le calcul repose sur les tarifs actuels de GPT-6 Sol Standard en contexte court : $2 par million de tokens d’entrée ordinaires, $0.20 par million de tokens d’entrée en cache, $2.50 par million de tokens écrits dans le cache et $10 par million de tokens de sortie. Chaque réponse a consommé cinq tokens de sortie.
En incluant la sortie, la répétition exacte a coûté 91.0% de moins que la réponse de référence. Pour un agent en dix étapes présentant la même répartition de tokens, une écriture suivie de neuf lectures coûte environ $0.009074. Dix écritures neuves reviennent à environ $0.05006. Dans cette charge synthétique, stabiliser le préfixe réduit de 81.9% le coût par étape terminée.
Voilà l’indicateur qui doit guider la décision. Un taux de réutilisation du cache peut sembler satisfaisant alors que quelques tours longs et coûteux réécrivent sans cesse le contexte. Additionnez le coût réel de chaque classe de tokens sur les tâches terminées, puis comparez les résultats acceptés, les nouvelles tentatives et les frais d’outils.
Les temps mesurés ne permettent pas de conclure sur la latence. Les quatre appels ont pris entre 892 et 1,254 millisecondes, et la répétition avec cache n’était pas la plus rapide. Sur un échantillon aussi réduit, le réseau et le routage dominent. Le coût a nettement baissé ; pour la latence, il faut multiplier les mesures et suivre le délai avant le premier token.
Le test a également révélé un problème d’intégration utile. Vercel AI Gateway a bien transmis prompt_cache_options, renvoyé l’identifiant de réponse du fournisseur OpenAI et indiqué les lectures et écritures du cache, mais sa réponse normalisée omettait prompt_cache_diagnostics. L’échec volontaire restait évident : aucun token en cache et 1,981 tokens écrits. Si un SDK ou une passerelle s’intercale entre votre application et OpenAI, vérifiez qu’il expose le nouveau champ de diagnostic avant d’en dépendre en production.
Stabiliser le préfixe avant d’ajouter des points de rupture
La plupart des échecs viennent de la construction ordinaire des requêtes. Corrigez d’abord ces points :
- Conservez à l’identique les noms, descriptions, schémas, configurations et l’ordre des outils. Utilisez
tool_choice: "none"lorsqu’aucun outil ne doit être exécuté, ouallowed_toolspour limiter les outils appelables, tout en fournissant la liste complète. - Ne changez ni le modèle, ni le niveau de service, ni le schéma de texte, ni le niveau de raisonnement défini dans la requête, ni la verbosité entre des requêtes censées partager un préfixe.
- Placez les horodatages, identifiants utilisateur, identifiants de trace et données propres à la tâche après les instructions et références stables.
- Ajoutez les messages et résultats d’outils à la suite. Réécrire ou résumer un élément antérieur de la conversation modifie le préfixe.
- Après chaque correction, comparez avec la bonne référence. Les diagnostics ne signalent que la première différence classifiée.
Avec GPT-6, modifiez l’effort au moyen d’un élément de conversation plutôt qu’en changeant le réglage de premier niveau. La requête ci-dessous conserve low au premier niveau, puis applique high au message suivant.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
Les mises à jour de configuration fonctionnent avec la famille GPT-6 en mode standard à agent unique, et ne modifient que l’effort de raisonnement. N’en placez pas deux à la suite. Elles ne sont pas non plus compatibles avec la compaction automatique ou la troncature automatique.
Le guide de migration vers l’API Responses détaille les choix plus larges liés à l’état. Pour la mise en cache, l’essentiel tient en une règle : conservez les anciens éléments à leur place et ajoutez le changement à la suite.
N’ajouter des points de rupture explicites que s’ils sont rentables
Un point de rupture explicite est utile lorsqu’une requête contient un socle stable, suivi d’un suffixe qui change trop souvent pour mériter une écriture dans le cache. Placez les instructions stables dans un bloc input_text au sein d’un message développeur, ajoutez prompt_cache_breakpoint: {"mode":"explicit"} à ce bloc et réglez prompt_cache_options.mode sur explicit.
Le champ instructions de premier niveau ne peut pas accueillir de point de rupture explicite. En mode explicite, une requête dépourvue de marqueur n’écrit rien dans le cache. C’est parfois la bonne stratégie pour un prompt utilisé une seule fois : l’écriture coûte 25% de plus qu’une entrée ordinaire et n’est amortie que si une requête ultérieure vient la relire.
Une requête peut créer jusqu’à quatre écritures de cache. Inutile de consommer ces emplacements à chaque message. Choisissez des frontières qui reflètent les véritables embranchements de l’application : une politique commune à l’entreprise, le contexte d’un espace de travail, une bifurcation dans la conversation et, éventuellement, une grille d’évaluation stable.
Le préchauffage répond à un autre besoin : la latence. Une requête avec prompt_cache_options.prewarm: true prépare un contexte connu sans générer de sortie, puis la requête utilisateur renvoie le même préfixe. Cet appel est facturé au tarif normal d’écriture du cache. Réservez-le donc à un trafic prévisible et mesurez le délai avant le premier token.
Sept workflows qui bénéficient le plus du cache
1. Plateformes d’agents de code
Un agent de code renvoie régulièrement la cartographie du dépôt, les règles développeur, les schémas d’outils et les tours précédents. Gardez ces blocs stables, puis ajoutez les modifications de fichiers et les résultats d’outils. Les tâches en arrière-plan peuvent bifurquer depuis l’historique partagé. À la clé : un contexte moins cher sur les longues sessions. Comme un simple renommage d’outil peut annuler l’économie, ce cas d’usage mérite tout particulièrement un test de régression du cache dans la CI.
2. Agents de support client
Une équipe de support peut s’appuyer sur un long manuel de procédures, les règles du catalogue produit et des outils d’escalade fixes. Placez ce socle commun en premier et le ticket en cours ensuite. C’est exactement le schéma de la politique synthétique mesurée plus haut. À forme de requête identique, dix courtes réponses terminées sont passées d’environ $0.05006 avec des écritures répétées à $0.009074 avec une écriture et neuf lectures.
3. Équipes d’évaluation et de qualité
Un évaluateur peut réutiliser une grille de notation, des exemples annotés, un schéma de sortie et des définitions d’outils, tandis que seule l’interaction à évaluer change à la fin. Le mode explicite permet d’éviter de payer l’écriture de cette partie variable. Le cache devient alors un levier mesurable de l’économie des évaluations, et non un détail invisible de la plateforme.
4. Agents de recherche et d’audit
Un workflow de recherche peut maintenir un corpus de sources validées et des règles d’analyse stables, puis ajouter de nouvelles questions. Les synthèses dérivées, contrôles de contradiction et sections de rapport peuvent partager le même préfixe. Le gain augmente lorsque plusieurs agents partent des mêmes éléments pour produire des livrables différents.
5. Revue de contrats et conformité
Une équipe juridique opérationnelle peut placer sa bibliothèque de clauses, sa grille de risques, ses formulations approuvées et ses outils de revue avant le contrat étudié. Chaque nouveau document devient le suffixe variable. Le cache ne rend pas l’analyse plus sûre, mais il peut réduire le coût de chargement répété des mêmes garde-fous.
6. Opérations multi-agents
Un orchestrateur peut conserver un plan commun, l’état de l’espace de travail et l’historique des outils avant de répartir le travail entre des agents spécialisés. La réutilisation du cache rend ces bifurcations moins coûteuses quand le préfixe partagé est volumineux. Gardez les définitions d’outils stables et, si l’application le permet, ajoutez les nouveaux outils via un historique en ajout uniquement.
7. Lancements interactifs prévisibles
Un produit reposant sur un corpus connu peut préchauffer le cache au démarrage, avant la première requête utilisateur. Le traitement du préfixe intervient ainsi avant que l’utilisateur ne commence à patienter. Cette approche n’a d’intérêt que si le trafic arrive assez vite pour réutiliser l’entrée et si des tests répétés confirment le gain de latence.
Trois produits à construire autour du prompt caching
1. Cache Regression CI, l’opportunité la plus solide
Créez une barrière de test qui rejoue des requêtes d’agent représentatives, compare chaque réponse à une référence enregistrée et fait échouer une pull request si les tokens en cache diminuent ou si les écritures bondissent. Les équipes qui développent des plateformes d’agents sont prêtes à payer, car une modification apparemment anodine du schéma d’un outil peut transformer chaque tour de production en nouvelle écriture.
La demande est assez ciblée pour être adressée et assez visible pour compter : prompt caching génère environ 1,300 recherches mensuelles aux États-Unis, openai prompt caching en génère 320, et la requête exacte consacrée à la configuration de GPT-6 n’a renvoyé que deux guides indépendants. Helicone facture déjà $79 par mois son offre Pro avec alertes et rapports, preuve que les équipes consacrent un budget au monitoring des LLM.
La plus petite version commercialisable réunit une CLI, un contrôle GitHub et un rapport unique regroupant l’identifiant de la réponse de référence, la cause du diagnostic, les tokens en cache, les tokens écrits, le temps écoulé et le coût calculé. Attention toutefois au tableau de bord et aux diagnostics natifs d’OpenAI. Pour mériter sa place, le produit doit ajouter une barrière de déploiement, une couverture multi-fournisseurs ou l’attribution à une modification du code.
2. Un outil de ventilation des coûts sensible au cache
Construisez un registre de coûts par client pour les produits d’IA, en séparant les entrées ordinaires, les lectures du cache, les écritures du cache, les sorties et les frais d’outils. Les équipes finance et plateforme en ont besoin lorsqu’un même préfixe d’agent sert plusieurs clients, mais que le produit doit toujours justifier ses marges par espace de travail.
Environ 50 recherches mensuelles aux États-Unis ciblent openai api prompt caching, tandis que les questions People Also Ask observées incluent « Should I use prompt caching? » et « When not to use caching? ». Langfuse propose des offres cloud de production à $29 et $199 par mois, autre indice qu’un budget logiciel existe déjà pour le suivi des tokens et des coûts.
Le MVP tient dans un wrapper de SDK, une grille tarifaire, des tags de tenant et une vue par tâche terminée. La vraie difficulté est l’attribution. Avec GPT-5.6 et les versions ultérieures, prompt_cache_key n’est pas requis pour le routage, et les clés distinctes servent surtout à la comptabilité. Des frontières mal définies entre tenants peuvent produire des factures difficiles à comprendre ou soulever des questions de confidentialité.
3. Un moniteur de conformité des adaptateurs
Développez une suite de tests capable de vérifier qu’un SDK, un proxy ou une passerelle de modèles transmet les nouveaux champs de l’API Responses et les restitue sans altération. Après chaque mise à jour de dépendance, elle contrôlerait comparison_response_id, les types de diagnostics, le détail des tokens du cache, les mises à jour de configuration, les points de rupture explicites et les identifiants de réponse du fournisseur.
Le besoin se lit dans les lacunes pédagogiques : what is prompt caching représente environ 480 recherches mensuelles aux États-Unis, how does prompt caching work environ 140, et la question « How do I turn on prompt caching? » figure dans les résultats People Also Ask observés. Le test de terrain a aussi mis au jour un défaut concret : la passerelle conservait les données d’usage, mais omettait l’objet de diagnostic.
Le MVP serait une matrice de compatibilité hébergée, complétée par une commande lançant cinq requêtes synthétiques vers l’endpoint du client. Reste la question de la pérennité : les fournisseurs de passerelles finiront par ajouter ces champs. Le produit doit donc tester en continu les protocoles de plusieurs fournisseurs, au lieu de rester un simple vérificateur GPT-6 ponctuel.
Limites et verdict sans détour
Le prompt caching mérite d’être intégré à l’architecture lorsqu’un long préfixe se répète. C’est une mauvaise cible pour des requêtes courtes, uniques ou continuellement réécrites près du début.
Le seuil de 1,024 tokens compte réellement. Ajouter du contenu inutile à un petit prompt uniquement pour devenir éligible peut augmenter la facture. Des exemples stables et utiles ou des documents de référence peuvent justifier ces tokens supplémentaires, mais la décision dépend du nombre de réutilisations et de la qualité obtenue — pas de l’envie d’afficher un accès au cache.
L’état du cache est aussi lié à l’infrastructure physique. Les entrées résident sur des machines individuelles, et un trafic supérieur à environ 15 requêtes par minute peut déborder vers d’autres machines. Le routage et la charge peuvent donc provoquer des échecs même lorsque le contenu paraît stable côté application. Un accès au cache reste un résultat d’optimisation, jamais une garantie de fonctionnement.
Les entrées en cache comptent toujours dans les limites de tokens par minute. Il est impossible de vider le cache manuellement. La réutilisation ne modifie pas la génération de sortie : deux requêtes identiques peuvent donc produire des réponses différentes. Avec GPT-6 Sol, une requête dépassant 272,000 tokens d’entrée bascule aussi dans son intégralité vers les tarifs plus élevés du contexte long.
La meilleure règle opérationnelle est simple : suivez le coût par tâche acceptée, gardez le préfixe stable et traitez toute hausse des écritures comme un incident à expliquer.
L’action à mener lundi
Lundi prochain, choisissez un endpoint d’agent en production. Enregistrez l’identifiant d’une réponse représentative, rejouez la même tâche terminée, puis notez les tokens en cache, les tokens écrits, le temps écoulé, les tokens de sortie et le coût total. Modifiez ensuite une description ou un nom d’outil, comparez avec la même référence, restaurez la liste d’outils et relancez. Si la requête restaurée réduit le coût par tâche terminée sans nuire au taux d’acceptation, intégrez exactement ce test à la CI avant de modifier les prompts ou d’ajouter des points de rupture.
Questions fréquentes
Comment activer le prompt caching ?
Dans la plupart des cas, aucune activation n’est nécessaire. Le prompt caching est actif par défaut sur les modèles OpenAI compatibles. Gardez au moins 1,024 tokens visibles stables au début d’une requête destinée à GPT-5.6 ou une version ultérieure, envoyez une requête identique pendant la fenêtre active, puis consultez cached_tokens. N’utilisez prompt_cache_options.mode que pour contrôler précisément les points de rupture.
Qu’est-ce que le prompt caching et comment fonctionne-t-il ?
Il conserve l’état clé-valeur déjà calculé par le modèle pour un préfixe de prompt exact. La première requête éligible écrit cet état ; les requêtes suivantes dotées du même préfixe peuvent le relire au lieu de le recalculer. Le nouveau contenu ajouté en suffixe et la génération de sortie demandent toujours du travail.
Dans quels cas faut-il éviter la mise en cache ?
Ne cherchez pas à l’optimiser si les prompts restent sous le seuil minimal, se répètent rarement, changent près du début ou expirent avant la requête suivante. En mode explicite, l’absence de point de rupture évite de payer le tarif d’écriture à 1.25× pour un préfixe qui ne sera probablement pas réutilisé.
Faut-il utiliser le prompt caching ?
Oui, si les entrées répétées pèsent réellement dans le coût des tâches terminées. Mesurez une écriture et plusieurs lectures avec vos vrais outils et vos contrôles d’acceptation. Un taux de réutilisation élevé n’a d’intérêt que si le coût total par tâche acceptée diminue.
Quelle est la meilleure stratégie de mise en cache ?
Commencez par la mise en cache automatique et implicite. Placez le contenu stable en premier, ajoutez les éléments variables à la fin, gardez les outils et paramètres de requête fixes, puis diagnostiquez les échecs. N’ajoutez des points de rupture explicites qu’autour de blocs stables suffisamment réutilisés pour amortir le coût d’écriture.
Pour intégrer cette mesure et ce contrôle de régression à votre stack d’agents, l’offre Systèmes d’IA en production est le point de départ adapté.
- Dernière mise à jour
- 27 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Prix Copilot Studio : le vrai coût du Managed Runtime
Prix Copilot Studio : calculez le coût réel du Managed Runtime, des appels API aux crédits, licences, agents, lancements et frais d’hébergement.26 sept. 2026Build
n8n workflow ou Agent IA : lequel choisir ?
Faut-il choisir un n8n workflow ou un Agent IA ? Comparatif concret des coûts d’exécution, validations, sessions et limites de la version Preview.26 sept. 2026Build
OpenRouter pricing : Jev Router est-il vraiment gratuit ?
OpenRouter pricing affiche Jev Router à $0. Voici ce que ce tarif couvre, quels coûts restent à vérifier et comment auditer chaque requête routée.26 sept. 2026Build
Claude Code plugin : comment le publier dans l’annuaire
Publiez un Claude Code plugin dans l’annuaire Claude : dépôt GitHub, validation, examen, connecteur MCP, coûts, propriété et suivi des mises à jour.26 sept. 2026Build
MCP Cloudflare : le portail est-il vraiment gratuit ?
Le portail MCP Cloudflare est gratuit jusqu’à 50 utilisateurs actifs. Découvrez ses limites, le prix des sièges et les coûts à prévoir autour.26 sept. 2026Build
Performance GPU : bien utiliser Agentic CUDA Optimizer
Configurez Agentic CUDA Optimizer, encadrez l’optimisation d’un kernel CUDA et validez exactitude, temps GPU et coûts du modèle avant tout déploiement.25 sept. 2026Build
Cloud GPU Runpod : le vrai coût des Pods face au Serverless
Comparez les tarifs du cloud GPU Runpod pour les Pods et le Serverless, le coût du stockage et le seuil de 60.33% qui détermine l’option la moins chère.25 sept. 2026Build