GPT-6 프롬프트 캐싱: 비용 급증을 막는 진단 전략
GPT-6 프롬프트 캐싱에서 적중과 미스를 가르는 접두부 설계 원칙을 정리합니다. 실제 토큰·비용 측정값과 새 대시보드·진단 기능, 명시적 중단점 활용법을 함께 살펴보고 캐시 쓰기 급증을 운영 전에 잡는 방법을 실제 API 설정 예시와 함께 설명합니다.



GPT-6 프롬프트 캐싱은 요청마다 반복되는 지침, 툴, 컨텍스트가 맨 앞에서 정확히 같을수록 비용을 낮춥니다. 실제 GPT-6 Sol 실행에서 완전히 같은 요청은 캐시된 토큰 1,980개를 재사용해 $0.000452가 들었습니다. 툴 이름 하나를 바꾸자 접두부를 다시 기록하며 비용이 $0.0050085로 뛰었습니다. 9월 22일에 추가된 대시보드와 진단 기능을 쓰면 이 차이가 운영 비용으로 쌓이기 전에 확인할 수 있습니다.
프롬프트 캐싱의 원칙: 고정 정보는 앞에, 변경 정보는 뒤에
프롬프트 캐싱은 요청의 시작 부분, 즉 바뀌지 않은 접두부를 처리한 모델 상태를 저장합니다. 작업장을 퇴근할 때 그대로 두는 상황을 떠올리면 쉽습니다. 정책 매뉴얼과 툴 선반, 조립 중인 작업물을 제자리에 두면 다음 교대조는 작업장을 처음부터 다시 꾸리지 않고 그 지점에서 바로 시작할 수 있습니다.
OpenAI는 프롬프트 사본이 아니라 모델의 작업 상태인 키-값 텐서를 저장합니다. 캐시 범위에는 OpenAI 지침, 개발자 메시지, 툴 정의, 대화 기록까지 렌더링된 전체 컨텍스트가 들어갑니다. 이후 요청은 렌더링된 접두부에서 처음으로 의미 있는 차이가 나타나는 지점까지만 이 작업을 재사용할 수 있습니다.
따라서 요청 순서 자체가 비용 설계입니다. 변하지 않는 정책, 참고 자료, 예시, 툴 정의는 앞에 배치하고 타임스탬프, 요청 ID, 고객 정보, 현재 작업은 뒤로 보냅니다. 앞부분의 한 줄만 수정해도 그 뒤의 캐시가 모두 무효가 될 수 있습니다.
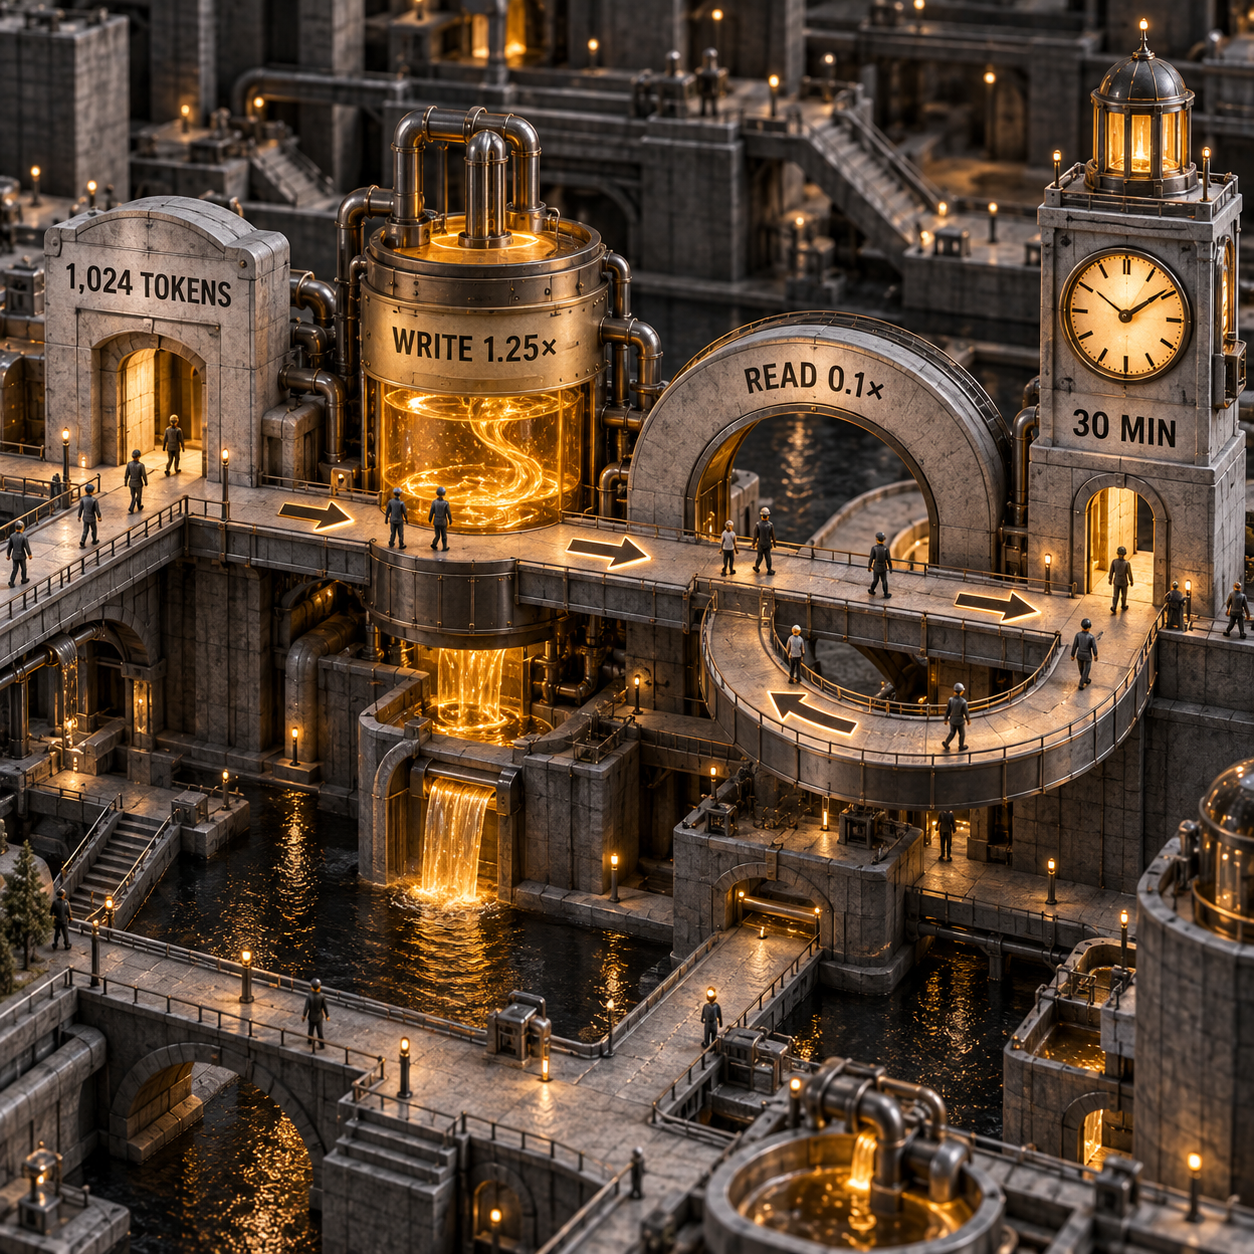
지원 모델에서는 프롬프트 캐싱이 이미 켜져 있습니다. GPT-5.6 이상에서는 눈에 보이는 입력 토큰이 1,024개에 도달해야 접두부가 캐시 대상이 됩니다. 처음 대상이 된 요청은 일반 입력 요금의 1.25배로 접두부를 쓰고, 일치하는 요청은 일반 요금의 0.1배로 읽습니다. 항목은 마지막 쓰기 또는 재사용 이후 최소 30분 동안 유효합니다.
이는 의미의 유사성을 찾는 기능이 아니라 접두부를 재사용하는 기능입니다. 뜻은 같아도 앞부분의 표현이 다른 두 정책은 서로 다른 캐시 입력입니다. 툴 이름, 설명, JSON 스키마, 순서, 모델, 출력 형식, 추론 강도, 상세 수준 가운데 하나가 바뀌어도 마찬가지입니다.
9월 22일 업데이트에서 달라진 점
이번에는 캐시 자체보다 새 운영 계층이 더 중요합니다. OpenAI의 9월 22일 업데이트에는 Prompt Caching Dashboard, 요청 비교 진단, GPT-6 대화 도중 캐시를 유지한 채 추론 강도를 바꾸는 방법이 추가됐습니다. OpenAI에 따르면 GPT-6 제품군은 기본 적중률도 개선됐습니다.
이 기능을 GPT-5.6에도 적용되는 캐시 작동 방식과 혼동하면 안 됩니다. 현재 프롬프트 캐싱 가이드는 1,024토큰 최소 기준, 1.25× 쓰기 요금, 0.1× 읽기 요금, 암시적·명시적 중단점, 30분 TTL을 GPT-5.6 이상에 적용합니다.
기존 GPT-6 Sol과 Luna 비교는 모델을 고르는 단계의 판단입니다. 캐싱은 모델을 선택한 다음에 적용합니다. 안정적인 접두부를 쓰는 저렴한 모델과 안정적인 접두부를 쓰는 고가 모델 사이의 상대적인 장단점은 그대로 유지됩니다.
자동 프롬프트 캐싱부터 시작해야 하는 이유
자동 캐싱은 프롬프트를 거의 손대지 않고도 기준선을 만들 수 있어 첫 설정으로 적합합니다. 실제 요청을 활성 시간 안에 두 번 보내고 캐시에 민감한 모든 필드를 고정한 다음, 두 번째 응답을 살펴봅니다.
과금 여부를 가르는 필드는 usage.input_tokens_details.cached_tokens와 cache_write_tokens입니다. cached_tokens가 크면 처리된 입력을 재사용했다는 뜻이고, cache_write_tokens가 크면 새 캐시 상태를 만드는 비용을 냈다는 뜻입니다. 일반 입력 토큰은 전체 입력에서 이 두 값을 뺀 수치입니다.
새 진단 흐름은 이 수치에 원인까지 붙여 줍니다.
- 같은 조직에서 최근 완료된 응답 ID를 저장합니다.
- 현재 요청의
prompt_cache_options.comparison_response_id에 그 ID를 넣습니다. - 응답의
prompt_cache_diagnostics를 확인합니다. - 과금에는 진단 추정치가 아니라 사용량 필드를 적용합니다.
Responses API를 직접 호출하면 cache_hit, cache_miss, comparison_response_not_found, unavailable이 보고될 수 있습니다. 진단 시스템이 툴 정의 변경을 식별하면 tools_changed로 분류합니다. 진단은 가능한 범위에서 제공되며 분류 가능한 첫 원인만 알려주므로, 그 원인을 고친 뒤 다시 비교해야 합니다.
아래는 Responses API를 직접 시험하는 간단한 스크립트입니다. 정책 파일에는 1,024토큰 최소 기준을 넘길 만큼 유용하고 고정적인 내용이 들어 있어야 합니다.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
최근 기준선을 사용해야 합니다. 진단 기록은 짧은 시간이 지나면 만료되며, 비교 ID는 원인 설명만 요청합니다. 이전 대화를 불러오거나 그 자체로 캐시 적중을 만들지는 않습니다.
GPT-6 프롬프트 캐시를 의도적으로 깨뜨려 본 결과
실제 테스트에는 GPT-6 Sol, 1,635단어로 만든 가상 지원 정책, 함수 툴 하나, Reply with exactly OK.라는 짧은 작업을 사용했습니다. 모델은 모든 요청에서 OK를 반환했습니다. 바뀐 것은 캐시에 민감한 구조뿐입니다.
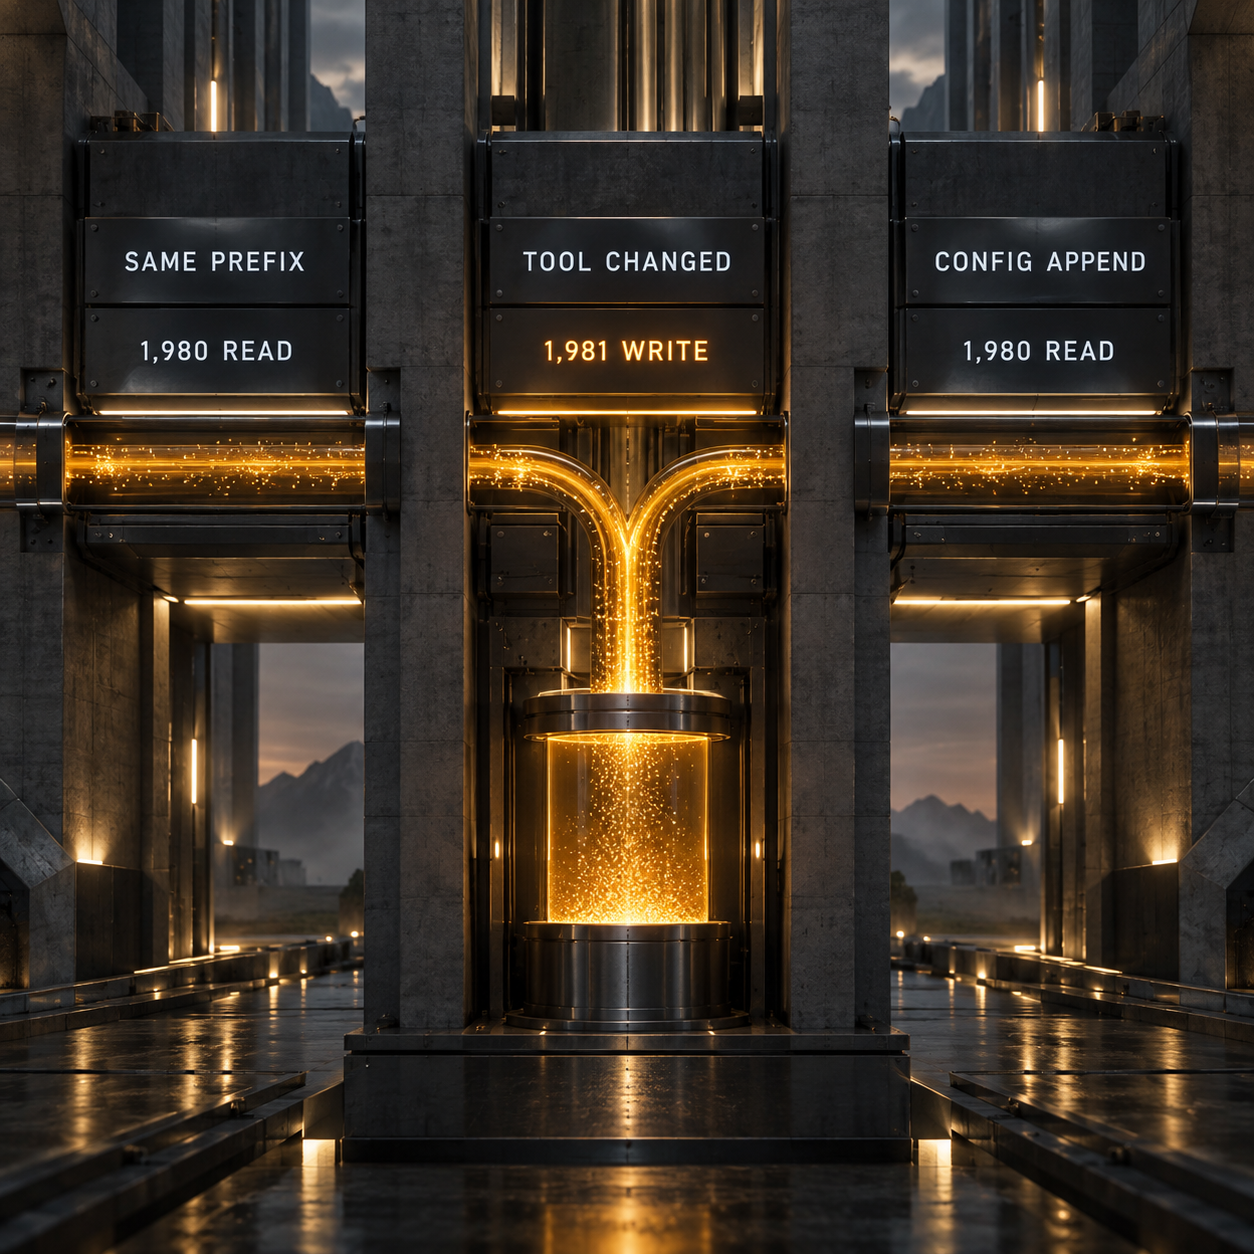
비용은 현재 GPT-6 Sol Standard 단기 컨텍스트 요금을 적용했습니다. 일반 입력 토큰 백만 개당 $2, 캐시 입력 토큰 백만 개당 $0.20, 캐시 쓰기 토큰 백만 개당 $2.50, 출력 토큰 백만 개당 $10입니다. 각 응답은 출력 토큰 다섯 개를 사용했습니다.
완전히 같은 요청의 비용은 출력을 포함한 기준선 응답보다 91.0% 낮았습니다. 같은 토큰 구조를 지닌 열 단계 에이전트라면 한 번 쓰고 아홉 번 읽을 때 약 $0.009074가 듭니다. 열 번 모두 새로 쓰면 약 $0.05006입니다. 이 가상 워크로드에서는 접두부를 고정해 완료된 단계의 비용을 81.9% 줄였습니다.
판단할 때 봐야 할 지표는 바로 이것입니다. 캐시 적중률이 좋아 보여도 일부 비싼 장문 컨텍스트 작업이 계속 다시 쓰이면 비용은 커질 수 있습니다. 완료된 작업 전체에서 실제 토큰 유형별 사용량과 비용을 합산한 뒤 승인된 결과, 재시도, 툴 비용을 함께 비교해야 합니다.
측정된 경과 시간만으로는 지연 시간에 관한 결론을 낼 수 없습니다. 네 번의 호출은 892~1,254밀리초 범위였고, 캐시를 읽은 반복 요청이 가장 빠르지도 않았습니다. 이처럼 작은 표본에서는 네트워크와 라우팅 잡음이 지배적입니다. 비용 차이는 명확하지만, 지연 시간은 반복 측정과 첫 토큰 도달 시간 데이터가 필요합니다.
통합 과정에서는 유용한 실패 사례도 하나 나왔습니다. Vercel AI Gateway는 prompt_cache_options를 전달하고 OpenAI 제공자의 응답 ID와 캐시 읽기·쓰기 사용량을 반환했지만, 정규화된 응답에서 prompt_cache_diagnostics를 누락했습니다. 그래도 캐시 토큰이 하나도 없고 쓰기 토큰이 1,981개였기 때문에 의도적인 미스는 분명했습니다. 앱과 OpenAI 사이에 SDK나 게이트웨이가 있다면, 운영에서 새 진단 필드에 의존하기 전에 해당 필드가 실제로 노출되는지 시험해야 합니다.
중단점을 추가하기 전에 접두부부터 고칩니다
대부분의 미스는 평범한 요청 구성 방식에서 생깁니다. 다음 항목을 먼저 바로잡습니다.
- 툴 이름, 설명, 스키마, 구성, 순서를 바꾸지 않습니다. 툴을 실행하면 안 될 때는
tool_choice: "none"을 쓰고, 일부만 호출 가능하게 하려면allowed_tools를 사용하되 제공하는 전체 툴 목록은 유지합니다. - 같은 접두부를 공유해야 하는 요청에서는 모델, 서비스 등급, 텍스트 스키마, 요청 수준의 추론 강도, 상세 수준을 고정합니다.
- 타임스탬프, 사용자 ID, 추적 ID, 작업별 데이터는 고정 지침과 참고 자료 뒤로 옮깁니다.
- 메시지와 툴 결과는 뒤에 추가합니다. 이전 대화 내용을 다시 쓰거나 요약하면 접두부가 달라집니다.
- 수정할 때마다 의도한 기준선과 비교합니다. 진단은 분류된 첫 차이만 보고합니다.
GPT-6에서는 최상위 설정을 바꾸는 대신 대화 항목으로 추론 강도를 변경합니다. 아래 요청은 최상위 low를 유지한 채 후속 작업에 high를 적용합니다.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
구성 업데이트는 표준 단일 에이전트 모드의 GPT-6 제품군에서 작동하며 추론 강도만 바꿉니다. 업데이트 두 개를 서로 붙여 놓으면 안 됩니다. 자동 압축 또는 자동 잘라내기와 함께 사용할 수도 없습니다.
Responses API 마이그레이션 가이드는 더 폭넓은 상태 관리 판단을 다룹니다. 캐싱의 핵심은 더 간단합니다. 기존 항목은 제자리에 보존하고 변경 사항을 뒤에 추가하면 됩니다.
효과가 분명한 곳에만 명시적 중단점을 둡니다
요청에 고정된 핵심 부분이 있고 그 뒤의 접미부가 너무 자주 바뀌어 캐시 쓰기 비용을 낼 가치가 없다면 명시적 중단점이 유용합니다. 개발자 메시지 안의 input_text 블록에 고정 지침을 넣고, 그 블록에 prompt_cache_breakpoint: {"mode":"explicit"}를 추가한 다음 prompt_cache_options.mode를 explicit로 설정합니다.
최상위 instructions에는 명시적 중단점을 넣을 수 없습니다. 명시적 모드에서 마커가 없는 요청은 캐시 쓰기를 수행하지 않습니다. 한 번만 쓸 프롬프트라면 이것이 적절할 수 있습니다. 캐시 쓰기는 일반 입력보다 25% 비싸고, 이후 요청이 읽어야만 그 비용을 회수할 수 있기 때문입니다.
요청 하나에서 캐시 쓰기를 최대 네 개까지 만들 수 있습니다. 모든 메시지에 슬롯을 쓰지 말아야 합니다. 애플리케이션이 실제로 분기하는 방식에 맞는 경계를 고릅니다. 공통 회사 정책, 워크스페이스 컨텍스트, 대화 분기, 필요하다면 고정 평가 기준표가 후보입니다.
프리워밍은 별개의 지연 시간 개선 수단입니다. prompt_cache_options.prewarm: true를 넣은 요청으로 출력을 생성하지 않고 알려진 컨텍스트를 준비한 뒤, 같은 접두부로 사용자 요청을 보냅니다. 프리워밍 호출에도 일반 캐시 쓰기 요금이 부과되므로 예측 가능한 트래픽에만 사용하고 첫 토큰 도달 시간을 측정해야 합니다.
LLM 캐싱 효과가 가장 큰 일곱 가지 워크플로
1. 코딩 에이전트 플랫폼
코딩 에이전트는 저장소 맵, 개발자 규칙, 툴 스키마, 이전 대화를 반복해서 전송합니다. 이 블록들은 고정하고 파일 변경 사항과 툴 결과를 뒤에 추가하며, 공유 기록에서 백그라운드 작업을 분기합니다. 긴 세션의 컨텍스트 비용을 낮출 수 있습니다. 툴 이름 하나만 바꿔도 절감 효과가 사라질 수 있어, 이 유형은 CI에 캐시 회귀 테스트를 넣었을 때 특히 큰 효과를 봅니다.
2. 고객 지원 에이전트
지원 조직에는 긴 정책 매뉴얼, 제품 카탈로그 규칙, 고정된 에스컬레이션 툴이 있을 수 있습니다. 이 공통 자료를 앞에 두고 현재 티켓은 뒤에 추가합니다. 앞서 측정한 가상 정책이 바로 이 패턴입니다. 요청 구조가 같을 때, 짧은 응답 열 번을 모두 새로 쓰면 약 $0.05006였지만 한 번 쓰고 아홉 번 읽자 완료 비용이 $0.009074로 낮아졌습니다.
3. 평가 및 품질 팀
평가자는 채점 기준표, 라벨이 있는 예시, 출력 스키마, 툴 정의를 재사용하고 평가할 상호작용만 끝부분에서 바꿀 수 있습니다. 명시적 모드를 사용하면 계속 바뀌는 평가 대상에 쓰기 요금이 붙는 것을 막을 수 있습니다. 이렇게 캐시는 보이지 않는 플랫폼 세부 기능이 아니라 평가의 단위 경제성을 구성하는 요소가 됩니다.
4. 리서치 및 실사 에이전트
리서치 워크플로는 검증된 자료 묶음과 분석 규칙을 고정한 채 새 질문을 뒤에 추가할 수 있습니다. 요약 분기, 모순 검사, 메모의 각 섹션이 같은 접두부를 공유합니다. 여러 작업자가 동일한 근거에서 출발해 서로 다른 결과물을 만들 때 이점이 커집니다.
5. 계약 및 컴플라이언스 검토
법무 운영팀은 조항 라이브러리, 위험 평가표, 승인 문구, 검토 툴을 검토 대상 계약서보다 앞에 둘 수 있습니다. 새 문서가 매번 바뀌는 접미부가 됩니다. 캐시가 판단 자체를 더 안전하게 만들지는 않지만, 동일한 통제 자료를 반복해서 불러오는 비용은 줄일 수 있습니다.
6. 멀티 에이전트 운영
오케스트레이터는 전문 에이전트로 분기하기 전에 공통 계획, 워크스페이스 상태, 툴 기록을 보존할 수 있습니다. 공유 접두부가 클수록 캐시 재사용으로 분기 비용이 낮아집니다. 툴 정의는 고정하고, 애플리케이션이 지원한다면 새로 발견한 툴은 기록 뒤에 추가합니다.
7. 예측 가능한 인터랙티브 출시
참고 자료가 정해진 제품은 첫 사용자 요청이 오기 전 시작 과정에서 프리워밍할 수 있습니다. 접두부 처리 시간을 사용자의 대기 시간 밖으로 옮기는 방식입니다. 항목이 만료되기 전에 트래픽이 들어오고, 반복 시험에서도 지연 시간 개선이 확인될 때만 유용합니다.
구축할 가치가 있는 세 가지 제품
1. 가장 유망한 Cache Regression CI
대표적인 에이전트 요청을 재실행하고, 각 응답을 저장된 기준선과 비교하며, 캐시 토큰이 줄거나 캐시 쓰기가 급증하면 풀 리퀘스트를 실패 처리하는 테스트 게이트를 만듭니다. 별것 아닌 툴 스키마 수정 하나가 모든 운영 요청을 새 쓰기로 바꿀 수 있기 때문에 에이전트 플랫폼 팀이 비용을 지불할 이유가 있습니다.
수요는 공략할 만큼 작으면서도 무시하기 어려울 만큼 큽니다. 미국에서 prompt caching은 월 약 1,300회, openai prompt caching은 320회 검색되며, 정확한 GPT-6 설정 질의에서는 독립적으로 작성된 가이드가 두 개뿐이었습니다. Helicone은 알림과 보고서가 포함된 Pro 플랜을 월 $79에 이미 판매하고 있어, 팀이 LLM 모니터링에 예산을 배정한다는 점도 확인됩니다.
판매 가능한 최소 버전은 CLI, GitHub 검사, 그리고 기준선 응답 ID, 진단 원인, 캐시 토큰, 쓰기 토큰, 경과 시간, 계산 비용을 담은 보고서 하나입니다. 변수는 OpenAI가 자체 대시보드와 진단 기능을 제공한다는 점입니다. 비용을 받을 만하려면 배포 게이트, 여러 제공자를 아우르는 지원, 코드 수준의 원인 추적 중 하나가 필요합니다.
2. 캐시를 반영하는 비용 배분기
일반 입력, 캐시 읽기, 캐시 쓰기, 출력, 툴 비용을 구분하는 고객별 AI 제품 원장을 만듭니다. 여러 고객이 공통 에이전트 접두부를 사용하면서도 제품이 워크스페이스별 마진을 명확히 산출해야 할 때 재무팀과 플랫폼팀이 비용을 지불합니다.
미국에서 openai api prompt caching을 찾는 검색은 월 약 50회이며, 실시간 People Also Ask에는 “Should I use prompt caching?”과 “When not to use caching?”이 포함돼 있습니다. Langfuse의 프로덕션 클라우드 플랜은 월 $29와 $199로 책정돼 있어, 토큰 및 비용 추적 소프트웨어에 이미 예산이 있다는 또 다른 근거가 됩니다.
MVP는 SDK 래퍼, 가격표, 테넌트 태그, 완료된 작업 보기로 구성합니다. 현실적인 난점은 비용 귀속입니다. GPT-5.6 이상은 라우팅에 prompt_cache_key가 필요하지 않고, 별도 키는 주로 회계 처리에 쓰입니다. 테넌트 경계를 잘못 설정하면 청구 내역이 혼란스러워지거나 개인정보 보호 우려가 생길 수 있습니다.
3. 어댑터 적합성 모니터
SDK, 프록시, 모델 게이트웨이가 새 Responses 필드를 전달하고 손상 없이 반환하는지 확인하는 테스트 스위트를 만듭니다. 의존성을 업그레이드할 때마다 comparison_response_id, 진단 유형, 캐시 토큰 상세, 구성 업데이트, 명시적 중단점, 제공자 응답 ID를 검사합니다.
수요 신호는 학습 격차에서 드러납니다. 미국에서 what is prompt caching은 월 약 480회, how does prompt caching work은 140회 검색되며, 실시간 People Also Ask에는 “How do I turn on prompt caching?”이 나타납니다. 앞선 실제 실행에서도 구체적인 실패를 확인했습니다. 게이트웨이는 사용량을 보존했지만 진단 객체는 누락했습니다.
MVP는 호스팅 호환성 표와 고객 엔드포인트에 가상 요청 다섯 개를 실행하는 명령입니다. 관건은 지속성입니다. 게이트웨이 제공자들이 필드를 추가할 것이므로, 일회성 GPT-6 검사기가 아니라 여러 제공자의 프로토콜을 계속 시험해야 합니다.
한계와 솔직한 결론
긴 접두부가 반복될 때는 프롬프트 캐싱을 고려할 가치가 있습니다. 요청이 짧거나 매번 다르거나 앞부분이 계속 다시 작성된다면 좋은 최적화 대상이 아닙니다.
1,024토큰이라는 최저 기준은 중요합니다. 캐시 대상이 되려고 짧은 프롬프트를 억지로 늘리면 비용이 오를 수 있습니다. 유용하고 고정적인 예시나 참고 자료라면 추가 토큰이 정당화될 수 있지만, 판단 기준은 캐시 적중 자체가 아니라 재사용 횟수와 품질입니다.
캐시 상태는 물리적인 제약도 받습니다. 항목은 개별 머신에 저장되며, 트래픽이 분당 약 15개 요청을 넘으면 다른 머신으로 넘어갈 수 있습니다. 애플리케이션의 내용이 같아 보여도 라우팅과 부하 때문에 미스가 날 수 있습니다. 캐시 적중은 최적화의 결과이지 정확성을 보장하는 조건이 아닙니다.
캐시된 입력도 분당 토큰 한도에 포함됩니다. 캐시는 수동으로 지울 수 없습니다. 재사용은 출력 생성을 바꾸지 않으므로 같은 요청도 서로 다른 답을 낼 수 있습니다. GPT-6 Sol에서는 입력 토큰이 272,000개를 넘는 요청에 더 높은 장문 컨텍스트 요금이 전체 요청에 적용됩니다.
가장 중요한 운영 원칙은 단순합니다. 승인된 작업당 비용을 추적하고 접두부를 고정하며, 쓰기 급증이 생길 때마다 원인을 밝혀야 할 사고로 취급합니다.
다음 월요일에 바로 할 일
다음 월요일에 운영 중인 에이전트 엔드포인트 하나를 고릅니다. 대표 응답 ID를 저장하고, 완료된 동일 작업을 다시 실행한 뒤 캐시 토큰, 쓰기 토큰, 경과 시간, 출력 토큰, 총비용을 기록합니다. 그런 다음 툴 설명이나 이름 하나를 바꾸고 같은 기준선과 비교한 뒤, 툴 목록을 복원해 다시 실행합니다. 복원한 요청이 승인 결과를 해치지 않으면서 완료 작업 비용을 낮춘다면, 프롬프트를 수정하거나 중단점을 추가하기 전에 그 테스트를 그대로 CI에 넣습니다.
자주 묻는 질문
OpenAI 프롬프트 캐싱은 어떻게 켜나요?
대부분은 따로 켤 필요가 없습니다. 지원되는 OpenAI 모델에서는 프롬프트 캐싱이 기본으로 활성화돼 있습니다. GPT-5.6 이상 요청의 시작 부분에서 눈에 보이는 토큰을 최소 1,024개 이상 고정하고, 활성 시간 안에 일치하는 요청을 보낸 뒤 cached_tokens를 확인합니다. 중단점을 직접 제어해야 할 때만 prompt_cache_options.mode를 사용합니다.
프롬프트 캐싱이란 무엇이며 어떻게 작동하나요?
정확히 일치하는 프롬프트 접두부에 대해 모델이 처리한 키-값 상태를 저장합니다. 처음 대상이 된 요청이 이 상태를 쓰고, 이후 일치하는 요청은 같은 접두부를 다시 처리하는 대신 저장된 상태를 읽을 수 있습니다. 새 접미부 내용과 출력 생성에는 여전히 연산이 필요합니다.
캐싱을 사용하지 말아야 할 때는 언제인가요?
프롬프트가 최소 기준보다 짧거나, 거의 반복되지 않거나, 앞부분이 바뀌거나, 다음 요청 전에 캐시가 만료된다면 최적화 대상으로 삼지 않습니다. 명시적 모드에서는 중단점을 생략해 재사용할 가능성이 없는 접두부에 1.25× 쓰기 요금을 내지 않을 수 있습니다.
프롬프트 캐싱을 사용해야 하나요?
반복 입력이 완료된 작업 비용에서 의미 있는 비중을 차지한다면 사용합니다. 실제 툴과 승인 검사를 적용해 쓰기 한 번과 여러 번의 읽기를 측정합니다. 적중률이 높더라도 승인된 작업당 총비용이 낮아져야 의미가 있습니다.
가장 좋은 캐싱 전략은 무엇인가요?
자동 암시적 캐싱부터 시작합니다. 고정 콘텐츠를 앞에 놓고 변경 콘텐츠는 뒤에 추가하며, 툴과 요청 설정을 고정하고 미스 원인을 진단합니다. 자주 바뀌는 접미부 때문에 불필요한 쓰기가 생기는 고정 블록에만 명시적 중단점을 더합니다.
에이전트 스택에 이 측정 및 회귀 게이트를 구축하고 싶다면 AI 프로덕션 시스템이 적합한 출발점입니다.
- 마지막 업데이트
- 2026년 9월 27일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.
Copilot Studio 가격으로 보는 Managed Runtime 비용 구조
Copilot Studio 가격과 Copilot Managed Runtime의 크레딧 과금 구조를 한눈에 정리합니다. 앱 제작, 실행, API 호출, 호스팅, AI 서비스, 라이선스 비용을 분리해 실제 예산과 손익분기점을 계산하는 방법을 지금 확인하세요.2026년 9월 26일Build
n8n 자동화, 에이전트와 워크플로우 중 무엇을 쓸까
n8n 자동화에서 에이전트와 워크플로우 중 무엇을 선택해야 할까요? 30턴 지원 테스트의 실행 수, 모델 호출, 세션, 승인 흐름과 Preview 제약을 비교해 고정 절차와 대화형 판단을 나누는 실무 설계 기준, 요금 계산, 안전한 전환 원칙까지 정리합니다.2026년 9월 26일Build
OpenRouter 가격: Jev Router는 정말 무료일까?
OpenRouter 가격표에는 Jev Router가 $0로 표시됩니다. 하지만 선택된 모델과 추론 비용까지 정말 무료일까요? 응답의 usage.cost와 생성 기록, 캐시·툴 비용을 대조해 실제 세션 비용을 확인하는 방법과 도입 전 4개 요청 검증 절차를 정리했습니다.2026년 9월 26일Build
Claude 플러그인 게시 실전 가이드: 디렉터리 등록까지
Claude 플러그인을 GitHub 저장소에서 공식 디렉터리에 게시하는 전 과정을 안내합니다. 번들 준비와 로컬 검증부터 조직 소유권, MCP 커넥터 분리 등록, 데이터 처리·컴플라이언스 설정, 심사 상태, 업데이트 방식과 비용까지 출시 전에 필요한 실무 기준을 확인하세요.2026년 9월 26일Build
Cloudflare MCP 서버 포털은 무료일까? 요금과 한계 정리
Cloudflare MCP 서버 포털의 무료 플랜 한도와 유료 좌석 비용을 확인합니다. 팀 에이전트를 연결하기 전에 사용자 50명 제한, 로그 보존 범위, 모델·업스트림 SaaS·서버 호스팅의 별도 비용과 보안 요건까지 한눈에 비교해 실제 월 예산과 도입 조건을 판단하세요.2026년 9월 26일Build
Agentic CUDA Optimizer로 GPU 최적화하는 방법
Agentic CUDA Optimizer로 GPU 최적화를 안전하게 실험하는 방법을 알아봅니다. v0.0 커밋 고정, Windows 환경 설정, 7회 탐색, 정확성 검증, GPU 시간과 모델 비용 기록, best.cu 독립 재실행, 실제 워크로드의 비용 회수 판단까지 정리했습니다.2026년 9월 25일Build
Runpod 가격 총정리: Pod와 Serverless, 비용은 언제 갈릴까?
Runpod 가격을 H100 Pod, Serverless, 스토리지까지 실제 수치로 비교합니다. 100시간·730시간·요청별 비용과 60.33% 손익분기점, Secure Cloud와 Community Cloud의 차이를 살펴보고 워크로드별 최적의 선택을 확인하세요.2026년 9월 25일Build