Кэширование промптов GPT-6: как находить промахи кэша и снижать расходы
Разбираем кэширование промптов GPT-6: как сохранить стабильный префикс, найти промахи кэша и снизить стоимость запросов по реальным замерам.



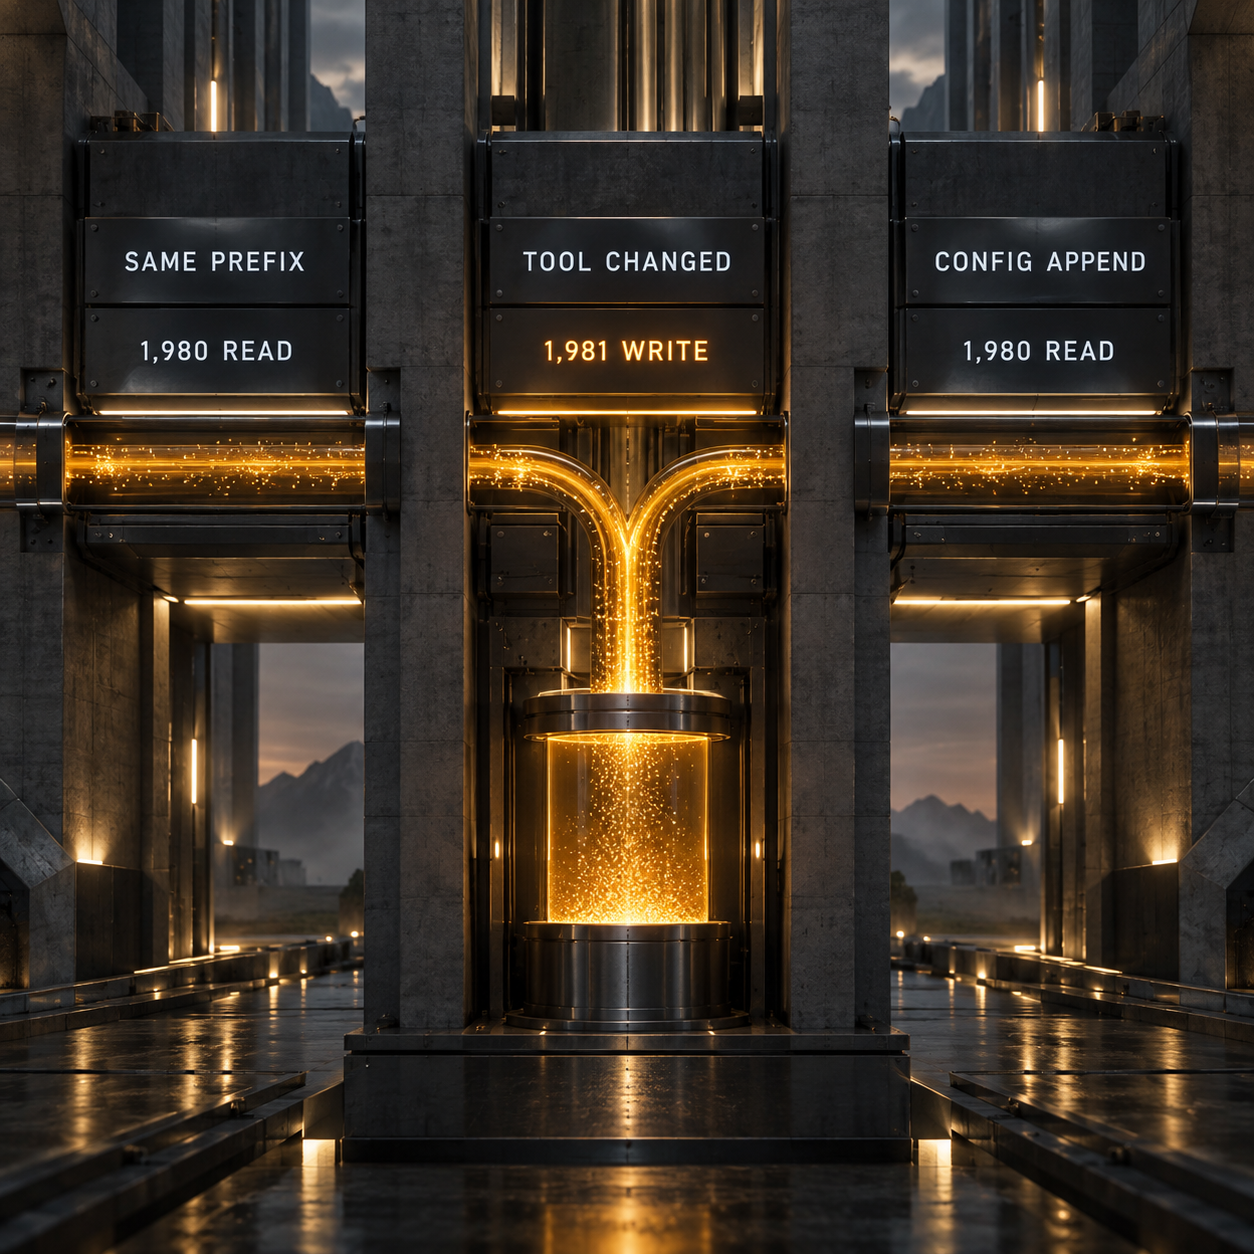
Кэширование промптов снижает расходы на агента GPT-6, если повторяющиеся инструкции, инструменты и контекст остаются без изменений в начале каждого запроса. В реальном запуске GPT-6 Sol точный повтор использовал 1,980 токенов из кэша и обошёлся в $0.000452. Достаточно было изменить имя одного инструмента — префикс записался заново, а стоимость выросла до $0.0050085. Панель мониторинга и диагностика от 22 сентября позволяют заметить эту разницу до того, как она превратится в производственный счёт.
Кэширование промптов: стабильное — в начало, меняющееся — в конец
Кэширование промптов сохраняет обработанное состояние модели для неизменного префикса — содержимого в начале запроса. Представьте мастерскую, которую не стали разбирать на ночь. Регламент, стойка с инструментами и наполовину собранное изделие остаются на месте, поэтому следующая смена продолжает работу, а не обустраивает мастерскую заново.
OpenAI хранит тензоры ключей и значений — рабочее состояние модели, — а не копию промпта. Кэш охватывает весь сформированный контекст: инструкции OpenAI, сообщения разработчика, определения инструментов и историю диалога. Следующий запрос может повторно использовать эту работу лишь до первого существенного отличия в сформированном префиксе.
Поэтому порядок частей запроса напрямую влияет на стоимость. Сначала размещайте стабильные правила, справочные материалы, примеры и определения инструментов. Временные метки, идентификаторы запросов, данные клиента и текущую задачу переносите ближе к концу. Если изменить строку в начале, всё после неё может перестать попадать в кэш.
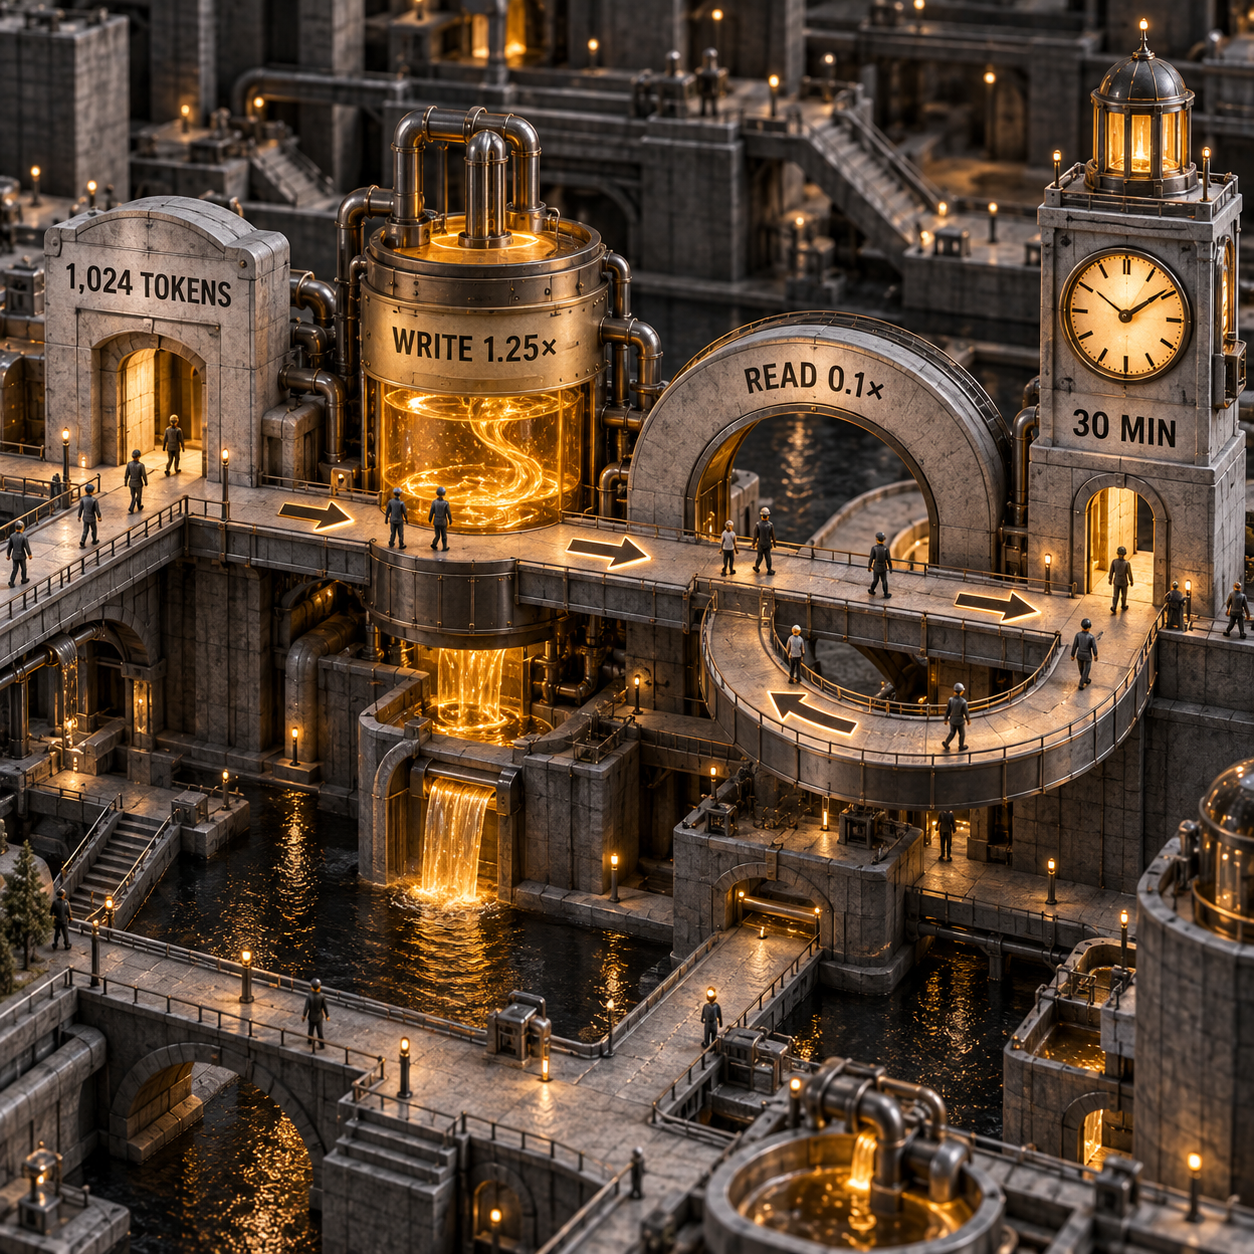
Для поддерживаемых моделей кэширование промптов уже включено. В GPT-5.6 и более новых моделях префикс становится пригодным для кэширования с 1,024 видимых входных токенов. Первый подходящий запрос записывает префикс по ставке, равной 1.25 обычной ставки за входные токены. Совпавший запрос читает его по ставке, равной 0.1 обычной ставки. Запись остаётся доступной не менее 30 минут после последней записи или повторного использования.
Речь идёт о повторном использовании префикса, а не о смысловом сходстве. Два регламента с одинаковым смыслом, но разным текстом в начале дают разные входные данные для кэша. То же происходит при изменении имени или описания инструмента, JSON-схемы, порядка, модели, формата вывода, настройки рассуждения или уровня подробности.
Что изменилось 22 сентября
Новые средства контроля важнее самого механизма кэширования. В релизе от 22 сентября OpenAI представила панель Prompt Caching Dashboard, диагностику для сравнения запросов и способ менять интенсивность рассуждения в диалоге с GPT-6 без сброса кэша. По данным OpenAI, у семейства GPT-6 также выросла доля попаданий в кэш по умолчанию.
Не стоит смешивать эти нововведения с механизмами, которые работают и в GPT-5.6. Актуальное руководство по кэшированию промптов относит минимум в 1,024 токена, ставку записи 1.25×, ставку чтения 0.1×, неявные и явные точки останова и TTL в 30 минут к GPT-5.6 и более новым моделям.
В отдельной статье уже есть сравнение GPT-6 Sol и Luna, которое помогает выбрать модель. Кэширование имеет смысл настраивать после этого выбора. Для дешёвой и дорогой модели стабильные префиксы не меняют исходного соотношения возможностей и цены.
Сначала настройте автоматическое кэширование
Автоматическое кэширование — правильная отправная точка: оно даёт чистую базовую линию почти без переделки промптов. Отправьте реальный запрос дважды в пределах активного окна, не меняйте ни одно чувствительное к кэшу поле и проверьте второй ответ.
Для расчёта стоимости нужны два поля: usage.input_tokens_details.cached_tokens и cache_write_tokens. Большое значение cached_tokens означает, что запрос повторно использовал уже обработанный ввод. Большое значение cache_write_tokens показывает, что пришлось оплатить создание нового состояния кэша. Обычные входные токены — это общее число входных токенов за вычетом этих двух величин.
Новая схема диагностики объясняет причину, которая стоит за этими числами:
- Сохраните идентификатор недавнего завершённого ответа из той же организации.
- Передайте его в
prompt_cache_options.comparison_response_idтекущего запроса. - Прочитайте
prompt_cache_diagnosticsв ответе. - Для расчёта стоимости используйте поля usage, а не диагностические оценки.
Прямой вызов Responses API может вернуть cache_hit, cache_miss, comparison_response_not_found или unavailable. Если диагностическая система распознает изменение определения инструмента, причина будет классифицирована как tools_changed. Диагностика работает по принципу best effort и сообщает первую распознанную причину, поэтому исправьте её и повторите сравнение.
Ниже — компактный тест для прямого обращения к API. Файл с регламентом должен содержать достаточно полезного стабильного текста, чтобы преодолеть минимум в 1,024 токена.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
Используйте свежую базовую линию. Диагностические записи хранятся недолго, а идентификатор для сравнения лишь запрашивает объяснение. Сам по себе он не загружает предыдущий диалог и не создаёт попадание в кэш.
Как намеренно сломать попадание в кэш
В реальном тесте использовались GPT-6 Sol, искусственный регламент службы поддержки объёмом 1,635 слов, один функциональный инструмент и короткая задача Reply with exactly OK. На каждый запрос модель отвечала OK. Менялась только чувствительная к кэшу структура.
Расчёт основан на текущих тарифах GPT-6 Sol Standard для короткого контекста: $2 за миллион обычных входных токенов, $0.20 за миллион кэшированных входных токенов, $2.50 за миллион токенов записи в кэш и $10 за миллион выходных токенов. Каждый ответ содержал пять выходных токенов.
С учётом вывода точный повтор стоил на 91.0% меньше первого ответа. Для агента из десяти шагов с тем же распределением токенов одна запись и девять чтений обойдутся примерно в $0.009074. Десять новых записей будут стоить около $0.05006. В этой искусственной нагрузке стабильный префикс снижает стоимость завершённого шага на 81.9%.
Именно эту метрику стоит использовать при принятии решения. Доля попаданий в кэш может выглядеть хорошо, даже если несколько дорогих запросов с длинным контекстом постоянно перезаписывают данные. Суммируйте стоимость реальных классов токенов по завершённым задачам, а затем сопоставляйте успешно принятые результаты, повторные попытки и расходы на инструменты.
По этим замерам нельзя делать вывод о задержке. Четыре вызова заняли от 892 до 1,254 миллисекунд, причём повтор с чтением из кэша не оказался самым быстрым. Для столь маленькой выборки важнее сетевой шум и маршрутизация. Изменение стоимости видно отчётливо, а для оценки задержки нужны повторные измерения и данные о времени до первого токена.
Тест выявил и одну важную проблему интеграции. Vercel AI Gateway передал prompt_cache_options, вернул идентификатор ответа провайдера OpenAI и сообщил о чтении и записи кэша, но исключил prompt_cache_diagnostics из нормализованного ответа. Намеренный промах всё равно был заметен по нулю кэшированных токенов и 1,981 токену записи. Если между приложением и OpenAI стоит SDK или шлюз, заранее проверьте, что новое диагностическое поле доходит до вашего производственного кода.
Сначала исправьте префикс, потом добавляйте точки останова
Большинство промахов вызвано обычной сборкой запроса. Сначала устраните эти причины:
- Не меняйте имена, описания, схемы, конфигурацию и порядок инструментов. Если инструмент не должен запускаться, используйте
tool_choice: "none"; если доступно лишь подмножество, используйтеallowed_tools, но передавайте полный список инструментов. - Сохраняйте модель, уровень обслуживания, текстовую схему, интенсивность рассуждения на уровне запроса и подробность ответа неизменными для запросов с общим префиксом.
- Перенесите временные метки, идентификаторы пользователей и трассировки, а также данные конкретной задачи ниже стабильных инструкций и справочных материалов.
- Добавляйте сообщения и результаты инструментов в конец. Перезапись или суммаризация ранней части диалога меняет префикс.
- После каждого исправления сверяйтесь с нужной базовой линией. Диагностика сообщает только первое классифицированное отличие.
В GPT-6 меняйте интенсивность с помощью элемента диалога, а не параметра верхнего уровня. В запросе ниже на верхнем уровне сохраняется low, а к уточнению применяется high.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
Обновления конфигурации работают для семейства GPT-6 в стандартном одноагентном режиме и меняют только интенсивность рассуждения. Не размещайте два обновления подряд. Кроме того, их нельзя сочетать с автоматическим сжатием контекста или автоматическим усечением.
В руководстве по переходу на Responses API подробно разобран выбор способа управления состоянием. Для кэширования вывод проще: не меняйте старые элементы, а добавляйте новое в конец.
Когда окупаются явные точки останова
Явная точка останова полезна, если за стабильным ядром запроса идёт суффикс, который меняется слишком часто и не заслуживает платной записи в кэш. Поместите стабильные инструкции в блок input_text внутри сообщения разработчика, добавьте в этот блок prompt_cache_breakpoint: {"mode":"explicit"}, а для prompt_cache_options.mode задайте explicit.
В instructions верхнего уровня нельзя разместить явную точку останова. В явном режиме запрос без такого маркера ничего не записывает в кэш. Для одноразового промпта это может быть правильным решением: запись в кэш стоит на 25% дороже обычного ввода и окупается только тогда, когда следующий запрос её прочитает.
Один запрос может создать до четырёх записей в кэш. Не тратьте эти слоты на каждое сообщение. Выбирайте границы по реальным ветвлениям приложения: общий регламент компании, контекст рабочего пространства, развилка диалога и, возможно, стабильная оценочная рубрика.
Предварительный прогрев — отдельный инструмент для снижения задержки. Запрос с prompt_cache_options.prewarm: true подготавливает известный контекст, не генерируя вывод, после чего пользовательский запрос отправляет тот же префикс. Прогрев оплачивается по обычной ставке записи в кэш, поэтому применяйте его только при предсказуемом трафике и измеряйте время до первого токена.
Семь сценариев с наибольшей отдачей
1. Платформы с агентами для разработки
Агент-разработчик снова и снова передаёт карты репозитория, правила разработчика, схемы инструментов и предыдущие реплики. Сохраняйте эти блоки неизменными, добавляйте изменения файлов и результаты инструментов в конец, а фоновые задачи создавайте из общей истории. Так стоимость контекста в длинных сессиях снижается. Одного переименованного инструмента достаточно, чтобы лишиться экономии, поэтому именно таким платформам особенно полезен тест на регрессию кэша в CI.
2. Агенты клиентской поддержки
У службы поддержки может быть объёмный регламент, правила каталога продуктов и фиксированные инструменты эскалации. Размещайте общие материалы в начале, а текущую заявку — после них. Именно этот сценарий имитирует измеренный искусственный регламент. При той же структуре запроса десять завершённых коротких ответов подешевели примерно с $0.05006 при повторных записях до $0.009074 при одной записи и девяти чтениях.
3. Команды оценки и контроля качества
Система оценки может повторно использовать оценочную рубрику, размеченные примеры, схему вывода и определения инструментов, меняя в конце только проверяемое взаимодействие. Явный режим позволяет не платить за запись меняющегося проверяемого примера. Так кэш становится частью экономики оценки, а не невидимой деталью платформы.
4. Агенты для исследований и комплексной проверки
Исследовательский процесс может сохранять проверенный набор источников и правила анализа, добавляя в конец новые вопросы. Ответвлённые сводки, проверки противоречий и разделы записки способны использовать общий префикс. Выгода растёт, когда несколько исполнителей начинают с одной доказательной базы, но готовят разные результаты.
5. Проверка договоров и соответствия требованиям
Юридическая команда может поставить перед проверяемым договором свою библиотеку положений, матрицу рисков, утверждённые формулировки и инструменты проверки. Тогда каждый новый документ становится меняющимся суффиксом. Кэш не делает само решение безопаснее, но сокращает повторные расходы на загрузку одних и тех же правил контроля.
6. Мультиагентные процессы
Оркестратор может сохранить общий план, состояние рабочего пространства и историю инструментов, а затем разветвить работу между профильными агентами. Повторное использование кэша удешевляет такие ответвления, если общий префикс велик. Не меняйте определения инструментов, а вновь обнаруженные инструменты добавляйте только в конец истории, если приложение это поддерживает.
7. Предсказуемые интерактивные запуски
Продукт с заранее известными справочными материалами может выполнить прогрев при запуске до первого пользовательского запроса. Тогда пользователю не придётся ждать обработки префикса. Это полезно лишь в том случае, если трафик приходит достаточно быстро для повторного использования записи, а выигрыш в задержке подтверждается полноценным повторным тестом.
Три продукта, которые стоит создать
1. Cache Regression CI — самая перспективная идея
Создайте проверку, которая воспроизводит типовые запросы агента, сравнивает каждый ответ с сохранённой базовой линией и блокирует pull request, если число кэшированных токенов падает или объём записи резко растёт. Команды агентных платформ готовы платить за это, потому что безобидная правка схемы инструмента способна превратить каждый производственный запрос в новую запись.
Рынок достаточно узкий для точечного продукта, но достаточно заметный: prompt caching получает около 1,300 поисковых запросов в США в месяц, openai prompt caching — 320, а по точному запросу о настройке GPT-6 нашлось лишь два независимых текстовых руководства. У Helicone уже есть тариф Pro за $79 в месяц с оповещениями и отчётами — значит, команды закладывают мониторинг LLM в бюджет.
Минимальная версия, которую можно продавать, — это CLI, проверка GitHub и один отчёт с идентификатором базового ответа, диагностической причиной, числом кэшированных токенов и токенов записи, временем выполнения и рассчитанной стоимостью. Но есть ограничение: OpenAI уже предлагает собственную панель и диагностику. Чтобы оправдать своё место в стеке, продукту нужны проверка при развёртывании, поддержка разных провайдеров или привязка проблемы к конкретному коду.
2. Cache-Aware Cost Allocator
Создайте реестр расходов по клиентам для ИИ-продуктов, который разделяет обычный ввод, чтение и запись кэша, вывод и плату за инструменты. Финансовым и платформенным командам это нужно, когда один префикс агента обслуживает многих клиентов, но продукту всё равно требуется обоснованная маржинальность по рабочим пространствам.
Около 50 поисковых запросов в США в месяц приходится на openai api prompt caching, а в актуальном блоке People Also Ask есть вопросы “Should I use prompt caching?” и “When not to use caching?” Langfuse предлагает облачные производственные тарифы за $29 и $199 в месяц — ещё один признак того, что компании уже готовы платить за учёт токенов и расходов.
MVP включает обёртку SDK, таблицу тарифов, теги арендаторов и представление по завершённым задачам. Главная сложность — атрибуция. В GPT-5.6 и более новых моделях prompt_cache_key больше не нужен для маршрутизации, а отдельные ключи существуют в основном для учёта. Нечёткие границы между арендаторами могут запутать счета или создать риски для конфиденциальности.
3. Adapter Conformance Monitor
Создайте набор тестов, который проверяет, передаёт ли SDK, прокси или модельный шлюз новые поля Responses и возвращает ли их без изменений. После каждого обновления зависимостей он должен проверять comparison_response_id, типы диагностики, сведения о токенах кэша, обновления конфигурации, явные точки останова и идентификаторы ответов провайдера.
На пробел в знаниях указывает поисковый спрос: what is prompt caching получает около 480 запросов в США в месяц, how does prompt caching work — 140, а вопрос “How do I turn on prompt caching?” появляется в актуальных результатах People Also Ask. Практический тест также выявил конкретный сбой: шлюз сохранил данные usage, но исключил объект диагностики.
MVP — это онлайн-матрица совместимости и команда, которая выполняет пять искусственных запросов к клиентской конечной точке. Главная сложность — сохранить ценность продукта со временем. Поставщики шлюзов будут добавлять поля, поэтому сервису нужно постоянно тестировать протоколы разных провайдеров, а не ограничиваться одноразовой проверкой GPT-6.
Ограничения и честный вывод
Кэширование промптов стоит учитывать в архитектуре, когда длинный префикс повторяется. Если запросы короткие, уникальные или постоянно переписываются в начале, оптимизировать кэш бессмысленно.
Порог в 1,024 токена имеет значение. Искусственно раздувая короткий промпт лишь ради соответствия порогу, можно повысить расходы. Полезные стабильные примеры или справочные материалы иногда оправдывают дополнительные токены, но решение зависит от частоты повторного использования и качества, а не от желания увидеть попадание в кэш.
Состояние кэша привязано к инфраструктуре. Записи находятся на отдельных машинах, а при трафике выше примерно 15 запросов в минуту нагрузка может перейти на другие машины. Из-за маршрутизации и нагрузки случаются промахи, даже если содержимое приложения выглядит стабильным. Попадание в кэш — результат оптимизации, а не гарантия корректности.
Кэшированный ввод по-прежнему учитывается в лимитах токенов в минуту. Очистить кэш вручную нельзя. Повторное использование не меняет генерацию вывода, поэтому одинаковые запросы всё равно могут дать разные ответы. Для GPT-6 Sol запрос объёмом свыше 272,000 входных токенов также целиком переводится на более высокие тарифы длинного контекста.
Главное практическое правило просто: отслеживайте стоимость каждой задачи с принятым результатом, сохраняйте префикс стабильным и относитесь к каждому скачку записи как к инциденту, который нужно объяснить.
Что сделать в понедельник
В следующий понедельник выберите одну производственную конечную точку агента. Сохраните идентификатор типового ответа, повторите ту же завершённую задачу и запишите число кэшированных токенов и токенов записи, время выполнения, выходные токены и общую стоимость. Затем измените описание или имя одного инструмента, сравните результат с той же базовой линией, восстановите список инструментов и запустите тест ещё раз. Если после восстановления стоимость завершённой задачи снизилась без ухудшения приёмки, добавьте именно этот тест в CI до изменения промптов или точек останова.
Частые вопросы
Как включить кэширование промптов?
Обычно включать его не требуется. Кэширование промптов по умолчанию работает для поддерживаемых моделей OpenAI. Сохраняйте в начале запроса GPT-5.6 или более новой модели не менее 1,024 видимых токенов без изменений, отправьте совпадающий запрос в пределах активного окна и проверьте cached_tokens. Используйте prompt_cache_options.mode, только если нужно вручную управлять точками останова.
Что такое кэширование промптов и как оно работает?
Оно сохраняет обработанное состояние ключей и значений модели для точного префикса промпта. Первый подходящий запрос записывает это состояние, а следующие совпадающие запросы могут прочитать его, не обрабатывая тот же префикс заново. Новый суффикс и генерация вывода всё равно требуют вычислений.
Когда кэширование не нужно?
Не оптимизируйте его, если промпты не достигают минимальной длины, редко повторяются, меняются в начале или успевают истечь до следующего запроса. В явном режиме отсутствие точки останова позволяет не платить ставку записи 1.25× за префикс, который вы не собираетесь использовать повторно.
Стоит ли использовать кэширование промптов?
Используйте его, если повторяющийся ввод составляет заметную долю стоимости завершённой задачи. Измерьте одну запись и несколько чтений с вашими реальными инструментами и проверками приёмки. Высокая доля попаданий полезна только тогда, когда снижается общая стоимость принятой задачи.
Какая стратегия кэширования лучше?
Начните с автоматического неявного кэширования. Размещайте стабильное содержимое в начале, добавляйте меняющееся в конец, не меняйте инструменты и параметры запроса и диагностируйте промахи. Явные точки останова добавляйте только вокруг стабильных блоков, которые будут использованы достаточно часто, чтобы окупить запись.
Если вам нужна такая система измерений и защиты от регрессий в стеке агентов, лучше всего начать с производственных ИИ-систем.
- Последнее обновление
- 27 сент. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.
Цена Copilot Managed Runtime: кредиты и скрытые расходы
Цена Copilot Managed Runtime по статьям: вызовы API, запуск, хостинг, Copilot Credits и Power Apps Premium. Расчёт бюджета без скрытых расходов.26 сент. 2026 г.Build
Агенты n8n или workflow: что выбрать для автоматизации
Агенты n8n или workflow: сравниваем контроль, память, стоимость и ограничения, чтобы выбрать надежную архитектуру автоматизации для продакшена.26 сент. 2026 г.Build
Jev Router бесплатно: что на самом деле означает $0
Для Jev Router заявлена цена $0, но покрывает ли она выбранную модель? Разбираем тарификацию OpenRouter, usage.cost и проверку расходов на агентную сессию.26 сент. 2026 г.Build
Плагины Claude: как попасть в каталог Anthropic
Как подготовить плагины Claude, выбрать тип заявки, пройти проверку в каталоге Anthropic и отдельно оформить удаленный MCP-коннектор для публикации.26 сент. 2026 г.Build
Cloudflare MCP Portals бесплатно: лимиты и реальные расходы
Cloudflare MCP Portals бесплатно: где проходит лимит Free, сколько стоят активные пользователи и какие расходы остаются за пределами портала.26 сент. 2026 г.Build
Оптимизация CUDA с Agentic CUDA Optimizer: практическое руководство
Разбираем, как настроить Agentic CUDA Optimizer, провести ограниченный эксперимент с ядром и проверить корректность, время GPU и затраты на модель.25 сент. 2026 г.Build
Цены Runpod в 2026 году: что выгоднее — Pods или Serverless
Разбираем цены Runpod на Pods, Serverless и хранилище, считаем расходы на H100 и находим порог, после которого выделенный GPU обходится дешевле.25 сент. 2026 г.Build