GPT-6 提示词缓存实战:诊断命中、控制写入与降低成本
通过真实 GPT-6 Sol 请求拆解提示词缓存的写入、命中与失效:读懂 cached_tokens 和诊断结果,稳定工具定义与请求前缀,并用自动缓存、显式断点和回归测试降低生产成本。文中涵盖 1,024 token 门槛、30 分钟有效期、配置更新,以及最适合缓存复用的 7 类工作流。



做好 GPT-6 提示词缓存,关键是让每次请求开头重复出现的指令、工具和上下文保持完全一致。在一次真实的 GPT-6 Sol 测试中,完全相同的重复请求复用了 1,980 个缓存 token,成本为 $0.000452;只改动一个工具名称,就需要重新写入前缀,成本升至 $0.0050085。9 月 22 日上线的控制面板和诊断功能,能在这类差异演变成生产账单之前把它暴露出来。
GPT-6 提示词缓存的核心规则:稳定内容在前,变化内容在后
提示词缓存会保存模型处理未变化前缀后的状态,也就是请求开头那部分内容。可以把它想成下班后不收拾工作台:制度手册、工具架和做到一半的组件都留在原位,下一班无需重搭环境,直接从这里接着做。
OpenAI 保存的是键值张量,也就是模型的工作状态,而不是提示词的副本。缓存覆盖完整的渲染后上下文,包括 OpenAI 指令、开发者消息、工具定义和对话历史。后续请求只能复用到渲染后前缀中首次出现实质差异的位置。
因此,请求内容的排列顺序会直接影响成本。把稳定的策略、参考资料、示例和工具定义放在前面;把时间戳、请求 ID、客户信息和当前任务放在后面。哪怕只修改前部的一行,也可能让它之后的全部内容失去缓存。
支持缓存的模型默认已经启用提示词缓存。对于 GPT-5.6 及更高版本,前缀达到 1,024 个可见输入 token 后才具备缓存资格。首次符合条件的请求按普通输入费率的 1.25 倍写入;匹配请求按普通输入费率的 0.1 倍读取。自最近一次写入或复用起,条目至少保持 30 分钟有效。
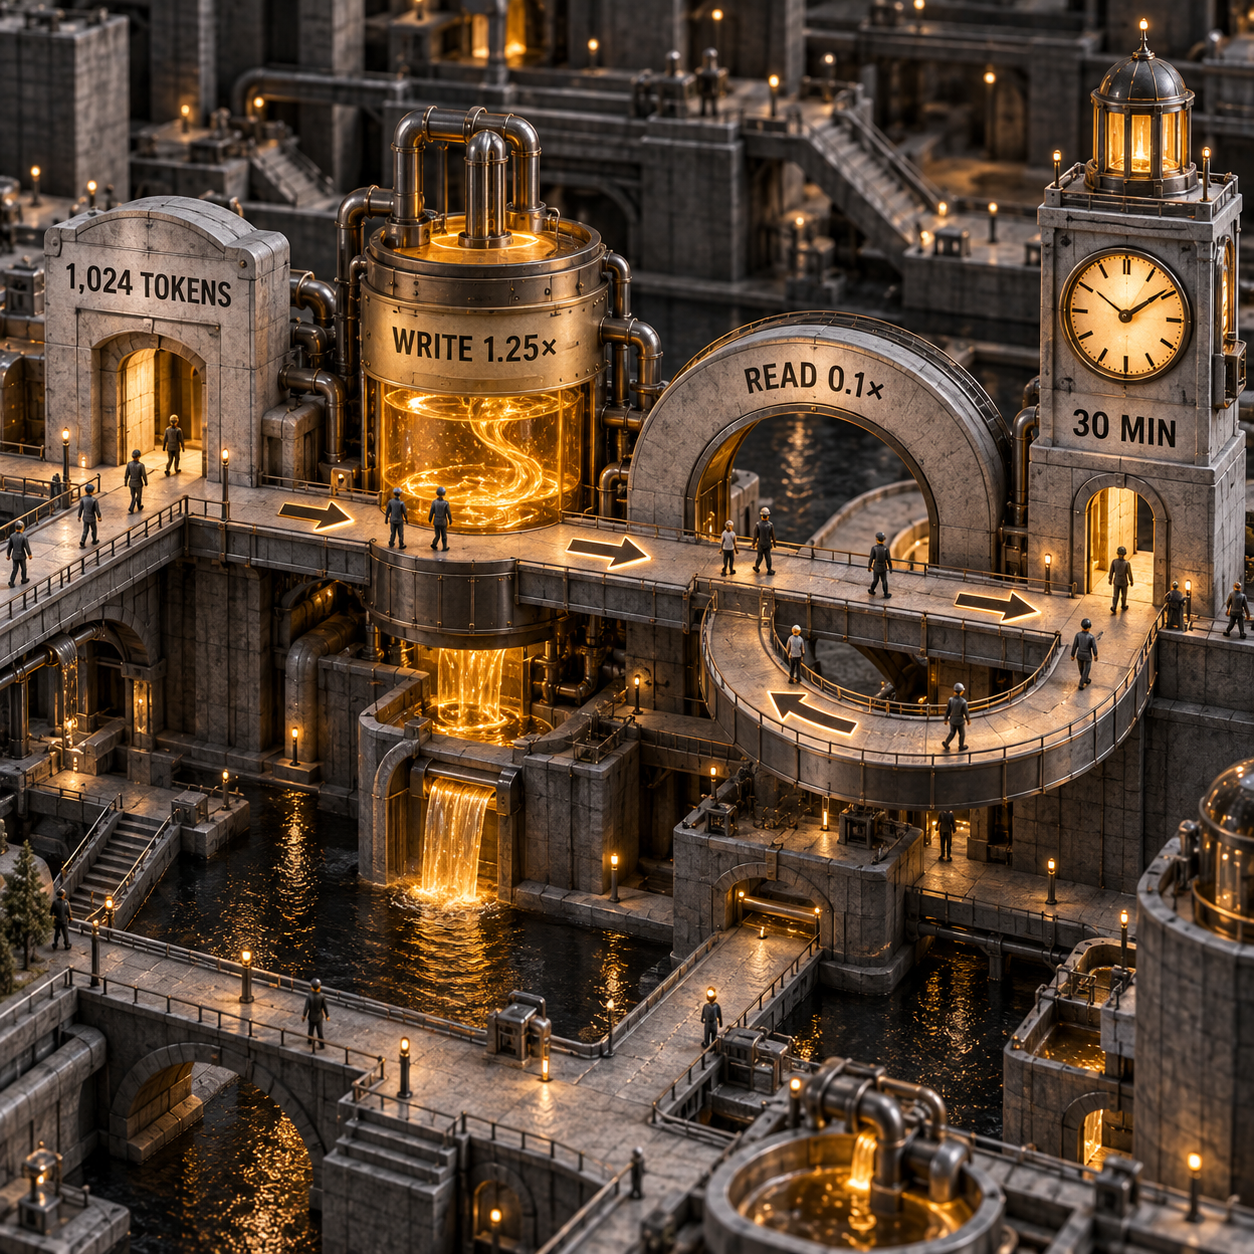
这里复用的是前缀,而不是语义相似度。两份策略即使含义相同,只要开头附近的写法不同,就会成为不同的缓存输入。工具名称、描述、JSON schema、排列顺序、模型、输出格式、推理设置或详细程度发生变化时也是如此。
9 月 22 日更新了什么
这次新增的运维层能力比缓存机制本身更值得关注。OpenAI 的 9 月 22 日更新加入了 Prompt Caching Dashboard、请求对比诊断,以及在 GPT-6 对话中调整推理强度但不破坏缓存的方法。OpenAI 还表示,GPT-6 系列的默认命中率有所提升。
不要把这些新增功能与同样适用于 GPT-5.6 的底层机制混为一谈。当前的提示词缓存指南明确说明,1,024 token 最低门槛、1.25× 写入费率、0.1× 读取费率、隐式与显式断点,以及 30 分钟 TTL,均适用于 GPT-5.6 及更高版本。
已有的 GPT-6 Sol 与 Luna 对比解决的是模型选择问题,缓存优化应当放在选型之后。无论选择更便宜还是更昂贵的模型,只要前缀稳定,两者原有的模型取舍关系都不会改变。
先从自动缓存开始
自动缓存几乎不需要改造提示词,又能给出干净的基线,因此是正确的起点。在有效窗口内把真实请求发送两次,确保所有影响缓存的字段都不变,然后检查第二次响应。
判断账单的两个关键字段是 usage.input_tokens_details.cached_tokens 和 cache_write_tokens。cached_tokens 很大,说明请求复用了已处理的输入;cache_write_tokens 很大,则说明这次请求为创建新缓存状态支付了费用。普通输入 token 数等于总输入减去这两类 token。
新的诊断流程会在这些计数之外给出原因:
- 保存同一组织中最近一次已完成响应的 ID。
- 在当前请求的
prompt_cache_options.comparison_response_id中填入该 ID。 - 读取响应里的
prompt_cache_diagnostics。 - 账单以 usage 字段为准,不要使用诊断估算值。
直接调用 Responses API 时,结果可能是 cache_hit、cache_miss、comparison_response_not_found 或 unavailable。如果诊断系统识别出工具定义有变化,会将其归类为 tools_changed。诊断属于尽力而为,并且只报告第一个成功分类的原因;修复该原因后,再进行下一轮对比。
下面是一段精简的 API 直连测试脚本。策略文件需要包含足够多且确有用途的稳定内容,才能超过 1,024 token 最低门槛。
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
基线响应应尽量新。诊断记录会在较短时间后过期,而且 comparison ID 只用于请求原因说明;它本身不会加载之前的对话,也不会制造缓存命中。
一次刻意制造的缓存未命中
这次真实测试使用 GPT-6 Sol、一份合成的 1,635 词客服策略、一个函数工具,以及简短任务 Reply with exactly OK.。每次请求模型都返回 OK,唯一变化的是影响缓存的结构。
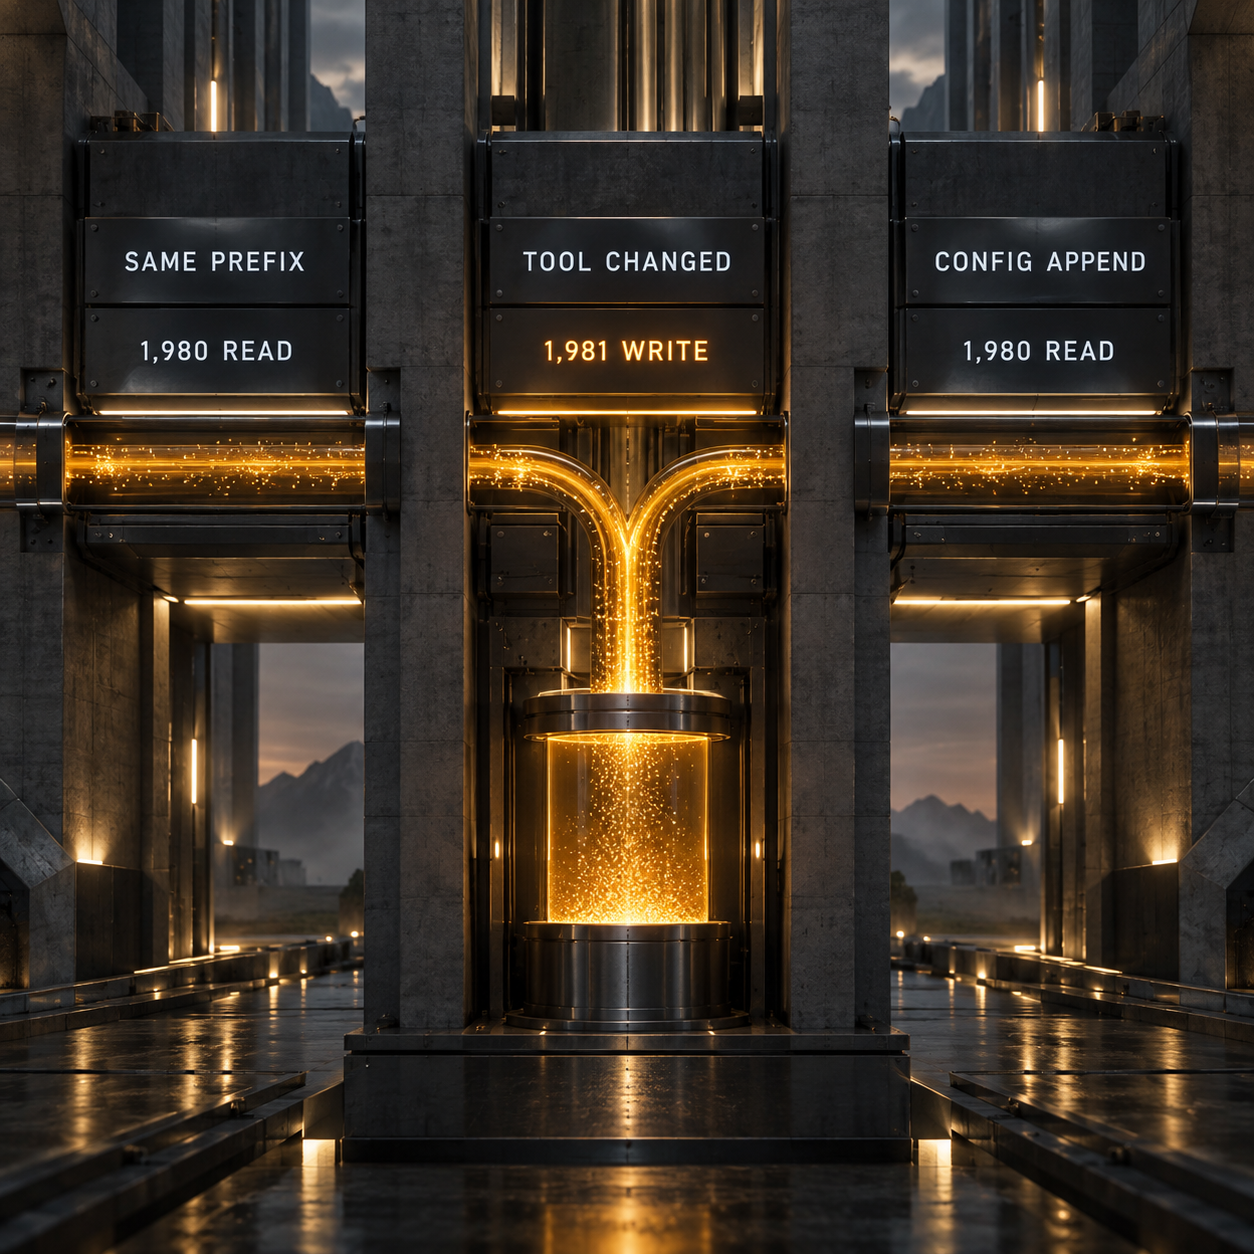
成本按当前 GPT-6 Sol Standard 短上下文费率计算:普通输入每百万 token $2,缓存输入每百万 token $0.20,缓存写入每百万 token $2.50,输出每百万 token $10。每次响应都使用了 5 个输出 token。
计入输出后,完全相同的重复请求比基线响应便宜 91.0%。对于 token 结构相同的 10 步 agent,一次写入加 9 次读取约花费 $0.009074;连续 10 次重新写入约花费 $0.05006。在这组合成工作负载中,保持前缀稳定可将每个已完成步骤的成本降低 81.9%。
真正应关注的是这个决策指标。即使命中率看起来不错,少数昂贵的长上下文轮次仍可能不断重写缓存。应当汇总每个已完成任务的实际 token 类别与成本,再结合可接受结果、重试和工具费用进行比较。
这些耗时数据不足以支持任何延迟结论。4 次调用耗时在 892 到 1,254 毫秒之间,缓存命中的重复请求并不是最快的一次。样本如此之小时,网络和路由噪声占主导。成本变化很清楚;要判断延迟,还需要多次重复测量和首 token 时间数据。
测试中还出现了一个值得注意的集成问题。Vercel AI Gateway 会转发 prompt_cache_options,返回 OpenAI provider response ID,也会上报缓存读取和写入,但其标准化响应遗漏了 prompt_cache_diagnostics。即便如此,从缓存 token 为 0、写入 token 为 1,981,仍能一眼看出这次刻意制造的未命中。如果应用与 OpenAI 之间还隔着 SDK 或 gateway,上生产前务必验证它是否会暴露新的诊断字段。
增加断点之前,先把前缀修好
大多数未命中都源于普通的请求构造问题。先解决这些问题:
- 保持工具名称、描述、schema、配置和顺序不变。不需要调用工具时使用
tool_choice: "none";只允许调用其中一部分时使用allowed_tools,同时保留完整的工具列表。 - 对预期共享前缀的请求,保持模型、service tier、文本 schema、请求级推理强度和详细程度稳定。
- 将时间戳、用户 ID、trace ID 和每个任务独有的数据移到稳定指令与参考资料之后。
- 只追加消息和工具结果。改写或总结早期对话内容都会改变前缀。
- 每修复一处,就与目标基线重新比较。诊断只会报告第一个成功分类的差异。
对于 GPT-6,应当通过对话 item 调整推理强度,而不是修改顶层设置。下面的请求继续把顶层设为 low,再对后续轮次应用 high。
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
配置更新适用于 standard、single-agent 模式下的 GPT-6 系列,而且只能改变推理强度。不要连续放置两个更新。它也不能与自动压缩或自动截断同时使用。
Responses API 迁移指南介绍了更广泛的状态管理取舍。就缓存而言,关键要简单得多:把原有 item 留在原位,只在后面追加变化。
只在确实划算的位置增加显式断点
如果请求由稳定核心和频繁变化、根本不值得写入缓存的后缀组成,显式断点就很有价值。把稳定指令放进 developer message 内的 input_text block,在该 block 上加入 prompt_cache_breakpoint: {"mode":"explicit"},并将 prompt_cache_options.mode 设为 explicit。
顶层 instructions 不能承载显式断点。在显式模式下,如果请求里没有显式 marker,就不会执行任何缓存写入。对于一次性提示词,这可能正是正确选择,因为缓存写入比普通输入贵 25%,只有后续请求会读取它时,这笔投入才能回本。
一次请求最多可以创建 4 次缓存写入。不要把这些名额耗在每条消息上。应当按照应用实际分支方式来选边界,例如共享的公司策略、workspace 上下文、对话分叉,以及可能存在的稳定评估 rubric。
预热是另一种延迟优化工具。设置 prompt_cache_options.prewarm: true 的请求会提前准备已知上下文而不生成输出,随后用户请求再发送同一个前缀。预热调用按正常的缓存写入费率收费,因此只应面向可预测流量使用,并测量首 token 时间。
最能从缓存中获益的 7 类工作流
1. Coding agent 平台
Coding agent 会反复发送仓库地图、开发规则、工具 schema 和早期对话。让这些区块保持稳定,在末尾追加文件变更和工具结果,并从共享历史中分叉后台任务,就能降低长会话中的上下文成本。一个被重命名的工具就可能抹掉全部节省,因此这类产品最应该在 CI 中加入缓存回归测试。
2. 客服 agent
客服团队可能有很长的策略手册、产品目录规则和固定升级工具。将这些共享材料放在前面,把当前工单放在后面。本次测量的合成策略正是这种模式。在请求结构相同的情况下,10 个已完成的短响应从重复写入时约 $0.05006,降至一次写入加 9 次读取时的 $0.009074。
3. 评估与质量团队
评估器可以复用评分 rubric、已标注示例、输出 schema 和工具定义,只替换末尾的候选交互。显式模式还能让不断变化的候选内容不产生写入费用。这样一来,缓存就从不可见的平台细节,变成评估单位经济性的一部分。
4. 研究与尽调 agent
研究工作流可以让已审核的资料包和分析规则保持稳定,在末尾追加新问题。基于同一份证据生成的分叉摘要、矛盾核查和备忘录章节,都能共享相同前缀。当多个 worker 从同一证据起步、产出不同交付物时,收益会更大。
5. 合同与合规审查
法务运营团队可以把条款库、风险 rubric、批准用语和审查工具放在待审合同之前,每份新文档都作为变化的后缀。缓存不会让判断本身更安全,但能降低重复加载相同控制要求的成本。
6. Multi-agent 运营
Orchestrator 可以在分支到 specialist agent 之前,保留共同计划、workspace 状态和工具历史。共享前缀很大时,缓存复用会降低分叉成本。保持工具定义稳定;如果应用支持,则通过只追加历史的方式加入新发现的工具。
7. 可预测的交互式发布
拥有已知参考资料的产品,可以在启动期间、首个用户请求到来前执行预热,将前缀处理移出用户等待时间。只有流量及时到来、能够复用条目,并且延迟收益经得起规范的重复测试时,这种做法才有价值。
值得开发的 3 款产品
1. Cache Regression CI:机会最大
构建一道测试门禁:重放有代表性的 agent 请求,将每次响应与已保存的基线比较;一旦缓存 token 下降或写入 token 激增,就让 pull request 失败。Agent 平台团队愿意为此付费,因为一次看似无害的工具 schema 修改,就可能让生产中的每个轮次都变成全新写入。
需求规模既适合切入,也足以形成生意:prompt caching 在美国每月约有 1,300 次搜索,openai prompt caching 为 320 次,而此次检索中,针对 GPT-6 具体配置问题的独立文字指南只有 2 篇。Helicone 的 Pro 方案已经以每月 $79 提供 alerts 和 reports,说明团队确实会为 LLM monitoring 编列预算。
最小可售版本可以由 CLI、GitHub check 和一份报告组成,报告包含 baseline response ID、诊断原因、缓存 token、写入 token、耗时和计算成本。需要正视的是 OpenAI 自带的 dashboard 与 diagnostics。产品必须提供 deployment gate、跨 provider 覆盖或代码级归因,才有资格占据工具栈的一席之地。
2. Cache-Aware Cost Allocator
为 AI 产品构建按客户核算的成本账本,分别记录普通输入、缓存读取、缓存写入、输出和工具费用。当多个客户共享 agent 前缀,而产品仍需给出可信的 workspace 级利润率时,财务与平台团队会愿意购买。
美国每月约有 50 次搜索指向 openai api prompt caching,当时的 People Also Ask 里还出现了“Should I use prompt caching?”和“When not to use caching?”。Langfuse 的生产云方案定价为每月 $29 和 $199,这同样说明 token 与成本追踪已经有成熟的软件预算。
MVP 可以是一层 SDK wrapper、一张定价表、tenant tag 和 completed-task 视图。真正的难点是归因。GPT-5.6 及更高版本不需要依靠 prompt_cache_key 做路由,单独的 key 主要用于核算。tenant 边界划分不当,可能造成账单混乱或隐私问题。
3. Adapter Conformance Monitor
构建一套测试,检查 SDK、proxy 或 model gateway 是否会转发 Responses 的新字段,并完整返回这些字段。每次依赖升级后,它都应测试 comparison_response_id、诊断类型、缓存 token 详情、配置更新、显式断点和 provider response ID。
需求信号来自认知缺口:what is prompt caching 在美国每月约有 480 次搜索,how does prompt caching work 为 140 次,“How do I turn on prompt caching?”也出现在当时的 People Also Ask 中。第一手测试还暴露了一个具体故障:gateway 保留了 usage,却遗漏了诊断对象。
MVP 可以是一张托管兼容性矩阵,再加一条命令,用 5 个合成请求测试客户 endpoint。难点在于产品的长期生命力。Gateway 厂商会不断补齐字段,因此这款产品需要持续测试各 provider 的协议,而不能只做一次性的 GPT-6 检查器。
局限,以及不回避问题的结论
当一个很长的前缀会反复出现时,提示词缓存值得专门设计。如果请求很短、彼此不同,或前部一直被改写,就不值得把它作为优化目标。
1,024 token 门槛很关键。仅仅为了达到缓存资格而给短提示词填充内容,反而可能提高成本。稳定且确实有用的示例或参考资料,也许值得增加这些 token;但判断依据应是复用次数和质量,而不是看到一次缓存命中的欲望。
缓存状态也受物理位置影响。条目存放在单台机器上,流量超过每分钟约 15 个请求时,可能溢出到其他机器。即使应用内容看起来完全稳定,路由和负载也可能造成未命中。缓存命中只是一项优化结果,不能作为正确性保证。
缓存输入仍然计入每分钟 token 限额。缓存无法手动清除。复用不会改变输出生成,因此完全相同的请求依然可能产生不同答案。对于 GPT-6 Sol,输入超过 272,000 token 的请求还会让整次请求进入更高的长上下文费率档位。
最重要的运维原则很简单:追踪每个可接受任务的成本,保持前缀稳定,并把每一次写入激增都视为值得查明原因的事件。
周一就做这一步
下周一挑选一个生产 agent endpoint。保存一条有代表性的 response ID,重放同一个已完成任务,并记录缓存 token、写入 token、耗时、输出 token 和总成本。然后只修改一处工具描述或名称,用同一基线进行比较;恢复工具列表后再运行一次。如果恢复后的请求在不损害验收结果的前提下降低了已完成任务成本,就在调整提示词或增加断点之前,把这项测试原样加入 CI。
常见问题
如何开启提示词缓存?
通常不需要手动开启。支持的 OpenAI 模型默认启用提示词缓存。对于 GPT-5.6 及更高版本,只要让请求开头至少 1,024 个可见 token 保持稳定,在有效窗口内发送匹配请求,再检查 cached_tokens 即可。只有需要精确控制断点时,才使用 prompt_cache_options.mode。
提示词缓存是什么,如何工作?
它会保存模型针对完全一致的提示词前缀处理出的键值状态。第一个符合条件的请求写入该状态,后续匹配请求可以直接读取,无需再次处理相同前缀;新的后缀内容和输出生成仍然需要计算。
什么时候不该使用缓存?
如果提示词低于最低门槛、很少重复、开头频繁变化,或在下一次请求到来前就已过期,就不要为缓存做优化。在显式模式下,不设置断点可以避免为预计不会复用的前缀支付 1.25× 写入费率。
应该使用提示词缓存吗?
如果重复输入在已完成任务成本中占比明显,就值得使用。用真实工具和验收检查,测量一次写入和多次读取。只有每个可接受任务的总成本确实下降,高命中率才有意义。
最好的缓存策略是什么?
先从自动隐式缓存开始。稳定内容放在前面,变化内容追加在后面,保持工具与请求设置不变,并诊断未命中原因。只有稳定区块会被充分复用、足以收回写入成本时,才增加显式断点。
如果希望把这套测量与回归门禁接入自己的 agent 技术栈,AI 生产系统正是合适的起点。
- 最近更新
- 2026年9月27日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
Copilot Managed Runtime 定价拆解:API、Credits 与 Premium 成本怎么算
Copilot Managed Runtime 定价并非一笔平台费。本文逐项拆解应用创建、启动、API 调用、托管管理、AI 服务与用户许可成本,解释 $10 示例究竟覆盖什么,并比较按量付费、Power Apps Premium、容量包和 P3,帮助团队依据公开费率与租户实测用量建立可执行预算。2026年9月26日Build
n8n 自动化该选 Agent 还是工作流?实测拆解
n8n Agent 与工作流到底怎么选?本文用同一套客服工单完成 30 轮对照测试,逐项拆解执行次数、会话状态、工作流工具调用、模型请求、审批边界与套餐成本。结论很清楚:固定步骤交给工作流,对话中真正需要判断的下一步交给 Agent,再用范围受限的工作流和人工审批控制生产环境中的风险。2026年9月26日Build
OpenRouter 价格拆解:Jev Router 真的免费吗?
OpenRouter 将 Jev Router 的提示词和补全 token 标为 $0,但整段路由会话未必零成本。本文拆解 OpenRouter 价格中的所选模型推理费、推理与缓存、工具和充值手续费,并给出用 usage.cost、生成记录与 Activity 对账的四请求验证方法,帮助团队在上线前确认真实预算。2026年9月26日Build
Claude 插件上架实战:从 GitHub 到目录审核
想把 Claude 插件从 GitHub 仓库上架到目录?本文拆解开发者门户全流程:确认付费套餐与长期归属,准备 plugin.json、README 和许可证,完成本地与门户验证、合规填写、审核提交及版本更新;若插件连接自建远程 MCP 服务器,还要单独提交 MCP connector,避免条目归属和运营数据脱节。2026年9月26日Build
Cloudflare MCP Server Portals 到底免费吗?套餐成本与限制
Cloudflare MCP Server Portals 可在 $0 免费套餐中供最多 50 名活跃用户使用。本文拆解免费版、$7/用户/月按量付费版的席位成本、日志保留、DLP 与 Logpush 边界,并解释 60 人团队为何每月需 $420,以及模型、上游 SaaS 和托管成本为何另算。2026年9月26日Build
Agentic CUDA Optimizer 实战:用 7 轮受控实验做 CUDA 性能优化
本文用一个 float32 矩阵乘法内核,拆解 Agentic CUDA Optimizer 的 7 轮受控搜索:从固定 v0.0 commit、准备独立参考实现与输入用例,到审查 history.json、复跑 best.cu,并用完整 GPU、API 和人工成本判断加速是否值得上线。2026年9月25日Build
Runpod 价格详解:Pods 与 Serverless 怎么选
Runpod 价格到底怎么计算?本文对比 Secure Cloud Pods、Serverless Flex、Active workers 与存储费率,用 100 小时、730 小时和请求量场景拆解 H100 成本,并给出 60.33% 的盈亏平衡线,帮助你按真实 worker 时长选择方案。2026年9月25日Build