Cache de prompts no GPT-6: como diagnosticar falhas e reduzir custos
Veja como estruturar o cache de prompts no GPT-6, diagnosticar falhas de prefixo e medir leituras e gravações para reduzir o custo real dos agentes de IA.



Com cache de prompts, um agente no GPT-6 fica mais barato quando as instruções, as ferramentas e o contexto que se repetem permanecem exatamente iguais no início de cada requisição. Em uma execução real com o GPT-6 Sol, uma repetição exata reutilizou 1,980 tokens em cache e custou $0.000452. A troca do nome de uma única ferramenta obrigou o sistema a gravar o prefixo novamente e elevou o custo para $0.0050085. O painel e os diagnósticos de 22 de setembro deixam essa diferença visível antes que ela vire uma conta de produção.
A regra do cache de prompts: primeiro o estável, depois o variável
O cache de prompts preserva o estado já processado pelo modelo para um prefixo que não mudou — ou seja, o conteúdo que abre a requisição. É como deixar uma oficina pronta de um dia para o outro: manual de procedimentos, bancada de ferramentas e montagem em andamento continuam no lugar, permitindo que o turno seguinte retome o trabalho sem preparar tudo outra vez.
O que a OpenAI armazena são tensores de chave e valor, o estado de trabalho do modelo, e não uma cópia do prompt. O cache abrange todo o contexto renderizado: instruções da OpenAI, mensagens do desenvolvedor, definições de ferramentas e histórico da conversa. Uma requisição posterior só consegue reutilizar esse trabalho até a primeira diferença relevante no prefixo renderizado.
Por isso, a ordem da requisição afeta diretamente o custo. Coloque primeiro políticas estáveis, materiais de referência, exemplos e definições de ferramentas. Deixe para depois timestamps, IDs de requisição, dados de clientes e a tarefa atual. Alterar uma linha logo no começo pode invalidar tudo o que vem em seguida.
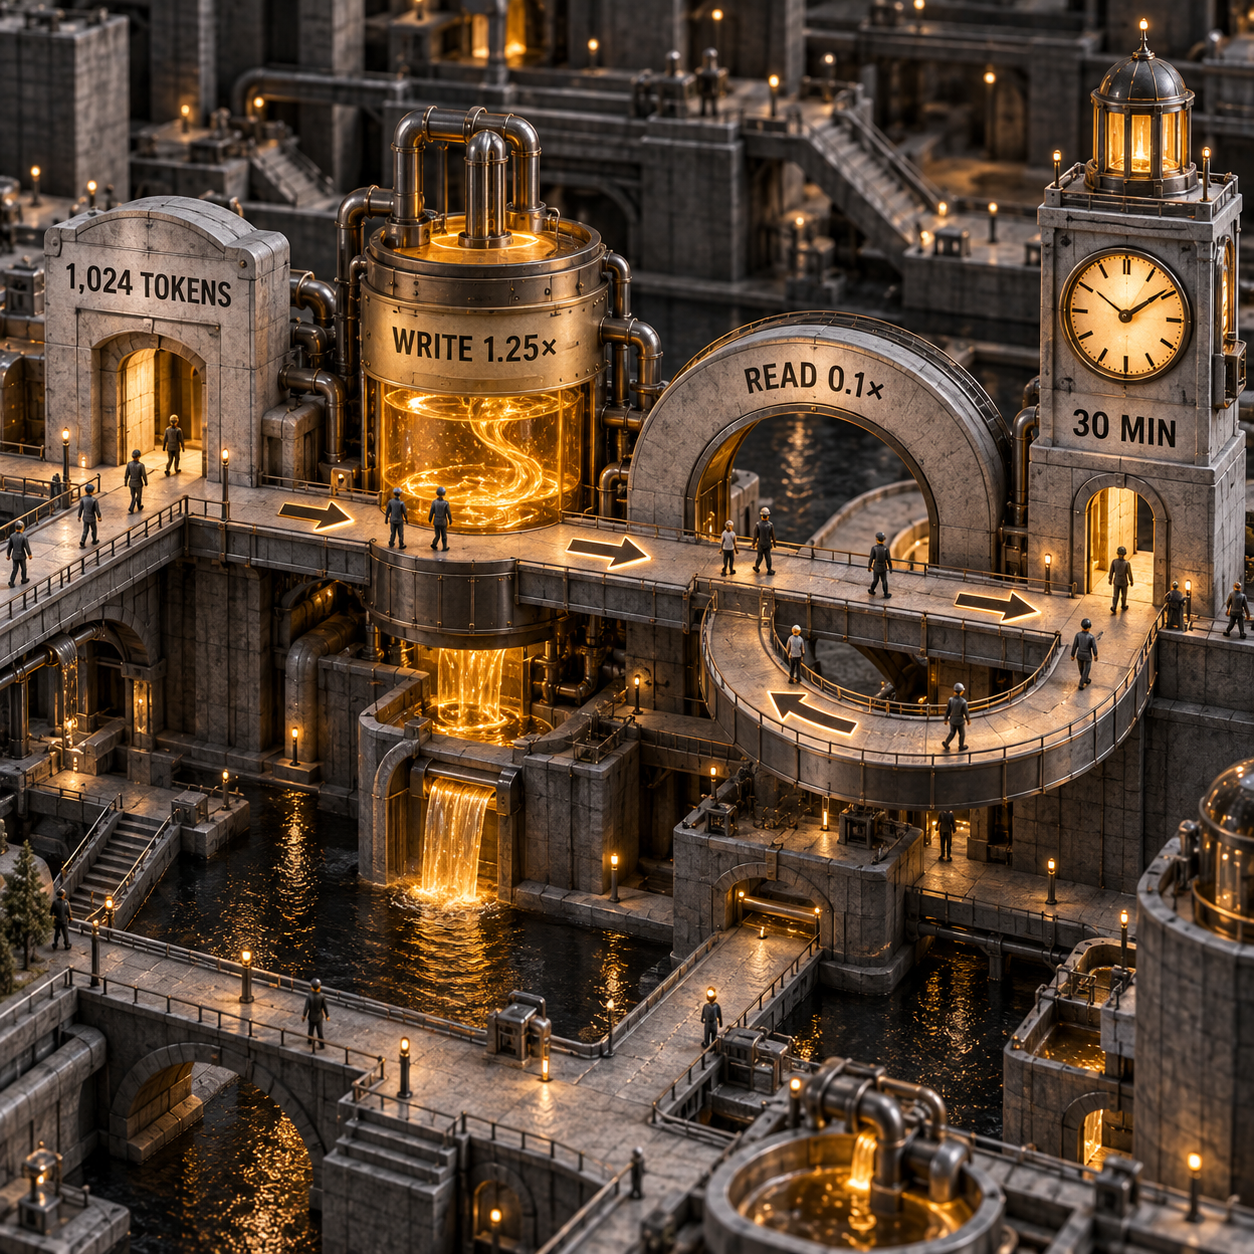
O cache de prompts já vem ativado nos modelos compatíveis. No GPT-5.6 e posteriores, um prefixo se torna elegível ao atingir 1,024 tokens de entrada visíveis. A primeira requisição elegível grava o prefixo por 1.25 vez a tarifa normal de entrada. Uma requisição correspondente o lê por 0.1 vez essa tarifa. A entrada permanece elegível por pelo menos 30 minutos após a gravação ou reutilização mais recente.
Trata-se de reutilização de prefixo, não de semelhança semântica. Duas políticas podem dizer a mesma coisa, mas, se diferirem perto do início, serão entradas distintas para o cache. O mesmo vale quando mudam o nome, a descrição, o schema JSON ou a ordem de uma ferramenta, bem como o modelo, o formato de saída, a configuração de raciocínio ou a verbosidade.
O que mudou em 22 de setembro
A nova camada para operadores é mais importante que o cache em si. O lançamento de 22 de setembro da OpenAI adicionou um Painel de Cache de Prompts, diagnósticos para comparar requisições e uma forma de alterar o esforço de raciocínio durante uma conversa com GPT-6 sem perder o cache. Segundo a OpenAI, a família GPT-6 também melhora as taxas padrão de acerto.
Não confunda essas novidades com os mecanismos que também se aplicam ao GPT-5.6. O guia atual de cache de prompts aplica ao GPT-5.6 e posteriores o mínimo de 1,024 tokens, a tarifa de gravação de 1.25×, a tarifa de leitura de 0.1×, os pontos de interrupção implícitos e explícitos e o TTL de 30 minutos.
A comparação entre GPT-6 Sol e Luna já publicada ajuda a escolher o modelo. A decisão sobre cache vem depois. Um modelo mais barato com prefixos estáveis e um modelo mais caro com prefixos estáveis mantêm entre si a mesma relação de custo e capacidade.
Como começar com o cache automático
O cache automático é a configuração inicial certa porque cria uma linha de base limpa praticamente sem exigir mudanças no prompt. Envie duas vezes a requisição real dentro da janela ativa, mantenha fixos todos os campos sensíveis ao cache e examine a segunda resposta.
Os dois campos que resolvem a dúvida sobre cobrança são usage.input_tokens_details.cached_tokens e cache_write_tokens. Um valor alto em cached_tokens indica que a requisição reutilizou uma entrada já processada. Um valor alto em cache_write_tokens mostra que ela pagou para criar um novo estado de cache. Os tokens de entrada comuns correspondem ao total de entrada menos esses dois valores.
O novo fluxo de diagnóstico acrescenta a causa a essas contagens:
- Salve o ID de uma resposta concluída recentemente na mesma organização.
- Informe esse valor em
prompt_cache_options.comparison_response_idna requisição atual. - Consulte
prompt_cache_diagnosticsna resposta. - Para cobrança, use os campos de uso, não as estimativas do diagnóstico.
A Responses API direta pode informar cache_hit, cache_miss, comparison_response_not_found ou unavailable. Quando o sistema de diagnóstico identifica uma alteração na definição de ferramenta, ele a classifica como tools_changed. Os diagnósticos funcionam em regime de melhor esforço e exibem a primeira causa classificada; corrija esse motivo e faça uma nova comparação.
Veja um script compacto para testar diretamente pela API. O arquivo de políticas precisa ter conteúdo estável e útil o bastante para ultrapassar o mínimo de 1,024 tokens.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
Use uma linha de base recente. Os registros de diagnóstico expiram depois de um período curto, e o ID de comparação serve apenas para solicitar uma explicação. Ele não carrega a conversa anterior nem produz sozinho um acerto de cache.
Um cache hit quebrado de propósito
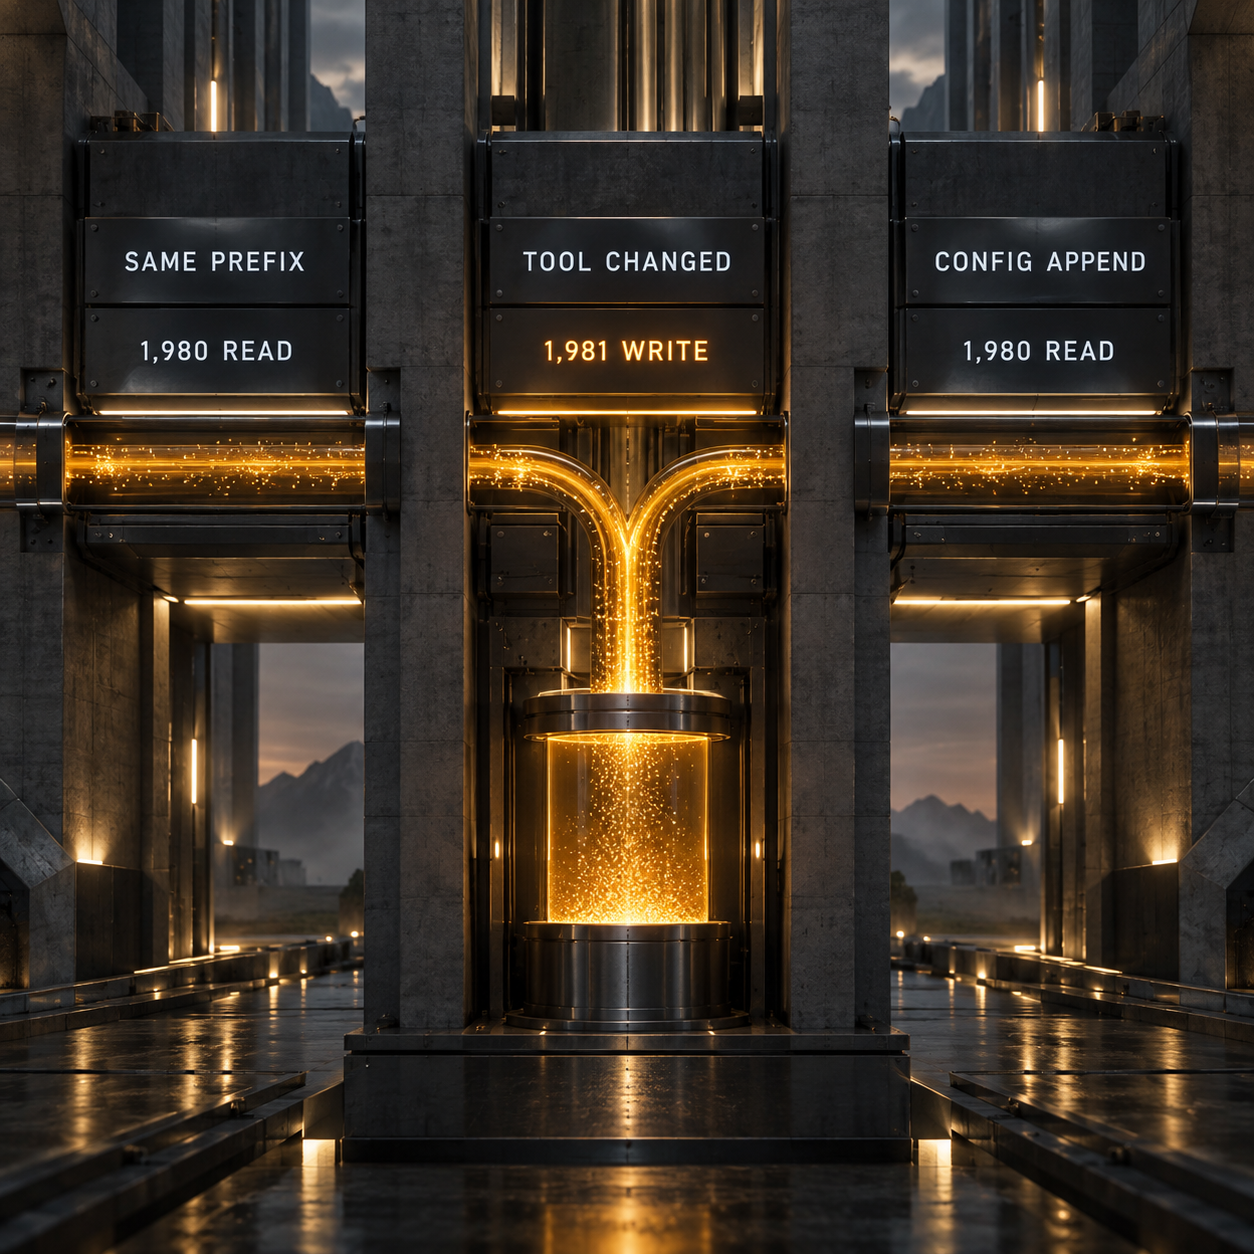
O teste real usou o GPT-6 Sol, uma política sintética de suporte com 1,635 palavras, uma ferramenta de função e a tarefa curta Reply with exactly OK.. O modelo respondeu OK em todas as requisições. A única mudança ocorreu na estrutura sensível ao cache.
O cálculo usa as tarifas atuais do GPT-6 Sol Standard em contexto curto: $2 por milhão de tokens de entrada comuns, $0.20 por milhão de tokens de entrada em cache, $2.50 por milhão de tokens gravados no cache e $10 por milhão de tokens de saída. Cada resposta usou cinco tokens de saída.
Incluindo a saída, a repetição exata custou 91.0% menos que a resposta inicial. Para um agente de dez etapas com o mesmo perfil de tokens, uma gravação seguida por nove leituras custa cerca de $0.009074. Dez gravações novas custam aproximadamente $0.05006. Manter o prefixo estável reduz em 81.9% o custo por etapa concluída nessa carga de trabalho sintética.
Essa é a métrica que orienta a decisão. A porcentagem de cache hits pode parecer saudável mesmo quando poucas interações caras e de contexto longo continuam regravando o cache. Some o custo e as classes reais de tokens de todas as tarefas concluídas; depois, compare resultados aceitos, novas tentativas e cobranças de ferramentas.
Os tempos decorridos não sustentam uma conclusão sobre latência. As quatro chamadas variaram de 892 a 1,254 milissegundos, e a repetição em cache não foi a mais rápida. O ruído de rede e roteamento domina uma amostra tão pequena. A mudança no custo é clara; para avaliar latência, são necessárias medições repetidas e dados de tempo até o primeiro token.
O teste também revelou uma falha de integração importante. O Vercel AI Gateway encaminhou prompt_cache_options, devolveu o ID de resposta do provedor OpenAI e informou leituras e gravações de cache, mas omitiu prompt_cache_diagnostics da resposta normalizada. Ainda assim, a falha provocada de propósito ficou evidente pelos zero tokens em cache e pelos 1,981 tokens de gravação. Se houver um SDK ou gateway entre a aplicação e a OpenAI, confirme que ele expõe o novo campo de diagnóstico antes de depender desse dado em produção.
Corrija o prefixo antes de criar pontos de interrupção
A maioria das falhas nasce da montagem comum da requisição. Corrija primeiro esses pontos:
- Mantenha inalterados nomes, descrições, schemas, configurações e ordem das ferramentas. Use
tool_choice: "none"quando nenhuma ferramenta deva ser executada, ouallowed_toolsquando apenas um subconjunto puder ser chamado, sem remover itens da lista completa de ferramentas fornecida. - Mantenha estáveis o modelo, o nível de serviço, o schema de texto, o esforço de raciocínio no nível da requisição e a verbosidade nas requisições que devem compartilhar um prefixo.
- Coloque timestamps, IDs de usuário, IDs de rastreamento e dados específicos da tarefa depois das instruções e referências estáveis.
- Acrescente mensagens e resultados de ferramentas ao final. Reescrever ou resumir o conteúdo anterior da conversa muda o prefixo.
- Depois de cada correção, compare com a linha de base pretendida. O diagnóstico informa apenas a primeira diferença classificada.
No GPT-6, altere o esforço por meio de um item da conversa, e não pela configuração de nível superior. A requisição abaixo mantém low no nível superior e aplica high à continuação.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
As atualizações de configuração funcionam para a família GPT-6 no modo padrão de agente único e alteram apenas o esforço de raciocínio. Não coloque duas atualizações lado a lado. Elas também não podem ser combinadas com compactação automática nem com truncamento automático.
O guia de migração para a Responses API explica a decisão mais ampla sobre estado. Para cache, o ponto central é mais simples: preserve os itens antigos no lugar e acrescente a mudança ao final.
Quando adicionar pontos de interrupção explícitos ao cache de prompts
Um ponto de interrupção explícito é útil quando a requisição tem um núcleo estável seguido por um sufixo que muda com frequência demais para justificar uma gravação no cache. Coloque as instruções estáveis em um bloco input_text dentro de uma mensagem de desenvolvedor, adicione prompt_cache_breakpoint: {"mode":"explicit"} a esse bloco e configure prompt_cache_options.mode como explicit.
O campo de nível superior instructions não aceita um ponto de interrupção explícito. No modo explícito, uma requisição sem marcador explícito não faz nenhuma gravação no cache. Para um prompt usado uma única vez, essa pode ser a escolha certa: uma gravação custa 25% mais que a entrada comum e só se paga quando uma requisição posterior a lê.
Uma requisição pode criar até quatro gravações de cache. Não consuma essas posições em todas as mensagens. Escolha limites que representem as ramificações reais da aplicação: uma política comum da empresa, o contexto de um workspace, uma bifurcação na conversa e, talvez, uma rubrica de avaliação estável.
O prewarming é uma ferramenta diferente, voltada à latência. Uma requisição com prompt_cache_options.prewarm: true prepara um contexto conhecido sem gerar saída; depois, a requisição do usuário envia o mesmo prefixo. A chamada de prewarm é cobrada pela tarifa normal de gravação no cache. Portanto, reserve-a para tráfego previsível e meça o tempo até o primeiro token.
Sete fluxos de trabalho que mais ganham com o cache
1. Plataformas de agentes de programação
Um agente de programação envia repetidamente mapas do repositório, regras do desenvolvedor, schemas de ferramentas e interações anteriores. Mantenha esses blocos estáveis, acrescente mudanças em arquivos e resultados de ferramentas ao final e ramifique tarefas em segundo plano a partir do histórico compartilhado. O ganho aparece na redução do custo de contexto durante sessões longas. Como uma única ferramenta renomeada pode eliminar a economia, esse grupo é o que mais se beneficia de um teste de regressão de cache no CI.
2. Agentes de atendimento ao cliente
Uma equipe de atendimento pode ter um manual extenso de políticas, regras de catálogo de produtos e ferramentas fixas de escalonamento. Coloque o material compartilhado primeiro e o chamado atual depois. A política sintética medida reproduz esse padrão. Com o mesmo formato de requisição, dez respostas curtas concluídas caíram de cerca de $0.05006, com gravações repetidas, para $0.009074, com uma gravação e nove leituras.
3. Equipes de avaliação e qualidade
Um avaliador pode reutilizar uma rubrica de pontuação, exemplos rotulados, um schema de saída e as definições de ferramentas, mudando apenas a interação candidata no final. O modo explícito pode impedir que essa parte variável gere uma cobrança de gravação. Assim, o cache entra na economia unitária da avaliação em vez de permanecer como um detalhe invisível da plataforma.
4. Agentes de pesquisa e diligência
Um fluxo de pesquisa pode manter estáveis um pacote de fontes verificadas e suas regras de análise, acrescentando novas perguntas ao final. Resumos ramificados, verificações de contradições e seções de memorandos podem compartilhar o mesmo prefixo. O benefício aumenta quando vários workers partem das mesmas evidências para produzir entregas diferentes.
5. Revisão de contratos e conformidade
Uma equipe de operações jurídicas pode colocar sua biblioteca de cláusulas, rubrica de risco, linguagem aprovada e ferramentas de revisão antes do contrato analisado. Cada documento novo se torna o sufixo variável. O cache não torna o julgamento mais seguro, mas pode reduzir o custo repetido de carregar os mesmos controles.
6. Operações multiagente
Um orquestrador pode preservar um plano comum, o estado do workspace e o histórico de ferramentas antes de ramificar o trabalho entre agentes especialistas. Reutilizar o cache reduz o custo dessas bifurcações quando o prefixo compartilhado é grande. Mantenha as definições de ferramentas estáveis e adicione novas ferramentas pelo histórico incremental, quando a aplicação permitir.
7. Lançamentos interativos previsíveis
Um produto com material de referência conhecido pode fazer prewarm durante a inicialização, antes da primeira requisição do usuário. Assim, o processamento do prefixo sai do tempo de espera do usuário. A técnica só vale a pena se o tráfego chegar cedo o bastante para reutilizar a entrada e se o ganho de latência resistir a um teste repetido adequado.
Três produtos que valem a pena construir
1. CI de regressão de cache, a oportunidade mais forte
Crie uma barreira de teste que reproduza requisições representativas de agentes, compare cada resposta com uma linha de base salva e reprove um pull request quando os tokens em cache diminuírem ou as gravações dispararem. Equipes de plataformas de agentes pagam por isso porque uma alteração aparentemente inofensiva no schema de uma ferramenta pode transformar toda interação em produção em uma nova gravação.
A demanda é pequena o bastante para ser atendida e grande o suficiente para chamar atenção: prompt caching recebe cerca de 1,300 buscas mensais nos EUA, openai prompt caching recebe 320, e a consulta exata de configuração do GPT-6 retornou apenas dois guias independentes por escrito. A Helicone já cobra $79 por mês pelo plano Pro, com alertas e relatórios, o que mostra que as equipes reservam orçamento para monitoramento de LLMs.
A menor versão vendável reúne uma CLI, uma verificação no GitHub e um relatório com ID da resposta de linha de base, motivo do diagnóstico, tokens em cache, tokens de gravação, tempo decorrido e custo calculado. O obstáculo é o próprio painel da OpenAI, com seus diagnósticos. Para justificar seu lugar, o produto precisa funcionar como barreira de implantação, cobrir diferentes provedores ou atribuir a falha ao código.
2. Um alocador de custos sensível ao cache
Crie um livro-razão de custos por cliente para produtos de IA, separando entrada comum, leituras de cache, gravações de cache, saída e tarifas de ferramentas. Equipes financeiras e de plataforma pagam por isso quando um prefixo compartilhado de agente atende muitos clientes, mas o produto ainda precisa demonstrar margens confiáveis por workspace.
Cerca de 50 buscas mensais nos EUA procuram openai api prompt caching, e a lista real de People Also Ask inclui “Should I use prompt caching?” e “When not to use caching?”. A Langfuse cobra $29 e $199 por mês em seus planos de nuvem para produção, outro sinal de que rastrear tokens e custos já conta com orçamento para software.
O MVP é composto por um wrapper de SDK, uma tabela de preços, tags de tenants e uma visão por tarefa concluída. A dificuldade real é a atribuição. O GPT-5.6 e posteriores não precisam de prompt_cache_key para roteamento, e as chaves separadas existem principalmente para contabilidade. Limites de tenant mal definidos podem gerar contas confusas ou preocupações com privacidade.
3. Um monitor de conformidade para adaptadores
Crie uma suíte de testes que verifique se um SDK, proxy ou gateway de modelos encaminha os novos campos da Responses API e os devolve intactos. Ela testaria comparison_response_id, tipos de diagnóstico, detalhes dos tokens de cache, atualizações de configuração, pontos de interrupção explícitos e IDs de resposta do provedor depois de cada atualização de dependência.
O sinal de demanda está na lacuna de aprendizado: what is prompt caching recebe cerca de 480 buscas mensais nos EUA, how does prompt caching work recebe 140, e “How do I turn on prompt caching?” aparece nos resultados reais de People Also Ask. A execução em primeira mão também revelou uma falha concreta: o gateway preservou os dados de uso, mas omitiu o objeto de diagnóstico.
O MVP é uma matriz de compatibilidade hospedada acompanhada de um comando que executa cinco requisições sintéticas no endpoint do cliente. A dificuldade está na durabilidade. Os fornecedores de gateways vão adicionar campos, então o produto precisa testar protocolos continuamente entre provedores, e não se limitar a uma verificação pontual do GPT-6.
Limites e a avaliação honesta
Vale a pena projetar para o cache de prompts quando um prefixo longo se repete. Ele não é um bom alvo quando as requisições são curtas, únicas ou reescritas constantemente perto do início.
O piso de 1,024 tokens faz diferença. Preencher um prompt pequeno só para torná-lo elegível pode aumentar o custo. Exemplos úteis ou materiais de referência estáveis talvez justifiquem os tokens extras, mas a decisão depende da quantidade de reutilizações e da qualidade, não da vontade de exibir um cache hit.
O estado do cache também é físico. As entradas ficam em máquinas individuais, e um tráfego acima de cerca de 15 requisições por minuto pode transbordar para outras máquinas. Roteamento e carga podem causar falhas mesmo quando o conteúdo da aplicação parece estável. Um cache hit é resultado de uma otimização, não uma garantia de correção.
Entradas em cache continuam contando para os limites de tokens por minuto. O cache não pode ser limpo manualmente. A reutilização não altera a geração da saída, portanto requisições idênticas ainda podem produzir respostas diferentes. No GPT-6 Sol, uma requisição acima de 272,000 tokens de entrada também faz toda a requisição passar para as tarifas mais altas de contexto longo.
A regra operacional mais forte é simples: acompanhe o custo por tarefa aceita, mantenha o prefixo estável e trate cada pico de gravação como um incidente que merece explicação.
O que fazer na próxima segunda-feira
Escolha um endpoint de agente em produção na próxima segunda-feira. Salve o ID de uma resposta representativa, repita a mesma tarefa concluída e registre tokens em cache, tokens de gravação, tempo decorrido, tokens de saída e custo total. Depois, altere uma descrição ou um nome de ferramenta, compare com a mesma linha de base, restaure a lista de ferramentas e execute novamente. Se a requisição restaurada reduzir o custo por tarefa concluída sem prejudicar a aceitação, adicione exatamente esse teste ao CI antes de mexer nos prompts ou criar pontos de interrupção.
Perguntas frequentes
Como ativar o cache de prompts?
Em geral, não é preciso ativá-lo. O cache de prompts vem habilitado por padrão nos modelos compatíveis da OpenAI. Mantenha pelo menos 1,024 tokens visíveis estáveis no início de uma requisição do GPT-5.6 ou posterior, envie uma requisição correspondente dentro da janela ativa e consulte cached_tokens. Use prompt_cache_options.mode apenas quando precisar controlar deliberadamente os pontos de interrupção.
O que é cache de prompts e como ele funciona?
Ele preserva o estado de chave e valor já processado pelo modelo para um prefixo exato do prompt. A primeira requisição elegível grava esse estado, e as requisições posteriores correspondentes podem lê-lo em vez de processar o mesmo prefixo novamente. O novo conteúdo no sufixo e a geração da saída ainda exigem processamento.
Quando não usar cache?
Não otimize para cache quando os prompts ficam abaixo do mínimo, raramente se repetem, mudam perto do início ou expiram antes da chegada de outra requisição. No modo explícito, omitir um ponto de interrupção evita pagar a tarifa de gravação de 1.25× por um prefixo que provavelmente não será reutilizado.
Vale a pena usar cache de prompts?
Use-o quando a entrada repetida representar uma parcela relevante do custo por tarefa concluída. Meça uma gravação e várias leituras com suas ferramentas reais e verificações de aceitação. Uma taxa de acerto alta só importa quando o custo total por tarefa aceita diminui.
Qual é a melhor estratégia de cache?
Comece com o cache automático implícito. Coloque o conteúdo estável primeiro, acrescente o conteúdo variável ao final, mantenha fixas as ferramentas e configurações da requisição e diagnostique as falhas. Adicione pontos de interrupção explícitos apenas em torno de blocos estáveis que serão reutilizados o suficiente para compensar a gravação.
Se quiser incorporar essa medição e essa barreira de regressão à sua stack de agentes, sistemas de IA em produção é o ponto de partida certo.
- Última atualização
- 27 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Preço Copilot Studio: quanto custa o Managed Runtime
Entenda como créditos, chamadas de API, licenças, hospedagem e agentes compõem o preço Copilot Studio no Managed Runtime antes de fechar o orçamento.26 de set. de 2026Build
n8n automação: quando usar Agents ou workflows
n8n automação: entenda quando usar um Agent, quando um workflow é mais seguro e por que o modelo híbrido costuma ser a melhor escolha em produção.26 de set. de 2026Build
Jev Router é grátis? Veja o custo real de uma sessão
Jev Router é grátis no anúncio, mas isso não garante uma sessão a custo zero. Veja como conferir modelo escolhido, cache, ferramentas e cobrança real.26 de set. de 2026Build
Plugins Claude: como publicar no diretório oficial
Aprenda a publicar plugins Claude no diretório oficial: prepare o pacote, valide o repositório, envie para análise e separe o conector MCP remoto.26 de set. de 2026Build
Cloudflare MCP é gratuito? Preços, limites e custos reais
Cloudflare MCP é gratuito para até 50 usuários ativos. Veja os limites do plano Free, o custo do Pay-as-you-go e as despesas que ficam fora do portal.26 de set. de 2026Build
Otimização CUDA com Agentic CUDA Optimizer: guia prático
Aprenda a usar o Agentic CUDA Optimizer em um teste controlado, validar kernels, medir custos de GPU e decidir se o ganho de desempenho compensa.25 de set. de 2026Build
Runpod pricing: guia de custos de Pods e Serverless em 2026
Veja quanto custa a Runpod, compare Pods e Serverless, entenda o ponto de equilíbrio e estime gastos com GPU, armazenamento e requisições na prática.25 de set. de 2026Build