Caché de prompts en GPT-6: cómo detectar fallos y ahorrar
Aprende a configurar la caché de prompts en GPT-6, detectar por qué falla y medir lecturas, escrituras y costos reales antes de llevarla a producción.



La caché de prompts reduce el costo de un agente GPT-6 cuando las instrucciones, las herramientas y el contexto que se repiten permanecen exactamente iguales al principio de cada solicitud. En una ejecución real con GPT-6 Sol, una repetición exacta reutilizó 1,980 tokens en caché y costó $0.000452. Cambiar el nombre de una sola herramienta obligó a reescribir el prefijo y elevó el costo a $0.0050085. El panel y los diagnósticos del 22 de septiembre permiten ver esa diferencia antes de que se convierta en una factura de producción.
La regla de la caché de prompts: primero lo estable, al final lo variable
La caché de prompts conserva el estado ya procesado por el modelo para un prefijo sin cambios, es decir, el contenido que encabeza una solicitud. Es como dejar un taller preparado de un día para otro: el manual de políticas, las herramientas y el trabajo a medio terminar permanecen en su sitio, de modo que el siguiente turno puede continuar desde ahí en vez de montar todo de nuevo.
OpenAI almacena tensores de clave-valor —el estado de trabajo del modelo—, no una copia del prompt. La caché abarca todo el contexto renderizado: las instrucciones de OpenAI, los mensajes de desarrollador, las definiciones de herramientas y el historial de la conversación. Una solicitud posterior solo puede reutilizar ese trabajo hasta la primera diferencia relevante en el prefijo renderizado.
Por eso, el orden de una solicitud también determina su costo. Coloque primero las políticas, el material de referencia, los ejemplos y las definiciones de herramientas que no cambian. Deje para el final las marcas de tiempo, los identificadores de solicitud, los datos del cliente y la tarea actual. Modificar una línea al principio puede invalidar todo lo que viene después.
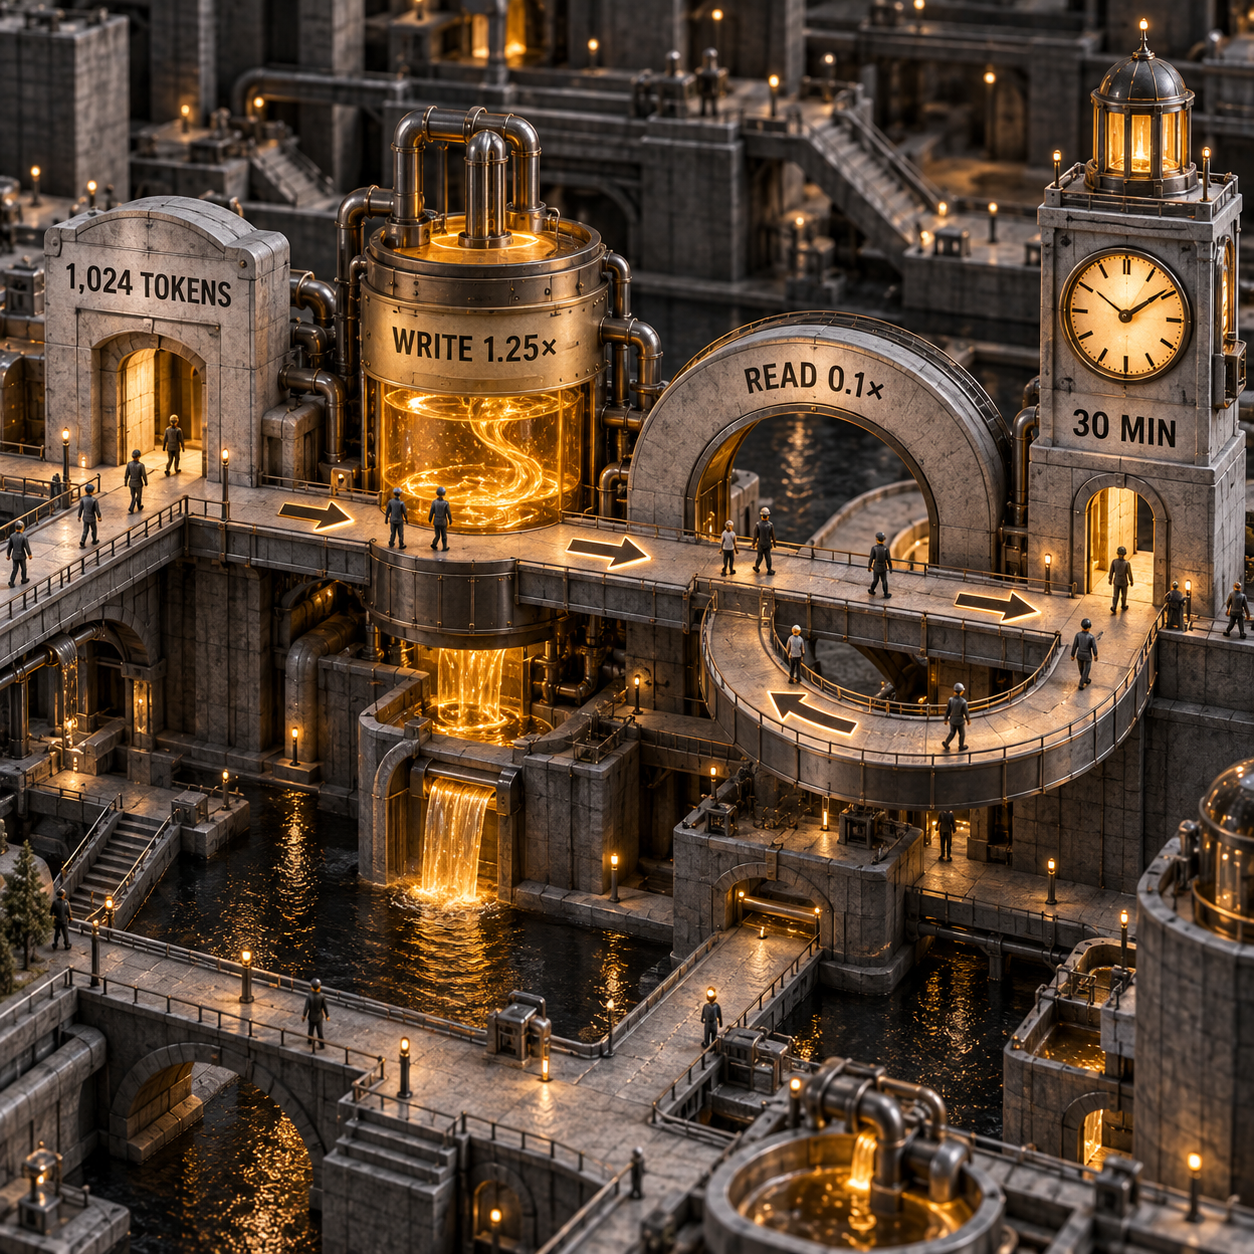
La caché de prompts ya está activada en los modelos compatibles. En GPT-5.6 y versiones posteriores, un prefijo puede entrar en caché a partir de 1,024 tokens de entrada visibles. La primera solicitud que cumple el requisito escribe el prefijo a 1.25 veces la tarifa normal de entrada. Una solicitud coincidente lo lee a 0.1 veces esa tarifa. La entrada permanece disponible durante al menos 30 minutos desde la última escritura o reutilización.
Se trata de reutilizar un prefijo, no de detectar similitud semántica. Dos políticas con el mismo significado pero con diferencias cerca del comienzo producen entradas de caché distintas. Lo mismo ocurre al cambiar el nombre, la descripción, el esquema JSON o el orden de una herramienta, así como el modelo, el formato de salida, la configuración de razonamiento o el nivel de detalle.
Qué cambió el 22 de septiembre
La nueva capa operativa importa más que la propia caché. El lanzamiento de OpenAI del 22 de septiembre incorporó un panel de caché de prompts, diagnósticos para comparar solicitudes y una forma de cambiar el esfuerzo de razonamiento durante una conversación con GPT-6 sin perder la caché. OpenAI también afirma que la familia GPT-6 mejora la tasa de aciertos predeterminada.
No hay que confundir estas novedades con mecanismos que también se aplican a GPT-5.6. La guía vigente sobre caché de prompts establece para GPT-5.6 y versiones posteriores el mínimo de 1,024 tokens, la tarifa de escritura de 1.25×, la tarifa de lectura de 0.1×, los puntos de corte implícitos y explícitos, y el TTL de 30 minutos.
La comparativa entre GPT-6 Sol y Luna aborda la elección del modelo. La caché viene después. Tanto en un modelo más económico como en uno más costoso, mantener prefijos estables conserva la misma diferencia relativa entre ambos.
Empiece con la caché de prompts automática
La caché automática es el punto de partida adecuado porque ofrece una línea base clara sin apenas modificar el prompt. Envíe dos veces la solicitud real dentro de la ventana activa, mantenga fijos todos los campos sensibles a la caché y revise la segunda respuesta.
Los dos campos que resuelven la cuestión de la facturación son usage.input_tokens_details.cached_tokens y cache_write_tokens. Un valor alto de cached_tokens indica que la solicitud reutilizó entrada ya procesada. Un valor alto de cache_write_tokens indica que se pagó por crear un estado de caché nuevo. Los tokens de entrada ordinarios equivalen al total de entrada menos esos dos valores.
El nuevo flujo de diagnóstico añade la causa a esos valores:
- Guarde el ID de una respuesta completada recientemente en la misma organización.
- Inclúyalo en
prompt_cache_options.comparison_response_iddentro de la solicitud actual. - Consulte
prompt_cache_diagnosticsen la respuesta. - Para la facturación, use los campos de uso y no las estimaciones del diagnóstico.
La API Responses directa puede informar cache_hit, cache_miss, comparison_response_not_found o unavailable. Cuando el sistema de diagnóstico detecta que cambió la definición de una herramienta, lo clasifica como tools_changed. Los diagnósticos son orientativos y muestran la primera causa que logran clasificar; corrija esa causa y vuelva a comparar.
Este script compacto permite probarlo directamente con la API. El archivo de políticas debe contener suficiente material estable y útil para superar el mínimo de 1,024 tokens.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
Use una línea base reciente. Los registros de diagnóstico caducan al poco tiempo, y el ID de comparación solo solicita una explicación. Por sí solo, no carga la conversación anterior ni genera un acierto de caché.
Un acierto de caché roto a propósito
La prueba real utilizó GPT-6 Sol, una política de soporte sintética de 1,635 palabras, una herramienta de función y la tarea breve Reply with exactly OK. El modelo respondió OK en todas las solicitudes. Lo único que cambió fue la estructura sensible a la caché.
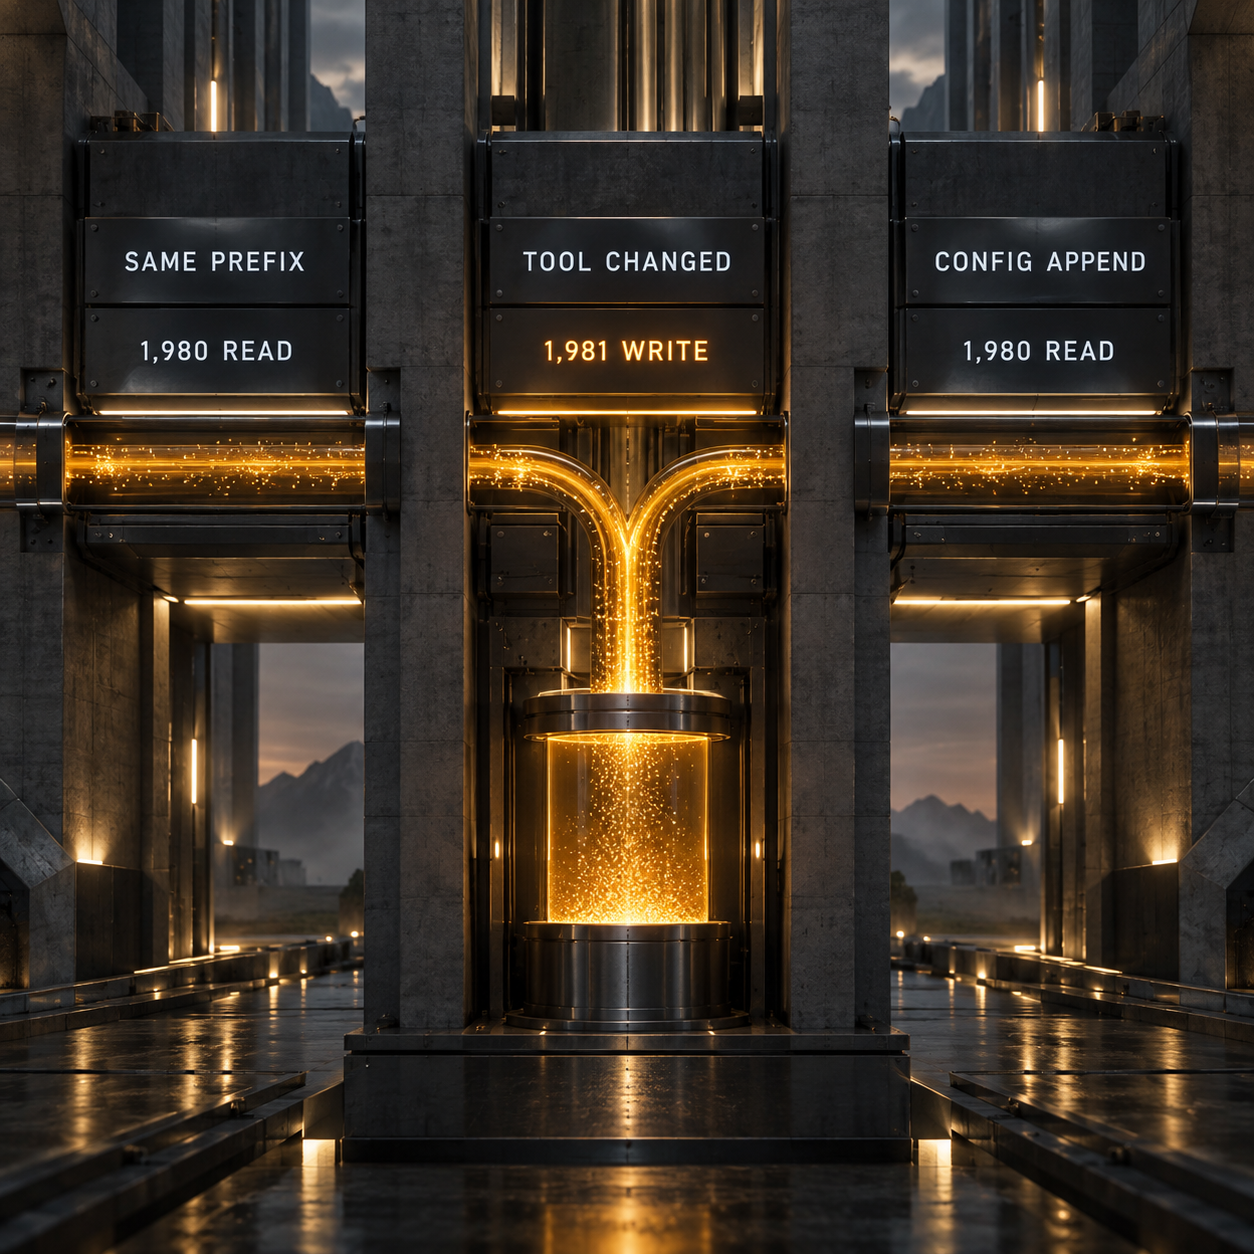
El cálculo utiliza las tarifas actuales de GPT-6 Sol Standard para contexto corto: $2 por millón de tokens de entrada ordinarios, $0.20 por millón de tokens de entrada en caché, $2.50 por millón de tokens escritos en caché y $10 por millón de tokens de salida. Cada respuesta consumió cinco tokens de salida.
Incluida la salida, la repetición exacta costó 91.0% menos que la respuesta de referencia. Para un agente de diez pasos con esta misma distribución de tokens, una escritura y nueve lecturas cuestan cerca de $0.009074. Diez escrituras nuevas cuestan alrededor de $0.05006. Mantener estable el prefijo reduce 81.9% el costo por paso completado en esta carga sintética.
Esa es la métrica que debe guiar la decisión. Un porcentaje de aciertos de caché puede parecer saludable aunque unos pocos turnos costosos y de contexto largo sigan reescribiendo el estado. Sume las clases de tokens y el costo real de las tareas completadas; después compare los resultados aceptados, los reintentos y los cargos por herramientas.
Los tiempos transcurridos no permiten concluir nada sobre la latencia. Las cuatro llamadas tardaron entre 892 y 1,254 milisegundos, y la repetición en caché no fue la más rápida. En una muestra tan pequeña, el ruido de red y enrutamiento domina el resultado. El costo sí cambió con claridad; para evaluar la latencia hacen falta mediciones repetidas y datos del tiempo hasta el primer token.
La integración sí reveló un fallo útil. Vercel AI Gateway reenvió prompt_cache_options, devolvió el ID de respuesta del proveedor OpenAI e informó las lecturas y escrituras de caché, pero omitió prompt_cache_diagnostics de su respuesta normalizada. Aun así, el fallo provocado era evidente: cero tokens en caché y 1,981 tokens escritos. Si hay un SDK o gateway entre su aplicación y OpenAI, compruebe que expone el nuevo campo de diagnóstico antes de depender de él en producción.
Corrija el prefijo antes de añadir puntos de corte
La mayoría de los fallos se originan en la forma habitual de construir las solicitudes. Corrija primero estos puntos:
- Mantenga sin cambios los nombres, las descripciones, los esquemas, la configuración y el orden de las herramientas. Use
tool_choice: "none"cuando no deba ejecutarse ninguna herramienta, oallowed_toolscuando solo se pueda invocar un subconjunto, pero conserve la lista completa de herramientas suministradas. - Mantenga estables el modelo, el nivel de servicio, el esquema de texto, el esfuerzo de razonamiento de la solicitud y el nivel de detalle en las solicitudes que deban compartir un prefijo.
- Coloque las marcas de tiempo, los ID de usuario, los ID de seguimiento y los datos propios de cada tarea después de las instrucciones y referencias estables.
- Añada mensajes y resultados de herramientas al final. Reescribir o resumir contenido anterior de la conversación cambia el prefijo.
- Compare cada corrección con la línea base prevista. Los diagnósticos solo informan la primera diferencia clasificada.
En GPT-6, cambie el esfuerzo mediante un elemento de conversación en lugar de modificar el ajuste de nivel superior. La siguiente solicitud conserva low en el nivel superior y aplica high al seguimiento.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
Las actualizaciones de configuración funcionan en la familia GPT-6 en modo estándar y de un solo agente, y solo modifican el esfuerzo de razonamiento. No coloque dos actualizaciones consecutivas. Tampoco se pueden combinar con compactación automática ni truncamiento automático.
La guía de migración a la API Responses explica la decisión más amplia sobre el estado. Para la caché, la idea esencial es más sencilla: mantenga los elementos anteriores en su sitio y añada el cambio al final.
Añada puntos de corte explícitos solo cuando compensen
Un punto de corte explícito resulta útil cuando la solicitud contiene un núcleo estable seguido de un sufijo que cambia con demasiada frecuencia como para justificar una escritura en caché. Coloque las instrucciones estables en un bloque input_text dentro de un mensaje de desarrollador, añada prompt_cache_breakpoint: {"mode":"explicit"} a ese bloque y configure prompt_cache_options.mode como explicit.
El campo instructions de nivel superior no admite un punto de corte explícito. En modo explícito, una solicitud sin marcador explícito no escribe en caché. Esa puede ser la decisión correcta para un prompt de una sola ejecución, porque escribir en caché cuesta 25% más que una entrada ordinaria y solo se amortiza si una solicitud posterior lo lee.
Una solicitud puede generar hasta cuatro escrituras de caché. No desperdicie esos espacios en cada mensaje. Elija límites que reflejen las bifurcaciones reales de la aplicación: una política empresarial compartida, el contexto de un espacio de trabajo, una rama de la conversación y, quizá, una rúbrica de evaluación estable.
El precalentamiento es una herramienta distinta, orientada a la latencia. Una solicitud con prompt_cache_options.prewarm: true prepara un contexto conocido sin generar salida; después, la solicitud del usuario envía el mismo prefijo. La llamada de precalentamiento se factura a la tarifa normal de escritura en caché, así que resérvela para tráfico predecible y mida el tiempo hasta el primer token.
Siete flujos de trabajo que más se benefician
1. Plataformas de agentes de programación
Un agente de programación envía una y otra vez mapas del repositorio, reglas de desarrollo, esquemas de herramientas y turnos anteriores. Mantenga esos bloques estables, añada al final los cambios de archivos y los resultados de herramientas, y bifurque las tareas en segundo plano a partir del historial compartido. El beneficio es un menor costo de contexto durante sesiones largas. Cambiar el nombre de una sola herramienta puede borrar el ahorro, por lo que este grupo es el que más se beneficia de una prueba de regresión de caché en CI.
2. Agentes de atención al cliente
Un equipo de soporte puede trabajar con un manual de políticas extenso, reglas del catálogo de productos y herramientas de escalamiento fijas. Coloque primero ese material compartido y añada después el caso actual. La política sintética medida reproduce este patrón. Con la misma estructura de solicitud, diez respuestas breves completadas pasaron de cerca de $0.05006 con escrituras repetidas a $0.009074 con una escritura y nueve lecturas.
3. Equipos de evaluación y calidad
Un evaluador puede reutilizar una rúbrica de calificación, ejemplos etiquetados, un esquema de salida y definiciones de herramientas, mientras cambia únicamente la interacción candidata al final. El modo explícito puede evitar que esa parte variable genere un cargo de escritura. Así, la caché pasa a formar parte de la economía unitaria de la evaluación en vez de quedar oculta como un detalle de plataforma.
4. Agentes de investigación y diligencia
Un flujo de investigación puede mantener estables un conjunto de fuentes verificadas y las reglas de análisis mientras añade preguntas nuevas. Los resúmenes bifurcados, las comprobaciones de contradicciones y las secciones de informes pueden compartir el mismo prefijo. El beneficio aumenta cuando varios procesos parten de la misma evidencia y producen entregables distintos.
5. Revisión contractual y de cumplimiento
Un equipo de operaciones legales puede colocar su biblioteca de cláusulas, su rúbrica de riesgos, el lenguaje aprobado y las herramientas de revisión antes del contrato que se va a examinar. Cada documento nuevo se convierte en el sufijo variable. La caché no hace más seguro el criterio, pero puede reducir el costo repetido de cargar los mismos controles.
6. Operaciones multiagente
Un orquestador puede conservar un plan común, el estado del espacio de trabajo y el historial de herramientas antes de abrir ramas para agentes especialistas. La reutilización de caché abarata las bifurcaciones cuando el prefijo compartido es grande. Mantenga estables las definiciones de herramientas y añada las recién descubiertas mediante un historial que solo crece, siempre que la aplicación lo permita.
7. Lanzamientos interactivos predecibles
Un producto con material de referencia conocido puede precalentar la caché durante el arranque, antes de la primera solicitud del usuario. Así, el procesamiento del prefijo queda fuera del tiempo de espera del usuario. Solo resulta útil si el tráfico llega con suficiente rapidez para reutilizar la entrada y si la mejora de latencia se mantiene en una prueba repetida y rigurosa.
Tres productos que vale la pena construir
1. CI para regresiones de caché, la oportunidad más sólida
Cree una puerta de control que reproduzca solicitudes representativas de agentes, compare cada respuesta con una línea base guardada y rechace una solicitud de cambios cuando bajen los tokens en caché o suban las escrituras. Los equipos de plataformas de agentes pagan por ello porque un cambio aparentemente inofensivo en el esquema de una herramienta puede convertir cada turno de producción en una escritura nueva.
La demanda es lo bastante pequeña para atenderla y lo bastante visible para justificarla: prompt caching recibe cerca de 1,300 búsquedas mensuales en Estados Unidos, openai prompt caching recibe 320 y la consulta exacta sobre la configuración de GPT-6 solo devolvió dos guías escritas independientes. Helicone ya cobra $79 al mes por un plan Pro con alertas e informes, señal de que los equipos reservan presupuesto para supervisar LLM.
La versión mínima vendible consiste en una CLI, una comprobación de GitHub y un informe que incluya el ID de la respuesta de referencia, la causa del diagnóstico, los tokens en caché, los tokens escritos, el tiempo transcurrido y el costo calculado. El obstáculo es el propio panel de OpenAI y sus diagnósticos. Para justificar su lugar, el producto necesita una puerta de despliegue, cobertura entre proveedores o atribución del cambio a una parte del código.
2. Un asignador de costos que entienda la caché
Cree un registro de costos por cliente para productos de IA que separe la entrada ordinaria, las lecturas de caché, las escrituras de caché, la salida y los cargos por herramientas. Los equipos financieros y de plataforma pagan cuando un prefijo compartido por el agente atiende a muchos clientes, pero el producto sigue necesitando márgenes defendibles por espacio de trabajo.
Cerca de 50 búsquedas mensuales en Estados Unidos apuntan a openai api prompt caching, y el conjunto activo de People Also Ask incluye “Should I use prompt caching?” y “When not to use caching?”. Langfuse ofrece planes de nube para producción de $29 y $199 al mes, otra señal de que ya existe presupuesto de software para seguir tokens y costos.
El MVP es un wrapper de SDK, una tabla de precios, etiquetas de inquilino y una vista por tarea completada. El verdadero reto es la atribución. GPT-5.6 y las versiones posteriores no necesitan prompt_cache_key para el enrutamiento, y las claves separadas existen principalmente para la contabilidad. Unos límites deficientes entre inquilinos pueden producir facturas confusas o inquietudes de privacidad.
3. Un monitor de conformidad para adaptadores
Cree un conjunto de pruebas que verifique si un SDK, proxy o gateway de modelos reenvía los campos nuevos de Responses y los devuelve intactos. Debería probar comparison_response_id, los tipos de diagnóstico, el detalle de tokens de caché, las actualizaciones de configuración, los puntos de corte explícitos y los ID de respuesta del proveedor después de cada actualización de dependencias.
La señal de demanda está en la brecha de conocimiento: what is prompt caching recibe cerca de 480 búsquedas mensuales en Estados Unidos, how does prompt caching work recibe 140 y “How do I turn on prompt caching?” aparece entre los resultados activos de People Also Ask. La ejecución directa también dejó al descubierto un fallo concreto: el gateway conservó los datos de uso, pero omitió el objeto de diagnóstico.
El MVP es una matriz de compatibilidad alojada y un comando que ejecuta cinco solicitudes sintéticas contra el endpoint del cliente. El reto es mantenerlo vigente. Los proveedores de gateways añadirán campos, así que el producto necesita pruebas continuas de protocolo entre proveedores, no un verificador puntual de GPT-6.
Límites y una valoración realista
Vale la pena diseñar para la caché de prompts cuando se repite un prefijo largo. No es un buen objetivo cuando las solicitudes son cortas, únicas o se reescriben constantemente cerca del comienzo.
El mínimo de 1,024 tokens importa. Rellenar un prompt pequeño solo para cumplirlo puede elevar el costo. Añadir ejemplos útiles y estables o material de referencia puede justificar los tokens adicionales, pero la decisión depende del número de reutilizaciones y de la calidad, no del deseo de ver un acierto de caché.
El estado de caché también tiene una dimensión física. Las entradas viven en máquinas individuales, y un tráfico superior a unas 15 solicitudes por minuto puede desbordarse hacia otras máquinas. El enrutamiento y la carga pueden provocar fallos aunque el contenido de la aplicación parezca estable. Un acierto de caché es el resultado de una optimización, no una garantía de corrección.
Las entradas en caché siguen contando para los límites de tokens por minuto. La caché no se puede vaciar de forma manual. La reutilización no modifica la generación de salida, así que solicitudes idénticas aún pueden producir respuestas distintas. En GPT-6 Sol, una solicitud que supere 272,000 tokens de entrada también pasa por completo a las tarifas más altas de contexto largo.
La regla operativa más importante es sencilla: siga el costo por tarea aceptada, mantenga estable el prefijo y trate cada aumento brusco de escrituras como un incidente que merece explicación.
La acción para el próximo lunes
El próximo lunes, elija un endpoint de agente en producción. Guarde el ID de una respuesta representativa, repita la misma tarea completada y registre los tokens en caché, los tokens escritos, el tiempo transcurrido, los tokens de salida y el costo total. Después, cambie la descripción o el nombre de una herramienta, compare con la misma línea base, restaure la lista de herramientas y ejecute de nuevo la prueba. Si la solicitud restaurada reduce el costo por tarea completada sin perjudicar la aceptación, añada esa prueba exacta a CI antes de modificar prompts o incorporar puntos de corte.
Preguntas frecuentes
¿Cómo se activa la caché de prompts?
Por lo general, no hace falta activarla. La caché de prompts viene habilitada de forma predeterminada en los modelos compatibles de OpenAI. Mantenga estables al menos 1,024 tokens visibles al principio de una solicitud a GPT-5.6 o una versión posterior, envíe una solicitud coincidente dentro de la ventana activa y revise cached_tokens. Use prompt_cache_options.mode solo si necesita controlar los puntos de corte de forma deliberada.
¿Qué es la caché de prompts y cómo funciona?
Guarda el estado de clave-valor que el modelo ya procesó para un prefijo exacto del prompt. La primera solicitud que cumple los requisitos escribe ese estado; las solicitudes posteriores que coincidan pueden leerlo en lugar de procesar otra vez el mismo prefijo. El contenido nuevo del sufijo y la generación de salida todavía requieren trabajo.
¿Cuándo no conviene usar la caché?
No la optimice cuando los prompts estén por debajo del mínimo, casi nunca se repitan, cambien cerca del principio o caduquen antes de que llegue otra solicitud. En modo explícito, omitir un punto de corte evita pagar la tarifa de escritura de 1.25× por un prefijo que no espera reutilizar.
¿Conviene usar la caché de prompts?
Úsela cuando la entrada repetida represente una parte significativa del costo por tarea completada. Mida una escritura y varias lecturas con sus herramientas reales y sus controles de aceptación. Una tasa de aciertos alta solo sirve si baja el costo total por tarea aceptada.
¿Cuál es la mejor estrategia de caché?
Empiece con la caché implícita automática. Coloque primero el contenido estable, añada después el contenido variable, mantenga fijas las herramientas y la configuración de la solicitud, y diagnostique los fallos. Incorpore puntos de corte explícitos solo alrededor de bloques estables que se reutilizarán lo suficiente para compensar el costo de escritura.
Si quiere incorporar esta medición y una puerta contra regresiones a su stack de agentes, sistemas de IA en producción es el punto de partida adecuado.
- Última actualización
- 27 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Precio de Copilot Managed Runtime: créditos, licencias y cargos
Guía del costo de Copilot Managed Runtime: créditos para crear y ejecutar apps, licencias de Power Apps Premium y cargos que se facturan por separado.26 sept 2026Build
Agentes de IA en n8n vs workflows: cuál usar y cuándo
Comparamos agentes de IA en n8n y workflows con 30 turnos de soporte: control, sesiones, costos y el diseño híbrido que conviene usar en producción.26 sept 2026Build
OpenRouter precios: cuánto cuesta realmente Jev Router
Jev Router figura a $0 en OpenRouter, pero la factura del modelo elegido no está clara. Revisamos qué cubre el precio y cómo verificar cada sesión completa.26 sept 2026Build
Publicar plugins de Claude: del repositorio al directorio
Aprenda a publicar plugins de Claude desde GitHub, validar el paquete, elegir quién será su propietario y enviar por separado cualquier conector MCP remoto.26 sept 2026Build
Cloudflare gratis: el precio real de MCP Portals
Cloudflare gratis incluye MCP Portals hasta 50 usuarios. Compara el plan Free, Pay-as-you-go, los gastos externos, los registros y la seguridad.26 sept 2026Build
Cómo mejorar el rendimiento GPU con Agentic CUDA Optimizer
Mejora el rendimiento GPU con Agentic CUDA Optimizer: prepara un kernel, limita la búsqueda a siete intentos y valida el ahorro antes de desplegarlo.25 sept 2026Build
Runpod pricing en 2026: cuándo elegir Pods o Serverless
Compara los precios de Runpod para Pods, Serverless y almacenamiento, con cálculos de H100 y el punto de equilibrio según el tiempo facturable.25 sept 2026Build