التخزين المؤقت للمطالبات في GPT-6: كيف تمنع قفزات التكلفة
دليل عملي إلى التخزين المؤقت للمطالبات في GPT-6: ثبّت البادئة، وقِس توكنات القراءة والكتابة، وشخّص الإخفاقات قبل أن ترتفع فاتورة الإنتاج لديك.



يخفض التخزين المؤقت للمطالبات تكلفة وكيل GPT-6 عندما تبقى التعليمات والأدوات والسياق المتكرر مطابقة تمامًا في بداية كل طلب. ففي تشغيل فعلي باستخدام GPT-6 Sol، أعاد طلب مطابق استخدام 1,980 توكنًا مخزنًا مؤقتًا، ولم تتجاوز تكلفته $0.000452. لكن تغيير اسم أداة واحدة أدى إلى كتابة البادئة من جديد ورفع التكلفة إلى $0.0050085. وتكشف لوحة المعلومات وأدوات التشخيص الصادرة في 22 سبتمبر هذا الفارق قبل أن يتحول إلى فاتورة إنتاج.
قاعدة التخزين المؤقت للمطالبات: الثابت أولًا والمتغير أخيرًا
يحتفظ التخزين المؤقت للمطالبات بالحالة التي عالجها النموذج لبادئة لم تتغير، أي المحتوى الموجود في مطلع الطلب. تخيل ورشة عمل تُترك جاهزة حتى اليوم التالي: يبقى دليل السياسات ورف الأدوات والقطعة نصف المكتملة في أماكنها، فتبدأ الوردية التالية من النقطة نفسها بدل إعادة تجهيز الورشة بالكامل.
لا تخزن OpenAI نسخة من مطالبتك، بل تخزن موترات المفتاح والقيمة التي تمثل حالة عمل النموذج. وتشمل الذاكرة المؤقتة كامل السياق بعد تجهيزه: تعليمات OpenAI ورسائل المطور وتعريفات الأدوات وسجل المحادثة. ولا يستطيع طلب لاحق إعادة استخدام هذا العمل إلا إلى أن يظهر أول اختلاف مؤثر في البادئة المجهزة.
لهذا يصبح ترتيب الطلب قرارًا ماليًا. ضع السياسات والمواد المرجعية والأمثلة وتعريفات الأدوات الثابتة أولًا، ثم أضف الطوابع الزمنية ومعرّفات الطلبات وبيانات العملاء والمهمة الحالية لاحقًا. فتعديل سطر مبكر قد يبطل كل ما يأتي بعده.
التخزين المؤقت للمطالبات مفعّل بالفعل في النماذج المدعومة. وفي GPT-5.6 وما بعده، تصبح البادئة مؤهلة عند بلوغ 1,024 توكن إدخال ظاهر. يكتب الطلب المؤهل الأول البادئة بتكلفة تعادل 1.25 ضعف سعر الإدخال العادي، بينما يقرأها الطلب المطابق بتكلفة تعادل 0.1 ضعف ذلك السعر. ويظل الإدخال مؤهلًا لمدة 30 دقيقة على الأقل بعد آخر كتابة أو إعادة استخدام.
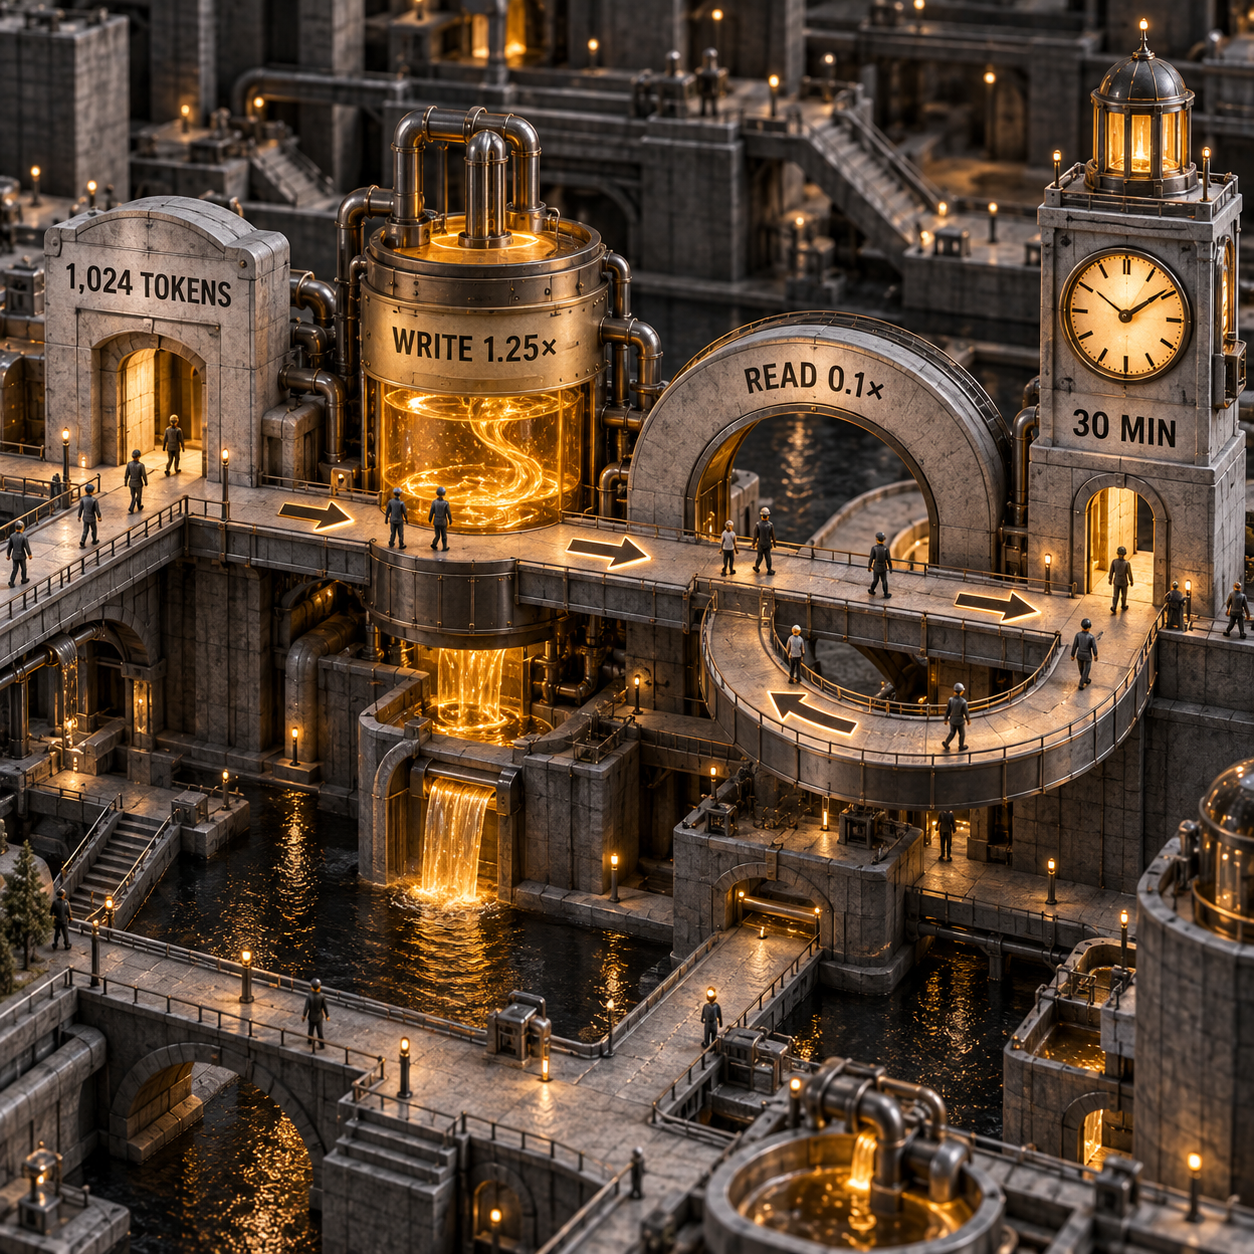
هذه آلية لإعادة استخدام البادئة، وليست مطابقة دلالية. فإذا حملت سياستان المعنى نفسه لكنهما اختلفتا قرب البداية، فستُعاملان كمدخلين مختلفين للذاكرة المؤقتة. وينطبق الأمر ذاته عند تغيير اسم أداة أو وصفها أو مخطط JSON أو الترتيب أو النموذج أو تنسيق المخرجات أو إعداد الاستدلال أو مستوى الإسهاب.
ما الذي تغير في 22 سبتمبر؟
تكمن الأهمية الأكبر في طبقة التشغيل الجديدة لا في الذاكرة المؤقتة نفسها. فقد أضاف إصدار OpenAI في 22 سبتمبر لوحة معلومات للتخزين المؤقت للمطالبات، وأدوات تشخيص تقارن بين الطلبات، وطريقة لتغيير جهد الاستدلال أثناء محادثة GPT-6 من دون كسر الذاكرة المؤقتة. وتقول OpenAI أيضًا إن عائلة GPT-6 تحقق معدلات إصابة أفضل افتراضيًا.
لا تخلط بين هذه الإضافات والآليات التي تعمل أيضًا مع GPT-5.6. يطبّق الدليل الحالي للتخزين المؤقت للمطالبات حدًا أدنى يبلغ 1,024 توكنًا، وسعر كتابة قدره 1.25×، وسعر قراءة قدره 0.1×، ونقاط فصل ضمنية وصريحة، ومدة صلاحية تبلغ 30 دقيقة على GPT-5.6 وما بعده.
تتناول مقارنة GPT-6 Sol وLuna الحالية قرار اختيار النموذج، ويأتي التخزين المؤقت بعده. فإذا حافظ نموذجان، أحدهما أرخص والآخر أعلى تكلفة، على بادئات ثابتة، ظلت المفاضلة النسبية بينهما كما هي.
ابدأ بالتخزين المؤقت التلقائي
التخزين التلقائي هو نقطة البداية الصحيحة، لأنه يمنحك خط أساس واضحًا بأقل تعديل ممكن على المطالبة. أرسل الطلب الحقيقي مرتين خلال نافذة الصلاحية، وثبّت كل حقل يؤثر في الذاكرة المؤقتة، ثم افحص الاستجابة الثانية.
الحقلان اللذان يحسمان حساب الفاتورة هما usage.input_tokens_details.cached_tokens وcache_write_tokens. يعني ارتفاع cached_tokens أن الطلب أعاد استخدام مدخلات عولجت سابقًا، بينما يعني ارتفاع cache_write_tokens أن الطلب دفع تكلفة إنشاء حالة جديدة في الذاكرة المؤقتة. أما توكنات الإدخال العادية فتساوي إجمالي الإدخال بعد طرح هذين العددين.
ويضيف مسار التشخيص الجديد سبب النتيجة إلى هذه الأرقام:
- احفظ معرّف استجابة مكتملة حديثة من المؤسسة نفسها.
- ضعه في
prompt_cache_options.comparison_response_idداخل الطلب الحالي. - اقرأ
prompt_cache_diagnosticsفي الاستجابة. - استخدم حقول الاستخدام، لا تقديرات التشخيص، لحساب الفاتورة.
قد تعرض واجهة Responses API المباشرة إحدى الحالات cache_hit أو cache_miss أو comparison_response_not_found أو unavailable. وعندما يكتشف نظام التشخيص تغير تعريف أداة، يصنف السبب على أنه tools_changed. أدوات التشخيص تقديرية وتعرض أول سبب أمكن تصنيفه؛ أصلح هذا السبب ثم أعد المقارنة.
هذا سكربت اختبار مختصر للاتصال المباشر بالواجهة. ويجب أن يحتوي ملف السياسات على قدر كافٍ من المحتوى الثابت المفيد لتجاوز الحد الأدنى البالغ 1,024 توكنًا.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
استخدم خط أساس حديثًا؛ فسجلات التشخيص تنتهي بعد مدة قصيرة. وتذكّر أن معرّف المقارنة لا يفعل سوى طلب تفسير، ولا يحمّل المحادثة السابقة ولا يصنع إصابة في الذاكرة المؤقتة بمفرده.
اختبار يتعمد كسر إصابة الذاكرة المؤقتة
استخدم الاختبار الفعلي GPT-6 Sol، وسياسة دعم اصطناعية بطول 1,635 كلمة، وأداة دالة واحدة، والمهمة القصيرة Reply with exactly OK.. أعاد النموذج OK في كل طلب، ولم يتغير سوى البنية التي تؤثر في الذاكرة المؤقتة.
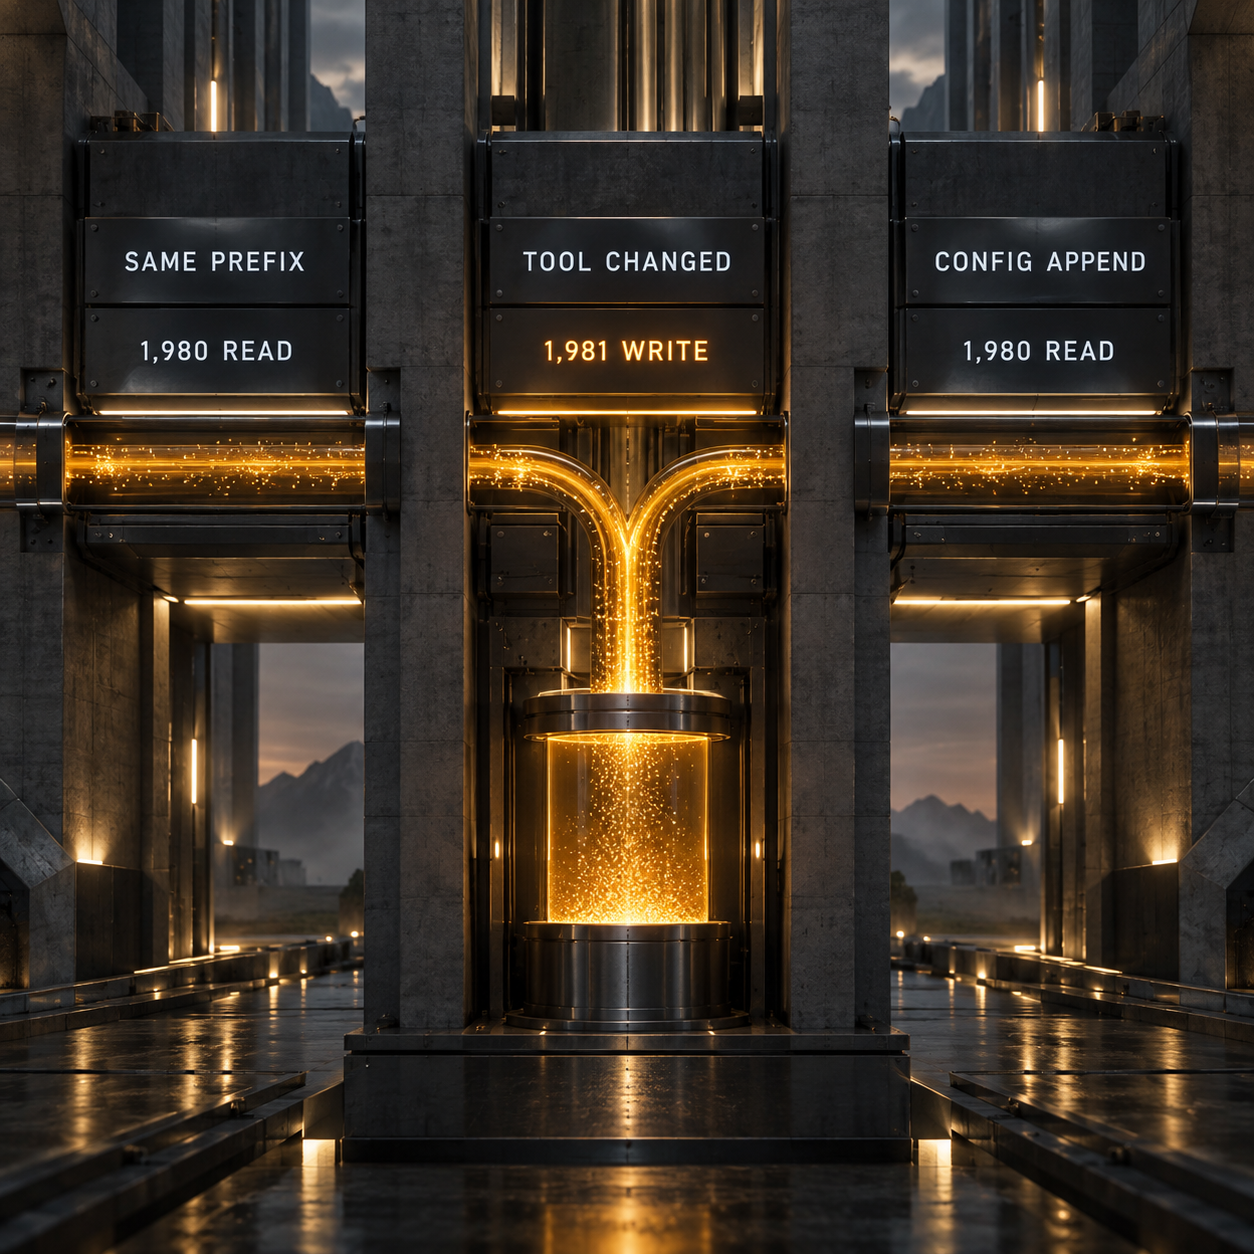
يستخدم حساب التكلفة أسعار GPT-6 Sol Standard الحالية للسياق القصير: $2 لكل مليون توكن إدخال عادي، و$0.20 لكل مليون توكن إدخال مخزن مؤقتًا، و$2.50 لكل مليون توكن كتابة في الذاكرة المؤقتة، و$10 لكل مليون توكن مخرجات. واستخدمت كل استجابة خمسة توكنات مخرجات.
كانت تكلفة التكرار المطابق أقل من استجابة خط الأساس بنسبة 91.0% بعد احتساب المخرجات. وبالنسبة إلى وكيل من عشر خطوات له شكل التوكنات نفسه، تبلغ تكلفة كتابة واحدة وتسع قراءات نحو $0.009074، مقابل نحو $0.05006 لعشر كتابات جديدة. وهكذا يخفض ثبات البادئة تكلفة الخطوة المكتملة بنسبة 81.9% في حمل العمل الاصطناعي هذا.
هذا هو مقياس القرار الحقيقي. فقد تبدو نسبة إصابات الذاكرة المؤقتة جيدة، مع استمرار بضعة أدوار طويلة السياق وعالية التكلفة في إعادة الكتابة. اجمع تكاليف فئات التوكنات الفعلية عبر المهام المكتملة، ثم قارن النتائج المقبولة وعمليات الإعادة ورسوم الأدوات.
لا تكفي الأزمنة المنقضية لإثبات تحسن زمن الاستجابة. تراوحت المكالمات الأربع بين 892 و1,254 مللي ثانية، ولم يكن التكرار المخزن مؤقتًا هو الأسرع. فضوضاء الشبكة والتوجيه تطغى على عينة بهذا الحجم. التغير في التكلفة واضح، أما زمن الاستجابة فيحتاج إلى قياسات متكررة وبيانات زمن الوصول إلى أول توكن.
وكشف الاختبار أيضًا عن مشكلة تكامل مفيدة. مرّرت Vercel AI Gateway الحقل prompt_cache_options، وأعادت معرّف استجابة مزود OpenAI، وأبلغت عن قراءات الذاكرة المؤقتة وكتابتها، لكن استجابتها الموحّدة أسقطت prompt_cache_diagnostics. ومع ذلك ظل الإخفاق المتعمد واضحًا: صفر من التوكنات المخزنة و1,981 توكن كتابة. إذا كانت هناك SDK أو بوابة بين تطبيقك وOpenAI، فتحقق من أنها تعرض حقل التشخيص الجديد قبل الاعتماد عليه في الإنتاج.
أصلح البادئة قبل إضافة نقاط الفصل
تنشأ معظم الإخفاقات من تفاصيل اعتيادية في بناء الطلب. أصلحها أولًا:
- أبقِ أسماء الأدوات وأوصافها ومخططاتها وإعداداتها وترتيبها بلا تغيير. استخدم
tool_choice: "none"عندما لا ينبغي تشغيل أي أداة، أوallowed_toolsعندما تريد إتاحة مجموعة فرعية فقط، مع الاحتفاظ بالقائمة الكاملة للأدوات المرسلة. - ثبّت النموذج وطبقة الخدمة ومخطط النص وجهد الاستدلال على مستوى الطلب ومستوى الإسهاب في الطلبات التي يُفترض أن تتشارك بادئة واحدة.
- انقل الطوابع الزمنية ومعرّفات المستخدم والتتبع وبيانات كل مهمة إلى ما بعد التعليمات والمراجع الثابتة.
- ألحق الرسائل ونتائج الأدوات بدل تعديل محتوى المحادثة السابق أو تلخيصه، لأن ذلك يغير البادئة.
- قارن بخط الأساس المقصود بعد كل إصلاح، إذ لا تعرض أدوات التشخيص سوى أول اختلاف مصنف.
في GPT-6، غيّر جهد الاستدلال بعنصر داخل المحادثة بدل تعديل إعداد المستوى الأعلى. يبقى الطلب التالي عند low على المستوى الأعلى، ثم يطبق high على المتابعة.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
تعمل تحديثات الإعداد مع عائلة GPT-6 في الوضع القياسي أحادي الوكيل، ولا تغيّر سوى جهد الاستدلال. لا تضع تحديثين متجاورين، كما لا يمكن الجمع بينها وبين الضغط التلقائي أو الاقتطاع التلقائي.
يشرح دليل الانتقال إلى Responses API قرار إدارة الحالة الأوسع. أما في التخزين المؤقت، فالقاعدة أبسط: أبقِ العناصر القديمة في مواضعها وألحق التغيير.
لا تضف نقاط فصل صريحة إلا حين تحقق عائدًا
تفيد نقطة الفصل الصريحة عندما يحتوي الطلب على نواة ثابتة تتبعها لاحقة تتغير أكثر مما يستحق تكلفة كتابتها إلى الذاكرة المؤقتة. ضع التعليمات الثابتة في كتلة input_text داخل رسالة مطور، وأضف prompt_cache_breakpoint: {"mode":"explicit"} إلى تلك الكتلة، واضبط prompt_cache_options.mode على explicit.
لا يمكن أن تحمل instructions على المستوى الأعلى نقطة فصل صريحة. وفي الوضع الصريح، لا ينفذ الطلب الخالي من علامة صريحة أي كتابة إلى الذاكرة المؤقتة. قد يكون هذا هو القرار الصحيح لمطالبة تستخدم مرة واحدة، لأن كتابة الذاكرة المؤقتة تكلف أكثر من الإدخال العادي بنسبة 25% ولا تسترد هذه الزيادة إلا عندما يقرأها طلب لاحق.
يمكن للطلب إنشاء ما يصل إلى أربع عمليات كتابة في الذاكرة المؤقتة. فلا تهدر هذه المواضع عند كل رسالة، بل اختر حدودًا تعكس تفرعات التطبيق الحقيقية: سياسة شركة مشتركة، أو سياق مساحة عمل، أو تفرع محادثة، وربما معيار تقييم ثابت.
أما التهيئة المسبقة فهي أداة مستقلة لتحسين زمن الاستجابة. فالطلب الذي يتضمن prompt_cache_options.prewarm: true يجهز السياق المعروف من دون إنشاء مخرجات، ثم يرسل طلب المستخدم البادئة نفسها. وتحاسب مكالمة التهيئة بسعر الكتابة العادي للذاكرة المؤقتة، لذا استخدمها مع حركة يمكن توقعها وقِس زمن الوصول إلى أول توكن.
سبعة مسارات عمل تستفيد أكثر من غيرها
1. منصات وكلاء البرمجة
يرسل وكيل البرمجة مرارًا خرائط المستودعات وقواعد المطور ومخططات الأدوات والأدوار السابقة. أبقِ هذه الكتل ثابتة، وألحق تغييرات الملفات ونتائج الأدوات، وأنشئ المهام الخلفية انطلاقًا من السجل المشترك. العائد هو خفض تكلفة السياق خلال الجلسات الطويلة. لكن إعادة تسمية أداة واحدة قد تمحو الوفر، لذلك تستفيد هذه الفئة أكثر من غيرها من اختبار تراجع الذاكرة المؤقتة ضمن CI.
2. وكلاء دعم العملاء
قد يعتمد فريق الدعم على دليل سياسات طويل وقواعد لكتالوج المنتجات وأدوات تصعيد ثابتة. ضع هذه المواد المشتركة أولًا، ثم أضف التذكرة الحالية. وهذا هو النمط الذي تحاكيه السياسة الاصطناعية المقاسة. ومع شكل الطلب نفسه، انخفضت تكلفة عشر استجابات قصيرة مكتملة من نحو $0.05006 عند تكرار الكتابة إلى $0.009074 بكتابة واحدة وتسع قراءات.
3. فرق التقييم والجودة
يستطيع نظام التقييم إعادة استخدام معيار الدرجات والأمثلة المصنفة ومخطط المخرجات وتعريفات الأدوات، مع تغيير التفاعل المرشح في النهاية فقط. ويمكن للوضع الصريح منع كتابة المرشح المتغير إلى الذاكرة المؤقتة. بذلك تصبح الذاكرة المؤقتة جزءًا من اقتصاديات وحدة التقييم بدل أن تظل تفصيلًا خفيًا في المنصة.
4. وكلاء البحث والعناية الواجبة
يمكن لمسار بحث أن يثبت حزمة مصادر مدققة وقواعد التحليل، ثم يلحق الأسئلة الجديدة. وتستطيع الملخصات المتفرعة وفحوص التناقض وأقسام المذكرات مشاركة البادئة نفسها. ويزداد العائد عندما تبدأ عدة جهات منفذة من الأدلة نفسها وتنتج مخرجات مختلفة.
5. مراجعة العقود والامتثال
يمكن لفريق العمليات القانونية وضع مكتبة البنود ومعيار المخاطر والصياغات المعتمدة وأدوات المراجعة قبل العقد الجاري فحصه، ليصبح كل مستند جديد هو اللاحقة المتغيرة. لا تجعل الذاكرة المؤقتة الحكم أكثر أمانًا، لكنها قد تخفض التكلفة المتكررة لتحميل الضوابط نفسها.
6. عمليات متعددة الوكلاء
يستطيع المنسق الحفاظ على خطة مشتركة وحالة مساحة العمل وسجل الأدوات قبل التفرع إلى وكلاء متخصصين. وتقلل إعادة استخدام الذاكرة المؤقتة تكلفة الفروع عندما تكون البادئة المشتركة كبيرة. أبقِ تعريفات الأدوات ثابتة، وأضف الأدوات المكتشفة حديثًا من خلال سجل لا يقبل إلا الإلحاق عندما يدعم التطبيق ذلك.
7. إطلاقات تفاعلية متوقعة
يستطيع منتج يملك مواد مرجعية معروفة تنفيذ التهيئة المسبقة عند بدء التشغيل وقبل أول طلب للمستخدم، لينقل معالجة البادئة إلى خارج وقت انتظاره. ولا يفيد ذلك إلا إذا وصلت الحركة في وقت يسمح بإعادة استخدام الإدخال، وإذا ظل تحسن زمن الاستجابة قائمًا في اختبار متكرر سليم.
ثلاثة منتجات تستحق البناء
1. Cache Regression CI: الفرصة الأقوى
ابنِ بوابة اختبار تعيد تشغيل طلبات تمثيلية لوكيل، وتقارن كل استجابة بخط أساس محفوظ، وترفض طلب الدمج عندما تنخفض التوكنات المخزنة أو تقفز عمليات الكتابة. ستدفع فرق منصات الوكلاء مقابل ذلك، لأن تعديلًا بسيطًا في مخطط أداة قد يحول كل دور في الإنتاج إلى كتابة جديدة.
الطلب صغير بما يكفي لخدمته وكبير بما يكفي ليُلاحظ: يجذب prompt caching نحو 1,300 عملية بحث شهريًا في الولايات المتحدة، ويجذب openai prompt caching نحو 320، بينما لم يُظهر استعلام إعداد GPT-6 المطابق سوى دليلين مكتوبين مستقلين. وتفرض Helicone بالفعل $79 شهريًا على خطة Pro التي تشمل التنبيهات والتقارير، ما يثبت أن الفرق تخصص ميزانية لمراقبة LLM.
أصغر نسخة قابلة للبيع هي CLI وفحص GitHub وتقرير واحد يعرض معرّف استجابة خط الأساس وسبب التشخيص والتوكنات المخزنة وتوكنات الكتابة والزمن المنقضي والتكلفة المحسوبة. أما التحدي فهو لوحة OpenAI وأدوات التشخيص الخاصة بها. يحتاج المنتج إلى بوابة نشر أو تغطية عبر مزودين متعددين أو إسناد التغيير إلى موضعه في الشفرة كي يستحق اعتماده.
2. موزّع تكاليف يراعي الذاكرة المؤقتة
ابنِ دفتر تكاليف لكل عميل في منتجات AI يفصل الإدخال العادي وقراءات الذاكرة المؤقتة وكتابتها والمخرجات ورسوم الأدوات. ستدفع فرق المالية والمنصات عندما تخدم بادئة وكيل مشتركة عددًا كبيرًا من العملاء، بينما يظل المنتج بحاجة إلى هوامش ربح يمكن تبريرها على مستوى مساحة العمل.
يستهدف نحو 50 بحثًا شهريًا في الولايات المتحدة عبارة openai api prompt caching، وتتضمن أسئلة People Also Ask الفعلية: “Should I use prompt caching?” و“When not to use caching?”. وتسعّر Langfuse خططها السحابية للإنتاج عند $29 و$199 شهريًا، وهي إشارة أخرى إلى وجود ميزانية برمجية لتتبع التوكنات والتكلفة.
الحد الأدنى للمنتج هو غلاف SDK وجدول أسعار ووسوم للمستأجرين وعرض للمهام المكتملة. أما التحدي الصريح فهو الإسناد؛ فنماذج GPT-5.6 وما بعدها لا تحتاج إلى prompt_cache_key للتوجيه، وتوجد المفاتيح المنفصلة أساسًا للمحاسبة. وقد يؤدي ضعف الفصل بين المستأجرين إلى فواتير مربكة أو مخاوف تتعلق بالخصوصية.
3. مراقب توافق المهايئات
ابنِ حزمة اختبارات تتحقق مما إذا كانت SDK أو الوسيط أو بوابة النماذج تمرر حقول Responses الجديدة وتعيدها سليمة. تختبر الحزمة comparison_response_id وأنواع التشخيص وتفاصيل توكنات الذاكرة المؤقتة وتحديثات الإعداد ونقاط الفصل الصريحة ومعرّفات استجابة المزود بعد كل ترقية للاعتماديات.
تظهر إشارة الطلب في فجوة التعلم: تحصل عبارة what is prompt caching على نحو 480 عملية بحث شهريًا في الولايات المتحدة، وتحصل how does prompt caching work على 140، كما يظهر سؤال “How do I turn on prompt caching?” ضمن نتائج People Also Ask الفعلية. وكشف التشغيل العملي أيضًا إخفاقًا ملموسًا: حافظت البوابة على بيانات الاستخدام لكنها حذفت كائن التشخيص.
الحد الأدنى للمنتج هو مصفوفة توافق مستضافة وأمر يشغل خمسة طلبات اصطناعية على نقطة نهاية العميل. أما التحدي فهو الاستمرارية؛ إذ ستضيف شركات البوابات الحقول بمرور الوقت، لذلك يحتاج المنتج إلى اختبار متواصل للبروتوكول عبر المزودين بدل أداة تحقق مؤقتة خاصة بـGPT-6.
القيود والخلاصة الصريحة
يستحق التخزين المؤقت للمطالبات أن تراعيه في التصميم عندما تتكرر بادئة طويلة، لكنه هدف سيئ عندما تكون الطلبات قصيرة أو فريدة أو يعاد تعديل بدايتها باستمرار.
حد 1,024 توكنًا مهم. فقد يؤدي حشو مطالبة صغيرة لمجرد التأهل إلى رفع التكلفة. وربما تبرر الأمثلة المفيدة الثابتة أو المواد المرجعية إضافة التوكنات، لكن القرار يعتمد على عدد مرات إعادة الاستخدام والجودة، لا على الرغبة في رؤية إصابة في الذاكرة المؤقتة.
لحالة الذاكرة المؤقتة جانب مادي أيضًا. تعيش الإدخالات على أجهزة منفردة، وقد يؤدي ارتفاع الحركة فوق نحو 15 طلبًا في الدقيقة إلى توزيعها على أجهزة أخرى. وهكذا يمكن للتوجيه والحمل أن يصنعا إخفاقات حتى عندما يبدو محتوى التطبيق ثابتًا. إصابة الذاكرة المؤقتة ثمرة تحسين، وليست ضمانًا لصحة التشغيل.
تظل المدخلات المخزنة محسوبة ضمن حدود التوكنات في الدقيقة. ولا يمكن مسح الذاكرة المؤقتة يدويًا. كذلك لا تغير إعادة الاستخدام آلية توليد المخرجات، لذا قد تنتج الطلبات المتطابقة إجابات مختلفة. وفي GPT-6 Sol، يؤدي تجاوز الطلب 272,000 توكن إدخال إلى نقل الطلب بأكمله إلى أسعار السياق الطويل الأعلى.
قاعدة التشغيل الأقوى بسيطة: تتبع تكلفة كل مهمة مقبولة، وثبّت البادئة، وتعامل مع كل قفزة في الكتابة كحادث يستحق التفسير.
خطوة يوم الاثنين
اختر نقطة نهاية واحدة لوكيل إنتاج يوم الاثنين المقبل. احفظ معرّف استجابة تمثيلية، وأعد تشغيل المهمة المكتملة نفسها، وسجل التوكنات المخزنة وتوكنات الكتابة والزمن المنقضي وتوكنات المخرجات والتكلفة الإجمالية. بعد ذلك، غيّر وصف أداة واحدة أو اسمها، وقارن النتيجة بخط الأساس نفسه، ثم أعد قائمة الأدوات وشغل الاختبار مجددًا. إذا خفّض الطلب المستعاد تكلفة المهمة المكتملة من دون الإضرار بالقبول، فأضف هذا الاختبار نفسه إلى CI قبل تغيير المطالبات أو إضافة نقاط الفصل.
الأسئلة الشائعة
كيف أفعّل التخزين المؤقت للمطالبات؟
لا تحتاج عادةً إلى تفعيله؛ فهو يعمل افتراضيًا في نماذج OpenAI المدعومة. حافظ على ثبات 1,024 توكنًا ظاهرًا على الأقل في بداية طلب يستخدم GPT-5.6 أو إصدارًا أحدث، وأرسل طلبًا مطابقًا خلال نافذة الصلاحية، ثم افحص cached_tokens. ولا تستخدم prompt_cache_options.mode إلا عندما تحتاج إلى تحكم مقصود في نقاط الفصل.
ما التخزين المؤقت للمطالبات، وكيف يعمل؟
يحفظ حالة المفتاح والقيمة التي عالجها النموذج لبادئة مطالبة مطابقة. يكتب الطلب المؤهل الأول هذه الحالة، ثم تقرؤها الطلبات المطابقة اللاحقة بدل معالجة البادئة نفسها من جديد. أما محتوى اللاحقة الجديدة وتوليد المخرجات فيظلان بحاجة إلى المعالجة.
متى ينبغي ألا أستخدم التخزين المؤقت؟
لا تحسّن طلباتك من أجله إذا كانت أقصر من الحد الأدنى، أو نادرًا ما تتكرر، أو تتغير قرب البداية، أو تنتهي صلاحيتها قبل وصول طلب آخر. وفي الوضع الصريح، يؤدي حذف نقطة الفصل إلى تجنب دفع سعر الكتابة البالغ 1.25× لبادئة لا تتوقع إعادة استخدامها.
هل ينبغي أن أستخدم التخزين المؤقت للمطالبات؟
استخدمه عندما يمثل الإدخال المتكرر جزءًا مؤثرًا من تكلفة المهمة المكتملة. قِس كتابة واحدة وعدة قراءات باستخدام أدواتك الحقيقية وفحوص القبول لديك. ولا تكون نسبة الإصابة المرتفعة مفيدة إلا إذا انخفضت التكلفة الإجمالية لكل مهمة مقبولة.
ما أفضل استراتيجية للتخزين المؤقت؟
ابدأ بالتخزين التلقائي الضمني. ضع المحتوى الثابت أولًا، وألحق المحتوى المتغير، وثبّت الأدوات وإعدادات الطلب، وشخّص الإخفاقات. ولا تضف نقاط فصل صريحة إلا حول الكتل الثابتة التي ستُعاد قراءتها بما يكفي لاسترداد تكلفة الكتابة.
إذا أردت دمج هذا القياس وبوابة منع التراجع في بنية وكيلك، فإن أنظمة AI للإنتاج هي نقطة البداية المناسبة.
- آخر تحديث
- 27 سبتمبر 2026
- التصنيف
- Build
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.
أسعار Copilot Managed Runtime: دليلك إلى الفاتورة الفعلية
افهم أسعار Copilot Managed Runtime بندًا بندًا: Copilot Credits، واستدعاءات API، والاستضافة، وPower Apps Premium، وحدود نقطة التعادل قبل إعداد ميزانية التطبيق.26 سبتمبر 2026Build
n8n AI Agent أم سير العمل؟ دليل عملي للاختيار
مقارنة عملية بين n8n AI Agent وسير العمل: متى تحتاج قرارًا حواريًا، ومتى يكون المسار الثابت أكثر أمانًا؟ مع نتائج اختبار التكلفة والتنفيذ المقاسة.26 سبتمبر 2026Build
هل Jev Router مجاني فعلًا؟ أين تظهر تكلفة الجلسة
هل Jev Router مجاني فعلًا؟ نوضح ما يغطيه سعر $0، وأين قد تظهر تكلفة النموذج المختار، وكيف تتحقق من usage.cost وسجل الجلسة قبل اعتماد الميزانية.26 سبتمبر 2026Build
إضافات Claude: دليل النشر من GitHub إلى الدليل العام
دليل عملي لنشر إضافات Claude من مستودع GitHub عبر بوابة المطورين، مع شرح الملكية والتحقق والمراجعة، ومتى يلزم إرسال خادم MCP في قائمة موصل مستقلة.26 سبتمبر 2026Build
هل Cloudflare مجاني؟ تكلفة بوابات MCP وحدود الخطة
هل بوابات Cloudflare MCP مجانية فعلًا؟ تعرّف إلى حد 50 مستخدمًا، وتكلفة Pay-as-you-go، وما لا يشمله سعر البوابة من نماذج واستضافة وأمان مؤسسي.26 سبتمبر 2026Build
تحسين GPU عمليًا باستخدام Agentic CUDA Optimizer
دليل عملي لتحسين GPU عبر Agentic CUDA Optimizer: ثبّت بيئة الاختبار، نفّذ سبع محاولات، راجع الأدلة، ثم احسب جدوى النواة قبل اعتمادها في الإنتاج.25 سبتمبر 2026Build
Runpod pricing: احسب تكلفة Pods وServerless بالوقت المدفوع
دليل عملي لفهم أسعار Runpod ومقارنة Secure Cloud Pods مع Serverless Flex، مع نقطة التعادل وتكاليف التخزين ونماذج حساب واضحة قبل اعتماد ميزانية H100.25 سبتمبر 2026Build