LLM Caching mit GPT-6: Kosten messen, Cache-Fehler finden
LLM Caching mit GPT-6 senkt wiederkehrende Eingabekosten. So zeigen Dashboard, Diagnosen und Tokenwerte, wo Cache-Treffer in der Praxis verloren gehen.



LLM Caching macht einen GPT-6-Agenten günstiger, wenn wiederkehrende Anweisungen, Tools und Kontext am Anfang jeder Anfrage exakt gleich bleiben. In einem Live-Test mit GPT-6 Sol wurden bei einer identischen Wiederholung 1,980 gecachte Tokens wiederverwendet; die Kosten lagen bei $0.000452. Schon die Änderung eines einzigen Toolnamens schrieb den Präfix neu und erhöhte die Kosten auf $0.0050085. Mit dem Dashboard und den Diagnosen vom 22. September wird dieser Unterschied sichtbar, bevor er sich in der Produktionsrechnung niederschlägt.
LLM Caching: Erst stabil, dann variabel
Prompt Caching speichert den bereits verarbeiteten Zustand eines unveränderten Präfixes, also des Inhalts am Anfang einer Anfrage. Das lässt sich mit einer Werkstatt vergleichen, die über Nacht eingerichtet bleibt: Handbuch, Werkzeugwand und das halbfertige Werkstück bleiben an ihrem Platz. Die nächste Schicht kann dort weitermachen, statt alles erneut aufzubauen.
OpenAI speichert Key-Value-Tensoren – den Arbeitszustand des Modells – und nicht etwa eine Kopie des Prompts. Der Cache umfasst den vollständig gerenderten Kontext: OpenAI-Anweisungen, Entwicklermeldungen, Tooldefinitionen und den bisherigen Gesprächsverlauf. Eine spätere Anfrage kann diese Vorarbeit nur bis zur ersten relevanten Abweichung im gerenderten Präfix wiederverwenden.
Damit wird die Reihenfolge innerhalb einer Anfrage zur Kostenfrage. Stabile Richtlinien, Referenzmaterial, Beispiele und Tooldefinitionen gehören nach vorn. Zeitstempel, Anfrage-IDs, Kundendaten und die aktuelle Aufgabe folgen danach. Wer eine frühe Zeile ändert, kann damit alles entwerten, was dahinter liegt.
Prompt Caching ist bei unterstützten Modellen bereits aktiviert. Ab GPT-5.6 kommt ein Präfix ab 1,024 sichtbaren Eingabetokens für den Cache infrage. Die erste geeignete Anfrage schreibt den Präfix zum 1.25-Fachen des regulären Eingabepreises. Eine passende Folgeanfrage liest ihn zum 0.1-Fachen des regulären Preises. Der Eintrag bleibt nach dem letzten Schreiben oder Wiederverwenden mindestens 30 Minuten lang verfügbar.
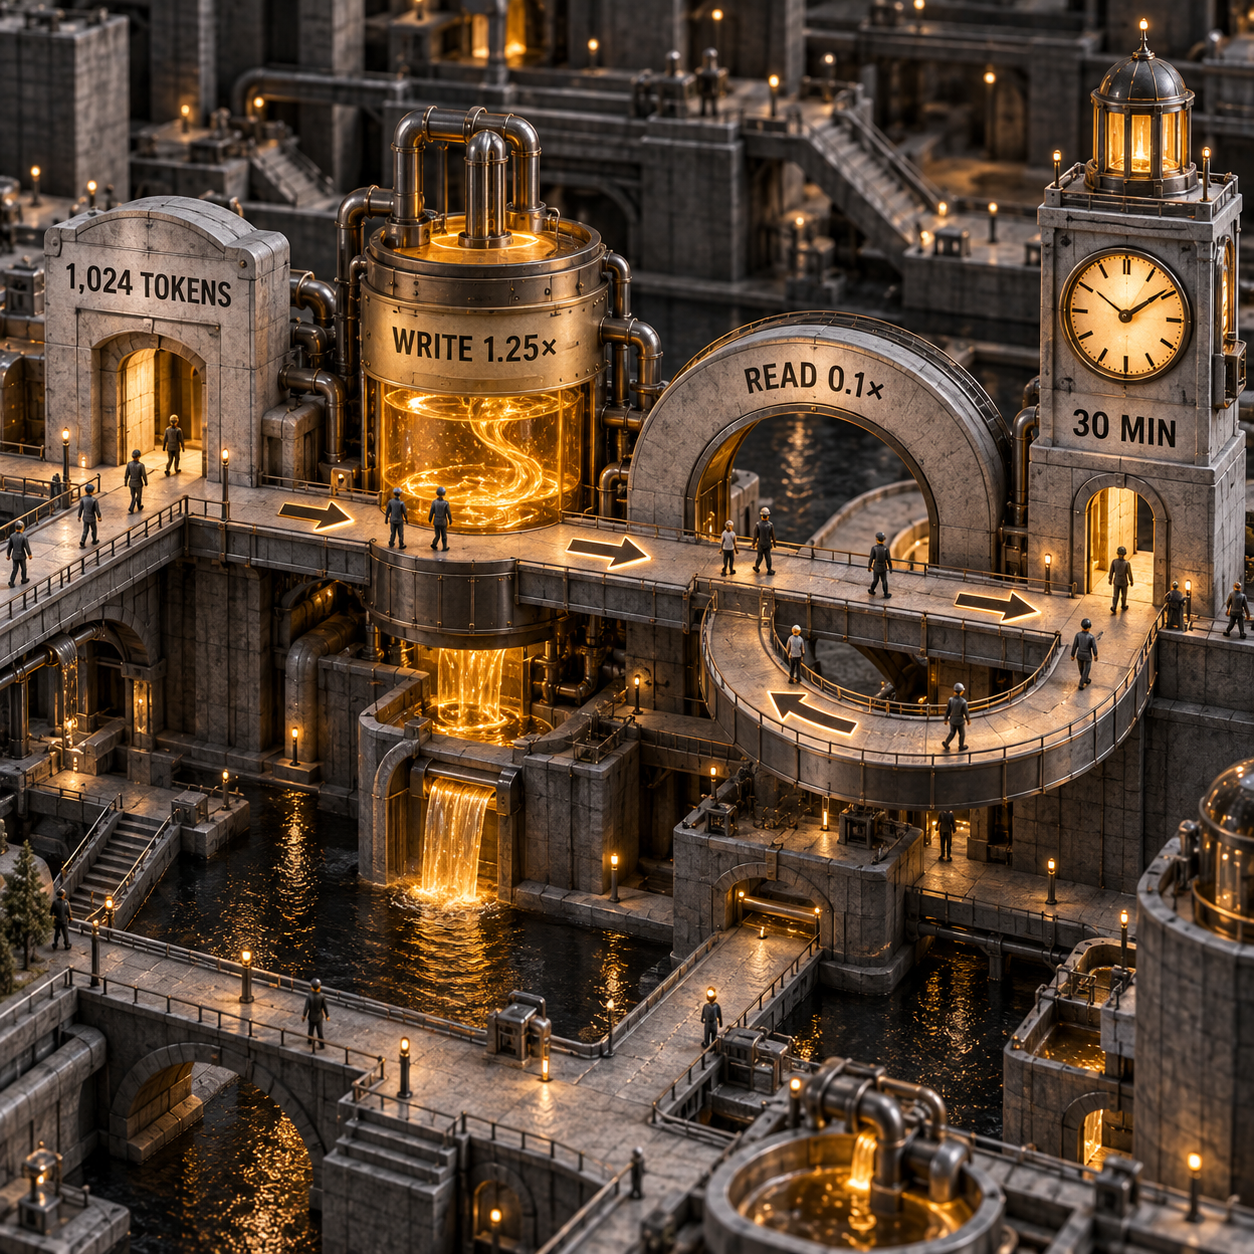
Entscheidend ist die Wiederverwendung des Präfixes, nicht die semantische Ähnlichkeit. Zwei Richtlinien mit derselben Bedeutung, aber unterschiedlichem Wortlaut am Anfang sind für den Cache zwei verschiedene Eingaben. Das gilt ebenso, wenn sich Toolname, Beschreibung, JSON-Schema, Reihenfolge, Modell, Ausgabeformat, Reasoning-Einstellung oder Ausführlichkeit ändern.
Was sich am 22. September geändert hat
Wichtiger als der Cache selbst ist die neue Betriebsebene. Mit dem Release vom 22. September führte OpenAI ein Prompt-Caching-Dashboard, Diagnosen zum Vergleich von Anfragen und eine cachefreundliche Möglichkeit ein, den Reasoning-Aufwand während einer GPT-6-Unterhaltung zu ändern. Nach Angaben von OpenAI erzielt die GPT-6-Familie außerdem standardmäßig bessere Trefferquoten.
Diese Neuerungen dürfen nicht mit den Mechanismen verwechselt werden, die auch für GPT-5.6 gelten. Der aktuelle Leitfaden zu Prompt Caching nennt für GPT-5.6 und neuere Modelle dieselben Eckdaten: mindestens 1,024 Tokens, einen Schreibpreis von 1.25×, einen Lesepreis von 0.1×, implizite und explizite Breakpoints sowie eine TTL von 30 Minuten.
Der vorhandene Vergleich von GPT-6 Sol und Luna hilft bei der Modellwahl. Erst danach kommt das Caching. Ob günstigeres oder teureres Modell: Bei stabilen Präfixen bleibt das relative Verhältnis zwischen den Modellen bestehen.
Prompt Caching aktivieren: Mit Automatik beginnen
Automatisches Caching ist der richtige Ausgangspunkt. Es liefert mit fast unverändertem Prompt eine saubere Vergleichsbasis. Dazu wird die echte Anfrage innerhalb des aktiven Zeitfensters zweimal gesendet, wobei alle cacheempfindlichen Felder unverändert bleiben. Anschließend wird die zweite Antwort geprüft.
Für die Abrechnung sind zwei Felder ausschlaggebend: usage.input_tokens_details.cached_tokens und cache_write_tokens. Ein hoher Wert bei cached_tokens zeigt, dass bereits verarbeitete Eingaben wiederverwendet wurden. Ein hoher Wert bei cache_write_tokens bedeutet, dass die Anfrage für einen neuen Cache-Zustand bezahlt hat. Reguläre Eingabetokens ergeben sich aus der Gesamteingabe abzüglich dieser beiden Werte.
Der neue Diagnoseablauf ergänzt diese Zahlen um ihre Ursache:
- Die ID einer kürzlich abgeschlossenen Antwort derselben Organisation speichern.
- Diese ID in der aktuellen Anfrage unter
prompt_cache_options.comparison_response_ideintragen. - In der Antwort
prompt_cache_diagnosticsauslesen. - Für die Abrechnung die Nutzungsfelder verwenden, nicht die Schätzwerte der Diagnose.
Die direkte Responses API kann cache_hit, cache_miss, comparison_response_not_found oder unavailable melden. Eine geänderte Tooldefinition wird als tools_changed klassifiziert, sofern das Diagnosesystem sie erkennt. Die Diagnose arbeitet nach bestem Bemühen und nennt nur die erste klassifizierte Ursache. Deshalb sollte zunächst dieser Grund behoben und anschließend erneut verglichen werden.
Das folgende kompakte Testskript spricht die API direkt an. Die Richtliniendatei muss genügend sinnvollen, stabilen Inhalt enthalten, um die Mindestgrenze von 1,024 Tokens zu überschreiten.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
Als Basis sollte eine aktuelle Antwort dienen. Diagnoseeinträge laufen nach kurzer Zeit ab; außerdem fordert die Vergleichs-ID lediglich eine Erklärung an. Sie lädt weder die frühere Unterhaltung noch erzeugt sie selbst einen Cache-Treffer.
Ein bewusst zerstörter Cache-Treffer
Im Live-Test kamen GPT-6 Sol, eine synthetische Supportrichtlinie mit 1,635 Wörtern, ein Funktionstool und die kurze Aufgabe Reply with exactly OK. zum Einsatz. Bei jeder Anfrage antwortete das Modell mit OK. Geändert wurde ausschließlich die cacheempfindliche Struktur.
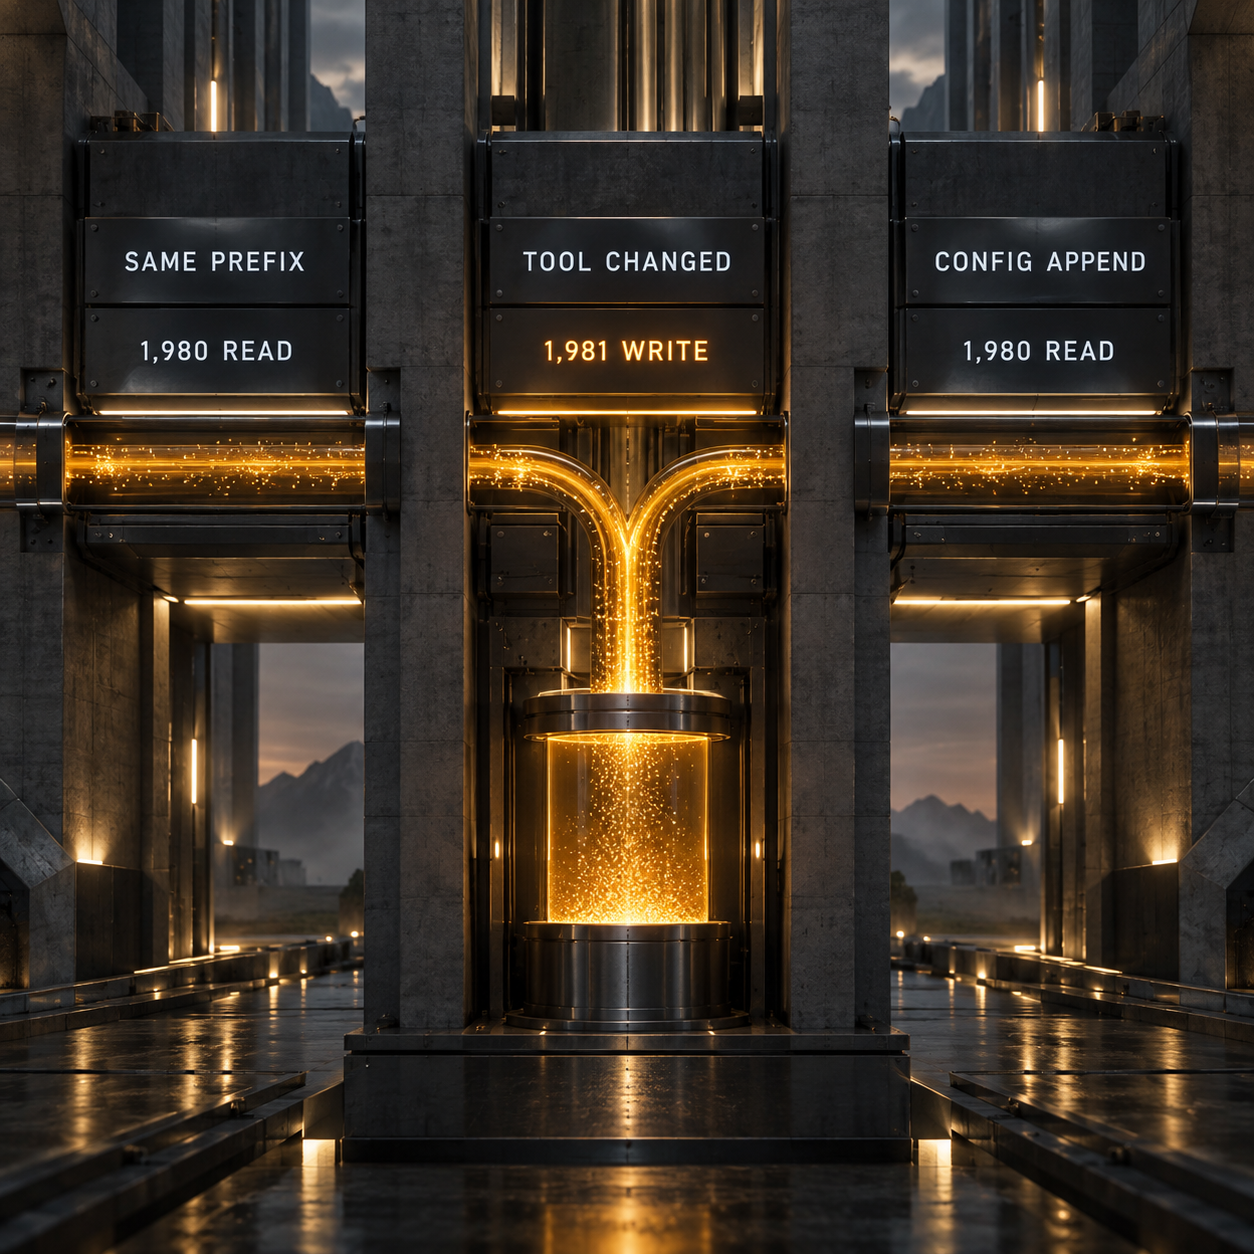
Die Kosten basieren auf den aktuellen Standardtarifen für kurze Kontexte von GPT-6 Sol: $2 pro Million reguläre Eingabetokens, $0.20 pro Million gecachte Eingabetokens, $2.50 pro Million Cache-Schreibtokens und $10 pro Million Ausgabetokens. Jede Antwort umfasste fünf Ausgabetokens.
Einschließlich der Ausgabe kostete die identische Wiederholung 91.0% weniger als die erste Antwort. Bei einem Agenten mit zehn Schritten und demselben Tokenprofil kosten ein Schreibvorgang und neun Lesevorgänge rund $0.009074. Zehn vollständige Schreibvorgänge kosten dagegen etwa $0.05006. Ein stabiler Präfix senkt die Kosten pro abgeschlossenem Schritt in diesem synthetischen Szenario um 81.9%.
Genau das ist die relevante Entscheidungskennzahl. Eine hohe Cache-Trefferquote kann gut aussehen, während wenige teure Langkontextanfragen den Cache immer wieder neu schreiben. Deshalb sollten die tatsächlichen Tokenklassen und Kosten über abgeschlossene Aufgaben hinweg summiert und anschließend mit akzeptierten Ergebnissen, Wiederholungen und Toolkosten verglichen werden.
Aus den Laufzeiten lässt sich keine belastbare Aussage über die Latenz ableiten. Die vier Aufrufe lagen zwischen 892 und 1,254 Millisekunden; die gecachte Wiederholung war nicht einmal der schnellste Aufruf. Bei einer so kleinen Stichprobe dominieren Netzwerk- und Routing-Schwankungen. Die Kostendifferenz ist eindeutig, für Aussagen zur Latenz braucht es dagegen wiederholte Messungen und Daten zur Zeit bis zum ersten Token.
Beim Einbinden trat ein aufschlussreicher Fehler auf. Das Vercel AI Gateway leitete prompt_cache_options weiter, gab die OpenAI-Antwort-ID des Providers zurück und meldete Cache-Lese- und Schreibvorgänge. In der normalisierten Antwort fehlte jedoch prompt_cache_diagnostics. Dass der absichtlich herbeigeführte Fehlschlag stattgefunden hatte, war trotzdem an null gecachten Tokens und 1,981 Schreibtokens erkennbar. Wer ein SDK oder Gateway zwischen Anwendung und OpenAI einsetzt, sollte deshalb prüfen, ob das neue Diagnosefeld offengelegt wird, bevor es zur Grundlage des Produktionsbetriebs wird.
Erst den Präfix reparieren, dann Breakpoints setzen
Die meisten Cache-Fehlschläge entstehen durch den gewöhnlichen Aufbau einer Anfrage. Diese Ursachen sollten zuerst beseitigt werden:
- Toolnamen, Beschreibungen, Schemas, Konfiguration und Reihenfolge unverändert lassen. Mit
tool_choice: "none"wird die Toolausführung unterbunden; mitallowed_toolslässt sich die Auswahl einschränken. Die vollständige übergebene Toolliste bleibt in beiden Fällen erhalten. - Modell, Servicestufe, Textschema, Reasoning-Aufwand auf Anfrageebene und Ausführlichkeit für Anfragen mit gemeinsamem Präfix stabil halten.
- Zeitstempel, Nutzer-IDs, Trace-IDs und aufgabenspezifische Daten hinter stabile Anweisungen und Referenzen verschieben.
- Nachrichten und Toolergebnisse anhängen. Wer frühere Gesprächsinhalte umschreibt oder zusammenfasst, verändert den Präfix.
- Nach jeder Korrektur mit der vorgesehenen Basis vergleichen. Die Diagnose meldet nur die erste klassifizierte Abweichung.
Bei GPT-6 wird der Reasoning-Aufwand über ein Unterhaltungselement geändert, nicht über die Top-Level-Einstellung. Die folgende Anfrage bleibt auf Top-Level-Ebene bei low und setzt die Folgefrage anschließend auf high.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
Konfigurationsupdates funktionieren für die GPT-6-Familie im standardmäßigen Einzelagentenmodus und ändern ausschließlich den Reasoning-Aufwand. Zwei Updates dürfen nicht unmittelbar aufeinanderfolgen. Auch mit automatischer Komprimierung oder automatischer Kürzung lassen sie sich nicht kombinieren.
Der Leitfaden zur Migration auf die Responses API behandelt die umfassendere Entscheidung zur Zustandsverwaltung. Für das Caching genügt ein einfacherer Grundsatz: Bisherige Elemente bleiben unverändert, die Anpassung wird angehängt.
Explizite Breakpoints nur bei klarem Nutzen
Ein expliziter Breakpoint lohnt sich, wenn auf einen stabilen Kern ein Suffix folgt, der sich zu häufig ändert, um einen Cache-Schreibvorgang zu rechtfertigen. Dazu kommen die stabilen Anweisungen in einen input_text-Block innerhalb einer Entwicklermeldung. Dieser Block erhält prompt_cache_breakpoint: {"mode":"explicit"}; zugleich wird prompt_cache_options.mode auf explicit gesetzt.
Top-Level-instructions können keinen expliziten Breakpoint enthalten. Eine Anfrage im expliziten Modus ohne Markierung schreibt nichts in den Cache. Bei einem einmalig verwendeten Prompt kann genau das sinnvoll sein: Ein Cache-Schreibvorgang kostet 25% mehr als eine reguläre Eingabe und amortisiert sich erst, wenn eine spätere Anfrage ihn liest.
Pro Anfrage sind bis zu vier Cache-Schreibvorgänge möglich. Diese Plätze sollten nicht an jede Nachricht vergeben werden. Sinnvolle Grenzen spiegeln die tatsächlichen Verzweigungen der Anwendung wider – etwa eine gemeinsame Unternehmensrichtlinie, den Workspace-Kontext, eine Gesprächsverzweigung und gegebenenfalls ein stabiles Bewertungsraster.
Prewarming ist ein eigenes Werkzeug zur Latenzoptimierung. Eine Anfrage mit prompt_cache_options.prewarm: true bereitet bekannten Kontext ohne Ausgabe vor; die Nutzeranfrage sendet danach denselben Präfix. Der Prewarm-Aufruf wird zum regulären Cache-Schreibpreis abgerechnet. Er sollte daher nur für vorhersehbaren Traffic eingesetzt werden, und der Effekt auf die Zeit bis zum ersten Token gehört in wiederholten Tests gemessen.
Sieben Workflows, in denen sich LLM Caching besonders lohnt
1. Plattformen für Coding-Agenten
Ein Coding-Agent sendet immer wieder Repository-Übersichten, Entwicklervorgaben, Toolschemas und frühere Gesprächsschritte. Diese Blöcke sollten stabil bleiben, während Dateiänderungen und Toolergebnisse angehängt und Hintergrundaufgaben aus dem gemeinsamen Verlauf abgezweigt werden. So sinken die Kontextkosten in langen Sitzungen. Da schon ein umbenanntes Tool die Ersparnis zunichtemachen kann, profitiert diese Gruppe besonders von einem Cache-Regressionstest in der CI.
2. Agenten im Kundensupport
Ein Supportteam arbeitet womöglich mit einem langen Richtlinienhandbuch, Regeln für den Produktkatalog und festen Eskalationstools. Das gemeinsame Material steht am Anfang, das aktuelle Ticket folgt danach. Genau diesem Muster entspricht die gemessene synthetische Richtlinie. Bei identischem Anfrageprofil sanken die Kosten für zehn abgeschlossene Kurzantworten von rund $0.05006 bei wiederholten Schreibvorgängen auf $0.009074 bei einem Schreibvorgang und neun Lesevorgängen.
3. Evaluations- und Qualitätsteams
Ein Evaluator kann Bewertungsraster, gelabelte Beispiele, Ausgabeschema und Tooldefinitionen wiederverwenden und nur die zu prüfende Interaktion am Ende austauschen. Im expliziten Modus lässt sich verhindern, dass der variable Kandidat einen Schreibpreis auslöst. So wird der Cache zum Bestandteil der Wirtschaftlichkeit von Evaluationen, statt ein unsichtbares Plattformdetail zu bleiben.
4. Recherche- und Due-Diligence-Agenten
Ein Rechercheworkflow hält ein geprüftes Quellenpaket und die Analyseregeln stabil und hängt jeweils neue Fragen an. Abgezweigte Zusammenfassungen, Widerspruchsprüfungen und einzelne Abschnitte eines Memos können denselben Präfix nutzen. Besonders groß ist der Vorteil, wenn mehrere Worker von derselben Beleglage ausgehen und unterschiedliche Ergebnisse liefern.
5. Vertrags- und Compliance-Prüfung
Ein Legal-Ops-Team kann Klauselbibliothek, Risikoraster, freigegebene Formulierungen und Prüftools vor dem zu prüfenden Vertrag platzieren. Jedes neue Dokument wird so zum variablen Suffix. Der Cache macht die fachliche Beurteilung nicht sicherer, kann aber die wiederkehrenden Kosten für dieselben Kontrollvorgaben senken.
6. Multi-Agenten-Betrieb
Ein Orchestrator kann einen gemeinsamen Plan, den Workspace-Zustand und den Toolverlauf erhalten, bevor er die Arbeit an spezialisierte Agenten verzweigt. Bei einem großen gemeinsamen Präfix macht Cache-Wiederverwendung solche Abzweigungen günstiger. Tooldefinitionen bleiben stabil; neu entdeckte Tools werden, sofern die Anwendung dies unterstützt, über einen ausschließlich erweiterten Verlauf ergänzt.
7. Planbare interaktive Produkteinführungen
Ein Produkt mit bekanntem Referenzmaterial kann während des Starts und noch vor der ersten Nutzeranfrage vorwärmen. Damit wird die Präfixverarbeitung aus der Wartezeit des Nutzers herausgenommen. Sinnvoll ist das nur, wenn der Traffic früh genug eintrifft, um den Eintrag wiederzuverwenden, und sich der Latenzgewinn in einem sauberen Wiederholungstest bestätigt.
Drei Produktideen mit Potenzial
1. Cache Regression CI – die stärkste Chance
Ein solcher Test-Gate spielt repräsentative Agentenanfragen erneut ab, vergleicht jede Antwort mit einer gespeicherten Basis und lässt einen Pull Request scheitern, sobald gecachte Tokens sinken oder Schreibvorgänge sprunghaft steigen. Teams mit Agentenplattformen zahlen dafür, weil eine scheinbar harmlose Änderung am Toolschema plötzlich jeden Produktionsschritt in einen vollständigen Schreibvorgang verwandeln kann.
Die Nachfrage ist überschaubar genug, um sie gezielt zu bedienen, aber groß genug, um aufzufallen: prompt caching erzielt in den USA etwa 1,300 Suchanfragen pro Monat, openai prompt caching erreicht 320, und die exakte Einrichtungsfrage zu GPT-6 lieferte nur zwei unabhängige schriftliche Anleitungen. Helicone verlangt bereits $79 pro Monat für einen Pro-Tarif mit Alarmen und Berichten. Das zeigt, dass Teams für LLM-Monitoring ein Budget einplanen.
Die kleinste verkaufbare Version besteht aus einer CLI, einem GitHub-Check und einem Bericht mit Basis-Antwort-ID, Diagnosegrund, gecachten Tokens, Schreibtokens, Laufzeit und berechneten Kosten. Der Haken: OpenAI bietet selbst Dashboard und Diagnosen an. Das Produkt muss mit einem Deployment-Gate, anbieterübergreifender Abdeckung oder Zuordnung bis auf Codeebene seinen Platz rechtfertigen.
2. Cache-fähige Kostenzuordnung
Das Produkt wäre ein Kostenbuch pro Kunde für KI-Anwendungen, das reguläre Eingaben, Cache-Lesevorgänge, Cache-Schreibvorgänge, Ausgaben und Toolgebühren getrennt erfasst. Finanz- und Plattformteams zahlen dafür, wenn viele Kunden denselben Agentenpräfix nutzen, das Produkt aber weiterhin belastbare Margen pro Workspace ausweisen muss.
Etwa 50 Suchanfragen pro Monat in den USA zielen auf openai api prompt caching. Zu den live angezeigten „Nutzer fragen auch“-Fragen gehören „Should I use prompt caching?“ und „When not to use caching?“. Langfuse berechnet für produktive Cloud-Tarife $29 beziehungsweise $199 pro Monat – ein weiteres Zeichen dafür, dass Token- und Kostenverfolgung bereits über ein Softwarebudget verfügt.
Das MVP umfasst einen SDK-Wrapper, eine Preistabelle, Mandanten-Tags und eine Ansicht nach abgeschlossenen Aufgaben. Die eigentliche Schwierigkeit ist eine saubere Zuordnung. GPT-5.6 und neuere Modelle benötigen für das Routing keinen prompt_cache_key; getrennte Schlüssel dienen vor allem der Abrechnung. Unsaubere Mandantengrenzen können zu schwer nachvollziehbaren Rechnungen oder Datenschutzbedenken führen.
3. Konformitätsmonitor für Adapter
Eine Testsuite prüft, ob ein SDK, Proxy oder Modell-Gateway neue Responses-Felder weiterleitet und unverändert zurückgibt. Nach jedem Abhängigkeitsupdate testet sie comparison_response_id, Diagnosetypen, Cache-Tokendetails, Konfigurationsupdates, explizite Breakpoints und Provider-Antwort-IDs.
Das Nachfragesignal liegt in der Wissenslücke: what is prompt caching kommt in den USA auf etwa 480 Suchanfragen pro Monat, how does prompt caching work auf 140; zudem erscheint „How do I turn on prompt caching?“ in den live angezeigten „Nutzer fragen auch“-Ergebnissen. Der Praxistest legte ebenfalls einen konkreten Fehler offen: Das Gateway behielt die Nutzungsdaten bei, ließ aber das Diagnoseobjekt weg.
Das MVP ist eine gehostete Kompatibilitätsmatrix samt Befehl, der fünf synthetische Anfragen gegen den Endpunkt eines Kunden ausführt. Die Herausforderung ist die dauerhafte Relevanz. Gateway-Anbieter werden neue Felder nachrüsten; deshalb braucht das Produkt fortlaufende Protokolltests über mehrere Anbieter hinweg, nicht nur eine einmalige GPT-6-Prüfung.
Grenzen und eine nüchterne Einordnung
Prompt Caching sollte gezielt eingeplant werden, wenn sich ein langer Präfix wiederholt. Bei kurzen, einmaligen oder am Anfang ständig umgeschriebenen Anfragen ist es hingegen das falsche Optimierungsziel.
Die Grenze von 1,024 Tokens spielt dabei eine wichtige Rolle. Einen kleinen Prompt allein für die Cache-Berechtigung künstlich aufzublähen, kann die Kosten erhöhen. Zusätzliche stabile Beispiele oder Referenzinhalte können fachlich sinnvoll sein; entscheidend sind jedoch Wiederverwendungszahl und Qualität, nicht der bloße Wunsch nach einem Cache-Treffer.
Auch der Cache-Zustand ist physisch gebunden. Einträge liegen auf einzelnen Maschinen, und bei einem Traffic von mehr als etwa 15 Anfragen pro Minute kann die Last auf weitere Maschinen verteilt werden. Routing und Auslastung können daher Fehlschläge verursachen, obwohl die Anwendungsinhalte stabil erscheinen. Ein Cache-Treffer ist ein Optimierungsergebnis, keine Korrektheitsgarantie.
Gecachte Eingaben zählen weiterhin zu den Token-pro-Minute-Limits. Der Cache lässt sich nicht manuell leeren. Die Wiederverwendung ändert nichts an der Ausgabeerzeugung, daher können selbst identische Anfragen verschiedene Antworten liefern. Bei GPT-6 Sol führt eine Anfrage mit mehr als 272,000 Eingabetokens außerdem dazu, dass für die gesamte Anfrage die höheren Langkontexttarife gelten.
Die wichtigste Betriebsregel lautet deshalb: Kosten pro akzeptierter Aufgabe verfolgen, den Präfix stabil halten und jeden sprunghaften Anstieg der Schreibvorgänge wie einen erklärungsbedürftigen Vorfall behandeln.
Die Aufgabe für Montag
Am nächsten Montag wird ein produktiver Agenten-Endpunkt ausgewählt. Dann: eine repräsentative Antwort-ID speichern, dieselbe abgeschlossene Aufgabe erneut ausführen und gecachte Tokens, Schreibtokens, Laufzeit, Ausgabetokens und Gesamtkosten erfassen. Anschließend eine Toolbeschreibung oder einen Toolnamen ändern, mit derselben Basis vergleichen, die Toolliste wiederherstellen und den Test erneut ausführen. Senkt die wiederhergestellte Anfrage die Kosten pro abgeschlossener Aufgabe, ohne die Akzeptanz zu beeinträchtigen, gehört genau dieser Test in die CI – noch bevor Prompts geändert oder Breakpoints ergänzt werden.
Häufig gestellte Fragen
Wie lässt sich Prompt Caching aktivieren?
In der Regel muss es nicht eigens aktiviert werden. Bei unterstützten OpenAI-Modellen ist Prompt Caching standardmäßig eingeschaltet. Ab GPT-5.6 müssen am Anfang einer Anfrage mindestens 1,024 sichtbare Tokens stabil bleiben; danach wird innerhalb des aktiven Zeitfensters eine passende Anfrage gesendet und cached_tokens geprüft. prompt_cache_options.mode ist nur erforderlich, wenn Breakpoints gezielt gesteuert werden sollen.
Was ist Prompt Caching und wie funktioniert es?
Dabei wird der verarbeitete Key-Value-Zustand des Modells für einen exakten Prompt-Präfix gespeichert. Die erste geeignete Anfrage schreibt diesen Zustand; spätere passende Anfragen können ihn lesen, anstatt denselben Präfix erneut zu verarbeiten. Neue Inhalte im Suffix und die Ausgabeerzeugung verursachen weiterhin Rechenaufwand.
Wann sollte Caching nicht eingesetzt werden?
Es lohnt sich nicht, wenn Prompts unterhalb der Mindestgrenze liegen, sich selten wiederholen, am Anfang ändern oder vor der nächsten Anfrage ablaufen. Im expliziten Modus verhindert ein fehlender Breakpoint, dass für einen voraussichtlich nicht wiederverwendeten Präfix der Schreibpreis von 1.25× anfällt.
Sollte ich Prompt Caching einsetzen?
Ja, wenn wiederkehrende Eingaben einen relevanten Anteil der Kosten pro abgeschlossener Aufgabe ausmachen. Ein Schreibvorgang und mehrere Lesevorgänge sollten mit den echten Tools und Akzeptanzprüfungen gemessen werden. Eine hohe Trefferquote ist nur dann hilfreich, wenn die Gesamtkosten pro akzeptierter Aufgabe sinken.
Welche Caching-Strategie ist die beste?
Der beste Einstieg ist automatisches implizites Caching. Stabile Inhalte stehen am Anfang, variable Inhalte werden angehängt, Tools und Anfrageeinstellungen bleiben unverändert, Fehlschläge werden diagnostiziert. Explizite Breakpoints kommen nur an stabile Blöcke, die oft genug wiederverwendet werden, um den Schreibpreis auszugleichen.
Wenn Messung und Regressionstest direkt in den eigenen Agenten-Stack integriert werden sollen, sind KI-Produktionssysteme der passende Einstieg.
- Zuletzt aktualisiert
- 27. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Microsoft Copilot Kosten: Managed Runtime sicher kalkulieren
Microsoft Copilot Kosten im Detail: So kalkulieren Unternehmen Managed Runtime mit Credits, API-Aufrufen, Power Apps Premium und separaten KI-Gebühren.26. Sept. 2026Build
n8n Workflow oder Agent? Die richtige Architektur wählen
n8n Workflow oder Agent? Der Praxistest zeigt, wann feste Abläufe gewinnen, wann Gesprächskontext zählt und warum die beste Lösung oft hybrid ist.26. Sept. 2026Build
OpenRouter Kosten: Ist Jev Router wirklich kostenlos?
Welche OpenRouter Kosten entstehen mit Jev Router wirklich? Der $0-Preis gilt für Prompt- und Completion-Tokens, doch die Gesamtrechnung muss geprüft werden.26. Sept. 2026Build
Claude Plugins veröffentlichen: Vom Repository ins Directory
Claude Plugins im Directory veröffentlichen: Bundle vorbereiten, im Entwicklerportal validieren, Prüfung bestehen und MCP Connector separat einreichen.26. Sept. 2026Build
Cloudflare MCP Gateway: Was kostenlos ist – und was nicht
Das MCP Gateway von Cloudflare ist für bis zu 50 aktive Nutzer kostenlos. Wie Nutzerplätze, Logs, DLP und Zusatzkosten die Tarifwahl bestimmen.26. Sept. 2026Build
CUDA-Kernel optimieren: Ein belastbarer Pilot mit Agentic CUDA Optimizer
Mit Agentic CUDA Optimizer einen CUDA-Kernel optimieren: sieben Versuche testen und Korrektheit, GPU-Zeit sowie Modellkosten vor dem Einsatz prüfen.25. Sept. 2026Build
GPU mieten bei Runpod: Was Pods und Serverless 2026 kosten
GPU mieten bei Runpod: Der Vergleich erklärt Pod-, Serverless- und Speicherkosten, rechnet H100-Szenarien durch und zeigt klar den Break-even.25. Sept. 2026Build