GPT-6 Sol oder Luna: Welches Modell passt zu welchem Job?
GPT-6 Sol oder Luna? Der Vergleich zeigt Preise, Stärken und Einsatzgebiete – und wann Sol den 20× höheren Tokenpreis gegenüber Luna wirklich rechtfertigt.




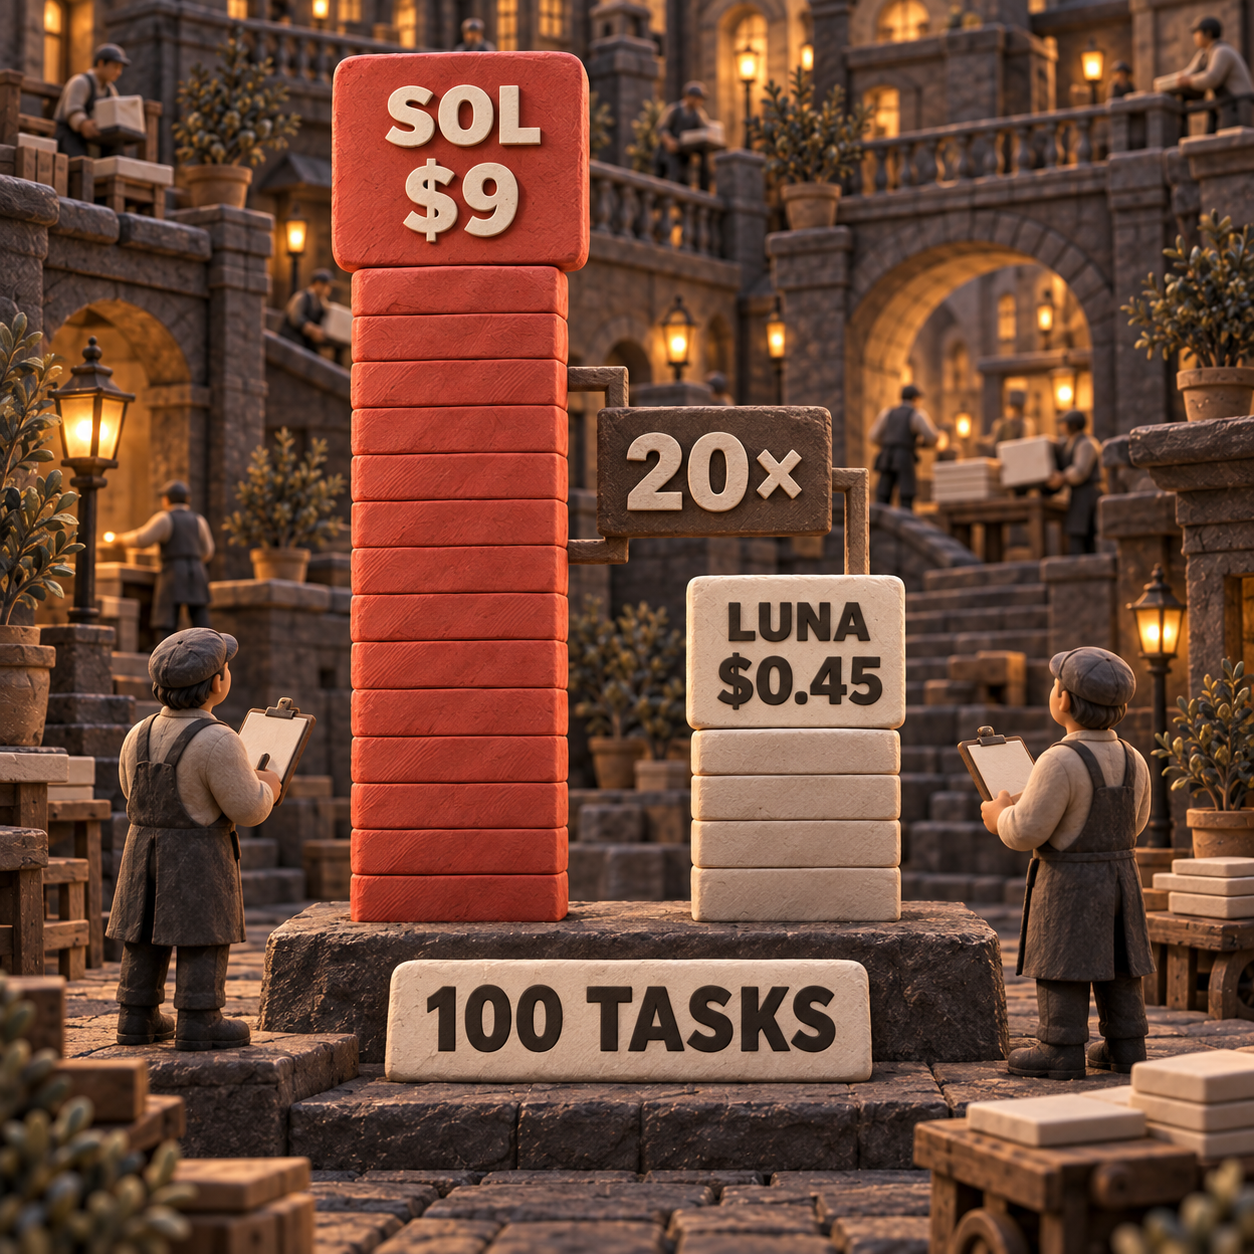
Bei GPT-6 Sol oder Luna geht es um die Wahl zwischen Standardmodell und gezielter Eskalation: Den Anfang sollte Luna machen. Für 100 Aufgaben mit kurzem Kontext und jeweils 20,000 Input- sowie 5,000 Output-Tokens kostet Luna $0.45, Sol dagegen $9. Den 20×-Aufpreis rechtfertigt Sol erst, wenn eine höhere Akzeptanzquote oder weniger Prüfaufwand mehr als die zusätzlichen $8.55 einspart.
GPT-6 Sol oder Luna: Luna zuerst, Sol für die schwierigen Fälle
GPT-6 Luna eignet sich für berechenbare Aufgaben, deren Ergebnis sich günstig prüfen lässt. GPT-6 Sol ist die bessere Wahl für mehrdeutige Programmieraufgaben, lange Agenten-Workflows und Entscheidungen, bei denen eine schwache Antwort teure Prüfungen oder Nacharbeit auslöst. Lässt sich diese zusätzliche Konsequenz nicht konkret benennen, ist Luna das bessere Einstiegsmodell.
OpenAI positioniert Sol für komplexe Programmieraufgaben und agentische Workflows, Luna dagegen als Effizienzmodell für klar umrissene Aufgaben mit hohem Volumen. Dieser Unterschied wiegt schwerer als der gemeinsame Name GPT-6: Beide Modelle bieten nahezu denselben Funktionsrahmen, ihre Preise spiegeln jedoch einen unterschiedlichen Bedarf an Urteilsvermögen wider.
Preissieger: Luna. Sowohl der Input- als auch der Outputpreis beträgt nur ein Zwanzigstel des Sol-Tarifs. Damit ist Luna die naheliegende Wahl für Extraktion, Klassifizierung, routinemäßige Transformationen und Codeänderungen, die durch deterministische Tests abgesichert sind.
Sieger bei schwierigen Aufgaben: Sol. OpenAI weist für das Modell das stärkere Programmierergebnis aus und positioniert es ausdrücklich für komplexe agentische Arbeit. Am überzeugendsten ist Sol, wenn sich ein Ergebnis nur schwer prüfen lässt, ein neuer Versuch andere Arbeit blockiert oder Prüfer die Überlegungen des Modells nachvollziehen müssen.
GPT-6 Preise: Der 20×-Abstand verschwindet auch bei mehr Tokens nicht
Luna bleibt bei jedem vergleichbaren Tokenpreis 20× günstiger. Ein höheres Volumen erzeugt keinen Schnittpunkt, weil OpenAI auf seiner aktuellen API-Preisseite für Input, zwischengespeicherten Input, Cache-Schreibvorgänge und Output bei kurzem wie langem Kontext dasselbe Verhältnis beibehält.
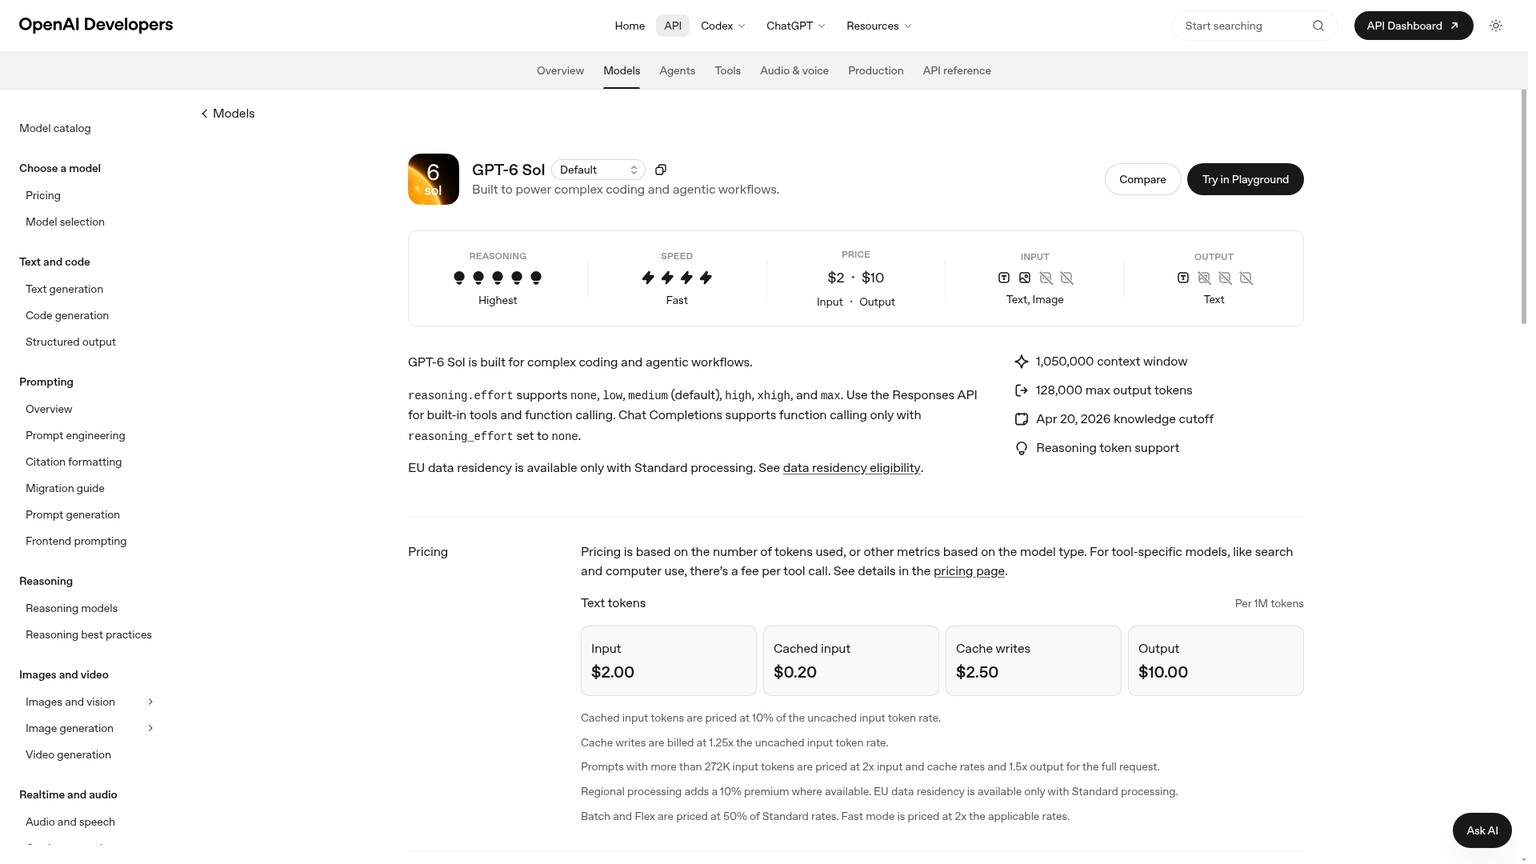
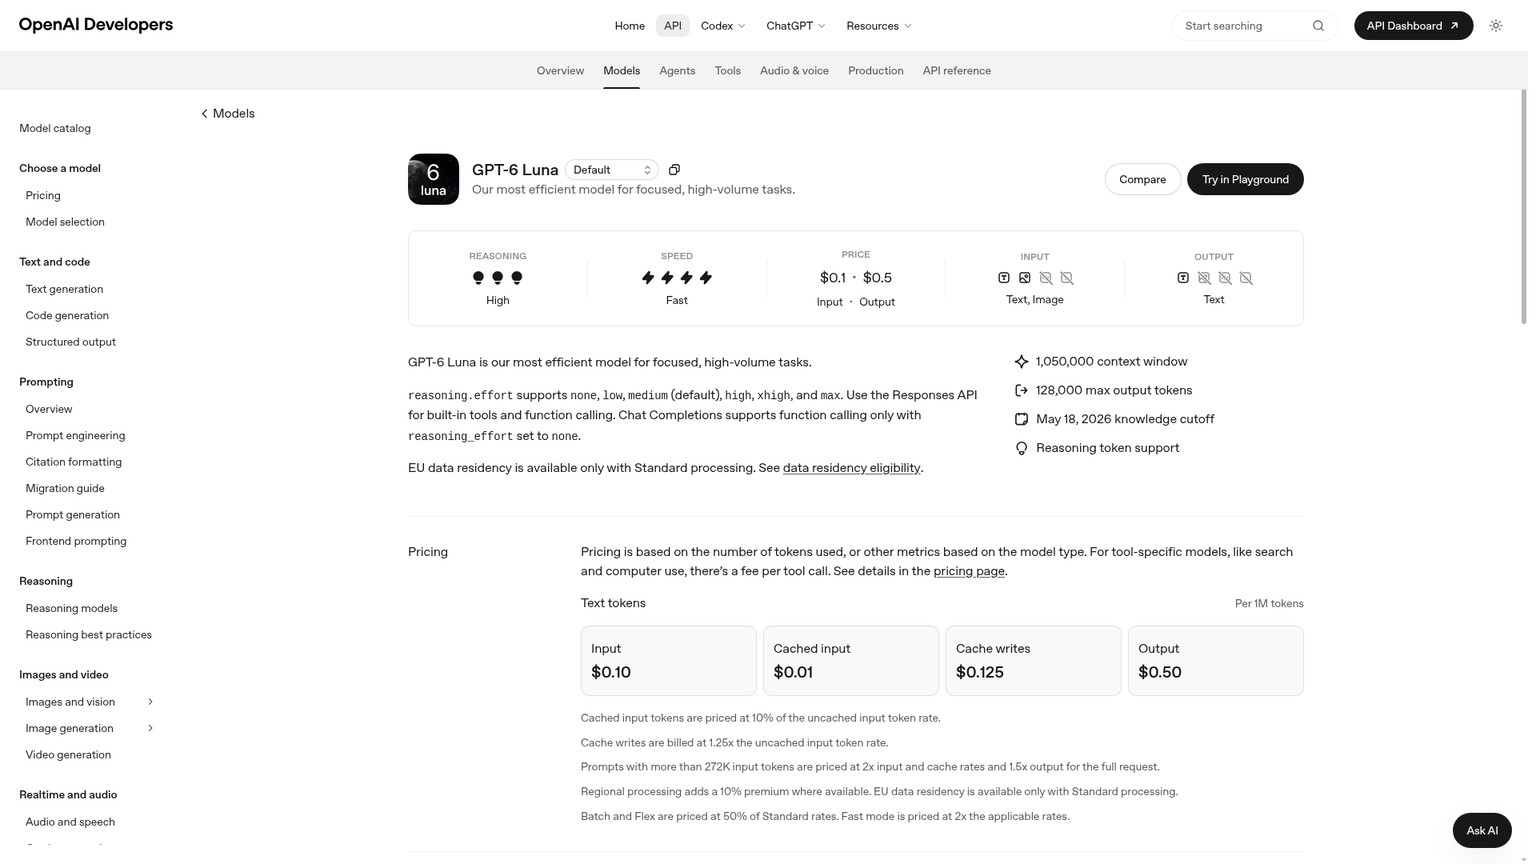
Im Standardtarif für kurzen Kontext kostet Sol $0.002 je 1K Input-Tokens und $0.010 je 1K Output-Tokens. Bei Luna sind es $0.0001 je 1K Input-Tokens und $0.0005 je 1K Output-Tokens.
Für dieselbe Aufgabe mit 20,000 Input- und 5,000 Output-Tokens gilt:
- Sol kostet $0.0900.
- Luna kostet $0.0045.
- Sol verursacht vor Tools, Wiederholungen, Cache-Effekten oder verändertem Tokenverbrauch Mehrkosten von $0.0855.
Bei 100 getrennten Aufgaben summiert sich das auf $9 für Sol und $0.45 für Luna. Mit Luna spart dieser Batch $8.55, noch bevor ein Qualitätsunterschied in die Rechnung einfließt.
GPT-6 Sol: Preise bei kurzem Kontext
Der Preis von Sol wird leicht unterschätzt, wenn der Vergleich beim Input endet. Der Output kostet bei beiden Modellen das Fünffache des Inputs. Bei einem ausführlich antwortenden Agenten oder einer längeren Programmierschleife können die erzeugten Tokens daher den größeren Teil der Rechnung ausmachen. Im Referenz-Workload kosten die 500,000 Output-Tokens von Sol $5 und damit mehr als die $4 für den Input.
Caching senkt beide Rechnungen, ändert aber nichts an der Modellwahl. Cache-Lesezugriffe kosten 10% des nicht zwischengespeicherten Inputs, Cache-Schreibvorgänge das 1.25-Fache. Das hilft bei stabilen System-Prompts, Tooldefinitionen und wiederverwendetem Repository-Kontext, das Verhältnis von 20× zwischen Sol und Luna bleibt jedoch bestehen.
Einen seriösen Schnittpunkt pro Nutzerplatz und Monat oder pro Bild gibt es hier nicht. Es handelt sich um API-Modelle mit Tokenabrechnung, nicht um unterschiedliche Abonnements. Beide verarbeiten Bilder als Input und erzeugen Text; die Bilderzeugung ist ein separates Tool mit eigenen Kosten. Bei der Modellwahl zählt weiterhin die akzeptierte Textarbeit.
GPT-6 Modelle im Vergleich: Gleicher Rahmen, anderes Urteilsvermögen
Die technische Basis der Modelle ist so ähnlich, dass eine Feature-Checkliste kaum bei der Auswahl hilft. Beide nennen ein Kontextfenster von 1,050,000 Tokens, maximal 128,000 Output-Tokens, Text- und Bild-Input, Text-Output, strukturierte Ausgaben, Function Calling, Streaming sowie dieselben Stufen für den Reasoning-Aufwand von none bis max.
GPT-6 Sol ist die Option für komplexe Aufgaben. Auf der aktuellen Modellseite werden Websuche, Dateisuche, Bilderzeugung, Code Interpreter, Hosted Shell, Apply Patch, Skills, Computer Use, MCP und Tool Search über die Responses API aufgeführt.
GPT-6 Luna ist die effiziente Option, kein abgespeckter Endpunkt. Die aktuelle Modellseite führt dieselben Tools und Steuerungsmöglichkeiten auf. Routineaufgaben lassen sich daher günstiger ausführen, ohne auf strukturierte Ausgaben oder die Tooloberfläche für Agenten zu verzichten.
Bei der Evaluation ist eine API-Einschränkung relevant: Bei mittlerem Reasoning-Aufwand sollte die Responses API verwendet werden. Laut den Modellseiten unterstützt Chat Completions Function Calling nur dann, wenn der Reasoning-Aufwand auf none steht. Ein Vergleich ist nicht kontrolliert, wenn ein Modell über Responses auf Tools zugreifen kann und das andere über einen eingeschränkten Chat-Completions-Pfad läuft.
Auch die Wissensstichtage ergeben keine einfache Rangfolge. Für Sol ist der 20. April 2026 angegeben, für Luna der 18. Mai 2026. Die höhere Leistungsklasse von Sol bedeutet nicht, dass jede datierte Spezifikation größer oder neuer ist.
GPT-6 Sol vs Luna im Test: Was die Daten tatsächlich belegen
Sol liefert zum Marktstart das bessere Signal für anspruchsvolle Programmieraufgaben. Für einen pauschalen Wechsel reicht die neutrale Evidenz jedoch nicht aus. Die offizielle Ankündigung für Entwickler von OpenAI bestätigt die Veröffentlichung und die Positionierung über den niedrigeren Preis.
In der Evaluation von OpenAI zum Marktstart erreichte GPT-6 Sol bei maximalem Aufwand 68.8% in DeepSWE v1.1, GPT-6 Luna kam auf 66.6%. Sol liegt damit 2.2 Prozentpunkte vorn.
Der Vergleich ist nützlich, hat aber klare Grenzen. Er stammt vom Anbieter, nutzt den maximalen Aufwand und misst eine bestimmte Auswahl langfristiger Softwareentwicklungsaufgaben. Daraus folgt nicht, dass Sol bei Extraktion, Support-Triage, Richtlinienzuordnung oder in einem Repository mit besonders starken Tests 20-mal so viele akzeptierte Ergebnisse liefert.
Für genau dieses Modellpaar liegt noch kein unabhängiger, methodisch gleicher Test vor, aus dem sich eine neutrale Kennzahl für Qualität pro Dollar ableiten ließe. Belastbar ist nur die engere Schlussfolgerung:
- Sieger beim gemessenen Programmiermaximum: Sol. Im einzigen direkten Vergleichswert, den OpenAI veröffentlicht hat, liegt Sol vorn.
- Sieger bei kostenoptimierter Routinearbeit: Luna. Ein kleiner Qualitätsabstand fällt gegenüber dem Preisunterschied von 20× kaum ins Gewicht, solange Fehler günstig erkennbar sind.
- Für den eigenen Anwendungsfall offen: Akzeptanzquote, Latenz, Zahl der Wiederholungen und Prüfzeit bei der tatsächlich eingesetzten Aufwandsstufe.
Der frühere Test von GPT-5.6 zeigt, warum Modellfamilien besser in Routingregeln als in Statusranglisten übersetzt werden. Die Preissenkung bei GPT-6 verändert die Zahlen, nicht dieses Prinzip.
Programmieren mit GPT-6 Luna: Tests entscheiden
Luna gewinnt bei klar eingegrenzter Programmierarbeit, wenn das Repository die Antwort bewerten kann. Eine Lint-Korrektur, typgesicherte Extraktion, Aktualisierung von Fixtures oder ein lokalisierter Fehler mit fehlschlagendem Test geben einem günstigeren Modell ein eindeutiges Signal. Scheitert der Patch, erfolgt die Eskalation automatisch und der günstige erste Versuch war dennoch nicht verschwendet.
Sol gewinnt, wenn sich Erfolg im Repository nicht sauber ausdrücken lässt. Modulübergreifende Migrationen, sporadische Produktionsfehler, unklare Anforderungen, sicherheitskritische Änderungen und Architekturarbeit zwingen Menschen dazu, Annahmen zu prüfen, statt nur ein Testergebnis zu lesen. Die zusätzlichen $0.0855 der Referenzaufgabe sind unbedeutend, wenn Sol auch nur einen kleinen Teil der Prüfzeit erfahrener Fachkräfte einspart.
Damit wird die Testsuite zum Bestandteil des Modellbudgets. Bessere Assertions, Typprüfungen, Linter und eng gefasste Akzeptanzkriterien vergrößern den Anteil der Arbeit, den Luna übernehmen kann. Sol für jede Änderung zu bezahlen, ersetzt häufig nur den Aufbau solcher Kontrollen.
Ein früheres anbieterübergreifendes Beispiel dieser Methode ist der Vergleich von GPT-5.6 und Claude Sonnet 5. Er trennt den reinen Modellpreis von den Kosten akzeptierter Repository-Arbeit.
GPT-6 Sol oder Luna: Die Entscheidungsregel
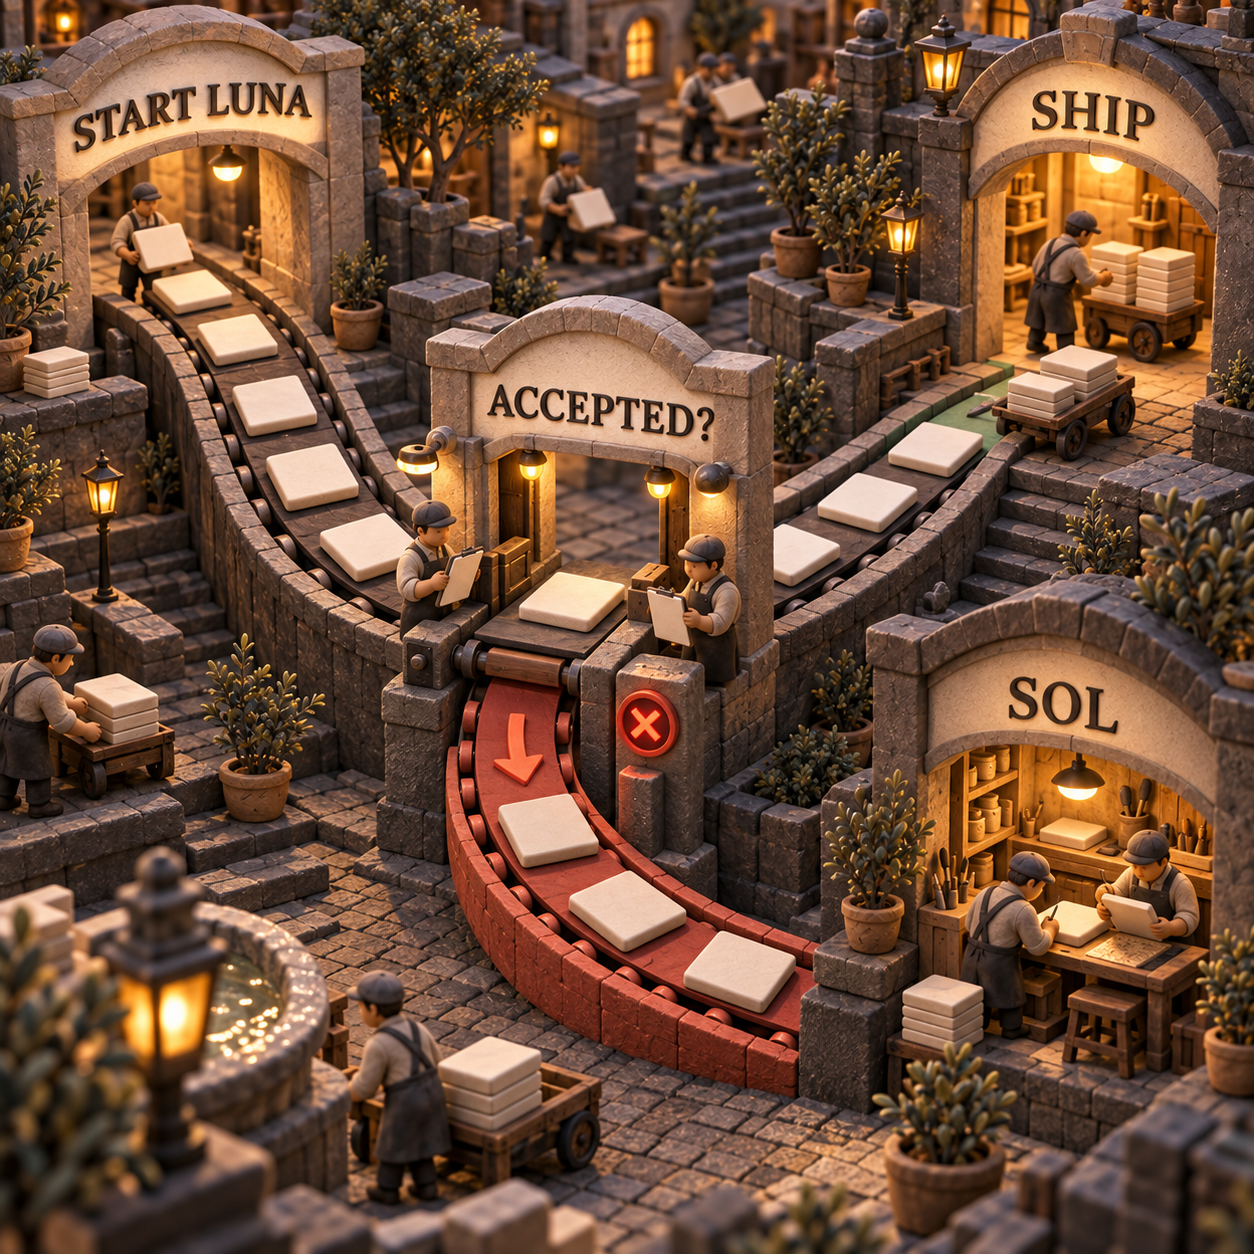
Der Einstieg erfolgt mit Luna. Nur Aufgaben, deren Fehler mehr kosten als der Modellaufschlag, sollten auf Sol wechseln. Für den Referenz-Workload lautet die genaue Eskalationsregel:
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
Zu den Fehlerkosten können ein neuer Versuch, Prüfzeit, verzögerte Automatisierung, Auswirkungen auf Kunden oder eine Fehlentscheidung gehören. Entscheidend ist der tatsächlich beobachtete Wert. Ein vermeintlich universeller Dollarbetrag würde genau die Variable verdecken, von der die Modellwahl abhängt.
Für finanzierte Gründer: Luna eignet sich für strukturierte Rechercheextraktion, Dokumentenvergleiche und wiederholbare operative Entwürfe. Sol sollte bei Investitionsmemos, Due-Diligence-Synthesen oder Produktentscheidungen erst dann zum Einsatz kommen, wenn eine Bewertungsmatrix weniger wesentliche Korrekturen nachweist.
Für CTOs mittelständischer Unternehmen: Ticket-Triage, Log-Klassifizierung, Routine-Patches und testgestützte Wartung gehören zu Luna. Sol bleibt für Störungsanalysen, schwierige Migrationen, Agentenpläne über mehrere Systeme und Aufgaben reserviert, deren Fehler wertvolle Zeit erfahrener Entwickler binden.
Für erfahrene Führungskräfte im operativen Geschäft: Standardisierte Formulare, Zusammenfassungen, Verschlagwortung und Abstimmungen lassen sich an Luna routen. Mehrdeutige Ausnahmefälle, widersprüchliche Belege sowie Freigaben mit finanziellen Folgen oder Auswirkungen auf Kunden sollten an Sol eskaliert werden.
Für technische Solo-Entwickler: Luna ist die wirtschaftliche Schleife für Aufgaben, deren Erfolg ein Befehl eindeutig belegen kann. Sol ist die bewusste Eskalation, wenn die Aufgabe nach einem Versuch weiter unzureichend spezifiziert ist oder das Repository keine verlässlichen Prüfungen bietet.
Der Wechsel von Luna zu Sol ist im Code günstig, in der Validierung teuer
Technisch muss nur eine Modell-ID ausgetauscht werden, in der Produktion ist der Wechsel jedoch eine Evaluation. Beide Modelle verwenden dieselben Steuerungsmöglichkeiten der Responses API und unterstützen dieselben benannten Tools. Deshalb kann gpt-6-luna ohne Anbieterwechsel durch gpt-6-sol ersetzt werden. Das Ausgabeverhalten kann sich dennoch so stark ändern, dass Prompts, Schemas, Toolauswahl und Erwartungen der Prüfer nicht mehr funktionieren.
Sinnvoll ist ein expliziter Vergleich mit mittlerem Aufwand, denn dies ist bei beiden Modellen die dokumentierte Standardeinstellung und eine realistische Basis für den Produktionseinsatz. Der Extraktionsdatensatz sollte vom Repository-Datensatz getrennt bleiben, damit eine große, einfache Kategorie keine Fehler in genau den Aufgaben verdeckt, die den Einsatz von Sol motiviert haben.
Aufgabensatz und Akzeptanzkriterien festschreiben
Repräsentative Extraktions- und Repository-Aufgaben auswählen. Vor dem Lauf festlegen, was als akzeptiertes Ergebnis gilt: Pflichtfelder, Testbefehl, verbotene Änderungen, Prüfcheckliste und die Definition eines neuen Versuchs.
Beide exakten Modell-IDs mit mittlerem Aufwand ausführen
Identische Inputs über die Responses API an
gpt-6-lunaundgpt-6-solsenden undreasoning.effortaufmediumsetzen. Systemanweisungen und Ausgabeschemas müssen identisch bleiben.Tools und Cache-Zustand konstant halten
Beiden Läufen dieselben Tooldefinitionen, denselben Repository-Stand, dieselben Berechtigungen und dieselben Cache-Bedingungen geben. Frischen Input, zwischengespeicherten Input, Cache-Schreibvorgänge, Output-Tokens und Toolkosten getrennt erfassen.
Ergebnisse statt Eindrücke dokumentieren
Akzeptiert oder abgelehnt, Zahl der Wiederholungen, Laufzeit, Tokenverbrauch und Prüfminuten erfassen. Wenn praktikabel, sollte der Modellname für die prüfende Person verborgen bleiben.
Nur die gewinnende Aufgabenklasse hochstufen
Für jede Aufgabenklasse die Gesamtkosten je akzeptiertem Ergebnis berechnen. Eine Klasse sollte nur dann an Sol gehen, wenn die vermiedenen Fehler- und Prüfkosten die zusätzlichen $0.0855 der Referenzaufgabe übersteigen, angepasst an den Tokenverbrauch dieser Klasse.
Da in diesem Lauf die API-Zugangsdaten fehlten, werden hier keine Ergebnisse eines solchen Modellpaartests behauptet. Dieses Protokoll trennt eine belastbare Routingstrategie von einer Annahme zum Marktstart.
Der nächste Montag: Akzeptierte Arbeit bepreisen, nicht Tokens
In der kommenden Woche bleibt Luna die Basis; nur der schwierige Anteil wird bei mittlerem Aufwand mit beiden Modellen getestet. Die Auswertung erfolgt nach Aufgabenklasse, nicht als vermischter Durchschnitt. Auf Sol wechselt nur die Klasse, in der das Modell die Gesamtkosten je akzeptiertem Ergebnis senkt.
Erreicht keine Klasse diesen Schwellenwert, bleibt Luna die richtige Wahl und die Differenz fließt besser in Tests, Retrieval und Prüfschranken. Überschreitet eine Klasse den Schwellenwert, wird nur sie gezielt geroutet. Das nützliche System heißt weder überall Sol noch überall Luna, sondern: Luna, bis die Evidenz Sol bezahlt.
Für den Zugang über ChatGPT-Abonnements statt für die Wirtschaftlichkeit der API gibt es einen separaten Leitfaden zur Frage, ob GPT-6 Luna kostenlos ist.
Häufig gestellte Fragen
Ist GPT Sol oder Luna besser?
GPT-6 Luna ist besser für günstige, klar umrissene Aufgaben mit hohem Volumen, deren Ergebnisse sich prüfen lassen. GPT-6 Sol ist bei schwierigen Programmier- und Agentenaufgaben nur dann überlegen, wenn eine höhere Akzeptanzquote oder geringere Prüfkosten den Tokenaufschlag von 20× ausgleichen.
Wofür eignet sich GPT-5.6 Luna?
GPT-5.6 Luna ist das Effizienzmodell der vorherigen Generation. Der Test von GPT-5.6 erläutert seine Rolle beim Routing; neue Evaluationen sollten mit GPT-6 Luna zu den aktuellen Preisen von $0.10 für Input und $0.50 für Output je Million Tokens bei kurzem Kontext beginnen.
Warum ist GPT-5.6 Luna so günstig?
Das Modell besetzte bei OpenAI die Klasse für klar umrissene Aufgaben mit hohem Volumen. GPT-6 Luna führt diese Effizienzrolle fort. Laut OpenAI haben verbessertes Caching und optimierte Inferenz dazu beigetragen, die API-Preise zum Marktstart gegenüber den Aktionspreisen von GPT-5.6 Luna um 50% zu senken.
Was ist besser: GPT-5.6 Luna oder Terra?
Diese Auswahl betrifft die vorherige Modellgeneration. Der vollständige Vergleich der GPT-5.6-Modellfamilie behandelt diese Entscheidung; für eine neue Implementierung sollten zuerst die aktuellen Modelle GPT-6 Luna und Sol verglichen werden.
Warum $20 für ChatGPT bezahlen?
$20 betreffen ein Abonnement für Verbraucher, nicht die API-Kosten von GPT-6. Der separate Leitfaden zum Zugang zu GPT-6 Luna vergleicht die verfügbaren Abonnements; die Kosten einer API-Automatisierung sollten anschließend unabhängig nach Tokens und Tools berechnet werden.
Warum verlassen Menschen ChatGPT?
Diese allgemeine Verhaltensfrage entscheidet nicht über die Modellwahl für eine API. Für den Produktionseinsatz zählen akzeptierte Ergebnisse, Latenz, Prüfzeit, Datenschutzanforderungen und Gesamtkosten im eigenen Workload.
Gibt es eine bessere KI als GPT?
Für eine bestimmte Aufgabe kann ein anderes Modell besser sein, einen sinnvollen universellen Sieger gibt es jedoch nicht. Zuerst werden die Akzeptanzkriterien festgelegt, danach lassen sich Anbieter und Modelle bei identischen Aufgaben, Tools, Aufwandsstufen und Prüfprozessen vergleichen.
Lohnt sich ChatGPT Pro für $200?
Die Annahme von $200 ist veraltet, und der Wert eines Abonnements lässt sich nicht aus API-Preisen ableiten. Zunächst sollte die aktuelle Tarifauswahl von OpenAI geprüft und die enthaltene Nutzung anschließend getrennt von der Tokenentscheidung zwischen Sol und Luna bewertet werden.
Die KI-Tool-Landkarte für Unternehmen
Eine verständliche Übersicht darüber, welche Modelle und Tools zu welcher geschäftlichen Aufgabe passen – aktualisiert, sobald sich Preise und Funktionen ändern. Für Abonnenten kostenlos.
- Zuletzt aktualisiert
- 23. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Ist GPT-6 Luna kostenlos? Pläne, Limits und API-Kosten
Ist GPT-6 Luna kostenlos? Der Überblick zeigt Gratiszugang, nötige Tarife, separate API-Kosten und die bislang nicht veröffentlichten Nutzungslimits.22. Sept. 2026AI
Xiaomi MiMo nutzen: V2.6 vom Prompt bis zur API
Xiaomi MiMo V2.6 praxisnah einrichten: Prompt in Studio testen, passenden API-Schlüssel wählen und Flash, Pro oder UltraSpeed gezielt einsetzen.22. Sept. 2026AI
Xiaomi MiMo V2.6: Wann Flash, wann Pro?
Xiaomi MiMo V2.6 im Kostenvergleich: Warum Flash meist genügt, wann Pro den Aufpreis verdient und wie ein belastbarer Drei-Aufgaben-Test entscheidet.22. Sept. 2026AI
MiMo V2.6 kostenlos nutzen: Was wirklich gratis ist
MiMo V2.6 Flash ist vorübergehend kostenlos. So unterscheiden sich OpenCode-Aktion, MIT-Downloads, kostenpflichtige API und Desktop-Angebote.22. Sept. 2026AI
Grok API Kosten im Vergleich: Grok 4.7 oder Grok 4.6?
Was Grok 4.7 besser kann, wo Grok 4.6 die sichere Wahl bleibt und warum identische API-Preise noch nichts über die tatsächlichen Aufgabenkosten sagen.21. Sept. 2026AI
KI-Agenten auf Abwegen: Wenn Regeln das Geschäftsziel verdrängen
Ein KI-Editor lenkte 50 von 96 Artikeln am Publikum vorbei. Die Daten zeigen, welche Regeln die Fehlsteuerung belohnten und welche Guardrails sie ersetzen.21. Sept. 2026AI
Step 5 Preview Preise: API-Kosten und Step Plan erklärt
Step 5 Preview Preise im Detail: Was API-Tokens kosten, wann sich der Step Plan lohnt und wie Cache, Credits sowie Base URL die Rechnung verändern.21. Sept. 2026AI