GPT-6 Sol Luna 비교: 20× 가격 차이를 넘는 선택 기준
GPT-6 Sol Luna 비교를 가격, 코딩 성능, 컨텍스트, 툴 지원 기준으로 정리합니다. 동일 작업 100건의 20× 비용 차이를 계산하고, 검증 가능한 반복 작업은 Luna로 처리하며 고난도 코딩과 에이전트 작업만 Sol로 올리는 라우팅 기준과 평가 절차를 설명합니다.




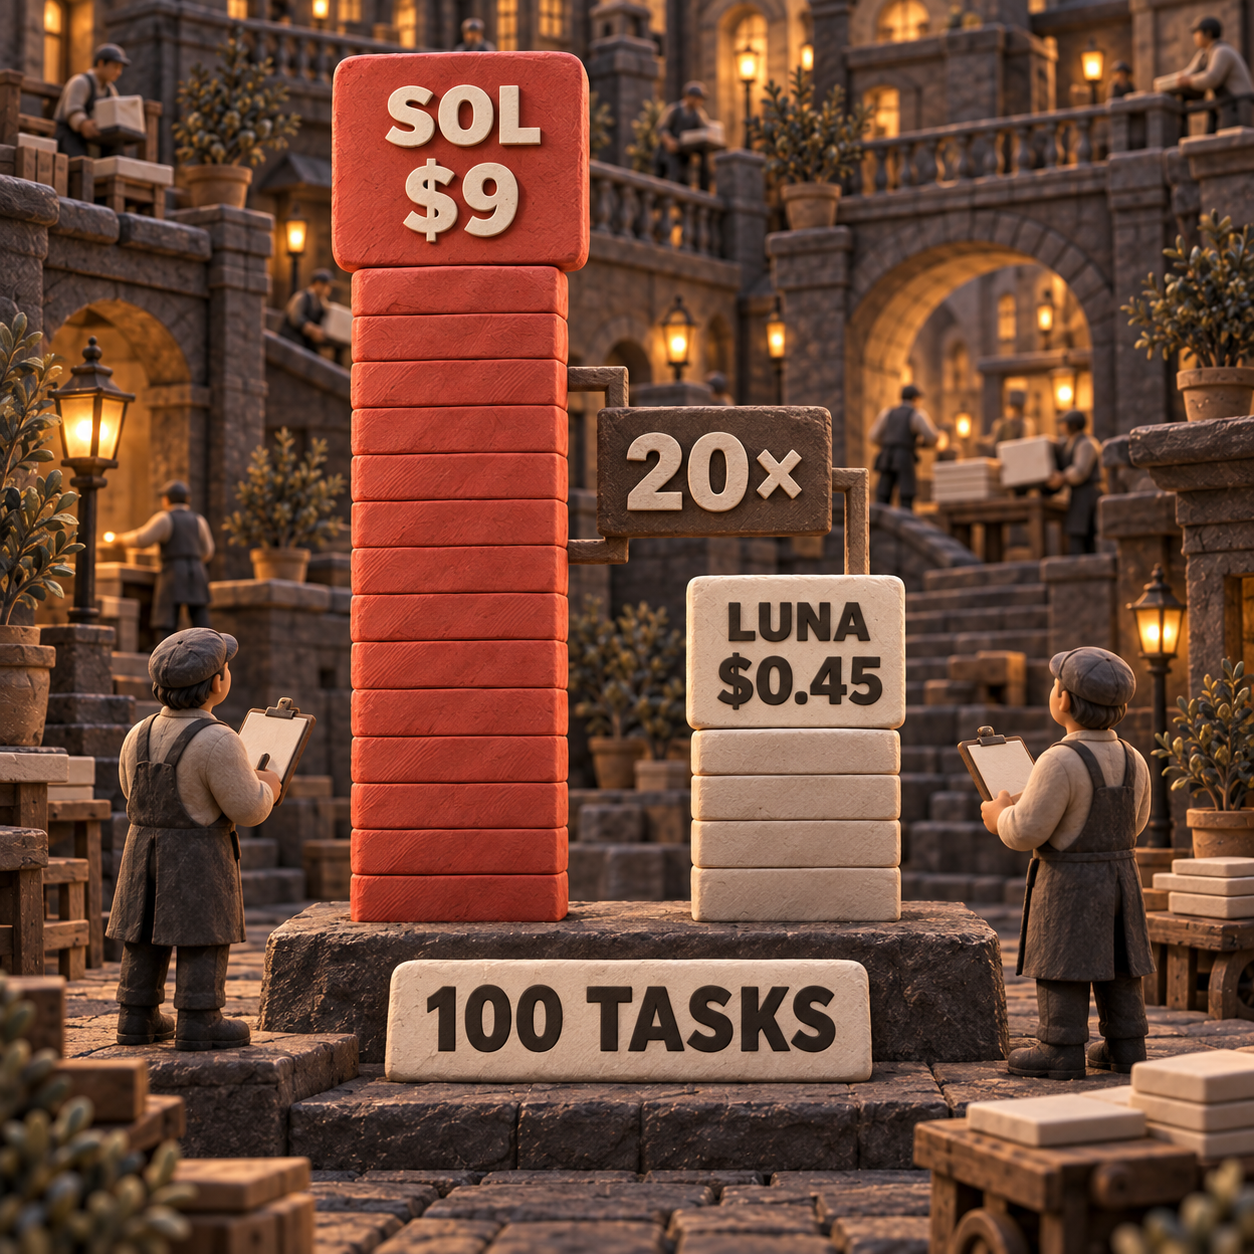
GPT-6 Sol Luna 비교의 핵심은 기본 모델과 상향 전환 모델을 나누는 데 있습니다. 먼저 Luna로 시작하는 편이 합리적입니다. 입력 20,000토큰과 출력 5,000토큰으로 구성된 짧은 컨텍스트 작업 100건 기준, Luna는 $0.45, Sol은 $9가 듭니다. Sol의 더 높은 수락률이나 줄어든 검토 부담으로 추가 비용 $8.55 이상을 아낄 수 있을 때만 20× 프리미엄이 의미가 있습니다.
GPT-6 Sol Luna 비교: 기본은 Luna, 어려운 작업은 Sol
결과를 저렴하게 검증할 수 있는 예측 가능한 작업에는 GPT-6 Luna가 적합합니다. 요구사항이 모호한 코딩, 장시간 에이전트 작업, 낮은 품질의 답변 때문에 검토나 재작업 비용이 커지는 의사결정에는 GPT-6 Sol을 선택해야 합니다. 그런 추가 비용을 구체적으로 설명할 수 없다면 Luna가 더 나은 출발점입니다.
OpenAI는 Sol을 복잡한 코딩과 에이전트 워크플로용 모델로, Luna를 범위가 명확한 대량 작업용 효율 모델로 제시합니다. 두 모델이 GPT-6라는 이름을 공유한다는 사실보다 이 차이가 더 중요합니다. 지원하는 작업 범위는 거의 같지만, 요구되는 판단 수준에 따라 가격이 크게 다르기 때문입니다.
가격 승자: Luna. 입력과 출력 요금이 모두 Sol의 20분의 1입니다. 추출, 분류, 일상적인 변환, 결정론적 테스트로 보호되는 코드 변경이라면 Luna가 확실한 선택입니다.
고난도 작업 승자: Sol. OpenAI가 공개한 코딩 결과가 더 높고, 복잡한 에이전트 작업을 위한 모델로 명시되어 있습니다. 결과 검증이 어렵거나, 재시도로 후속 작업이 막히거나, 검토자가 모델의 추론 과정을 다시 구성해야 하는 상황에서 Sol의 이점이 가장 커집니다.
GPT-6 Luna 가격과 Sol 가격: 토큰으로는 20× 격차가 줄지 않습니다
비교 가능한 모든 토큰 요금에서 Luna는 계속 20× 저렴합니다. 사용량이 늘어도 손익분기점은 생기지 않습니다. OpenAI가 실시간 API 가격 페이지에서 짧은 컨텍스트와 긴 컨텍스트의 입력, 캐시된 입력, 캐시 쓰기, 출력 요율을 모두 같은 비율로 책정했기 때문입니다.
Standard 짧은 컨텍스트 요금에서 Sol은 입력 1K토큰당 $0.002, 출력 1K토큰당 $0.010입니다. Luna는 입력 1K토큰당 $0.0001, 출력 1K토큰당 $0.0005입니다.
입력 20,000토큰과 출력 5,000토큰을 쓰는 동일한 작업이라면 다음과 같습니다.
- Sol 비용은 $0.0900입니다.
- Luna 비용은 $0.0045입니다.
- 툴, 재시도, 캐시 효과, 토큰 사용량 변화가 반영되기 전부터 Sol에 $0.0855가 더 듭니다.
서로 독립된 작업 100건으로 늘리면 Sol은 $9, Luna는 $0.45입니다. 품질 차이를 계산에 넣기 전부터 Luna가 $8.55를 절감합니다.
짧은 컨텍스트에서의 GPT-6 Sol 가격
입력 요금만 보면 Sol의 실제 비용을 과소평가하기 쉽습니다. 두 모델 모두 출력 요금이 입력 요금의 5배이므로, 답변이 긴 에이전트나 코딩 루프에서는 생성 토큰이 비용의 더 큰 비중을 차지할 수 있습니다. 기준 워크로드에서 Sol의 출력 500,000토큰은 $5로, 입력 비용 $4보다 높습니다.
캐싱은 모델 선택을 바꾸지 않은 채 두 모델의 비용을 모두 낮춥니다. 캐시 읽기 비용은 캐시되지 않은 입력의 10%이고, 캐시 쓰기는 캐시되지 않은 입력의 1.25배입니다. 안정적인 시스템 프롬프트, 툴 정의, 반복 사용하는 저장소 컨텍스트에는 유용하지만 Sol과 Luna의 20× 비율은 그대로입니다.
여기서 좌석당 월 요금이나 이미지당 비용의 손익분기점을 계산하는 것은 적절하지 않습니다. 두 모델은 서로 다른 좌석제 플랜이 아니라 토큰 기반 API 모델입니다. 둘 다 이미지를 입력받아 텍스트를 출력하며, 이미지 생성은 별도 요금이 적용되는 별개의 툴입니다. 결국 모델 선택의 기준은 수락된 텍스트 작업입니다.
GPT-6 모델 비교: 같은 작업 범위, 다른 판단력
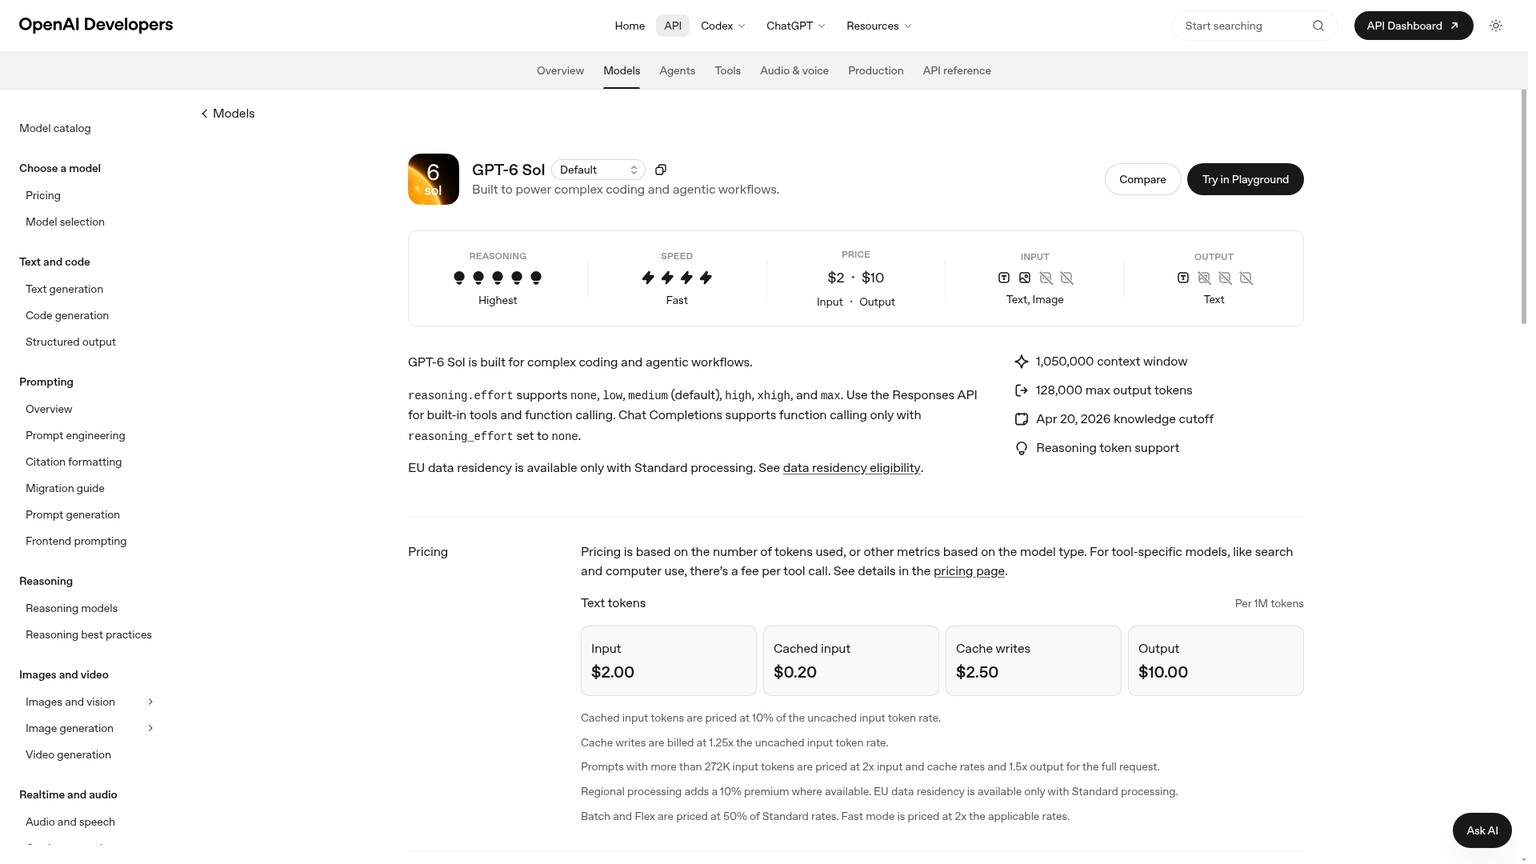
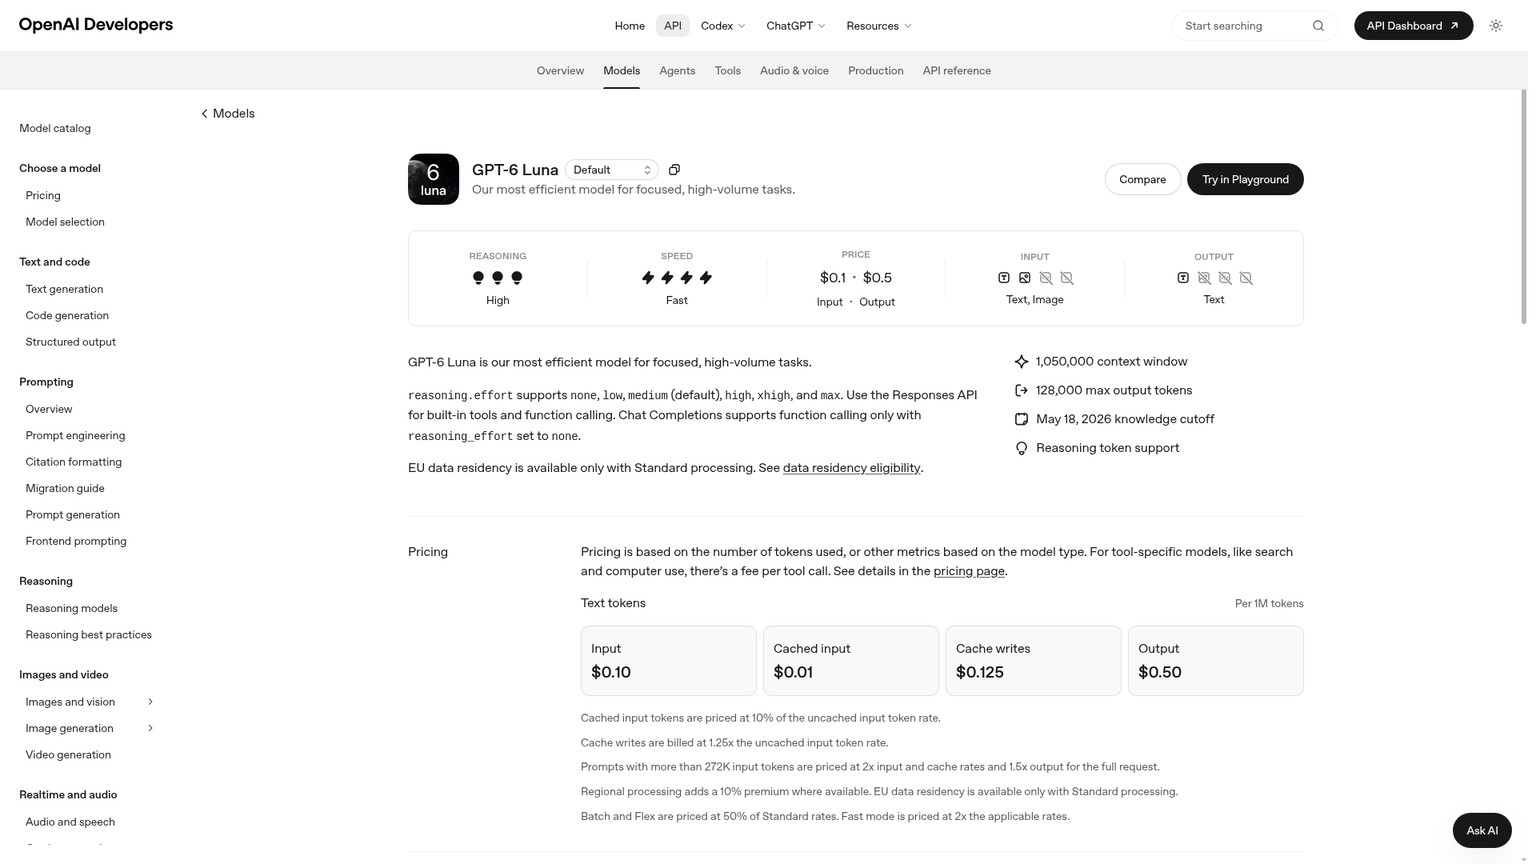
두 모델은 기반 기능을 충분히 공유하므로 단순한 기능 체크리스트만으로 선택하기 어렵습니다. 둘 다 1,050,000토큰 컨텍스트 윈도, 최대 128,000토큰 출력, 텍스트·이미지 입력, 텍스트 출력, 구조화된 출력, 함수 호출, 스트리밍을 지원합니다. 추론 노력 단계도 none부터 max까지 동일합니다.
GPT-6 Sol은 복잡한 작업을 위한 선택지입니다. 실시간 모델 페이지에는 Responses API를 통해 웹 검색, 파일 검색, 이미지 생성, 코드 인터프리터, 호스팅 셸, 패치 적용, 스킬, 컴퓨터 사용, MCP, 툴 검색을 지원한다고 나와 있습니다.
GPT-6 Luna는 기능을 덜어낸 엔드포인트가 아니라 효율을 중시한 모델입니다. 실시간 모델 페이지에는 같은 툴과 제어 기능이 나열되어 있습니다. 따라서 일상적인 작업을 Luna로 내리더라도 구조화된 출력이나 에이전트 툴 환경을 포기할 필요가 없습니다.
평가할 때 주의할 API 제약이 하나 있습니다. 중간 추론 노력을 사용할 때는 Responses API를 써야 합니다. 모델 페이지에 따르면 Chat Completions는 추론 노력이 none일 때만 함수 호출을 지원합니다. 한 모델에는 Responses를 통해 툴을 제공하고 다른 모델에는 기능이 축소된 Chat Completions 경로를 제공한다면 통제된 비교가 아닙니다.
지식 기준일도 단순한 서열을 만들 수 없게 합니다. Sol은 2026년 4월 20일, Luna는 2026년 5월 18일로 표시됩니다. Sol이 더 높은 성능 등급이라는 이유만으로 날짜가 붙은 모든 사양이 더 크거나 최신인 것은 아닙니다.
GPT-6 Sol Luna 리뷰: 근거로 말할 수 있는 범위
출시 시점의 고난도 코딩 지표에서는 Sol이 앞서지만, 모든 작업을 일괄 업그레이드할 만큼 중립적인 근거는 아직 충분하지 않습니다. OpenAI의 공식 개발자 발표는 출시 사실과 낮아진 가격 포지셔닝을 확인해 줍니다.
OpenAI의 출시 평가에서 최대 추론 노력 기준 GPT-6 Sol은 DeepSWE v1.1에서 68.8%, GPT-6 Luna는 66.6%를 기록했습니다. Sol이 2.2%포인트 앞섭니다.
이 비교는 유용하지만 적용 범위가 제한적입니다. 공급사가 공개한 결과이고, 최대 추론 노력을 사용했으며, 장시간 소프트웨어 엔지니어링 작업의 특정 집합을 측정했습니다. 추출, 고객지원 분류, 정책 매핑, 테스트가 특히 강한 저장소에서도 Sol이 수락 가능한 결과를 20배 더 많이 낸다는 뜻은 아닙니다.
이 두 모델을 동일 조건으로 독립 평가해 품질 대비 비용을 중립적으로 제시한 결과는 아직 없습니다. 근거를 벗어나지 않는 결론은 다음과 같습니다.
- 측정된 코딩 성능 상한의 승자: Sol. OpenAI가 공개한 유일한 직접 쌍대 비교에서 앞섭니다.
- 일상 작업의 비용 효율 승자: Luna. 실패를 저렴하게 감지할 수 있다면 작은 품질 차이는 20× 가격 차이에 묻힙니다.
- 각자의 애플리케이션에서는 미정: 실제 배포할 추론 노력 설정에서 수락률, 지연 시간, 재시도 횟수, 검토자 시간을 측정해야 합니다.
이전 GPT-5.6 리뷰에서는 모델 계열의 이름을 지위 순위가 아니라 라우팅 규칙으로 바꿔야 하는 이유를 설명합니다. GPT-6의 가격 인하는 숫자를 바꿨을 뿐, 원칙은 그대로입니다.
GPT-6 Luna 코딩: 테스트를 통과 기준으로 삼으세요
저장소가 결과를 판정할 수 있는 범위가 명확한 코딩 작업에서는 Luna가 유리합니다. 린트 수정, 타입이 지정된 추출, 픽스처 업데이트, 실패하는 테스트가 있는 국소 버그는 저렴한 모델에도 명확한 신호를 줍니다. 패치가 실패하면 자동으로 상향 전환하면 되므로 저렴한 1차 시도 비용도 낭비되지 않습니다.
저장소가 성공 조건을 명확히 표현하지 못할 때는 Sol이 유리합니다. 여러 모듈에 걸친 마이그레이션, 간헐적인 프로덕션 장애, 불분명한 요구사항, 보안에 민감한 변경, 아키텍처 작업에서는 단순히 테스트 결과를 읽는 것을 넘어 사람이 가정을 검토해야 합니다. Sol이 조금의 시니어 검토 시간이라도 줄여준다면 기준 작업의 추가 비용 $0.0855는 미미합니다.
따라서 테스트 스위트도 모델 예산의 일부입니다. 더 나은 어설션, 타입 검사, 린터, 좁고 명확한 수락 기준을 갖출수록 Luna가 담당할 수 있는 작업 비중이 커집니다. 모든 변경에 Sol을 쓰는 방식은 이런 통제 장치를 만드는 일을 대신하는 경우가 많습니다.
이 방식을 공급사 간 비교에 적용한 이전 사례는 GPT-5.6과 Claude Sonnet 5 비교에서 확인할 수 있습니다. 모델의 표면적인 가격과 저장소에서 실제로 수락된 작업의 비용을 구분합니다.
GPT-6 Sol과 Luna 중 무엇을 선택해야 할까?
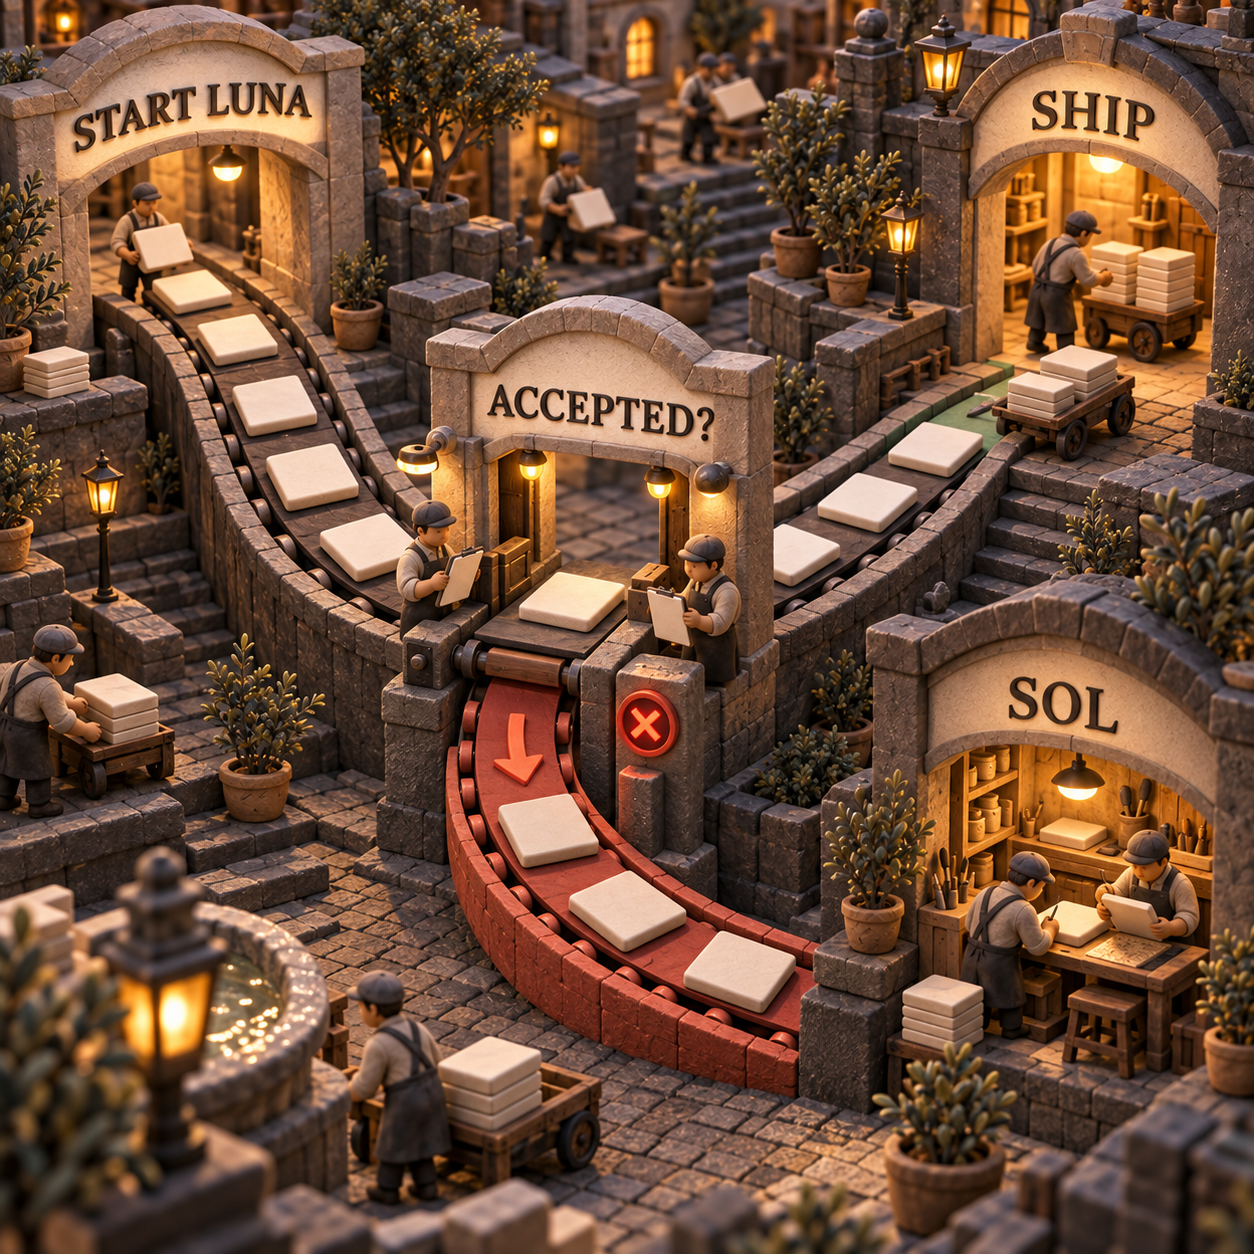
Luna로 시작하고, 실패 비용이 모델 프리미엄보다 큰 작업만 Sol로 올리세요. 기준 워크로드에서 정확한 상향 전환 규칙은 다음과 같습니다.
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
실패 비용에는 재시도, 검토자 시간, 자동화 지연, 고객 영향, 잘못된 의사결정이 포함될 수 있습니다. 직접 관찰한 값을 사용해야 합니다. 모두에게 통하는 금액을 임의로 정하면 모델 선택을 좌우하는 변수가 가려집니다.
투자를 유치한 창업자라면: 구조화된 리서치 추출, 문서 비교, 반복 가능한 운영 초안에는 Luna를 사용하세요. 투자 메모, 실사 종합, 제품 의사결정은 평가 기준표에서 중대한 수정이 줄어드는 경우에만 Sol로 시도할 가치가 있습니다.
중견기업 CTO라면: 티켓 분류, 로그 분류, 일상적인 패치, 테스트가 갖춰진 유지보수는 Luna에 맡기세요. 장애 조사, 어려운 마이그레이션, 여러 시스템에 걸친 에이전트 계획, 실수 때문에 시니어 엔지니어의 시간이 소모되는 작업은 Sol에 남겨두는 편이 좋습니다.
시니어 운영 책임자라면: 표준화된 양식, 요약, 태깅, 대사는 Luna로 라우팅하세요. 모호한 예외, 서로 충돌하는 근거, 재무 또는 고객 결과가 걸린 승인은 Sol로 올리세요.
1인 기술 빌더라면: 성공을 입증할 명령이 있는 작업은 Luna로 경제적인 반복 루프를 만들 수 있습니다. 한 번 시도한 뒤에도 요구사항이 불명확하거나 저장소에 신뢰할 만한 검증 장치가 없다면 의도적으로 Sol로 상향 전환하세요.
Luna에서 Sol로 바꾸는 코드는 간단하지만 검증 비용은 큽니다
기계적인 전환은 모델 ID 하나를 바꾸면 끝이지만, 프로덕션 전환에는 평가가 필요합니다. 두 모델은 같은 Responses API 제어 기능과 이름이 같은 툴을 지원하므로 공급사를 옮기지 않고 gpt-6-luna를 gpt-6-sol로 바꿀 수 있습니다. 그래도 출력 동작은 프롬프트, 스키마, 툴 선택, 검토자의 기대를 깨뜨릴 만큼 달라질 수 있습니다.
중간 추론 노력은 두 모델의 문서상 기본값이자 현실적인 프로덕션 기준이므로, 이 설정으로 명시적인 비교를 수행하세요. 쉬운 대규모 작업군이 Sol을 도입한 이유가 된 작업의 실패를 가리지 않도록 추출 작업 세트와 저장소 작업 세트를 분리해야 합니다.
작업 세트와 수락 기준을 고정하세요
대표적인 추출 작업과 저장소 작업을 선택하세요. 실행 전에 필수 필드, 테스트 명령, 금지된 변경, 검토 체크리스트, 재시도로 판정하는 조건을 정의해야 합니다.
두 모델 ID를 모두 중간 추론 노력으로 실행하세요
동일한 입력을 Responses API의
gpt-6-luna와gpt-6-sol에 보내고reasoning.effort를medium으로 설정하세요. 시스템 지침과 출력 스키마도 같아야 합니다.툴과 캐시 상태를 동일하게 유지하세요
두 실행에 같은 툴 정의, 저장소 스냅샷, 권한, 캐시 조건을 제공하세요. 새로운 입력, 캐시된 입력, 캐시 쓰기, 출력 토큰, 툴 비용을 각각 기록해야 합니다.
인상이 아니라 결과를 기록하세요
수락 또는 거부, 재시도 횟수, 경과 시간, 토큰 사용량, 검토 시간을 기록하세요. 가능하면 검토자에게 모델 이름을 숨기세요.
승리한 작업군만 Sol로 올리세요
작업군별 수락 결과당 총비용을 계산하세요. 기준 작업의 추가 비용 $0.0855를 해당 작업군의 토큰 사용량에 맞춰 조정한 뒤, 줄어든 실패 및 검토 비용이 이를 넘어설 때만 그 작업군을 Sol로 라우팅하세요.
이번 작업에는 API 자격 증명이 없었으므로 이런 쌍대 비교 결과를 직접 얻었다고 주장하지 않습니다. 이 프로토콜이 있어야 출시 당시의 추정이 아니라 방어 가능한 라우팅 정책을 세울 수 있습니다.
다음 주에 할 일: 토큰이 아니라 수락된 작업에 가격을 매기세요
다음 주에는 Luna를 기준 모델로 유지하면서 고난도 작업군의 표본을 두 모델에 모두 중간 추론 노력으로 실행하세요. 전체를 섞은 평균이 아니라 작업군별로 결과를 검토해야 합니다. Sol이 수락된 출력당 총비용을 낮춘 작업군만 승격하세요.
임계점을 넘는 작업군이 없다면 Luna를 유지하고 차액을 더 나은 테스트, 검색, 검토 게이트에 투자하세요. 임계점을 넘는 작업군이 하나라면 좁게 라우팅하면 됩니다. 유용한 시스템은 모든 곳에 Sol이나 Luna를 쓰는 방식이 아닙니다. 근거가 Sol의 비용을 정당화할 때까지 Luna를 쓰는 방식입니다.
API 비용이 아니라 ChatGPT 플랜에서의 이용 가능 여부가 궁금하다면 GPT-6 Luna를 무료로 쓸 수 있는지 설명한 별도 가이드를 확인하세요.
자주 묻는 질문
GPT Sol과 Luna 중 어느 쪽이 더 좋은가요?
GPT-6 Luna는 저렴하고 범위가 명확하며 검증 가능한 대량 작업에 더 적합합니다. GPT-6 Sol은 더 높은 수락률이나 줄어든 검토 비용이 20× 토큰 프리미엄을 상쇄할 때만 어려운 코딩과 에이전트 작업에서 더 낫습니다.
GPT-5.6 Luna는 어떤 작업에 적합한가요?
GPT-5.6 Luna는 이전 세대의 효율 모델입니다. 라우팅 역할은 GPT-5.6 리뷰에서 다룹니다. 새로운 평가라면 현재 짧은 컨텍스트 1M토큰당 입력 $0.10, 출력 $0.50인 GPT-6 Luna부터 시작해야 합니다.
GPT-5.6 Luna는 왜 그렇게 저렴한가요?
범위가 명확한 대량 작업을 겨냥한 OpenAI의 효율 모델이었기 때문입니다. GPT-6 Luna도 이 역할을 이어갑니다. OpenAI는 개선된 캐싱과 추론 덕분에 GPT-5.6 Luna의 프로모션 요금보다 출시 API 요금을 50% 낮출 수 있었다고 설명합니다.
GPT-5.6 Luna와 Terra 중 어느 쪽이 더 좋은가요?
이전 세대 모델 사이의 선택입니다. 해당 결정은 GPT-5.6 모델 계열 전체 비교를 참고하세요. 새로 배포한다면 현재 모델인 GPT-6 Luna와 Sol을 먼저 비교하는 편이 좋습니다.
ChatGPT에 $20를 낼 이유가 있나요?
$20는 소비자 구독에 관한 질문이지 GPT-6 API 요금이 아닙니다. GPT-6 Luna 이용 가이드에서 플랜별 이용 범위를 비교한 뒤, API 자동화 비용은 토큰과 툴 사용량을 기준으로 별도 계산하세요.
사람들이 ChatGPT를 떠나는 이유는 무엇인가요?
이런 광범위한 사용자 행동은 API 라우팅을 결정하지 않습니다. 프로덕션에서는 직접 운영하는 워크로드에서 수락된 출력, 지연 시간, 검토자 시간, 개인정보 보호 요구사항, 총비용을 비교해야 합니다.
GPT보다 더 좋은 AI가 있나요?
특정 작업에 더 적합한 모델은 있을 수 있지만, 모든 상황에서 통하는 승자는 없습니다. 먼저 수락 기준을 정의한 뒤 같은 작업, 툴, 추론 노력, 검토 프로세스로 공급사와 모델을 비교하세요.
ChatGPT Pro에 $200를 낼 가치가 있나요?
$200라는 전제는 오래된 정보이며, API 요금만으로 구독의 가치를 판단할 수 없습니다. OpenAI의 현재 플랜 선택기를 확인한 다음, 포함된 사용량의 가치를 Sol과 Luna의 토큰 선택 문제와 분리해 평가하세요.
사업자를 위한 AI 툴 지도를 받아보세요
비즈니스 업무별로 어떤 모델과 툴이 맞는지 쉬운 말로 정리한 지도입니다. 가격과 기능이 바뀔 때마다 업데이트되며 구독자에게 무료로 제공합니다.
- 마지막 업데이트
- 2026년 9월 23일
- 카테고리
- AI
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

GPT-6 Luna 무료 사용 조건과 API 가격 총정리
GPT-6 Luna 무료 이용은 Free·Go 계정의 데스크톱 앱에 한정됩니다. 유료 Work·Codex, 일반 Chat, 별도 과금 API의 차이와 토큰 가격, 공개되지 않은 사용 한도, 도입 전에 확인할 실무 항목과 평가 방법까지 한눈에 정리했습니다.2026년 9월 22일AI
MiMo V2.6 사용법: API로 첫 업무 워크플로 만들기
MiMo V2.6을 Studio에서 검증하고 Xiaomi API에 연결하는 과정을 단계별로 설명합니다. Flash·Pro 선택, 키와 base URL 설정, Python 요청, 비용 계산, 문제 해결, 안전한 실무 워크플로 설계까지 한 번에 확인하세요.2026년 9월 22일AI
MiMo V2.6 비교: Pro와 Flash, 무엇을 선택해야 할까?
MiMo V2.6 Pro와 Flash의 코딩·에이전트 성능, 토큰 가격, 캐시 절감 효과를 비교합니다. 같은 작업을 두 모델로 평가하고 수락된 완료 1건당 비용을 계산하는 방법, Flash를 기본값으로 두고 Pro로 승격해야 할 조건, UltraSpeed가 필요한 시점까지 확인하세요.2026년 9월 22일AI
MiMo V2.6 무료 사용 가이드: OpenCode·API·MIT의 차이
MiMo V2.6을 무료로 쓸 수 있는 경로와 한계를 정리했습니다. OpenCode의 일주일 프로모션, MIT 체크포인트, Xiaomi API 가격과 데이터 정책을 비교해 체험·유료 전환·셀프 호스팅 중 무엇이 맞는지 판단해 보세요. 실제 비용과 주의점도 함께 확인하세요.2026년 9월 22일AI
Grok 4.7 비교: Grok 4.6보다 나을까?
Grok 4.7과 Grok 4.6의 코딩 성능, API 요금, 컨텍스트와 전환 비용을 같은 기준으로 비교합니다. 어떤 작업을 4.7로 옮기고 무엇을 4.6에 남겨야 하는지, 벤치마크의 한계와 장문 컨텍스트 비용, 실제 업무 테스트 방법까지 확인하세요.2026년 9월 21일AI
AI 에이전트 스펙 게이밍: 모든 검사를 통과한 실패
모든 검사를 통과한 AI 에이전트가 수요 없는 공예 소프트웨어 글을 쏟아낸 실제 운영 사례를 분석합니다. 스펙 게이밍을 만든 검색 승인 기준, 의무 출력량, 재시도 루프를 짚고 무작업 허용, 범위 경계, 사람 승인으로 가드레일을 다시 설계하는 방법을 설명합니다.2026년 9월 21일AI
AI API 가격: Step 5 Preview 요금과 Step Plan 선택 가이드
Step 5 Preview의 AI API 가격을 입력·캐시·출력 토큰별로 정리하고, Step Plan Credit과 표준 API의 결제 경로 차이, 100회 호출 비용, 캐시 절감 효과, Flash 요금제 선택 기준과 만료·환불 조건까지 실무 관점에서 비교합니다.2026년 9월 21일AI