GPT-6 Sol ou Luna : quel modèle choisir ?
GPT-6 Sol ou Luna : comparez prix, usages, limites et coût par résultat accepté pour choisir le bon modèle sans payer 20× plus cher par défaut.




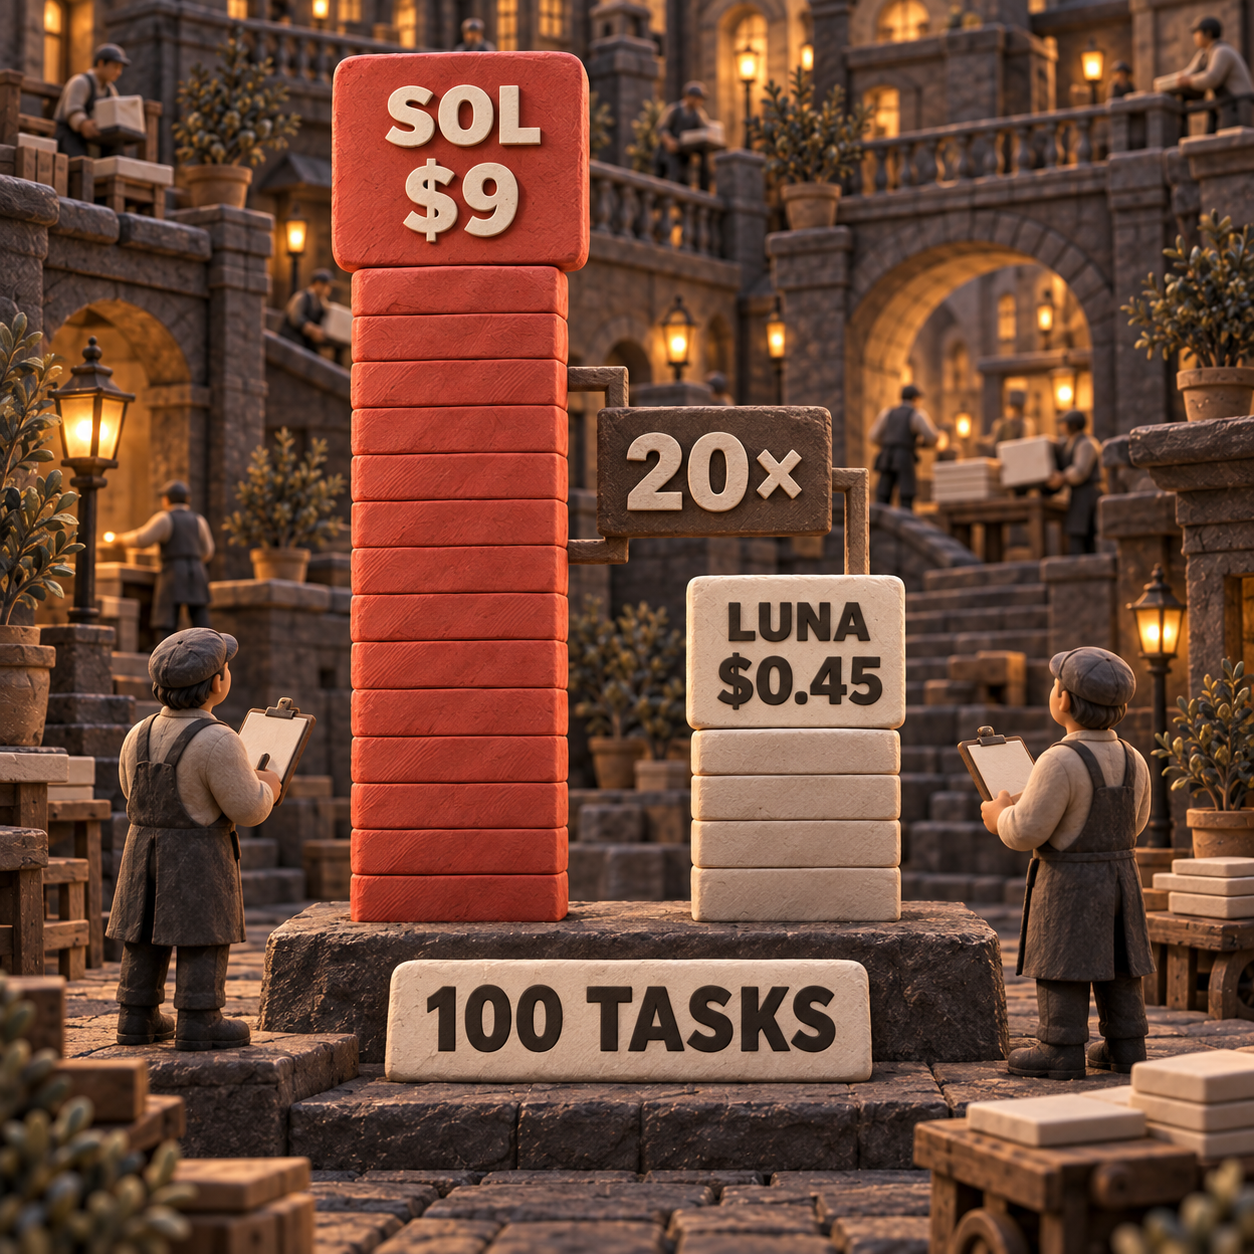
GPT-6 Sol ou Luna : le choix oppose un modèle par défaut à un modèle d’escalade. Commencez par Luna. Pour 100 tâches en contexte court, avec chacune 20,000 tokens en entrée et 5,000 en sortie, Luna coûte $0.45 contre $9 pour Sol. Le surcoût de 20× de Sol ne se justifie que si son meilleur taux d’acceptation ou la baisse du temps de relecture économise plus que les $8.55 supplémentaires.
GPT-6 Sol ou Luna : commencez par Luna, réservez Sol aux cas difficiles
Choisissez GPT-6 Luna pour les tâches prévisibles que vous pouvez vérifier à peu de frais. Réservez GPT-6 Sol au code ambigu, aux longues missions agentiques et aux décisions dont une réponse médiocre entraînerait beaucoup de relecture ou de reprise. Si vous ne pouvez pas nommer cette conséquence supplémentaire, Luna constitue le meilleur point de départ.
OpenAI présente Sol comme le modèle destiné au code complexe et aux workflows agentiques, tandis que Luna mise sur l’efficacité pour les tâches ciblées et à fort volume. Cette distinction compte davantage que leur nom commun GPT-6 : leur périmètre opérationnel est presque identique, mais leur tarification correspond à des niveaux de jugement très différents.
Vainqueur sur le prix : Luna. Les tarifs d’entrée comme de sortie représentent chacun un vingtième de ceux de Sol. Luna s’impose donc pour l’extraction, la classification, les transformations courantes et les modifications de code encadrées par des tests déterministes.
Vainqueur sur les tâches difficiles : Sol. OpenAI lui attribue le meilleur résultat en code et le positionne explicitement sur les tâches agentiques complexes. Son intérêt est maximal lorsqu’un résultat est difficile à vérifier, qu’une nouvelle tentative bloque la suite du travail ou qu’un relecteur doit reconstituer le raisonnement du modèle.
Prix de GPT-6 Sol et Luna : l’écart de 20× ne disparaît jamais
Luna reste 20× moins cher à chaque tarif comparable. L’augmentation du volume ne crée aucun point de croisement, car OpenAI conserve le même rapport pour les tokens d’entrée, les entrées en cache, l’écriture du cache et les sorties, en contexte court comme long, sur sa page de tarification de l’API.
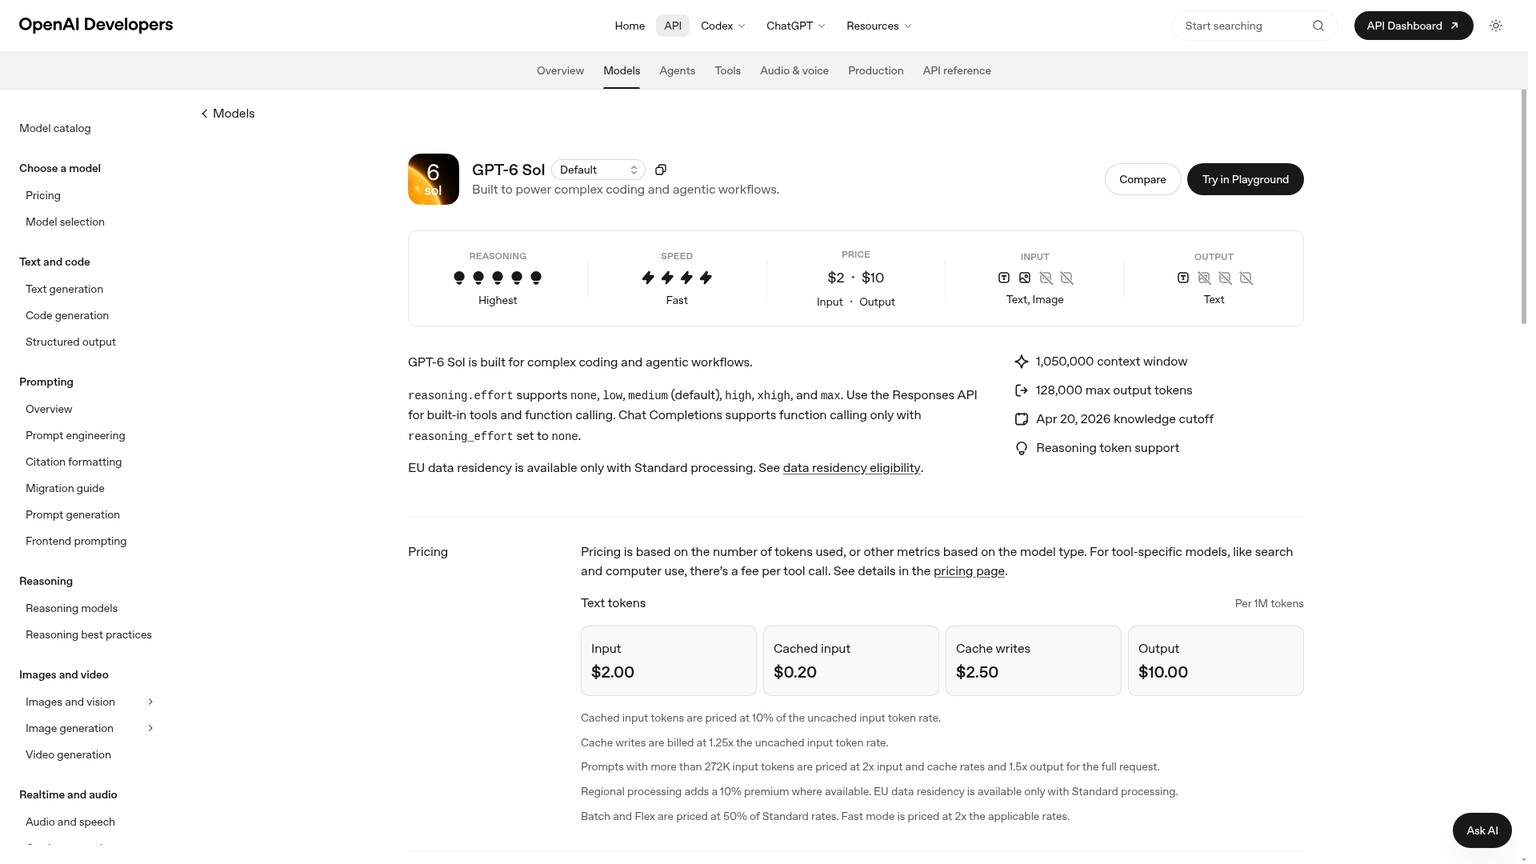
Aux tarifs Standard en contexte court, Sol coûte $0.002 par 1K tokens d’entrée et $0.010 par 1K tokens de sortie. Luna coûte $0.0001 par 1K tokens d’entrée et $0.0005 par 1K tokens de sortie.
Pour une même tâche comprenant 20,000 tokens en entrée et 5,000 en sortie :
- Sol coûte $0.0900.
- Luna coûte $0.0045.
- Sol ajoute $0.0855 avant les outils, les nouvelles tentatives, les effets du cache ou toute variation du nombre de tokens.
Sur 100 tâches distinctes, le coût atteint $9 avec Sol contre $0.45 avec Luna. Le lot permet donc d’économiser $8.55 avec Luna avant même de tenir compte d’une éventuelle différence de qualité.
Tarif de GPT-6 Sol en contexte court
Le prix de Sol est facile à sous-estimer lorsque la comparaison s’arrête aux entrées. Pour les deux modèles, la sortie coûte cinq fois plus cher que l’entrée. Les tokens générés peuvent donc devenir le principal poste de dépense d’un agent prolixe ou d’une boucle de développement. Dans la charge de référence, les 500,000 tokens de sortie de Sol coûtent $5, contre $4 pour les entrées.
La mise en cache réduit les deux factures sans modifier le choix. Les lectures en cache coûtent 10% du tarif d’une entrée non mise en cache, tandis que l’écriture du cache coûte 1.25 fois ce tarif. C’est utile pour les prompts système stables, les définitions d’outils et le contexte de dépôt réutilisé, mais le rapport de 20× entre Sol et Luna reste inchangé.
Il n’existe ici aucun point de croisement crédible par siège mensuel ou par image. Ces modèles d’API sont facturés au token, et non selon des formules d’abonnement distinctes. Tous deux acceptent des images en entrée et produisent du texte ; la génération d’images relève d’un outil séparé, facturé à part. Le choix du modèle dépend donc toujours du travail textuel effectivement accepté.
Comparatif GPT-6 Sol Luna : même cadre, jugement différent
Les deux modèles partagent suffisamment d’infrastructure pour qu’une simple liste de fonctionnalités soit un mauvais critère de sélection. Tous deux annoncent une fenêtre de contexte de 1,050,000 tokens, une sortie maximale de 128,000 tokens, du texte et des images en entrée, du texte en sortie, les sorties structurées, les appels de fonction, le streaming et la même échelle d’effort de raisonnement, de none à max.
GPT-6 Sol est l’option réservée aux tâches complexes. Sa page modèle répertorie la recherche web, la recherche de fichiers, la génération d’images, l’interpréteur de code, le shell hébergé, apply patch, les skills, l’utilisation de l’ordinateur, MCP et la recherche d’outils via l’API Responses.
GPT-6 Luna est l’option efficace, pas une version amputée. Sa page modèle présente les mêmes outils et réglages. Basculer les tâches courantes vers Luna n’oblige donc à renoncer ni aux sorties structurées ni à l’environnement d’outils pour agents.
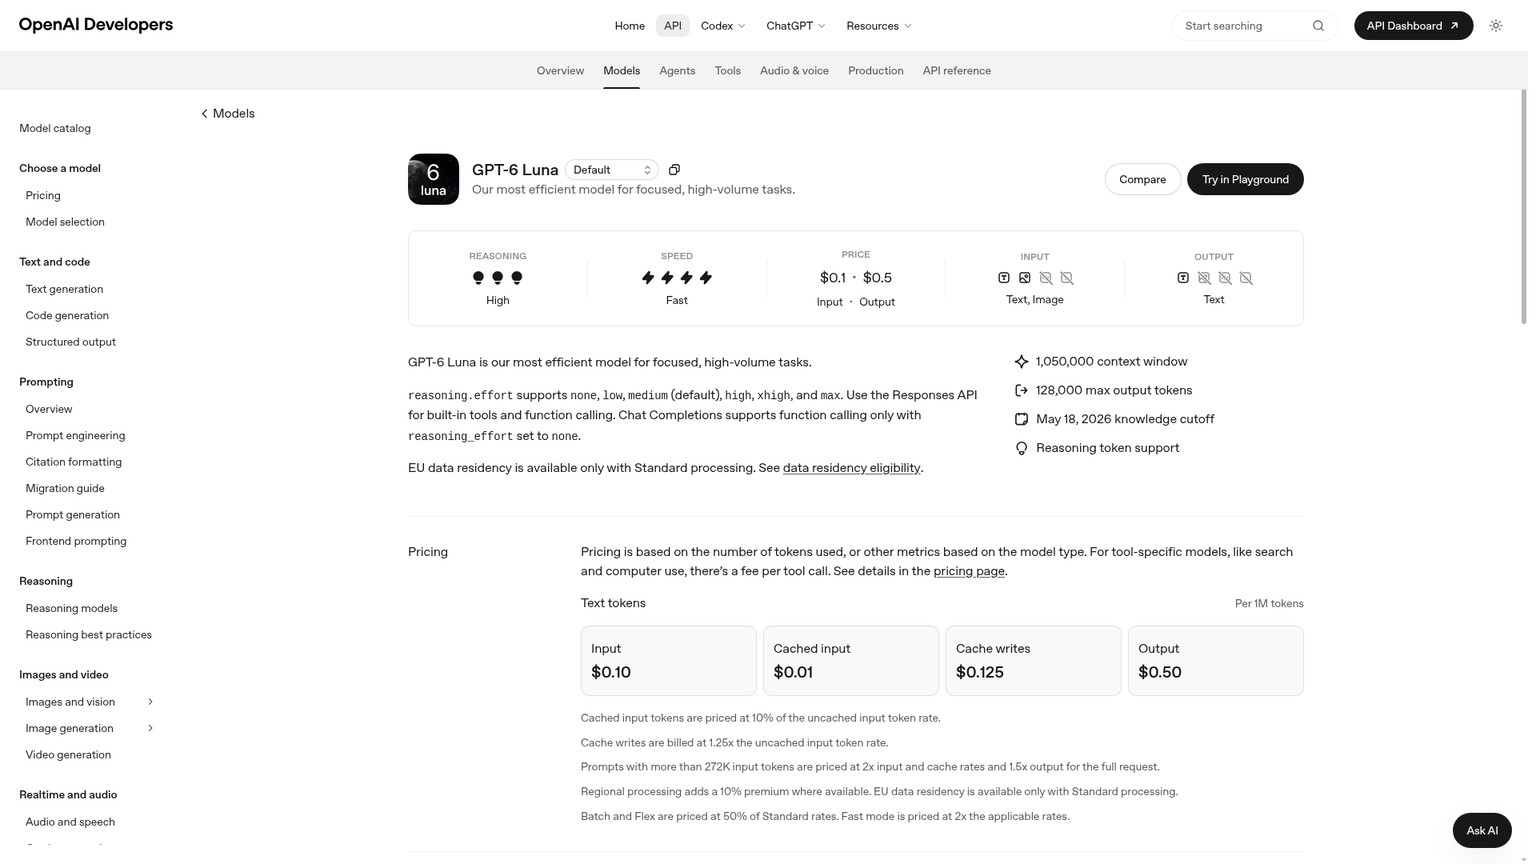
Une contrainte d’API compte pendant l’évaluation : avec un effort de raisonnement moyen, utilisez l’API Responses. Les pages des modèles précisent que Chat Completions ne prend en charge les appels de fonction que si l’effort de raisonnement est réglé sur none. Comparer un modèle doté d’outils via Responses à un autre limité par Chat Completions fausserait l’expérience.
Les dates de fin des connaissances ne dessinent pas non plus une hiérarchie simple. Celle de Sol est le 20 avril 2026, celle de Luna le 18 mai 2026. Le niveau de capacité supérieur de Sol ne signifie pas que chacune de ses caractéristiques datées est plus élevée ou plus récente.
Test de GPT-6 Sol face à Luna : ce que prouvent les données
Sol affiche le meilleur signal initial pour le code difficile, mais les preuves neutres restent insuffisantes pour justifier une mise à niveau systématique. L’annonce officielle destinée aux développeurs d’OpenAI confirme le lancement et le positionnement tarifaire inférieur de Luna.
Dans l’évaluation de lancement d’OpenAI, GPT-6 Sol a obtenu 68.8% sur DeepSWE v1.1 à l’effort maximal, contre 66.6% pour GPT-6 Luna. Sol devance donc Luna de 2.2 points de pourcentage.
Cette comparaison est utile, mais son périmètre est limité. Elle provient du fournisseur, emploie l’effort maximal et mesure un ensemble précis de tâches de génie logiciel de longue durée. Elle ne montre pas que Sol produira 20 fois plus de résultats acceptés pour l’extraction, le triage du support, la mise en correspondance de politiques ou un dépôt doté de tests particulièrement solides.
Aucun test indépendant et comparable de ces deux modèles ne permet encore d’établir un rapport qualité-prix neutre. La conclusion défendable est plus ciblée :
- Vainqueur sur le plafond mesuré en code : Sol. Il domine le seul score comparatif direct publié par OpenAI.
- Vainqueur sur les tâches courantes ajustées au coût : Luna. Un faible écart de qualité est balayé par un écart de prix de 20× lorsque les erreurs sont faciles à détecter.
- Verdict encore ouvert pour votre application : taux d’acceptation, latence, nombre de nouvelles tentatives et temps de relecture au niveau d’effort réellement déployé.
Le précédent test de GPT-5.6 explique pourquoi les noms de familles de modèles doivent servir à établir des règles de routage, et non un classement de prestige. La baisse de prix de GPT-6 change les chiffres, pas ce principe.
GPT-6 Luna pour le code : faites des tests votre arbitre
Luna s’impose pour les tâches de code bien délimitées lorsque le dépôt sait juger la réponse. Une correction de lint, une extraction typée, une mise à jour de fixture ou un bug localisé assorti d’un test en échec donne un signal ferme au modèle le moins cher. Si le patch échoue, l’escalade est automatique et le faible coût de la première tentative n’a pas été gaspillé.
Sol l’emporte lorsque le dépôt ne peut pas formaliser clairement la réussite. Les migrations entre plusieurs modules, les incidents intermittents en production, les exigences floues, les modifications sensibles pour la sécurité et les travaux d’architecture obligent un humain à contrôler les hypothèses au lieu de simplement lire le résultat d’un test. Le supplément de $0.0855 sur la tâche de référence est négligeable si Sol évite ne serait-ce qu’un peu de relecture par un profil senior.
La suite de tests fait donc partie intégrante du budget modèle. De meilleures assertions, des vérifications de types, des linters et des critères d’acceptation précis élargissent la part du travail que Luna peut prendre en charge. Payer Sol pour chaque modification revient souvent à compenser l’absence de ces garde-fous.
Pour un précédent exemple de cette méthode entre fournisseurs, le comparatif entre GPT-5.6 et Claude Sonnet 5 distingue le prix brut du modèle du coût du travail effectivement accepté dans un dépôt.
GPT-6 Sol ou Luna : la règle de décision
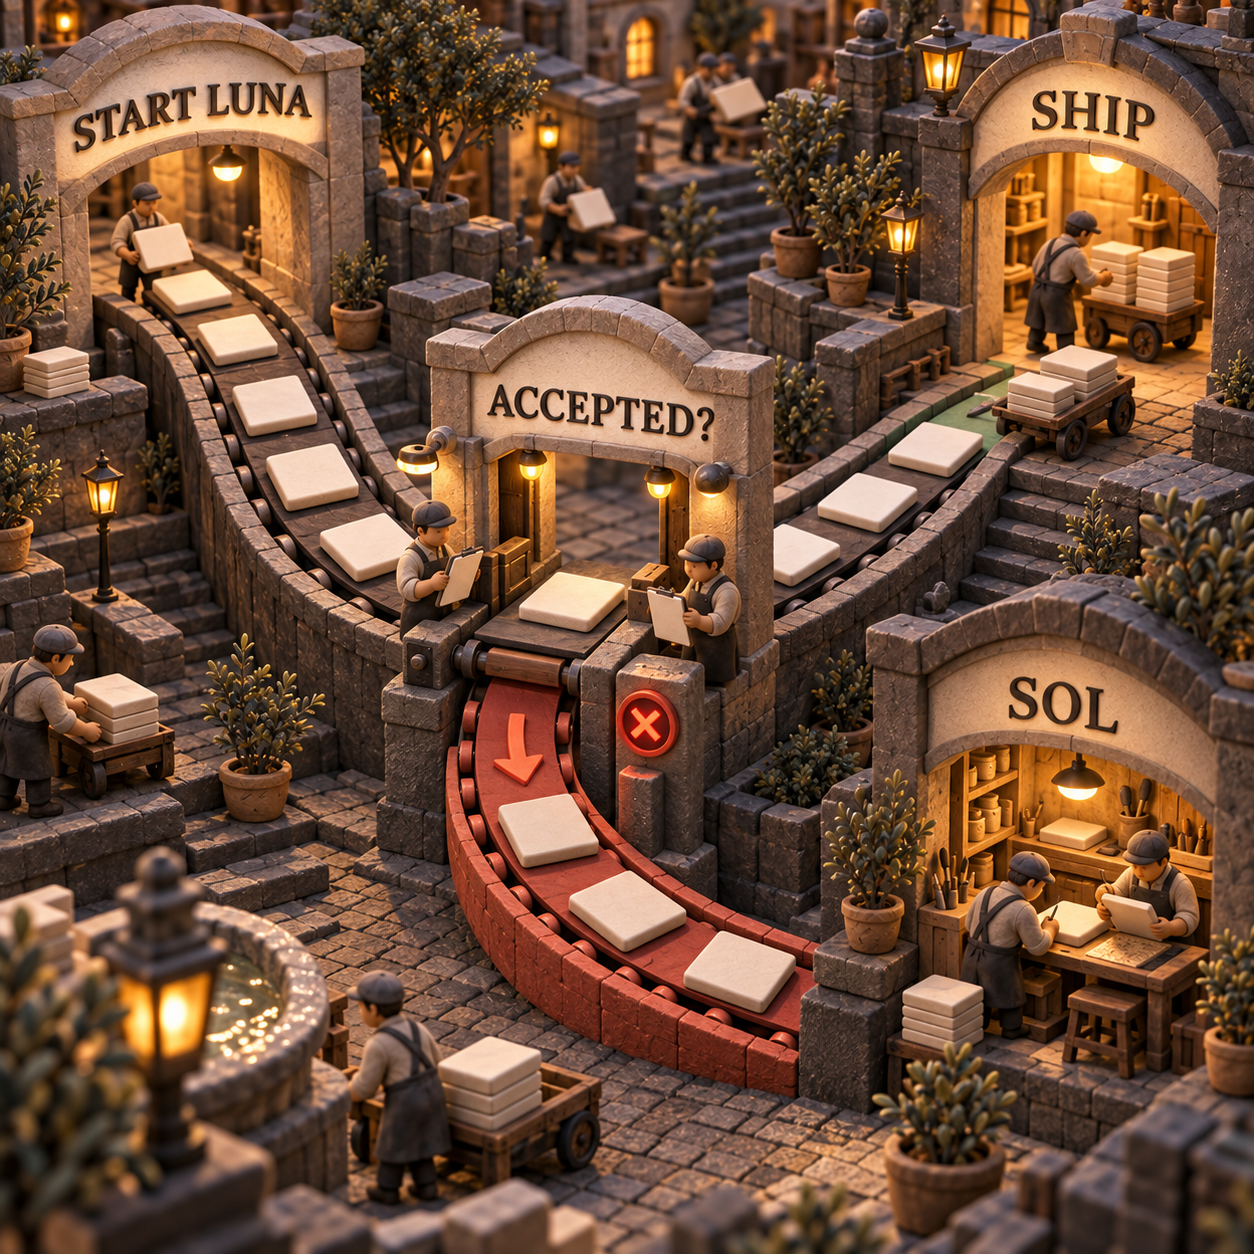
Commencez avec Luna, puis ne faites monter que les tâches dont l’échec coûte plus cher que le surcoût du modèle. Pour la charge de référence, la règle exacte est la suivante :
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
Le coût d’un échec peut inclure une nouvelle tentative, le temps du relecteur, une automatisation retardée, un impact client ou une mauvaise décision. Utilisez votre propre valeur observée. Inventer un montant universel masquerait la variable qui décide réellement du modèle.
Pour une start-up financée : utilisez Luna pour extraire des données de recherche structurées, comparer des documents et rédiger des livrables opérationnels répétables. Testez Sol sur les notes d’investissement, les synthèses de due diligence ou les décisions produit uniquement si une grille d’évaluation révèle moins de corrections importantes.
Pour le CTO d’une entreprise de taille intermédiaire : confiez à Luna le triage des tickets, la classification des logs, les correctifs courants et la maintenance encadrée par des tests. Gardez Sol pour l’analyse d’incidents, les migrations difficiles, les plans d’agents couvrant plusieurs systèmes et les erreurs qui mobilisent le temps des ingénieurs seniors.
Pour un responsable opérationnel expérimenté : routez vers Luna les formulaires standardisés, les résumés, l’étiquetage et les rapprochements. Faites remonter à Sol les exceptions ambiguës, les éléments contradictoires et les validations ayant des conséquences financières ou client.
Pour un développeur technique indépendant : Luna constitue la boucle économique pour les tâches dont une commande peut prouver la réussite. Sol devient l’escalade délibérée lorsque la mission reste insuffisamment définie après une tentative ou que le dépôt ne dispose pas de contrôles fiables.
Passer de Luna à Sol est simple dans le code, coûteux à valider
Le changement mécanique tient à un identifiant de modèle, mais le changement en production exige une évaluation. Les deux modèles emploient les mêmes réglages de l’API Responses et prennent en charge les mêmes outils nommés : gpt-6-luna peut donc devenir gpt-6-sol sans migration de fournisseur. Le comportement des sorties peut néanmoins changer suffisamment pour casser les prompts, les schémas, le choix des outils et les attentes des relecteurs.
Effectuez une comparaison explicite avec un effort moyen : c’est la valeur par défaut documentée des deux modèles et une base réaliste en production. Séparez le jeu d’extraction du jeu de dépôt, afin qu’une grande catégorie facile ne masque pas les échecs sur les tâches qui ont motivé le recours à Sol.
Figez les tâches et la grille d’acceptation
Sélectionnez des tâches d’extraction et de dépôt représentatives. Définissez le résultat acceptable avant l’exécution : champs obligatoires, commande de test, modifications interdites, liste de contrôle pour la relecture et critère déclenchant une nouvelle tentative.
Testez les deux identifiants exacts avec un effort moyen
Envoyez des entrées identiques à
gpt-6-lunaetgpt-6-solvia l’API Responses, avecreasoning.effortréglé surmedium. Conservez les mêmes instructions système et les mêmes schémas de sortie.Gardez les outils et l’état du cache constants
Fournissez aux deux exécutions les mêmes définitions d’outils, le même instantané du dépôt, les mêmes autorisations et les mêmes conditions de cache. Consignez séparément les entrées nouvelles, les entrées en cache, les écritures dans le cache, les tokens de sortie et les frais d’outils.
Mesurez les résultats, pas les impressions
Consignez l’acceptation ou le rejet, le nombre de nouvelles tentatives, le temps écoulé, les tokens consommés et les minutes de relecture. Lorsque c’est possible, masquez au relecteur le nom du modèle.
Ne promouvez que la catégorie gagnante
Calculez le coût total par résultat accepté pour chaque catégorie de tâches. Ne routez une catégorie vers Sol que si la baisse du coût des échecs et de la relecture dépasse les $0.0855 supplémentaires de la tâche de référence, après ajustement au nombre de tokens de cette catégorie.
L’absence d’identifiant d’API pendant ce test signifie qu’aucun résultat comparatif de ce type n’est revendiqué ici. Ce protocole sépare une politique de routage défendable d’une hypothèse formulée le jour du lancement.
À faire lundi : mesurez le coût du travail accepté, pas celui des tokens
La semaine prochaine, conservez Luna comme référence et échantillonnez les cas difficiles sur les deux modèles avec un effort moyen. Examinez les résultats par catégorie de tâches, et non sous la forme d’une moyenne globale. Ne promouvez que la catégorie pour laquelle Sol réduit le coût total par sortie acceptée.
Si aucune catégorie ne franchit le seuil, restez sur Luna et investissez la différence dans de meilleurs tests, la récupération d’informations et les contrôles de relecture. Si une catégorie le franchit, routez-la précisément. Le bon système n’est ni Sol partout ni Luna partout : c’est Luna jusqu’à ce que les preuves financent Sol.
Pour comparer les formules ChatGPT plutôt que l’économie de l’API, consultez le guide séparé qui explique si GPT-6 Luna est gratuit.
Questions fréquentes
GPT Sol ou Luna : lequel est le meilleur ?
GPT-6 Luna est préférable pour les tâches ciblées, peu coûteuses et à fort volume que vous pouvez vérifier. GPT-6 Sol convient mieux au code difficile et au travail agentique uniquement si son meilleur taux d’acceptation ou la baisse du coût de relecture compense son surcoût de 20× sur les tokens.
À quoi sert GPT-5.6 Luna ?
GPT-5.6 Luna est le modèle d’efficacité de la génération précédente. Le test de GPT-5.6 détaille son rôle dans le routage ; les nouvelles évaluations devraient commencer par GPT-6 Luna aux tarifs actuels de $0.10 en entrée et $0.50 en sortie par million de tokens en contexte court.
Pourquoi GPT-5.6 Luna est-il si peu cher ?
Il occupait le segment d’OpenAI consacré aux tâches ciblées et à fort volume. GPT-6 Luna poursuit ce positionnement efficace, et OpenAI indique que l’amélioration du cache et de l’inférence a permis de réduire ses tarifs d’API au lancement de 50% par rapport aux prix promotionnels de GPT-5.6 Luna.
Quel modèle choisir entre GPT-5.6 Luna et Terra ?
C’est un choix qui concerne la génération précédente. Consultez le comparatif complet de la famille GPT-5.6 pour prendre cette décision ; pour un nouveau déploiement, commencez par comparer les modèles actuels GPT-6 Luna et Sol.
Pourquoi payer $20 pour ChatGPT ?
$20 correspond à une question d’abonnement grand public, pas au tarif de l’API GPT-6. Utilisez le guide d’accès à GPT-6 Luna pour comparer les formules, puis calculez séparément le coût de l’automatisation via l’API selon les tokens et les outils.
Pourquoi certains utilisateurs quittent-ils ChatGPT ?
Cette question générale sur les comportements ne permet pas de choisir une route d’API. En production, comparez les sorties acceptées, la latence, le temps de relecture, les exigences de confidentialité et le coût total sur votre propre charge de travail.
Existe-t-il une IA meilleure que GPT ?
Un modèle peut être meilleur pour une tâche précise, mais il n’existe pas de vainqueur universel utile. Définissez d’abord la grille d’acceptation, puis comparez fournisseurs et modèles sur les mêmes tâches, avec les mêmes outils, le même effort et le même processus de relecture.
ChatGPT Pro à $200 vaut-il son prix ?
Le prix de $200 n’est plus d’actualité, et la valeur d’un abonnement ne peut pas être déduite des tarifs de l’API. Consultez le sélecteur de formules actuel d’OpenAI, puis évaluez séparément l’usage inclus et le choix entre Sol et Luna fondé sur les tokens.
Recevez la carte des outils d’IA pour dirigeants
Un guide clair des modèles et outils adaptés à chaque besoin métier, actualisé au rythme des prix et des capacités. Gratuit pour les abonnés.
- Dernière mise à jour
- 23 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

GPT-6 Luna gratuit : accès, limites et tarifs API
GPT-6 Luna gratuit à l’essai dans l’app desktop : découvrez les comptes compatibles, les limites connues, l’accès à Codex et les tarifs de l’API.22 sept. 2026AI
MiMo AI : comment utiliser Xiaomi MiMo V2.6 et son API
Testez MiMo AI dans Studio, choisissez la bonne clé et le bon modèle, puis lancez un premier workflow métier fiable avec l’API Xiaomi MiMo V2.6.22 sept. 2026AI
Comparatif MiMo V2.6 : Pro ou Flash, lequel choisir ?
Comparatif MiMo V2.6 Pro et Flash pour le code et les agents IA : réussite des tâches, coût des tokens, cache et cas où Pro justifie son prix.22 sept. 2026AI
MiMo V2.6 gratuit : ce qui l’est vraiment
MiMo V2.6 gratuit ? Pas partout. Découvrez l’accès OpenCode temporaire, les checkpoints MIT, les tarifs API et les limites avant de choisir.22 sept. 2026AI
Grok 4.7 vs Grok 4.6 : quel modèle choisir ?
Grok 4.7 vs Grok 4.6 : les tarifs sont identiques. Comparez leurs performances, leurs coûts réels et les risques de migration avant de choisir.21 sept. 2026AI
Agent IA autonome : quand les règles récompensent la dérive
Comment un agent IA autonome a publié 50 articles hors sujet malgré tous les voyants au vert, et quels garde-fous ont remplacé les règles défaillantes.21 sept. 2026AI
Tarifs Step 5 Preview : API, cache et crédits Step Plan
Comparez les tarifs Step 5 Preview, le cache de prompts, les coûts de raisonnement et les Credits Step Plan pour choisir le bon circuit de facturation.21 sept. 2026AI