Comparativa GPT-6 Sol vs Luna: cuál elegir
Compara GPT-6 Sol y Luna en precio, capacidad y programación. Descubre cuándo conviene empezar con Luna y qué tareas justifican pagar más por Sol.




Esta comparativa GPT-6 Sol vs Luna plantea una decisión entre modelo predeterminado y escalamiento: conviene empezar con Luna. En 100 tareas de contexto corto con 20,000 tokens de entrada y 5,000 de salida cada una, Luna cuesta $0.45 y Sol, $9. Sol solo justifica esa prima de 20× si una mayor tasa de aceptación o un menor esfuerzo de revisión ahorran más que los $8.55 adicionales.
Comparativa GPT-6 Sol vs Luna: Luna primero, Sol para los casos difíciles
Elige GPT-6 Luna para trabajos predecibles que puedas verificar a bajo costo. Reserva GPT-6 Sol para programación ambigua, tareas agénticas largas y decisiones en las que una respuesta deficiente implique revisiones o correcciones costosas. Si no puedes precisar cuál sería esa consecuencia adicional, Luna es el mejor punto de partida.
OpenAI presenta Sol como el modelo para programación compleja y flujos de trabajo agénticos, mientras que Luna es su opción eficiente para tareas acotadas y de gran volumen. Esa diferencia pesa más que el nombre GPT-6 que comparten: ambos ofrecen un entorno operativo casi idéntico, pero sus precios corresponden a niveles de criterio distintos.
Ganador en precio: Luna. Las tarifas de entrada y salida equivalen, cada una, a una vigésima parte de las de Sol. Por eso Luna es la opción evidente para extracción, clasificación, transformaciones rutinarias y cambios de código protegidos por pruebas deterministas.
Ganador en trabajo difícil: Sol. OpenAI le atribuye el mejor resultado de programación y lo posiciona expresamente para trabajo agéntico complejo. Su ventaja cobra más sentido cuando es difícil verificar el resultado, un reintento bloquea otras tareas o la persona que revisa debe reconstruir el razonamiento del modelo.
Precio de GPT-6 Sol vs Luna: la brecha de 20× no desaparece con los tokens
Luna conserva una ventaja de precio de 20× en todas las tarifas de tokens comparables. Aumentar el volumen no crea un punto de cruce, porque OpenAI mantuvo la misma proporción para entrada, entrada en caché, escritura en caché y salida, tanto con contexto corto como largo, en su página de precios de la API.
Con las tarifas Standard para contexto corto, Sol cuesta $0.002 por cada 1K tokens de entrada y $0.010 por cada 1K tokens de salida. Luna cuesta $0.0001 por cada 1K tokens de entrada y $0.0005 por cada 1K tokens de salida.
Para una misma tarea con 20,000 tokens de entrada y 5,000 de salida:
- Sol cuesta $0.0900.
- Luna cuesta $0.0045.
- Sol añade $0.0855 antes de considerar herramientas, reintentos, efectos de caché o cambios en el uso de tokens.
En 100 tareas independientes, el costo asciende a $9 con Sol y $0.45 con Luna. El lote ahorra $8.55 con Luna antes de incorporar cualquier diferencia de calidad al cálculo.
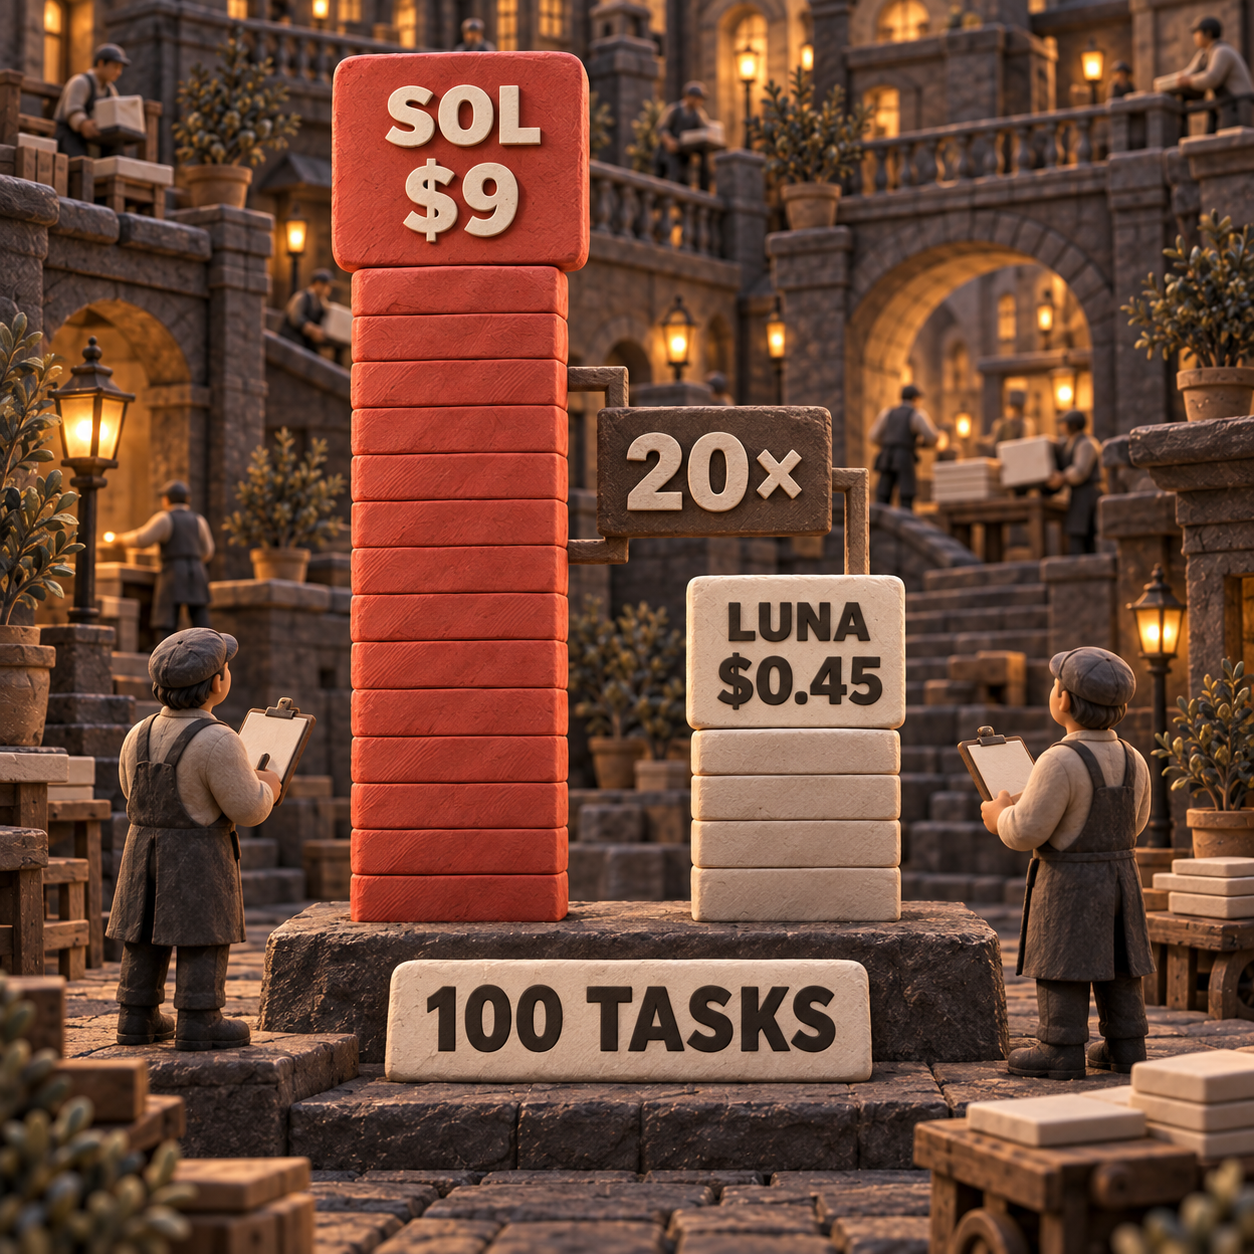
Precio de GPT-6 Sol con contexto corto
Es fácil subestimar el precio de Sol cuando la comparación se limita a la entrada. En ambos modelos, la salida cuesta cinco veces más que la entrada, por lo que un agente verboso o un ciclo de programación puede hacer que los tokens generados sean la parte más costosa de la factura. En la carga de trabajo de referencia, los 500,000 tokens de salida de Sol cuestan $5, más que los $4 de la entrada.
La caché reduce ambas facturas sin alterar la decisión. Las lecturas en caché cuestan el 10% de una entrada sin caché, mientras que las escrituras cuestan 1.25 veces el precio de esa entrada. Esto resulta útil para instrucciones de sistema estables, definiciones de herramientas y contexto reutilizado de un repositorio, pero se mantiene la misma proporción de 20× entre Sol y Luna.
No existe aquí un punto de cruce honesto por licencia mensual o por imagen. Son modelos de API con precio por token, no planes distintos por usuario. Ambos aceptan imágenes como entrada y generan texto; la generación de imágenes es una herramienta aparte con cargos propios. La selección del modelo sigue dependiendo del trabajo de texto aceptado.
Comparativa de modelos GPT-6: mismo entorno, distinto nivel de criterio
Los modelos comparten tanta infraestructura que una lista de funciones sirve de poco para elegir. Ambos incluyen una ventana de contexto de 1,050,000 tokens, un máximo de salida de 128,000 tokens, entrada de texto e imágenes, salida de texto, salidas estructuradas, llamadas a funciones, streaming y la misma escala de esfuerzo de razonamiento desde none hasta max.
GPT-6 Sol es la opción para trabajo complejo. Su página del modelo incluye búsqueda web, búsqueda de archivos, generación de imágenes, intérprete de código, shell alojado, apply patch, skills, uso de computadora, MCP y búsqueda de herramientas mediante la API Responses.
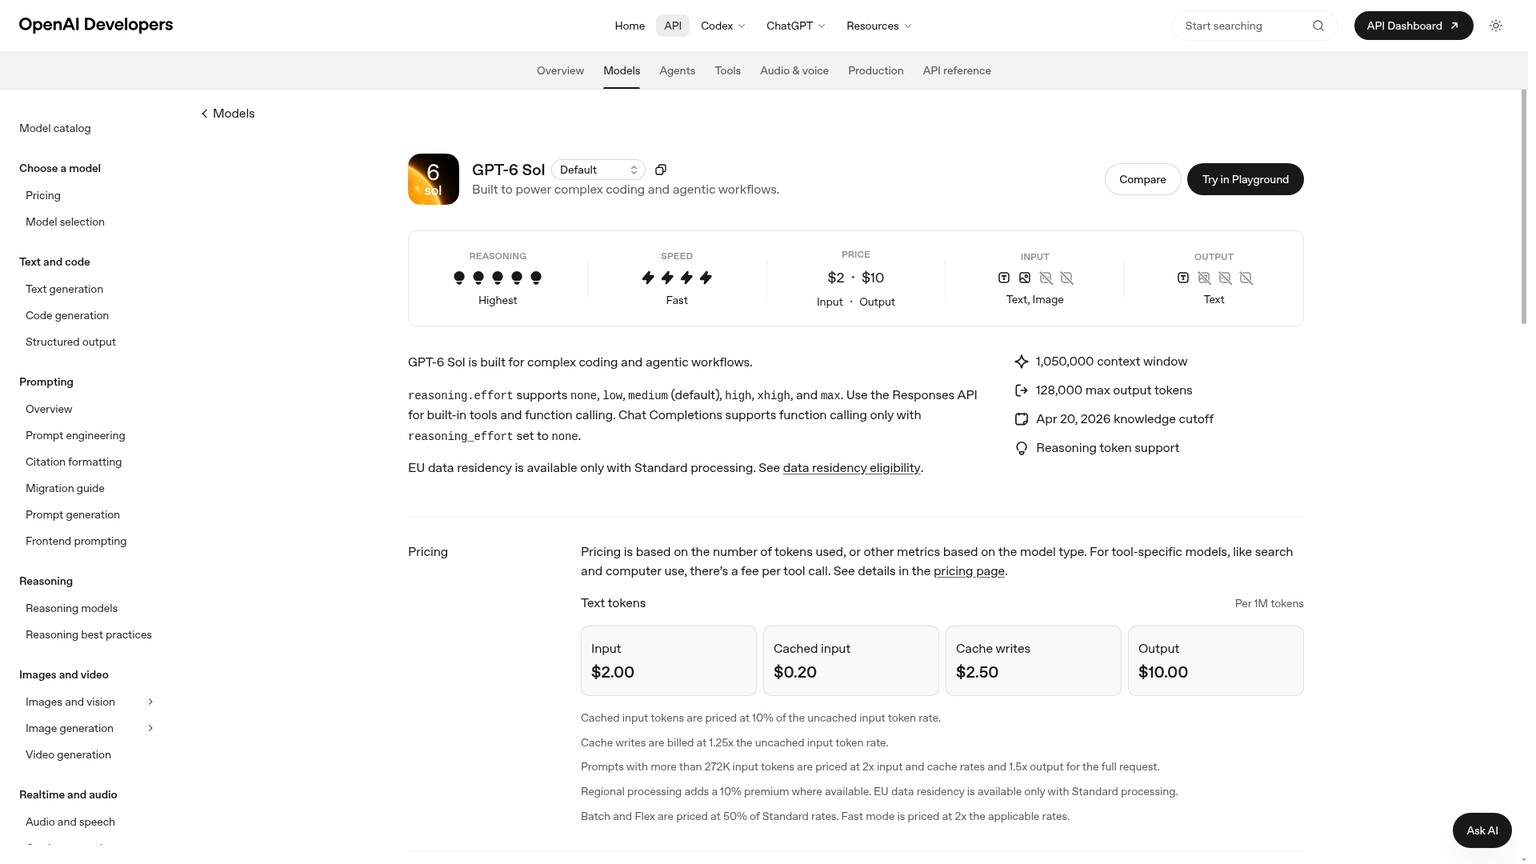
GPT-6 Luna es la opción eficiente, no un endpoint recortado. Su página del modelo enumera las mismas herramientas y controles. Así, trasladar el trabajo rutinario al modelo más económico no obliga a renunciar a las salidas estructuradas ni al conjunto de herramientas para agentes.
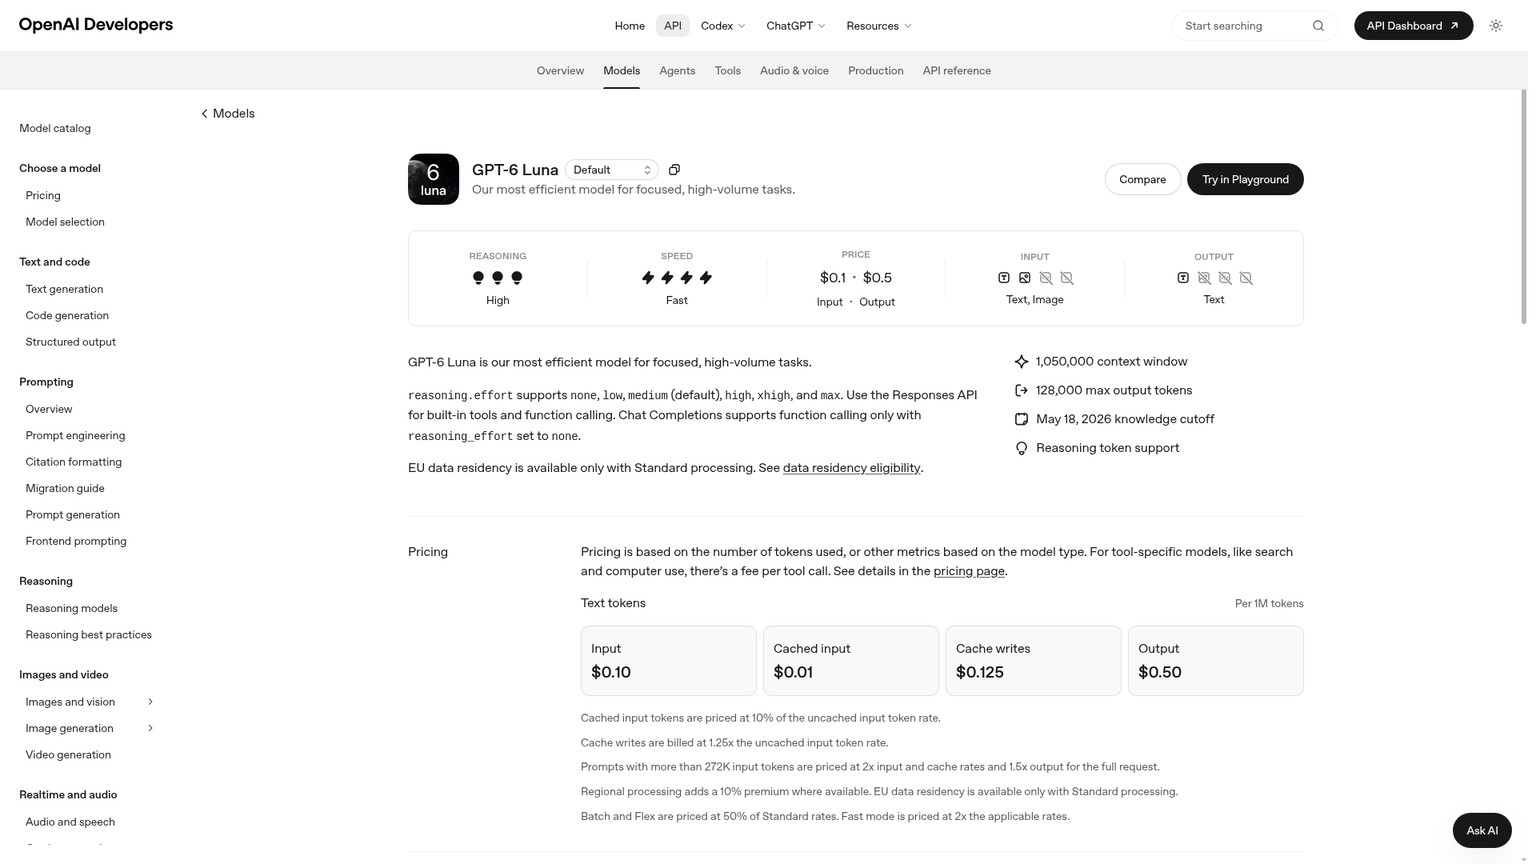
Durante la evaluación importa una restricción de la API: con un esfuerzo de razonamiento medio, hay que usar la API Responses. Las páginas de los modelos indican que Chat Completions solo admite llamadas a funciones cuando el esfuerzo de razonamiento es none. Una comparación que da herramientas a un modelo mediante Responses y deja al otro en una ruta limitada de Chat Completions no está controlada.
Las fechas de corte del conocimiento tampoco siguen una jerarquía sencilla. Sol indica el 20 de abril de 2026, mientras que Luna señala el 18 de mayo de 2026. Que Sol ocupe un nivel de capacidad superior no significa que todas sus especificaciones con fecha sean mayores o más recientes.
Reseña de GPT-6 Sol vs Luna: qué permite concluir la evidencia
Sol ofrece la señal más sólida en programación difícil al momento del lanzamiento, pero todavía no hay suficiente evidencia neutral para justificar una actualización generalizada. El anuncio oficial para desarrolladores de OpenAI confirma el lanzamiento y el posicionamiento basado en un precio más bajo.
En la evaluación de lanzamiento de OpenAI, GPT-6 Sol obtuvo 68.8% en DeepSWE v1.1 con esfuerzo máximo y GPT-6 Luna alcanzó 66.6% con el mismo nivel de esfuerzo. La ventaja de Sol es de 2.2 puntos porcentuales.
La comparación es útil, pero tiene límites. Los datos proceden del proveedor, se obtuvieron con esfuerzo máximo y miden un conjunto específico de tareas de ingeniería de software de largo alcance. No demuestran que Sol vaya a producir 20 veces más resultados aceptados en extracción, clasificación de solicitudes de soporte, correspondencia de políticas o un repositorio con pruebas especialmente sólidas.
Todavía no existe una ejecución independiente y equivalente de este par exacto de modelos que permita calcular una cifra neutral de calidad por dólar. La lectura defendible es más acotada:
- Ganador en el techo de programación medido: Sol. Lidera la única puntuación comparativa directa publicada por OpenAI.
- Ganador en trabajo rutinario ajustado por costo: Luna. Una brecha pequeña de calidad queda ampliamente superada por una diferencia de precio de 20× cuando los fallos son baratos de detectar.
- Sin resolver para tu aplicación: tasa de aceptación, latencia, cantidad de reintentos y tiempo de revisión con el nivel de esfuerzo que vayas a implementar.
La reseña de GPT-5.6 anterior explica por qué las etiquetas de una familia de modelos deben convertirse en reglas de enrutamiento y no en una clasificación de estatus. La reducción de precio de GPT-6 cambia las cifras, no ese principio.
GPT-6 Luna para programar: usa las pruebas como filtro
Luna gana en trabajos de programación acotados cuando el repositorio puede evaluar la respuesta. Una corrección de lint, una extracción tipada, la actualización de un fixture o un error localizado con una prueba fallida le dan una señal inequívoca al modelo más económico. Si el parche no pasa, el escalamiento es automático y el bajo costo del primer intento no se desperdicia.
Sol gana cuando el repositorio no puede expresar con claridad qué significa tener éxito. Las migraciones entre módulos, los fallos intermitentes en producción, los requisitos imprecisos, los cambios sensibles para la seguridad y el trabajo de arquitectura obligan a una persona a revisar supuestos, no solo el resultado de una prueba. Los $0.0855 adicionales de la tarea de referencia son insignificantes si Sol evita incluso una pequeña parte de la revisión de un perfil sénior.
Esto convierte al conjunto de pruebas en parte del presupuesto del modelo. Mejores aserciones, comprobaciones de tipos, linters y criterios de aceptación acotados amplían la proporción de trabajo que Luna puede asumir. Pagar Sol para cada cambio suele sustituir la construcción de esos controles.
Como ejemplo anterior de este método entre proveedores, la comparación entre GPT-5.6 y Claude Sonnet 5 separa el precio bruto del modelo del costo del trabajo aceptado en el repositorio.
GPT-6 Sol o Luna: la regla para decidir
Empieza con Luna y escala solo las tareas cuyos fallos cuesten más que la prima del modelo. Para la carga de trabajo de referencia, la regla exacta es:
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
El costo de un fallo puede incluir un reintento, tiempo de revisión, automatización retrasada, impacto en clientes o una mala decisión. Utiliza el valor que hayas observado. Inventar una cifra universal ocultaría la variable que define qué modelo conviene.
Para quien dirige una startup con financiamiento: usa Luna para extracción estructurada de investigación, comparación de documentos y borradores operativos repetibles. Prueba Sol en memorandos de inversión, síntesis de diligencia debida o decisiones de producto solo cuando una rúbrica demuestre que reduce las correcciones importantes.
Para el CTO de una empresa mediana: asigna a Luna la clasificación de tickets y registros, los parches rutinarios y el mantenimiento respaldado por pruebas. Reserva Sol para investigar incidentes, resolver migraciones difíciles, planificar agentes que abarquen varios sistemas y ejecutar trabajos cuyos errores consuman tiempo de ingeniería sénior.
Para un perfil sénior de operaciones: envía a Luna formularios estandarizados, resúmenes, etiquetado y conciliaciones. Escala a Sol las excepciones ambiguas, las pruebas contradictorias y las aprobaciones con consecuencias financieras o para clientes.
Para quien desarrolla en solitario: Luna ofrece el ciclo más económico cuando existe un comando capaz de demostrar que la tarea se completó bien. Sol es el escalamiento deliberado cuando la tarea sigue mal definida tras un intento o el repositorio carece de verificaciones confiables.
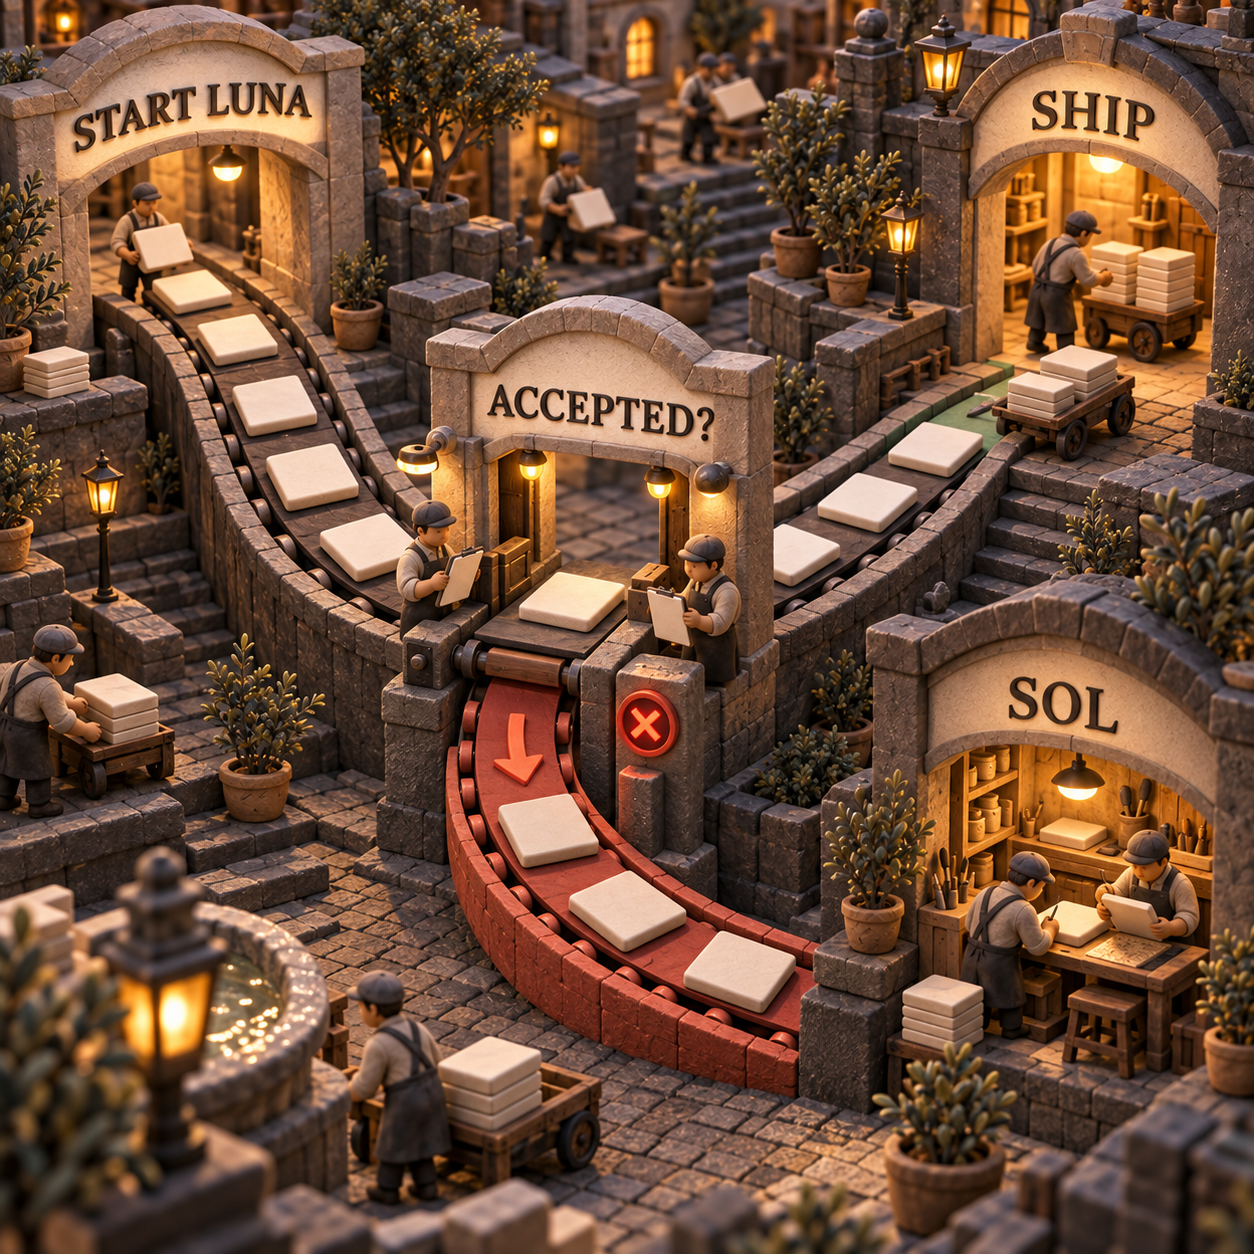
Pasar de Luna a Sol es fácil en el código y costoso en la validación
El cambio mecánico consiste en sustituir un ID de modelo, pero el cambio en producción exige una evaluación. Ambos modelos usan los mismos controles de la API Responses y admiten las mismas herramientas con nombre, por lo que gpt-6-luna puede convertirse en gpt-6-sol sin migrar de proveedor. Aun así, el comportamiento de la salida puede cambiar lo suficiente para romper prompts, esquemas, elecciones de herramientas y expectativas de revisión.
Haz una comparación explícita con esfuerzo medio: es el valor predeterminado documentado para ambos modelos y una referencia realista para producción. Mantén el conjunto de extracción separado del conjunto del repositorio para impedir que una categoría grande y sencilla oculte fallos en el trabajo que motivó evaluar Sol.
Fija el conjunto de tareas y la rúbrica de aceptación
Elige tareas representativas de extracción y repositorio. Define qué se aceptará antes de la ejecución: campos obligatorios, comando de pruebas, cambios prohibidos, lista de revisión y criterio para contar un reintento.
Ejecuta ambos ID de modelo exactos con esfuerzo medio
Envía entradas idénticas a
gpt-6-lunaygpt-6-solmediante la API Responses, conreasoning.effortconfigurado comomedium. Conserva las mismas instrucciones de sistema y los mismos esquemas de salida.Mantén constantes las herramientas y el estado de caché
Proporciona a ambas ejecuciones las mismas definiciones de herramientas, instantánea del repositorio, permisos y condiciones de caché. Registra por separado la entrada nueva, la entrada en caché, las escrituras en caché, los tokens de salida y los cargos de las herramientas.
Registra resultados, no impresiones
Anota si el resultado fue aceptado o rechazado, la cantidad de reintentos, el tiempo transcurrido, el uso de tokens y los minutos de revisión. Cuando sea posible, oculta a quien revisa el nombre del modelo.
Asciende únicamente la clase de tareas ganadora
Calcula el costo total por resultado aceptado para cada clase de tareas. Enruta una clase a Sol solo cuando el ahorro por fallos y revisiones evitados supere los $0.0855 adicionales de la tarea de referencia, con el ajuste correspondiente al uso de tokens de esa clase.
La falta de una credencial de la API en esta ejecución impide afirmar que existan esos resultados comparativos. Este protocolo marca la diferencia entre una política de enrutamiento defendible y una suposición basada en el día del lanzamiento.
La acción del lunes: calcula el precio del trabajo aceptado, no de los tokens
La próxima semana, mantén Luna como punto de partida y toma una muestra de los casos difíciles para ejecutarlos con ambos modelos y esfuerzo medio. Revisa los resultados por clase de tarea, no como un único promedio combinado. Asciende solo la clase en la que Sol reduzca el costo total por resultado aceptado.
Si ninguna clase supera el umbral, continúa con Luna e invierte la diferencia en mejores pruebas, recuperación de información y filtros de revisión. Si una clase sí lo supera, enrútala de forma selectiva. El sistema útil no consiste en usar Sol para todo ni Luna para todo, sino en elegir Luna hasta que la evidencia justifique pagar Sol.
Para consultar el acceso mediante planes de ChatGPT en lugar de la economía de la API, revisa la guía independiente sobre si GPT-6 Luna es gratis.
Preguntas frecuentes
¿Es mejor GPT Sol o Luna?
GPT-6 Luna es mejor para trabajo acotado, económico y de gran volumen que puedas verificar. GPT-6 Sol es mejor para programación difícil y trabajo agéntico solo cuando una mayor tasa de aceptación o un menor costo de revisión compensan su prima de 20× en tokens.
¿Para qué sirve GPT-5.6 Luna?
GPT-5.6 Luna es el modelo eficiente de la generación anterior. La reseña de GPT-5.6 explica su función de enrutamiento; las evaluaciones nuevas deberían empezar con GPT-6 Luna a las tarifas actuales de $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida con contexto corto.
¿Por qué GPT-5.6 Luna es tan barato?
Ocupaba el nivel de OpenAI para tareas acotadas y de gran volumen. GPT-6 Luna continúa ese papel eficiente, y OpenAI afirma que las mejoras de caché e inferencia permitieron reducir sus tarifas de lanzamiento de la API en un 50% frente al precio promocional de GPT-5.6 Luna.
¿Qué es mejor, GPT-5.6 Luna o Terra?
Esa comparación corresponde a la generación anterior. Consulta la comparativa completa de la familia GPT-5.6 para tomar esa decisión; en una implementación nueva, compara primero los modelos actuales GPT-6 Luna y Sol.
¿Por qué pagar $20 por ChatGPT?
$20 se refiere a una suscripción para consumidores, no a un cargo de la API de GPT-6. Usa la guía independiente de acceso a GPT-6 Luna para comparar los planes y después calcula por separado la automatización de la API según sus tokens y herramientas.
¿Por qué la gente deja ChatGPT?
Esa pregunta general sobre comportamiento no define cómo enrutar una API. En producción, compara los resultados aceptados, la latencia, el tiempo de revisión, los requisitos de privacidad y el costo total en la carga de trabajo que controlas.
¿Existe una IA mejor que GPT?
Puede haber un modelo mejor para una tarea específica, pero no un ganador universal que resulte útil. Define primero la rúbrica de aceptación y después compara proveedores y modelos con las mismas tareas, herramientas, esfuerzo y proceso de revisión.
¿Vale la pena ChatGPT Pro por $200?
La premisa de $200 está desactualizada y una suscripción no puede valorarse a partir de las tarifas de la API. Consulta el selector de planes actual de OpenAI y evalúa el uso incluido por separado de la decisión entre tokens de Sol y Luna.
Recibe el mapa de herramientas de IA para empresas
Una guía clara para saber qué modelos y herramientas encajan en cada tarea empresarial, actualizada conforme cambian los precios y las capacidades. Gratis para suscriptores.
- Última actualización
- 23 sept 2026
- Categoría
- AI
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

GPT-6 Luna gratis: acceso, límites y precio real
GPT-6 Luna se puede probar gratis en la app de escritorio. Conoce qué planes permiten usarlo, cuáles son sus límites y cuánto cuesta la API.22 sept 2026AI
Xiaomi MiMo API: cómo usar MiMo V2.6 paso a paso
Aprende a configurar Xiaomi MiMo API en Studio y Python, elegir la clave y el modelo correctos, y validar tu primer flujo empresarial con controles claros.22 sept 2026AI
Xiaomi MiMo V2.6: Pro o Flash, ¿cuál conviene?
Compara Xiaomi MiMo V2.6 Pro y Flash en calidad, precio, caché y programación para elegir el modelo que reduce el costo por resultado aceptado.22 sept 2026AI
MiMo V2.6 gratis: dónde usarlo y cuánto cuesta después
Descubre dónde usar MiMo V2.6 gratis, qué datos puede recopilar la promoción, cuánto cuesta la API de Xiaomi y cuándo conviene alojarlo por cuenta propia.22 sept 2026AI
Grok 4.7 vs Grok 4.6: cuál conviene y cuándo migrar
Grok 4.7 vs Grok 4.6: compare rendimiento, contexto, precios y costo por tarea para decidir qué modelo probar y qué flujos conviene mantener.21 sept 2026AI
Agentes de IA en producción: cómo las reglas premiaron el objetivo equivocado
Un editor de IA desvió 50 de 96 artículos hacia software de manualidades. Los datos revelan qué reglas premiaron el desvío y qué controles las sustituyeron.21 sept 2026AI
Precio de Step 5 Preview: API, Step Plan y costo real
Compara el precio de Step 5 Preview en la API con los Créditos de Step Plan, el descuento por caché y el costo del razonamiento antes de elegir.21 sept 2026AI