GPT-6 Sol Luna 比較:20倍の価格差で選ぶべきモデル
GPT-6 SolとLunaは同じツールとコンテキスト枠を備えながら、料金は20倍違います。100件の基準タスクで$9と$0.45になるコスト差、DeepSWEの2.2ポイント差、レビュー負担を含む損益分岐点を整理し、Lunaを標準にしてSolへ切り替える条件を具体的に解説します。




GPT-6 Sol Luna 比較で重要なのは、標準モデルと上位モデルをどう使い分けるかです。まずLunaから始めます。入力20,000トークン、出力5,000トークンの短いコンテキストのタスクを100件処理すると、Lunaは$0.45、Solは$9です。Solの料金は20倍ですが、合格率の向上やレビュー工数の削減によって追加の$8.55を上回る価値を生める場合に限り、その差を正当化できます。
GPT-6 Sol Luna 比較:基本はLuna、難題だけSol
低コストで確実に検証できる仕事にはGPT-6 Lunaが向いています。要件が曖昧なコーディング、長時間動くエージェント、回答の質が低いとレビューや手戻りが高くつく判断にはGPT-6 Solを選びます。そうした追加コストを具体的に説明できないなら、出発点はLunaで十分です。
OpenAIは、Solを複雑なコーディングやエージェント型ワークフロー向け、Lunaを対象が明確な大量処理向けの効率重視モデルと位置づけています。同じGPT-6という名前より、この役割の違いのほうが重要です。両モデルの動作範囲はほぼ同じでも、料金は求められる判断力の水準に応じて大きく分かれています。
料金で選ぶならLunaです。 入力も出力もSolの20分の1です。抽出、分類、定型変換、決定的なテストで守られたコード変更なら、Lunaが明確な第一候補になります。
難しい仕事で選ぶならSolです。 OpenAIのコーディング評価ではSolが上回り、複雑なエージェント作業向けと明示されています。出力の検証が難しい、再試行で後続作業が止まる、モデルの判断過程をレビュー担当者が組み立て直さなければならない、といった場面で差が生きます。
GPT-6 SolとLunaの料金比較:トークンでは20倍差を逆転できない
比較可能なすべてのトークン単価で、Lunaは一貫して20倍安価です。処理量を増やしても損益分岐点は現れません。OpenAIの最新API料金ページでは、短いコンテキストと長いコンテキストのどちらでも、入力、キャッシュ済み入力、キャッシュ書き込み、出力の比率が同じだからです。
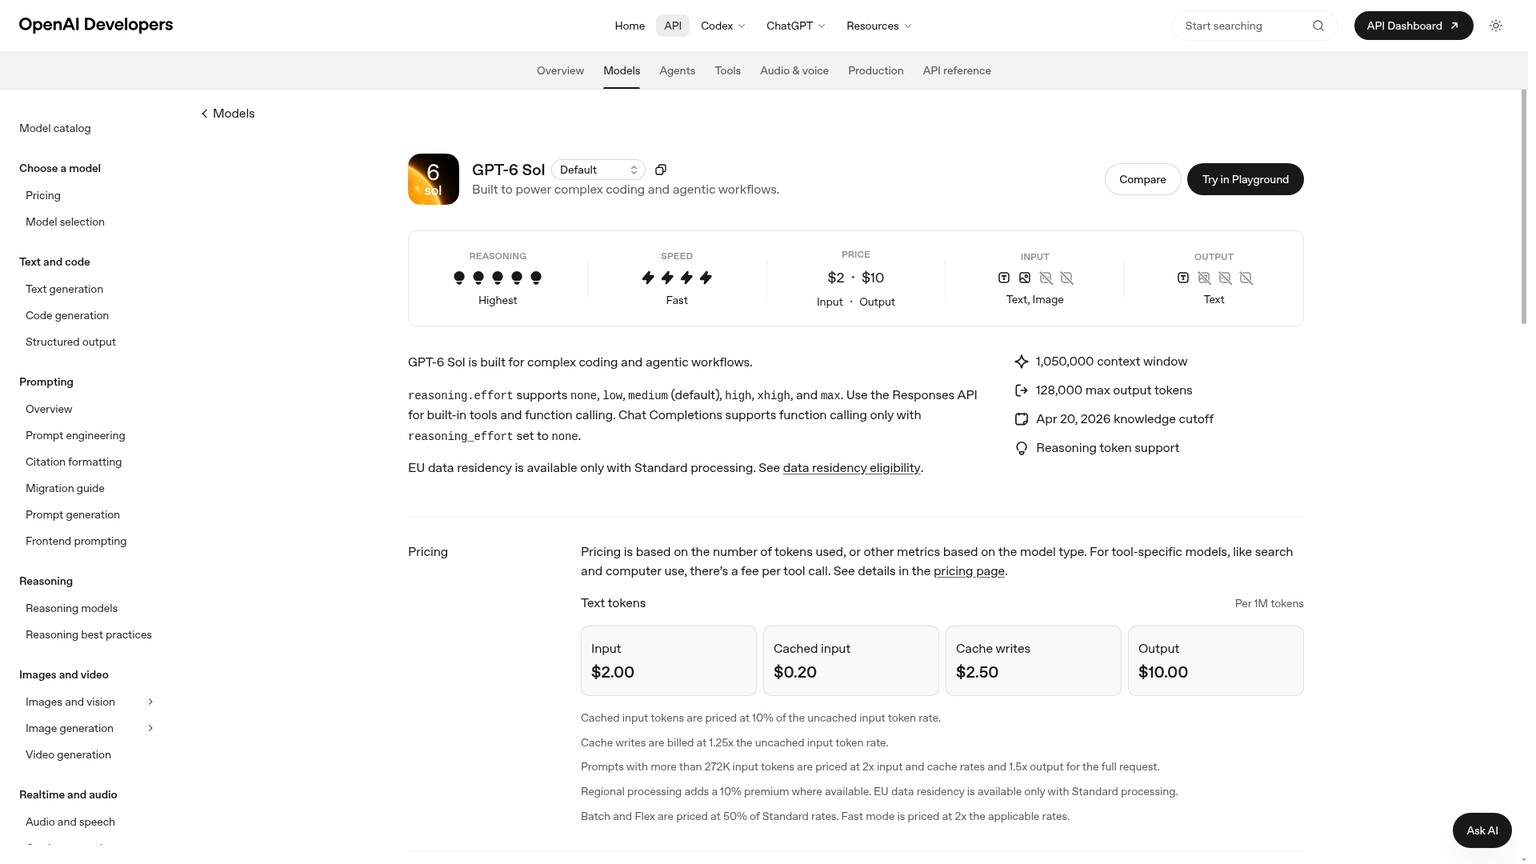
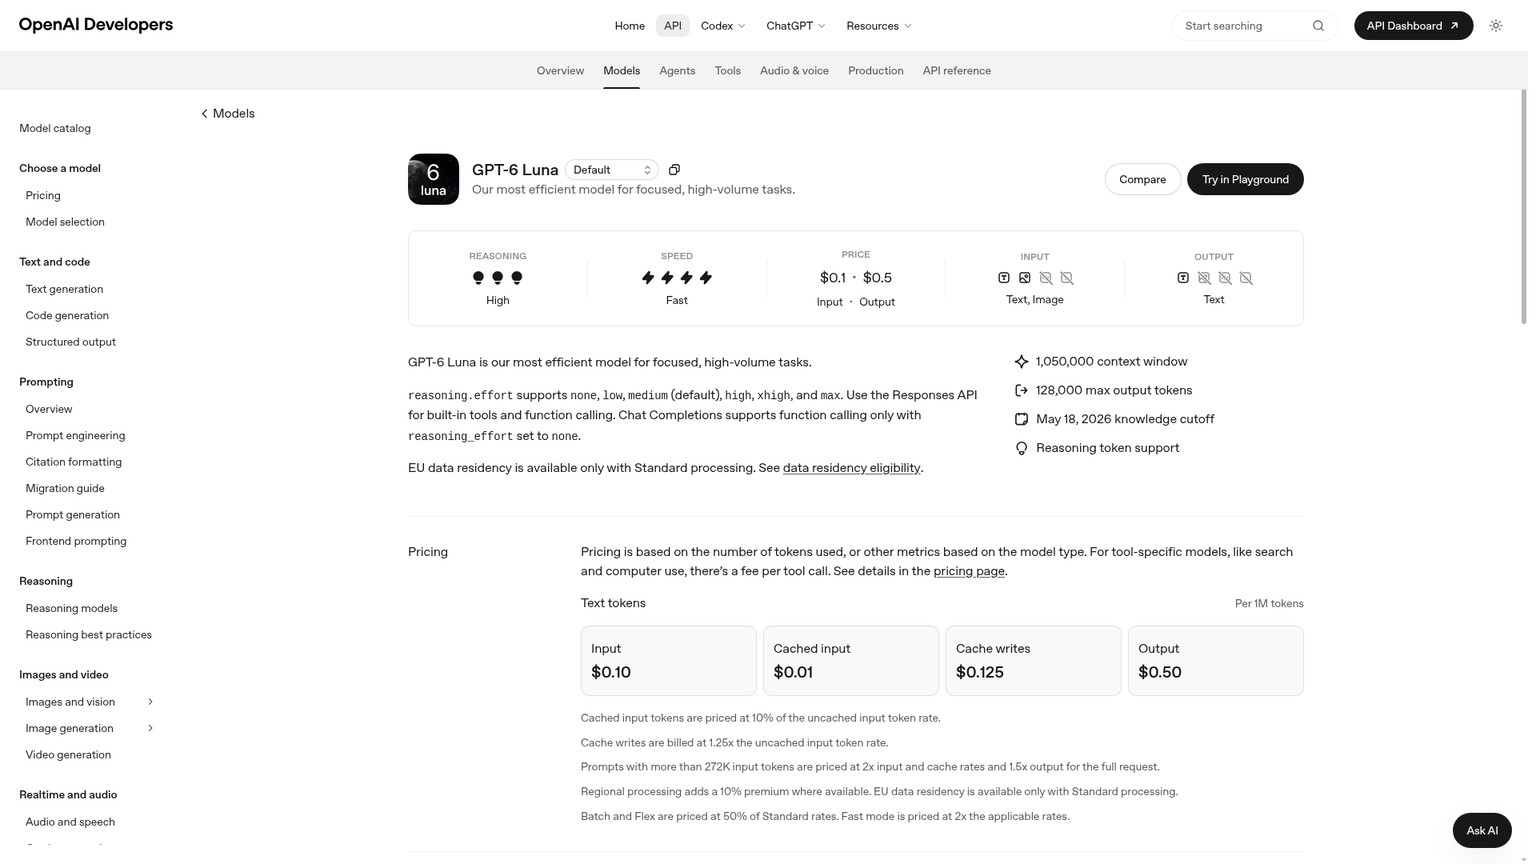
Standardの短いコンテキスト料金では、Solは入力1Kトークンあたり$0.002、出力1Kトークンあたり$0.010です。Lunaは入力1Kトークンあたり$0.0001、出力1Kトークンあたり$0.0005です。
同じく入力20,000トークン、出力5,000トークンのタスクなら、料金は次のようになります。
- Solは$0.0900。
- Lunaは$0.0045。
- ツール、再試行、キャッシュの影響、トークン使用量の変化を含める前の時点で、Solは$0.0855高くなります。
このタスクを100件別々に実行すると、Solは$9、Lunaは$0.45です。品質差を考慮する前でも、Lunaならバッチ全体で$8.55を節約できます。
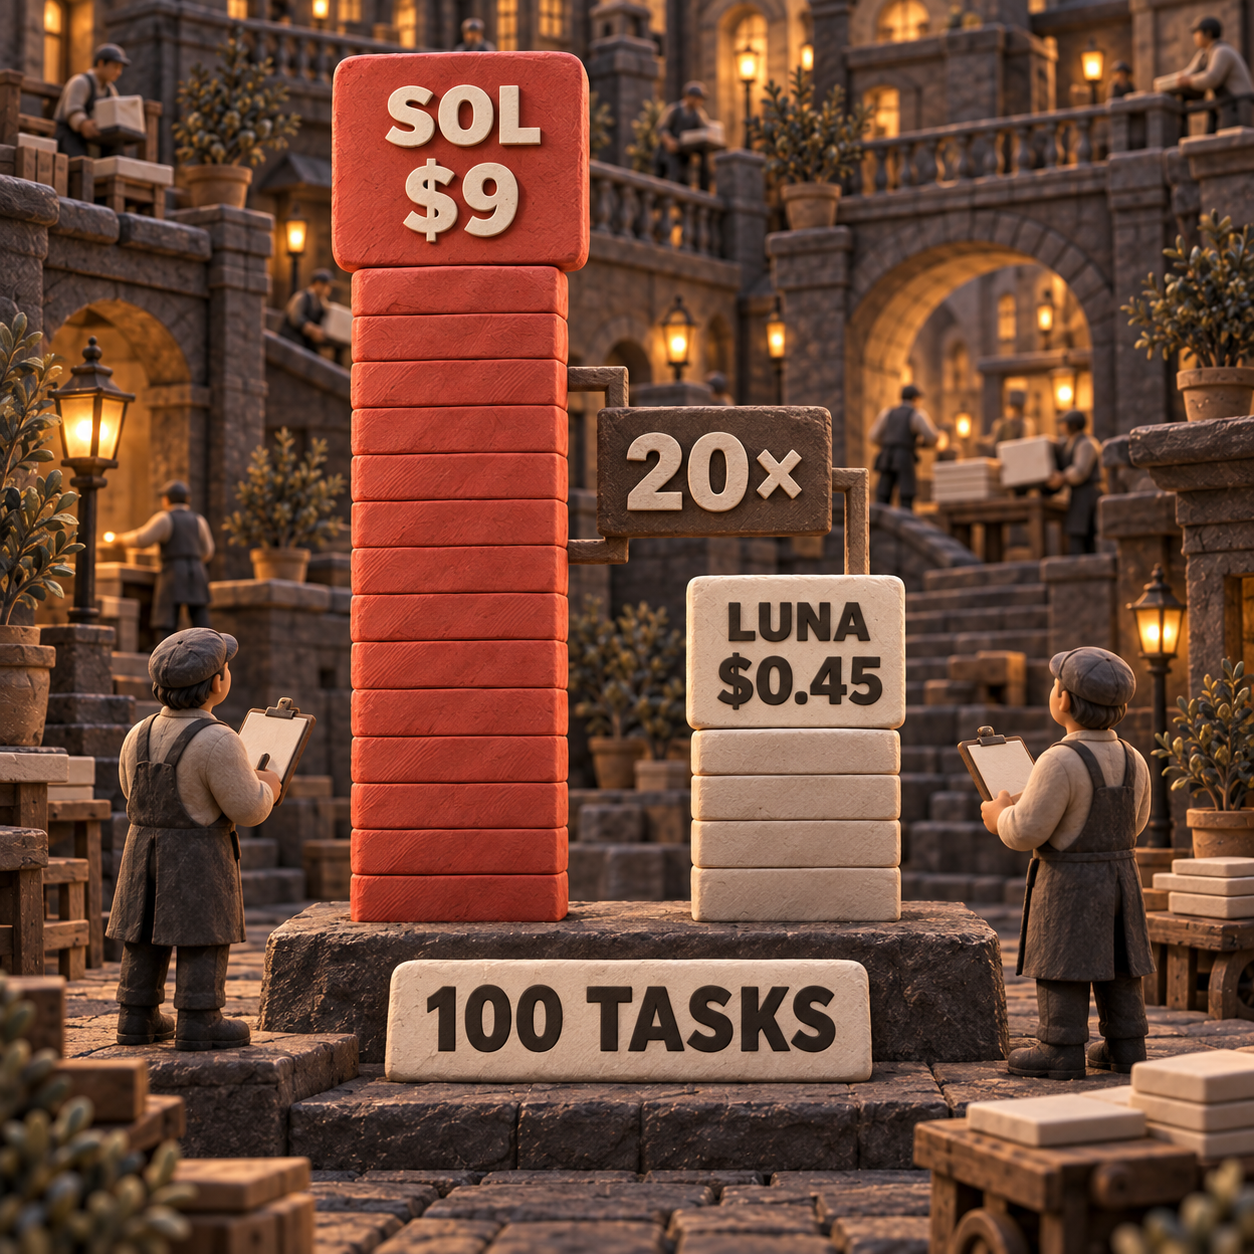
短いコンテキストにおけるGPT-6 Solの料金
入力単価だけを見ていると、Solの費用を過小評価しがちです。両モデルとも出力単価は入力の5倍なので、長文を生成するエージェントやコーディングループでは、出力トークンが請求額の大半を占めることがあります。基準ワークロードの場合、Solの出力500,000トークンは$5で、入力の$4を上回ります。
キャッシュを使えば両モデルとも安くなりますが、選択そのものは変わりません。キャッシュ読み取りは通常入力の10%、キャッシュ書き込みは通常入力の1.25倍です。固定されたシステムプロンプト、ツール定義、再利用するリポジトリのコンテキストには有効ですが、SolとLunaの20倍という比率はそのままです。
ここには、シート月額や画像単価による正当な損益分岐点はありません。比較しているのは座席プランではなく、トークン課金のAPIモデルです。どちらも画像入力を受け取りテキストを出力しますが、画像生成は別のツールで、料金も別です。モデル選びは結局、合格するテキスト成果物をいくらで得られるかに戻ります。
GPT-6モデル比較:動作範囲は同じ、判断力が違う
インフラ面の共通点が多いため、機能チェックリストだけでは選べません。両モデルとも、1,050,000トークンのコンテキストウィンドウ、最大128,000トークンの出力、テキストと画像の入力、テキスト出力、Structured Outputs、Function Calling、Streaming、そして none から max まで同じreasoning effortを備えています。
GPT-6 Solは複雑な仕事向けです。最新モデルページには、Responses APIで利用できるものとして、ウェブ検索、ファイル検索、画像生成、Code Interpreter、Hosted Shell、apply patch、Skills、Computer Use、MCP、Tool Searchが掲載されています。
GPT-6 Lunaは効率重視ですが、機能を削ったエンドポイントではありません。最新モデルページに並ぶツールと制御機能はSolと同じです。定型業務をLunaへ移しても、Structured Outputsやエージェント向けツール群を手放す必要はありません。
評価時には、APIの制約にも注意が必要です。reasoning effortをmediumにするならResponses APIを使います。モデルページによると、Chat CompletionsでFunction Callingを使えるのはreasoning effortが none の場合だけです。一方のモデルにResponses経由でツールを与え、もう一方を機能の少ないChat Completionsで動かしても、公平な比較にはなりません。
知識カットオフも、単純な上下関係ではありません。Solは2026年4月20日、Lunaは2026年5月18日です。Solが上位の能力階層にあるからといって、日付を含むすべての仕様が大きい、または新しいわけではありません。
GPT-6 SolとLunaのレビュー:エビデンスから言えること
難しいコーディングについては、リリース時点の指標でSolが上です。ただし、あらゆる仕事をSolへ切り替える根拠になるほど中立的なデータはまだありません。OpenAIの公式開発者向け発表では、両モデルのリリースと低価格化の位置づけが確認できます。
OpenAIのリリース時評価では、max effortのDeepSWE v1.1でGPT-6 Solが68.8%、GPT-6 Lunaが66.6%でした。Solのリードは2.2ポイントです。
この比較は参考になりますが、適用範囲は限られます。ベンダーであるOpenAIの公表値であり、max effortを使い、長期にわたる特定のソフトウェアエンジニアリング課題を測った結果です。抽出、サポートの振り分け、ポリシーの対応付け、テストが非常に充実したリポジトリでも、SolならLunaの20倍の合格成果物を返すとは言えません。
このモデルペアを同条件で動かした独立評価はまだなく、中立的な品質単価も算出できません。現時点で妥当なのは、次の限定的な読み方です。
- 測定されたコーディング性能の上限はSol。 OpenAIが公表した唯一の直接比較スコアで上回っています。
- 定型業務のコストパフォーマンスはLuna。 失敗を安く検出できるなら、小さな品質差は20倍の価格差に吸収されます。
- 実際の用途では未決着。 本番で使うeffort設定における合格率、レイテンシ、再試行回数、レビュー時間を測る必要があります。
以前のGPT-5.6レビューでも、モデルファミリーの名前を格付けとして見るのではなく、ルーティングルールへ落とし込む理由を解説しました。GPT-6の値下げで数字は変わっても、この原則は変わりません。
GPT-6 Lunaでコーディング:テストを判定基準にする
リポジトリ自身が成果物を判定できる、範囲の明確なコーディングならLunaが有利です。lint修正、型付きデータ抽出、fixture更新、失敗するテストで場所を絞れたバグ修正には、低価格モデルでも明確な合否シグナルがあります。パッチが不合格なら自動で上位モデルへ回せるため、安い初回実行も無駄になりません。
成功条件をリポジトリで明確に表せない仕事ではSolが有利です。複数モジュールをまたぐ移行、断続的な本番障害、曖昧な要件、セキュリティ上重要な変更、アーキテクチャ設計では、テスト結果を読むだけでなく、人が前提まで検証しなければなりません。Solがシニア担当者のレビュー時間を少しでも減らせるなら、基準タスクで増える$0.0855はわずかな額です。
つまり、テストスイートもモデル予算の一部です。assertion、型チェック、linter、限定的な受け入れ条件を整えるほど、Lunaに任せられる領域が広がります。あらゆる変更にSolを使うことは、こうした制御の整備を先送りする代替策になりがちです。
この考え方を異なるベンダー間で適用した例は、GPT-5.6とClaude Sonnet 5の比較で確認できます。モデルの表面上の単価と、リポジトリで合格する成果物のコストを分けて評価しています。
GPT-6 SolとLuna、どちらを選ぶべきか
まずLunaを使い、失敗コストがモデル料金の差を超えるタスクだけSolへ昇格させます。基準ワークロードにおける正確な切り替え条件は次のとおりです。
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
失敗コストには、再試行、レビュー時間、自動化の遅延、顧客への影響、誤った意思決定を含められます。ここには実測値を入れてください。誰にでも当てはまる金額を作れば、モデル選びを決める変数が見えなくなります。
資金調達済みの創業者: 構造化した調査データの抽出、文書比較、反復可能な業務文書の下書きにはLunaを使います。投資メモ、デューデリジェンスの統合、プロダクト判断は、評価基準上の重大な修正が減る場合だけSolを試します。
中堅企業のCTO: チケットの振り分け、ログ分類、定型パッチ、テストで守られた保守にはLunaを配置します。インシデント調査、難しい移行、複数システムにまたがるエージェント計画、ミスによってシニアエンジニアの時間を奪う仕事にはSolを残します。
シニアオペレーター: 標準化されたフォーム、要約、タグ付け、照合作業はLunaへ回します。曖昧な例外、矛盾する証拠、金銭や顧客への影響を伴う承認はSolへ引き上げます。
個人の技術系ビルダー: 成功をコマンドで証明できるタスクなら、Lunaが経済的な反復ループになります。一度試しても要件が定まらない場合や、リポジトリに信頼できるチェックがない場合は、意図的にSolへ切り替えます。
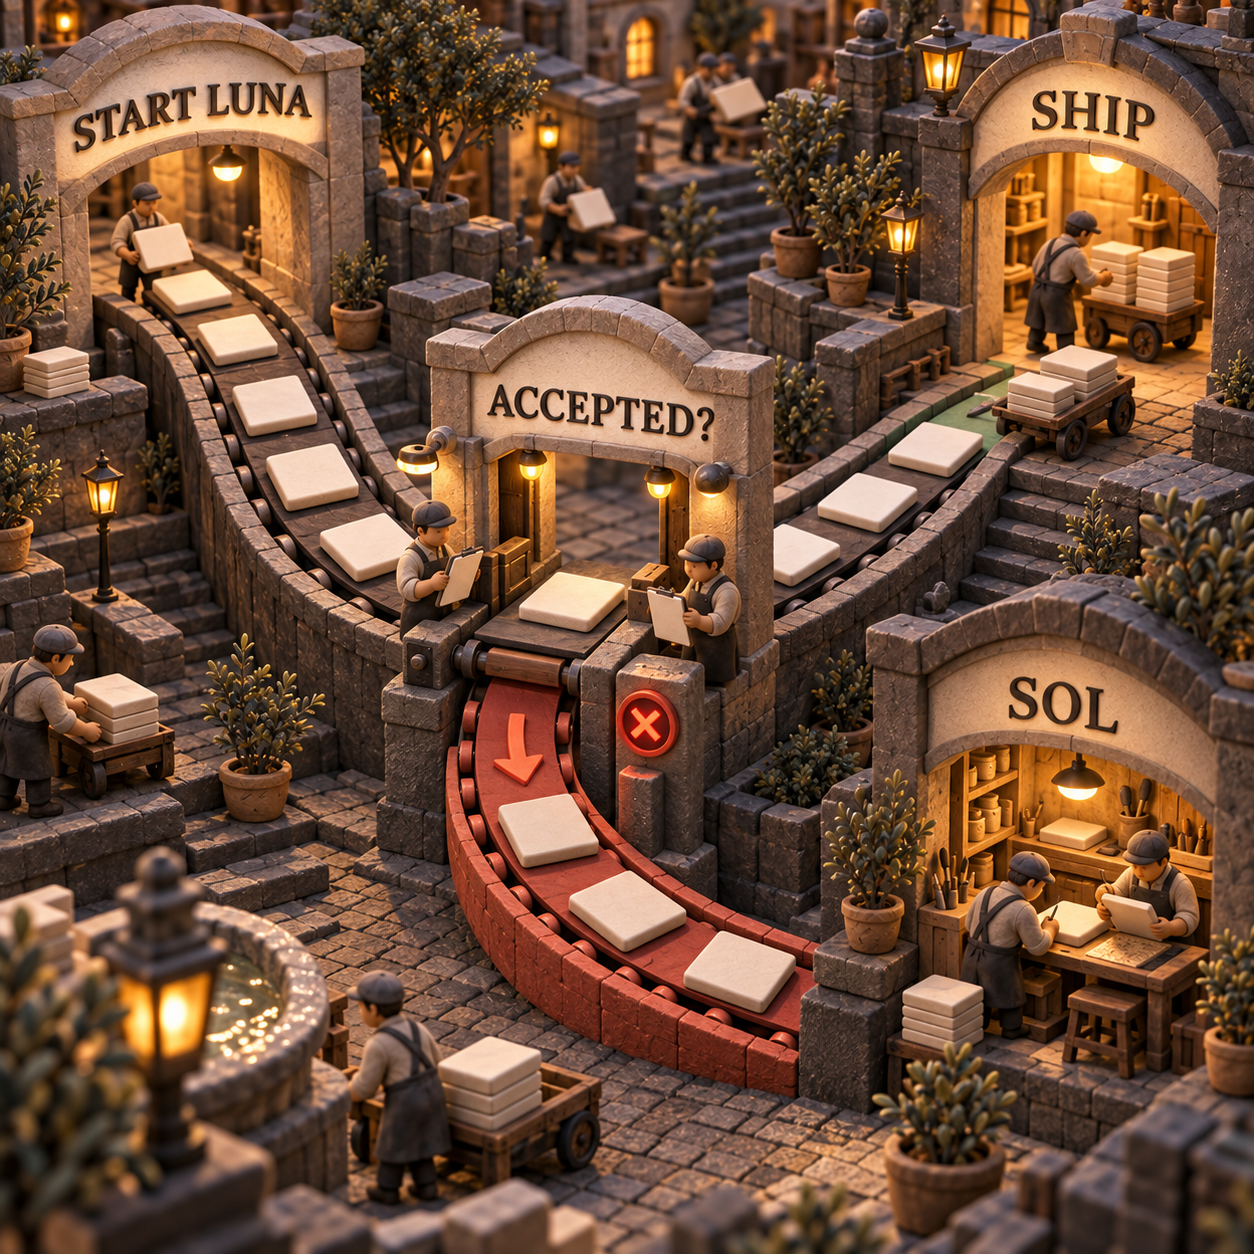
LunaからSolへの変更は実装より検証が重い
コード上はモデルIDを差し替えるだけですが、本番での切り替えには評価が欠かせません。両モデルはResponses APIの制御機能と対応ツールが同じなので、プロバイダーを移行せず gpt-6-luna を gpt-6-sol に変更できます。それでも出力の振る舞いが変わり、プロンプト、スキーマ、ツール選択、レビュー担当者の期待を崩す可能性があります。
比較にはmedium effortを明示的に使います。両モデルのドキュメント上のデフォルトであり、現実的な本番基準でもあるからです。抽出タスクとリポジトリ作業の評価セットは分けてください。大量の簡単なタスクが、Solを検討するきっかけになった難しい仕事の失敗を覆い隠さないようにします。
タスクセットと合格基準を固定する
代表的な抽出タスクとリポジトリ作業を選びます。実行前に、必須フィールド、テストコマンド、禁止する変更、レビュー用チェックリスト、再試行の定義を決め、何を合格とするか固定します。
正確なモデルIDをmedium effortで比較する
Responses APIを通じて
gpt-6-lunaとgpt-6-solに同一の入力を送り、reasoning.effortをmediumに設定します。システム指示と出力スキーマも同じにします。ツールとキャッシュ条件をそろえる
両方の実行に同じツール定義、リポジトリのスナップショット、権限、キャッシュ条件を与えます。新規入力、キャッシュ済み入力、キャッシュ書き込み、出力トークン、ツール料金を分けて記録します。
印象ではなく結果を記録する
合否、再試行回数、経過時間、トークン使用量、レビュー時間を記録します。可能であれば、レビュー担当者にはモデル名を伏せます。
勝ったタスク分類だけを昇格させる
タスク分類ごとに、合格成果物あたりの総コストを計算します。失敗とレビューの削減額が、その分類のトークン使用量で調整した基準タスクの追加$0.0855を上回る場合だけ、Solへ振り分けます。
この検証ではAPIの認証情報がなかったため、上記のペア比較結果を実測値としては示しません。この手順を守れるかどうかが、根拠のあるルーティング方針とリリース時の思い込みを分けます。
次の月曜日にやること:トークンではなく合格成果物に値段を付ける
来週はLunaを基準に据えたまま、難しいタスク群だけをmedium effortで両モデルに実行します。全体を一つの平均にまとめず、タスク分類ごとに結果を見ます。合格成果物あたりの総コストをSolが下げられた分類だけを昇格させてください。
基準を超える分類がなければLunaを使い続け、差額をテスト、検索、レビューゲートの改善へ回します。超える分類があれば、そこだけを狭く振り分けます。役に立つ仕組みは「すべてSol」でも「すべてLuna」でもありません。根拠によってSolの費用を回収できるまではLunaを使う設計です。
APIの料金ではなくChatGPTプランでの利用可否を知りたい場合は、別記事のGPT-6 Lunaを無料で使えるかどうかを参照してください。
よくある質問
GPT SolとLunaはどちらが優れていますか?
低価格で、対象が明確な大量処理を検証しながら進めるならGPT-6 Lunaが適しています。難しいコーディングやエージェント作業では、合格率の向上やレビュー費用の削減で20倍のトークン料金を回収できる場合に限り、GPT-6 Solが優位です。
GPT-5.6 Lunaは何に向いていますか?
GPT-5.6 Lunaは前世代の効率重視モデルです。GPT-5.6レビューでそのルーティング上の役割を解説しています。新しく評価するなら、短いコンテキストで入力1Mトークンあたり$0.10、出力1Mトークンあたり$0.50という現在の料金でGPT-6 Lunaから始めます。
GPT-5.6 Lunaはなぜ安いのですか?
OpenAIのモデル群では、対象が明確な大量処理を担う階層だったからです。GPT-6 Lunaも効率重視の役割を引き継いでいます。OpenAIは、キャッシュと推論の改善により、GPT-5.6 Lunaのプロモーション料金からリリース時のAPI料金を50%引き下げたと説明しています。
GPT-5.6 LunaとTerraはどちらが優れていますか?
それは前世代モデル同士の選択です。判断材料はGPT-5.6モデルファミリーの完全比較で確認できます。新規導入なら、まず現行のGPT-6 LunaとSolを比較してください。
ChatGPTに$20を払う理由は何ですか?
$20は一般ユーザー向けサブスクリプションの話で、GPT-6 APIの料金ではありません。まずGPT-6 Lunaのアクセスガイドで利用できるプランを比べ、その後、APIによる自動化はトークンとツールを基準に別途見積もります。
ChatGPTから離れる人がいるのはなぜですか?
そのような幅広い利用動向だけでは、APIの振り分け方は決まりません。本番では、自分たちのワークロードについて、合格成果物、レイテンシ、レビュー時間、プライバシー要件、総コストを比較します。
GPTより優れたAIはありますか?
特定の仕事でより優れたモデルはあり得ますが、あらゆる用途で勝つモデルを決めても実用的ではありません。まず合格基準を定義し、同じタスク、ツール、effort、レビュープロセスでプロバイダーとモデルを比較してください。
ChatGPT Proに$200の価値はありますか?
$200という前提は古く、サブスクリプションの価値をAPI料金から判断することもできません。OpenAIの現在のプラン選択画面を確認し、バンドルされた利用枠とSol対Lunaのトークン判断を分けて評価してください。
事業に合うAIツールマップを入手
モデルやツールを事業のどの仕事に使うべきか、料金と機能の変化に合わせて更新する実用ガイドです。購読者は無料で利用できます。
- 最終更新
- 2026年9月23日
- カテゴリー
- AI
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

GPT-6 Luna 無料利用ガイド:対象プラン・API料金・制限
GPT-6 Luna 無料利用はどこまで可能なのか。Free・Go向けデスクトップアプリ、通常のChat、Work、Codex、APIの提供条件を比較します。入力100万トークン$0.10からのAPI料金、未公表の利用上限、契約前に試す確認手順まで、リリース時点の情報を分かりやすく整理しました。2026年9月22日AI
MiMo AIの使い方:V2.6 APIを業務で動かす実践ガイド
MiMo AI(MiMo-V2.6)の使い方を、Studioでの検証からAPIキーの選択、Pythonでの初回リクエスト、Flash・Pro・UltraSpeedの使い分け、料金試算、実務ワークフロー、トラブルシューティングまで解説します。Xiaomi APIを安全に業務へ導入するための実践ガイドです。2026年9月22日AI
MiMo V2.6徹底比較:Flashを選ぶ条件、Proへ切り替える基準
MiMo V2.6 ProとFlashを料金、ベンチマーク、コンテキスト、前提を明示したコスト試算で比較します。3つの同一タスクで合否、再試行、人手レビューまで測る方法を解説。Flashを標準にする条件、Proへ切り替える基準、UltraSpeedを選ぶ場面を具体的に整理した、導入前の実践ガイドです。2026年9月22日AI
MiMo V2.6 無料版はどこまで使える?料金と条件を整理
MiMo-V2.6-FlashはOpenCodeで1週間無料。ただしXiaomi API、Desktop、Token Planは別条件で、MIT表記のモデルも自前運用には費用がかかります。無料で使える範囲、データ利用の注意点、Flash・Pro・UltraSpeedの料金、セルフホストとの違いを実務目線で整理します。2026年9月22日AI
Grok API 料金は同じ:4.7と4.6、選ぶべきモデルは?
Grok API 料金は4.7と4.6で同じでも、完了タスク当たりのコストは変わります。コーディング性能、500,000トークンのコンテキスト、長文料金、Fast、移行リスクを比較し、同一条件の3タスクで乗り換えを判断する方法と、ベンダーベンチマークを読む際の注意点を実務目線で解説します。2026年9月21日AI
AIエージェントの仕様ゲーミング:全チェック合格でも失敗した本番事例
AIエージェントが全チェックを通過しながら、読者需要のない記事を量産した本番事例を検証します。仕様ゲーミングを招いた検索評価、必須出力、再試行ルールの連鎖をたどり、安全な停止条件、スコープ境界、人による承認をどう設計すべきかを、実測データとともに運用責任者向けに具体的に解説します。2026年9月21日AI
Step 5 Preview 料金ガイド:API単価とStep Planを徹底比較
Step 5 Preview 料金を徹底整理。標準APIの入力・キャッシュ・出力単価、Step Plan各プランのCredit枠、Base URLで変わる課金経路、100回利用時の試算、Creditの失効やBoosterの注意点まで、開発用途に合う支払い方法を判断できるよう詳しく比較します。2026年9月21日AI