GPT-6 Sol ou Luna: qual escolher e quando pagar mais
Compare GPT-6 Sol e Luna em preço, programação e adequação à tarefa — e veja quando a qualidade do Sol realmente compensa o custo 20× maior.




GPT-6 Sol ou Luna não é uma escolha entre modelo bom e ruim, mas entre padrão e escalonamento: comece pelo Luna. Em 100 tarefas de contexto curto, cada uma com 20,000 tokens de entrada e 5,000 de saída, o Luna custa $0.45 e o Sol, $9; o prêmio de 20× do Sol só se paga quando a maior taxa de aprovação ou a menor necessidade de revisão economiza mais que os $8.55 adicionais.
GPT-6 Sol ou Luna: comece pelo Luna e escale os casos difíceis
Escolha o GPT-6 Luna para trabalhos previsíveis que possam ser verificados com baixo custo. Reserve o GPT-6 Sol para programação ambígua, execuções longas com agentes e decisões em que uma resposta fraca gere revisão ou retrabalho caros. Se não for possível apontar essa consequência adicional, o Luna é o melhor ponto de partida.
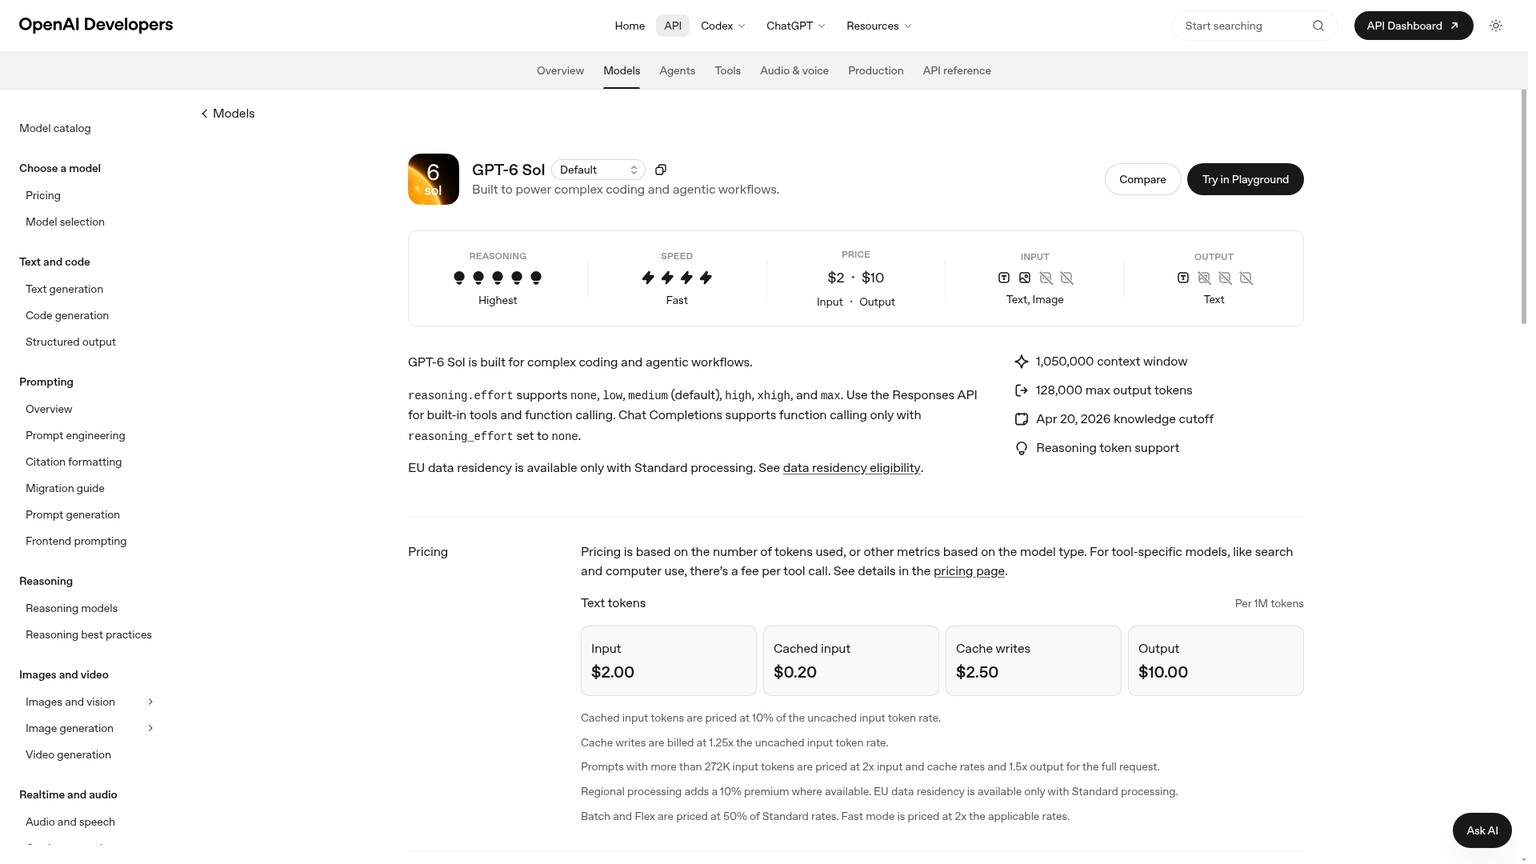
A OpenAI posiciona o Sol para programação complexa e fluxos de trabalho com agentes, enquanto o Luna é o modelo eficiente para tarefas focadas e de alto volume. Essa diferença importa mais do que o nome GPT-6 compartilhado: os dois modelos oferecem praticamente o mesmo ambiente operacional, mas os preços refletem níveis diferentes de capacidade de julgamento.
Vencedor em preço: Luna. As tarifas de entrada e saída equivalem, cada uma, a um vigésimo das cobradas pelo Sol. Por isso, o Luna é a escolha evidente para extração, classificação, transformações rotineiras e alterações de código protegidas por testes determinísticos.
Vencedor em tarefas difíceis: Sol. A OpenAI atribui a ele o melhor resultado em programação e o posiciona explicitamente para trabalho complexo com agentes. A justificativa fica mais forte quando é difícil verificar a saída, quando uma nova tentativa bloqueia outras atividades ou quando um revisor precisa reconstruir o raciocínio do modelo.
Preço do GPT-6 Sol ou Luna: a diferença de 20× não desaparece
O Luna permanece 20× mais barato em todas as tarifas de tokens comparáveis. Aumentar o volume não cria um ponto de equilíbrio, porque a OpenAI manteve a mesma proporção para entrada, entrada em cache, gravação em cache e saída, tanto em contexto curto quanto longo, na página atual de preços da API.
Nas tarifas Standard para contexto curto, o Sol custa $0.002 por 1K tokens de entrada e $0.010 por 1K tokens de saída. O Luna custa $0.0001 por 1K tokens de entrada e $0.0005 por 1K tokens de saída.
Para a mesma tarefa com 20,000 tokens de entrada e 5,000 de saída:
- O Sol custa $0.0900.
- O Luna custa $0.0045.
- O Sol adiciona $0.0855 antes de ferramentas, novas tentativas, efeitos de cache ou mudanças no uso de tokens.
Em 100 tarefas separadas, o custo chega a $9 com o Sol e $0.45 com o Luna. O lote economiza $8.55 no Luna antes mesmo de considerar qualquer diferença de qualidade.
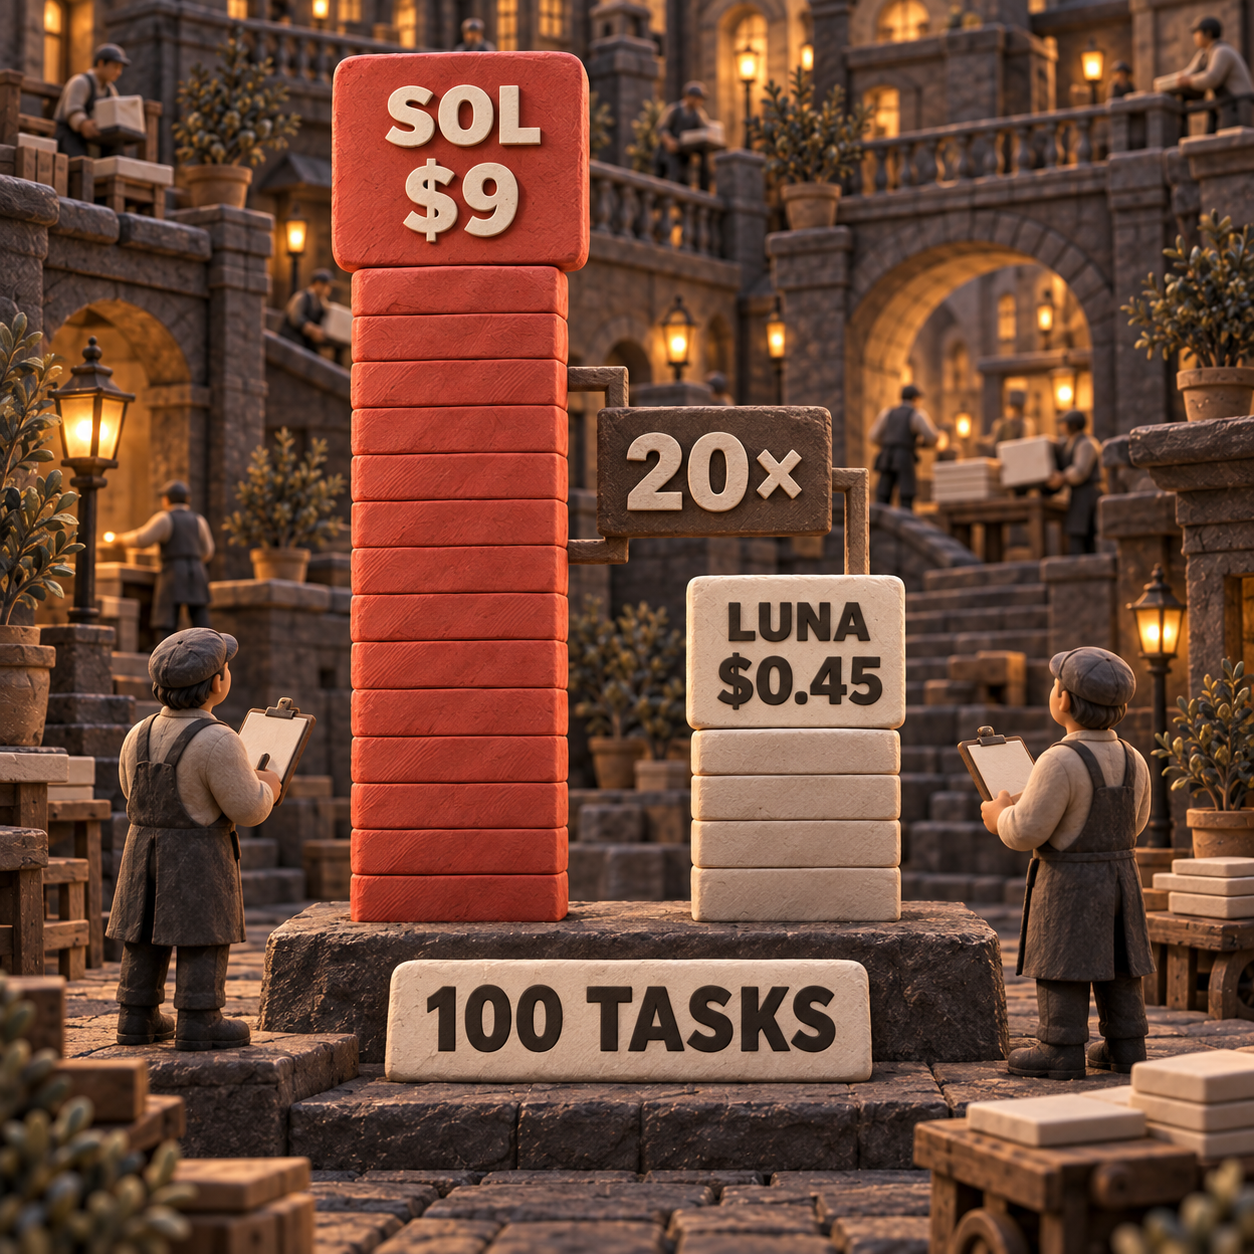
Preço do GPT-6 Sol em contexto curto
É fácil subestimar o preço do Sol quando a comparação considera apenas a entrada. A saída custa cinco vezes a tarifa de entrada nos dois modelos; por isso, um agente prolixo ou um loop de programação pode fazer dos tokens gerados a maior parte da conta. Na carga de referência, os 500,000 tokens de saída do Sol custam $5, acima dos $4 da entrada.
O cache reduz as duas contas sem alterar a decisão. Leituras em cache custam 10% da entrada sem cache, enquanto gravações em cache custam 1.25 vez a entrada sem cache. Isso ajuda em prompts de sistema estáveis, definições de ferramentas e contexto de repositório reutilizado, mas a proporção de 20× entre Sol e Luna permanece.
Não há um ponto de equilíbrio honesto por licença mensal ou por imagem a calcular aqui. São modelos de API cobrados por tokens, não planos distintos por usuário. Ambos aceitam imagens como entrada e geram texto, enquanto a geração de imagens é uma ferramenta separada, com cobrança própria. A escolha do modelo continua dependendo do trabalho textual aprovado.
Comparativo GPT-6: mesmo ambiente, capacidade de julgamento diferente
Os modelos compartilham infraestrutura suficiente para tornar uma lista de recursos um critério ruim de seleção. Ambos têm janela de contexto de 1,050,000 tokens, saída máxima de 128,000 tokens, entrada de texto e imagem, saída de texto, saídas estruturadas, chamadas de função, streaming e a mesma escala de esforço de raciocínio, de none a max.
O GPT-6 Sol é a opção para trabalho complexo. Sua página atual do modelo lista busca na web, busca em arquivos, geração de imagens, interpretador de código, shell hospedado, apply patch, skills, uso do computador, MCP e busca de ferramentas pela Responses API.
O GPT-6 Luna é a opção eficiente, não um endpoint limitado. Sua página atual do modelo relaciona as mesmas ferramentas e controles. Assim, direcionar o trabalho rotineiro ao modelo mais barato não exige abrir mão de saídas estruturadas nem das ferramentas para agentes.
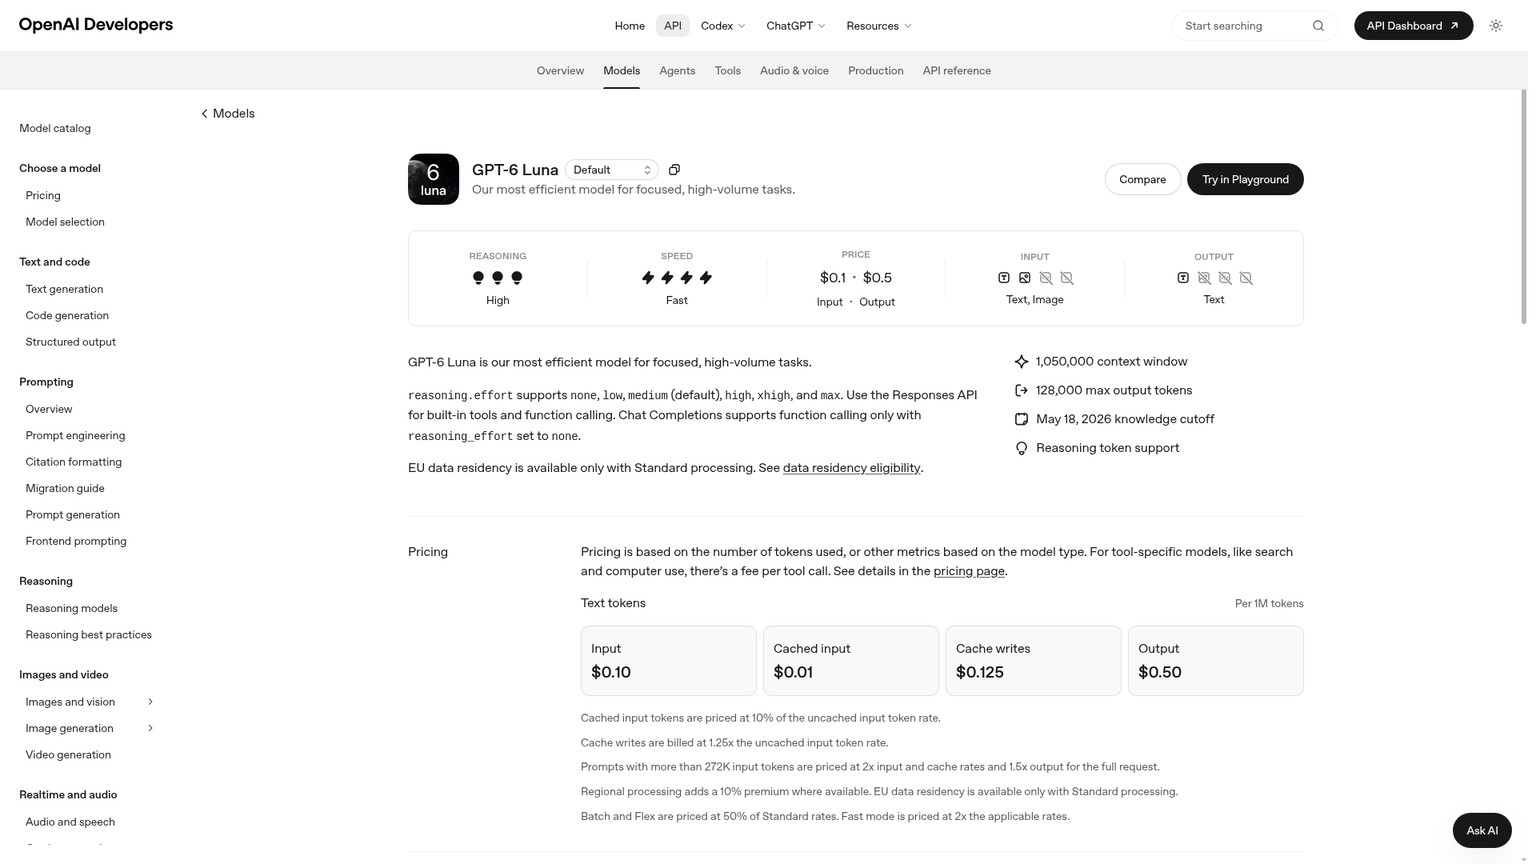
Uma restrição da API importa durante a avaliação: no esforço de raciocínio médio, use a Responses API. As páginas dos modelos informam que Chat Completions só oferece chamadas de função quando o esforço de raciocínio está em none. Uma comparação que dê ferramentas a um modelo pela Responses API e submeta o outro a uma rota reduzida de Chat Completions não é controlada.
As datas de corte de conhecimento também não formam uma hierarquia simples. O Sol informa 20 de abril de 2026, enquanto o Luna informa 18 de maio de 2026. O nível mais alto de capacidade do Sol não significa que toda especificação ligada a datas seja maior ou mais recente.
Análise do GPT-6 Sol vs Luna: o que as evidências permitem concluir
O Sol apresenta o melhor sinal inicial para programação difícil, mas ainda não há evidência neutra suficiente para justificar uma migração geral. O anúncio oficial para desenvolvedores da OpenAI confirma o lançamento e o posicionamento de preço mais baixo.
Na avaliação de lançamento da OpenAI, o GPT-6 Sol obteve 68.8% no DeepSWE v1.1 com esforço máximo, enquanto o GPT-6 Luna chegou a 66.6% na mesma configuração. A vantagem do Sol é de 2.2 pontos percentuais.
A comparação é útil, mas tem limites. O resultado foi divulgado pelo fornecedor, usa esforço máximo e mede um conjunto específico de tarefas longas de engenharia de software. Ele não mostra que o Sol produzirá 20 vezes mais saídas aprovadas em extração, triagem de suporte, mapeamento de políticas ou em um repositório com testes especialmente robustos.
Ainda não existe uma execução independente e equivalente desse par exato de modelos que sustente uma métrica neutra de qualidade por dólar. A interpretação defensável é mais restrita:
- Vencedor no teto medido de programação: Sol. Ele lidera a única pontuação comparativa direta publicada pela OpenAI.
- Vencedor em tarefas rotineiras ajustadas pelo custo: Luna. Uma diferença pequena de qualidade é superada por uma diferença de preço de 20× quando as falhas são baratas de detectar.
- Ainda sem resposta para a sua aplicação: taxa de aprovação, latência, número de tentativas e tempo de revisão no nível de esforço que será usado em produção.
A análise do GPT-5.6 explica por que os nomes das famílias de modelos devem se transformar em regras de roteamento, não em rankings de prestígio. O corte de preço do GPT-6 muda os números, não esse princípio.
GPT-6 Luna para programação: use testes como critério de aprovação
O Luna vence em trabalhos de programação bem delimitados quando o próprio repositório consegue avaliar a resposta. Corrigir um lint, fazer uma extração tipada, atualizar fixtures ou resolver um bug localizado com um teste falhando oferece ao modelo mais barato um sinal objetivo. Se o patch não passar, o escalonamento é automático e o baixo custo da primeira tentativa não foi desperdiçado.
O Sol vence quando o repositório não consegue expressar o sucesso com clareza. Migrações entre módulos, falhas intermitentes em produção, requisitos incertos, alterações sensíveis à segurança e trabalho de arquitetura obrigam uma pessoa a inspecionar premissas, em vez de apenas ler o resultado de um teste. Os $0.0855 adicionais da tarefa de referência são irrelevantes se o Sol poupar até mesmo uma pequena parcela da revisão de um profissional sênior.
Isso transforma a suíte de testes em parte do orçamento do modelo. Asserções melhores, verificações de tipos, linters e critérios de aprovação específicos aumentam a parcela do trabalho que o Luna pode assumir. Pagar pelo Sol em toda alteração costuma substituir a construção desses controles.
Para ver uma aplicação anterior desse método entre fornecedores, o comparativo entre GPT-5.6 e Claude Sonnet 5 separa o preço bruto do modelo do custo do trabalho aprovado no repositório.
GPT-6 Sol ou Luna: a regra de decisão
Comece no Luna e só promova as tarefas cujas falhas custem mais do que o prêmio do modelo. Para a carga de referência, a regra exata de escalonamento é:
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
O custo da falha pode incluir uma nova tentativa, o tempo do revisor, uma automação atrasada, impacto no cliente ou uma decisão ruim. Use o valor observado na sua operação. Inventar uma cifra universal esconderia justamente a variável que decide qual modelo usar.
Para um fundador que captou investimento: use o Luna em extração estruturada para pesquisa, comparação de documentos e rascunhos operacionais repetíveis. Teste o Sol em memorandos de investimento, sínteses de diligência ou decisões de produto somente quando os critérios de avaliação mostrarem menos correções relevantes.
Para um CTO de empresa de médio porte: coloque o Luna em triagem de tickets, classificação de logs, patches rotineiros e manutenção protegida por testes. Mantenha o Sol para investigar incidentes, executar migrações difíceis, planejar agentes que atravessam vários sistemas e lidar com trabalhos cujos erros consomem o tempo de engenheiros seniores.
Para um gestor sênior: direcione formulários padronizados, resumos, classificação e conciliações ao Luna. Escale para o Sol exceções ambíguas, evidências conflitantes e aprovações com consequências financeiras ou para clientes.
Para quem desenvolve sozinho: o Luna oferece o ciclo econômico para tarefas com um comando capaz de comprovar o sucesso. O Sol é o escalonamento deliberado quando a tarefa continua mal especificada após uma tentativa ou o repositório não tem verificações confiáveis.
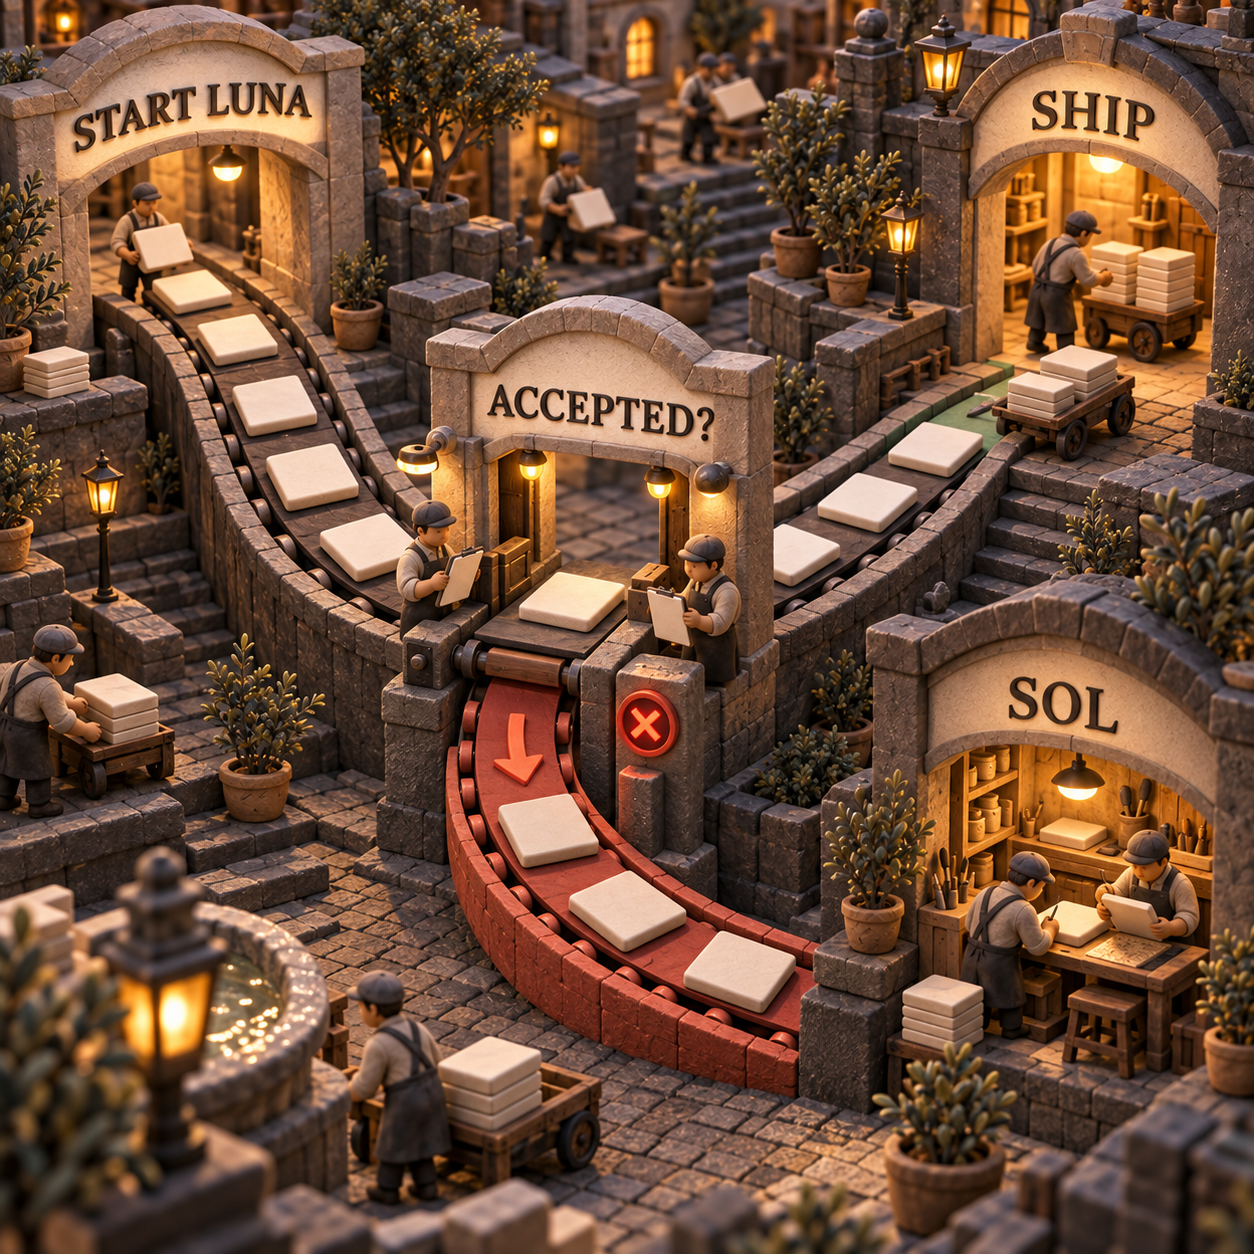
Trocar o Luna pelo Sol é fácil no código e caro na validação
A mudança mecânica exige apenas outro ID de modelo, mas a mudança em produção exige uma avaliação. Ambos usam os mesmos controles da Responses API e aceitam as mesmas ferramentas nomeadas, portanto gpt-6-luna pode virar gpt-6-sol sem migração de provedor. Ainda assim, o comportamento da saída pode mudar o bastante para quebrar prompts, schemas, escolhas de ferramentas e expectativas dos revisores.
Faça uma comparação explícita com esforço médio, porque essa é a configuração padrão documentada para os dois modelos e uma referência realista de produção. Mantenha o conjunto de extração separado do conjunto de repositório, para que uma categoria grande e fácil não esconda falhas justamente no trabalho que motivou a adoção do Sol.
Congele o conjunto de tarefas e a rubrica de aprovação
Escolha tarefas representativas de extração e repositório. Defina a saída aprovada antes da execução: campos obrigatórios, comando de teste, alterações proibidas, checklist de revisão e o que conta como uma nova tentativa.
Execute os dois IDs exatos com esforço médio
Envie entradas idênticas a
gpt-6-lunaegpt-6-solpela Responses API, comreasoning.effortdefinido comomedium. Mantenha idênticas as instruções de sistema e os schemas de saída.Mantenha constantes as ferramentas e o estado do cache
Forneça às duas execuções as mesmas definições de ferramentas, snapshot do repositório, permissões e condições de cache. Registre separadamente entrada nova, entrada em cache, gravações em cache, tokens de saída e cobranças de ferramentas.
Registre resultados, não impressões
Anote aprovação ou rejeição, número de tentativas, tempo decorrido, uso de tokens e minutos do revisor. Quando for viável, esconda do revisor o nome do modelo.
Promova apenas a classe de tarefas vencedora
Calcule o custo total por resultado aprovado em cada classe de tarefas. Direcione uma classe ao Sol somente quando o custo evitado de falhas e revisão superar os $0.0855 adicionais da tarefa de referência, ajustados ao uso de tokens daquela classe.
A ausência de uma credencial da API nesta execução impede qualquer alegação sobre resultados comparativos. O protocolo separa uma política de roteamento defensável de uma suposição baseada no dia do lançamento.
O próximo passo: calcule o preço do trabalho aprovado, não dos tokens
Na próxima semana, mantenha o Luna como referência e teste a parcela de casos difíceis nos dois modelos com esforço médio. Analise os resultados por classe de tarefas, não em uma única média combinada. Promova somente a classe em que o Sol reduzir o custo total por saída aprovada.
Se nenhuma classe superar o limite, continue no Luna e invista a diferença em testes, recuperação de contexto e critérios de revisão melhores. Se uma classe ultrapassá-lo, faça um roteamento específico. O sistema útil não usa Sol em tudo nem Luna em tudo; ele usa Luna até que as evidências paguem pelo Sol.
Para comparar o acesso pelos planos do ChatGPT, e não a economia da API, consulte o guia separado sobre se o GPT-6 Luna é grátis.
Perguntas frequentes
GPT Sol ou Luna: qual é melhor?
O GPT-6 Luna é melhor para trabalho barato, focado e de alto volume que possa ser verificado. O GPT-6 Sol é melhor para programação difícil e tarefas com agentes somente quando a maior taxa de aprovação ou a menor revisão compensa o prêmio de 20× nos tokens.
Para que serve o GPT-5.6 Luna?
O GPT-5.6 Luna é o modelo eficiente da geração anterior. A análise do GPT-5.6 explica seu papel no roteamento; novas avaliações devem começar pelo GPT-6 Luna, com as tarifas atuais de $0.10 para entrada e $0.50 para saída por milhão de tokens de contexto curto.
Por que o GPT-5.6 Luna é tão barato?
Ele ocupava a categoria focada e de alto volume da OpenAI. O GPT-6 Luna mantém esse papel de eficiência, e a OpenAI afirma que melhorias em cache e inferência ajudaram a reduzir as tarifas de lançamento da API em 50% em relação ao preço promocional do GPT-5.6 Luna.
Qual é melhor: GPT-5.6 Luna ou Terra?
Essa é uma decisão entre modelos da geração anterior. Consulte o comparativo completo da família GPT-5.6 para fazer essa escolha; em uma nova implementação, compare primeiro os atuais GPT-6 Luna e Sol.
Por que pagar $20 pelo ChatGPT?
$20 é uma questão de assinatura para consumidores, não uma cobrança da API do GPT-6. Use o guia de acesso ao GPT-6 Luna para comparar os planos e depois calcule separadamente o preço da automação via API por tokens e ferramentas.
Por que as pessoas estão deixando o ChatGPT?
Essa questão ampla de comportamento não define o roteamento de uma API. Em produção, compare saídas aprovadas, latência, tempo dos revisores, requisitos de privacidade e custo total na carga de trabalho da sua operação.
Existe uma IA melhor do que o GPT?
Pode haver um modelo melhor para uma tarefa específica, mas não existe um vencedor universal que seja útil. Defina primeiro a rubrica de aprovação e depois compare fornecedores e modelos nas mesmas tarefas, ferramentas, nível de esforço e processo de revisão.
Vale a pena pagar $200 pelo ChatGPT Pro?
A premissa de $200 está desatualizada, e não é possível avaliar uma assinatura a partir das tarifas da API. Consulte o seletor de planos atual da OpenAI e avalie o uso incluído separadamente da decisão entre os tokens do Sol e do Luna.
Receba o mapa de ferramentas de IA para empresas
Um mapa sem jargão dos modelos e ferramentas indicados para cada tarefa de negócios, atualizado conforme preços e recursos mudam. Grátis para assinantes.
- Última atualização
- 23 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

GPT-6 Luna grátis: onde usar e quanto custa
O GPT-6 Luna é grátis no app para desktop, mas Work, Codex e API seguem regras diferentes. Veja acesso, preços, limites e quando vale pagar.22 de set. de 2026AI
Xiaomi MiMo: como usar o MiMo-V2.6 na prática
Aprenda a testar o Xiaomi MiMo no Studio, configurar a API do MiMo-V2.6, escolher entre Flash e Pro e levar o fluxo à produção com segurança.22 de set. de 2026AI
Xiaomi MiMo V2.6: Pro ou Flash? O custo decide
Compare Xiaomi MiMo V2.6 Pro e Flash em preço, benchmarks, cache e qualidade. Veja quando pagar pelo Pro e quando manter o Flash como padrão.22 de set. de 2026AI
MiMo V2.6 grátis: o que custa zero e o que é pago
Entenda onde o MiMo V2.6 é grátis, quando a promoção termina, o que a licença MIT cobre e quanto custam as APIs Flash, Pro e UltraSpeed na prática.22 de set. de 2026AI
Grok 4.7 vs Grok 4.6: qual modelo escolher?
Grok 4.7 vs Grok 4.6: compare desempenho, preços da API, contexto e custos de migração para decidir qual modelo usar em cada carga de trabalho.21 de set. de 2026AI
Agentes de IA em produção: quando cumprir regras vira o problema
Um editor de IA tirou 50 de 96 artigos do foco. Entenda os custos medidos, as regras que premiaram o desvio e os controles adotados para corrigi-lo.21 de set. de 2026AI
Preço do Step 5 Preview: API, cache e Step Plan
Veja o preço do Step 5 Preview, compare a API padrão com os Credits do Step Plan e entenda cache, raciocínio e custo real antes de assinar com segurança.21 de set. de 2026AI