Quale modello GPT-6 scegliere: Sol o Luna?
Confronta GPT-6 Sol e Luna per prezzi API, qualità nel coding e costi di revisione. Scopri quando conviene partire da Luna e quando passare a Sol.




Capire quale modello GPT-6 scegliere tra Sol e Luna significa decidere quale usare come base e quale riservare all’escalation: parti da Luna. Su 100 attività a contesto breve, ciascuna con 20,000 token in input e 5,000 in output, Luna costa $0.45 e Sol $9; il sovrapprezzo di 20× di Sol si giustifica solo se un tasso di accettazione più alto o meno lavoro di revisione fa risparmiare più degli $8.55 aggiuntivi.
Quale modello GPT-6 scegliere: Luna prima, Sol per i casi più difficili
Scegli GPT-6 Luna per il lavoro prevedibile che puoi verificare a basso costo. Scegli GPT-6 Sol per il coding ambiguo, i processi agentici lunghi e le decisioni in cui una risposta debole genera revisioni o rifacimenti costosi. Se non sai indicare quale sia la conseguenza aggiuntiva, Luna è il punto di partenza migliore.
OpenAI presenta Sol come il modello per il coding complesso e i workflow agentici, mentre Luna è il modello efficiente per attività mirate e ad alto volume. Questa differenza conta più del nome GPT-6 condiviso: i due modelli offrono un perimetro operativo quasi identico, ma i prezzi riflettono livelli di giudizio diversi.
Vincitore sul prezzo: Luna. Le tariffe di input e output sono entrambe pari a un ventesimo di quelle di Sol. Luna è quindi la scelta naturale per estrazione, classificazione, trasformazioni di routine e modifiche al codice protette da test deterministici.
Vincitore sul lavoro difficile: Sol. OpenAI gli attribuisce il risultato migliore nel coding e lo posiziona esplicitamente per il lavoro agentico complesso. Il vantaggio è più concreto quando l’output è difficile da verificare, un nuovo tentativo blocca altre attività oppure chi revisiona deve ricostruire il ragionamento del modello.
Prezzi di GPT-6 Sol vs Luna: sui token il divario di 20× non si chiude
Luna resta 20× più economico per ogni tariffa di token confrontabile. Aumentare il volume non crea un punto di pareggio, perché OpenAI ha mantenuto lo stesso rapporto per input, input in cache, scritture in cache e output, sia con contesto breve sia con contesto lungo, nella sua pagina live dei prezzi API.
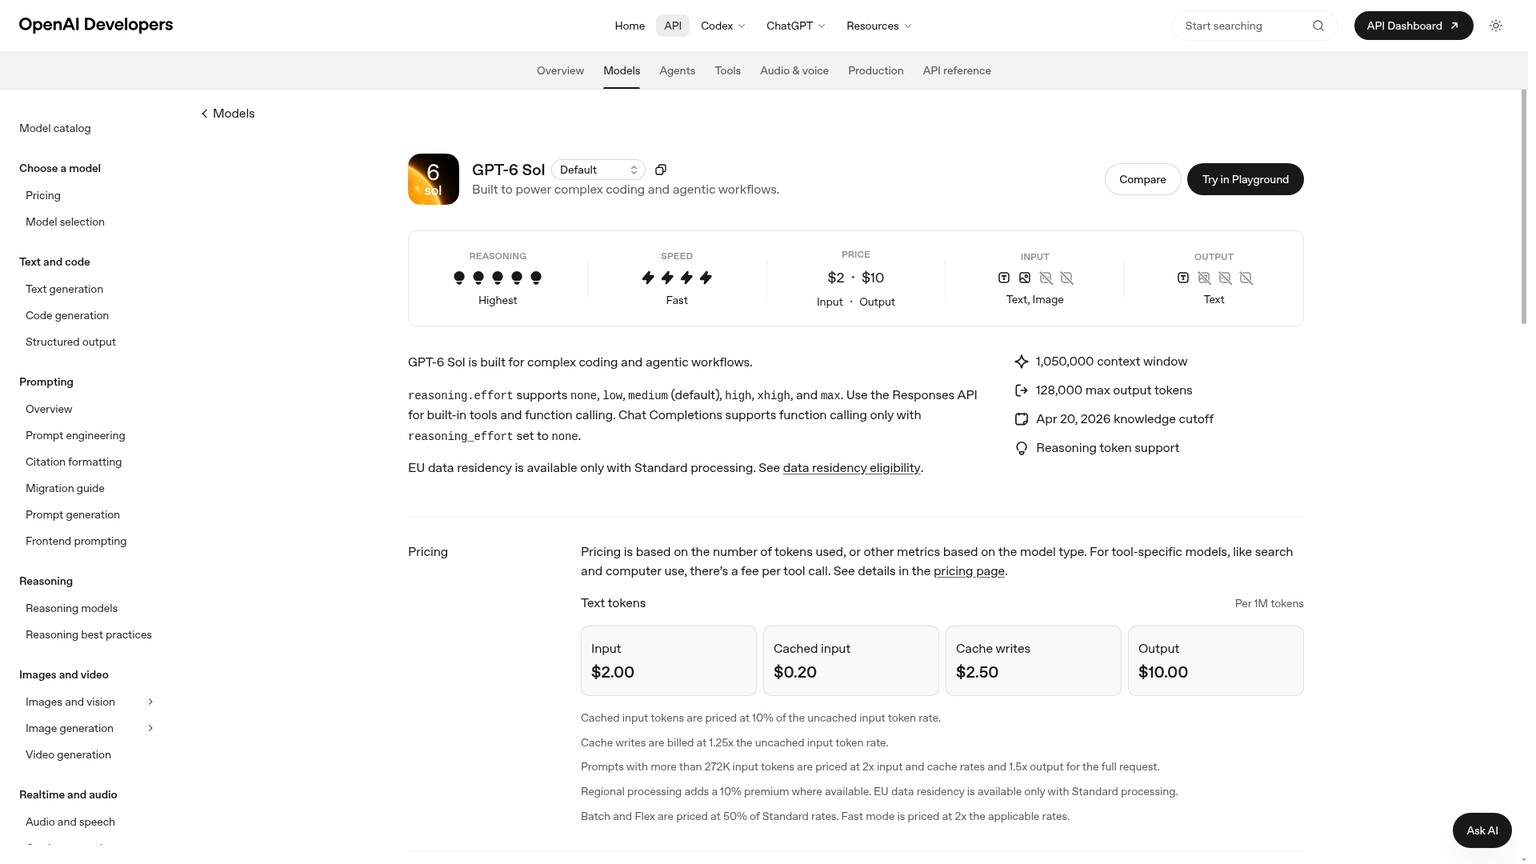
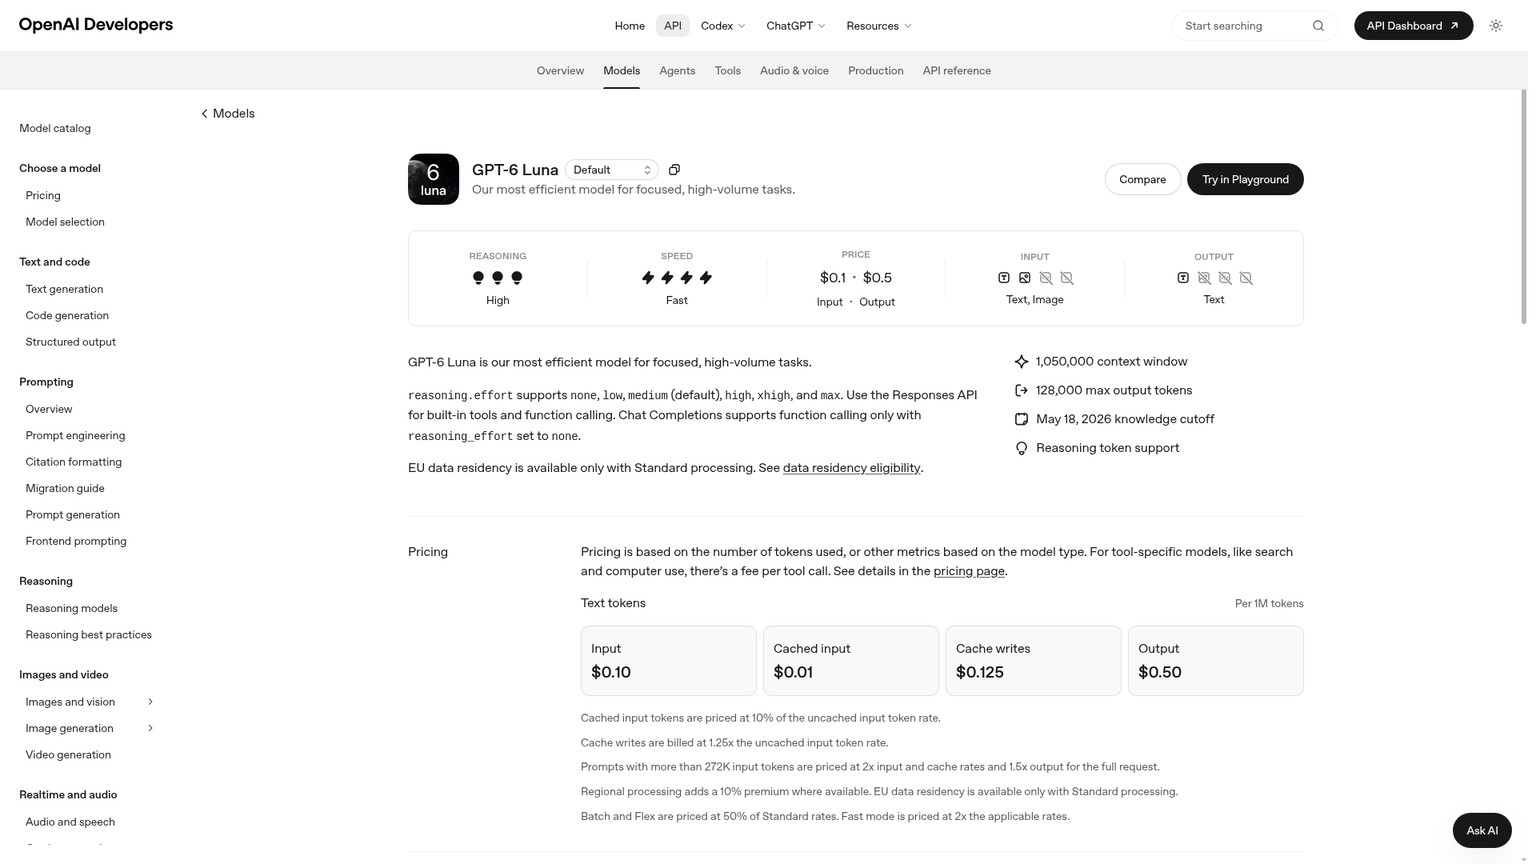
Con le tariffe Standard a contesto breve, Sol costa $0.002 per 1K token in input e $0.010 per 1K token in output. Luna costa $0.0001 per 1K token in input e $0.0005 per 1K token in output.
Per la stessa attività da 20,000 token in input e 5,000 in output:
- Sol costa $0.0900.
- Luna costa $0.0045.
- Sol aggiunge $0.0855 prima di strumenti, nuovi tentativi, effetti della cache o variazioni nel consumo di token.
Su 100 attività separate, il costo diventa $9 con Sol e $0.45 con Luna. Il batch fa risparmiare $8.55 usando Luna, prima ancora di considerare eventuali differenze qualitative.
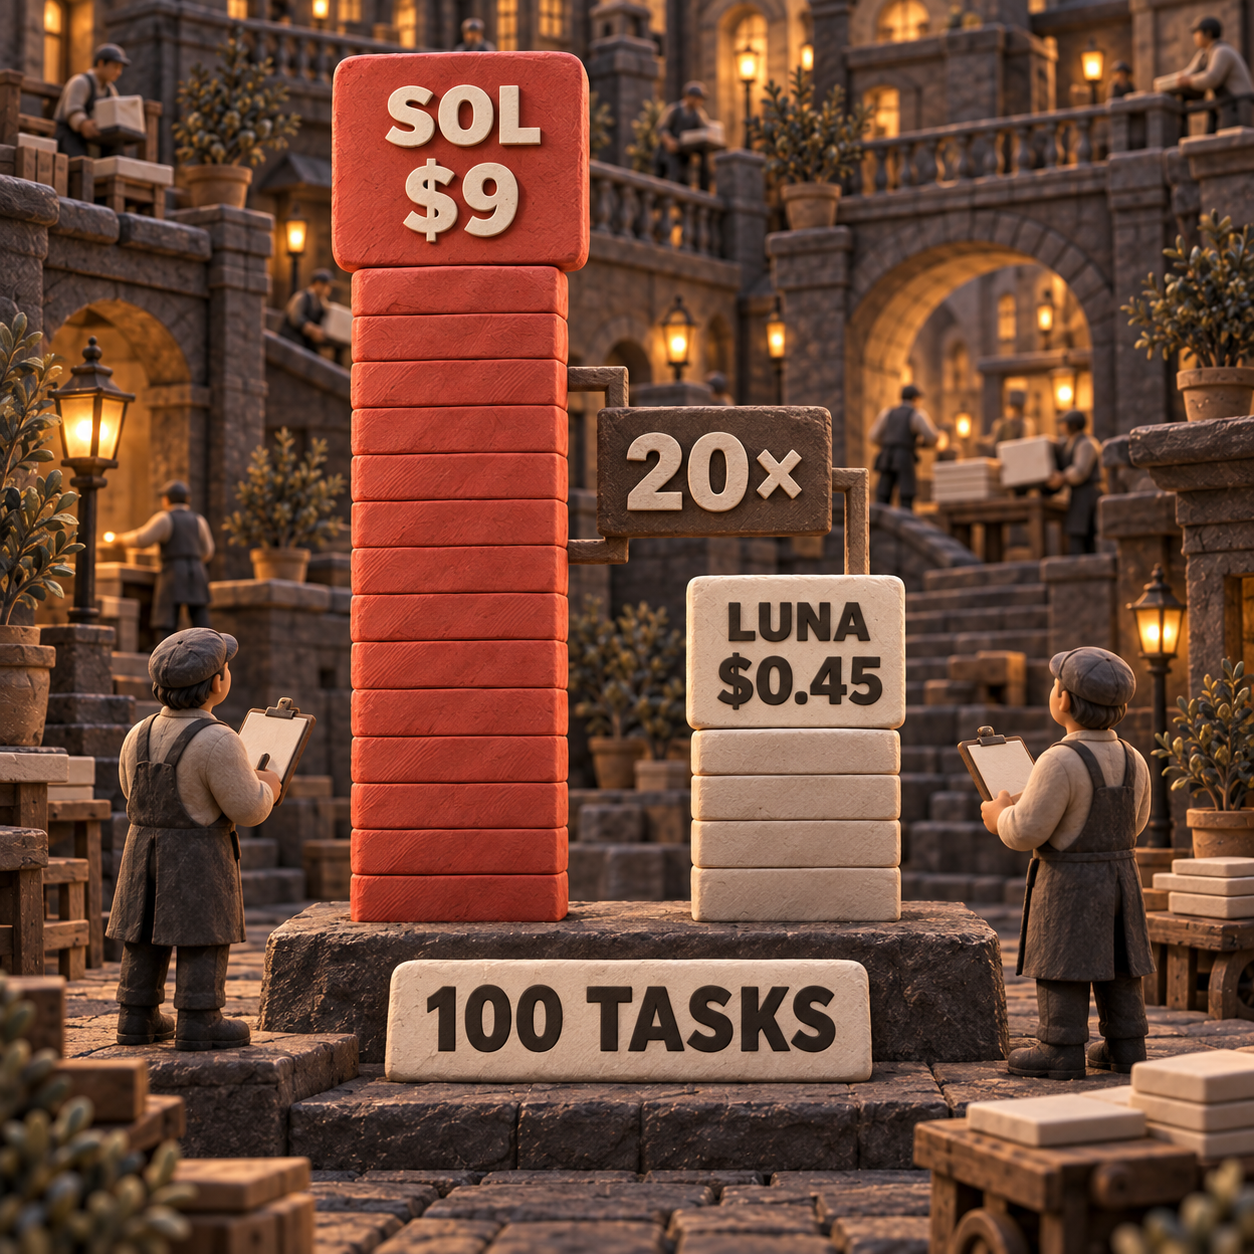
Prezzi di GPT-6 Sol con contesto breve
È facile sottostimare il prezzo di Sol quando il confronto si ferma all’input. Per entrambi i modelli, l’output costa cinque volte l’input: in un agente prolisso o in un ciclo di coding, i token generati possono quindi diventare la parte più consistente della spesa. Nel carico di lavoro di riferimento, i 500,000 token in output di Sol costano $5, più dei $4 dell’input.
La cache riduce entrambe le fatture senza cambiare la scelta. Le letture dalla cache costano il 10% dell’input non memorizzato, mentre le scritture costano 1.25 volte l’input non memorizzato. È utile per prompt di sistema stabili, definizioni degli strumenti e contesto del repository riutilizzato, ma il rapporto di 20× tra Sol e Luna rimane invariato.
Non c’è un confronto corretto da fare sul costo mensile per postazione o per immagine. Sono modelli API fatturati a token, non piani per postazione differenti. Entrambi accettano immagini in input e producono testo; la generazione di immagini è invece uno strumento separato, con costi propri. La scelta del modello torna sempre al lavoro testuale effettivamente accettato.
Confronto tra i modelli GPT-6: stesso perimetro, giudizio diverso
I due modelli condividono abbastanza infrastruttura da rendere poco utile una selezione basata su una lista di funzionalità. Entrambi dichiarano una finestra di contesto da 1,050,000 token, un output massimo da 128,000 token, input di testo e immagini, output testuale, output strutturati, function calling, streaming e la stessa scala di reasoning effort da none a max.
GPT-6 Sol è l’opzione per il lavoro complesso. La sua pagina live del modello elenca ricerca web, ricerca nei file, generazione di immagini, interprete di codice, shell in hosting, apply patch, skill, uso del computer, MCP e ricerca degli strumenti tramite Responses API.
GPT-6 Luna è l’opzione efficiente, non un endpoint ridotto. La sua pagina live del modello elenca gli stessi strumenti e controlli: spostare verso il basso le attività di routine non significa rinunciare agli output strutturati o agli strumenti per agenti.
Durante la valutazione conta un vincolo API: con reasoning effort medio, usa Responses API. Le pagine dei modelli indicano che Chat Completions supporta il function calling solo quando il reasoning effort è none. Un confronto in cui un modello usa gli strumenti tramite Responses e l’altro passa da un percorso Chat Completions ridotto non è controllato.
Anche le date di cutoff delle conoscenze non definiscono una gerarchia semplice. Per Sol è indicato il 20 aprile 2026, per Luna il 18 maggio 2026. Una fascia di capacità superiore per Sol non implica che ogni specifica legata a una data sia maggiore o più recente.
Recensione di GPT-6 Sol vs Luna: fin dove arrivano le prove
Sol offre il segnale iniziale migliore sul coding difficile, ma non ci sono ancora prove neutrali sufficienti per giustificare un upgrade generalizzato. L’annuncio ufficiale per gli sviluppatori di OpenAI conferma il lancio e il posizionamento a prezzo inferiore.
Nella valutazione di lancio di OpenAI, GPT-6 Sol ha ottenuto il 68.8% su DeepSWE v1.1 al massimo effort e GPT-6 Luna il 66.6%, sempre al massimo effort. Il vantaggio di Sol è di 2.2 punti percentuali.
Il confronto è utile, ma va circoscritto. È dichiarato dal fornitore, usa il massimo effort e misura un insieme specifico di attività di ingegneria software a lungo orizzonte. Non dimostra che Sol produca 20 volte più output accettati nell’estrazione, nello smistamento delle richieste di assistenza, nella mappatura delle policy o in un repository con test particolarmente solidi.
Non è ancora disponibile un test indipendente e comparabile su questa coppia esatta di modelli che permetta di calcolare un rapporto neutrale tra qualità e prezzo. La lettura difendibile è più limitata:
- Vincitore sul livello massimo di coding misurato: Sol. È in testa nell’unico punteggio comparativo diretto pubblicato da OpenAI.
- Vincitore sul lavoro di routine corretto per il costo: Luna. Quando gli errori sono economici da rilevare, un piccolo scarto qualitativo viene travolto da una differenza di prezzo di 20×.
- Da verificare nella tua applicazione: tasso di accettazione, latenza, numero di nuovi tentativi e tempo dei revisori con l’effort che userai in produzione.
La precedente recensione di GPT-5.6 spiega perché le etichette delle famiglie di modelli dovrebbero tradursi in regole di routing, non in classifiche di prestigio. Il taglio dei prezzi di GPT-6 cambia i numeri, non il principio.
GPT-6 Luna per il coding: usa i test come criterio di accesso
Luna vince sul coding circoscritto quando il repository è in grado di giudicare la risposta. Correggere un errore di lint, implementare un’estrazione tipizzata, aggiornare una fixture o risolvere un bug localizzato con un test fallito dà a un modello più economico un segnale netto. Se la patch non supera il test, l’escalation è automatica e il basso costo del primo tentativo non è stato sprecato.
Sol vince quando il repository non può esprimere chiaramente che cosa significhi riuscire. Migrazioni tra moduli, errori intermittenti in produzione, requisiti poco chiari, modifiche sensibili per la sicurezza e lavoro di architettura obbligano una persona a esaminare le ipotesi, non soltanto il risultato di un test. Gli $0.0855 aggiuntivi dell’attività di riferimento sono irrilevanti se Sol evita anche solo una piccola quantità di revisione senior.
La suite di test diventa così una parte del budget destinato al modello. Assert migliori, controlli dei tipi, linter e criteri di accettazione ristretti aumentano la quota di lavoro che Luna può gestire. Pagare Sol per ogni modifica spesso sostituisce la costruzione di questi controlli.
Per un precedente esempio tra fornitori diversi, il confronto tra GPT-5.6 e Claude Sonnet 5 separa il prezzo nominale del modello dal costo del lavoro accettato nel repository.
GPT-6 Sol o Luna: la regola per scegliere
Parti da Luna, poi promuovi soltanto le attività il cui fallimento costa più del sovrapprezzo del modello. Per il carico di lavoro di riferimento, la regola esatta di promozione è:
(Luna failure rate - Sol failure rate) × cost of a failed task > $0.0855
Il costo di un fallimento può comprendere un nuovo tentativo, il tempo di chi revisiona, un’automazione in ritardo, l’impatto sui clienti o una decisione sbagliata. Usa il valore che hai osservato. Inventare una cifra universale nasconderebbe proprio la variabile che determina la scelta del modello.
Per un founder finanziato: usa Luna per l’estrazione strutturata nelle ricerche, il confronto tra documenti e le bozze operative ripetibili. Prova Sol per memorandum d’investimento, sintesi di due diligence o decisioni di prodotto soltanto quando una griglia di valutazione mostra meno correzioni sostanziali.
Per il CTO di un’azienda di medie dimensioni: affida a Luna lo smistamento dei ticket, la classificazione dei log, le patch di routine e la manutenzione coperta da test. Riserva Sol all’analisi degli incidenti, alle migrazioni difficili, ai piani agentici che attraversano più sistemi e al lavoro in cui gli errori consumano tempo dell’ingegneria senior.
Per un responsabile operativo senior: instrada verso Luna moduli standardizzati, riepiloghi, tagging e riconciliazioni. Porta su Sol le eccezioni ambigue, le evidenze in conflitto e le approvazioni con conseguenze finanziarie o per i clienti.
Per chi sviluppa da solo: Luna è il ciclo economico per le attività in cui un comando può dimostrare la riuscita. Sol è l’escalation intenzionale quando, dopo un tentativo, l’attività resta poco definita oppure il repository non dispone di controlli affidabili.
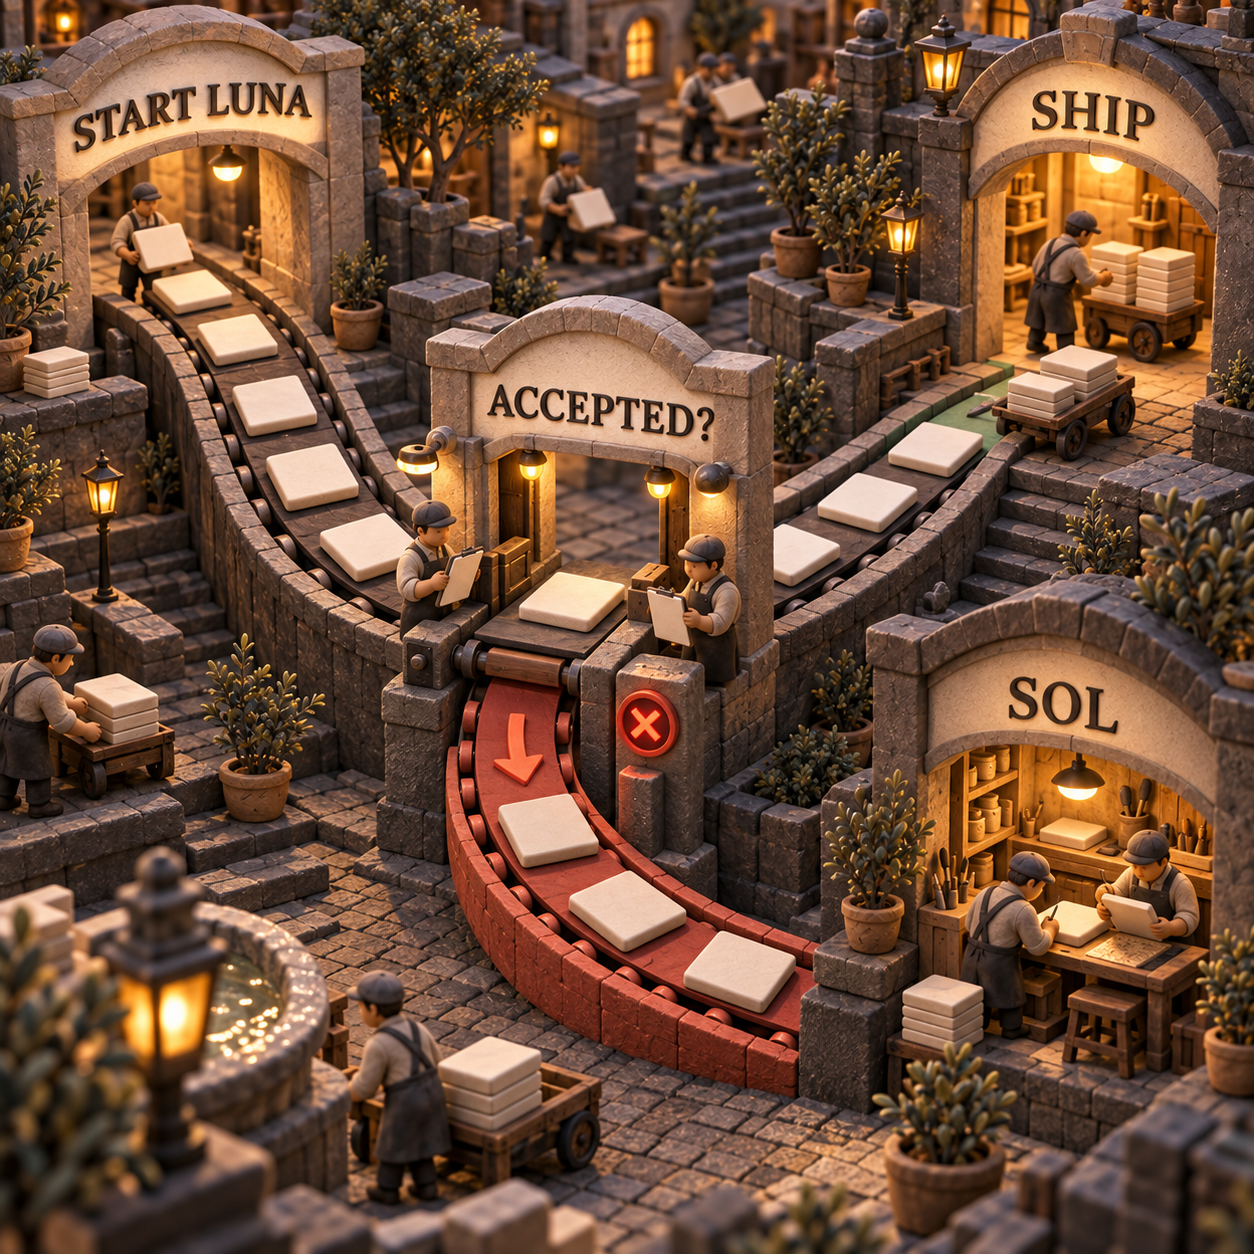
Passare da Luna a Sol è facile nel codice, costoso nella validazione
La modifica tecnica riguarda un solo ID modello, ma in produzione il passaggio richiede una valutazione. Entrambi i modelli usano gli stessi controlli della Responses API e supportano gli stessi strumenti nominali, quindi gpt-6-luna può diventare gpt-6-sol senza migrare il provider. Il comportamento dell’output può comunque cambiare abbastanza da compromettere prompt, schemi, scelta degli strumenti e aspettative di chi revisiona.
Confrontali esplicitamente a effort medio: è l’impostazione predefinita documentata per entrambi e una base realistica per la produzione. Tieni separato il set di estrazione da quello del repository, così una categoria ampia e semplice non potrà nascondere i fallimenti proprio nel lavoro che ti ha spinto a considerare Sol.
Blocca il set di attività e i criteri di accettazione
Scegli attività rappresentative per estrazione e repository. Prima dell’esecuzione, definisci l’output accettato: campi obbligatori, comando di test, modifiche vietate, checklist di revisione e condizioni che richiedono un nuovo tentativo.
Esegui entrambi gli ID modello esatti con effort medio
Invia gli stessi input a
gpt-6-lunaegpt-6-soltramite Responses API, impostandoreasoning.effortsumedium. Mantieni identiche le istruzioni di sistema e gli schemi di output.Mantieni costanti strumenti e stato della cache
Fornisci a entrambe le esecuzioni le stesse definizioni degli strumenti, lo stesso snapshot del repository, gli stessi permessi e le stesse condizioni della cache. Registra separatamente input nuovo, input dalla cache, scritture in cache, token in output e costi degli strumenti.
Registra i risultati, non le impressioni
Annota accettazione o rifiuto, numero di nuovi tentativi, tempo trascorso, consumo di token e minuti di revisione. Quando è pratico, nascondi a chi revisiona il nome del modello.
Promuovi soltanto la classe di attività vincente
Calcola il costo totale per risultato accettato in ciascuna classe di attività. Instrada una classe verso Sol soltanto quando il valore dei fallimenti e della revisione evitati supera gli $0.0855 aggiuntivi dell’attività di riferimento, adattati al consumo di token della classe.
L’assenza di una credenziale API in questa analisi impedisce di presentare quei risultati comparativi come effettivamente misurati. Il protocollo separa una policy di routing difendibile da un’ipotesi formulata il giorno del lancio.
La mossa di lunedì: calcola il costo del lavoro accettato, non dei token
La prossima settimana, mantieni Luna come base e prova la coda dei casi difficili su entrambi i modelli con effort medio. Valuta i risultati per classe di attività, non come un’unica media aggregata. Promuovi soltanto la classe in cui Sol riduce il costo totale per output accettato.
Se nessuna classe supera la soglia, resta su Luna e investi la differenza in test, retrieval e controlli di revisione migliori. Se una classe la supera, crea un routing ristretto. Il sistema utile non è Sol ovunque o Luna ovunque: è Luna finché le prove non giustificano il costo di Sol.
Per l’accesso dai piani ChatGPT, distinto dai costi dell’API, consulta la guida dedicata a GPT-6 Luna gratis o a pagamento.
Domande frequenti
È meglio GPT Sol o Luna?
GPT-6 Luna è migliore per il lavoro economico, mirato e ad alto volume che puoi verificare. GPT-6 Sol è migliore per il coding difficile e il lavoro agentico soltanto quando un tasso di accettazione più alto o costi di revisione più bassi compensano il sovrapprezzo di 20× sui token.
Per cosa è indicato GPT-5.6 Luna?
GPT-5.6 Luna è il modello efficiente della generazione precedente. La recensione di GPT-5.6 ne analizza il ruolo nel routing; le nuove valutazioni dovrebbero partire da GPT-6 Luna alle tariffe correnti di $0.10 per l’input e $0.50 per l’output, per milione di token a contesto breve.
Perché GPT-5.6 Luna costa così poco?
Occupava la fascia di OpenAI dedicata al lavoro mirato e ad alto volume. GPT-6 Luna prosegue in quel ruolo efficiente e OpenAI afferma che i miglioramenti nella cache e nell’inferenza hanno permesso di ridurre del 50% le tariffe API di lancio rispetto ai prezzi promozionali di GPT-5.6 Luna.
È meglio GPT-5.6 Luna o Terra?
È una scelta tra modelli della generazione precedente. Per quella decisione, leggi il confronto completo della famiglia GPT-5.6; per un nuovo deployment, confronta prima gli attuali GPT-6 Luna e Sol.
Perché pagare $20 per ChatGPT?
$20 riguarda un abbonamento consumer, non un costo API di GPT-6. Usa la guida dedicata all’accesso a GPT-6 Luna per confrontare i diversi piani, poi calcola separatamente il costo dell’automazione API in base a token e strumenti.
Perché le persone abbandonano ChatGPT?
Una domanda così ampia sul comportamento degli utenti non determina il routing di un’API. In produzione, confronta output accettati, latenza, tempo dei revisori, requisiti di privacy e costo totale sul carico di lavoro che gestisci.
Esiste un’IA migliore di GPT?
Può esistere un modello migliore per un’attività specifica, ma non un vincitore universale davvero utile. Definisci prima i criteri di accettazione, poi confronta provider e modelli sulle stesse attività, con gli stessi strumenti, effort e processi di revisione.
ChatGPT Pro vale $200?
Il presupposto dei $200 non è più attuale e il valore di un abbonamento non si può ricavare dalle tariffe API. Controlla il selettore dei piani corrente di OpenAI, poi valuta l’utilizzo incluso separatamente dalla scelta dei token tra Sol e Luna.
Ricevi la mappa degli strumenti di IA per chi fa impresa
Una mappa chiara dei modelli e degli strumenti più adatti a ogni attività aziendale, aggiornata quando cambiano prezzi e funzionalità. Gratis per gli iscritti.
- Ultimo aggiornamento
- 23 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

GPT-6 Luna gratis: dove usarlo e quanto costa davvero
GPT-6 Luna è gratis nell’app desktop per gli utenti Free e Go. Scopri dove funziona, quali piani lo includono e quanto costa davvero usare l’API.22 set 2026AI
MiMo AI V2.6: dalla prova in Studio alla prima API
Scopri come provare MiMo AI V2.6 in Studio, configurare chiavi e API corrette e portare in produzione un primo flusso di lavoro verificabile.22 set 2026AI
AI per programmare: MiMo V2.6 Pro o Flash?
Confronto tra MiMo V2.6 Pro e Flash per coding, agenti e UI: prezzi, benchmark e una regola pratica per scegliere il modello più conveniente.22 set 2026AI
MiMo V2.6 gratis? Accessi, licenza e costi reali
MiMo V2.6 è gratis solo in alcuni casi: ecco cosa offre OpenCode, cosa copre la licenza MIT e quanto costano le API Flash, Pro e UltraSpeed.22 set 2026AI
Grok API: confronto tra Grok 4.7 e Grok 4.6
Grok API, confronto tra Grok 4.7 e 4.6: benchmark, prezzi, limiti e un test in tre attività per scegliere il modello giusto senza migrazioni alla cieca.21 set 2026AI
Agenti AI in produzione: quando le metriche premiano il fallimento
Un caso reale mostra come gli agenti AI possano superare ogni controllo e mancare l’obiettivo: numeri, cause e guardrail per fermare la deriva.21 set 2026AI
StepFun Step 5 Preview: prezzi API, piani e costi reali
Prezzi API, cache, Crediti e piani di StepFun Step 5 Preview: tariffe verificate, esempi di costo e criteri per scegliere il canale corretto.21 set 2026AI