GPT-6のprompt cachingを安定させる設計と診断
GPT-6のprompt cachingを実運用で効かせるために、安定したプレフィックス設計、キャッシュヒットの診断、明示的ブレークポイントの使い分けを解説します。GPT-6 Solの実測値から、ツール変更でコストが跳ねる理由、設定更新でキャッシュを維持する方法、CIで回帰を検知する手順まで整理します。



GPT-6エージェントのコストを抑える鍵は、毎回のリクエスト先頭に置く指示、ツール、コンテキストを一字一句変えないことです。GPT-6 Solで実際に検証したところ、同一リクエストでは1,980トークンがキャッシュから再利用され、コストは$0.000452でした。ツール名を1つ変えただけでプレフィックスが再び書き込まれ、$0.0050085まで上昇しました。9月22日に追加されたダッシュボードと診断機能を使えば、prompt cachingの差が本番コストに表れる前に把握できます。
prompt cachingの鉄則:固定要素を先に、変動要素を後に
Prompt cachingは、リクエスト冒頭にある変更されていないプレフィックスについて、モデルが処理済みの状態を保存する仕組みです。作業場を翌朝まで片付けずに残しておく場面を想像すると分かりやすいでしょう。手順書、ツール棚、組み立て途中の部品がそのままなら、次の担当者は作業場を一から準備せず、続きから始められます。
OpenAIが保存するのはプロンプトのコピーではなく、モデルの作業状態にあたるkey-valueテンソルです。キャッシュの対象は、OpenAIの指示、開発者メッセージ、ツール定義、会話履歴を含む、レンダリング後のコンテキスト全体です。後続リクエストが処理を再利用できるのは、レンダリングされたプレフィックスに最初の意味のある差分が現れる直前までです。
つまり、リクエスト内の並び順がそのままコストを左右します。変わらないポリシー、参照資料、例、ツール定義は先に置き、タイムスタンプ、リクエストID、顧客情報、今回のタスクは後ろに置きます。冒頭付近を1行編集するだけで、それ以降がすべて無効になる可能性があります。
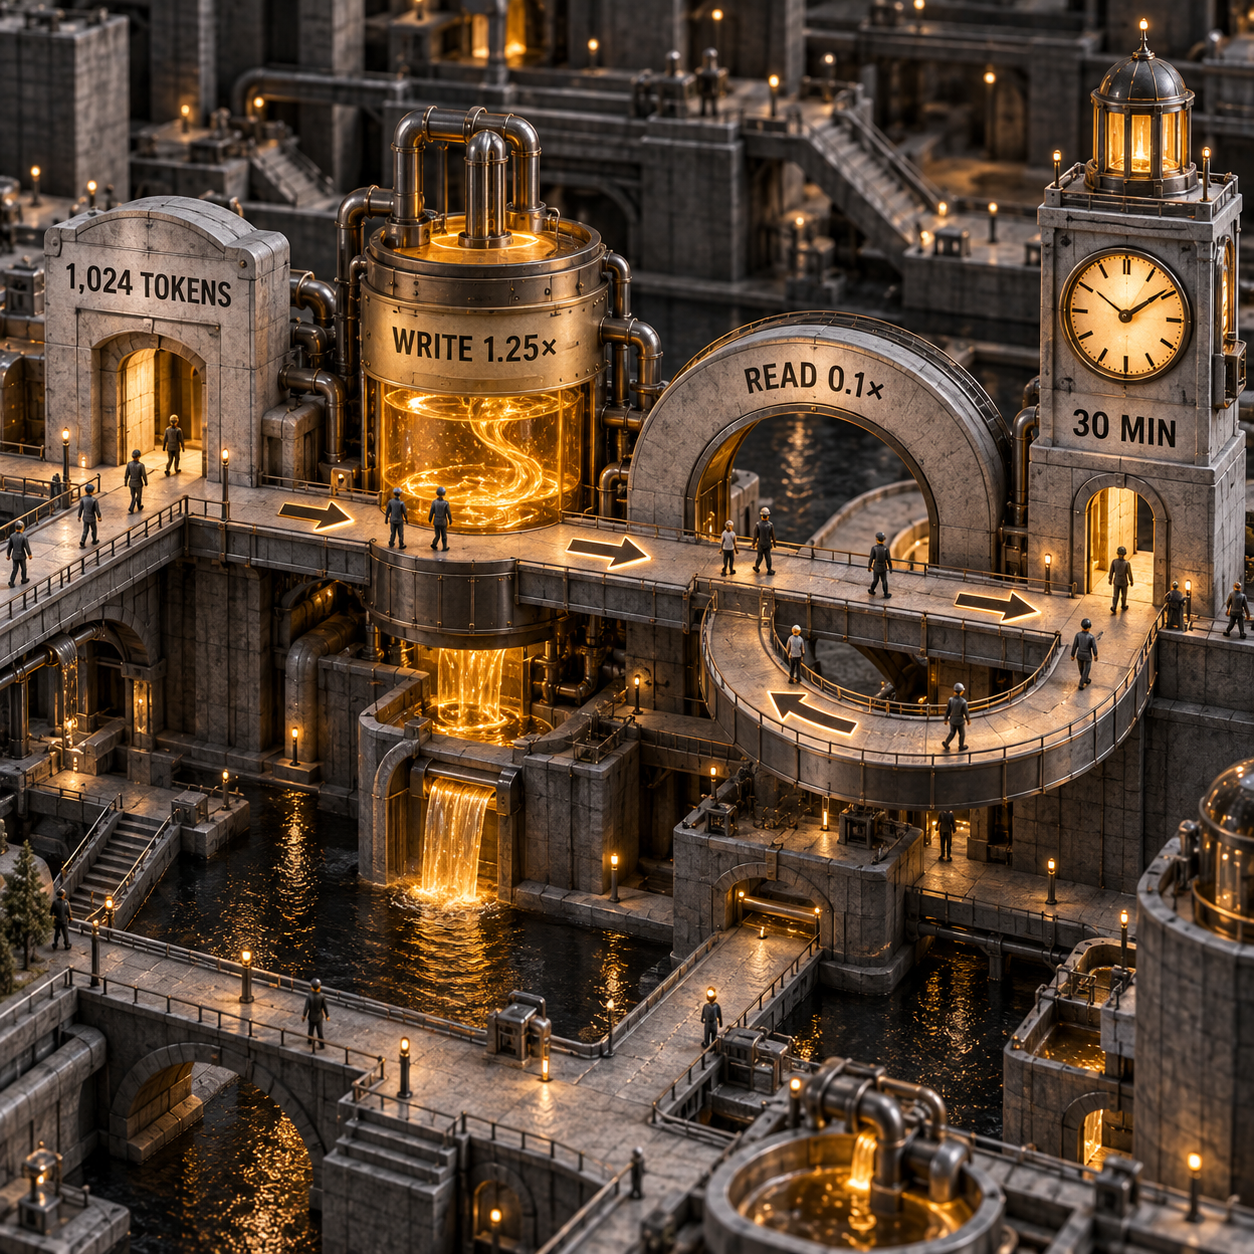
Prompt cachingは、対応モデルですでに有効です。GPT-5.6以降では、表示される入力が1,024トークンに達するとプレフィックスが対象になります。最初の対象リクエストは通常入力料金の1.25倍でプレフィックスを書き込み、一致する後続リクエストは通常料金の0.1倍で読み出します。エントリは、最後に書き込むか再利用してから少なくとも30分間、再利用可能な状態を保ちます。
これは意味の近さではなく、プレフィックスの一致による再利用です。意味が同じポリシーでも冒頭付近の表現が違えば、別のキャッシュ入力として扱われます。ツールの名前、説明、JSONスキーマ、順序、モデル、出力形式、推論設定、詳細度のいずれかが変わった場合も同様です。
9月22日の変更点
今回重要なのは、キャッシュそのものより運用レイヤーの強化です。OpenAIの9月22日のリリースでは、Prompt Caching Dashboard、リクエスト比較診断、GPT-6の会話中にキャッシュを維持したまま推論量を変更する方法が追加されました。OpenAIは、GPT-6ファミリーの標準的なヒット率も改善したとしています。
ただし、これらの追加機能と、GPT-5.6にも適用される基本動作を混同してはいけません。現在のprompt cachingガイドでは、1,024トークンの最小値、1.25倍の書き込み料金、0.1倍の読み出し料金、暗黙および明示的なブレークポイント、30分のTTLがGPT-5.6以降に適用されます。
既存のGPT-6 SolとLunaの比較は、モデル選定のための記事です。キャッシュを検討するのは、その選定後です。安価なモデルでも高価なモデルでも、プレフィックスが安定していれば、モデル間の相対的なトレードオフは変わりません。
まずは自動キャッシュから始める
最初に選ぶべきなのは自動キャッシュです。プロンプトを大きく組み替えなくても、比較の基準となるデータを得られます。実際のリクエストを有効期間内に2回送り、キャッシュに影響するすべてのフィールドを固定したうえで、2回目のレスポンスを確認します。
課金を判断するフィールドは、usage.input_tokens_details.cached_tokensとcache_write_tokensです。cached_tokensが多ければ、処理済み入力が再利用されています。cache_write_tokensが多ければ、新しいキャッシュ状態の作成に料金が発生しています。通常の入力トークン数は、入力全体からこの2種類を差し引いた値です。
新しい診断フローでは、トークン数だけでなく原因も確認できます。
- 同じorganizationで直近に完了したresponse IDを保存します。
- 現在のリクエストの
prompt_cache_options.comparison_response_idにそのIDを指定します。 - レスポンスの
prompt_cache_diagnosticsを読みます。 - 課金の確認には診断上の推定値ではなく、usageフィールドを使います。
Responses APIを直接利用すると、cache_hit、cache_miss、comparison_response_not_found、unavailableのいずれかが返ることがあります。変更されたツール定義は、診断システムが特定できた場合にtools_changedと分類されます。診断はベストエフォートで、最初に分類できた原因だけを示します。その原因を修正してから、もう一度比較してください。
以下は、Responses APIを直接試すための簡潔なテストスクリプトです。ポリシーファイルには、1,024トークンの最小値を超えるだけの、有用で固定された内容が必要です。
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
比較には直近のベースラインを使います。診断レコードは短期間で期限切れになります。また、比較用のresponse IDが要求するのは説明だけです。過去の会話を読み込むことも、それ自体でキャッシュヒットを起こすこともありません。
意図的にキャッシュヒットを壊してみる
実測では、GPT-6 Sol、1,635語の架空のサポートポリシー、1つの関数ツール、短いタスクReply with exactly OK.を使用しました。どのリクエストでも、モデルの返答はOKです。変更したのは、キャッシュに影響する構造だけでした。
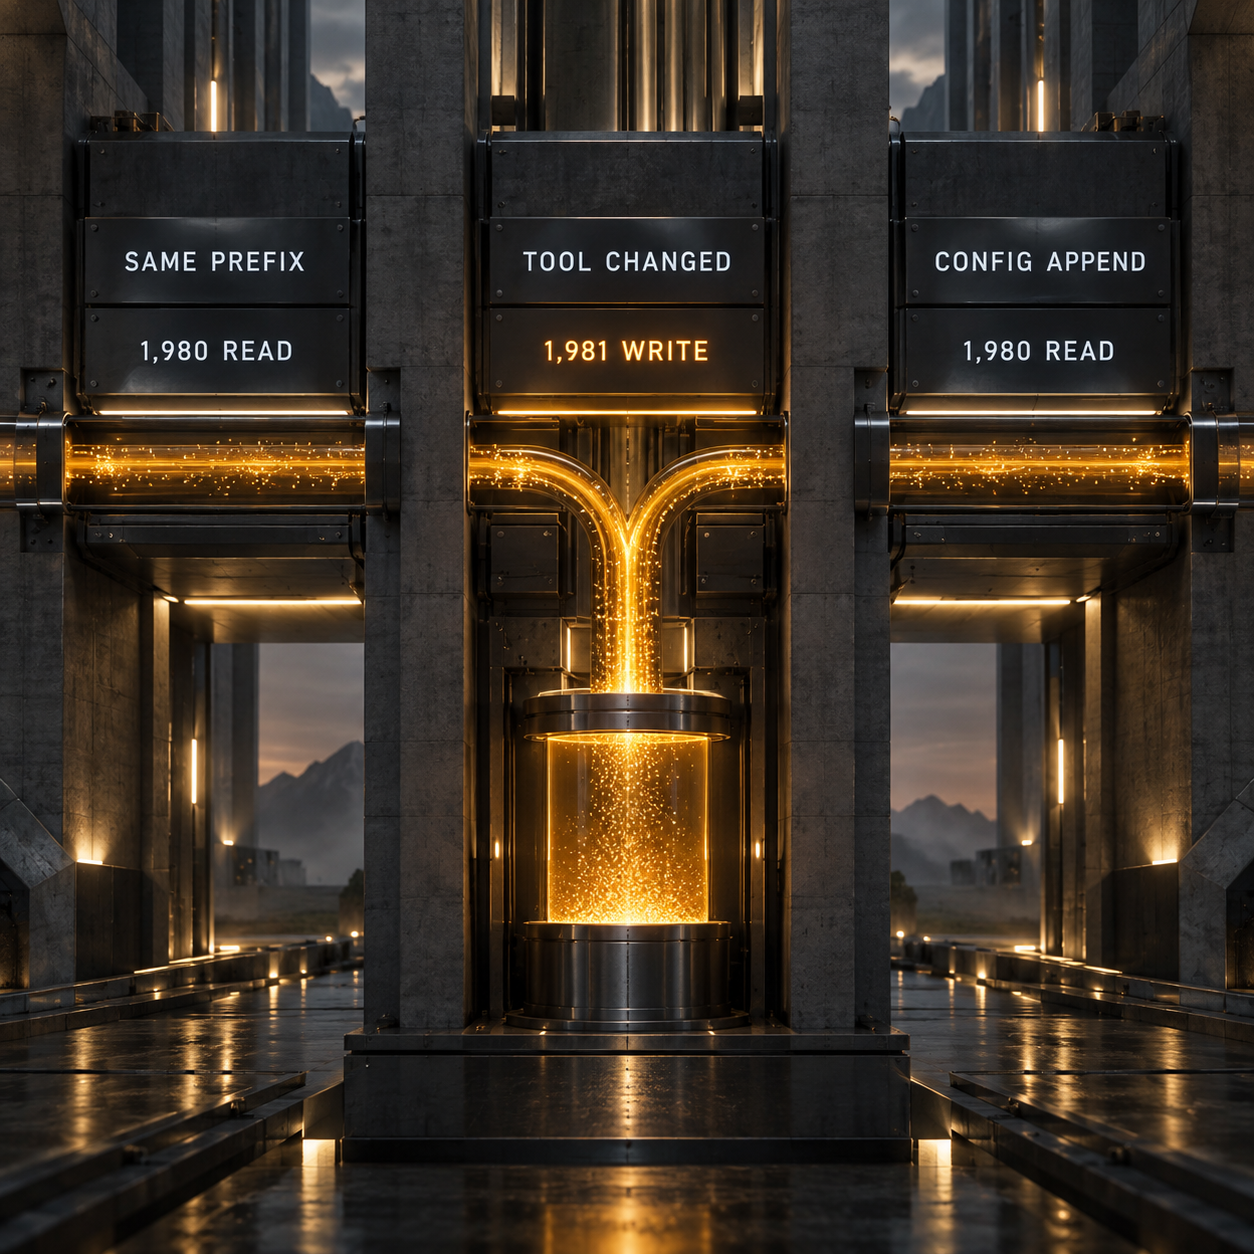
コストの計算には、現在のGPT-6 Sol Standardにおける短いコンテキストの料金を使っています。通常入力は100万トークンあたり$2、キャッシュ済み入力は$0.20、キャッシュ書き込みは$2.50、出力は$10です。各レスポンスの出力は5トークンでした。
出力を含めても、完全一致の再実行はベースラインのレスポンスより91.0%安くなりました。同じトークン構成の10ステップのエージェントでは、1回の書き込みと9回の読み出しで約$0.009074です。10回とも新規書き込みなら約$0.05006かかります。この架空ワークロードでは、プレフィックスを固定することで完了ステップあたりのコストを81.9%削減できました。
判断に使うべきなのは、この指標です。キャッシュヒット率が良好に見えても、長いコンテキストを使う少数の高額なターンが再書き込みを続けていることがあります。完了したタスク全体について、実際の各トークンクラスとコストを合計し、採用された結果、再試行、ツール料金まで比較します。
この経過時間からレイテンシーについて結論を出すことはできません。4回の呼び出しは892〜1,254ミリ秒の範囲で、キャッシュを再利用したリクエストが最速でもありませんでした。これほど小さなサンプルでは、ネットワークやルーティングのノイズが支配的です。コスト差は明確ですが、レイテンシーの評価には、反復測定と最初のトークンが届くまでの時間が必要です。
検証中には、実務上重要な連携不具合も1つ見つかりました。Vercel AI Gatewayはprompt_cache_optionsを転送し、OpenAIプロバイダーのresponse IDを返し、キャッシュの読み書きも報告しましたが、正規化後のレスポンスからprompt_cache_diagnosticsが欠落していました。それでも、キャッシュ済みトークンが0、書き込みが1,981トークンだったため、意図的なミスは明白でした。アプリとOpenAIの間にSDKやゲートウェイを挟む場合は、本番で新しい診断フィールドに依存する前に、そのフィールドが公開されるか確認してください。
ブレークポイントを増やす前にプレフィックスを直す
キャッシュミスの多くは、日常的なリクエストの組み立て方に原因があります。まず、そこから修正します。
- ツールの名前、説明、スキーマ、設定、順序を変えないでください。ツールを実行しない場合は
tool_choice: "none"、呼び出せるものを一部に絞る場合はallowed_toolsを使い、提供するツール一覧全体は維持します。 - 同じプレフィックスを共有させるリクエストでは、モデル、サービス階層、テキストスキーマ、リクエスト単位の推論量、詳細度を固定します。
- タイムスタンプ、ユーザーID、トレースID、タスクごとのデータは、固定された指示と参照情報の後ろへ移します。
- メッセージとツール結果は末尾に追加します。過去の会話を書き換えたり要約したりすると、プレフィックスが変わります。
- 修正するたびに、意図したベースラインと比較します。診断が示すのは、最初に分類された差分だけです。
GPT-6で推論量を変えるときは、トップレベル設定を変更せず、会話アイテムを使います。以下のリクエストは、トップレベルのlowを維持しながら、追加質問にhighを適用します。
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
設定更新は、Standardのシングルエージェントモードで動くGPT-6ファミリーに対応し、変更できるのは推論量だけです。2つの更新を隣り合わせに置かないでください。また、自動コンパクションや自動切り詰めと併用することもできません。
Responses API移行ガイドでは、状態管理に関する、より広い判断を扱っています。キャッシュに限れば要点は単純です。過去のアイテムはそのまま保ち、変更を末尾に追加します。
明示的ブレークポイントは効果が見込める場所だけに置く
固定されたコアの後ろに、頻繁に変わるためキャッシュ書き込みに値しないサフィックスが続く場合は、明示的ブレークポイントが役立ちます。固定指示を開発者メッセージ内のinput_textブロックに置き、そのブロックへprompt_cache_breakpoint: {"mode":"explicit"}を追加し、prompt_cache_options.modeをexplicitに設定します。
トップレベルのinstructionsには、明示的ブレークポイントを設定できません。explicit modeで明示的なマーカーがないリクエストは、キャッシュへ書き込みません。キャッシュ書き込みは通常入力より25%高く、後続リクエストで読み出して初めて元を取れるため、1回限りのプロンプトでは、書き込まないことが適切な場合があります。
1つのリクエストで作成できるキャッシュ書き込みは最大4つです。すべてのメッセージに枠を使うのではなく、アプリケーションが実際に分岐する地点を選びます。たとえば、全社共通ポリシー、ワークスペースのコンテキスト、会話の分岐、そして必要なら固定された評価基準です。
プリウォームは、レイテンシーを改善するための別の手段です。prompt_cache_options.prewarm: trueを指定したリクエストで既知のコンテキストを出力生成なしに準備し、その後のユーザーリクエストで同じプレフィックスを送ります。プリウォームの呼び出しには通常のキャッシュ書き込み料金が発生します。予測可能なトラフィックにだけ使い、最初のトークンが届くまでの時間を測定してください。
prompt cachingの効果が高い7つのワークフロー
1. コーディングエージェント基盤
コーディングエージェントは、リポジトリマップ、開発者向けルール、ツールスキーマ、過去のターンを繰り返し送ります。これらのブロックを固定し、ファイル変更とツール結果を末尾に加え、共有履歴からバックグラウンドタスクを分岐させます。長いセッションを通じてコンテキストコストが下がることが利点です。ツール名が1つ変わるだけで節約効果が消えるため、この用途ではCIのキャッシュ回帰テストが特に有効です。
2. カスタマーサポートエージェント
サポートチームでは、長いポリシーマニュアル、商品カタログのルール、固定されたエスカレーションツールを使うことがあります。共通資料を先に置き、現在の問い合わせを後ろに追加します。今回計測した架空のポリシーは、このパターンです。同じリクエスト構成なら、短いレスポンスを10回完了するコストは、毎回書き込む約$0.05006から、1回の書き込みと9回の読み出しによる$0.009074へ下がりました。
3. 評価・品質管理チーム
評価担当は、採点基準、ラベル付きの例、出力スキーマ、ツール定義を再利用し、最後に置く評価対象のやり取りだけを変更できます。explicit modeなら、変化する対象への書き込み料金を避けられます。キャッシュを見えない基盤機能ではなく、評価の採算性を左右する要素として管理できるようになります。
4. リサーチ・デューデリジェンスエージェント
リサーチのワークフローでは、検証済みの資料一式と分析ルールを固定し、新しい質問を末尾に追加できます。同じ根拠資料から複数の担当エージェントが分岐し、別々の成果物を作るほど、分岐後の要約、矛盾チェック、メモの各セクションで共有プレフィックスを使う効果が高まります。
5. 契約・コンプライアンスレビュー
法務オペレーションチームなら、条項ライブラリ、リスク評価基準、承認済み文言、レビューツールを、審査対象の契約書より前に置けます。新しい文書が変動サフィックスになります。キャッシュによって判断の安全性が高まるわけではありませんが、同じ統制情報を読み込む反復コストは減らせます。
6. マルチエージェント運用
オーケストレーターは、共通の計画、ワークスペースの状態、ツール履歴を保ったまま、専門エージェントへ分岐できます。共有プレフィックスが大きいほど、キャッシュ再利用によって分岐のコストが下がります。ツール定義は固定し、アプリケーションが対応していれば、新しく見つかったツールを追記専用の履歴として追加します。
7. 予測可能な対話型ローンチ
参照資料があらかじめ分かっているプロダクトは、最初のユーザーリクエストより前に、起動時のプリウォームを実行できます。プレフィックス処理をユーザーの待ち時間の外へ移せます。ただし、エントリを再利用できる時間内にトラフィックが到着し、十分な反復テストでもレイテンシー改善が確認できる場合に限って有効です。
プロダクト化する価値がある3つの案
1. 最有力はCache Regression CI
代表的なエージェントリクエストを再実行し、各レスポンスを保存済みのベースラインと比べ、キャッシュ済みトークンの減少や書き込みの急増があればpull requestを失敗させるテストゲートを作ります。一見無害なツールスキーマの変更で、本番のすべてのターンが新規書き込みに変わり得るため、エージェント基盤のチームには導入する理由があります。
需要は、対応可能な規模でありながら無視できない大きさです。米国ではprompt cachingが月間約1,300件、openai prompt cachingが320件検索され、GPT-6の具体的な設定に関する検索では独立した解説記事が2件しか見つかりませんでした。Heliconeはアラートとレポートを備えたProプランを月額$79で提供しており、LLM監視に予算を割くチームがいることも分かります。
販売可能な最小構成は、CLI、GitHubチェック、そしてベースラインのresponse ID、診断理由、キャッシュ済みトークン、書き込みトークン、経過時間、計算コストをまとめた1つのレポートです。課題は、OpenAI自身もダッシュボードと診断機能を提供していることです。導入価値を生むには、デプロイのゲート、プロバイダー横断の対応、コード単位の原因特定のいずれかが必要です。
2. キャッシュ対応のコスト配賦ツール
通常入力、キャッシュ読み出し、キャッシュ書き込み、出力、ツール料金を分け、AIプロダクトの顧客別コスト台帳を作ります。複数顧客が共通のエージェントプレフィックスを使いながら、プロダクト側ではワークスペース単位で説明できる粗利を求められるとき、財務チームと基盤チームには導入する理由があります。
米国ではopenai api prompt cachingが月間約50件検索され、実際のPeople Also Askには「Should I use prompt caching?」と「When not to use caching?」が含まれています。Langfuseの本番向けクラウドプランは月額$29と$199で、トークンとコストの追跡には、すでにソフトウェア予算があることを示す別の事例です。
MVPは、SDKラッパー、料金表、テナントタグ、完了タスク画面で構成できます。正直な課題はコストの帰属です。GPT-5.6以降では、ルーティングのためにprompt_cache_keyを使う必要がなく、個別のキーは主に会計目的で存在します。テナントの境界が曖昧だと、請求やプライバシーへの懸念を招く可能性があります。
3. アダプター適合性モニター
SDK、プロキシ、モデルゲートウェイが、Responsesの新しいフィールドを正しく転送し、そのまま返すか検証するテストスイートを作ります。依存関係をアップグレードするたびに、comparison_response_id、診断の種類、キャッシュトークンの詳細、設定更新、明示的ブレークポイント、プロバイダーのresponse IDをテストします。
需要を示すのは、理解不足を埋めたいという検索です。米国ではwhat is prompt cachingが月間約480件、how does prompt caching workが140件検索され、「How do I turn on prompt caching?」も実際のPeople Also Askに表示されます。今回の実測でも、ゲートウェイがusageを維持しながら診断オブジェクトを落とすという具体的な不具合が見つかりました。
MVPは、ホスト型の互換性マトリクスと、顧客のエンドポイントに対して5件の架空リクエストを実行するコマンドです。課題は持続性です。ゲートウェイベンダーはいずれフィールドを追加するため、1回限りのGPT-6チェッカーではなく、プロバイダーを横断した継続的なプロトコルテストが必要です。
限界と率直な評価
Prompt cachingは、長いプレフィックスを繰り返し使うときに設計する価値があります。リクエストが短い、毎回異なる、または冒頭付近が絶えず書き換わる場合は、適した最適化対象ではありません。
1,024トークンという下限は重要です。対象にするためだけに短いプロンプトを水増しすると、かえってコストが上がり得ます。有用で固定された例や参照資料なら、トークン追加を正当化できるかもしれません。しかし判断材料は、キャッシュヒットを表示させたいという願望ではなく、再利用回数と品質です。
キャッシュ状態には物理的な制約もあります。エントリは個々のマシンに置かれ、トラフィックが毎分約15リクエストを超えると、別のマシンへあふれることがあります。アプリケーション側の内容が同じに見えても、ルーティングと負荷によってミスが起こり得ます。キャッシュヒットは最適化の結果であり、正しさを保証するものではありません。
キャッシュ済み入力も1分あたりのトークン数制限に算入されます。キャッシュを手動で消去することはできません。再利用しても出力生成は変わらないため、同じリクエストから異なる回答が返る場合があります。GPT-6 Solでは、入力が272,000トークンを超えると、リクエスト全体に高い長文コンテキスト料金が適用されます。
運用上もっとも重要な原則は単純です。採用されたタスクごとのコストを追い、プレフィックスを固定し、書き込みの急増はすべて原因究明が必要なインシデントとして扱います。
次の月曜日に試すこと
次の月曜日に、本番エージェントのエンドポイントを1つ選びます。代表的なresponse IDを保存し、完了済みの同じタスクを再実行して、キャッシュ済みトークン、書き込みトークン、経過時間、出力トークン、総コストを記録します。次に、ツールの説明または名前を1つ変え、同じベースラインと比較します。ツール一覧を元に戻してから再実行し、採用率を損なわずに完了タスクのコストが下がったなら、プロンプトの変更やブレークポイントの追加より先に、そのテストをそのままCIへ組み込みます。
よくある質問
prompt cachingを有効にするには?
通常は、有効化の操作は必要ありません。対応するOpenAIモデルでは、prompt cachingが標準で有効です。GPT-5.6以降のリクエスト冒頭で、表示される1,024トークン以上を固定し、有効期間内に一致するリクエストを送ってcached_tokensを確認します。ブレークポイントを意図的に制御したい場合にだけ、prompt_cache_options.modeを使います。
prompt cachingとは何ですか? どのように動きますか?
完全に一致するプロンプトのプレフィックスについて、モデルが処理したkey-value状態を保存する仕組みです。最初の対象リクエストがその状態を書き込み、後続の一致するリクエストは同じプレフィックスを再処理せずに読み出せます。新しいサフィックスの内容と出力生成には、引き続き処理が必要です。
キャッシュを使わないほうがよいのはどんな場合ですか?
プロンプトが最小値を下回る、ほとんど繰り返さない、冒頭付近が変わる、または次のリクエストより前に期限切れになる場合は、キャッシュ向けの最適化を避けます。explicit modeでブレークポイントを指定しなければ、再利用する見込みのないプレフィックスに1.25倍の書き込み料金を払わずに済みます。
prompt cachingを使うべきですか?
反復入力が完了タスクのコストに占める割合が大きいなら、使う価値があります。実際のツールと採用条件を使い、1回の書き込みと複数回の読み出しを測定してください。ヒット率が高くても、採用されたタスクごとの総コストが下がらなければ意味はありません。
最適なキャッシュ戦略は何ですか?
まず自動のimplicit cachingから始めます。固定内容を先に、変動内容を後ろに置き、ツールとリクエスト設定を固定してミスを診断します。明示的ブレークポイントを追加するのは、無駄な書き込みを生む変動サフィックスの手前に、十分な回数再利用される固定ブロックがある場合だけです。
この計測と回帰防止の仕組みをエージェント基盤へ組み込みたい場合は、AI本番システムが最適な相談窓口です。
- 最終更新
- 2026年9月27日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。
Copilot Studio 料金でわかるManaged Runtimeの費用構造
Copilot Studio 料金を起点に、Copilot Managed Runtimeの構築、起動、API呼び出し、ホスティング、AIサービス、ライセンスを分けて試算します。Power Apps Premium、従量課金、容量パック、P3の損益分岐点と、公開資料だけでは確定できない費用まで整理しました。2026年9月26日Build
n8n AIエージェントはワークフローと何が違う?実測で選び方を検証
n8n AIエージェントと従来のワークフローを、同じサポート業務で実測比較。30回の実行、20件の完了、モデル呼び出し数、料金、セッション、承認機能を検証し、会話に判断を任せる場面と固定手順を残す場面、移行前に知るべきPreviewの制約、本番での安全な設計までわかりやすく整理します。2026年9月26日Build
OpenRouter 料金を検証:Jev Routerは本当に無料なのか
OpenRouter 料金ページでJev Routerは$0と表示されていますが、選択モデルの推論まで含むセッション総額が無料とは限りません。usage.cost、生成ログ、Activityの照合方法と、$1以内の4リクエストで実コストを安全に確かめる手順を、公開情報と具体的な計算例から整理します。2026年9月26日Build
Claude プラグイン公開の実務ガイド:申請・審査・運用まで
Claude プラグインをGitHubから公開ディレクトリへ登録する流れを実務目線で解説。申請主体の決め方、plugin.jsonとREADMEの準備、ローカル検証、ポータル審査、MCPコネクタの別申請、公開後のアップデートと利用分析まで、つまずきやすい要点を順にわかりやすく整理します。2026年9月26日Build
Cloudflare Zero Trust 料金で検証:MCP Portalsは無料か
Cloudflare MCP PortalsのFreeはアクティブユーザー50人まで$0。60人ならCloudflare Oneのシート料金は月額$420です。課金を決めるのはツール呼び出し回数ではなくアクティブユーザー数。ログ保持、DLP、外部コスト、Pay-as-you-goへ移る判断基準を整理します。2026年9月26日Build
Agentic CUDA Optimizerで始める、検証可能なGPU高速化
Agentic CUDA Optimizerを固定コミットからセットアップし、CUDAカーネル探索を7回で区切る手順を解説。独自の参照実装と入力ケース、best.cuの監査、ホールドアウトでの再検証、モデルAPI・GPU時間・レビュー工数を含む採算判断まで、GPU高速化を本番へ持ち込む前に確認すべき要点をまとめます。2026年9月25日Build
Runpod 料金ガイド(2026年版):PodsとServerlessはどちらが得か
Runpod 料金をPods、Serverless、ストレージ別に整理。H100の実勢価格、100時間・730時間・リクエスト単位の試算、課金時間60.33%の損益分岐点を、2026年9月25日に確認した公式価格に基づいて比較します。GPUクラウドの構成選びと予算化に必要な判断基準も分かります。2026年9月25日Build