Prompt caching con GPT-6: diagnosi e risparmio sui costi
Scopri come stabilizzare i prefissi, leggere cache hit e miss e ridurre i costi API OpenAI con dashboard, diagnostica e breakpoint di GPT-6.



Con il prompt caching, un agente GPT-6 costa meno quando istruzioni, strumenti e contesto ripetuti restano identici all'inizio di ogni richiesta. In un test reale con GPT-6 Sol, una ripetizione esatta ha riutilizzato 1,980 token in cache, per un costo di $0.000452. È bastato cambiare il nome di uno strumento per riscrivere il prefisso e portare il costo a $0.0050085. La dashboard e la diagnostica del 22 settembre rendono visibile questa differenza prima che si trasformi in una voce pesante sulla fattura di produzione.
Prompt caching: prima i contenuti stabili, poi quelli variabili
Il prompt caching conserva lo stato già elaborato dal modello per un prefisso invariato, cioè per la parte iniziale della richiesta. È come lasciare un'officina pronta per il turno successivo: manuale operativo, attrezzi e assemblaggio incompleto rimangono al loro posto, evitando di riallestire tutto da zero.
OpenAI memorizza i tensori key-value, ossia lo stato operativo del modello, non una copia del prompt. La cache comprende l'intero contesto renderizzato: istruzioni OpenAI, messaggi developer, definizioni degli strumenti e cronologia della conversazione. Una richiesta successiva può riutilizzare questo lavoro solo fino alla prima differenza significativa nel prefisso renderizzato.
L'ordine dei contenuti diventa quindi una scelta di costo. All'inizio vanno policy stabili, materiali di riferimento, esempi e definizioni degli strumenti; più avanti timestamp, ID della richiesta, dati del cliente e attività corrente. Modificare una riga iniziale può invalidare tutto ciò che segue.
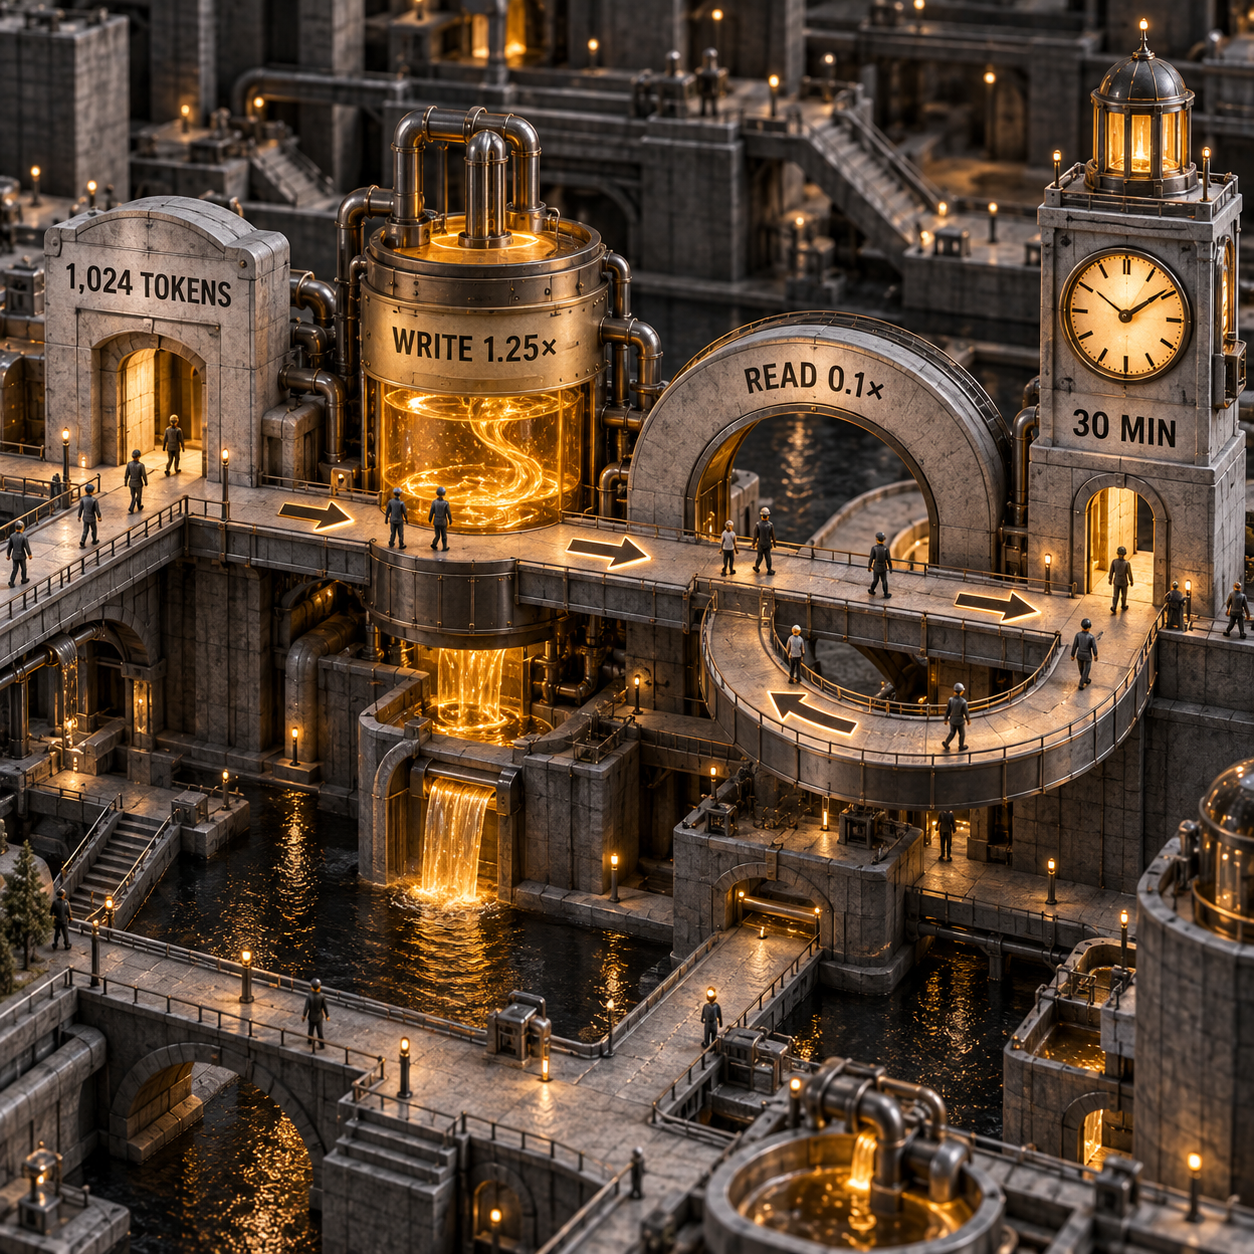
Il prompt caching è già attivo sui modelli supportati. Da GPT-5.6 in poi, un prefisso diventa idoneo a partire da 1,024 token di input visibili. La prima richiesta idonea scrive il prefisso a 1.25 volte la tariffa ordinaria dell'input; una richiesta corrispondente lo legge a 0.1 volte quella tariffa. La voce resta utilizzabile per almeno 30 minuti dall'ultima scrittura o dall'ultimo riutilizzo.
Si tratta di riutilizzare un prefisso, non di riconoscere una somiglianza semantica. Due policy dal significato equivalente ma diverse nelle prime righe producono input distinti per la cache. Lo stesso vale se cambiano nome, descrizione, schema JSON o ordine di uno strumento, oppure modello, formato di output, impostazione di reasoning o verbosity.
Le novità introdotte il 22 settembre
Il nuovo livello operativo conta più della cache in sé. La release OpenAI del 22 settembre ha aggiunto una dashboard per il prompt caching, la diagnostica comparativa delle richieste e un modo per variare il reasoning effort durante una conversazione GPT-6 senza perdere la cache. OpenAI dichiara inoltre un miglioramento degli hit rate predefiniti per la famiglia GPT-6.
Queste novità non vanno confuse con i meccanismi validi anche per GPT-5.6. La guida attuale al prompt caching applica a GPT-5.6 e versioni successive la soglia minima di 1,024 token, la tariffa di scrittura di 1.25×, quella di lettura di 0.1×, i breakpoint impliciti ed espliciti e il TTL di 30 minuti.
Il confronto già pubblicato tra GPT-6 Sol e Luna serve a scegliere il modello. Il caching viene dopo: il compromesso relativo tra un modello più economico e uno più costoso resta lo stesso anche quando entrambi usano prefissi stabili.
Iniziare dalla cache automatica
La cache automatica è il punto di partenza corretto: offre una baseline pulita quasi senza intervenire sui prompt. Basta inviare due volte la richiesta reale entro la finestra attiva, mantenere invariato ogni campo sensibile alla cache e controllare la seconda risposta.
I due campi che chiariscono l'addebito sono usage.input_tokens_details.cached_tokens e cache_write_tokens. Un valore elevato di cached_tokens indica che la richiesta ha riutilizzato input già elaborato; un valore elevato di cache_write_tokens segnala invece che ha pagato per creare nuovo stato in cache. I token di input ordinari corrispondono al totale dell'input meno questi due valori.
Il nuovo flusso diagnostico aggiunge la causa a questi conteggi:
- Salvare l'ID di una risposta completata di recente nella stessa organizzazione.
- Inserirlo in
prompt_cache_options.comparison_response_idnella richiesta corrente. - Leggere
prompt_cache_diagnosticsnella risposta. - Per la fatturazione, usare i campi di utilizzo e non le stime diagnostiche.
La Responses API diretta può restituire cache_hit, cache_miss, comparison_response_not_found o unavailable. Quando il sistema diagnostico riconosce la modifica alla definizione di uno strumento, la classifica come tools_changed. La diagnostica è best effort e mostra la prima causa che riesce a classificare: va quindi corretta quella causa e ripetuto il confronto.
Ecco uno script compatto per un test diretto via API. Il file della policy deve contenere abbastanza materiale stabile e utile da superare la soglia di 1,024 token.
from pathlib import Path
from openai import OpenAI

client = OpenAI()
policy = Path("support-policy.txt").read_text()
tool = {
    "type": "function",
    "name": "lookup_order",
    "description": "Look up a synthetic order by its test identifier.",
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
    "strict": True,
}

def run(tools, comparison_id=None):
    options = {"mode": "implicit", "ttl": "30m"}
    if comparison_id:
        options["comparison_response_id"] = comparison_id
    return client.responses.create(
        model="gpt-6-sol",
        reasoning={"effort": "low"},
        instructions=policy,
        input="Reply with exactly OK.",
        tools=tools,
        prompt_cache_options=options,
    )

baseline = run([tool])
hit = run([tool], baseline.id)
broken = run([{**tool, "name": "lookup_shipment"}], baseline.id)
print(hit.prompt_cache_diagnostics, hit.usage.input_tokens_details)
print(broken.prompt_cache_diagnostics, broken.usage.input_tokens_details)
Conviene usare una baseline recente. I record diagnostici scadono dopo poco tempo e l'ID di confronto serve soltanto a chiedere una spiegazione: da solo non carica la conversazione precedente e non genera un cache hit.
Un cache hit interrotto di proposito
Il test reale ha usato GPT-6 Sol, una policy di supporto sintetica da 1,635 parole, un function tool e la breve attività Reply with exactly OK.. Il modello ha restituito OK a ogni richiesta. È cambiata soltanto la struttura sensibile alla cache.
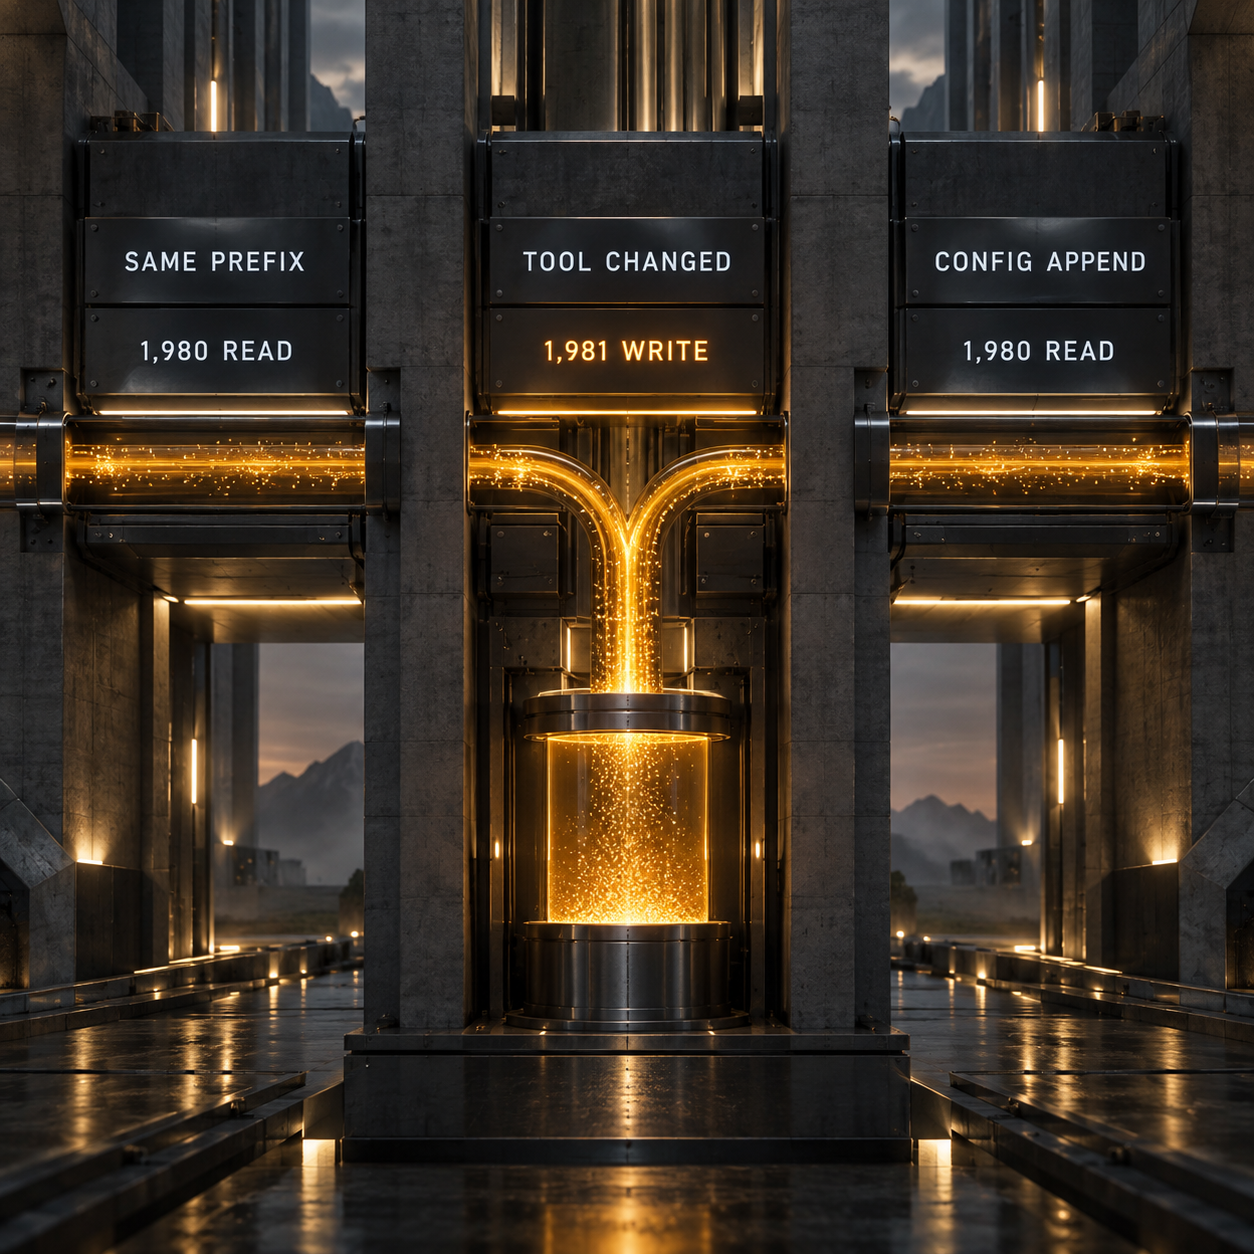
Il calcolo usa le tariffe correnti di GPT-6 Sol Standard per contesto breve: $2 per milione di token di input ordinari, $0.20 per milione di token di input in cache, $2.50 per milione di token di scrittura cache e $10 per milione di token di output. Ogni risposta ha utilizzato cinque token di output.
Includendo l'output, la ripetizione esatta è costata il 91.0% in meno rispetto alla risposta baseline. Per un agente di dieci passaggi con la stessa distribuzione di token, una scrittura seguita da nove letture costa circa $0.009074; dieci nuove scritture costano circa $0.05006. In questo carico sintetico, mantenere stabile il prefisso riduce dell'81.9% il costo per passaggio completato.
Questa è la metrica su cui decidere. Una percentuale di cache hit può sembrare ottima anche se pochi turni costosi e con contesto lungo continuano a riscrivere la cache. Occorre sommare le classi di token effettive e il costo delle attività completate, per poi confrontare risultati accettati, tentativi ripetuti e costi degli strumenti.
I tempi rilevati non consentono di sostenere un vantaggio di latenza. Le quattro chiamate sono durate da 892 a 1,254 millisecondi e la ripetizione in cache non è stata la più veloce. In un campione così piccolo, il rumore di rete e routing prevale. Il costo è cambiato in modo evidente; per valutare la latenza servono misurazioni ripetute e dati sul time to first token.
Il test ha fatto emergere anche un problema di integrazione utile. Vercel AI Gateway ha inoltrato prompt_cache_options, restituito l'ID della risposta del provider OpenAI e segnalato letture e scritture della cache, ma la risposta normalizzata ometteva prompt_cache_diagnostics. Il miss provocato intenzionalmente restava evidente: zero token in cache e 1,981 token scritti. Se tra l'applicazione e OpenAI c'è un SDK o un gateway, prima di affidarsi al nuovo campo diagnostico in produzione bisogna verificare che venga esposto.
Sistemare il prefisso prima di aggiungere breakpoint
La maggior parte dei miss nasce da normali scelte nella costruzione della richiesta. È da lì che conviene cominciare:
- Mantenere invariati nomi, descrizioni, schemi, configurazione e ordine degli strumenti. Quando nessuno strumento deve essere eseguito, usare
tool_choice: "none"; se deve essere disponibile soltanto un sottoinsieme, usareallowed_tools, conservando comunque l'elenco completo degli strumenti forniti. - Mantenere stabili modello, service tier, schema testuale, reasoning effort a livello di richiesta e verbosity per le richieste che dovrebbero condividere un prefisso.
- Spostare timestamp, ID utente, trace ID e dati specifici dell'attività dopo istruzioni e riferimenti stabili.
- Aggiungere in coda messaggi e risultati degli strumenti. Riscrivere o riassumere contenuti precedenti della conversazione cambia il prefisso.
- Dopo ogni correzione, confrontare la richiesta con la baseline prevista. La diagnostica segnala soltanto la prima differenza classificata.
Con GPT-6, il livello di effort va modificato tramite un elemento della conversazione, non intervenendo sull'impostazione top-level. La richiesta seguente mantiene low a livello top-level e applica poi high al follow-up.
follow_up = client.responses.create(
    model="gpt-6-sol",
    previous_response_id=baseline.id,
    reasoning={"effort": "low"},
    tools=[tool],
    input=[
        {"type": "configuration_update", "reasoning": {"effort": "high"}},
        {"role": "user", "content": "Analyze the difficult exception."},
    ],
    prompt_cache_options={"comparison_response_id": baseline.id},
)
Gli aggiornamenti di configurazione funzionano per la famiglia GPT-6 in modalità standard e single-agent e modificano soltanto il reasoning effort. Non vanno inseriti due aggiornamenti consecutivi. Inoltre non sono compatibili con compaction automatica o truncation automatica.
La guida alla migrazione verso Responses API affronta la più ampia scelta relativa allo stato. Per il caching, il concetto è più semplice: lasciare gli elementi precedenti al loro posto e aggiungere la modifica in coda.
Aggiungere breakpoint espliciti solo quando conviene
Un breakpoint esplicito serve quando la richiesta contiene un nucleo stabile seguito da un suffisso che cambia troppo spesso per giustificare una scrittura in cache. Le istruzioni stabili vanno inserite in un blocco input_text dentro un messaggio developer; a quel blocco si aggiunge prompt_cache_breakpoint: {"mode":"explicit"}, impostando poi prompt_cache_options.mode su explicit.
Le instructions top-level non possono contenere un breakpoint esplicito. In modalità esplicita, una richiesta priva di marker non esegue alcuna scrittura in cache. Per un prompt usato una volta sola può essere la scelta giusta: una scrittura costa il 25% in più dell'input ordinario e si ripaga solo se una richiesta successiva la legge.
Una singola richiesta può creare fino a quattro scritture in cache. Non conviene usare tutti gli slot per ogni messaggio. I confini devono rispecchiare le vere diramazioni dell'applicazione: una policy aziendale condivisa, il contesto di un workspace, un fork della conversazione ed eventualmente una rubrica di valutazione stabile.
Il prewarming è uno strumento distinto, pensato per la latenza. Una richiesta con prompt_cache_options.prewarm: true prepara il contesto noto senza generare output; in seguito, la richiesta dell'utente invia lo stesso prefisso. La chiamata di prewarm viene fatturata alla normale tariffa di scrittura cache: va riservata a traffico prevedibile e valutata misurando il time to first token.
I sette workflow che ne traggono più vantaggio
1. Piattaforme per coding agent
Un coding agent invia ripetutamente mappe del repository, regole developer, schemi degli strumenti e turni precedenti. Questi blocchi vanno mantenuti stabili, aggiungendo in coda modifiche ai file e risultati degli strumenti; le attività in background possono derivare dalla cronologia condivisa. Il risultato è un costo di contesto più basso nelle sessioni lunghe. Basta rinominare uno strumento per perdere il risparmio: per questo tali piattaforme sono le prime a beneficiare di un test CI sulle regressioni della cache.
2. Agenti di assistenza clienti
Un team di supporto può avere un lungo manuale operativo, regole sul catalogo prodotti e strumenti di escalation fissi. Il materiale condiviso va all'inizio, il ticket corrente alla fine. Il test con la policy sintetica riproduce proprio questo schema. A parità di struttura della richiesta, dieci brevi risposte completate sono passate da circa $0.05006 con scritture ripetute a $0.009074 con una scrittura e nove letture.
3. Team di valutazione e qualità
Un evaluator può riutilizzare una rubrica di valutazione, esempi etichettati, schema di output e definizioni degli strumenti, cambiando soltanto l'interazione candidata in fondo. La modalità esplicita permette di non addebitare una scrittura al candidato variabile. In questo modo la cache entra nell'economia unitaria delle valutazioni, invece di restare un dettaglio invisibile della piattaforma.
4. Agenti di ricerca e due diligence
Un workflow di ricerca può mantenere stabili un pacchetto di fonti già verificate e le regole di analisi, aggiungendo nuove domande. Riassunti derivati, controlli delle contraddizioni e sezioni di un memo possono condividere lo stesso prefisso. Il vantaggio cresce quando più worker partono dalle medesime evidenze per produrre deliverable differenti.
5. Revisione contrattuale e compliance
Un team legal operations può collocare la libreria di clausole, la rubrica dei rischi, il linguaggio approvato e gli strumenti di revisione prima del contratto da esaminare. Ogni nuovo documento diventa il suffisso variabile. La cache non rende più sicuro il giudizio, ma può ridurre il costo ripetuto necessario a caricare gli stessi controlli.
6. Operazioni multi-agent
Un orchestrator può conservare un piano comune, lo stato del workspace e la cronologia degli strumenti prima di diramare il lavoro verso agenti specialisti. Il riutilizzo della cache riduce il costo dei fork quando il prefisso condiviso è ampio. Le definizioni degli strumenti devono restare stabili; se l'applicazione lo supporta, i nuovi strumenti scoperti vanno aggiunti tramite una cronologia append-only.
7. Lanci interattivi prevedibili
Un prodotto con materiale di riferimento noto può eseguire il prewarm all'avvio, prima della prima richiesta dell'utente. L'elaborazione del prefisso viene così spostata fuori dall'attesa dell'utente. È utile soltanto se il traffico arriva abbastanza presto da riutilizzare la voce e se il guadagno di latenza resiste a un test ripetuto correttamente.
Tre prodotti che vale la pena costruire
1. Cache Regression CI, l'opportunità più solida
Si può creare un gate di test che riproduce richieste rappresentative degli agenti, confronta ogni risposta con una baseline salvata e blocca una pull request quando i token in cache diminuiscono o quelli di scrittura aumentano. I team che sviluppano piattaforme per agenti hanno un motivo concreto per pagarlo: una modifica apparentemente innocua allo schema di uno strumento può trasformare ogni turno in produzione in una nuova scrittura.
La domanda è abbastanza circoscritta da poter essere servita e abbastanza ampia da risultare interessante: prompt caching registra circa 1,300 ricerche mensili negli Stati Uniti, openai prompt caching ne registra 320 e la query esatta sulla configurazione di GPT-6 ha restituito soltanto due guide scritte indipendenti. Helicone chiede già $79 al mese per un piano Pro con avvisi e report, segno che i team assegnano un budget al monitoraggio degli LLM.
La versione minima vendibile comprende una CLI, un controllo GitHub e un unico report con ID della risposta baseline, motivo diagnostico, token in cache, token scritti, tempo trascorso e costo calcolato. Il limite è rappresentato dalla dashboard e dalla diagnostica offerte direttamente da OpenAI: per meritarsi un posto nello stack, il prodotto deve fornire un gate di deployment, copertura cross-provider o attribuzione a livello di codice.
2. Un sistema di attribuzione dei costi consapevole della cache
Si può costruire un registro dei costi per cliente destinato ai prodotti AI, separando input ordinario, letture e scritture della cache, output e costi degli strumenti. I team finance e platform sono disposti a pagare quando molti clienti condividono il prefisso di un agente, ma il prodotto deve comunque dimostrare margini attendibili per ogni workspace.
Circa 50 ricerche mensili negli Stati Uniti riguardano openai api prompt caching, mentre tra le domande People Also Ask rilevate compaiono “Should I use prompt caching?” e “When not to use caching?”. Langfuse propone piani cloud di produzione da $29 e $199 al mese: un'altra indicazione del fatto che il monitoraggio di token e costi dispone già di un budget software.
L'MVP è composto da un wrapper SDK, una tabella dei prezzi, tag per tenant e una vista per attività completata. Il vero punto critico è l'attribuzione. Da GPT-5.6 in poi, prompt_cache_key non serve per il routing e le chiavi separate esistono soprattutto a fini contabili. Confini poco chiari tra tenant possono produrre fatture difficili da interpretare o problemi di privacy.
3. Un monitor di conformità per gli adapter
Si può realizzare una suite di test che verifichi se un SDK, un proxy o un model gateway inoltra i nuovi campi di Responses e li restituisce senza alterazioni. Dopo ogni aggiornamento delle dipendenze, il sistema controllerà comparison_response_id, tipi diagnostici, dettagli sui token della cache, aggiornamenti di configurazione, breakpoint espliciti e ID delle risposte del provider.
Il segnale di domanda arriva dal divario di conoscenze: what is prompt caching registra circa 480 ricerche mensili negli Stati Uniti, how does prompt caching work ne registra 140 e tra le domande People Also Ask rilevate compare “How do I turn on prompt caching?”. Il test diretto ha inoltre evidenziato un problema concreto: il gateway conservava i dati di utilizzo ma ometteva l'oggetto diagnostico.
L'MVP è una matrice di compatibilità in hosting, accompagnata da un comando che esegue cinque richieste sintetiche sull'endpoint del cliente. Il limite è la durata nel tempo: i fornitori di gateway aggiungeranno i nuovi campi, quindi il prodotto deve offrire test continui del protocollo su più provider, non un controllo una tantum dedicato a GPT-6.
Limiti e valutazione realistica
Progettare intorno al prompt caching ha senso quando si ripete un prefisso lungo. È invece un obiettivo sbagliato per richieste brevi, uniche o riscritte di continuo nella parte iniziale.
La soglia di 1,024 token conta. Aggiungere contenuto inutile a un prompt breve soltanto per renderlo idoneo può aumentare il costo. Esempi stabili e utili o materiali di riferimento possono giustificare quei token in più, ma la scelta dipende dal numero di riutilizzi e dalla qualità, non dal desiderio di vedere un cache hit.
Lo stato della cache ha anche una collocazione fisica. Le voci risiedono su singole macchine e, oltre circa 15 richieste al minuto, il traffico può essere distribuito su altre macchine. Routing e carico possono quindi causare miss anche quando il contenuto dell'applicazione sembra stabile. Un cache hit è un risultato di ottimizzazione, non una garanzia di correttezza.
Gli input memorizzati continuano a concorrere ai limiti di token per minuto. La cache non può essere svuotata manualmente. Il riutilizzo non modifica la generazione dell'output, quindi richieste identiche possono comunque produrre risposte diverse. Con GPT-6 Sol, una richiesta superiore a 272,000 token di input sposta inoltre l'intera richiesta sulle tariffe maggiorate del contesto lungo.
La regola operativa più efficace è semplice: misurare il costo per attività accettata, mantenere stabile il prefisso e trattare ogni picco di scritture come un incidente da spiegare.
L'azione da fare lunedì
Lunedì prossimo, scegliere un endpoint di un agente in produzione. Salvare l'ID di una risposta rappresentativa, ripetere la stessa attività completata e annotare token in cache, token scritti, tempo trascorso, token di output e costo totale. Poi modificare il nome o la descrizione di un solo strumento, confrontare il risultato con la stessa baseline, ripristinare l'elenco degli strumenti ed eseguire nuovamente il test. Se la richiesta ripristinata riduce il costo dell'attività completata senza peggiorarne l'accettazione, aggiungere proprio quel test alla CI prima di modificare i prompt o introdurre breakpoint.
Domande frequenti
Come si attiva il prompt caching?
Di solito non serve attivarlo. Il prompt caching è abilitato per impostazione predefinita sui modelli OpenAI supportati. Mantenere stabili almeno 1,024 token visibili all'inizio di una richiesta per GPT-5.6 o versioni successive, inviare una richiesta corrispondente entro la finestra attiva e controllare cached_tokens. Usare prompt_cache_options.mode soltanto quando serve un controllo intenzionale dei breakpoint.
Che cos'è il prompt caching e come funziona?
Salva lo stato key-value elaborato dal modello per un prefisso esatto del prompt. La prima richiesta idonea scrive quello stato; le richieste successive con lo stesso prefisso possono leggerlo, evitando di rielaborare la parte comune. Il nuovo suffisso e la generazione dell'output richiedono comunque lavoro.
Quando è meglio non usare la cache?
Non conviene ottimizzarla quando i prompt restano sotto la soglia minima, si ripetono raramente, cambiano nella parte iniziale o scadono prima della richiesta successiva. In modalità esplicita, omettere un breakpoint evita di pagare la tariffa di scrittura di 1.25× per un prefisso che probabilmente non verrà riutilizzato.
Conviene usare il prompt caching?
Sì, quando l'input ripetuto rappresenta una quota rilevante del costo per attività completata. Occorre misurare una scrittura e più letture con gli strumenti reali e i propri controlli di accettazione. Un hit rate elevato conta soltanto se diminuisce il costo totale per attività accettata.
Qual è la strategia di caching migliore?
Iniziare con la cache implicita automatica. Collocare prima i contenuti stabili, aggiungere in coda quelli variabili, mantenere invariati strumenti e impostazioni della richiesta e diagnosticare i miss. I breakpoint espliciti vanno aggiunti soltanto intorno a blocchi stabili che saranno riutilizzati abbastanza da recuperare il costo della scrittura.
Per integrare questa misurazione e il gate contro le regressioni nello stack dei propri agenti, il servizio più adatto è AI production systems.
- Ultimo aggiornamento
- 27 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Microsoft Copilot prezzi: la guida ai costi di Managed Runtime
Microsoft Copilot Managed Runtime non ha un prezzo unico: calcola Copilot Credits, chiamate API, Power Apps Premium e tutti i costi da mettere a budget.26 set 2026Build
n8n workflow o AI Agent: quale scegliere davvero
Confronto tra n8n workflow e AI Agent: quando scegliere una sequenza fissa, quanto costano le esecuzioni e dove servono sessioni e approvazioni.26 set 2026Build
OpenRouter pricing: Jev Router è davvero gratis?
Jev Router mostra un prezzo di $0, ma una sessione instradata è davvero gratuita? Ecco quali dati di OpenRouter verificare prima di stimare i costi.26 set 2026Build
Server MCP Claude e plugin: come pubblicarli nella directory
Scopri come preparare, validare e pubblicare un plugin Claude e il relativo server MCP Claude nella directory, dal repository GitHub alla review finale.26 set 2026Build
Cloudflare MCP è gratis? Prezzi e limiti del portale
Scopri quando Cloudflare MCP Portals è gratis, quanto costano gli utenti attivi e quali spese per modelli, SaaS e server restano escluse dal piano.26 set 2026Build
Prestazioni GPU: mettere alla prova Agentic CUDA Optimizer
Scopri come testare Agentic CUDA Optimizer in sette tentativi, verificare ogni kernel e capire se il guadagno sulle prestazioni GPU ripaga davvero.25 set 2026Build
Runpod pricing 2026: quanto costano Pod e Serverless
Runpod pricing spiegato con costi di Pod, Serverless e storage, un calcolo H100 con data certa e la soglia di pareggio basata sul tempo fatturabile.25 set 2026Build