Claude Sonnet 5.5 : guide pratique, réglages et cas d’usage
Apprenez à utiliser Claude Sonnet 5.5, à régler son niveau d’effort et à migrer l’API grâce à des workflows fiables, des coûts réels et des garde-fous.



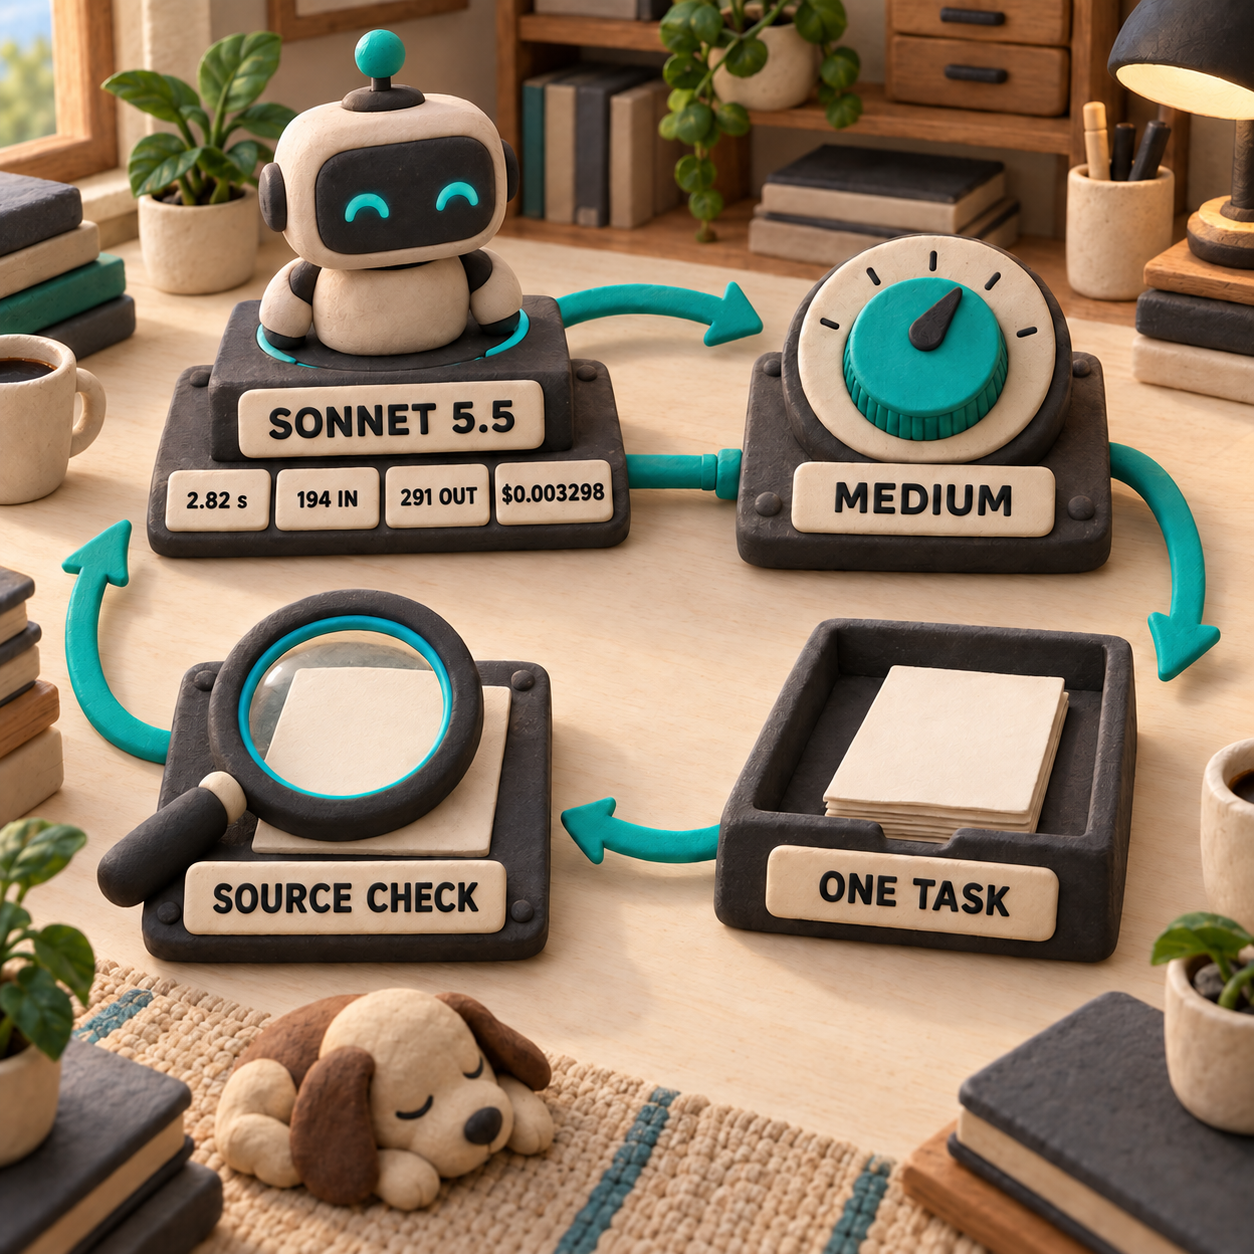
Pour bien utiliser Claude Sonnet 5.5, commencez par une seule tâche délimitée et facile à relire, avec l’effort réglé sur Medium : résumer un ticket de support ou préparer un brief client, par exemple. Lors de mon test local sur un ticket synthétique, le modèle a répondu en 2.82 secondes, consommé 194 tokens en entrée et 291 en sortie, pour un coût de $0.003298. Il a conservé les faits essentiels du ticket, mais aussi ajouté des hypothèses de résolution plausibles qui ne figuraient pas dans la source. Voilà l’enseignement pratique : Sonnet 5.5 rend le premier jet extrêmement peu coûteux, sans supprimer le travail de vérification.
Bien démarrer avec Claude Sonnet : une tâche en Medium
Le moyen le plus rapide d’obtenir un résultat utile passe par l’application Claude. Sélectionnez Sonnet 5.5, vérifiez que l’effort est réglé sur Medium, fournissez un seul dossier source et demandez un livrable que vous pourrez contrôler ligne par ligne.
Dans ses applications et Claude Code, Anthropic choisit Medium par défaut. Sur la Claude Platform, le réglage par défaut est High : les utilisateurs de l’API doivent donc préciser le niveau. Medium constitue un bon premier essai pour les synthèses de support, les briefs clients, les analyses courantes et les tâches outillées bien cadrées. La boucle de retour reste rapide, sans tomber au niveau le plus bas.
Sélectionnez Sonnet 5.5
Ouvrez une nouvelle conversation dans Claude. Cliquez sur le nom du modèle à côté du bouton d’envoi, choisissez Sonnet 5.5, puis ouvrez le menu Effort. Si le modèle n’apparaît pas dans la liste initiale, cliquez sur More models. Les administrateurs Enterprise peuvent limiter les modèles et les niveaux d’effort proposés.
Gardez Medium pour le premier essai
Pour une tâche métier bien délimitée, laissez l’effort sur Medium. Passez à High si la mission exige un jugement plus poussé, un enchaînement plus long ou une vérification plus stricte. Low devient pertinent une fois que vos propres contrôles ont confirmé le maintien de la qualité.
Donnez-lui une source et un format
Collez un ticket, la transcription d’un appel ou un ensemble de documents. Indiquez le destinataire et les champs attendus. Pour un ticket de support, exigez exactement quatre puces : Problème, Impact, Preuves et Prochaine action. Ajoutez : « N’invente aucun fait. Signale chaque déduction. »
Vérifiez chaque affirmation dans la source
Confrontez chaque nom, chiffre, cause, engagement et action recommandée aux données fournies. Supprimez tout conseil non étayé, même s’il semble raisonnable. Ne conservez le prompt qu’après l’avoir validé sur plusieurs exemples tirés de votre propre workflow.
Le ticket synthétique de mon test décrivait six agents de support bloqués après un changement de domaine de connexion, deux agents dont la session était restée ouverte, une erreur « Invalid organization » et des fiches utilisateur déjà rattachées au nouveau domaine. Sonnet 5.5 a préservé ces éléments et respecté le format en quatre puces. Il a toutefois avancé que le mapping de l’organisation pointait probablement encore vers l’ancien domaine et qualifié une correction de moins perturbatrice. Aucun de ces deux éléments ne figurait dans le ticket.
Le calcul du coût brut du modèle est simple. Au tarif publié par Anthropic, 194 tokens d’entrée coûtent $0.000388 et 291 tokens de sortie coûtent $0.00291, soit $0.003298 au total. Si 10,000 appels avaient exactement ce profil de tokens, la dépense brute du modèle atteindrait $32.98. Ce n’est pas le coût de 10,000 tickets résolus : la récupération des données, les intégrations, les nouvelles tentatives, le stockage, le monitoring et la relecture humaine s’ajoutent toujours à l’appel du modèle.
Claude Sonnet 5.5, concrètement, qu’est-ce que c’est ?
Sonnet 5.5 est le modèle rapide et généraliste de la famille 5.5 d’Anthropic. Considérez-le comme le modèle opérationnel pour les missions définies ; Opus 5.5 joue plutôt le rôle du spécialiste senior quand le problème est ouvert et demande beaucoup de jugement.
Cette version est distincte de Sonnet 5. Son identifiant dans l’API Claude directe est claude-sonnet-5-5, sans suffixe de date. Le modèle accepte du texte et des images, produit du texte, dispose d’une fenêtre de contexte de 1 million de tokens et peut générer jusqu’à 128,000 tokens en sortie. Pour retrouver les tarifs et le contexte du tokenizer du modèle précédent, consultez le test de Claude Sonnet 5, consacré séparément à cette version.
D’après Anthropic, Sonnet 5.5 génère ses réponses plus de 30% plus vite que Sonnet 5 et coûte jusqu’à 30% de moins par tâche achevée dans ses tests. Cette deuxième affirmation s’explique par un nombre inférieur de tokens nécessaires pour terminer le travail, et non par une baisse du tarif unitaire. Les prix restent ceux de Sonnet 5.
Les résultats de benchmark proviennent eux aussi d’Anthropic. L’entreprise annonce 70.6% pour Sonnet 5.5 contre 10.3% pour Sonnet 5 sur Terminal-Bench 4.0, ainsi que 55.5% contre 34.1% sur CursorBench 4.0. Ces chiffres justifient de tester le nouveau modèle, mais ne disent pas si votre politique de support, votre codebase ou votre modèle de document passera le contrôle. Le rapport de lancement d’Anthropic distingue lui aussi les scores de benchmark du jugement soutenu qu’exige un travail ouvert.
Choisir l’effort selon le coût d’une erreur
Le niveau d’effort pilote la qualité, la latence et la consommation de tokens ; ce n’est pas un réglage de longueur. Un effort supérieur laisse davantage de marge au modèle pour raisonner et vérifier, au prix possible d’un délai et d’une facture plus élevés. Si vous voulez une réponse brève, demandez-le séparément dans le prompt.
Anthropic a recalibré ces niveaux pour Sonnet 5.5. Le réglage Medium de ce modèle ne correspond donc pas au même volume de réflexion que Medium sur Sonnet 5. Recommencez l’évaluation sur vos propres exemples. Ne conservez pas un réglage simplement parce que son libellé n’a pas changé.
Sept workflows utiles, classés par bénéfice à court terme
Les meilleurs cas d’usage ont trois points communs : les données d’entrée sont disponibles, le résultat attendu possède une forme claire et une personne ou une règle peut le vérifier.
1. Trier les tickets de support
Un responsable des opérations support peut réunir le message du client, l’état de son compte, l’historique récent des tickets et la politique d’escalade. Sonnet 5.5 peut en tirer le problème, l’impact, les preuves, les informations manquantes et la prochaine action autorisée. Le bénéfice : moins de relecture avant l’orientation ou le transfert du dossier. Un humain doit encore contrôler les conseils qui modifient un compte, les remboursements, les promesses et les conclusions sur la cause racine.
C’est le meilleur workflow pour commencer, car chaque élément produit peut renvoyer à un champ source précis. Les erreurs du modèle deviennent aussi rapidement visibles. Si une synthèse ne permet pas de retrouver l’origine d’une affirmation, elle n’est pas prête à déclencher une action.
2. Préparer les briefs avant un appel client
Un directeur de clientèle peut fournir la dernière transcription d’appel, le cahier des charges, les tâches ouvertes et les notes de renouvellement. Demandez une page qui regroupe les décisions, les engagements, les risques, les questions en suspens et l’ordre du jour de la prochaine réunion. Vous obtenez ainsi un format de briefing reproductible, au lieu de repartir d’une page blanche avant chaque appel.
Séparez les rubriques « confirmé » et « déduit ». Cette distinction suffit à empêcher qu’une interprétation plausible du modèle ne devienne un engagement envers le client.
3. Relire les pull requests
Un responsable technique peut fournir au modèle un diff de code, les conventions du dépôt et une checklist couvrant la sécurité, les tests et la rétrocompatibilité. Sonnet 5.5 peut livrer une première analyse classée par risque et proposer des tests. L’intérêt est d’accélérer la prise en main par le reviewer, pas d’approuver automatiquement. La décision de merger doit rester entre les mains d’une personne responsable du système.
4. Corriger des bugs bien délimités
Un ingénieur produit confronté à un bug reproductible peut fournir le comportement défaillant, les fichiers concernés et les critères de validation. Medium est un point de départ raisonnable pour une correction bien spécifiée. Passez à High si le problème traverse plusieurs services ou si la première tentative saute l’étape de vérification. Des critères d’acceptation explicites empêchent le périmètre de dériver, tout en raccourcissant les boucles d’implémentation et de test.
5. Préparer les revues d’activité et les supports de conseil d’administration
Une équipe finance ou opérations peut fournir les documents sources ainsi qu’un modèle de présentation ou de document déjà approuvé. Sonnet 5.5 peut structurer une première revue, faire ressortir les lacunes et mettre le brouillon en forme. Anthropic le positionne expressément sur la création de documents, de présentations et de feuilles de calcul soignés. Le gain porte sur l’assemblage, mais chaque affirmation financière doit toujours renvoyer à une cellule ou à un document source.
6. Résumer les incidents
Un responsable d’incident peut transmettre au modèle la chronologie des événements, les alertes, les actions et les notes des personnes responsables. Demandez des blocs séparés pour les faits confirmés, les hypothèses, l’impact client, les questions non résolues et les suites à donner. Le relais et le brouillon du compte rendu gagnent en clarté. En revanche, ne laissez pas le modèle transformer une corrélation en cause racine.
7. Contrôler visuellement et peaufiner une interface
Un product designer ou un développeur front-end peut associer une capture d’écran aux règles de marque et à une checklist de validation. Sonnet 5.5 peut repérer les incohérences, hiérarchiser les corrections et aider à réaliser une passe bien délimitée. L’itération sur les défauts visibles s’accélère. Le goût, les tests d’accessibilité et le jugement produit final restent toutefois du ressort humain.
Trois produits qui méritent d’être construits
Un accès brut au modèle ne constitue pas une entreprise. Pour devenir vendable, un produit doit ajouter du contexte propriétaire, un workflow contrôlé, des preuves et un point de décision humain.
1. Un triage du support relié aux preuves : la meilleure opportunité
Construisez un copilote de support qui transforme un ticket et une fiche de compte en synthèse structurée, rattache chaque affirmation à un lien source, vérifie l’action proposée au regard de la politique et place le brouillon dans une file de validation. Les responsables du support et les équipes de service client externalisées paieraient pour un routage plus rapide et plus cohérent.
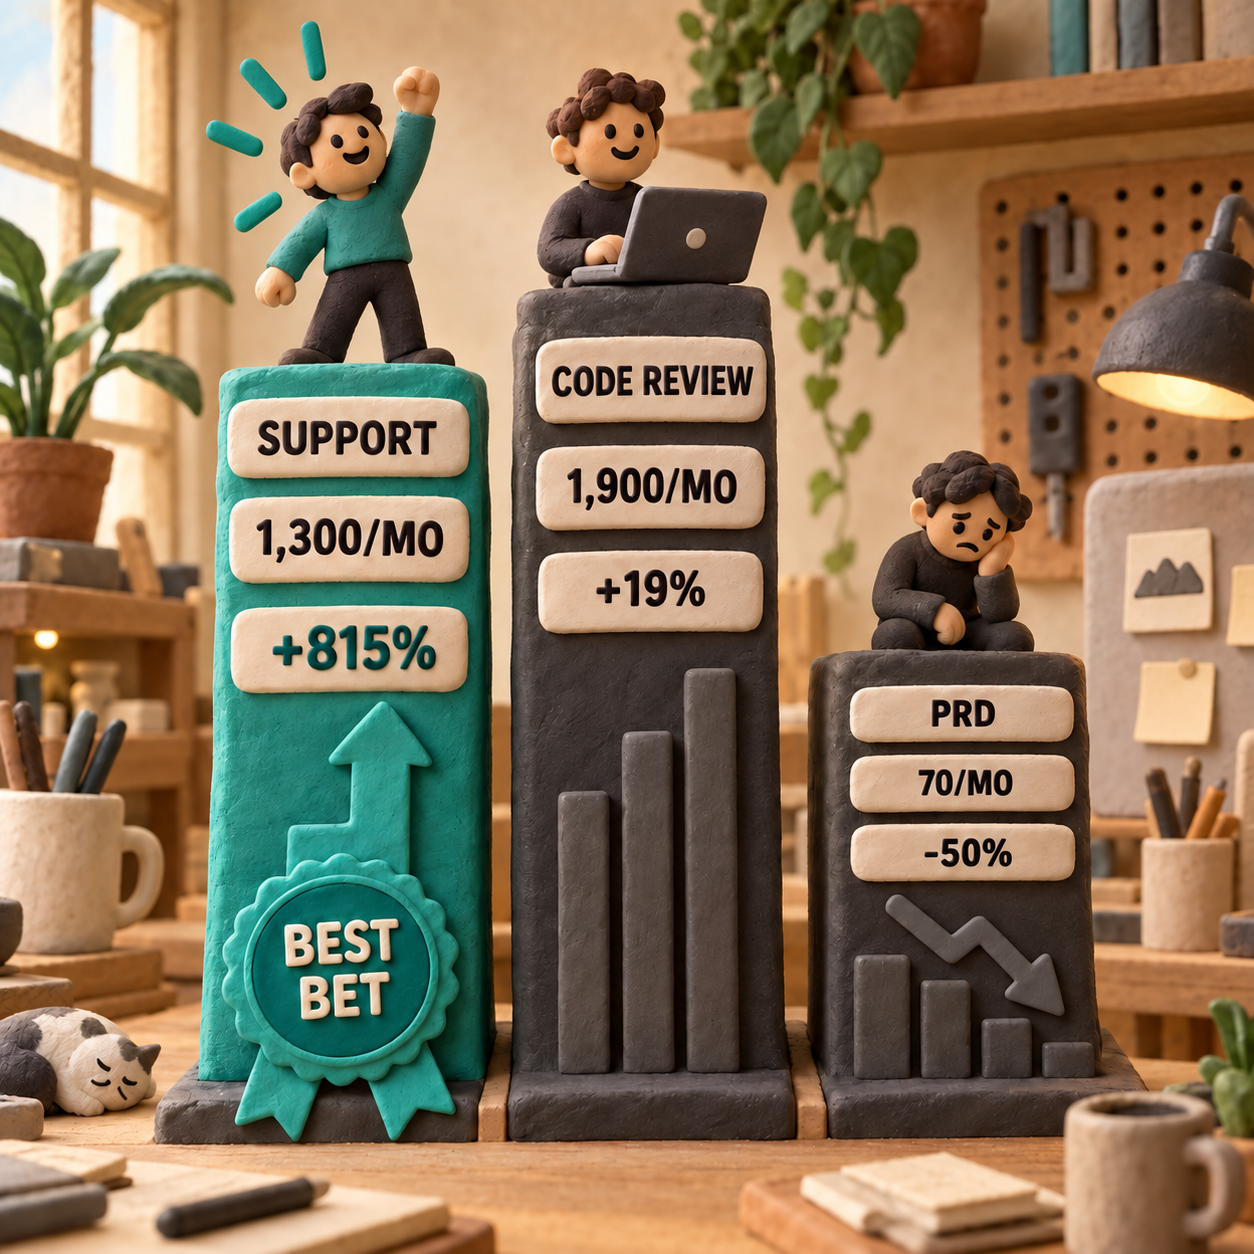
La demande est visible : ai customer service agent totalise 1,300 recherches mensuelles aux États-Unis, avec une intention commerciale et une croissance annuelle de 815% dans les données de mots-clés de cette analyse. Intercom facture Fin $0.99 par résultat. Ce prix n’est pas directement comparable au coût d’un appel de synthèse, car une résolution est une mission plus large, mais il prouve que les acheteurs acceptent déjà une automatisation du support facturée à l’usage.
La plus petite version vendable nécessite un connecteur de boîte de réception, un connecteur vers les données de compte, la synthèse en quatre champs, des citations de sources, un contrôle de conformité à la politique et des commandes pour approuver ou rejeter. Le point difficile reste l’intégration et la confiance. Si l’origine d’une recommandation ne peut pas être prouvée, les clients conserveront leur workflow actuel.
2. Une couche de code review sensible aux règles internes
Construisez une application GitHub qui lit un diff et les règles propres à chaque équipe, puis renvoie une revue classée par risque, les lacunes de test et un bref récapitulatif avant merge. Les acheteurs sont les responsables techniques et les équipes plateforme.
ai powered code review platform totalise 1,900 recherches mensuelles aux États-Unis et affiche une croissance annuelle de 19%. Le tarif public de CodeRabbit commence à $24 par développeur et par mois avec une facturation annuelle ; les offres supérieures coûtent $48 et $72. Le MVP comprend un hébergeur de dépôts, des webhooks de pull request, des contrôles personnalisés, une vue de commentaires et une piste d’audit indiquant quelle règle a déclenché chaque alerte.
Le marché est toutefois encombré. Un reviewer générique n’a aucun avantage défendable. Ciblez un créneau douloureux, comme les contrôles de mise en production réglementés, la sécurité des migrations de données ou un framework précis, puis mesurez les faux positifs aussi soigneusement que les défauts manqués.
3. Un outil vertical qui transforme un brief en PRD, mais pas un produit générique
Construisez un workflow spécialisé qui convertit des appels, des contraintes et des décisions antérieures en brief produit, avec critères d’acceptation et questions non résolues. Un cabinet de conseil produit ou une équipe logicielle verticale pourrait l’acheter si le modèle correspond exactement à sa manière de travailler.
La requête exacte ai product requirements document generator n’enregistre que 70 recherches mensuelles aux États-Unis et recule de 50% sur un an. C’est un avertissement, pas un argument commercial. Un générateur de PRD générique et autonome est ici l’opportunité la moins solide. La version viable prend la forme d’un module au sein d’un workflow de plus grande valeur : discovery en agence, déploiement dans la santé ou gestion du changement en entreprise, par exemple.
Le MVP repose sur un paquet de sources fixe, un seul modèle de document assumé, la traçabilité des décisions et un export vers le système déjà utilisé par l’acheteur. Le problème tient à la faiblesse de la demande et à la facilité de copie. Ne construisez ce produit que si vous possédez déjà la relation client ou un canal de données vertical.
Prix de Claude Sonnet : tarif stable, coût du workflow potentiellement plus bas
Sonnet 5.5 coûte $2 par million de tokens en entrée, $10 par million de tokens en sortie et $0.20 par million de tokens lus depuis le cache. Ce sont les mêmes tarifs publiés que pour Sonnet 5. La baisse de coût annoncée par Anthropic vient d’un nombre inférieur de tokens nécessaires pour terminer une tâche.
Cette nuance compte dans une prévision. Une trace de modèle plus courte peut réduire à la fois la latence et la dépense en tokens, même si la grille tarifaire ne change pas. Le coût total du produit peut aussi rester presque identique si la récupération des données, les outils tiers, les nouvelles tentatives et la relecture humaine dominent. Mesurez le coût par résultat accepté, pas le coût par appel.
Les abonnements à l’application Claude et l’utilisation de l’API sont deux produits distincts. Un abonnement Pro, Max, Team ou Enterprise n’inclut ni l’accès à la Claude Console ni la consommation de l’API. Le guide des offres Claude détaille les limites générales ; un workflow API exige son propre accès Console et une facturation à l’usage.
Migrer l’API Claude Sonnet une fois la tâche validée
L’ordre de migration le plus sûr est simple : validez le prompt sur des exemples représentatifs, épinglez le nouvel identifiant de modèle, définissez explicitement l’effort, puis corrigez le contrat de raisonnement et d’appel d’outils avant d’envoyer du trafic de production.
Pour une requête simple avec raisonnement adaptatif, omettez le champ thinking et lisez les blocs de texte selon leur type :
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Quatre changements de migration méritent une vérification méthodique.
thinking: {"type": "disabled"}n’est plus accepté par l’API Claude directe d’Anthropic. Utilisezthinking: {"type": "between_tools"}lorsque vous ne voulez aucun raisonnement initial. Ce réglage fonctionne avec Low, Medium et High, mais pas avec Xhigh ou Max.- Pour
tool_choice, l’API directe n’accepte plus la valeur forcéeany, nitoolavec le nom d’un outil. Utilisezauto, rendez le schéma strict lorsque cette option est prise en charge et indiquez dans le prompt quand l’outil doit s’exécuter. - Une réponse peut commencer par un bloc
thinking. Analysez chaque bloc de contenu selon sontype; ne supposez jamais quecontent[0].textexiste. - Dans une boucle d’outils, renvoyez les blocs de raisonnement sans les modifier. Ils portent des signatures liées aux échanges précédents : conservez donc un historique auquel vous ne faites qu’ajouter des messages.
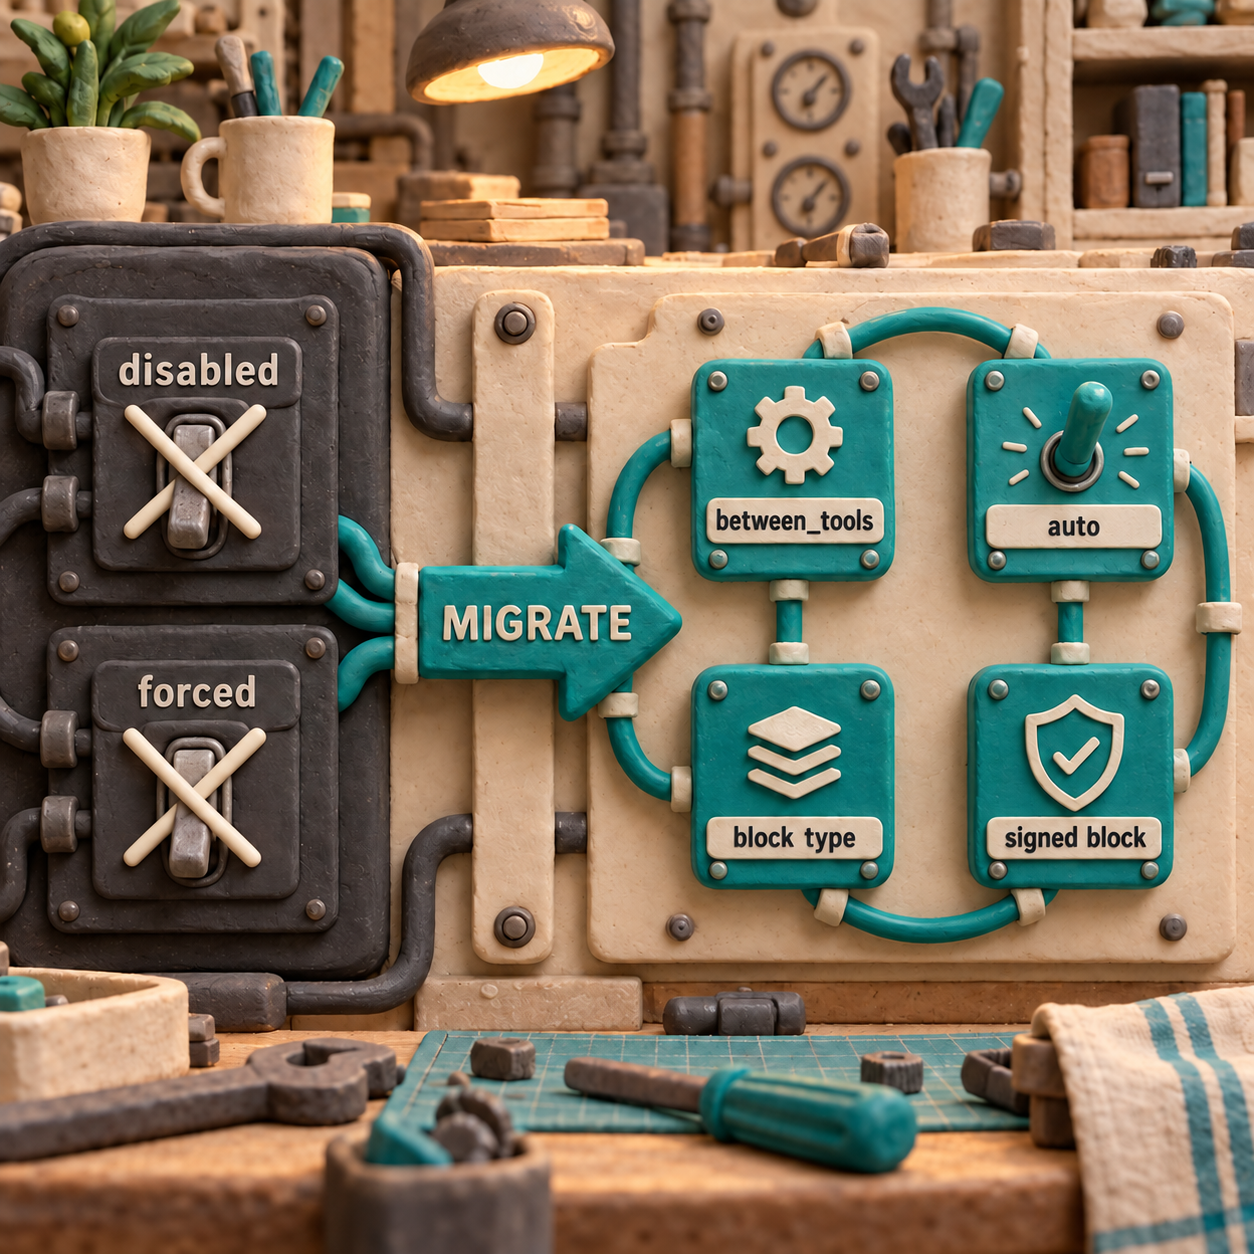
Ce modèle minimal utilise between_tools, conserve auto pour le choix des outils et préserve l’intégralité du tour de l’assistant :
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)
Le guide de migration de Sonnet 5.5 d’Anthropic documente les erreurs 400 de l’API directe et les champs de remplacement. Ma requête locale en Medium avec between_tools a renvoyé un statut HTTP 200 en 1.35 secondes. Une autre boucle adaptative avec outil a produit un bloc de raisonnement signé ; le renvoi de ce bloc complet et inchangé a réussi au tour suivant.
Une nuance importante subsiste. Mes appels passaient par une passerelle d’IA. Cette couche de compatibilité a renvoyé un statut HTTP 200 quand j’ai volontairement envoyé l’ancienne valeur de raisonnement disabled et forcé tool_choice: any, alors qu’Anthropic documente ces deux cas comme des erreurs de l’API directe. Ne considérez pas l’acceptation par un middleware comme une preuve de compatibilité avec votre intégration directe. Inspectez la requête brute dans le Playground d’Anthropic ou testez l’endpoint direct avant de basculer.
Ce que Sonnet 5.5 ne résout pas
Il ne transforme pas une déduction non étayée en fait. Le test local sur le support l’a clairement montré. Exigez des références aux sources pour les affirmations à fort impact et conservez des validations humaines pour les remboursements, les modifications de compte, les engagements juridiques, les décisions médicales et les actions de sécurité.
Il ne fait pas de chaque mission une tâche pour Medium. Augmentez l’effort lorsque vos propres exemples révèlent un raisonnement insuffisant ou un travail incomplet. Pour les missions ouvertes qui exigent un jugement soutenu, utilisez Opus ; le comparatif avec Opus 5.5 explique la place de ce niveau supérieur.
Il ne transforme pas non plus l’appel brut du modèle en produit. Les connecteurs, les autorisations, les contrôles de politique, les évaluations, l’observabilité, les solutions de repli et une interface de validation utile concentrent l’essentiel du travail de mise en production.
Enfin, il ne supprime pas le besoin de sources à jour. Si une réponse de support ou de recherche dépend des règles, obligations ou tarifs en vigueur, fournissez au modèle un outil de recherche ou de connaissance et demandez-lui de vérifier.
L’action à lancer lundi
Choisissez une file de travail dotée d’une source de vérité claire. Lundi, prenez 20 exemples récents, retirez les données privées inutiles et exécutez Sonnet 5.5 en Medium avec un schéma de sortie fixe. Évaluez la justesse factuelle, les déductions non étayées, l’exhaustivité, le temps écoulé et la consommation de tokens. Ne modifiez l’identifiant de modèle d’une API existante et n’effectuez les contrôles de migration ci-dessus qu’après la réussite de ce prompt.
Comment utiliser Claude Sonnet ?
Dans l’application Claude, cliquez sur le nom du modèle à côté du bouton d’envoi, choisissez Sonnet 5.5, sélectionnez l’effort Medium et commencez par une seule tâche délimitée dont vous pouvez vérifier le résultat. Dans Claude Code, lancez /model et choisissez Sonnet 5.5, ou ouvrez une session avec claude --model claude-sonnet-5-5.
À quoi Claude Sonnet 5 est-il le mieux adapté ?
Pour la version actuelle Sonnet 5.5, commencez par des tâches quotidiennes bien cadrées : synthèses de support, briefs clients, corrections de bugs, code review et documents professionnels soignés. Augmentez le niveau d’effort ou passez à Opus quand le travail est ouvert et qu’une erreur subtile aurait un coût élevé.
Claude Sonnet est-il gratuit ?
La disponibilité et les limites dépendent de l’offre Claude et des paramètres de l’organisation. L’accès à l’application et la facturation de l’API sont distincts : un abonnement Claude payant n’inclut pas l’utilisation de l’API. Consultez le guide des offres Claude cité plus haut pour connaître les limites en vigueur.
Combien coûte Claude Sonnet 5 ?
Claude Sonnet 5.5 coûte $2 par million de tokens en entrée, $10 par million de tokens en sortie et $0.20 par million de tokens lus depuis le cache. Selon Anthropic, il peut coûter moins cher par tâche achevée que Sonnet 5 parce qu’il utilise moins de tokens, et non parce que ces tarifs ont baissé.
Pour faire construire un workflow Claude fondé sur vos sources, découvrez les systèmes d’IA en production.
- Dernière mise à jour
- 28 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

GLM-5.3-Flash ou Jev : quel modèle de décision IA choisir ?
Jev réduit le coût du routage texte, tandis que GLM-5.3-Flash gère les images. Comparez prix, latence, précision et contraintes avant de choisir.27 sept. 2026AI
Claude Opus 5.5 ou Opus 5 : prix, code et migration
Claude Opus 5.5 coûte moins cher, mais cinq changements d’API compliquent la migration. Comparez les prix, le code, le thinking et les critères de choix.23 sept. 2026AI
GPT-6 Sol ou Luna : quel modèle choisir ?
GPT-6 Sol ou Luna : comparez prix, usages, limites et coût par résultat accepté pour choisir le bon modèle sans payer 20× plus cher par défaut.23 sept. 2026AI
GPT-6 Luna gratuit : accès, limites et tarifs API
GPT-6 Luna gratuit à l’essai dans l’app desktop : découvrez les comptes compatibles, les limites connues, l’accès à Codex et les tarifs de l’API.22 sept. 2026AI
MiMo AI : comment utiliser Xiaomi MiMo V2.6 et son API
Testez MiMo AI dans Studio, choisissez la bonne clé et le bon modèle, puis lancez un premier workflow métier fiable avec l’API Xiaomi MiMo V2.6.22 sept. 2026AI
Comparatif MiMo V2.6 : Pro ou Flash, lequel choisir ?
Comparatif MiMo V2.6 Pro et Flash pour le code et les agents IA : réussite des tâches, coût des tokens, cache et cas où Pro justifie son prix.22 sept. 2026AI
MiMo V2.6 gratuit : ce qui l’est vraiment
MiMo V2.6 gratuit ? Pas partout. Découvrez l’accès OpenCode temporaire, les checkpoints MIT, les tarifs API et les limites avant de choisir.22 sept. 2026AI