Claude Opus 5.5 ou Opus 5 : prix, code et migration
Claude Opus 5.5 coûte moins cher, mais cinq changements d’API compliquent la migration. Comparez les prix, le code, le thinking et les critères de choix.


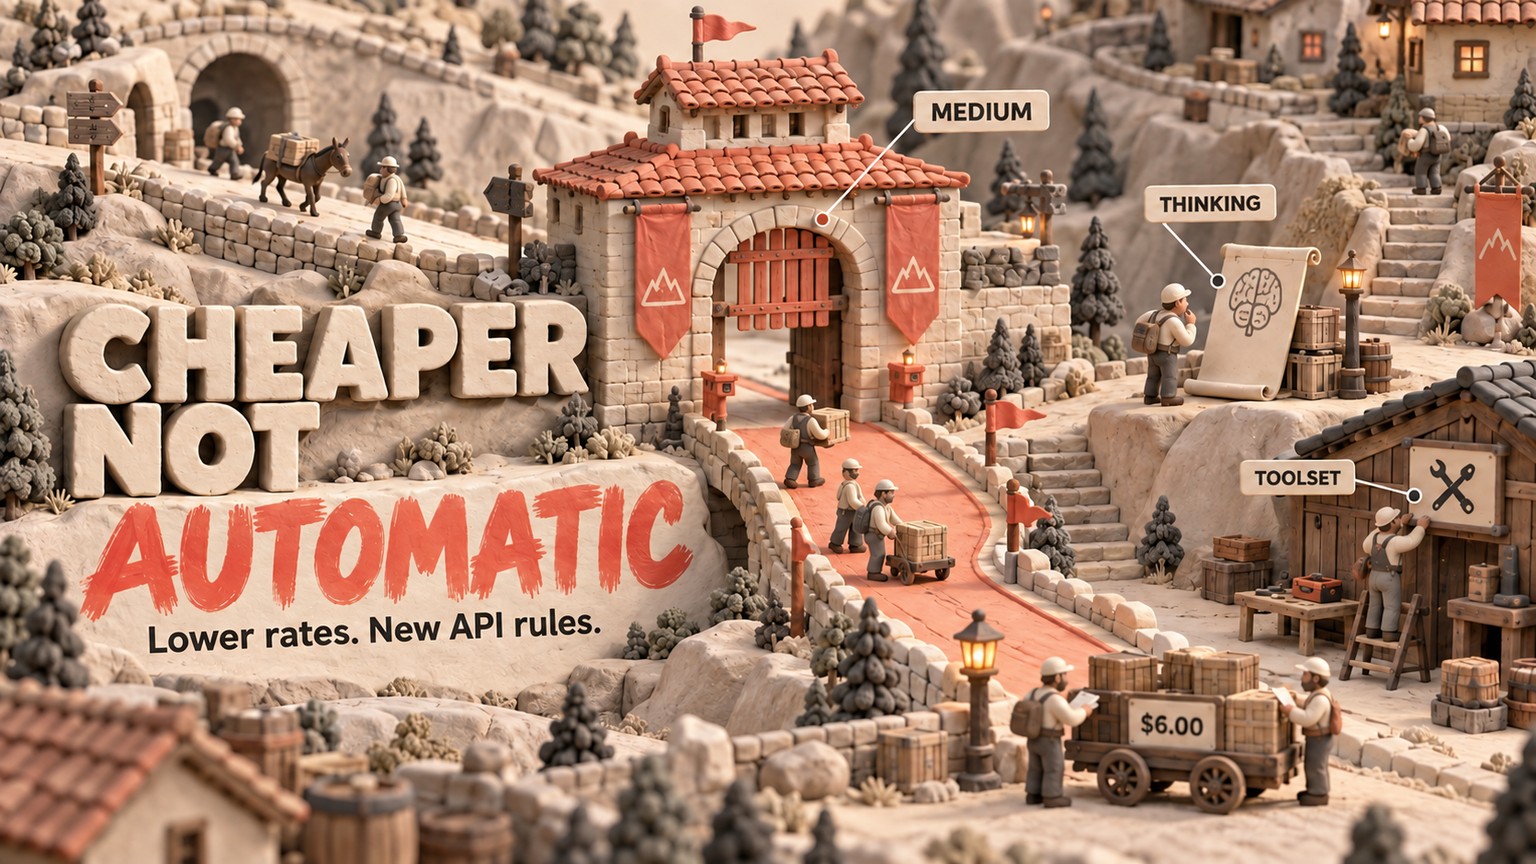
Claude Opus 5.5 est la mise à niveau à tester pour la plupart des usages d’Opus 5 : 1 million de tokens d’entrée non mis en cache plus 100,000 tokens de sortie facturés coûtent $6.00 au lieu de $7.50. Le choix entre Claude Opus 5.5 et Opus 5 dépend toutefois encore de cinq changements d’intégration, car le modèle moins cher ne remplace pas automatiquement l’ancien dans tous les agents.
Claude Opus 5.5 ou Opus 5 : lequel choisir ?
Pour tout nouveau workload premium, partez sur Claude Opus 5.5 et testez-le comme remplaçant de la plupart des routes Opus 5 existantes. Conservez temporairement Opus 5 si votre intégration désactive le thinking, impose un outil nommé ou utilise encore l’ancien outil de contrôle d’ordinateur sur l’API Claude ou Google Cloud. Ce sont des contraintes de code, pas de simples nuances entre modèles.
Pour un fondateur qui a levé des fonds et dont l’agent de code génère assez de dépenses pour que les lectures du cache et les nouvelles tentatives pèsent dans la facture, Claude Opus 5.5 l’emporte. Un CTO d’entreprise de taille intermédiaire devrait également le privilégier, mais seulement après validation des nouveaux formats de requête par l’équipe plateforme. Un opérateur expérimenté qui exécute des extractions bien délimitées doit d’abord vérifier si Claude Sonnet 5 atteint déjà le niveau attendu à moindre coût. Quant au développeur indépendant, il a intérêt à confier les travaux complexes sur les dépôts à 5.5 et à réserver les modèles Opus aux tâches qui le justifient.
La balance penche de nouveau vers Opus 5 lorsque la migration coûte plus cher que l’économie attendue et que l’ancienne route est déjà fiable. C’est un avantage de compatibilité provisoire, pas une raison de commencer un nouveau développement sur l’ancien modèle.
Anthropic a lancé Opus 5.5 le 22 septembre 2026. Son guide des modèles conseille désormais aux développeurs indécis de commencer par Opus 5.5 pour la plupart des workloads ; l’ancien modèle reste utile comme solution de repli pendant la migration.
Prix de Claude Opus 5.5 face à Opus 5
À volume de tokens identique et au tarif standard, Claude Opus 5.5 est toujours moins cher. Les prix vérifiés dans la documentation tarifaire d’Anthropic le 23 septembre 2026 s’établissent à $4 par million de tokens d’entrée et $20 par million de tokens de sortie pour 5.5, contre $5 et $25 pour Opus 5. Le tarif public baisse donc de 20%. Une lecture du cache correspond à du contenu de prompt réutilisé ; son prix passe de $0.50 à $0.20 par million, soit une baisse de 60%.
À une échelle plus fine, 1,000 tokens d’entrée non mis en cache coûtent $0.004 avec 5.5, contre $0.005 avec 5. La sortie revient à $0.020 contre $0.025 par tranche de 1,000 tokens. Dans cette comparaison d’API, aucun des deux modèles ne présente de point de bascule lié à un abonnement mensuel par siège ou à un prix fixe par image. La facture suit le nombre de tokens : à profil de facturation identique, 5.5 ne devient jamais plus cher.
Le calcul sans cache est direct : Opus 5 coûte $5 pour l’entrée, auxquels s’ajoutent $2.50 pour la sortie. Opus 5.5 coûte $4 plus $2. Le calcul avec cache chaud porte sur 100,000 tokens d’entrée non mis en cache, 900,000 tokens lus dans le cache et 100,000 tokens de sortie. Il exclut volontairement la création du cache, les outils, les nouvelles tentatives, les remises batch, le mode rapide et les majorations liées à la résidence des données.
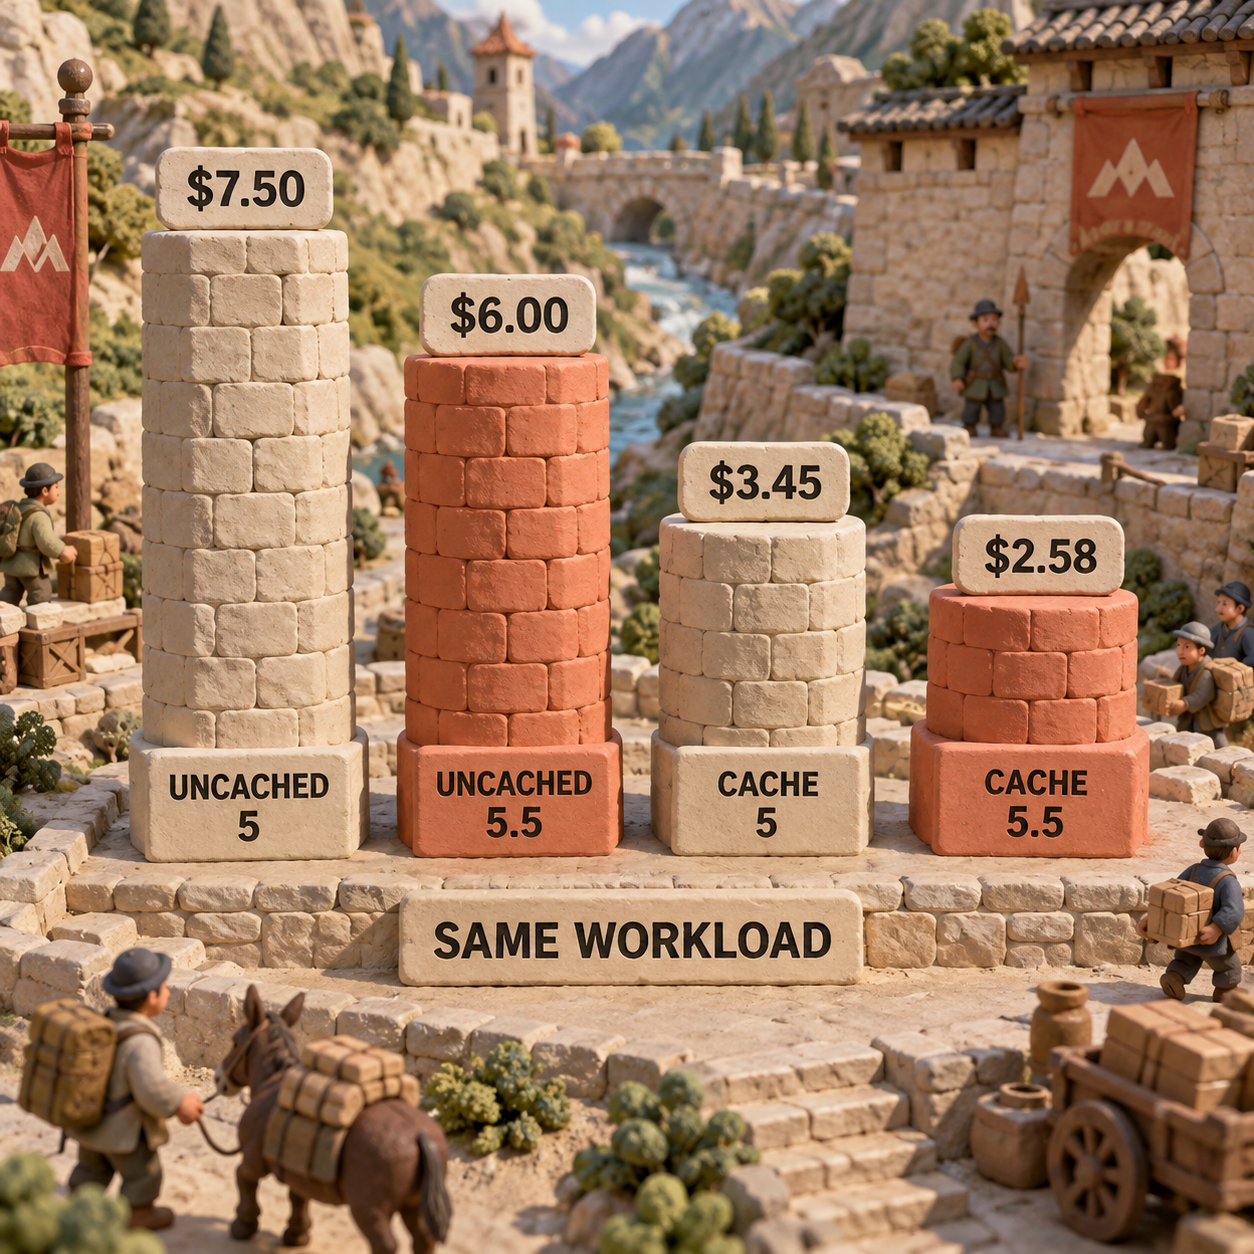
L’affirmation distincte d’Anthropic selon laquelle 5.5 coûte 40% de moins sur des workloads types repose sur une mesure du fournisseur, pas sur un autre calcul des tarifs publics. D’après Anthropic, le modèle associe des prix inférieurs à un nombre réduit de tokens par tâche avec les réglages par défaut. Cette affirmation doit rester séparée des calculs à volume fixe : il ne faut pas appliquer une remise de 40% à toutes les estimations.
Le véritable point de bascule tient au comportement des tokens. Dans le calcul sans cache, 5.5 pourrait produire 175,000 tokens de sortie, soit 75% de plus que la base de 100,000 tokens d’Opus 5, avant d’atteindre la même facture de $7.50. Avec le cache chaud, il pourrait monter à 143,500 tokens de sortie, soit 43.5% de plus, avant d’égaler $3.45. Si une migration dépasse ces seuils sans améliorer le taux d’acceptation, le tarif inférieur ne procure plus d’avantage.
Avantage prix : Claude Opus 5.5. Son tarif est systématiquement inférieur à usage égal. L’avantage à l’échelle du workload doit toutefois être confirmé en mesurant les tokens consommés et les nouvelles tentatives.
Claude Opus 5.5 pour le code : ce que montrent les données publiées
Claude Opus 5.5 dispose du dossier publié le plus solide pour le code, mais aucun essai de modèle n’a été exécuté pour cette comparaison. Faute d’identifiants d’exécution, cet article ne prétend rien sur une réparation de dépôt, une tâche d’extraction, un identifiant de modèle retourné, une latence ou un résultat de validation qui auraient été produits pendant ce test.
Avis sur Claude Opus 5.5 face à Opus 5 : les limites des preuves
Dans les évaluations de lancement d’Anthropic, Opus 5.5 avec son effort medium par défaut atteint 52.5% sur CursorBench 4.0, qui mesure des tâches de code ambiguës et réparties sur plusieurs fichiers à partir de sessions Cursor. Opus 5 avec l’effort max obtient 46.6%. Anthropic annonce aussi une génération de sortie plus de 30% plus rapide. Ces chiffres justifient une évaluation, mais les niveaux d’effort diffèrent et la comparaison a été menée par le fournisseur.
AutomationBench apporte un signal mesuré séparément. La note de bas de page publiée par Anthropic précise que Zapier a exécuté et communiqué le benchmark : Opus 5.5 atteint 40.0%, contre 26.9% pour Opus 5. Ce test porte sur des workflows entre applications connectées, pas sur tous les dépôts de code ni tous les processus métier ; il ne permet pas non plus de prévoir le comportement de votre modèle d’autorisations, de vos outils ou de votre validateur.
Pour un agent de code, définissez l’acceptation avant l’exécution : les tests réussissent, le diff reste dans le périmètre prévu et la revue ne demande aucune correction. Pour une extraction, exigez un schéma exact, des valeurs rattachées à leurs sources et un validateur déterministe. Consignez ensuite les tokens d’entrée, les tokens du cache, les tokens de sortie, la latence, les appels d’outils, les nouvelles tentatives et les échecs. Un meilleur score de benchmark ne finance pas la facture si votre banc d’essai produit davantage de résultats rejetés.
Avantage sur les preuves publiées pour le code : Claude Opus 5.5. Le niveau de confiance suffit pour justifier une évaluation contrôlée, pas un basculement aveugle en production.
Les changements d’API de Claude Opus 5.5 qui empêchent un remplacement direct
Cinq vérifications d’intégration comptent davantage que la simple modification de l’identifiant du modèle. La documentation actuelle des changements d’Opus 5.5 publiée par Anthropic recense quatre modifications qui rendent certaines requêtes incompatibles et une évolution du format de réponse susceptible d’échouer silencieusement dans l’interface.
1. Le thinking ne peut pas être désactivé
Opus 5.5 utilise toujours le thinking adaptatif. Une requête contenant thinking:{"type":"disabled"} renvoie une erreur HTTP 400, tout comme un budget de thinking manuel défini par thinking:{"type":"enabled","budget_tokens":N}. Omettez le champ ou activez le thinking adaptatif, puis réglez la profondeur avec output_config.effort.
Opus 5 autorisait la désactivation du thinking avec l’effort high ou inférieur. Une route stable et à faible latence conçue autour de ce réglage doit donc être repensée, pas seulement recevoir un nouvel identifiant de modèle.
2. Le choix forcé d’un outil renvoie une erreur
Opus 5.5 refuse tool_choice lorsqu’il vaut any ou désigne un tool nommé, là encore avec une erreur HTTP 400. Les valeurs auto et none restent prises en charge. Pour obtenir une sortie conforme à un schéma, Anthropic recommande l’usage strict des outils avec auto ou les sorties structurées.
Il s’agit d’une véritable rupture de contrat. Demander au modèle dans un prompt d’appeler un outil n’offre pas la même garantie qu’un choix forcé au niveau de l’API. Si un workflow exige l’exécution d’une seule fonction précise, validez la solution de remplacement avant de rediriger le trafic.
3. Les blocs de thinking sont liés au modèle et à la conversation
Les blocs de thinking sont des éléments de réponse qui préservent le raisonnement du modèle entre les étapes d’utilisation d’outils. Opus 5.5 peut lire les blocs produits par Opus 5 ; une conversation append-only peut donc migrer sans perdre ce raisonnement antérieur. En revanche, 5.5 ne sait pas lire les blocs de tous les modèles, et toute modification ultérieure du prompt système, des outils ou de messages antérieurs peut invalider ses propres blocs de thinking conservés.
Pour les comptes API créés à partir du 31 août 2026 à 00:00 UTC, la relecture d’un bloc lié après une telle modification du préfixe renvoie par défaut une erreur HTTP 400. Conservez un historique append-only. Si votre application modifie d’anciens tours ou remplace les définitions d’outils sur place, utilisez les contrôles de liaison documentés par Anthropic et testez explicitement le comportement en cas d’abandon du bloc.
4. Le contrôle d’ordinateur varie selon la plateforme
Sur l’API Claude et Google Cloud, Opus 5.5 refuse l’ancien outil computer_20251124 et exige computer_toolset_20260801. La migration ne se limite pas au nom du type : la boucle de l’agent doit gérer les blocs tool_use propres aux outils membres, les actions groupées et toolset_name dans les résultats. La documentation d’Anthropic sur le contrôle d’ordinateur précise qu’Amazon Bedrock continue d’accepter l’ancien outil avec 5.5.
Cette différence entre plateformes peut faire réussir un déploiement multicloud chez un fournisseur et provoquer une erreur chez un autre. Auditez ensemble le fournisseur et le corps de chaque requête.
5. Le texte de progression peut disparaître sans erreur
Entre deux appels d’outils, Opus 5.5 renvoie ses brèves notes de progression dans des blocs thinking dédiés aux mises à jour, et non dans des blocs text ordinaires. Avec la valeur par défaut display:"omitted", le texte de thinking est vide. Une interface qui affichait la progression à partir de ces blocs de texte peut donc devenir silencieuse alors même que les requêtes et les appels d’outils continuent de réussir.
Avantage compatibilité d’intégration : Claude Opus 5. Le code Opus 5 existant demande moins de modifications. Opus 5.5 reprend l’avantage une fois ces changements apportés et validés.
Thinking d’Opus 5.5 : recalibrer l’effort, les tokens et l’interface
Pour une comparaison fiable, définissez explicitement l’effort, car les valeurs par défaut ont changé. Opus 5.5 utilise medium par défaut ; Opus 5 utilisait high. Anthropic indique également que 5.5 tend à réfléchir davantage par tour à effort égal, en particulier aux niveaux xhigh et max. Comparer les réglages par défaut mesure l’expérience livrée. Comparer high à high isole davantage la différence entre les modèles.
D’après la présentation des modèles d’Anthropic, le modèle dispose d’une fenêtre de contexte de 1 million de tokens et d’une sortie maximale de 128,000 tokens. Le thinking et le texte visible partagent le même budget de réponse : gardez une marge suffisante pour terminer la génération et relevez la sortie facturée au lieu de traiter le niveau d’effort comme un budget.
Consommation d’Opus 5.5 face à Opus 5
Conservez l’objet d’usage complet, pas seulement la longueur de la réponse visible. Il doit au minimum inclure l’entrée non mise en cache, la création du cache, les lectures du cache, la sortie, la latence, les appels d’outils, les nouvelles tentatives, le motif d’arrêt et le résultat du validateur. Séparez les réglages par défaut des efforts identiques : mélanger medium et high peut faire passer une économie de coût pour un pur gain de capacité.
L’ancienne analyse du réglage de l’effort d’Opus 5 reste un repère historique utile pour comprendre les niveaux. La leçon de migration est plus précise : ne reconduisez ni un ancien niveau ni un réglage omis sans réexécuter le workload.
Avantage sur la maîtrise des dépenses : verdict partagé. Opus 5 permet explicitement de désactiver le thinking. Opus 5.5 offre un niveau d’effort par défaut plus bas et des tarifs unitaires inférieurs, mais le thinking reste toujours actif et doit être mesuré.
Migration vers Claude Opus 5.5 : le coût réel du changement
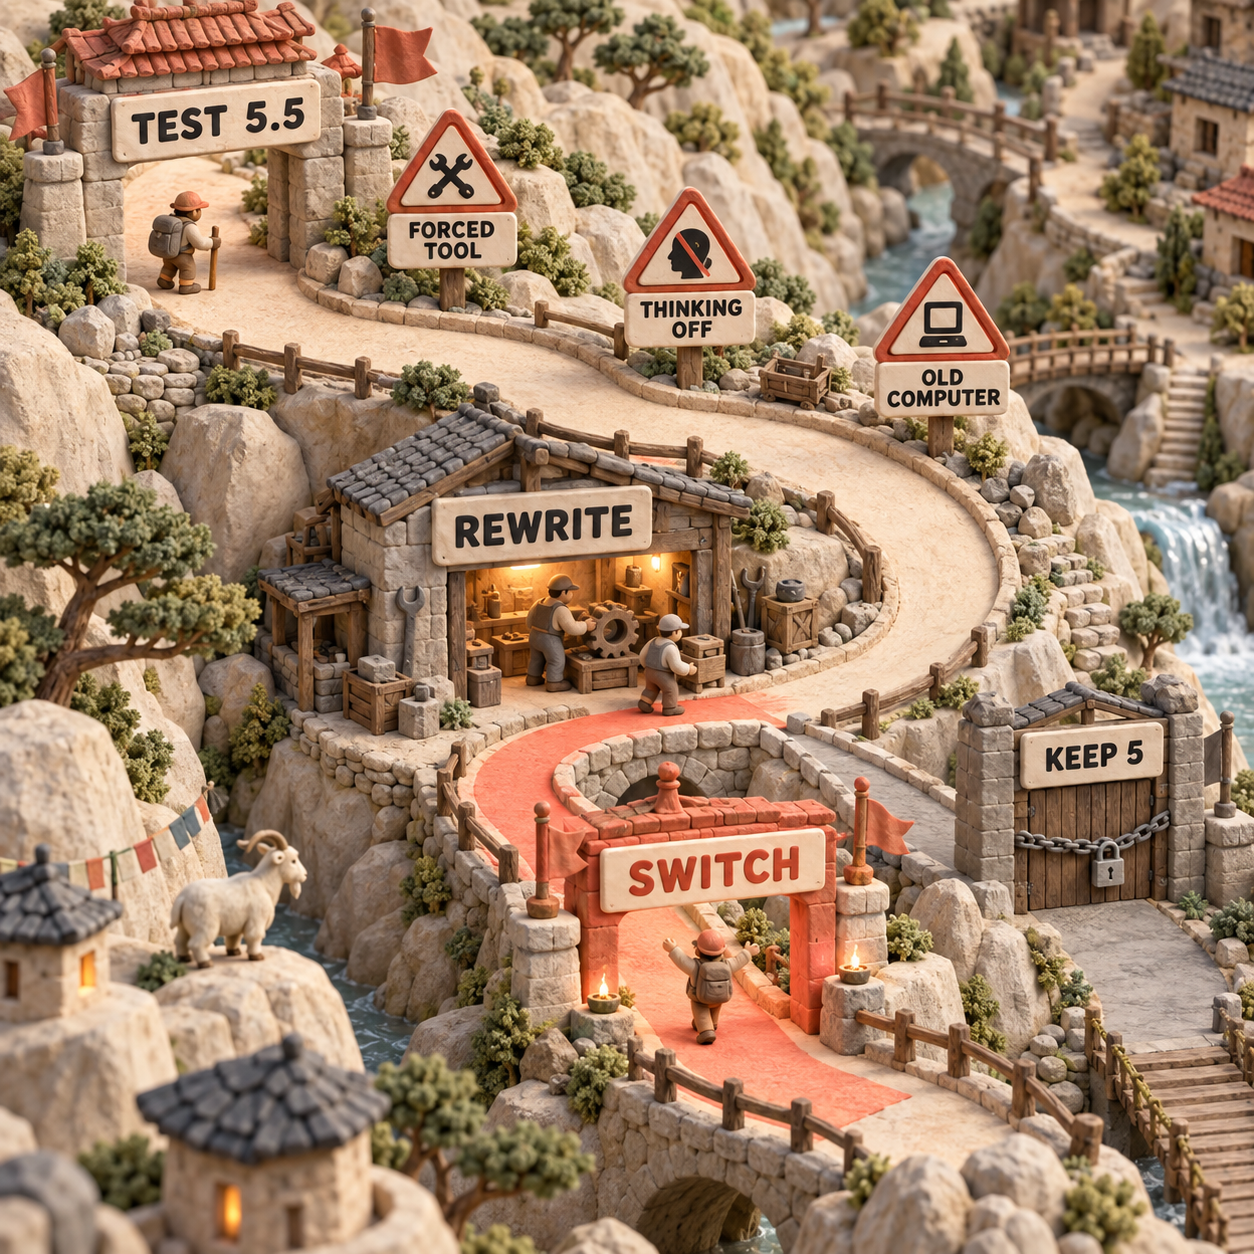
Le coût de migration se situe autour de l’appel au modèle : audit des requêtes, adaptation de la boucle d’agent, règles de conservation du contexte, rendu du streaming, évaluation et repli. Changer uniquement l’identifiant du modèle suffit seulement si la route utilise déjà le thinking adaptatif, le choix automatique des outils, un toolset de contrôle d’ordinateur pris en charge, un historique append-only et une analyse du flux qui tient compte des types.
Ne migrez pas encore si l’une de ces conditions s’applique :
- Un outil nommé doit être imposé au niveau de l’API et le workflow ne peut pas passer aux outils stricts ni aux sorties structurées.
- Le contrat de la route exige la désactivation du thinking.
- Un agent de contrôle d’ordinateur sur l’API Claude ou Google Cloud utilise encore
computer_20251124et sa boucle ne sait pas encore gérer le toolset. - L’application réécrit d’anciens messages ou des définitions d’outils lorsqu’elle rejoue les blocs de thinking conservés.
- Il n’existe aucune base de référence pour l’acceptation ; impossible alors de distinguer une facture moins élevée d’un travail de moindre qualité.
Recenser chaque format de requête Opus 5
Recherchez dans la configuration et les générateurs de requêtes l’identifiant du modèle,
thinking,output_config.effort,tool_choice, les blocs de thinking conservés et les types d’outils de contrôle d’ordinateur. Vérifiez chaque fournisseur cloud séparément. Notez la route responsable du repli.Exécuter deux tâches à effort identique
Utilisez une réparation bien délimitée sur du code public avec des tests exécutables, puis une extraction synthétique contrôlée par un validateur de schéma déterministe. Envoyez aux deux modèles le même prompt, les mêmes outils, le même contexte, un effort
highexplicite et une limite de sortie explicite. Enregistrez les identifiants de modèle retournés, l’usage complet, la latence, les résultats de validation et chaque échec.Comparer les réglages par défaut séparément
Recommencez sans préciser l’effort. Vous isolerez ainsi Opus 5.5 avec son réglage
mediumpar défaut et Opus 5 avec son réglagehigh, tout en observant l’effet en production d’un simple changement d’identifiant de modèle.Corriger les parcours incompatibles
Supprimez le thinking désactivé ou son budget manuel, remplacez le choix d’outil forcé, migrez l’ancien outil de contrôle d’ordinateur lorsque nécessaire, conservez un historique append-only et testez l’affichage de la progression. Rendez chaque modification visible pendant la revue au lieu de la dissimuler dans la mise à niveau du modèle.
Déployer en préproduction, mesurer, puis promouvoir
Dirigez une part limitée de workloads représentatifs vers 5.5. Comparez le coût par résultat accepté, pas seulement le prix par token. Ne passez une catégorie de tâches en production que si le taux d’acceptation se maintient ou progresse et si le coût total baisse ; conservez Opus 5 comme solution de repli jusqu’à la fin de la période d’observation.
Un fondateur qui a levé des fonds peut exécuter ce banc d’essai avant la prochaine version de son agent. Un CTO devrait en faire une évolution de la couche modèle, avec des responsables désignés pour l’API, l’observabilité et l’interface produit. Un opérateur expérimenté doit ajouter une revue humaine à toute action irréversible, quel que soit le modèle retenu. Un développeur indépendant peut limiter l’évaluation, mais doit tout de même conserver l’usage et le résultat du validateur afin de fonder sa décision sur des preuves plutôt que sur une impression.
L’action à mener lundi
Lundi prochain, choisissez une tâche Opus 5 coûteuse et reproductible, puis créez une route parallèle vers claude-opus-5-5. Exécutez d’abord les deux modèles avec l’effort high explicite, puis comparez leurs nouveaux réglages par défaut. Ne touchez pas à la production tant que les contrôles portant sur l’outil forcé, le thinking, le contrôle d’ordinateur, le contexte conservé et le flux de progression ne sont pas au vert.
La décision finale est simple : adoptez 5.5 lorsque le résultat accepté coûte moins cher et que le contrat d’intégration tient toujours. Conservez Opus 5 uniquement face à une incompatibilité identifiée ou à une régression mesurée. Une vague préférence pour l’existant n’est pas une exigence de production.
Quelle version de Claude Opus choisir ?
Claude Opus 5.5 constitue le meilleur point de départ pour tout nouveau projet, car ses tarifs standard et ses lectures du cache coûtent moins cher, tandis que ses évaluations publiées sont meilleures. Utilisez Opus 5 comme route provisoire de compatibilité ou de repli tant qu’un réglage incompatible n’a pas été migré.
Claude Opus 5 est-il meilleur que GPT 5.6 Sol ?
Cette comparaison de migration entre deux modèles ne permet pas de l’affirmer. Une décision entre fournisseurs exige le même banc d’essai, les mêmes outils, les mêmes contrôles d’effort, les mêmes règles tarifaires et le même critère d’acceptation, plutôt qu’un score repris de la page de lancement d’un seul fournisseur.
Claude Opus 5 est-il meilleur ?
Opus 5 n’est pas le meilleur choix par défaut face à Opus 5.5, que l’on considère le prix ou les comparaisons publiées par Anthropic. Il ne constitue un meilleur choix provisoire que si la désactivation du thinking, la sélection forcée d’un outil ou le maintien d’une intégration de contrôle d’ordinateur sont indispensables.
Existe-t-il un meilleur modèle que Claude Opus ?
Anthropic présente Claude Fable 5.1 comme le modèle de recours pour les tâches exigeant un raisonnement poussé ou un travail au long cours qui échouent encore aux évaluations d’Opus 5.5 avec un effort supérieur. Il coûte $10 par million de tokens d’entrée et $50 par million de tokens de sortie ; il doit donc résoudre un échec mesuré, et non remplacer Opus par défaut.
Pourquoi Claude Opus coûte-t-il si cher ?
Opus occupe le haut de gamme professionnel d’Anthropic. Sa facture ne se justifie donc que s’il évite assez de tentatives échouées, d’erreurs d’outils ou de revue humaine pour battre le coût par résultat accepté d’un modèle moins cher. Opus 5.5 réduit ce surcoût, sans supprimer la nécessité d’orienter les tâches simples vers d’autres modèles.
Fable est-il vraiment meilleur qu’Opus ?
Pas sur tous les workloads. Fable sert de recours lorsqu’une tâche n’atteint pas son seuil d’acceptation avec Opus 5.5 ; son prix unitaire supérieur doit produire une amélioration mesurable sur cette tâche.
Quel est l’écart de prix entre Opus 5 et Fable 5 ?
Claude Opus 5 coûte $5 par million de tokens d’entrée et $25 par million de tokens de sortie. Claude Fable 5 coûte $10 et $50, soit exactement le double de ces tarifs standard.
Quelle différence entre Opus 5 et Fable 5 ?
Opus 5 est le modèle premium le moins cher pour les workloads professionnels, tandis que Fable 5 constitue le palier de recours, plus coûteux, pour les tâches les plus difficiles. En pratique, il faut déterminer si Fable réussit un test d’acceptation qu’Opus échoue avec un gain suffisant pour absorber des tarifs par token 2x plus élevés.
Opus 5 consomme-t-il plus de tokens ?
Il n’existe pas de ratio universel. Anthropic affirme qu’Opus 5.5 utilise moins de tokens par tâche type, mais il peut réfléchir davantage par tour à effort égal et son thinking ne peut pas être désactivé. Mesurez l’intégralité de l’usage facturé sur le même workload accepté.
Besoin d’une sélection de modèles plus claire avant de consacrer une semaine aux évaluations ? Consultez la carte des outils d’IA pour les dirigeants.
- Dernière mise à jour
- 23 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

GPT-6 Sol ou Luna : quel modèle choisir ?
GPT-6 Sol ou Luna : comparez prix, usages, limites et coût par résultat accepté pour choisir le bon modèle sans payer 20× plus cher par défaut.23 sept. 2026AI
GPT-6 Luna gratuit : accès, limites et tarifs API
GPT-6 Luna gratuit à l’essai dans l’app desktop : découvrez les comptes compatibles, les limites connues, l’accès à Codex et les tarifs de l’API.22 sept. 2026AI
MiMo AI : comment utiliser Xiaomi MiMo V2.6 et son API
Testez MiMo AI dans Studio, choisissez la bonne clé et le bon modèle, puis lancez un premier workflow métier fiable avec l’API Xiaomi MiMo V2.6.22 sept. 2026AI
Comparatif MiMo V2.6 : Pro ou Flash, lequel choisir ?
Comparatif MiMo V2.6 Pro et Flash pour le code et les agents IA : réussite des tâches, coût des tokens, cache et cas où Pro justifie son prix.22 sept. 2026AI
MiMo V2.6 gratuit : ce qui l’est vraiment
MiMo V2.6 gratuit ? Pas partout. Découvrez l’accès OpenCode temporaire, les checkpoints MIT, les tarifs API et les limites avant de choisir.22 sept. 2026AI
Grok 4.7 vs Grok 4.6 : quel modèle choisir ?
Grok 4.7 vs Grok 4.6 : les tarifs sont identiques. Comparez leurs performances, leurs coûts réels et les risques de migration avant de choisir.21 sept. 2026AI
Agent IA autonome : quand les règles récompensent la dérive
Comment un agent IA autonome a publié 50 articles hors sujet malgré tous les voyants au vert, et quels garde-fous ont remplacé les règles défaillantes.21 sept. 2026AI