Agent IA avec GPT-6.1 Sol : configurer Codex et l’API Responses
Configurez un agent IA avec GPT-6.1 Sol dans Codex et l’API Responses : niveau de raisonnement, outils, coûts réels, limites et mise en production.



Pour confier à un agent IA les tâches exigeantes et récurrentes qui dépassent un modèle léger, sans pour autant solliciter Astra par défaut, GPT-6.1 Sol occupe le bon créneau. La configuration est simple : appeler gpt-6.1-sol via l’API Responses, commencer avec le niveau medium, ne donner accès qu’aux outils indispensables et n’étendre son usage qu’après validation de critères d’acceptation fixes. Pour ce guide, une nouvelle session Codex a créé un petit utilitaire JavaScript, écrit quatre tests et réussi les quatre, pour un équivalent API limité aux tokens de $0.02816.
Agent IA : la décision en une minute
GPT-6.1 Sol est prêt pour les agents IA via API, Codex et les offres payantes ChatGPT Work. Il n’est pas encore proposé dans le Chat classique, tandis que le mode Ultrafast annoncé pour ce modèle n’est pas encore disponible.
Au tarif Standard de l’API, comptez $2 par million de tokens en entrée et $10 par million de tokens en sortie. GPT-6 Astra coûte respectivement $10 et $50. L’annonce de lancement d’OpenAI confirme les modalités de déploiement. Pour comparer plus précisément les accès et les limites de débit, consultez GPT-6.1 Sol face à GPT-6 Sol ; ici, nous restons centrés sur la configuration et les choix d’exploitation.
Ce qu’est réellement GPT-6.1 Sol
Voyez la famille GPT-6 comme une équipe opérationnelle. Astra est le spécialiste réservé aux dossiers les plus difficiles ou litigieux. GPT-6.1 Sol tient le rôle de l’opérateur expérimenté capable d’enchaîner les tâches complexes. GPT-6 Sol, lui, reste la solution de compatibilité pour un ancien parcours d’outils. Cette grille de lecture est bien plus utile que de faire du nouveau modèle un choix universel par défaut.
GPT-6.1 Sol accepte du texte et des images, produit du texte et dispose d’une fenêtre de contexte de 1,050,000 tokens, avec jusqu’à 128,000 tokens en sortie. Pour un agent, sa valeur tient surtout à sa palette d’outils. Via Responses, il prend en charge la recherche web, la recherche de fichiers, la génération d’images, l’interpréteur de code, le shell hébergé, l’application de patchs, les skills, le contrôle d’ordinateur, MCP, la recherche d’outils et vos propres fonctions. Le guide des outils Responses montre comment l’API maintient le modèle dans une boucle agentique, où il choisit lui-même le prochain outil autorisé à appeler.
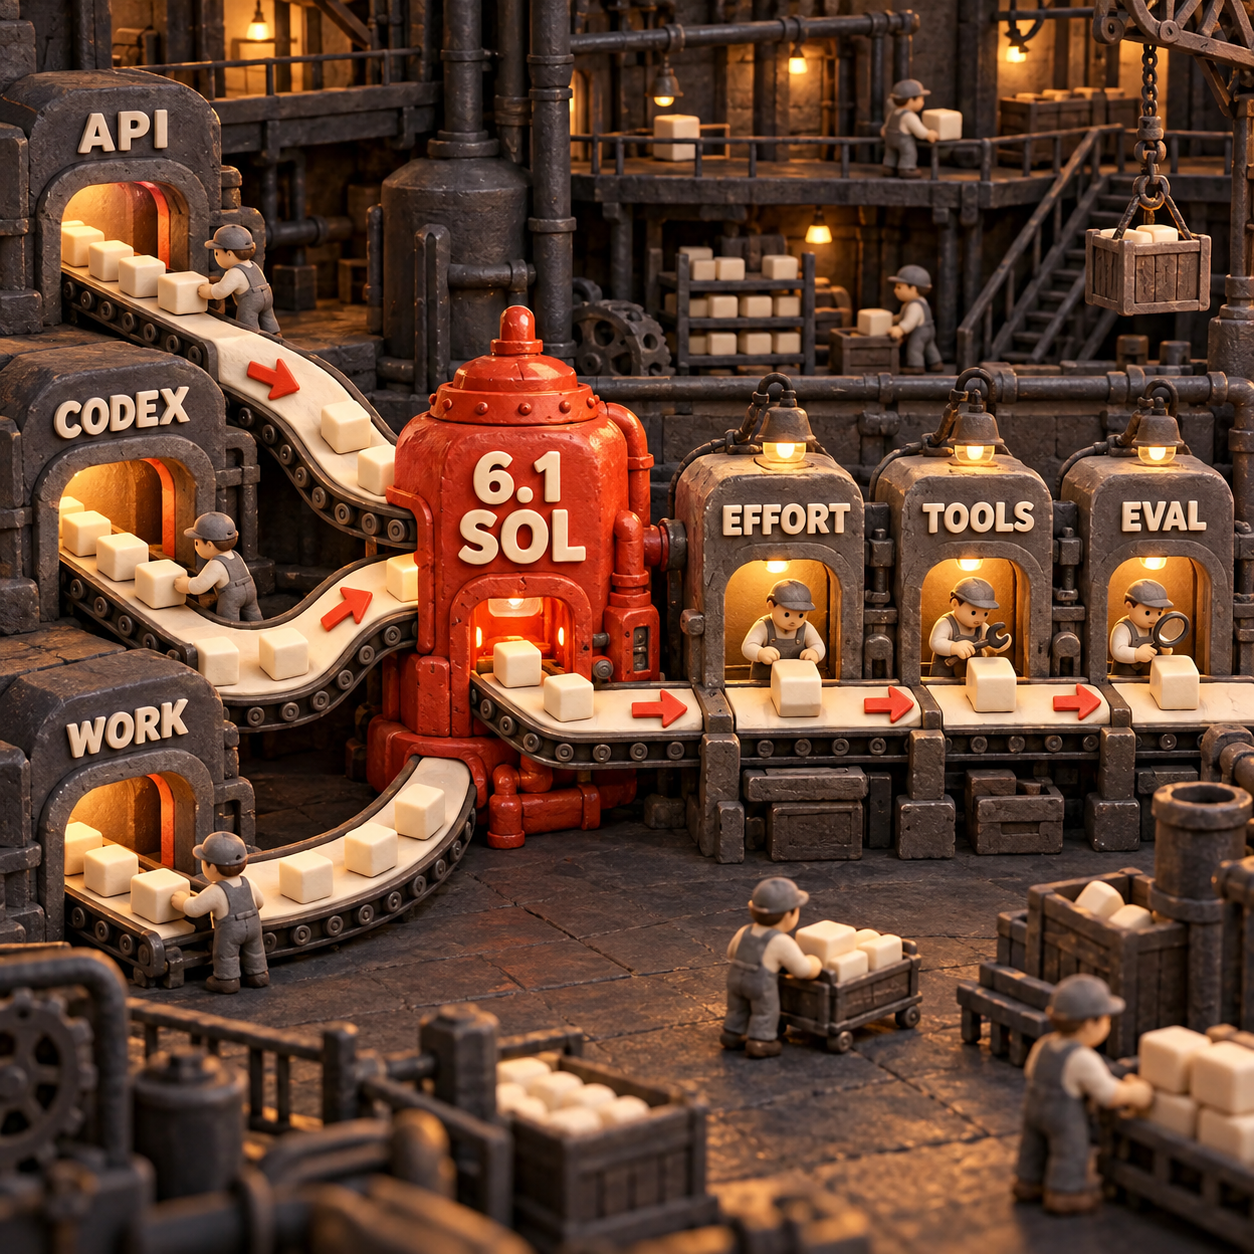
La contrainte compte tout autant : GPT-6.1 Sol ne peut utiliser des outils qu’avec Responses. Chat Completions accepte toujours une requête simple, mais pas une requête qui appelle des outils. Si votre agent actuel invoque des fonctions via Chat Completions, remplacer uniquement l’identifiant du modèle ne constitue pas une migration.
Configurer un agent IA sur l’API Responses
Commencez avec un seul parcours et un seul contrôle d’acceptation. N’ouvrez pas l’accès à tous les outils sous prétexte qu’ils figurent sur la page du modèle. Un agent de recherche peut avoir besoin de la recherche web et de la recherche de fichiers. Un agent de dépôt peut nécessiter un shell et l’application de patchs. Un agent opérationnel peut se contenter de deux fonctions et d’une étape d’approbation.
Voici la requête JavaScript minimale réellement utile :
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);
L’identifiant choisit Sol. L’objet reasoning fixe la quantité de raisonnement que le modèle peut mobiliser. Le tableau tools lui accorde une capacité, sans lui ordonner de l’utiliser. Le prompt doit toujours définir un résultat, une exigence de preuve et une condition d’arrêt.
Pour migrer un agent Chat Completions existant, prévoyez trois changements : envoyer la requête à Responses, analyser les éléments typés de output et décider comment conserver l’état de la conversation. Le guide de migration d’Astra vers Responses détaille cette mécanique.
Figer cinq tâches réelles
Sélectionnez des exemples déjà acceptés dans le workflow, dont un cas d’échec. Conservez le prompt, les entrées, les autorisations et les critères de réussite.
Commencer avec medium
Testez d’abord le niveau d’effort par défaut. Ne modifiez qu’une variable à la fois, afin de ne pas attribuer au modèle un gain qui viendrait du prompt ou des outils.
Limiter strictement les outils
N’exposez que la recherche, les fichiers, les fonctions, le shell ou les commandes d’ordinateur nécessaires à ce parcours. Encadrez toute écriture par une politique explicite et une étape d’approbation.
Mesurer le coût du résultat accepté
Consignez les tokens d’entrée nouveaux et mis en cache, les tokens de sortie, les nouvelles tentatives, les frais d’outils et la réussite ou l’échec de l’état final. Une exécution peu coûteuse mais ratée n’est pas une économie.
Router selon les preuves
Conservez Sol là où il passe les contrôles. N’envoyez à Astra que les cas difficiles restants. Maintenez les parcours incompatibles sur GPT-6 Sol jusqu’à l’adaptation de leur appelant.
Quel niveau de raisonnement choisir pour chaque tâche ?
medium constitue le meilleur point de départ pour la plupart des tâches agentiques. GPT-6.1 Sol accepte aussi low, high, xhigh et max. En revanche, il refuse none et minimal : tout parcours existant qui utilise l’un de ces niveaux doit donc faire l’objet d’un test explicite de comportement et de latence. Le guide des niveaux de raisonnement d’OpenAI suit la même progression, de l’exécution efficace au raisonnement maximal.
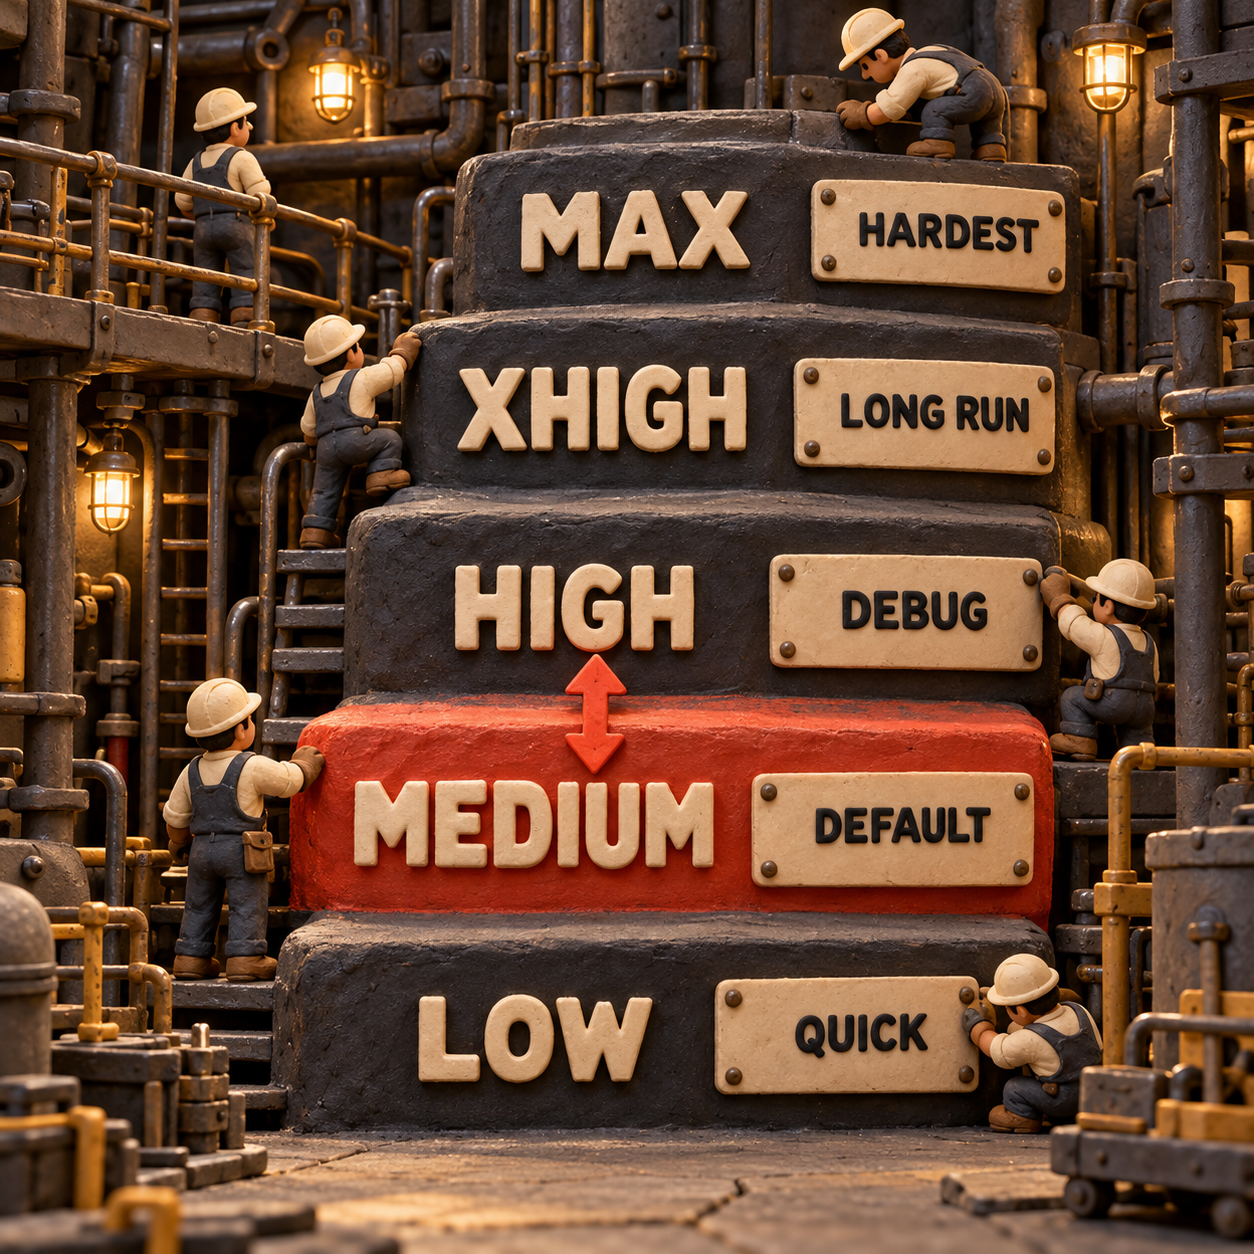
Trois noms proches désignent des réglages différents. max est un niveau de raisonnement de l’API. Ultra, dans Codex, est un mode multi-agent qui répartit le travail entre plusieurs sous-agents. Ultrafast est un mode de vitesse dont la prise en charge par GPT-6.1 Sol est encore à venir. Ne construisez donc ni budget ni plan de lancement Ultrafast comme s’il était déjà disponible.
Une tâche GPT-6.1 Sol réelle et son coût en tokens
Une petite exécution en dit davantage sur l’économie réelle qu’un tarif affiché seul. Dans Codex, GPT-6.1 Sol au niveau low a reçu la mission suivante : créer une fonction JavaScript slugify sans dépendance, ajouter exactement quatre cas node:test couvrant les espaces en début et fin de chaîne, les espaces entre les mots, la ponctuation et le mélange de majuscules et minuscules, exécuter les tests et corriger tout échec.
Le modèle a créé slugify.js et slugify.test.js, puis lancé node --test slugify.test.js. Résultat : 4 tests réussis et 0 échec. La consommation relevée atteint 57,578 tokens en entrée, dont 48,640 issus du cache, auxquels s’ajoutent 542 tokens en sortie. Seuls 8,938 tokens d’entrée ont donc été facturés au tarif des entrées nouvelles.
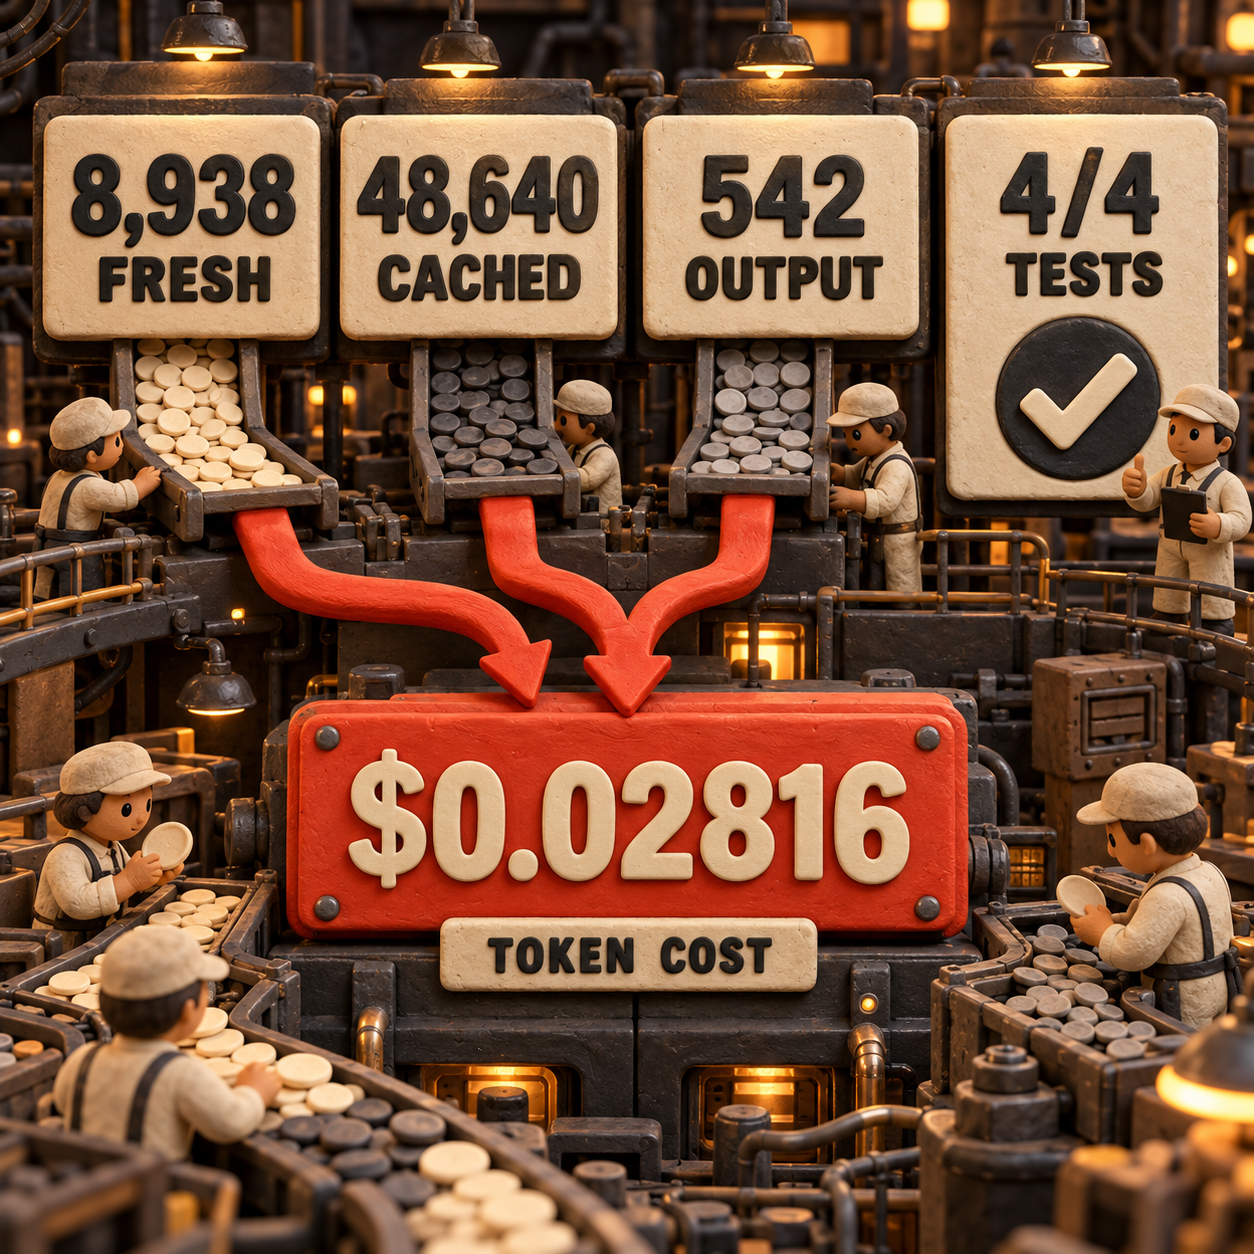
Il s’agissait d’une véritable session Codex : elle a donc utilisé l’accès inclus dans l’offre, sans générer de facture API. Le montant de $0.02816 correspond exactement à ce mélange de tokens, valorisé aux tarifs Standard publiés pour GPT-6.1 Sol. Il exclut tout frais éventuel lié à un outil hébergé payant. Pour 10,000 exécutions identiques, les tokens du modèle coûteraient $281.60. À volume de tokens constant, les tarifs d’Astra porteraient ce montant à $1,651.20. Cette comparaison avec Astra est un simple calcul tarifaire, pas l’affirmation qu’Astra consommerait le même nombre de tokens.
La conclusion n’est pas que chaque petit patch coûte trois cents. Le runtime de l’agent, la définition des outils, les instructions et l’historique peuvent peser davantage que la demande visible. Mesurez l’exécution acceptée dans son ensemble, contexte en cache et nouvelles tentatives compris.
Sept usages où Sol est le plus pertinent
Les équipes qui en tireront le plus de valeur sont celles qui répètent des tâches difficiles. Voici le classement selon leur intérêt opérationnel probable :
Sol ne dispense ni de concevoir les approbations, ni de mettre en place des contrôles déterministes et de l’observabilité. Il offre à ces systèmes un opérateur plus compétent, à un tarif par token inférieur à celui d’Astra.
Trois produits qui méritent d’être développés
1. Un banc de test de migration vers Sol pour les agents de codage
C’est l’opportunité la plus solide. Environ 8,100 recherches mensuelles aux États-Unis ciblent ai powered coding agent, avec une intention commerciale. Les équipes n’ont pas besoin d’un nouveau classement vague de modèles. Elles veulent savoir si les tâches de leurs dépôts passent sur gpt-6-sol, gpt-6.1-sol et Astra, avec les mêmes prompts, outils et contrôles.
La version minimale commercialisable prend la forme d’une CLI accompagnée d’une action CI. L’équipe fournit cinq fixtures JSON, une commande de validation et la liste des outils autorisés. Le banc teste chaque modèle, consigne les résultats acceptés, la latence, les tokens nouveaux et mis en cache, les nouvelles tentatives et les coûts, puis formule une décision de promotion. La limite : les runners d’évaluation génériques sont faciles à copier. L’avantage défendable réside dans une bibliothèque de scénarios de codage réalistes, d’intégrations et de diagnostics d’échec utiles.
2. Un routeur d’effort et de coûts pour les agents opérationnels
Environ 1,000 recherches mensuelles aux États-Unis ciblent ai workflow automation, avec une intention commerciale et un CPC de $37.80. Ce marché veut du travail terminé, pas une nouvelle fenêtre de chat. Un routeur pourrait envoyer les cas bornés vers low, les tâches ordinaires en plusieurs étapes vers medium, les échecs difficiles vers high, puis réserver Astra aux cas non résolus.
Un MVP nécessite une file, trois politiques d’effort, une fonction d’acceptation et un tableau de bord des dépenses. Il peut être vendu aux équipes opérationnelles qui paient déjà plusieurs automatisations. Mais gare à l’excès de confiance : une seule mauvaise classification sur un dossier lourd de conséquences peut effacer les économies réalisées. Le produit doit intégrer dès le premier jour des fixtures rejouables et une reprise en main manuelle.
3. Une couche d’acceptation pour les agents documentaires
ai document analysis génère environ 1,000 recherches mensuelles aux États-Unis et affiche un CPC de $10.44. Il ne s’agit pas de créer un énième écran de dépôt et de résumé. Le produit doit vérifier que l’agent documentaire a trouvé tous les champs requis, conservé les citations, rapproché les totaux et signalé ses incertitudes.
La première version peut prendre en charge un seul lot récurrent, par exemple des contrats fournisseurs ou des PDF financiers mensuels, avec un schéma fixe et une file d’exceptions. GPT-6.1 Sol traite l’analyse répétitive ; seuls les cas litigieux ou incomplets partent vers Astra. La difficulté tient à la spécialisation métier. Un produit horizontal trop large paraîtra générique, tandis qu’un lot ciblé assorti de contrôles crédibles peut gagner la confiance des utilisateurs.
Quand conserver GPT-6 Sol ou payer pour Astra
Conservez GPT-6 Sol lorsque la compatibilité est le facteur décisif. Il accepte toujours le niveau de raisonnement none et peut appeler des fonctions via Chat Completions lorsque reasoning_effort vaut none. Ce n’est pas le cas de GPT-6.1 Sol. Un parcours stable qui repose sur ces comportements doit changer de route API et réussir les tests de régression avant de changer de modèle.
Choisissez GPT-6 Astra lorsque le meilleur résultat compte davantage que la facture de tokens. OpenAI le présente comme son modèle le plus performant pour les tâches de raisonnement, de codage, de contrôle d’ordinateur, de recherche et de création de documents les plus exigeantes. Réservez-le aux cas ambigus et à forte valeur pour lesquels votre évaluation fixe démontre un gain substantiel. Aux tarifs Standard, Astra coûte $10 en entrée et $50 en sortie par million de tokens, contre $2 et $10 pour GPT-6.1 Sol.
Utilisez GPT-6.1 Sol pour le vaste milieu du spectre : des tâches sérieuses, répétitives, exécutées via Responses et assorties d’un critère de réussite mesurable. Les évaluations de lancement d’OpenAI montrent des résultats supérieurs à GPT-6 Sol sur plusieurs workloads difficiles, mais elles restent conduites par le fournisseur. Votre propre taux de résultats acceptés doit servir de feu vert pour la mise en production.
Les limites qui imposent d’adapter la configuration
GPT-6.1 Sol ne remplace pas tous les parcours. Il ne propose ni effort none ni minimal, n’appelle pas d’outils via Chat Completions, ne prend pas en charge le fine-tuning, n’accepte ni audio ni vidéo en entrée et n’est pas disponible dans le Chat classique au lancement. Les outils payants ajoutent leurs propres frais. Au-delà de 272,000 tokens d’entrée, l’intégralité de la requête passe aussi aux tarifs supérieurs du contexte long : une fenêtre de 1,050,000 tokens ne doit donc pas être considérée comme un espace de travail gratuit.
Ultrafast constitue l’autre limite à prendre en compte. OpenAI a annoncé une génération de tokens jusqu’à 8x plus rapide que la vitesse standard dans Codex, mais l’a présentée comme une fonction à venir. Tant qu’elle n’apparaît pas dans votre compte et votre client, planifiez avec Standard ou Fast et mesurez la latence réellement obtenue.
Ce qu’il faut faire lundi
Prenez cinq missions récemment menées à bien par votre agent actuel : une réussite facile, deux tâches ordinaires, une tâche fortement dépendante des outils et un échec connu. Rejouez les mêmes fixtures avec GPT-6.1 Sol au niveau medium, sans modifier les prompts ni les autorisations. Notez la réussite ou l’échec, le temps écoulé, les tokens d’entrée nouveaux et en cache, les tokens de sortie, les nouvelles tentatives et les frais d’outils.
Ensuite, routez les tâches au lieu de proclamer un vainqueur. Descendez les travaux bornés vers low s’ils passent toujours. Ne testez high que sur les échecs qui exigent davantage de raisonnement. Gardez sur GPT-6 Sol les appelants bloqués par la compatibilité. N’envoyez à Astra que les cas coûteux restants, lorsque l’amélioration du taux d’acceptation justifie le prix. Vous obtenez ainsi une décision de production dès cette semaine, pas une simple opinion sur un modèle.
Questions fréquentes
Qu’est-ce que GPT-6.1 Sol ?
GPT-6.1 Sol est le modèle moins coûteux d’OpenAI pour les tâches complexes de codage, de contrôle d’ordinateur et de travail professionnel. Son identifiant API est gpt-6.1-sol, et l’appel d’outils passe par l’API Responses.
Qu’est-ce qu’un agent IA de codage ?
Un agent IA de codage peut inspecter un dépôt, modifier des fichiers, exécuter des commandes et des tests, puis rendre compte du résultat dans le cadre des autorisations définies. La bonne unité de valeur est un résultat testé, pas seulement du code généré.
ChatGPT dispose-t-il d’un agent de codage ?
Oui. Codex est l’agent de codage d’OpenAI, et GPT-6.1 Sol est proposé dans le cadre du déploiement des offres payantes. Le modèle est aussi présent dans ChatGPT Work, mais pas encore dans le Chat classique.
GPT-6 Sol est-il moins cher ?
Pas pour les entrées nouvelles ni pour les sorties : les deux modèles Sol affichent $2 en entrée et $10 en sortie par million de tokens Standard. GPT-6.1 Sol bénéficie du tarif d’entrée en cache le plus bas. Le comparatif complet des modèles Sol détaille cet écart de prix et de compatibilité.
Pour faire concevoir, tester et déployer l’un de ces parcours agentiques dans votre entreprise, découvrez les systèmes d’IA en production.
- Dernière mise à jour
- 30 sept. 2026
- Catégorie
- AI
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
GPT-6.1 Sol vs GPT-6 Sol : le comparatif avant de migrer
GPT-6.1 Sol ou GPT-6 Sol ? Comparez le coût du cache, les performances, le raisonnement et les appels d’outils pour décider si la migration vaut le coup.30 sept. 2026AI
Claude Sonnet 5.5 : guide pratique, réglages et cas d’usage
Apprenez à utiliser Claude Sonnet 5.5, à régler son niveau d’effort et à migrer l’API grâce à des workflows fiables, des coûts réels et des garde-fous.28 sept. 2026AI
GLM-5.3-Flash ou Jev : quel modèle de décision IA choisir ?
Jev réduit le coût du routage texte, tandis que GLM-5.3-Flash gère les images. Comparez prix, latence, précision et contraintes avant de choisir.27 sept. 2026AI
Claude Opus 5.5 ou Opus 5 : prix, code et migration
Claude Opus 5.5 coûte moins cher, mais cinq changements d’API compliquent la migration. Comparez les prix, le code, le thinking et les critères de choix.23 sept. 2026AI
GPT-6 Sol ou Luna : quel modèle choisir ?
GPT-6 Sol ou Luna : comparez prix, usages, limites et coût par résultat accepté pour choisir le bon modèle sans payer 20× plus cher par défaut.23 sept. 2026AI
GPT-6 Luna gratuit : accès, limites et tarifs API
GPT-6 Luna gratuit à l’essai dans l’app desktop : découvrez les comptes compatibles, les limites connues, l’accès à Codex et les tarifs de l’API.22 sept. 2026AI
MiMo AI : comment utiliser Xiaomi MiMo V2.6 et son API
Testez MiMo AI dans Studio, choisissez la bonne clé et le bon modèle, puis lancez un premier workflow métier fiable avec l’API Xiaomi MiMo V2.6.22 sept. 2026AI