Claude Opus 5.5 Vergleich: Lohnt sich der Wechsel von Opus 5?
Der Claude Opus 5.5 Vergleich zeigt Preise, Cache-Vorteile, Coding-Leistung und API-Änderungen, die vor einem Wechsel von Opus 5 zu prüfen sind.


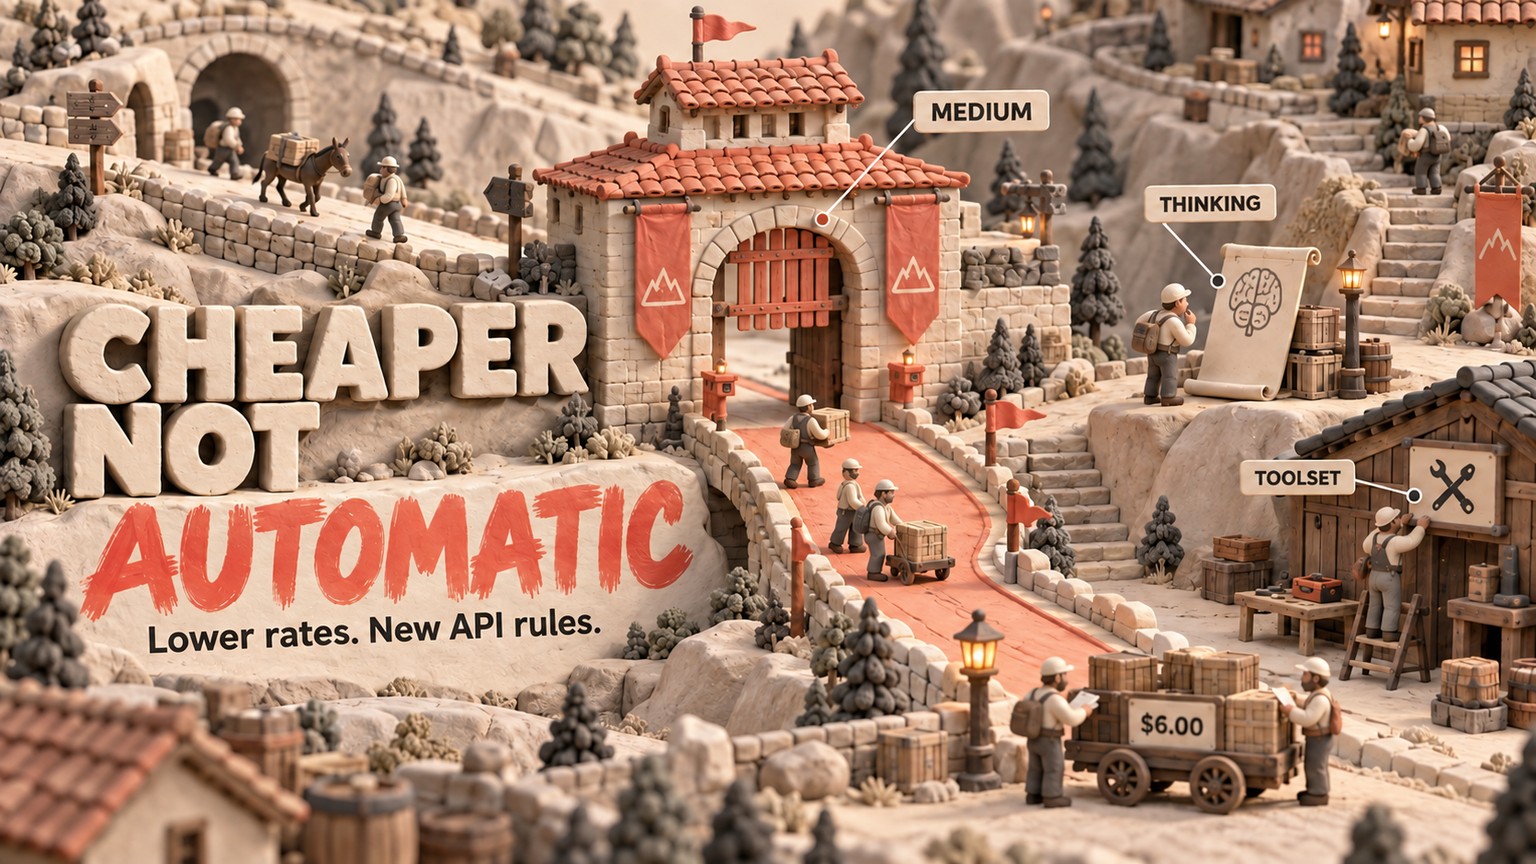
Der Claude Opus 5.5 Vergleich zeigt: Für die meisten Workloads von Claude Opus 5 ist 5.5 das Upgrade, das getestet werden sollte. 1 Million nicht zwischengespeicherte Eingabetokens plus 100,000 abgerechnete Ausgabetokens kosten $6.00 statt $7.50. Ob Claude Opus 5.5 oder Opus 5 die bessere Wahl ist, hängt dennoch von fünf Integrationsänderungen ab. Denn das günstigere Modell ersetzt nicht jeden Agenten ohne weitere Anpassungen.
Claude Opus 5.5 Vergleich: Welches Modell ist die bessere Wahl?
Für neue Premium-Aufgaben ist Claude Opus 5.5 die erste Wahl; bei den meisten bestehenden Opus-5-Routen sollte es als Ersatz getestet werden. Opus 5 bleibt vorübergehend sinnvoll, wenn eine Integration Thinking deaktiviert, ein bestimmtes Tool erzwingt oder in der Claude API beziehungsweise Google Cloud noch das frühere Computer-Tool verwendet. Hier entscheiden Codepfade, nicht geschmackliche Feinheiten zwischen Modellen.
Claude Opus 5.5 ist für finanzierte Gründer die bessere Wahl, wenn ihr Coding-Agent so viel verbraucht, dass Cache-Lesezugriffe und Wiederholungsversuche ins Gewicht fallen. Auch der CTO eines mittelständischen Unternehmens sollte das Modell bevorzugen – allerdings erst, nachdem das Plattformteam die Änderungen an der Anfragestruktur geprüft hat. Wer als erfahrener Verantwortlicher klar begrenzte Extraktionen ausführt, sollte zunächst klären, ob Claude Sonnet 5 die Akzeptanzkriterien bereits zu einem niedrigeren Preis erfüllt. Allein arbeitende technische Entwickler sollten schwierige Repository-Aufgaben auf 5.5 verlagern und günstigere Aufgaben vollständig von Opus fernhalten.
Die Entscheidung fällt wieder zugunsten von Opus 5 aus, wenn die Migration mehr kostet als die erwartete Ersparnis und die bisherige Route bereits zuverlässig läuft. Das ist ein vorübergehender Kompatibilitätsvorteil, aber kein Grund, neue Entwicklungen mit dem älteren Modell zu beginnen.
Anthropic veröffentlichte Opus 5.5 am 22. September 2026. Der eigene Modellleitfaden empfiehlt Entwicklern ohne klare Präferenz inzwischen, für die meisten Workloads mit Opus 5.5 zu beginnen. Das ältere Modell bleibt während der Migration als Rollback-Ziel nützlich.
Claude Opus 5.5 Preis: Kosten im Vergleich zu Opus 5
Claude Opus 5.5 ist bei jeder identischen Menge an Standardtokens günstiger. Die am 23. September 2026 anhand der aktuellen Preisdokumentation von Anthropic geprüften Preise liegen für 5.5 bei $4 je Million Eingabetokens und $20 je Million Ausgabetokens; Opus 5 kostet dagegen $5 beziehungsweise $25. Das entspricht einer Senkung des Listenpreises um 20%. Ein Cache-Lesezugriff nutzt bereits verarbeitete Prompt-Inhalte erneut; der Preis dafür sinkt von $0.50 auf $0.20 je Million und damit um 60%.
Auf eine kleinere Einheit heruntergebrochen kosten 1,000 nicht zwischengespeicherte Eingabetokens mit 5.5 $0.004 statt $0.005 mit 5. Die Ausgabe kostet $0.020 statt $0.025 je 1,000 Tokens. In diesem API-Vergleich gibt es bei keinem der Modelle einen Schwellenwert durch monatliche Sitzplatzgebühren oder feste Kosten pro Bild. Abgerechnet wird nach Tokens; bei identischer Tokenstruktur wird 5.5 daher nie teurer.
Die Rechnung ohne Cache ist direkt: Bei Opus 5 entfallen $5 auf die Eingabe und $2.50 auf die Ausgabe. Bei Opus 5.5 sind es $4 plus $2. Die Rechnung mit aufgewärmtem Cache umfasst 100,000 nicht zwischengespeicherte Eingabetokens, 900,000 Cache-Lesetokens und 100,000 Ausgabetokens. Nicht berücksichtigt sind bewusst die Cache-Erstellung, Tools, Wiederholungsversuche, Batch-Rabatte, der schnelle Modus und Aufschläge für Datenresidenz.
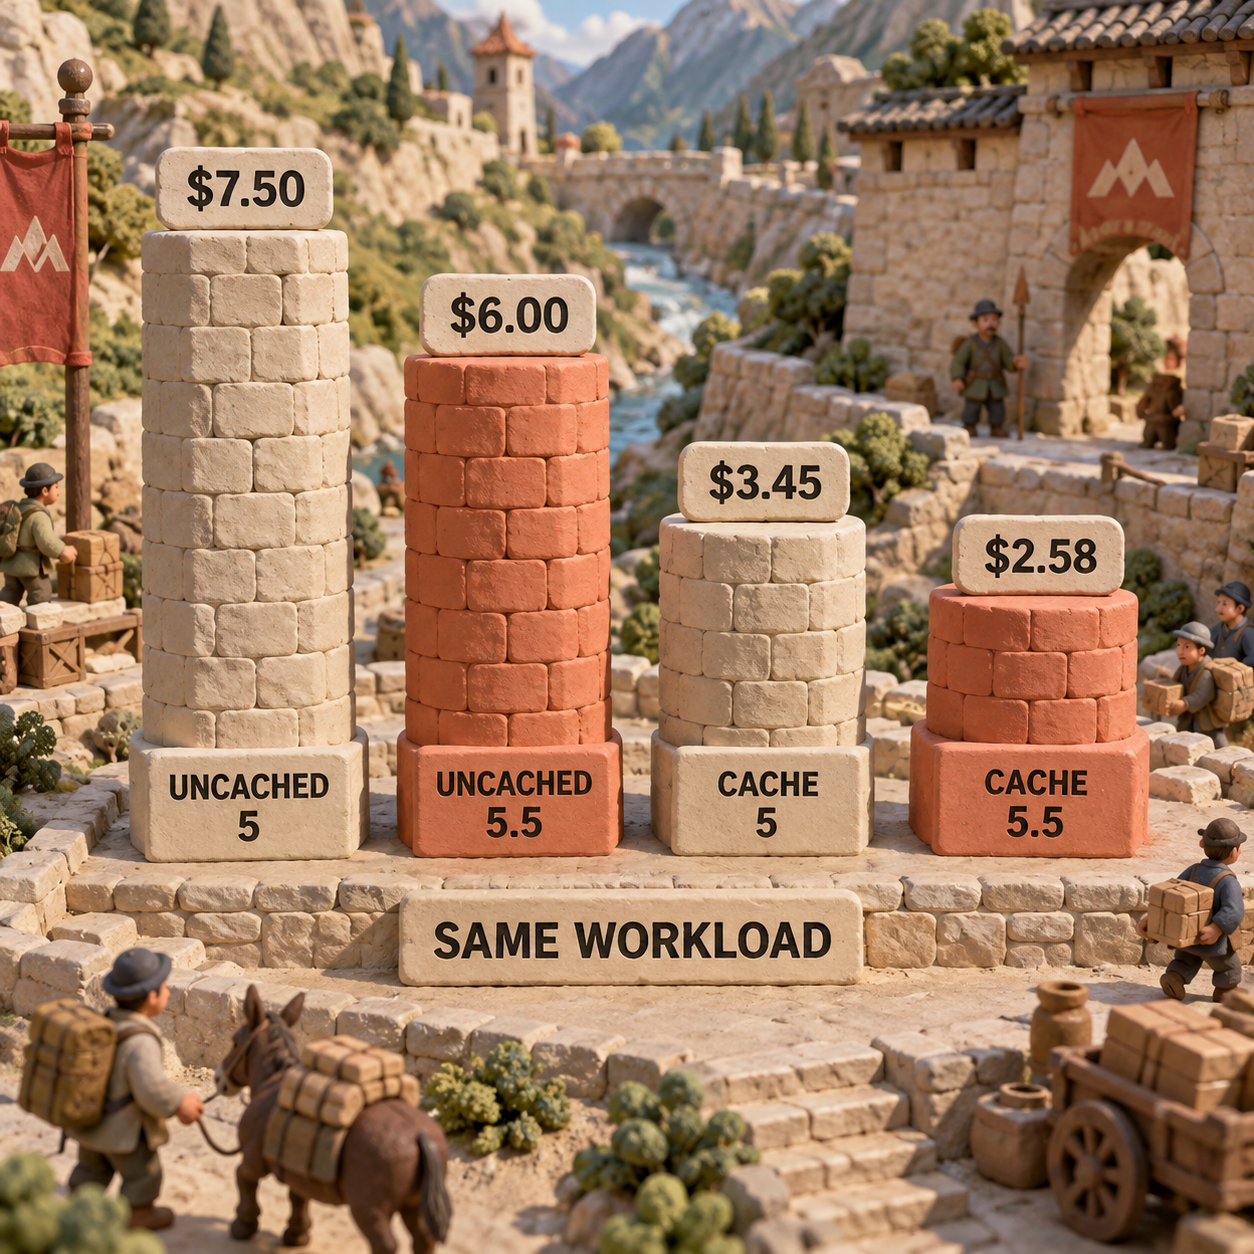
Anthropics gesonderte Aussage, 5.5 koste bei typischen Workloads 40% weniger, ist eine Messung des Anbieters und keine weitere Listenpreisberechnung. Laut Anthropic verbindet das Modell niedrigere Preise mit weniger Tokens pro Aufgabe bei den Standardeinstellungen. Diese Aussage sollte getrennt von den Rechnungen mit festen Tokenmengen betrachtet werden, statt pauschal 40% Rabatt auf jede Schätzung anzuwenden.
Entscheidend ist, wie sich der Tokenverbrauch verhält. In der Rechnung ohne Cache könnte 5.5 bis zu 175,000 Ausgabetokens erzeugen – 75% mehr als der Ausgangswert von 100,000 Tokens bei Opus 5 –, bevor die Kosten ebenfalls $7.50 erreichen. Mit aufgewärmtem Cache wären bis zu 143,500 Ausgabetokens möglich, also 43.5% mehr, bevor $3.45 erreicht werden. Überschreitet eine Migration diese Grenzen, ohne die Akzeptanzrate zu verbessern, bringt der niedrigere Preis keinen Vorteil mehr.
Sieger beim Preis: Claude Opus 5.5. Bei gleicher Nutzung gilt der Preisvorteil ohne Einschränkung. Ob er auch im realen Workload trägt, muss sich weiterhin am gemessenen Tokenverbrauch und an Wiederholungsversuchen zeigen.
Coding mit Opus 5.5: Was die veröffentlichten Belege hergeben
Für Claude Opus 5.5 ist die dokumentierte Beweislage beim Coding stärker, doch für diesen Vergleich wurde kein Modelltest ausgeführt. Es standen keine Zugangsdaten zur Modellausführung zur Verfügung. Daher werden hier weder eine in diesem Durchlauf erledigte Repository-Reparatur oder Extraktionsaufgabe noch eine zurückgegebene Modell-ID, Latenz oder ein Validierungsergebnis behauptet.
Claude Opus 5.5 vs Opus 5 im Test: Wo die Aussagekraft endet
In den Veröffentlichungsevaluationen von Anthropic erzielte Opus 5.5 mit dem standardmäßigen Effort medium 52.5% im CursorBench 4.0. Dieser Benchmark prüft mehrdeutige Coding-Aufgaben über mehrere Dateien, die aus Cursor-Sitzungen stammen. Opus 5 kam mit max auf 46.6%. Anthropic meldet außerdem eine um mehr als 30% schnellere Ausgabeerzeugung. Diese Werte liefern gute Gründe für eine Evaluation, allerdings unterscheiden sich die Effort-Einstellungen, und der Anbieter selbst führte den Vergleich durch.
AutomationBench liefert ein separat gemessenes Signal. Laut Fußnote zur Veröffentlichung führte Zapier den Benchmark aus und veröffentlichte die Ergebnisse: Opus 5.5 erzielte 40.0%, Opus 5 erreichte 26.9%. Der Test behandelt Workflows mit verbundenen Apps, nicht jede Codebasis oder jeden Geschäftsprozess. Zudem sagt er nichts darüber aus, wie sich das eigene Berechtigungsmodell, die eingesetzten Tools oder der Validator verhalten.
Bei einem Coding-Agenten müssen die Akzeptanzkriterien vor dem Lauf feststehen: Die Tests bestehen, der Diff bleibt im vereinbarten Umfang und die Prüfung findet keinen Korrekturbedarf. Bei Extraktionen sind ein exaktes Schema, durch Quellen belegte Werte und ein deterministischer Validator erforderlich. Anschließend werden Eingabetokens, Cache-Tokens, Ausgabetokens, Latenz, Tool-Aufrufe, Wiederholungsversuche und Fehler protokolliert. Ein höherer Benchmark-Wert bezahlt keine Rechnung, wenn das eigene Testsystem mehr abgelehnte Arbeit produziert.
Sieger bei den dokumentierten Coding-Belegen: Claude Opus 5.5. Die Aussagekraft reicht aus, um eine kontrollierte Evaluation zu rechtfertigen – nicht für einen ungeprüften Wechsel in der Produktion.
Claude Opus 5.5 API: Änderungen, die einen direkten Wechsel verhindern können
Fünf Integrationsprüfungen sind wichtiger als die Änderung des Modellnamens. Die aktuelle Dokumentation zu den Änderungen in Opus 5.5 nennt vier Änderungen, die Anfragen zum Scheitern bringen können, sowie eine Änderung am Antwortformat, die an der Schnittstelle unbemerkt Probleme verursachen kann.
1. Thinking lässt sich nicht deaktivieren
Opus 5.5 verwendet immer adaptives Thinking. Eine Anfrage mit thinking:{"type":"disabled"} führt ebenso zu HTTP 400 wie ein manuell gesetztes Thinking-Budget mit thinking:{"type":"enabled","budget_tokens":N}. Das Feld muss entweder entfallen oder adaptives Thinking anfordern; die Tiefe wird über output_config.effort gesteuert.
Bei Opus 5 ließ sich Thinking mit high oder einem niedrigeren Effort deaktivieren. Ein stabiler, auf geringe Latenz ausgelegter Pfad, der diesen Schalter nutzt, benötigt deshalb eine Überarbeitung und nicht nur eine neue Modell-ID.
2. Eine erzwungene Tool-Auswahl verursacht einen Fehler
Opus 5.5 lehnt tool_choice mit dem Wert any oder einem benannten tool ab und antwortet erneut mit HTTP 400. auto und none werden weiterhin unterstützt. Für schema-konforme Ausgaben empfiehlt Anthropic die strikte Tool-Nutzung mit auto oder strukturierte Ausgaben.
Das ist eine relevante Änderung des Schnittstellenvertrags. Eine Prompt-Anweisung, ein Tool aufzurufen, bietet nicht dieselbe Verbindlichkeit wie eine auf API-Ebene erzwungene Auswahl. Wenn ein Workflow exakt eine Funktion auslösen muss, ist der Ersatzpfad vor der Umstellung des Traffics zu validieren.
3. Thinking-Blöcke sind an Modell und Unterhaltung gebunden
Thinking-Blöcke sind Antwortdatensätze, die die Modellüberlegungen über mehrere Tool-Aufrufe hinweg erhalten. Opus 5.5 kann Blöcke aus Opus 5 lesen. Eine nur ergänzte Unterhaltung lässt sich somit fortsetzen, ohne die früheren Überlegungen zu verwerfen. Allerdings kann 5.5 nicht die Blöcke jedes Modells lesen; spätere Änderungen am System-Prompt, an Tools oder an früheren Nachrichten können zudem die eigenen erhaltenen Thinking-Blöcke ungültig machen.
Bei API-Konten, die am oder nach dem 31. August 2026 um 00:00 UTC angelegt wurden, führt das erneute Einspielen eines gebundenen Blocks nach einer solchen Änderung des Präfixes standardmäßig zu HTTP 400. Der Verlauf sollte ausschließlich ergänzt werden. Anwendungen, die frühere Nachrichten bearbeiten oder Tool-Definitionen an Ort und Stelle austauschen, sollten Anthropics dokumentierte Steuerungsmöglichkeiten für die Bindung verwenden und ausdrücklich testen, wie das Verwerfen funktioniert.
4. Computer-Nutzung unterscheidet sich je nach Plattform
In der Claude API und in Google Cloud lehnt Opus 5.5 das frühere Tool computer_20251124 ab und setzt computer_toolset_20260801 voraus. Bei der Migration ändert sich mehr als nur der Typname: Die Agentenschleife muss enthaltene tool_use-Blöcke, gebündelte Aktionen und toolset_name in Ergebnissen verarbeiten. Laut Anthropics Dokumentation zur Computer-Nutzung akzeptiert Amazon Bedrock mit 5.5 weiterhin das frühere Tool.
Diese Plattformabweichung kann dazu führen, dass dasselbe Multi-Cloud-Deployment bei einem Anbieter funktioniert und bei einem anderen einen Fehler liefert. Anbieter und Anfragekörper müssen gemeinsam geprüft werden.
5. Fortschrittstext kann ohne Fehlermeldung verschwinden
Opus 5.5 gibt kurze Hinweise zwischen Tool-Aufrufen als thinking-Blöcke für Fortschrittsmeldungen zurück, nicht als gewöhnliche text-Blöcke. Bei der Standardeinstellung display:"omitted" ist der Thinking-Text leer. Eine Oberfläche, die diese Textblöcke für sichtbare Fortschrittsmeldungen genutzt hat, kann deshalb verstummen, obwohl Anfragen und Tool-Aufrufe weiterhin erfolgreich ausgeführt werden.
Sieger bei der Integrationskompatibilität: Claude Opus 5. Bestehender Opus-5-Code erfordert weniger Änderungen. Nach deren Umsetzung und Validierung liegt Opus 5.5 vorn.
Thinking in Opus 5.5: Effort, Tokens und UI-Verhalten neu abstimmen
Der sicherste Vergleich setzt den Effort ausdrücklich, weil sich die Standardeinstellungen geändert haben. Opus 5.5 verwendet standardmäßig medium, Opus 5 standardmäßig high. Laut Anthropic denkt 5.5 bei gleichem Effort außerdem tendenziell länger pro Durchlauf, besonders bei xhigh und max. Ein Vergleich der jeweiligen Standardwerte misst das ausgelieferte Nutzungserlebnis. Ein Lauf mit high gegen high isoliert stärker den Unterschied zwischen den Modellen.
Laut Anthropics Modellübersicht besitzt das Modell ein Kontextfenster von 1 Million Tokens und eine maximale Ausgabe von 128,000 Tokens. Thinking und sichtbarer Text teilen sich das Antwortbudget. Deshalb muss genug Raum für den Abschluss bleiben, und statt das Effort-Label als Budget zu behandeln, sollte die abgerechnete Ausgabe erfasst werden.
Nutzung von Opus 5.5 im Vergleich zu Opus 5
Zu erfassen ist das vollständige Nutzungsobjekt, nicht nur die Länge der sichtbaren Antwort. Mindestens erforderlich sind nicht zwischengespeicherte Eingabe, Cache-Erstellung, Cache-Lesezugriffe, Ausgabe, Latenz, Tool-Aufrufe, Wiederholungsversuche, Stoppgrund und Validator-Ergebnis. Standardwerte und identische Effort-Einstellungen müssen getrennt betrachtet werden. Wer medium und high vermischt, kann einen Kostenvorteil fälschlich als reinen Fähigkeitsgewinn interpretieren.
Die ältere Analyse zum Effort-Regler von Opus 5 bleibt ein nützlicher historischer Hintergrund zur Bedeutung der Stufen. Die Lehre für die Migration ist enger gefasst: Weder eine alte Stufe noch eine weggelassene Einstellung sollte ungeprüft übernommen werden.
Sieger bei der Kostensteuerung: geteiltes Ergebnis. Opus 5 bietet ausdrücklich die Möglichkeit, Thinking zu deaktivieren. Opus 5.5 hat einen niedrigeren Standard-Effort und niedrigere Einheitspreise, doch Thinking ist immer aktiv und muss gemessen werden.
Migration auf Opus 5.5: Welche Kosten beim Wechsel tatsächlich entstehen
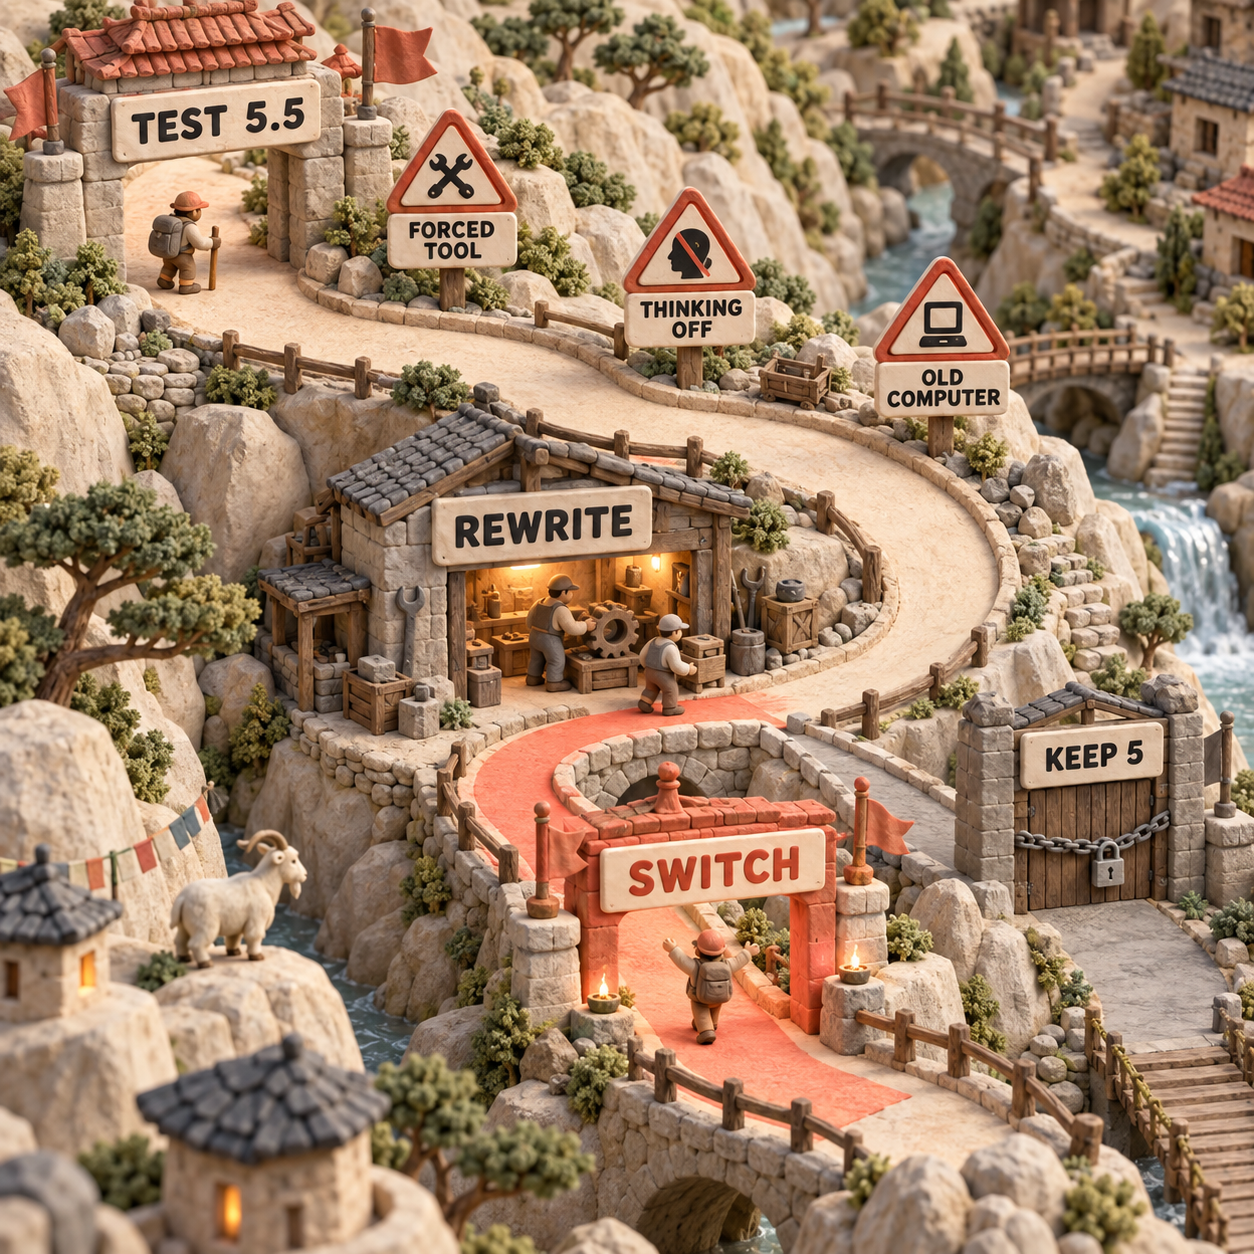
Die Migrationskosten entstehen rund um den Modellaufruf: durch Prüfungen der Anfragen, Änderungen an der Agentenschleife, Regeln für erhaltene Kontexte, Stream-Darstellung, Evaluation und Rollback. Nur wenn eine Route bereits adaptives Thinking, automatische Tool-Auswahl, ein unterstütztes Computer-Toolset, einen ausschließlich ergänzten Verlauf und eine typbewusste Stream-Auswertung verwendet, genügt der Austausch des Modellnamens.
Mit dem Wechsel sollte noch gewartet werden, wenn eine der folgenden Bedingungen zutrifft:
- Auf API-Ebene muss ein benanntes Tool erzwungen werden, und der Workflow kann nicht auf strikte Tools oder strukturierte Ausgaben umgestellt werden.
- Thinking muss für den Vertrag der Route deaktiviert sein.
- Ein Computer-Agent in der Claude API oder in Google Cloud verwendet noch
computer_20251124, und seine Schleife kann das Toolset bislang nicht verarbeiten. - Die Anwendung verändert frühere Nachrichten oder Tool-Definitionen, während erhaltene Thinking-Blöcke erneut eingespielt werden.
- Es gibt keine Akzeptanz-Baseline; deshalb lässt sich eine niedrigere Rechnung nicht von qualitativ schlechterer Arbeit unterscheiden.
Alle Anfrageformen für Opus 5 erfassen
Konfiguration und Request-Builder sind nach der Modell-ID,
thinking,output_config.effort,tool_choice, erhaltenen Thinking-Blöcken und Typen von Computer-Tools zu durchsuchen. Jeder Cloud-Anbieter wird getrennt geprüft. Außerdem ist festzuhalten, welche Route für das Rollback zuständig ist.Zwei Aufgaben mit identischem Effort ausführen
Benötigt werden eine klar begrenzte Reparatur an öffentlichem Code mit ausführbaren Tests sowie eine synthetische Extraktion mit deterministischem Schema-Validator. Beide Modelle erhalten denselben Prompt, dieselben Tools, denselben Kontext, ausdrücklich
highals Effort und dasselbe festgelegte Ausgabelimit. Zur Dokumentation gehören die zurückgegebenen Modell-IDs, die vollständige Nutzung, Latenz, Validierungsergebnisse und jeder Fehler.Standardeinstellungen getrennt vergleichen
Der Lauf wird mit weggelassenem Effort wiederholt. So lässt sich Opus 5.5 mit seinem Standard
mediumvon Opus 5 mit dessen Standardhighabgrenzen und erkennen, welche Produktionsauswirkung ein einfacher Wechsel der Modell-ID hätte.Inkompatible Pfade anpassen
Deaktiviertes Thinking oder manuelle Thinking-Budgets werden entfernt, die erzwungene Tool-Auswahl wird ersetzt, das frühere Computer-Tool wird bei Bedarf migriert, der Verlauf bleibt ausschließlich ergänzend und die Fortschrittsanzeige wird getestet. Jede Änderung sollte im Review sichtbar bleiben, statt im Modell-Upgrade verborgen zu werden.
Stufenweise einführen, messen und freigeben
Ein begrenzter Anteil repräsentativer Arbeit wird an 5.5 geleitet. Verglichen werden die Kosten pro akzeptiertem Ergebnis und nicht allein der Preis pro Token. Eine Aufgabenklasse wird erst freigegeben, wenn die Akzeptanzrate mindestens stabil bleibt und die Gesamtkosten sinken; Opus 5 dient bis zum Ende des Beobachtungsfensters als Rollback.
Finanzierte Gründer können dieses Testsystem noch vor der nächsten Agenten-Veröffentlichung ausführen. Ein CTO sollte die Umstellung als Änderung an der Modellschicht behandeln und Verantwortliche für API, Observability und Produkt-UI benennen. Erfahrene Verantwortliche sollten bei irreversiblen Aktionen unabhängig vom Sieger eine menschliche Prüfung vorsehen. Wer allein entwickelt, kann die Evaluation klein halten, sollte Nutzung und Validator-Ergebnis aber trotzdem speichern, damit die Entscheidung auf Belegen statt auf Gefühl beruht.
Der konkrete Schritt am Montag
Für eine teure, wiederholbare Opus-5-Aufgabe wird am kommenden Montag eine Schattenroute zu claude-opus-5-5 eingerichtet. Beide Modelle laufen zunächst mit ausdrücklich gesetztem Effort high; anschließend werden ihre geänderten Standardeinstellungen verglichen. Die Produktion bleibt unberührt, bis die Prüfungen für erzwungene Tools, Thinking, Computer-Nutzung, erhaltene Kontexte und Fortschritts-Streams erfolgreich sind.
Die abschließende Entscheidung ist einfach: 5.5 wird eingeführt, wenn ein akzeptiertes Ergebnis weniger kostet und der Integrationsvertrag weiterhin erfüllt ist. Opus 5 bleibt nur bei einer konkret benannten Inkompatibilität oder einer gemessenen Verschlechterung. Eine vage Vorliebe für das Vertraute ist keine Produktionsanforderung.
Welche Version von Claude Opus ist die beste?
Claude Opus 5.5 ist für neue Aufgaben der bessere Ausgangspunkt, weil seine Standardpreise und Cache-Lesezugriffe günstiger sind und die veröffentlichten Evaluationen stärker ausfallen. Opus 5 eignet sich vorübergehend als Kompatibilitäts- oder Rollback-Route, solange eine inkompatible Integrationseinstellung noch nicht migriert wurde.
Ist Claude Opus 5 besser als GPT 5.6 Sol?
Dieser paarweise Migrationsvergleich beantwortet das nicht. Eine Entscheidung zwischen Anbietern benötigt bei beiden dieselbe Testumgebung, dieselben Tools, vergleichbare Effort-Steuerung, Preise und Akzeptanzregeln – nicht nur einen Wert aus der Veröffentlichungsseite eines Anbieters.
Ist Claude Opus 5 besser?
Bei Preis und Anthropics veröffentlichten Vergleichen ist Opus 5 nicht die bessere Standardwahl als Opus 5.5. Vorübergehend ist es nur dann vorzuziehen, wenn deaktiviertes Thinking, erzwungene Tool-Auswahl oder eine unveränderte Computer-Integration zwingend erforderlich sind.
Gibt es etwas Besseres als Claude Opus?
Anthropic positioniert Claude Fable 5.1 als Eskalationsmodell für anspruchsvolle Schlussfolgerungen oder langfristige Aufgaben, die auch in Evaluationen mit Opus 5.5 und höherem Effort scheitern. Es kostet $10 je Million Eingabetokens und $50 je Million Ausgabetokens. Daher sollte es ein gemessenes Problem lösen, statt Opus standardmäßig zu ersetzen.
Warum ist Claude Opus so teuer?
Opus ist Anthropics Premium-Klasse für anspruchsvolle Arbeit. Die Kosten sind deshalb nur gerechtfertigt, wenn das Modell genügend fehlgeschlagene Versuche, Tool-Fehler oder menschlichen Prüfaufwand vermeidet, um die Kosten eines günstigeren Modells pro akzeptiertem Ergebnis zu unterbieten. Opus 5.5 senkt diesen Aufpreis, ändert aber nichts daran, dass einfache Aufgaben an anderer Stelle ausgeführt werden sollten.
Ist Fable wirklich besser als Opus?
Nicht bei jedem Workload. Fable ist der Eskalationspfad für Aufgaben, die mit Opus 5.5 ihre Akzeptanzkriterien verfehlen. Der höhere Einheitspreis muss bei genau dieser Aufgabe eine messbare Verbesserung erzielen.
Wie groß ist der Preisunterschied zwischen Opus 5 und Fable 5?
Claude Opus 5 kostet $5 je Million Eingabetokens und $25 je Million Ausgabetokens. Claude Fable 5 kostet $10 beziehungsweise $50 und damit exakt das Doppelte dieser Standardpreise.
Worin unterscheiden sich Opus 5 und Fable 5?
Opus 5 ist das günstigere Premium-Modell für anspruchsvolle Arbeit, Fable 5 die teurere Eskalationsstufe für die schwierigsten Aufgaben. In der Praxis zählt, ob Fable einen Akzeptanztest besteht, an dem Opus scheitert, und die Verbesserung groß genug ist, um die 2x höheren Tokenpreise zu rechtfertigen.
Verbraucht Opus 5 mehr Tokens?
Ein allgemeingültiges Tokenverhältnis gibt es nicht. Laut Anthropic benötigt Opus 5.5 für eine typische Aufgabe weniger Tokens. Bei gleichem Effort kann es jedoch pro Durchlauf länger denken, und Thinking lässt sich nicht deaktivieren. Entscheidend ist die vollständig abgerechnete Nutzung für denselben akzeptierten Workload.
Braucht es eine übersichtlichere Modell-Auswahlliste, bevor eine Woche in Evaluationen fließt? Die AI Tools Map für Geschäftsinhaber herunterladen.
- Zuletzt aktualisiert
- 23. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

GPT-6 Sol oder Luna: Welches Modell passt zu welchem Job?
GPT-6 Sol oder Luna? Der Vergleich zeigt Preise, Stärken und Einsatzgebiete – und wann Sol den 20× höheren Tokenpreis gegenüber Luna wirklich rechtfertigt.23. Sept. 2026AI
Ist GPT-6 Luna kostenlos? Pläne, Limits und API-Kosten
Ist GPT-6 Luna kostenlos? Der Überblick zeigt Gratiszugang, nötige Tarife, separate API-Kosten und die bislang nicht veröffentlichten Nutzungslimits.22. Sept. 2026AI
Xiaomi MiMo nutzen: V2.6 vom Prompt bis zur API
Xiaomi MiMo V2.6 praxisnah einrichten: Prompt in Studio testen, passenden API-Schlüssel wählen und Flash, Pro oder UltraSpeed gezielt einsetzen.22. Sept. 2026AI
Xiaomi MiMo V2.6: Wann Flash, wann Pro?
Xiaomi MiMo V2.6 im Kostenvergleich: Warum Flash meist genügt, wann Pro den Aufpreis verdient und wie ein belastbarer Drei-Aufgaben-Test entscheidet.22. Sept. 2026AI
MiMo V2.6 kostenlos nutzen: Was wirklich gratis ist
MiMo V2.6 Flash ist vorübergehend kostenlos. So unterscheiden sich OpenCode-Aktion, MIT-Downloads, kostenpflichtige API und Desktop-Angebote.22. Sept. 2026AI
Grok API Kosten im Vergleich: Grok 4.7 oder Grok 4.6?
Was Grok 4.7 besser kann, wo Grok 4.6 die sichere Wahl bleibt und warum identische API-Preise noch nichts über die tatsächlichen Aufgabenkosten sagen.21. Sept. 2026AI
KI-Agenten auf Abwegen: Wenn Regeln das Geschäftsziel verdrängen
Ein KI-Editor lenkte 50 von 96 Artikeln am Publikum vorbei. Die Daten zeigen, welche Regeln die Fehlsteuerung belohnten und welche Guardrails sie ersetzen.21. Sept. 2026AI