LangGraph im Vergleich: 8 Frameworks für KI-Agenten 2026
LangGraph, CrewAI und sechs weitere Frameworks für KI-Agenten im Vergleich: Zustand, MCP, Freigaben, Wiederaufnahme und Kosten für den Produktivbetrieb.



LangGraph ist die erste Wahl für einen zustandsbehafteten Workflow, CrewAI für ein echtes Team aus Agenten mit klaren Rollen und Mastra für einen Agenten in einer TypeScript-App. Für eine kompakte Agentenschleife, die die Anwendung selbst steuert, eignet sich das OpenAI Agents SDK. Bei diesen 8 Frameworks für KI-Agenten entscheidet vor allem, wer den Zustand, die Freigaben und die Wiederaufnahme nach Fehlern verantwortet.
Open-Source-Frameworks für KI-Agenten sparen die Abogebühr für die Bibliothek. Modellaufrufe, Hosting, Speicher und Betrieb kosten weiterhin Geld. Die hier verlinkte Dokumentation, die Lizenzen der Repositories und die Preislisten der Anbieter wurden am 7. Oktober 2026 geprüft.
Das Claude Agent SDK erfordert eine eigene Abwägung: Es bettet die Laufzeit von Claude Code samt Werkzeugnutzung in die Anwendung ein. Pydantic AI passt zu typisierten Python-Diensten, das Vercel AI SDK zu einer Weboberfläche mit Streaming und Google ADK zu einem Agentensystem im Google-Umfeld. Eine einfache Schleife mit dem SDK des Modellanbieters bleibt sinnvoll, wenn keine dieser zusätzlichen Funktionen ein konkretes Problem löst.
LangGraph im Vergleich: Frameworks für KI-Agenten im Überblick
Die Hosting-Spalte zeigt, welche Dienste sich beim jeweiligen Anbieter buchen lassen. Ein gehosteter Observability-Dienst zeichnet Ausführungen auf; eine gehostete Laufzeit führt sie aus. Das sind unterschiedliche Leistungen, auch wenn beide neben einer kostenlosen Bibliothek angeboten werden.
Die Auswahl ändert sich, sobald eine unerledigte Aufgabe die ursprüngliche Anfrage überdauern muss. Kann eine Freigabe erst morgen erfolgen oder ein Worker nach einem Schreibvorgang ausfallen, sollten Persistenz und Wiederaufnahme vor der Chatoberfläche geprüft werden. MCP, das Model Context Protocol zum Bereitstellen von Tools und Ressourcen für Agenten, garantiert diese Wiederaufnahme allein nicht.
Nach welchen Kriterien wurden die Agenten-Frameworks ausgewählt?
Die Empfehlungen beruhen auf einem Vergleich der dokumentierten Architektur, des Lizenzumfangs und der aktuellen Preise. Leistungsmessungen aus eigenen Framework-Läufen sind sie nicht.
Für die Auswahl sind sechs Fragen entscheidend:
- Ablaufmodell: Gibt der Code die Reihenfolge vor, wählt ein Modell das nächste Tool oder delegieren Spezialisten die Arbeit?
- Verantwortung für den Zustand: Was wird dauerhaft gespeichert: Nachrichten, die Position im Workflow, gemeinsames Gedächtnis, ausstehende Entscheidungen oder alles zusammen?
- Wiederaufnahme: Was passiert nach einem Prozessneustart, bei einem Tool-Timeout oder wenn der Nutzer später zurückkehrt?
- Tool-Grenzen: Lassen sich eng umrissene Anwendungsfunktionen und die benötigten MCP-Server bereitstellen?
- Menschliche Prüfung: Kann eine Person die vorgeschlagene Aktion vor der Ausführung prüfen, und lässt sich der Ablauf mit ihrer Entscheidung korrekt fortsetzen?
- Betriebskosten und Lizenz: Welche Funktionen gehören zum kostenlosen Kern, welche benötigen eine kommerzielle Vereinbarung und was rechnet der gehostete Dienst nach Verbrauch ab?
Die acht Abschnitte orientieren sich an konkreten Aufgaben im Produktivbetrieb. LangGraph ist die Standardempfehlung für den hier betrachteten zustandsbehafteten Workflow, aber kein pauschaler Sieger gegenüber einer kleineren Schleife. Ein TypeScript-Produkt, das hauptsächlich Antworten streamt, sollte nicht allein wegen dieser Empfehlung eine Graph-Laufzeit einführen.
Gehostete No-Code-Baukästen und Observability-Produkte stehen hier nicht als eigenständige Frameworks zur Auswahl. Logfire erscheint als optionales Angebot neben Pydantic AI, nicht als neuntes Framework. Spezialisierte Ökosysteme außerhalb dieser Auswahl können zu einem vorhandenen Stack passen. Sie ohne dieselbe Prüfung von Zustand, Freigaben und Preisen aufzunehmen, würde die Entscheidung jedoch erschweren.
Agenten orchestrieren: Zustand speichern und Freigaben absichern
Als Zustand zählt hier die Information, die ein anderer Worker braucht, um denselben Geschäftsvorgang korrekt fortzusetzen. Ein Orchestrierungs-Framework koordiniert die Schritte. Welche Aufzeichnungen eine sichere Fortsetzung ermöglichen, muss die Anwendung trotzdem festlegen.
Ein Erstattungsassistent macht die Unterschiede deutlich. Sein Verlauf enthält das Gespräch und die Prüfung der Erstattungsrichtlinie. Seine Position im Ablauf hält fest, dass der Anspruch geprüft wurde und die Erstattung noch aussteht. Sein Freigabevermerk dokumentiert den Betrag und die Aktion, die eine verantwortliche Person genehmigt hat. Sein Ausführungsbeleg zeigt, ob das Zahlungssystem den Vorgang angenommen hat.
Diese Aufzeichnungen beantworten unterschiedliche Fragen. Die Aussage „Erstattung freigegeben“ im Gesprächsverlauf belegt nicht, dass eine verantwortliche Person den aktuellen Betrag genehmigt hat. Ein Workflow-Checkpoint mit „Aufruf abgeschlossen“ ersetzt keinen Beleg des Zahlungssystems. Ein gespeicherter Beleg braucht außerdem eine stabile Vorgangskennung, damit ein erneuter Versuch denselben beabsichtigten Schreibvorgang erkennt.
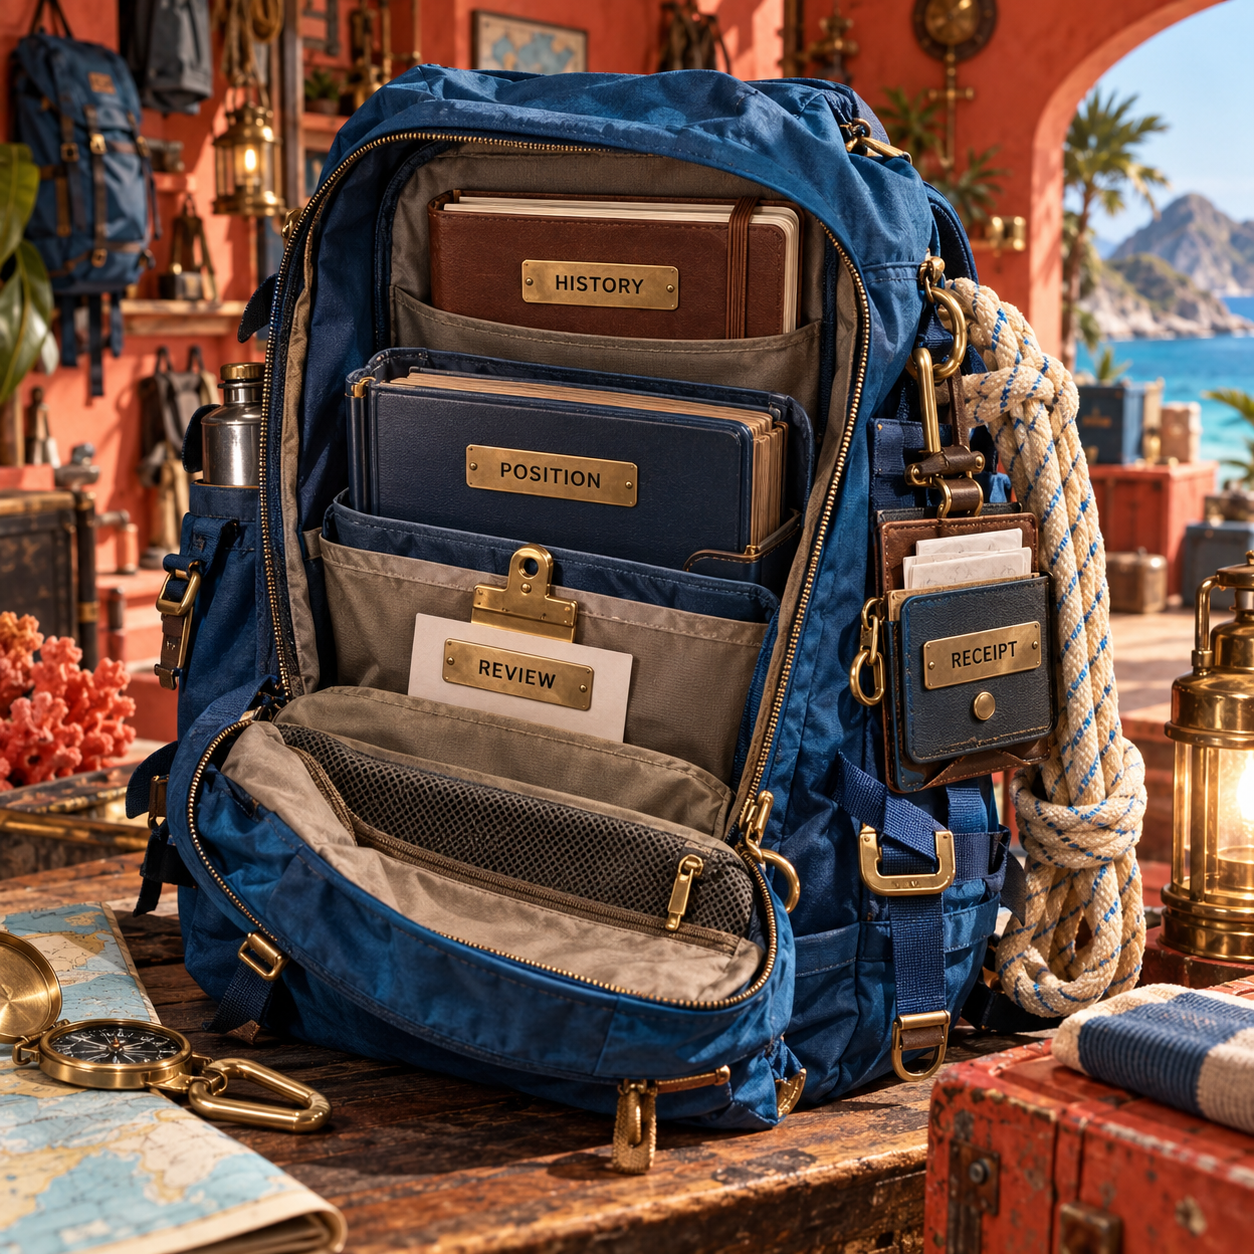
Für einen Rechercheassistenten mit rein lesendem Zugriff kann ein gespeicherter Verlauf ausreichen. Bei einem Onboarding, das auf Dokumente wartet, wird ein gespeicherter Ausführungsstand wertvoll. Für eine Erstattung oder Kontoänderung gehören Freigabe und externer Ausführungsbeleg schon vor dem Start zum Entwurf.
An dieser Stelle müssen auch Versprechen zur menschlichen Prüfung genau betrachtet werden. Ein Prompt, der das Modell zur Vorsicht auffordert, ist eine Anweisung. Eine Tool-Sperre, die vor der Ausführung auf eine Entscheidung wartet, ist eine Kontrollfunktion. Eine Freigabeoberfläche hilft im Betrieb, wenn sie die genauen Argumente zeigt, die prüfende Person authentifiziert, die Entscheidung speichert und nach einem Neustart wieder verfügbar ist.
Das SDK kann die Unterbrechung oder Freigabeanfrage bereitstellen. Für die Befugnis der prüfenden Person und die Gültigkeit der Aktion bleibt das Produkt verantwortlich. Ändert sich der angefragte Betrag nach der Freigabe, darf die frühere Entscheidung den neuen Betrag nicht stillschweigend autorisieren. Diese Regel gehört in den Anwendungsvertrag, unabhängig vom gewählten Framework.
Welches Framework passt zu welcher Aufgabe im Produktivbetrieb?
1. LangGraph: für mehrstufige Workflows mit gespeichertem Zustand
LangGraph ist der beste Ausgangspunkt, wenn der Agent einen Workflow bildet und dessen Ausführungsstand entscheidend ist. Es handelt sich um eine Graph-Laufzeit auf niedriger Abstraktionsebene: Definiert werden die Knoten, ihre Aufgaben und die Übergänge dazwischen. Einige Knoten können gewöhnlichen Code ausführen, andere ein Modell über den nächsten Schritt entscheiden lassen. LangChain-Komponenten sind optional. Die Wahl von LangGraph zwingt also nicht dazu, jede Anwendungsoperation hinter einer zusätzlichen Abstraktion zu verstecken.
Sprache und Lizenz: Python und TypeScript/JavaScript; Kern unter MIT-Lizenz.
Besonders geeignet für: Fallbearbeitung, Onboarding oder Recherche-Workflows mit Verzweigungen, Pausen und Wiederaufnahme.
Besonderheit: Expliziter Workflow-Zustand, Thread-Checkpoints und ein separater threadübergreifender Speicher.
Preise: Kostenlose Kernbibliothek. LangSmith Developer kostet $0 pro Nutzer und Monat, Plus $39 pro Nutzer und Monat; Enterprise hat individuelle Preise. Für jeden gehosteten Tarif gelten eigene Verbrauchsregeln.
Kostenlos testen: Developer ist dauerhaft kostenlos; kostenpflichtiger Zugriff auf Deployments beginnt mit Plus.
Beim Aufbau eines Lieferanten-Onboardings ist für technisch versierte Gründer der einzelne Lieferantenfall die sinnvolle Einheit. Ein Knoten zur Dokumentenextraktion kann mögliche Feldwerte liefern, deterministischer Code sie validieren, ein Agent fehlende Nachweise anfordern und eine prüfende Person den endgültigen Datensatz freigeben. Am Graphen lässt sich erkennen, welcher Übergang wartet. Der Fortschritt muss nicht aus einem Gespräch erschlossen werden.
Zustand: Checkpointer speichern den Graphzustand eines Threads. Stores halten anwendungsspezifische Informationen über Threads hinweg, etwa das stabile Profil eines Lieferanten. Ein Checkpointer im Arbeitsspeicher verliert seinen Inhalt beim Prozessneustart; für den Produktivbetrieb braucht es daher persistenten Speicher. Große Nachweisdateien sollten außerhalb des Checkpoints liegen und dort nur referenziert werden. Sonst wächst aus einem kompakten Steuerdatensatz eine Kopie sämtlicher Artefakte. Die Dokumentation zur LangGraph-Persistenz erläutert diese Unterschiede.
Tools, MCP und menschliche Prüfung: Knoten können eigenen Anwendungscode aufrufen. LangChain-MCP-Adapter stellen dem Graphen lokale Tools über stdio oder entfernte Tools über Streamable HTTP bereit. LangGraphs interrupt() unterbricht die Ausführung; der Aufrufer übergibt mit Command(resume=...) eine Entscheidung. Entscheidend ist, dass der unterbrochene Knoten bei der Wiederaufnahme erneut von vorn beginnt. Ein externer Schreibvorgang vor dieser Pause kann dadurch nochmals ausgeführt werden. Der Leitfaden zu Interrupts beschreibt dieses Verhalten ausdrücklich.
Die Grenze liegt in der Arbeit rund um eine Laufzeit auf niedriger Abstraktionsebene: Zustandsschemata, Aufbewahrung von Checkpoints, Worker-Deployments, Änderungen am Graphen und das Verhalten bei der Wiederaufnahme bleiben eigene Aufgaben. Dauerhafte, wiederaufnehmbare Ausführung muss konfiguriert und im Entwurf berücksichtigt werden. Sie verspricht nicht, dass eine Zahlung oder E-Mail unabhängig von der Tool-Implementierung genau einmal erfolgt.
Hosting-Kosten, geprüft am 7. Oktober 2026: Developer enthält einen Nutzerplatz und 5k Basis-Traces/Monat. Plus enthält organisationsweit 10k Basis-Traces/Monat und ein kostenloses Deployment der Größe Serverless Small. Zusätzliche serverlose oder dedizierte Deployments verbrauchen Ressourcen; für Agenten mit Kundenkontakt empfiehlt der Anbieter dedizierte Deployments. Enterprise bietet individuelle Preise sowie selbst gehostete und hybride Optionen. Die aktuelle Abrechnungseinheit ist die LSU zu $1.00/LSU. Veröffentlichte Deployment-Sätze sind 0.0675 LSU/vCPU-Stunde für Laufzeit-Rechenleistung, 0.0090 LSU/GiB-Stunde für Laufzeit-Arbeitsspeicher, 0.177 LSU/vCPU-Stunde für Datenbank-Rechenleistung und 0.025 LSU/GiB-Stunde für Datenbank-Arbeitsspeicher. Die LangSmith-Preisliste ist die Quelle für diese Tarife und Verbrauchssätze.
- Explizite Übergänge machen den Stand eines offenen Geschäftsvorgangs nachvollziehbar.
- Deterministische Validierung und modellgesteuerte Arbeit können denselben Graphen nutzen.
- Checkpoints und Interrupts unterstützen zeitversetzte menschliche Entscheidungen.
- Der MIT-Kern lässt sich ohne Abo für die Hosting-Plattform betreiben.
- Persistente Checkpoints und ihre Aufbewahrung müssen selbst betrieben werden.
- Bei der Wiederaufnahme unterbrochener Knoten müssen Seiteneffekte sorgfältig platziert sein.
- Gehostete Zusammenarbeit und produktive Deployments bringen Nutzergebühren und Verbrauchskosten mit sich.
Diese kurze Anleitung eignet sich als erste Entwurfsübung, bevor ein Tool mit Schreibzugriff angeschlossen wird:
Dem Vorgang eine dauerhafte Kennung geben
Pro Lieferantenfall, Kundenanfrage oder anderem Ergebnis eine Thread-Kennung verwenden. Bei der Wiederaufnahme bleibt sie gleich; ein anderer Worker ist kein Grund für einen neuen Thread.
Entscheidungen und Artefakte trennen
Die aktuelle Phase, Referenzen auf Nachweise, die vorgeschlagene Aktion und den Freigabestatus im Zustandsvertrag speichern. Dokumente und große Ausgaben gehören in einen eigenen Speicher.
Persistente Checkpoints konfigurieren
Den In-Memory-Speicher ersetzen, bevor das Pilotprojekt eine Wiederaufnahme nach Neustarts benötigt. Die Aufbewahrung festlegen und denselben Thread für einen Ersatz-Worker verfügbar machen.
Vor dem Schreibvorgang pausieren
Mit einem Interrupt die vorgeschlagene Aktion zur Prüfung vorlegen. Nach der Freigabe ein eng umrissenes Anwendungstool mit stabiler Vorgangskennung aufrufen und das Ergebnis speichern.
Die Wiederaufnahme erproben
Den Worker während eines Modellaufrufs, beim Warten auf die Freigabe und nach dem externen Schreibvorgang neu starten. Prüfen, ob der Vorgang fortgesetzt wird und die beabsichtigte Aktion nicht doppelt erfolgt.
Fazit: LangGraph passt, wenn ein gespeicherter Workflow-Stand und die Wiederaufnahme Anforderungen des Produkts sind. Für eine kurze Anfrage, die eine vorhandene Anwendung sauber abschließen und erneut ausführen kann, ist es verzichtbar.
2. CrewAI: für echte Agententeams mit klaren Rollen
CrewAI passt zu Aufgaben mit unterschiedlichen Fachrollen und Übergaben. Die Python-Abstraktion fasst Agenten mit ihren Rollen, Zielen und Aufgaben zu Crews zusammen; Flows bilden den ereignisgesteuerten Prozess darum herum. Für den Produktivbetrieb ist es sinnvoll, eine Crew einen klar begrenzten Teil der Zusammenarbeit erledigen zu lassen und die übergeordneten Phasen dem Flow zu überlassen.
Sprache und Lizenz: Python; MIT.
Besonders geeignet für: Recherche, Analyse und Textentwürfe mit unterschiedlichen Zuständigkeiten oder Tool-Zugriffen.
Besonderheit: Zusammenarbeit nach Rollen innerhalb strukturierter Flows.
Preise: Kostenlose Open-Source-Bibliothek. Der gehostete Basic-Tarif ist kostenlos und enthält 50 Workflow-Ausführungen/Monat; Enterprise hat individuelle Preise.
Kostenlos testen: Basic ist ein kostenloser Tarif. Für Enterprise lässt sich eine Testphase anfragen; die Preisseite nennt keine öffentliche Testdauer.
Wer Briefings zu Kundenkonten erstellt, kann einem Rechercheagenten Zugriff auf Nachweise geben, einen Analyseagenten relevante Kaufsignale ermitteln lassen und einem Schreibagenten die Verantwortung für das fertige Briefing übertragen. Diese Rollen sind sinnvoll, wenn sie unterschiedliche Eingaben, Berechtigungen oder Abnahmekriterien haben. Demselben Modell drei Biografien und dieselben Tools zu geben, schafft allein noch keine drei nützlichen Spezialisten.
Zustand: Der Zustand eines Flow kann ein Dictionary oder ein Pydantic-Modell sein, also ein Python-Schema zur Validierung erwarteter Felder. Der Mechanismus @persist speichert Zustands-Snapshots; SQLite ist das standardmäßige Persistenz-Backend, eigene Implementierungen werden ebenfalls unterstützt. Gespeicherter Zustand lässt sich unter einer bestehenden Kennung wiederherstellen oder in einen weiteren Lauf verzweigen. Der Status eines Flow sollte vom Wissen eines Agenten getrennt bleiben: „Das Briefing wartet auf Prüfung“ ist Prozesszustand; „Dieser Kunde verkauft an Krankenhäuser“ ist Wissen. Die Dokumentation zu CrewAI Flows beschreibt diese Steuerungsmöglichkeiten und menschliches Feedback.
Tools und MCP: Die aktuelle MCP-Schnittstelle unterstützt die Agentenkonfiguration über mcps mit lokalem stdio sowie HTTP und SSE; zusätzlich gibt es einen Adapter. Tool-Filter sind wichtiger als die Zahl angebundener Integrationen. Ein Rechercheagent sollte Nachschlage-Tools erhalten. Ein Agent, der ein Briefing entwirft, sollte nicht automatisch Kundenkonten ändern dürfen, nur weil derselbe MCP-Server beide Funktionen anbietet.
Menschliche Prüfung: Menschliches Feedback in Flows kann die Arbeit für eine Freigabe oder Überarbeitung anhalten. Eigene asynchrone Feedback-Provider ermöglichen es, die Entscheidung außerhalb des ursprünglichen interaktiven Prozesses einzuholen. Das Prüfergebnis sollte als ausdrückliche Geschäftsentscheidung modelliert werden, mit gespeichertem Vorschlag und dokumentierter prüfender Person. Eine Rolle namens „Prüfer“ innerhalb der Crew bleibt ein Modell. Sie ersetzt keine menschliche Freigabestelle, auf die sich der Betreiber verlassen kann.
Die Grenze ist erreicht, wenn die Zusammenarbeit schneller wächst als die klaren Aufgabenvereinbarungen. Ändert ein Rechercheagent das Format seiner Nachweise, kann der Analyseagent sie unbemerkt anders auslegen. Der Schreibagent macht daraus womöglich ein selbstsicher formuliertes Abschlussdokument. Jede Übergabe braucht deshalb strukturierte Nachweise und ein konkretes Abnahmekriterium. Abschließende Schreibvorgänge gehören außerhalb einer unbeschränkten Diskussion zwischen Agenten.
Hosting-Kosten, geprüft am 7. Oktober 2026: Die aktuelle CrewAI-Preisseite führt Basic als kostenlos auf, mit visuellem Editor, KI-Copilot, GitHub-Integration und 50 Workflow-Ausführungen/Monat. Enterprise hat individuelle Preise und bietet Governance sowie Deployments auf CrewAI Cloud, in der eigenen VPC oder auf eigener Infrastruktur. Ein mittlerer Tarif mit festem Dollarpreis oder ein Aufpreis pro zusätzlicher Ausführung ist nicht veröffentlicht. Ein Bedarf von 51 gehosteten Ausführungen überschreitet das angegebene Basic-Kontingent und verlangt eine kommerzielle Absprache oder ein anderes Deployment-Konzept. Modell- und Infrastrukturkosten der Open-Source-Bibliothek fallen separat an.
- Rollen passen zu Aufgaben mit getrennten Zuständigkeiten und Nachweisübergaben.
- Flows geben der Zusammenarbeit einen klaren Prozessrahmen.
- Persistenter Flow-Zustand und menschliches Feedback sind dokumentierte Funktionen.
- Open-Source-Kern und gehostete Plattform lassen sich getrennt auswählen.
- Agenten-Personas können zusätzliche Aufrufe verursachen, ohne das Geschäftsergebnis zu verbessern.
- Rollengrenzen brauchen weiterhin typisierte Eingaben und Abnahmeregeln.
- Für gehostete Aufgaben jenseits von Basic gibt es keinen öffentlichen festen Einstiegspreis.
Fazit: CrewAI passt, wenn die Zuständigkeit von Spezialisten zur Aufgabe gehört. Bei einem festgelegten Validierungs- und Freigabeprozess sollte der Flow führen. Agentenrollen lohnen sich nur, wenn ihr Beitrag die Modellaufrufe rechtfertigt.
3. OpenAI Agents SDK: für eine Agentenschleife unter Kontrolle der Anwendung
Das OpenAI Agents SDK passt, wenn Deployment und Daten bei der Anwendung bleiben sollen, während ein kleiner Runner Modellaufrufe, Tools und Übergaben verwaltet. Eine Agentendefinition bündelt Anweisungen und verfügbare Fähigkeiten. Der Runner läuft weiter, bis der Agent eine abschließende Antwort liefert, die Aufgabe übergibt oder pausiert. Für ein Produkt, das bereits Backend, Authentifizierung und Speicher besitzt, ist das ein sinnvoller Framework-Umfang.
Sprache und Lizenz: Python und TypeScript; Open-Source-SDK unter MIT-Lizenz.
Besonders geeignet für: Eine Anwendung im OpenAI-Umfeld mit Tool-Schleife, Übergaben an Spezialisten und Prüffunktionen.
Besonderheit: Ein kompakter Runner mit vom SDK verwalteten Tools und integriertem Tracing.
Preise: Keine kostenpflichtigen SDK-Tarife pro Nutzer. Modellaufrufe und gegebenenfalls gehostete Tools werden nach Verbrauch berechnet; die eigene Laufzeit kostet separat.
Kostenlos testen: Es gibt kein SDK-Abo, das getestet werden müsste; kostenlose API-Nutzung sollte nicht vorausgesetzt werden.
Ein Agent für Kontofragen in einem bestehenden SaaS-Produkt verdeutlicht den Nutzen. Das Backend kennt bereits das Konto und die Berechtigungen des angemeldeten Nutzers. Der Agent kann Kontoinformationen nachschlagen, ein fehlendes Detail erfragen und ein eng umrissenes Tool für eine Kündigungsanfrage aufrufen. Die hilfreiche Abstraktion ist eine kontrollierte Schleife um diese Vorgänge. Eine zweite Plattform, die zur Anwendungsdatenbank werden möchte, wird dafür nicht gebraucht.
Zustand: Die offizielle Dokumentation bietet einen lokal gespeicherten Verlauf zur erneuten Übergabe, SDK-Sitzungen mit eigenem Speicher, eine Kennung der Conversations API oder die Fortsetzung über die ID einer vorherigen Antwort. Die Strategie sollte einheitlich sein. Wird der vollständige lokale Verlauf geladen und zugleich die API zur Fortsetzung desselben gespeicherten Gesprächs aufgefordert, kann Kontext doppelt erscheinen. Ein Gesprächsdatensatz dokumentiert außerdem nicht automatisch den Lebenszyklus eines davon getrennten Abrechnungsvorgangs; dieser gehört in die Anwendung.
Tools, MCP und menschliche Prüfung: Das SDK unterstützt Funktions-Tools, gehostete Tools und MCP, einschließlich SDK-verwalteter lokaler/privater Server über stdio oder Streamable HTTP. Unterbrechungen für Freigaben liefern einen wiederaufnehmbaren Zustand zurück. Die Anwendung kann den vorgeschlagenen Aufruf genehmigen oder ablehnen, diesen Zustand für eine spätere Prüfung serialisieren und denselben Lauf fortsetzen. Guardrails sind automatisierte Prüfungen; die menschliche Freigabe ist eine gesonderte Entscheidung. Laut dem offiziellen Leitfaden zur menschlichen Prüfung gelten Eingabe-Guardrails für den ersten Agenten und Ausgabe-Guardrails für den Agenten, der das Endergebnis liefert. Prüfungen sollten direkt am Tool liegen, das den Seiteneffekt auslöst.
Die Grenze liegt in der Orchestrierung, die weiterhin selbst betrieben wird. Benötigt werden ein Speicheradapter, die Verwaltung des Auftragslebenszyklus, eine Prüfoberfläche und die Möglichkeit, auf einem anderen Worker fortzusetzen. Ein wiederaufnehmbarer Lauf bedeutet nicht, dass das SDK das geschäftliche Transaktionsprotokoll übernimmt. Bestehen diese Systeme bereits, ist diese Aufteilung attraktiv. Wer einen vollständig gehosteten Agentendienst erwartet hatte, muss mehr selbst aufbauen.
Kosten, geprüft am 7. Oktober 2026: Als Beispiel für die Modellrechnung nennt die OpenAI-Preisseite für gpt-6.1-sol im Standard-Modus bei kurzem Kontext $2.00 pro 1M Eingabe-Tokens und $10.00 pro 1M Ausgabe-Tokens. Eine angenommene abgeschlossene Aufgabe mit insgesamt 20,000 nicht gecachten Eingabe-Tokens und 2,000 Ausgabe-Tokens über alle Aufrufe kostet $0.06 an Modellnutzung. Bei 5,000 Aufgaben/Monat sind das $300 vor Tools, Hosting, Speicher und Observability. Das ist ein Rechenbeispiel, keine gemessene Agentenlast; für andere Kontexte, Modi und Caching gelten andere Sätze.
OpenAI bietet daneben eine separate Agents API mit einer verwalteten Codex-Ausführungsumgebung. Sie ist kein Hosting-Tarif für beliebigen Agents-SDK-Code. Für diesen verwalteten Weg müssen Modell-, Tool-, Sandbox- und Drittanbieterkosten berücksichtigt werden, statt einen monatlichen Tarif anzunehmen. Der Vergleich von OpenAI Agents API und Agents SDK erläutert den Unterschied.
- Passt in vorhandene Anwendungs-Backends mit Python oder TypeScript.
- Tools und Übergaben geben einer kleinen Schleife eine hilfreiche Struktur.
- Freigabeunterbrechungen können eine spätere Entscheidung zurück in den Lauf führen.
- Integriertes Tracing erleichtert die Prüfung der Schleife.
- Deployment, Speicher und Freigabeoberfläche bleiben Aufgaben der Anwendung.
- Die Fortsetzung eines Gesprächs ersetzt kein vollständiges Geschäftsprozessprotokoll.
- Der Komfort eines Anbieters bedeutet keine Kostengrenze für das gesamte Framework.
Fazit: Das SDK eignet sich, wenn das Backend das System verantworten soll und der Runner die ansonsten selbst zu pflegende Schleifensteuerung abnimmt. Nach dieser Entscheidung hilft der Leitfaden zum Bau eines KI-Agenten beim Einstieg.
4. Claude Agent SDK: für Agenten, die mit Dateien und Kommandos arbeiten
Das Claude Agent SDK ist die passende Wahl, wenn der Agent mit Dateien, Kommandos und Code in der Laufzeit von Claude Code arbeiten soll. Es bettet diese Laufzeit in einen selbst betriebenen Python- oder TypeScript-Prozess ein. Das ist eine deutlich weiter reichende Entscheidung als die Installation einer Client-Bibliothek, um einen Prompt an Claude zu senden.
Sprache und Lizenz: Python und TypeScript. Die LICENSE des Python-Wrappers ist MIT; laut Anthropics SDK-Dokumentation gelten für die Nutzung die Commercial Terms, mit Ausnahme separat lizenzierter Komponenten.
Besonders geeignet für: Repository-Assistenten, Worker zur Dateiverarbeitung oder Coding-Agenten, die eine fertige Laufzeit mit Tool-Nutzung benötigen.
Besonderheit: Integrierte Datei- und Kommando-Tools, Kontextverwaltung, Sitzungen, Hooks und Subagenten.
Preise: Kein eigener SDK-Abotarif; die API-Nutzung wird nach Verbrauch berechnet. Beim separaten Angebot Claude Managed Agents kommen $0.08 pro aktiver Sitzungsstunde zu den Modell-Tokens hinzu.
Kostenlos testen: Eine SDK-Abotestphase ist nicht erforderlich. Modellzugriff und gehostete Laufzeit haben jeweils eine eigene Abrechnung.
Für einen Dienst zur Repository-Wartung kann die integrierte Laufzeit die Verzeichnisstruktur lesen, relevante Dateien prüfen und Kommandos ausführen. Ein Support-Chatbot, der Kontoinformationen nachschlägt und einen Entwurf liefert, benötigt womöglich weniger Ausführungsmöglichkeiten. Die Umgebung sollte gewählt werden, weil die Aufgabe von ihr profitiert, nicht allein deshalb, weil beide Produkte Claude verwenden.
Zustand: Das SDK schreibt Gesprächssitzungen automatisch auf die Festplatte und unterstützt Fortsetzung, ausdrückliche Wiederaufnahme und Verzweigung. Die Dokumentation trennt Gesprächspersistenz und Dateisystempersistenz: Ein fortgesetzter Gesprächsverlauf setzt bearbeitete Dateien weder zurück noch stellt er sie wieder her. Beim Umzug auf einen anderen Host werden auch die erforderlichen Sitzungsdateien gebraucht, nicht nur eine Kennung. Der Betrieb benötigt daher eine Speicher- und Workspace-Regelung, die Nachweise und Arbeitsdateien zusammenhält. Die Dokumentation zu Claude-SDK-Sitzungen erklärt diese Grenze.
Tools, MCP und menschliche Prüfung: Zu den integrierten Fähigkeiten gehören das Lesen, Schreiben und Bearbeiten von Dateien, das Ausführen von Kommandos und die Anbindung von MCP-Tools. Berechtigungsregeln und -modi steuern die automatische Ausführung; canUseTool behandelt Aufrufe, die den Freigabe-Callback der Laufzeit erreichen. Eine vorherige automatische Freigabe kann diesen Callback umgehen. Muss eine Prüfung für jeden Tool-Aufruf gelten, eignet sich ein PreToolUse-Hook. Die Zugriffsgrenzen der tatsächlichen Umgebung müssen unter Kontrolle der Anwendung bleiben. Diese Laufzeitkontrollen ersetzen keine Isolation der Kunden-Workspaces.
Die Grenze liegt in der Bindung an eine Ausführungsumgebung und die Claude-Laufzeit. Das SDK kann das Gespräch verwalten. Das Produkt muss jedoch Workspaces bereitstellen, Artefakte aufbewahren, Zugangsdaten handhaben und Prüfentscheidungen übermitteln. Wird ein Mandantenauftrag in einem frischen Container ohne seine Dateien fortgesetzt, rekonstruiert ein Sitzungsprotokoll das Dateisystem nicht.
Kosten und Bedingungen, geprüft am 7. Oktober 2026: Die SDK-Übersicht unterscheidet ausdrücklich das eingebettete Agent SDK, das direkte Claude-Client-SDK und Claude Managed Agents. Für kommerzielle Produkte verweist sie auf die Authentifizierung per API-Schlüssel. Das claude.ai-Abo eines Nutzers ist kein gehostetes Agentenkontingent, das für Kunden vorausgesetzt werden kann. Der MIT-Python-Wrapper macht die gesamte mitgelieferte Laufzeit nicht zu einem anbieterneutralen MIT-Framework.
Die Claude-Preisseite nennt für Claude Sonnet 5.5 einen Basispreis von $2/MTok für Eingaben und $10/MTok für Ausgaben, zuzüglich gesonderter Cache- und anderer Preisanpassungen. Managed Agents berechnet Standard-Modell-Tokens plus $0.08 pro Sitzungsstunde, solange der Status running ist. Leerlauf, Neuplanung und Zeit nach Beendigung werden nicht berechnet. Angenommene 100 aktive Sitzungsstunden verursachen $8 Laufzeitkosten vor Modell- und Tool-Gebühren. Das ist eine separate gehostete Ausführungsumgebung und ein anderer Betriebsmodus als der eigene Betrieb des Agent SDK.
- Integrierte Datei- und Kommandofunktionen passen zu Aufgaben in einer Arbeitsumgebung.
- Sitzungen und Verzweigungen erhalten den Gesprächskontext für Folgeaufgaben.
- Hooks und Berechtigungsfunktionen bieten sinnvolle Eingriffspunkte für Prüfungen.
- Ein separater verwalteter Dienst ist verfügbar, wenn das Hosting der Ausführungsumgebung die größere Belastung darstellt.
- Ein gespeichertes Gespräch stellt das Arbeitsdateisystem nicht wieder her.
- Die Ausführungsumgebung rund um den Agenten muss selbst betrieben oder eingekauft werden.
- Die Wrapper-Lizenz und die kommerziellen Laufzeitbedingungen müssen getrennt betrachtet werden.
Fazit: Das SDK passt zu Aufgaben, die die Fähigkeiten der Claude-Code-Laufzeit brauchen. Für eine schmale Claude-Tool-Schleife reicht das Client-SDK des Anbieters, mit eigenen Tools und eigenem Zustand in der Anwendung.
5. Mastra: für Agenten innerhalb einer TypeScript-App
Mastra passt besser, wenn ein TypeScript-Produkt mehr braucht als eine gestreamte Modellantwort: Agenten, gespeichertes Gedächtnis, Tools und wiederaufnehmbare Workflows in einem Anwendungs-Framework. Diese Grundfunktionen werden durch die Entwicklungsoberfläche Mastra Studio ergänzt. Das schafft einen sinnvollen Mittelweg zwischen einer kleinen Schleife für die Weboberfläche und einer bewusst niedrig abstrahierten Workflow-Laufzeit.
Sprache und Lizenz: TypeScript. Der Kern und der Großteil des Repositories stehen unter Apache 2.0; Code in ee/-Verzeichnissen verwendet die Mastra Enterprise License.
Besonders geeignet für: TypeScript-SaaS-Agenten mit Anwendungsgedächtnis und Workflow-Phasen im Hintergrund.
Besonderheit: Agenten, Gedächtnis, Workflow-Snapshots und MCP-Client-/Server-Unterstützung in einem Stack.
Preise: Platform Starter $0/Monat zuzüglich Verbrauch; Teams $250/Monat zuzüglich Verbrauch; Enterprise mit individuellem Preis. Self-hosted Free kostet $0/Monat; Self-hosted Enterprise hat individuelle Preise.
Kostenlos testen: Starter ist ein dauerhaft verfügbarer $0-Tarif mit Abrechnung des Mehrverbrauchs, kein unbegrenzt kostenloser Betrieb.
Eine Customer-Success-Anwendung kann Nachweise für eine Vertragsverlängerung sammeln, eine Empfehlung entwerfen und anschließend auf die Prüfung durch die verantwortliche Person warten. Frontend und Backend sind bereits in TypeScript geschrieben. Mastra kann den Agenten und den umgebenden Workflow abbilden, ohne eine weitere Programmiersprache zur Voraussetzung zu machen.
Zustand: Das Gedächtnis eines Agenten benötigt einen konfigurierten Speicheranbieter. Nachrichtenverlauf, Arbeitsgedächtnis und längerfristige Kontextverwaltung erfüllen andere Aufgaben als die Position im Workflow. Mit suspend() erfasst ein Workflow einen Snapshot seines Ausführungsstands; resume() liefert die erwarteten Daten und setzt die angehaltene Arbeit fort. Werden die Snapshots über den konfigurierten Anbieter gespeichert, überdauern sie Deployments und Neustarts. Für einen Freigabe-Workflow ist der Leitfaden zu Unterbrechung und Wiederaufnahme entscheidend, nicht bloß eine Demo des Chatgedächtnisses.
Tools, MCP und menschliche Prüfung: MCPClient bindet externe Tools ein; MCPServer kann Mastra-Agenten, Tools und Workflows anderen Clients bereitstellen. Beide unterstützen stdio und Streamable HTTP. Ereignisse zu Tool-Freigaben und Unterbrechungen lassen sich an das Produkt weiterreichen. Ein Workflow kann für eine Prüfung pausieren und die Daten zur Wiederaufnahme validieren. Die Kennung eines Vorschlags sollte während dieser Pause stabil bleiben. Gibt eine verantwortliche Person eine vorgeschlagene Verlängerungsaktion frei, muss der gespeicherte Vorschlag fortgesetzt werden, nicht ein vom Modell neu erzeugter Ersatz.
Die Grenze verläuft zwischen verfügbaren Grundfunktionen und einer fertig konfigurierten Produktionsanwendung. Speicher, Mandantentrennung, Aufbewahrung, Authentifizierung und bei Wiederholungen sichere Tools brauchen weiterhin einen bewussten Entwurf. Vor dem Einsatz von Enterprise-Kontrollen müssen außerdem die Lizenzgrenzen geprüft werden: Die Apache-Lizenz des Kerns deckt nicht jedes ee/-Feature zu denselben Bedingungen ab.
Hosting-Kosten, geprüft am 7. Oktober 2026: Die aktuelle Mastra-Preisseite nennt für Starter 100K Observability-Ereignisse, danach $10/100K; 24 CPU-Stunden, danach $0.35/Stunde; sowie eine Aufbewahrung von 15 Tagen. Teams kostet $250/Monat mit 1M Ereignissen, danach $8/100K; 250 CPU-Stunden, danach $0.25/Stunde; und sechs Monaten Aufbewahrung. Beide Tarife nennen unbegrenzte Nutzer, Deployments und Projekte. Enterprise bietet individuelle Preise mit vereinbartem Volumen, Aufbewahrung und Support.
Ein Persistent Server für 24/7-Verfügbarkeit wird bei Starter und Teams mit $100/Projekt aufgeführt. Das Modell-Gateway nennt den Marktpreis zuzüglich 5.5%; für Gedächtnis, Retrieval, Datenbanken und ausgehenden Datenverkehr gibt es weitere Verbrauchssätze. Self-hosted Free hat einen Framework-Preis von $0; das lizenzierte Self-hosted Enterprise wird individuell mit einer pauschalen Jahresgebühr bepreist. Beim eigenen Hosting bleiben Modell- und Infrastrukturnutzung separate Kosten.
Bei einem angenommenen Monat mit 100 CPU-Stunden und 300K Ereignissen betragen die Mehrverbrauchskosten von Starter $26.60 für Rechenleistung plus $20 für Ereignisse, zusammen $46.60 vor weiteren Verbrauchsposten. Der Teams-Grundpreis von $250 ist für diese Last nicht automatisch günstiger. Teams sollte wegen der tatsächlich benötigten Funktionen und des passenden Verbrauchsprofils gewählt werden, nicht allein deshalb, weil der Agent inzwischen produktiv läuft.
- TypeScript-Agenten und -Workflows passen in einen vorhandenen Webanwendungs-Stack.
- Gespeicherte Snapshots bieten einen expliziten Weg für zeitversetzte Workflow-Prüfungen.
- MCP kann sowohl eingebunden als auch bereitgestellt werden und unterstützt damit beide Integrationsrichtungen.
- Gehostete Plattform und selbst gehosteter Kern lassen sich getrennt auswählen.
- Persistenz braucht eine echte Speicherkonfiguration und ein Mandantenkonzept.
- Mehrere gehostete Verbrauchsposten können außerhalb des beworbenen Tarifpreises liegen.
- Enterprise-Funktionen im Repository haben eine eigene Lizenzgrenze.
Fazit: Mastra passt, wenn die App Agentenverhalten und Workflow-Struktur gemeinsam braucht. Das Vercel AI SDK eignet sich, wenn die Hauptaufgabe eine Weboberfläche um eine kleinere Schleife ist.
6. Google ADK: für Agentensysteme im Google-Umfeld
Google ADK, das Agent Development Kit, passt zu Systemen, die von Googles Agentenwerkzeugen und Deployment-Weg profitieren, ihre Agenten und Workflows aber weiter im Code definieren möchten. Es unterstützt Python, TypeScript, Go, Java und Kotlin. Das Framework kann auf eigener Infrastruktur laufen; seine Nutzung setzt keinen Kauf einer gehosteten Laufzeit voraus.
Sprache und Lizenz: Python, TypeScript, Go, Java und Kotlin; Kern unter Apache 2.0, geprüft im Python-Repository.
Besonders geeignet für: Agentensysteme, deren vorhandene Betriebsumgebung auf Google Cloud liegt.
Besonderheit: Sitzungsdienste, Zustand mit definiertem Geltungsbereich, zusammensetzbare Workflows und ein verwalteter Deployment-Weg.
Preise: Kostenloses Framework. Agent Runtime wird nach Verbrauch berechnet: Standard-On-Demand-Rechenleistung für $0.085/vCPU-Stunde und RAM für $0.009/GiB-Stunde nach Ausschöpfung der jeweiligen Freikontingente.
Kostenlos testen: Es gibt monatliche Freikontingente für gehostete Ressourcen; Modell-Tokens und andere Verbrauchsposten bleiben separat.
Für einen Betriebsassistenten in einer Google-Cloud-Anwendung ist die vertraute Umgebung der praktische Vorteil. Nutzeridentität und Zugriffsgrenzen können im vorhandenen Backend bleiben, während ADK Tools und Spezialisten koordiniert. Das kann wertvoller sein, als nur für diesen Agenten die Cloud-Konsole eines anderen Frameworks einzuführen.
Zustand: Sitzungen enthalten Ereignisse, Gesprächsverlauf und Zustand. Präfixe unterscheiden anwendungsweite Werte, Nutzerwerte und temporäre Werte; Schlüssel ohne Präfix gelten für die jeweilige Sitzung. Der In-Memory-Sitzungsdienst bietet keine Persistenz über Neustarts hinweg. Datenbank- und Vertex-AI-Sitzungsdienste sind persistente Alternativen. Zustand sollte über nachverfolgte Kontextänderungen und Ereignisse aktualisiert werden. Ein abgerufenes Sitzungsobjekt zu verändern, bedeutet nicht automatisch, dass die Änderung gespeichert wurde. Die Namen des Cloud-Produkts haben sich geändert; die Zuständigkeitsfrage bleibt: Wo lädt ein Ersatz-Worker den Auftrag?
Tools und MCP: ADK unterstützt eigene Tools sowie MCP-Toolsets für lokale und entfernte Server. Die Implementierung in der gewählten Sprache muss geprüft werden; nicht jedes Beispiel gilt automatisch für alle fünf. Der aktuelle Leitfaden für native Deployments in Agent Runtime nennt Python und Go. Ein SDK für eine Sprache belegt nicht, dass verwaltete Deployments in gleichem Umfang unterstützt werden.
Menschliche Prüfung: Die experimentelle Funktion Tool Confirmation kann ein Tool anhalten, bis ein Nutzer oder ein überwachendes System reagiert. Die aktuellen bekannten Einschränkungen besagen, dass DatabaseSessionService und VertexAiSessionService nicht unterstützt werden. In TypeScript ist außerdem eine manuell implementierte Bestätigungslogik innerhalb der Tool-Ausführung erforderlich. Für einen Produktionsauftrag, der auf Prüfung warten und einen Prozessneustart überstehen muss, ist das eine entscheidende Kompatibilitätsprüfung. Ein persistenter Sitzungsdienst und Tool Confirmation dürfen nicht unabhängig ausgewählt werden, in der Annahme, ihre Kombination werde schon unterstützt. Ist diese Kombination zentral, braucht es einen anderen überprüfbaren Freigabemechanismus oder ein Framework mit passend dokumentierter Verbindung aus Pause und Speicherung.
Die Grenze liegt in der Funktionsgleichheit zwischen Sprachen und der Backend-Kompatibilität. Eine breite Sprachenliste kann verdecken, dass der Weg für eine konkrete Deployment- oder Prüffunktion enger ist. Geprüft werden muss die gesamte Kombination einschließlich Sitzungsdienst und Tool-Typ, nicht nur eine Liste einzelner Häkchen.
Hosting-Kosten, geprüft am 7. Oktober 2026: Googles Agent-Platform-Preisseite verwendet gemeinsame Ressourcen-Abrechnungsposten. Standard-On-Demand-Agent-Compute enthält 50 kostenlose vCPU-Stunden/Monat/Konto, danach kostet es $0.085/vCPU-Stunde. Agent Memory enthält 100 kostenlose GiB-Stunden/Monat/Konto, danach $0.009/GiB-Stunde. Agent Storage hat ein Freikontingent von 1 GiB-Monat; Sessions und Memory Bank nennen Speicherpreise von $0.30/GiB-Monat. Modell-Tokens werden separat berechnet.
Die Preisseite nennt außerdem bei entsprechender Berechtigung vergünstigte Sätze mit einjähriger Bindung von $0.0765/vCPU-Stunde und $0.0081/GiB-Stunde sowie mit dreijähriger Bindung von $0.068/vCPU-Stunde und $0.0072/GiB-Stunde. Das sind Optionen mit Laufzeitverpflichtung, keine Tarife des kostenlosen Frameworks. Auch Sitzungs- und Gedächtnisoperationen verbrauchen Agent Compute: Eine vCPU-Stunde zu $0.085 entspricht 3 Millionen Lesevorgängen oder 1 Million Schreibvorgängen. Diese gehören in die Hosting-Kalkulation.
Ein angenommener, isolierter Laufzeitmonat mit 100 vCPU-Stunden und 200 GiB-Stunden verursacht nach den Freikontingenten $5.15 für Rechenleistung und RAM. Modellnutzung, Speicher, Sitzungsoperationen und jeder andere Verbrauch der gemeinsam genutzten Freikontingente des Kontos sind dabei ausgeschlossen. Das ist eine Schätzung für einzelne Komponenten, keine vollständige Rechnung für einen gehosteten Agenten.
- Implementierungen in mehreren Sprachen eröffnen vorhandenen Backends einen Weg zu ADK.
- Sitzungsdienste trennen lokale Entwicklung und persistenten Betrieb.
- Eigene Tools und MCP passen zu bestehenden Dienstgrenzen der Anwendung.
- Deployments können auf eigener Infrastruktur bleiben oder Googles Laufzeit nutzen.
- Sprachunterstützung und Unterstützung verwalteter Deployments sind nicht durchgehend gleichwertig.
- Die experimentelle Tool Confirmation schließt wichtige persistente Sitzungs-Backends aus.
- Gemeinsame Cloud-Freikontingente und mehrere Verbrauchsposten erschweren die Angabe eines einfachen Einstiegspreises.
Fazit: ADK passt, wenn die benötigte Kombination aus Sprache, Deployment und Prüfung nachweislich unterstützt wird. Bei einer persistenten menschlichen Freigabe sollte belegte Kompatibilität stärker wiegen als eine allgemeine Vorliebe für Google Cloud.
7. Pydantic AI: für typisierte Python-Anwendungsdienste
Pydantic AI passt zu einem Python-Backend, dessen Agent validierte Daten zurückgeben und mit expliziten Anwendungsabhängigkeiten arbeiten muss. Pydantic-Schemata beschreiben die erwarteten Felder und Typen. Das Framework überträgt diese Disziplin auf Agentenausgaben und Tool-Schnittstellen. Besonders nützlich ist das, wenn der nächste Schritt eine strukturierte Entscheidung verarbeitet und keinen Absatz plausibel klingenden Textes.
Sprache und Lizenz: Python; MIT.
Besonders geeignet für: Agenten in einem Python-Dienst mit strikten Verträgen für Ein- und Ausgaben.
Besonderheit: Typisierte Abhängigkeiten und validierte Ausgaben, mit optionalen Backends für dauerhafte, wiederaufnehmbare Ausführung.
Preise: Kostenlose Bibliothek. Optionales Logfire: Personal kostenlos, Team $49/Monat, Growth $249/Monat und Enterprise mit individuellem Preis.
Kostenlos testen: Logfire Personal ist dauerhaft kostenlos. Das bietet Observability-Zugriff, keine kostenlose Modellausführung.
Ein Dienst zur Erfassung neuer Fälle könnte einer vorhandenen Anwendung eine Fallkategorie, Nachweisreferenzen und eine empfohlene nächste Aktion liefern. Eine validierte Ausgabe erleichtert es, fehlende oder falsch formatierte Felder zurückzuweisen, bevor jemand das Ergebnis im Betrieb sieht. Sie belegt jedoch nicht, dass die Empfehlung stimmt. Für die Aktion selbst sind weiterhin Geschäftsregeln, Nachweisprüfungen und eine Freigabe nötig.
Zustand: Der Nachrichtenverlauf kann zwischen Läufen weitergegeben und in einen frei gewählten Speicher serialisiert werden. Das erhält den Gesprächszusammenhang. Für Fortschritt, der Ausfälle und Neustarts überdauern muss, dokumentiert Pydantic AI externe Integrationen zur dauerhaften Ausführung, darunter Temporal, DBOS, Prefect und Restate. Diese Systeme erhalten den Ausführungsfortschritt; die Installation der Agentenbibliothek allein liefert diese Laufzeit nicht mit. Ein bestehender Python-Dienst mit dauerhaftem Auftragssystem sollte zuerst die Integration prüfen, bevor er seine Orchestrierung ersetzt.
Tools und MCP: Die aktuelle Dokumentation verwendet MCPToolset, das einen FastMCP-Client für Server mit stdio, Streamable HTTP und SSE kapselt. Serveridentität und nutzerspezifische Zugangsdaten bleiben Aufgaben der Anwendung. Eine gemeinsam genutzte Serververbindung unter einer Identität schafft nicht automatisch eine eigene Autorisierungsgrenze für jeden Nutzer, der dem Agenten eine Frage stellt.
Menschliche Prüfung: Zurückgestellte Tools können auf eine Freigabe oder ein externes Ausführungsergebnis warten. Ein Inline-Handler kann Anfragen innerhalb desselben Laufs beantworten. Für eine externe Prüfung kann der Agent DeferredToolRequests zurückgeben. Die Anwendung speichert dann den Verlauf und die offenen Aufrufe, holt eine Entscheidung ein und startet mit DeferredToolResults einen Folgelauf. Diese externe Fortsetzung ist ein neuer Agentenlauf. Sie muss deshalb dem ursprünglichen Gespräch zugeordnet werden; eine unveränderte Laufkennung darf nicht vorausgesetzt werden. Der Leitfaden zu zurückgestellten Tools dokumentiert diesen Unterschied.
Die Grenze liegt in der Infrastruktur um einen stark typisierten Agenten. Das Schema macht Schnittstellen leichter nachvollziehbar, liefert aber weder die Prüfoberfläche noch eine dauerhafte Warteschlange oder die inhaltliche Richtigkeit der Entscheidung. Steht in einem gültigen Zeichenkettenfeld die falsche Kundenkennung aus einem Dokument, kann die Typvalidierung sie akzeptieren. Identität und Nachweise müssen vor jedem Schreibvorgang unabhängig geprüft werden.
Hosting-Kosten, geprüft am 7. Oktober 2026: Die Logfire-Preisliste beschreibt ein gehostetes Observability- und Evaluierungsangebot. Personal enthält 10M Telemetrie-Datensätze/Monat mit fester Kostengrenze von $0, einen Nutzerplatz, zwei Gäste mit Lesezugriff, drei Projekte und 30 Tage Aufbewahrung. Team kostet $49/Monat mit 10M enthaltenen Datensätzen, danach $2 pro Million. Enthalten sind fünf Nutzerplätze; bis zu zwölf sind möglich, jeder zusätzliche kostet $25. Growth kostet $249/Monat mit unbegrenzten Nutzerplätzen, Gästen und Projekten, bis zu 90 Tagen Aufbewahrung sowie derselben enthaltenen Datensatzmenge und $2/Million für Mehrverbrauch. Enterprise hat individuelle Preise und die Varianten Cloud, Dedicated und Self-hosted.
Bei sechs Team-Nutzerplätzen beträgt der Grundpreis $74/Monat, bei zwölf $224/Monat. Der dreizehnte überschreitet die Nutzergrenze von Team. Growth liegt mit $249/Monat nur $25 über dem Team-Grundpreis für zwölf Nutzerplätze und bietet längere Aufbewahrung sowie zusätzliche Organisationsfunktionen. Keiner dieser Preise umfasst das Hosting des Pydantic-AI-Agenten oder dessen Modellaufrufe. Das Telemetrie-Budget sollte als eigener Posten geführt werden, nicht als Preis der Agentenlaufzeit.
- Typisierte Ausgaben machen die Verträge nachgelagerter Anwendungen explizit.
- Python-Abhängigkeiten binden vorhandene Dienste sauber in den Agenten ein.
- Zurückgestellte Tools unterstützen externe Freigabe- und Ausführungsabläufe.
- Integrationen zur dauerhaften Ausführung können einem vorhandenen Auftragssystem die Steuerung überlassen.
- Eine gültige Struktur belegt weder faktische noch geschäftliche Richtigkeit.
- Nachrichtenpersistenz und dauerhafte Ausführung sind getrennte Konfigurationen.
- Gehostetes Logfire nimmt die Verantwortung für Agenten-Deployments nicht ab.
Fazit: Pydantic AI passt, wenn ein typisierter Python-Dienst im Mittelpunkt des Produkts steht. Dauerhafte Ausführung sollte nur ergänzt werden, wenn die Aufgabe sie benötigt; die Betriebsanforderungen dieser Ausführungsumgebung sind separat zu vergleichen.
8. Vercel AI SDK: für Agenten-Web-Apps mit Streaming
Das Vercel AI SDK passt zu einer TypeScript- oder JavaScript-Anwendung, deren unmittelbares Produkt die Benutzeroberfläche, gestreamte Antworten und die Tool-Schleife sind. Seine Core-Schnittstelle vereinheitlicht Modell- und Tool-Aufrufe; seine UI-Schnittstelle verbindet diese Interaktionen mit der Weboberfläche. Die Bibliothek lässt sich nutzen, ohne die Anwendung auf Vercel zu deployen.
Sprache und Lizenz: TypeScript/JavaScript; Apache 2.0.
Besonders geeignet für: Chat- oder Agentenoberflächen in einem bestehenden Webprodukt.
Besonderheit: Grundfunktionen für Streaming-Oberflächen und wiederverwendbare Tool-Schleifen über mehrere Anbieter hinweg.
Preise: Kostenlose Bibliothek. Optionales Vercel-Hosting: Hobby $0/Monat, Pro $20/Monat zuzüglich Verbrauch, Enterprise mit individuellem Preis. AI Gateway hat eigene Guthaben.
Kostenlos testen: Hobby ist ein kostenloser Tarif für private Nutzung; die Hosting-Preisseite bietet eine Pro-Testphase an.
Wer eine Webanwendung um einen Kontoassistenten ergänzt, kann eine Antwort streamen, den Fortschritt eines Tools zeigen und in derselben Oberfläche um die Freigabe einer Änderung bitten. Wird der Großteil der Arbeit innerhalb dieser Interaktion abgeschlossen, ist der Umfang sinnvoll. Ein Prozess, der bis morgen auf eine andere Abteilung warten muss, braucht einen Auftragslebenszyklus und Persistenz über eine Browserkomponente hinaus.
Zustand: Wiederverwendbare Agentenschleifen machen aus einem Chat nicht automatisch einen dauerhaften Geschäftsprozess. Das dokumentierte Muster für Nachrichtenpersistenz speichert UI-Nachrichten in einem Speicher der Anwendung; im Produktivbetrieb kann das eine Datenbank oder Cloud-Speicher sein. Nachrichtenkennungen müssen stabil bleiben, und wiederhergestellte Tool-Nachrichten sollten gegen die aktuellen Schemata validiert werden. Gesondert festzulegen ist, was passiert, wenn der Browser geschlossen wird, während das Backend weiterarbeitet. Die Dokumentation zur Nachrichtenpersistenz für Chatbots erläutert diese Integration und behauptet nicht, das SDK liefere die Datenbank mit.
Tools, MCP und menschliche Prüfung: Der MCP-Client stellt Server-Tools für die Modellschleife bereit. Die aktuelle API zur Freigabe lokaler Tools heißt toolApproval; die ältere Eigenschaft needsApproval ist veraltet. Bei manueller Freigabe werden Anfragebestandteile zurückgegeben. Die Oberfläche holt eine Entscheidung ein, und ein späterer Aufruf verarbeitet die Freigabeantwort. Entscheidend ist: Beim Anbieter ausgeführte Tools unterliegen dieser lokalen Freigabeeinstellung nicht. Die anbieterseitigen Kontrollen müssen separat konfiguriert werden. Die Dokumentation zu Tool-Aufrufen beschreibt sowohl den Lebenszyklus als auch diese Grenze.
Die Grenze liegt in der Annahme, eine ausgereifte Gesprächsoberfläche sei bereits eine Workflow-Engine. Das SDK bietet hilfreiche Schleifensteuerung, und gewöhnlicher Code kann eine bekannte Reihenfolge abbilden. Es sorgt aber weder dafür, dass eine gehostete Funktion unbegrenzt auf eine prüfende Person wartet, noch bewahrt es automatisch einen externen Transaktionsbeleg auf oder autorisiert die Person, die auf „Freigeben“ klickt. Die Oberfläche sollte den Anwendungszustand anzeigen und nicht allein den Auftrag verantworten.
Hosting-Kosten, geprüft am 7. Oktober 2026: Vercels Hosting-Preisliste nennt Hobby mit $0/Monat, Pro mit $20/Monat und Enterprise mit individuellem Preis. Hobby ist auf nicht kommerzielle private Nutzung beschränkt. Laut den Preisdetails des Pro-Tarifs enthält die Plattformgebühr einen Nutzerplatz mit Deployment-Berechtigung und $20 monatliches Verbrauchsguthaben. Weitere Nutzerplätze mit Deployment-Berechtigung kosten $20/Monat; Betrachter sind kostenlos. Drei Nutzerplätze mit Deployment-Berechtigung beginnen damit bei $60/Monat vor zusätzlichem On-Demand-Verbrauch. Das Verbrauchsguthaben gehört zum Tarif und vervielfacht sich nicht mit weiteren Nutzerplätzen.
Die optionale AI-Gateway-Preisliste nennt einen kostenlosen Tarif mit $5/Monat Guthaben für berechtigte Modelle sowie einen kostenpflichtigen Tarif mit gekauftem, verbrauchsabhängigem Guthaben. Die Token-Sätze entsprechen den Listenpreisen der Anbieter ohne Aufschlag. Ein Guthabenkauf wechselt das Konto in den kostenpflichtigen Tarif und beendet das wiederkehrende Freikontingent; die Nutzung eigener API-Schlüssel ist im kostenpflichtigen Tarif verfügbar. Diese Gateway-Guthaben unterscheiden sich vom Verbrauchsguthaben des Hosting-Tarifs. Optionale Gateway-Funktionen können eigene Gebühren haben.
- Streaming und Tool-Interaktionen passen unmittelbar in die Oberfläche eines Webprodukts.
- Core-APIs unterstützen mehrere Modellanbieter.
- Lokale Tool-Freigaben lassen sich über die Anwendungsoberfläche einholen.
- Die Bibliothek setzt keinen Kauf von Vercel-Hosting voraus.
- Die Anwendung muss weiterhin Nachrichten und Aufträge persistent speichern.
- Lokale Freigabeeinstellungen steuern keine beim Anbieter ausgeführten Tools.
- Hosting-Nutzerplätze, Hosting-Verbrauch und Gateway-Guthaben sind getrennte Budgetposten.
Fazit: Das Vercel AI SDK passt zur Schleife hinter einer Weboberfläche. Mastra eignet sich, wenn Agenten und gespeicherte Workflows ein umfassenderes gemeinsames Framework brauchen. Überdauert die Aufgabe die Interaktion, kann auch ein separates dauerhaftes Auftragssystem ergänzt werden.
Welches Framework sollte welches Team wählen?
Für einen mehrstufigen Workflow mit gespeichertem Zustand ist LangGraph der Ausgangspunkt. Ausschlaggebend ist nicht die Zahl der Prompts, sondern ob gespeicherter Ausführungsstand, Verzweigungen und zeitversetzte Prüfungen zum Ergebnis gehören. Ein expliziter Graph hilft, wenn im Betrieb erkennbar sein muss, wo der Fall steht und welcher nächste Schritt sicher ausgeführt werden kann.
Für ein Team aus Agenten mit unterschiedlichen Rollen eignet sich CrewAI. Jede Rolle braucht eine eigene Aufgabe, klare Anforderungen an Nachweise oder eine eigene Tool-Grenze. Verwenden alle Rollen dieselben Eingaben und liefern dieselbe Art von Antwort, sollte zuerst der Entwurf vereinfacht werden, bevor ein Framework für die Zusammenarbeit ausgewählt wird.
Für einen Agenten in einer TypeScript-Web-App gehören Mastra und Vercel AI SDK auf die engere Liste. Der größere Umfang von Mastra lohnt sich, wenn gespeichertes Gedächtnis und unterbrechbare Workflows zum Produkt gehören. Das Vercel AI SDK passt, wenn Streaming und Tool-Interaktion im Mittelpunkt stehen und das Backend den Rest bereits verantwortet. Vorhandene Anwendungsinfrastruktur kann die Entscheidung verändern: Eine ausgereifte Auftrags-Engine verringert den Bedarf an einer weiteren Workflow-Schicht.
Für eine kompakte Schleife rund um einen Modellanbieter kommen OpenAI Agents SDK oder dessen Client-SDK infrage. Der Agenten-Runner von OpenAI ergänzt Tools, Übergaben und Freigabezustand innerhalb der Anwendung. Bei Claude lohnt sich das Agent SDK gezielt für integrierte Datei- und Kommandoaufgaben; für eine kleinere eigene Schleife passt das Client-SDK.
Für ein System im Google-Umfeld kommt ADK nach Prüfung der gesamten Funktionskombination infrage. Die aktuellen Einschränkungen von Tool Confirmation können die Architektur einer persistenten Prüfung verändern. Die Sprachunterstützung allein sollte die Entscheidung nicht bestimmen.
Welche Agenten-Frameworks gehören auf die Auswahlliste von Python-Teams?
LangGraph passt zu einem expliziten Workflow-Stand, Pydantic AI zu einem typisierten Dienst mit validierten Ausgaben und CrewAI zu getrennten, zusammenarbeitenden Rollen. Das OpenAI Agents SDK eignet sich für einen kleineren Runner unter Kontrolle der Anwendung. Die Verfügbarkeit für Python setzt die erste Grenze; den Ausschlag geben Zustands- und Freigabemodell.
Ist die Reihenfolge bereits bekannt, sollte gewöhnlicher Code oder ein deterministischer Workflow die Steuerung behalten. Der Vergleich von n8n-Agenten und Workflows vertieft dieselbe Grenze: Das Modell entscheidet dort, wo Urteilsvermögen hilft; der Workflow verantwortet Aktionen, die sich vorab festlegen lassen.
Wann reicht eine einfache Schleife ohne Framework?
Eine einfache Schleife mit dem SDK des Modellanbieters reicht, wenn ein Anbieter, wenige Tools und eine klar begrenzte Aufgabe den Bedarf abdecken. Rein lesende Kontoabfragen, Dokumentenklassifizierung oder kurze Textentwürfe können oft im bereits betriebenen Backend bleiben.
Die Grundschleife sendet die Anfrage, validiert gegebenenfalls Tool-Argumente, ruft eine erlaubte Anwendungsfunktion auf und gibt deren Ergebnis zurück. Sie läuft weiter, bis das Modell fertig ist oder die festgelegte Abbruchregel greift. Bei einer festen Reihenfolge kann die Anwendung die benötigten Funktionen direkt aufrufen und vom Modell nur die erforderliche Einschätzung oder den Text anfordern.
Das ist attraktiv, wenn die Anwendung Authentifizierung, dauerhafte Aufträge, Wiederholungsregeln, Speicher und Telemetrie bereits verantwortet. Ein Framework, das diese vorhandenen Bausteine lediglich umhüllt, schafft eine weitere zu pflegende Schnittstelle. Es wird wertvoll, wenn es eine konkrete wiederkehrende Last abnimmt, etwa einen wiederaufnehmbaren Workflow-Stand, einheitliche Übergaben oder den Lebenszyklus von Freigaben.
Der maximale Arbeitsumfang sollte begrenzt, der nötige Verlauf aufbewahrt und das Ergebnis protokolliert werden. Auch „ohne Framework“ braucht es eine klare Zuständigkeit für Fehler. Werden Checkpoint-Übergänge, spätere Freigaben oder die Orchestrierung von Spezialisten immer wieder selbst gebaut, lohnt ein erneuter Blick auf die Bibliothek, die genau diese fehlende Grundfunktion liefert. Ein konkretes wiederkehrendes Problem ist der Anlass für ihre Einführung.
Open-Source-Frameworks für KI-Agenten: Lizenzen und Betriebskosten
Die kostenlose Bibliothek und die gehostete Plattform sollten getrennte Budgetentscheidungen sein. LangGraph, CrewAI, OpenAI Agents SDK und Pydantic AI haben MIT-Kerne. Vercel AI SDK, der geprüfte Python-Kern von Google ADK und der Mastra-Kern verwenden Apache 2.0. Für Mastras Enterprise-Verzeichnisse und die Claude-Laufzeit gelten gesonderte Bedingungen. Claudes MIT-Python-Wrapper ist eine Komponente, keine pauschale Lizenzbeschreibung für alles, was er ausführt.
Modellnutzung, Laufzeitressourcen, persistenter Speicher, Observability und Prüfabläufe gehören als getrennte Posten in die Kalkulation. Ein kostenloses Trace-Kontingent ist kein kostenloses Agentenkontingent. Guthaben für ein Modell-Gateway ist kein Hosting-Guthaben. Ein Preis pro Nutzerplatz ist kein vollständiger Deployment-Preis. Die Rechenbeispiele in den obigen Framework-Profilen zeigen die Folgen, ohne einer nicht definierten Last eine erfundene Gesamtsumme zuzuweisen.
Für den Betrieb kann eine Aktion, deren Ausgang nach einem Timeout unbekannt ist, die teuerste Unklarheit darstellen. Der beabsichtigte Vorgang muss gespeichert, die erforderliche Freigabe eingeholt, die Aktion über ein eng umrissenes Anwendungstool ausgeführt und der externe Beleg aufbewahrt werden. Ein Idempotenzschlüssel ermöglicht es, eine wiederholte Anfrage als denselben beabsichtigten Vorgang zu erkennen, statt stillschweigend einen weiteren anzulegen. Wie das funktioniert, hängt von der Anwendung und dem Zieldienst ab.
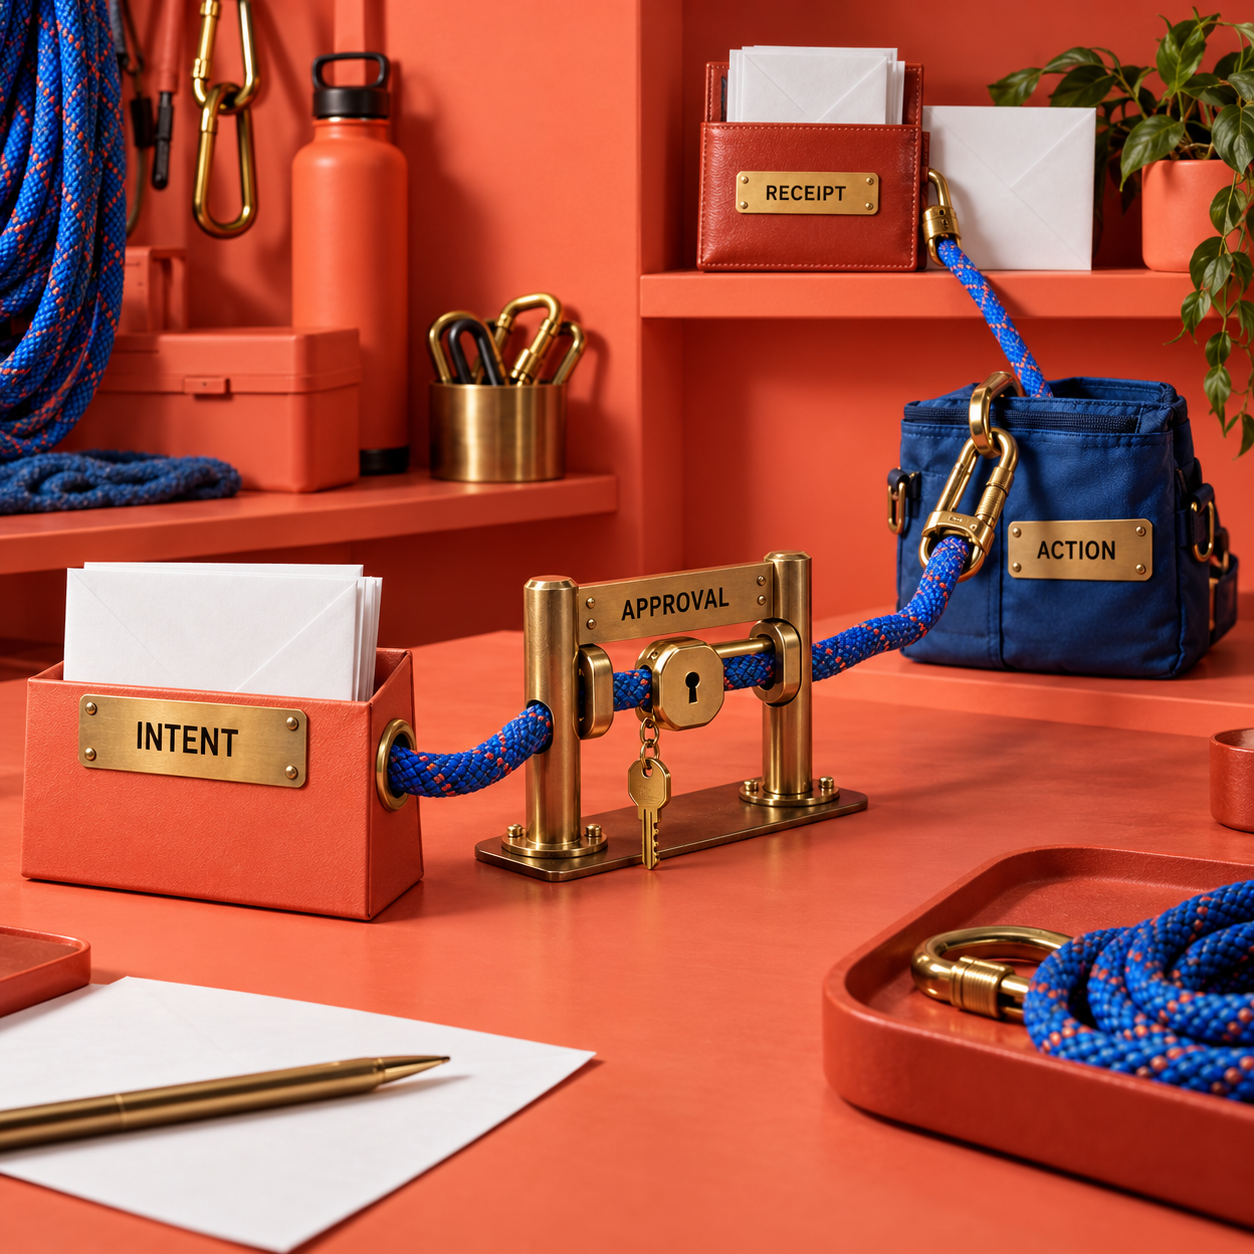
Ein Checkpoint kann die Position im Workflow wiederherstellen. Er kann allein aber nicht belegen, ob ein externer Dienst unmittelbar vor dem Netzwerkausfall einen Schreibvorgang abgeschlossen hat. Die Belegabfrage gehört zum Tool-Entwurf; das Modell sollte den Ausgang nicht aus seiner letzten Nachricht erraten müssen.
Das ist auch die praktische Grenze für einen Framework-Wechsel. Geschäftsschemata, Tool-Verträge und Aufzeichnungen externer Aktionen gehören in nachvollziehbaren Anwendungscode. Ein Wechsel kann weiterhin Änderungen am Ausführungszustand und an gespeicherten Nachrichten erfordern. Die eigentliche Geschäftsoperation sollte sich jedoch nicht erst aus einem Agentenprotokoll rekonstruieren lassen müssen.
Welche Fehlentscheidungen sollten vermieden werden?
LangGraph für einen einfachen Klassifikator ist unnötig, wenn das Backend bereits das Modell aufruft, ein Ergebnis validiert und speichert. Ein längeres Diagramm allein verbessert diese Aufgabe nicht.
CrewAI für bloß dekorative Personas sollte vermieden werden. Rechercheur, Stratege und Autor brauchen getrennte Verantwortlichkeiten oder Grenzen für ihre Nachweise. Sonst verbergen die Rollenbezeichnungen nur eine größere Schleife um dieselbe Aufgabe.
Claude Agent SDK für einfachen Chat lohnt sich nicht, wenn keine Datei-, Kommando- oder umgebungsbezogene Laufzeit benötigt wird. Das direkte Client-SDK ist der kleinere Ausgangspunkt für eine eigene Schleife beim Modellanbieter.
Google ADK Tool Confirmation zusammen mit einem nicht unterstützten persistenten Sitzungsdienst sollte vermieden werden. Die aktuelle dokumentierte Einschränkung betrifft DatabaseSessionService und VertexAiSessionService. Eine zentrale Freigabeanforderung im Produktivbetrieb darf nicht auf einer nur angenommenen Kombination beruhen.
Logfire oder ein AI Gateway als Agenten-Hosting zu behandeln, führt in die Irre. Das eine beobachtet die Arbeit, das andere vermittelt den Modellzugriff. Beides beantwortet nicht, wer den Anwendungsauftrag betreibt und nach einem Fehler wieder aufnimmt.
Ein Framework für KI-Agenten auswählen: die Entscheidung diese Woche treffen
Gewählt werden sollte der kleinste Kandidat, der die tatsächlichen Anforderungen an Wiederaufnahme und Prüfung erfüllt. Dafür reicht ein repräsentativer Geschäftsvorgang; eine Vorführung sämtlicher denkbarer Agentenfunktionen ist nicht nötig.
Ergebnis und Grenzen festhalten
Das fertige Ergebnis, die nötigen Nachweise, erlaubte Aktionen und prüfpflichtige Aktionen benennen. Festlegen, was im Betrieb bekannt sein muss, wenn ein Lauf auf halbem Weg stoppt.
Nach Sprache und Ablaufmodell eingrenzen
Das Framework passend zum dauerhaften Workflow, zu zusammenarbeitenden Rollen, zum typisierten Dienst oder zur Schleife hinter der Weboberfläche auswählen. Eine einfache Anbieterschleife bleibt im Vergleich, wenn sie die Anforderungen erfüllt.
Unterbrochene Abläufe erproben
Den Worker neu starten, einen Tool-Fehler auslösen, eine Freigabe ablehnen und ein Ereignis doppelt zustellen. Gespeicherten Zustand und externe Belege prüfen. Eine erfolgreiche abschließende Antwort allein belegt keine zuverlässige Wiederaufnahme.
Die Kosten des abgeschlossenen Vorgangs messen
Alle Modellaufrufe und Tool-Arbeiten zählen, einschließlich Wiederholungen und delegierter Aktivitäten. Die tatsächlich verwendeten Hosting-Verbrauchsposten ergänzen, dann feste Plattformgebühren und lastabhängige Kosten trennen.
Betriebsverantwortung zuweisen
Die Zuständigkeit für Speicher, Deployment, fehlgeschlagene Aufträge, ausstehende Freigaben und Kostenalarme festlegen. Den Kandidaten wählen, dessen fehlende Bausteine sich im Betrieb diese Woche abdecken lassen.
Häufige Fragen
Welche 5 Arten von KI-Agenten gibt es?
Listen mit fünf Arten sind didaktische Einteilungen, deren Definitionen variieren. Sie entscheiden nicht, welches Framework einen Workflow dauerhaft speichern oder eine Prüfung erzwingen kann. Für diese Auswahl müssen Ablaufmodell, Zustand, Tool-Zugriff und erlaubter Autonomiegrad festgelegt werden.
Welche 4 KI-Agenten gelten als die wichtigsten?
Eine verbindliche, allgemeingültige Gruppe der vier wichtigsten gibt es nicht. LangGraph, CrewAI, OpenAI Agents SDK und Google ADK lösen unterschiedliche Entwicklungsaufgaben. Sie als feste Rangliste nach Qualität zu behandeln, verdeckt die Produktionsanforderung, die die Auswahl bestimmen sollte.
Welche Frameworks gibt es für KI-Agenten?
Dieser Vergleich umfasst LangGraph, CrewAI, OpenAI Agents SDK, Claude Agent SDK, Mastra, Google ADK, Pydantic AI und Vercel AI SDK. Sie reichen von Workflow-Laufzeiten über typisierte Agentenbibliotheken bis zu SDKs für Tool-Schleifen hinter Weboberflächen. Ausgangspunkt sollte daher die konkrete Aufgabe sein.
Welche 7 Arten von KI-Agenten gibt es?
Auch Listen mit sieben Arten unterscheiden sich je nach Quelle und sind kein Standardmodell für die Beschaffung eines Frameworks. Eine Liste von Agentenkategorien belegt weder die Wiederaufnahme nach Neustarts noch Tool-Berechtigungsgrenzen oder die Kompatibilität von Freigabe- und Speicherfunktionen.
Ist ChatGPT ein Agent oder ein LLM?
ChatGPT ist ein Produkt für Endnutzer. Ein LLM ist das zugrunde liegende Sprachmodell; eine Agentenanwendung kombiniert ein Modell mit Tools, Zustand und einer Schleife, die auf ein Aufgabenziel hinarbeiten kann. Das sind unterschiedliche Ebenen. Der Produktname legt nicht die Laufzeit der eigenen Anwendung fest.
Welche KI-Agenten gehören zu den Top 5?
Eine aufgabenspezifische Auswahl ist hilfreicher als eine allgemeingültige Top-Fünf-Liste. Ausgangspunkte sind LangGraph für zustandsbehaftete Workflows, CrewAI für Spezialistenteams, Mastra für TypeScript-Workflows, Pydantic AI für typisierte Python-Dienste und OpenAI Agents SDK für eine kompakte Schleife unter Kontrolle der Anwendung. Andere Aufgaben verändern die Auswahl.
Welcher KI-Agent ist der neueste?
Über Modelle, gehostete Produkte und Entwicklungs-Frameworks hinweg gibt es keine einzelne hilfreiche Antwort. Für eine Umsetzung in dieser Woche sollte die aktuelle Dokumentation der benötigten Fähigkeiten gelesen und ihre Kompatibilität mit Deployment und Speicher geprüft werden. Eine neuere Version belegt keine bessere Eignung.
Ist ChatGPT der beste KI-Agent?
Das hängt von der Aufgabe des Nutzers und den benötigten Kontrollen ab. Es ist eine andere Frage als die Wahl des Codes, der in das eigene Produkt eingebettet werden soll. Für Entwickler zählen die Verantwortung für Zustand, Tool-Ausführung, Deployment, Prüfung und Betriebskosten.
Welche Frameworks für agentische KI sind 2026 führend?
Die praktikable Auswahl hängt von der Aufgabe ab: LangGraph für explizite dauerhafte Workflows; CrewAI für Zusammenarbeit nach Rollen; Mastra oder Vercel AI SDK für unterschiedliche Anforderungen von TypeScript-Anwendungen; Pydantic AI für typisiertes Python; OpenAI Agents SDK für einen Runner unter Kontrolle der Anwendung; Claude Agent SDK für seine Datei- und Kommandolaufzeit; und Google ADK, sofern die erforderliche Kombination unterstützt wird.
Die Checkliste zur Prüfung von KI-Geschäftsprozessen hilft, die erste Agentenaufgabe, ihre Prüfgrenze und die Betriebsverantwortung einzugrenzen, bevor die Entscheidung für ein Framework fällt.
- Zuletzt aktualisiert
- 7. Okt. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Codex CLI oder Cloud: Umgebung vorbereiten, Aufgaben weiterlaufen lassen
Codex CLI oder Cloud? Wiederverwendbare Umgebungen einrichten, Aufgaben bei ausgeschaltetem Laptop ausführen und Fortschritt vom Smartphone aus steuern.7. Okt. 2026Build
GitHub Copilot Kosten (2026): Welcher Tarif sich wirklich lohnt
GitHub Copilot Kosten im Überblick: Tarife, AI Credits und drei Beispielrechnungen. Pro, Pro+, Max und Team-Tarife mit passenden Ausgabenlimits vergleichen.6. Okt. 2026Build
Copilot CLI von GitHub: Installation, erste Aufgaben und Kosten
GitHub Copilot CLI im Terminal einrichten, Tests reparieren und Pull Requests öffnen. Mit Tarifen, KI-Credits, Modellen, Berechtigungen und MCP.6. Okt. 2026Build
Web Scraper im Vergleich 2026: Acht Tools für unterschiedliche Aufgaben
Acht Web Scraper im Vergleich: Firecrawl, Browse AI, Bright Data und weitere Tools. Preise, Gratislimits und Zuständigkeiten für wiederkehrende Datenabrufe.6. Okt. 2026Build
Agent Memory: Was KI-Agenten behalten und was es kostet
Was KI-Agenten speichern sollten: Kontext, Sitzungen, Langzeitgedächtnis und Skills. Mit Anbietergrenzen, Kostenbeispielen und Lösungen für typische Fehler.5. Okt. 2026Build
Pinecone Pricing 2026: Tarife, Grenzen und Rechenbeispiele
Pinecone Pricing 2026: Tarife und Kosten für 1M bis 100M Vektoren. Rechenbeispiele zeigen, wie Suchumfang und Nutzung die Monatsrechnung bestimmen.5. Okt. 2026Build
Lovable-Alternative gesucht? Was beim Wechsel wirklich zählt
Welche Lovable-Alternative passt? Replit, Emergent, Bolt, Blink, Base44 und v0 im Vergleich: Preise, Backend, Codeexport und Kosten einer Migration.5. Okt. 2026Build