Serveur MCP : régler l’attente au démarrage de Claude Code
Réglez le délai d’attente d’un serveur MCP dans Claude Code 2.1.274, distinguez les quatre timeouts et fiabilisez vos tâches automatisées en CI.


Pour maîtriser l’attente au démarrage d’un serveur MCP, définissez CLAUDE_CODE_MCP_STARTUP_WAIT_MS sur le nombre maximal de millisecondes pendant lequel une tâche Claude Code peut attendre ses serveurs MCP avant son premier tour non interactif. La valeur 0 supprime cette attente. Les tâches planifiées disposent ainsi d’un budget de disponibilité clair, sans modifier pour autant le timeout de connexion MCP, celui des outils MCP ni l’échéance globale de la tâche.
Combien de temps attendre un serveur MCP au démarrage ?
Lancez CLAUDE_CODE_MCP_STARTUP_WAIT_MS=5000 claude -p "Run the scheduled check" pour accorder jusqu’à cinq secondes au démarrage des serveurs MCP avant le premier tour. Choisissez CLAUDE_CODE_MCP_STARTUP_WAIT_MS=0 si la tâche peut commencer sans qu’aucun serveur MCP soit encore prêt.
Claude Code 2.1.274 a introduit cette variable le 17 septembre 2026. La note de version en précise deux aspects : la valeur borne, en millisecondes, l’attente du premier tour non interactif, et 0 signifie qu’il ne faut pas attendre. Aucun réglage par défaut n’est indiqué pour cette nouvelle variable. Mieux vaut donc la définir explicitement dans les tâches sans surveillance, afin qu’une future valeur par défaut ou une variable d’environnement propre à la machine ne modifie pas silencieusement votre politique de démarrage.
Par « non interactif », il faut entendre une exécution lancée avec -p ou --print : contrôle CI, tâche cron ou traitement piloté par un SDK. Ce réglage ne vise pas les sessions interactives dans un terminal.
La règle pratique tient en trois lignes :
Ces plages sont des recommandations d’exploitation, pas des valeurs par défaut d’Anthropic. Mesurez vos propres serveurs avant de les généraliser.
Ce que règle réellement l’attente au démarrage
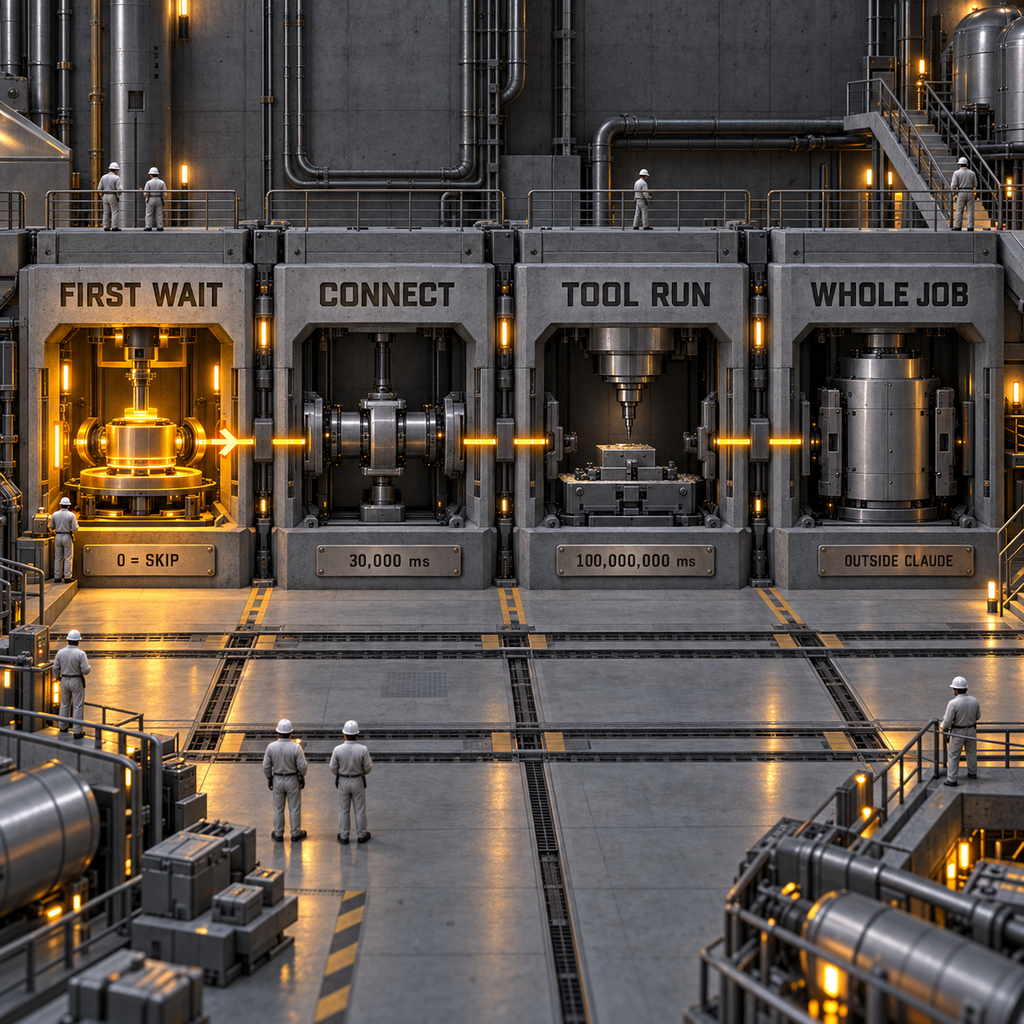
Imaginez le premier tour comme le départ d’un train et chaque serveur MCP comme un quai de correspondance. CLAUDE_CODE_MCP_STARTUP_WAIT_MS détermine combien de temps le train reste en gare pour attendre les voyageurs en correspondance. Cette variable ne décide ni du temps pendant lequel chacun peut tenter de rejoindre le quai, ni de la durée du travail après l’embarquement, ni de l’heure à laquelle le trajet complet doit impérativement prendre fin.
C’est précisément l’intérêt de ce périmètre restreint. Avant 2.1.274, les équipes se tournaient souvent vers MCP_TIMEOUT, qui pilote une autre horloge. Une tâche planifiée peut désormais choisir une courte fenêtre de disponibilité au premier tour, sans prétendre que chaque connexion serveur ou chaque appel d’outil ultérieur doit partager la même échéance.
Quatre horloges, quatre décisions en cas d’échec
La configuration la plus sûre attribue un rôle unique et explicite à chaque horloge.
Il existe aussi MCP_CONNECT_TIMEOUT_MS, dont la valeur par défaut est de 5,000 ms pour un lot de connexions bloquantes au démarrage. Cette variable s’applique aux comportements de démarrage bloquants, par exemple MCP_CONNECTION_NONBLOCKING=0, ou à un serveur marqué alwaysLoad: true. La référence des variables d’environnement d’Anthropic la distingue explicitement de MCP_TIMEOUT.
Pour les appels d’outils, un champ timeout défini sur un serveur dans .mcp.json remplace MCP_TOOL_TIMEOUT pour ce serveur. C’est pertinent lorsqu’une requête sur un entrepôt de données peut légitimement durer plus longtemps qu’une consultation de ticket. Ce réglage ne modifie toujours pas la nouvelle attente du premier tour.
Cette distinction explique aussi pourquoi 0 n’est pas un accélérateur universel. Lorsque la recherche d’outils est activée et que le prompt a ensuite besoin d’un serveur encore en cours de connexion, Claude Code attend dans ToolSearch. Si la recherche d’outils est désactivée, l’attente passe par WaitForMcpServers. Supprimer l’attente à l’entrée peut donc simplement la repousser plus loin dans la tâche.
Un test reproductible avec un serveur lent
Vous pouvez reproduire cette limite avec un serveur stdio local qui retarde uniquement sa réponse d’initialisation MCP. Enregistrez le code suivant dans slow-mcp.mjs :
import readline from "node:readline";

const delay = Number(process.env.SLOW_MCP_DELAY_MS || 5000);
const lines = readline.createInterface({ input: process.stdin });
const send = message => process.stdout.write(JSON.stringify(message) + "\n");

lines.on("line", line => {
  const request = JSON.parse(line);
  if (request.method === "initialize") {
    setTimeout(() => send({
      jsonrpc: "2.0",
      id: request.id,
      result: {
        protocolVersion: request.params.protocolVersion,
        capabilities: { tools: {} },
        serverInfo: { name: "slow-ready", version: "1.0.0" }
      }
    }), delay);
  } else if (request.method === "tools/list") {
    send({ jsonrpc: "2.0", id: request.id, result: { tools: [] } });
  }
});
Faites ensuite pointer Claude Code vers ce serveur avec slow-mcp.json :
{
  "mcpServers": {
    "slow-ready": {
      "type": "stdio",
      "command": "node",
      "args": ["./slow-mcp.mjs"],
      "env": { "SLOW_MCP_DELAY_MS": "5000" }
    }
  }
}
Exécutez le test avec CLAUDE_CODE_MCP_STARTUP_WAIT_MS=1000 MCP_TIMEOUT=10000 claude -p "Reply with OK." --mcp-config ./slow-mcp.json --strict-mcp-config --output-format stream-json --verbose.
L’option --strict-mcp-config écarte du test les serveurs utilisateur et projet sans rapport avec celui-ci. Le format de flux expose l’événement initial system/init, avec le nom et l’état de chaque serveur MCP. Il affiche également mcp_server_errors lorsqu’une configuration fournie n’est pas valide.
Résultat de la vérification locale
Une vérification de démarrage effectuée avant authentification sur Claude Code 2.1.274 a utilisé ce serveur de 5,000 ms. L’environnement n’étant pas connecté, l’exécution s’est arrêtée à l’étape d’authentification. La mesure ne porte donc que sur le démarrage, c’est-à-dire précisément la limite étudiée.
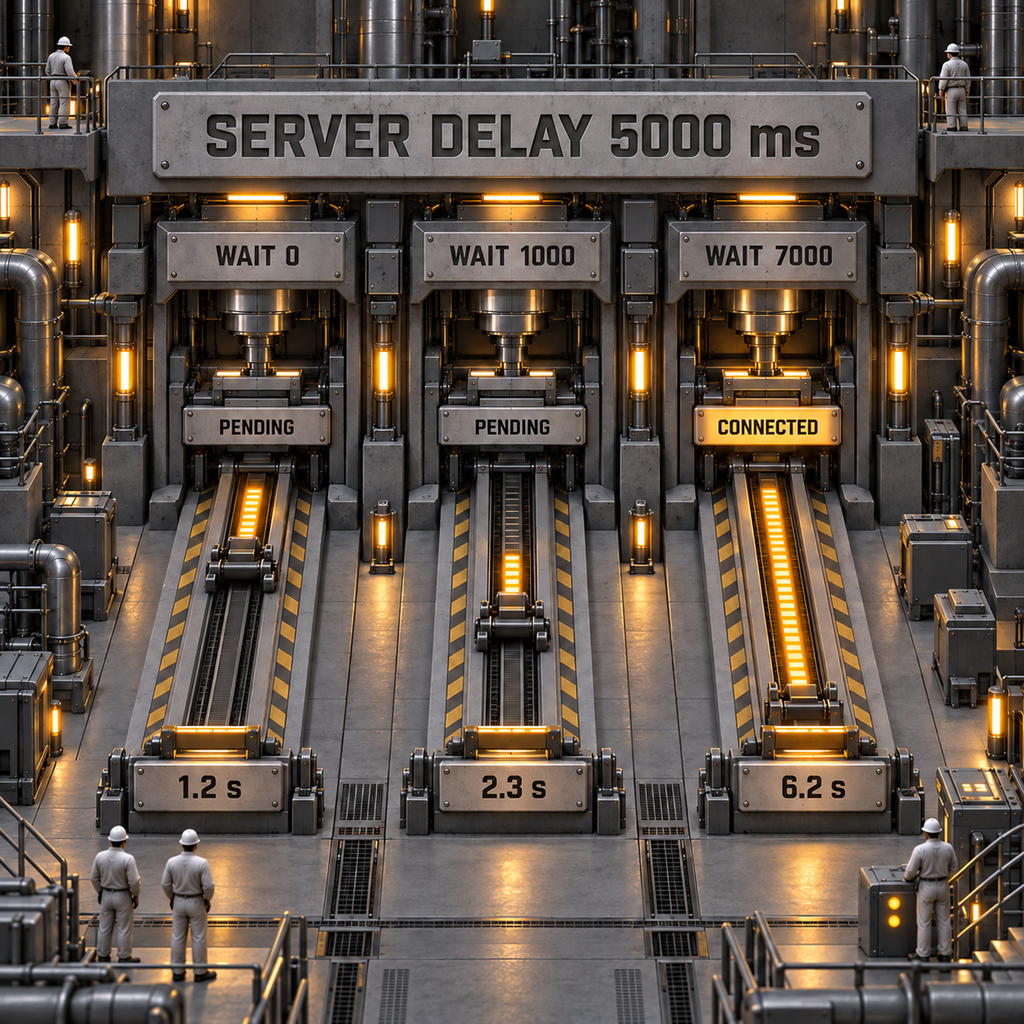
Les temps réels incluent le démarrage de Claude Code et de npx ; ils ne constituent donc pas des objectifs de service à recopier. Le constat utile est qualitatif : avec 0 et 1,000 ms, le contrôle du premier tour a été libéré alors que le serveur était encore en attente ; avec 7,000 ms, ce même serveur est apparu comme connecté. Ces mesures ne disent rien de la latence du modèle ni de la durée totale de la tâche.
Vérifier la disponibilité avant le travail métier
Un timeout ne répond qu’à la question « combien de temps attendons-nous ? ». En production, il faut aussi décider quels outils sont indispensables.
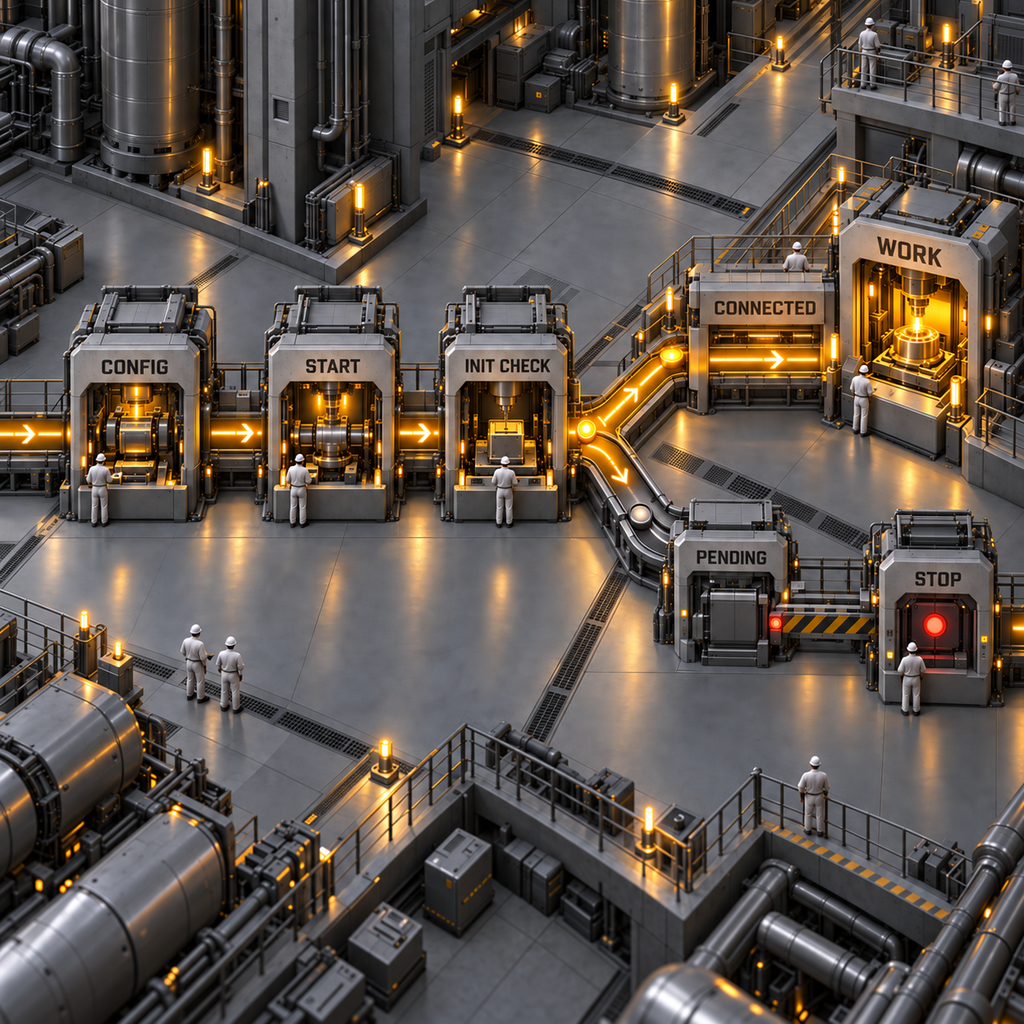
Mettez en place un contrôle en deux temps :
- Avant de lancer la tâche métier, vérifiez l’état de santé de chaque endpoint distant ou commande de serveur local indispensable. Pour les serveurs configurés et approuvés,
claude mcp listindique notamment s’ils sont connectés, s’ils nécessitent une authentification ou si leur connexion a échoué. - Dans le flux Claude Code, examinez
system/init.mcp_servers. Exigez que le serveur nommé ait le statutstatus: "connected", et refusez toute entréemcp_server_errorsnon vide qui le concerne. Gérez les serveurs en cache ou facultatifs au moyen d’une liste d’autorisation explicite.
Si un serveur indispensable reste en attente, interrompez l’exécution avant d’accepter le moindre résultat métier. S’il est facultatif, consignez le mode dégradé et poursuivez. Le délai d’attente devient alors un paramètre de la politique, et non la politique elle-même.
Le cache de découverte demande une attention particulière. Un serveur distant dont la liste d’outils est en cache peut apparaître comme étant en attente à l’initialisation, puis se connecter au premier appel d’outil. Ce fonctionnement convient aux outils facultatifs, mais ne tient pas une promesse stricte de disponibilité. Pour un outil indispensable, le contrôle doit exiger une connexion active ou effectuer sa propre vérification d’état.
Enfin, imposez au processus complet une échéance au niveau du planificateur. L’attente au démarrage ne peut empêcher une requête au modèle, une commande Bash, un hook ou un appel ultérieur à un outil MCP de consommer le reste de la fenêtre d’exécution.
L’enjeu économique tient surtout à la vitesse d’échec
Les économies de calcul existent, mais il est facile de les surestimer. Supposons que 10,000 tâches mensuelles attendent sinon 30 secondes complètes et que vous fixiez un budget de 3 secondes pour le premier tour. La capacité maximale récupérée atteint 4,500 minutes d’exécution.
GitHub affiche actuellement un tarif de $0.006 par minute pour un runner Linux hébergé standard à 2 cœurs, contre $0.062 par minute pour un runner macOS. À ces tarifs, 4,500 minutes représentent $27 de temps Linux ou $279 de temps macOS, avant déduction des minutes incluses. GitHub arrondit en outre la consommation de chaque tâche à la minute entière supérieure : gagner 27 secondes peut donc ne rien changer à la facture si la durée totale reste dans la même tranche de facturation.
Le principal bénéfice est opérationnel. Une tâche qui échoue à son contrôle de disponibilité en trois secondes laisse au planificateur le temps de réessayer, d’alerter la bonne personne ou de basculer vers une solution de repli. À l’inverse, une tâche qui démarre discrètement sans sa base de données ou son gestionnaire de tickets peut produire un résultat plausible mais incomplet, bien plus coûteux à détecter et à annuler que le temps de runner économisé.
Si vous devez également maîtriser les réponses volumineuses, le guide des limites de sortie des outils Claude Code traite séparément cette partie du workflow. Pour les installations sans surveillance et la politique réseau, associez ce contrôle de disponibilité à l’accès réseau par commande.
Sept workflows qui en profitent le plus
1. Rapports financiers et opérationnels planifiés
Une équipe financière lance à 6 h un rapport qui dépend d’un serveur MCP d’entrepôt de données. Déclarez ce serveur indispensable, ajoutez une petite marge à son temps de démarrage à froid mesuré et arrêtez la tâche s’il n’est pas connecté. L’intérêt ne se limite pas à accélérer l’exécution : vous évitez un rapport soigné, construit uniquement à partir des fichiers du dépôt alors que les chiffres en direct étaient indisponibles.
2. Contrôles automatisés du risque des pull requests
Une équipe plateforme exécute Claude Code sur chaque pull request à haut risque et attend les outils de GitHub, d’un gestionnaire de tickets et d’un scanner de sécurité. Le contrôle peut exiger le scanner et GitHub tout en considérant le gestionnaire de tickets comme facultatif. Les développeurs obtiennent ainsi un échec rapide et explicable, plutôt qu’une revue ayant silencieusement omis les éléments les plus importants.
3. Tâches de coordination des mises en production
Un responsable de release utilise un agent planifié pour comparer les changements fusionnés, les incidents ouverts et l’état du déploiement. Chaque source peut recevoir sa propre règle de disponibilité. Si le serveur MCP de déploiement est hors service, la tâche s’interrompt avant de rédiger des notes laissant entendre que la mise en production est sûre.
4. Triage nocturne du support
Une équipe support laisse une tâche regrouper les tickets, consulter l’historique des comptes et préparer des réponses. Les serveurs du centre d’assistance et des données clients sont indispensables ; Slack peut rester facultatif. Une attente bornée permet à la file d’avancer, tandis que la règle de disponibilité évite d’inventer du contexte client privé lorsqu’une source manque.
5. Assistants de réponse aux incidents
À partir d’une alerte, l’ingénieur d’astreinte lance un diagnostic non interactif. Un court budget de démarrage indique immédiatement si les logs et les métriques sont réellement accessibles. Si l’un de ces serveurs indispensables manque, le wrapper peut renvoyer sans délai vers le runbook manuel, au lieu de gaspiller la fenêtre d’intervention dans un diagnostic partiel.
6. Runners éphémères autoscalés
Une équipe lance un conteneur neuf pour chaque tâche d’agent. Les serveurs stdio locaux peuvent subir le coût de démarrage à froid du chargement des packages, des assistants d’authentification ou de la découverte de schéma. Mesurer ces démarrages permet de distinguer un budget de disponibilité réaliste de sept secondes d’un contournement permanent masquant un serveur défaillant.
7. Produits d’agents multi-tenant
Un produit dessert des clients dont les connexions MCP diffèrent. L’un peut avoir besoin de Salesforce, un autre de Linear, et un troisième d’aucun outil externe. Une liste de serveurs indispensables propre à chaque exécution permet à la même couche d’orchestration de choisir une courte attente par client, sans imposer à tous la lenteur de l’intégration la moins rapide.
Trois produits qui méritent d’être développés
1. Un contrôle de disponibilité MCP pour le CI Claude Code
C’est l’opportunité la plus solide. Le produit prendrait la forme d’un petit wrapper de runner : il lirait la politique des serveurs indispensables, démarrerait Claude Code avec une attente explicite, enregistrerait system/init, puis renverrait un échec de disponibilité exploitable par une machine avant d’accepter le résultat de l’agent.
La demande est étroite, mais commercialement intéressante : claude code automation représente environ 140 recherches mensuelles aux États-Unis, avec une hausse annuelle de 200% dans les données de suggestions et un CPC de $10.88. Les internautes demandent également comment automatiser l’exécution de Claude Code et comment configurer Claude Code avec MCP. Ces requêtes expriment directement le problème de configuration.
La plus petite version commercialisable serait une CLI dotée d’un fichier de politique, d’annotations GitHub Actions et de preuves JSON pour chaque exécution. La distribution reste le point faible. Anthropic peut enrichir ses politiques natives de disponibilité ; la valeur durable devra donc venir de l’historique inter-exécutions, des alertes et de la prise en charge de plusieurs runtimes d’agents.
2. Un linter de politiques de timeout
Cet outil analyserait les scripts shell, les fichiers CI, les réglages et .mcp.json, puis signalerait les horloges incohérentes : une attente de démarrage nulle malgré des outils indispensables, une courte échéance de tâche associée à un timeout d’outil de 28 heures, ou encore une intégration facultative sans aucune borne.
La requête exacte mcp server timeout génère environ 10 recherches mensuelles aux États-Unis et affiche une tendance annuelle de -67%. Parmi les recherches connexes figurent MCP_TOOL_TIMEOUT, ainsi que des questions sur la manière d’augmenter le timeout de Claude Code. La demande suffit à justifier une fonctionnalité du contrôle de disponibilité, pas une entreprise autonome.
Un MVP doit analyser GitHub Actions, les syntaxes shell courantes et la configuration MCP de Claude Code, puis proposer des corrections tranchées. Le risque tient au faux sentiment de sécurité : une configuration statique ne révèle pas la véritable distribution des temps de démarrage à froid d’un serveur sans mesures en conditions réelles.
3. Une télémétrie de démarrage pour les agents planifiés
Ce produit convertirait les événements system/init en une chronologie des latences de connexion, des états en attente, des configurations invalides et des exécutions dégradées. Les équipes plateforme paieraient pour suivre les tendances et recevoir des alertes à l’échelle de nombreux dépôts, plutôt que de lire manuellement des fichiers JSONL.
Il partage les 140 recherches mensuelles de claude code automation, tandis que claude code browser automation en ajoute 40 et affiche lui aussi une hausse annuelle de 200% dans les données de suggestions. Le signal général est clair : les équipes intègrent Claude Code à des tâches répétables, où les preuves de démarrage deviennent un sujet d’exploitation.
Le MVP se compose d’un collecteur d’événements, d’une cartographie des serveurs indispensables ou facultatifs et d’alertes lorsque la disponibilité dépasse un objectif de service. La sensibilité des données constitue la difficulté majeure. Les noms MCP et les métadonnées d’outils peuvent révéler des systèmes internes : le masquage et l’auto-hébergement doivent donc faire partie du produit dès le départ, pas être traités plus tard comme de simples finitions pour les grands comptes.
Limites et conclusion sans détour
Ce réglage résout une petite partie, néanmoins précieuse, de la fiabilité des automatisations. Il ne répare pas un serveur MCP défaillant, ne réauthentifie pas un connecteur expiré, ne raccourcit pas un appel d’outil ultérieur et n’arrête pas l’ensemble du processus Claude Code.
N’utilisez pas 0 lorsque la première action utile d’une tâche dépend de MCP. Le serveur peut apparaître comme pending à l’initialisation, puis l’attente revenir lors de la recherche de l’outil. À l’inverse, n’augmentez pas la valeur jusqu’à donner l’illusion que des serveurs instables sont sains. Les serveurs HTTP et SSE réessaient après les échecs transitoires de la première connexion, mais les erreurs d’authentification ou de ressource introuvable exigent une correction de configuration. Une attente plus longue ne fait que retarder ce constat.
Les serveurs stdio ne se reconnectent pas non plus automatiquement après une coupure en cours de session. Une fenêtre de démarrage généreuse ne garantit en rien leur état de santé dix minutes plus tard.
La meilleure politique est stricte et sans surprise : une courte attente explicite au premier tour, une liste de serveurs indispensables, un contrôle de leur état, un timeout distinct pour les outils et une échéance globale pour la tâche. Cet ensemble produit des échecs exploitables plutôt que des délais mystérieux.
Comment augmenter le timeout de Claude Code ?
Choisissez le timeout correspondant à l’étape lente. Utilisez CLAUDE_CODE_MCP_STARTUP_WAIT_MS pour l’attente de disponibilité MCP au premier tour non interactif, MCP_TIMEOUT pour le démarrage du serveur, MCP_TOOL_TIMEOUT ou un timeout propre au serveur pour l’exécution d’un outil, et la limite de votre runner pour la tâche complète.
Comment automatiser l’exécution de Claude Code ?
Lancez Claude Code en mode non interactif avec -p ou --print, définissez les permissions des outils sans surveillance, imposez une échéance au niveau du planificateur et rendez la disponibilité MCP explicite. Une simple attente au démarrage ne suffit pas à sécuriser une tâche automatisée.
Pourquoi Claude Code expire-t-il sans cesse ?
Commencez par repérer l’étape concernée dans les logs. Un délai avant system/init renvoie plutôt au démarrage ou à la disponibilité de la connexion. Un échec pendant l’appel d’un outil MCP pointe vers les limites de l’outil, d’inactivité ou de requête réseau. Un processus interrompu par le CI relève de l’échéance globale de la tâche.
Comment configurer Claude Code avec MCP ?
Ajoutez une configuration MCP au niveau du projet ou de l’utilisateur, ou fournissez un fichier avec --mcp-config. Pour les tâches reproductibles, ajoutez --strict-mcp-config, fixez une attente explicite au premier tour et vérifiez les serveurs indispensables dans system/init, au lieu de supposer qu’un serveur configuré est forcément connecté.
Lundi, choisissez une tâche Claude Code planifiée, mesurez le démarrage à froid de ses serveurs MCP indispensables, fixez la plus petite attente réaliste et faites échouer tout serveur indispensable encore en attente avant d’accorder la moindre confiance au résultat. Si vous souhaitez déployer cette couche de fiabilité dans tous vos workflows d’agents, je peux vous aider à construire le système de production.
- Dernière mise à jour
- 17 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Cloudflare : bloquer l’entraînement de l’IA sans sacrifier le SEO
Sur Cloudflare, réglez Search sur Allow et Training sur Disallow AI Training, puis vérifiez robots.txt pour préserver le SEO sans autoriser l’entraînement.16 sept. 2026Build
Dictée vocale hors ligne : faut-il installer Murmure ?
Murmure propose une dictée vocale gratuite et hors ligne. Notre test évalue sa précision, ses règles de correction, sa confidentialité et ses limites.14 sept. 2026Build
Tarifs RenderIO : le vrai coût de cette API FFmpeg
Découvrez les tarifs RenderIO, le coût réel des crédits FFmpeg et les seuils à partir desquels Starter, Growth ou Business devient le choix le plus rentable.14 sept. 2026Build
Logiciel de dictée vocale Dictare : le vrai coût du gratuit
Dictare est un logiciel de dictée vocale gratuit et local. Voici son prix réel, les coûts à prévoir et son intérêt face à Spokenly et Wispr Flow.13 sept. 2026Build
Plugins Claude Code : mesurer leur impact avec les evals natives
Apprenez à tester les plugins Claude Code avec les evals natives, mesurer leur impact réel et bloquer les régressions grâce à un garde-fou CI.12 sept. 2026Build
Agent vocal IA Cloudflare : diagnostiquer chaque latence
Identifiez l’étape qui ralentit ou bloque un agent vocal IA Cloudflare grâce aux métriques de tour, avant de changer de modèle ou de fournisseur.12 sept. 2026Build
Sous-titrer une vidéo avec Rendi : incruster un fichier SRT
Sous-titrer une vidéo avec un fichier SRT via l’API Rendi : préparez les fichiers, lancez FFmpeg, contrôlez le rendu et maîtrisez les coûts.11 sept. 2026Build