Cloudflare : bloquer l’entraînement de l’IA sans sacrifier le SEO
Sur Cloudflare, réglez Search sur Allow et Training sur Disallow AI Training, puis vérifiez robots.txt pour préserver le SEO sans autoriser l’entraînement.



Pour bloquer l’entraînement de l’IA sans couper les robots des moteurs de recherche, réglez Search sur Allow et Training sur Disallow AI Training, puis vérifiez à la fois les paramètres migrés et le fichier robots.txt servi par Cloudflare. Cette vérification est devenue indispensable depuis que Cloudflare a changé le sens de Block, le 15 septembre 2026. Désormais, ce réglage peut aussi empêcher des crawlers à usage mixte comme Googlebot, Applebot et Bingbot d’accéder au site pour le référencement.
Comment bloquer l’entraînement de l’IA sans perdre le référencement
Pour la plupart des sites tributaires des moteurs de recherche, le bon réglage tient en une ligne : autoriser Search, refuser Training et décider séparément du sort des Agents.
Dans son explication du 15 septembre, Cloudflare ne laisse aucune ambiguïté : choisissez Disallow AI Training pour refuser l’entraînement tout en préservant la recherche. Ne suivez pas un ancien guide qui recommande Training: Block. Avant cette évolution, les crawlers à usage mixte échappaient à ce blocage. Ce n’est plus le cas.
Ce contrôle est proposé dans toutes les offres Cloudflare : aucune montée en gamme n’est nécessaire. La dépense ne consiste donc plus à acheter un autre outil de blocage, mais à vérifier que la politique déclarée produit bien le comportement attendu. À titre de comparaison, une licence Screaming Frog SEO Spider coûte $279 par an aux États-Unis, tandis qu’un outil spécialisé dans la surveillance de robots.txt affiche une formule à $129 par mois. Cloudflare fournit le contrôle ; il reste à mettre en place la boucle de vérification.
Ce que fait réellement Disallow AI Training
Disallow exprime une préférence assortie d’une application sélective ; Block, lui, ferme la porte à clé.
Imaginez un crawler à usage mixte comme une camionnette qui transporte deux ordres de mission. Le premier dit : « indexer cette page pour la recherche ». Le second : « utiliser cette page pour entraîner un modèle ». Bloquer la camionnette interrompt les deux missions. Avec Disallow AI Training, un opérateur conforme aux critères Accountable peut conserver la mission de recherche, mais doit renoncer à celle d’entraînement.
Cloudflare répartit le trafic automatisé en trois usages :
- Search construit un index de recherche.
- Training entraîne ou affine un modèle.
- Agent consulte le site pour le compte d’une personne, par exemple via un assistant conversationnel qui récupère une page ou un agent pilotant un navigateur.
La nouvelle option Training demande à Bot Preference Sync de publier les consignes de refus d’entraînement correspondantes dans robots.txt. Les crawlers à usage mixte classés Accountable restent autorisés à accéder au site pour la recherche. Les crawlers d’Amazon, Anthropic, Meta et OpenAI dédiés à l’entraînement sont bloqués, sans bloquer du même coup leurs robots de recherche distincts.
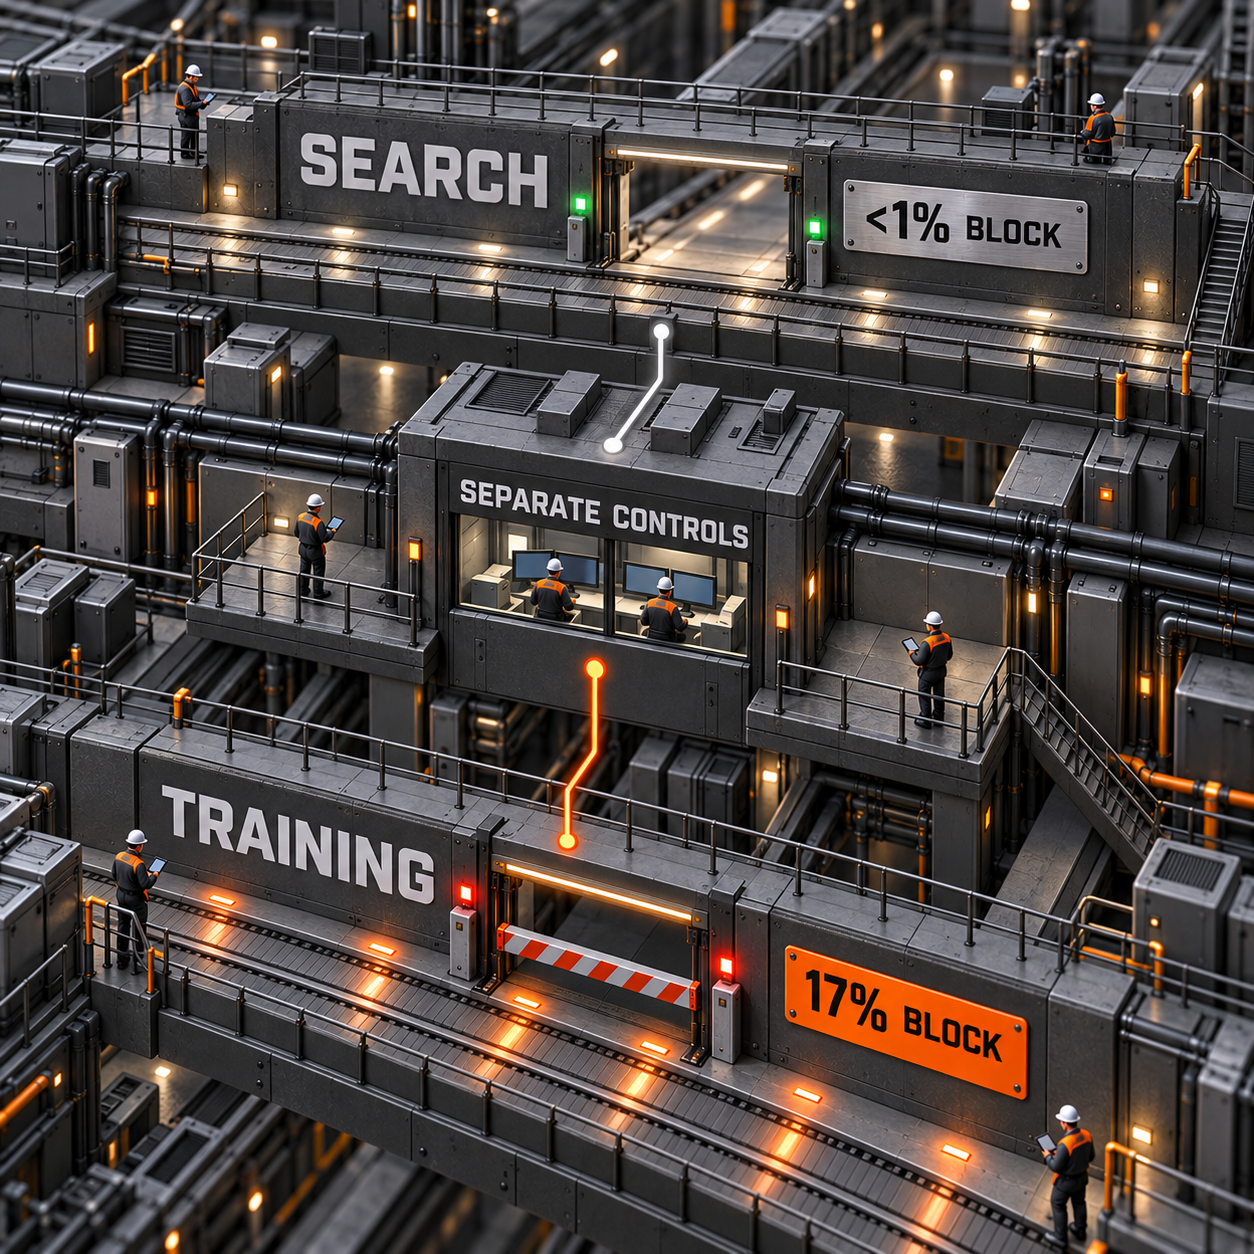
Selon Cloudflare, moins de 1% de ses sites bloquent les robots de recherche, alors que 17% activent un mécanisme destiné à bloquer l’entraînement. Cet écart explique la conception du produit : un unique interrupteur Block AI était trop radical au regard des besoins réels des propriétaires de sites.
Une distinction reste essentielle. Une instruction robots.txt n’est pas un champ de force. À elle seule, elle ne permet ni d’identifier l’entité qui explore le site, ni de connaître son intention, ni d’arrêter un crawler qui l’ignore. Cloudflare associe donc la préférence publiée à sa classification réseau et au blocage des crawlers qui ne remplissent pas les conditions du parcours Accountable.
Le statut Accountable ne garantit pas que tout soit déjà disponible
Chez Cloudflare, l’étiquette Accountable doit être lue comme un statut adossé à une feuille de route, et non comme la preuve que chaque contrôle promis fonctionne déjà.
Pour être éligible, un opérateur doit respecter — ou s’engager à respecter — des exigences portant sur le refus de l’entraînement, le refus des résumés générés par l’IA, la visibilité URL par URL et la garantie qu’un refus d’entraînement ne pénalisera pas la recherche traditionnelle. La nuance est importante.
- Google : Google-Extended peut être refusé dans robots.txt, et Google indique que ce choix n’influe pas sur le classement dans les résultats de recherche. Google propose aussi un contrôle destiné aux webmasters pour la recherche générative, ainsi que des rapports. En revanche, la transparence supplémentaire de Google-Extended au niveau de chaque URL était encore annoncée pour les semaines suivant la présentation.
- Apple : Applebot-Extended permet de refuser l’entraînement dans robots.txt. Apple prend également en charge
nosnippetpour les résumés générés par l’IA et le balisage des paywalls. L’inspection URL par URL n’était pas disponible le jour de l’annonce et figurait parmi les travaux prévus pour l’année suivante. - Microsoft : le dispositif actuel de Bing est différent. Les propriétaires de sites peuvent combiner
NOARCHIVEavec les outils Block URLs ou Content Removal de Bing. Microsoft vise le début de 2027 pour que Bingbot respecte une préférence de refus d’entraînement à l’échelle du domaine dans robots.txt. D’ici là, le réglage Disallow AI Training de Cloudflare ne transmet pas automatiquement cette préférence à Bing via robots.txt.
La promesse exacte est donc plus étroite que « un interrupteur contrôle tous les usages, partout ». Le nouveau réglage clarifie nettement l’arbitrage entre recherche et entraînement, mais Bing exige encore une vérification séparée aujourd’hui.
Vérifier les réglages migrés par Cloudflare
La plupart des paramètres sont repris automatiquement. Toutefois, les libellés et leurs effets ont suffisamment changé pour justifier un audit.
Si un domaine n’utilisait pas encore les contrôles détaillés Search, Training et Agent, Cloudflare convertit l’ancien réglage Block AI Bots de la manière suivante :
Lorsqu’un domaine utilisait déjà les contrôles détaillés, Search et Agent conservent leur état effectif. Training: Allow reste sur Allow. Training: Block et Training: Block on pages with ads deviennent tous deux Disallow AI Training.
Voici la procédure à suivre pour contrôler la migration :
- Ouvrez le domaine dans Cloudflare, accédez à Security Settings, puis à Configure AI bot policies.
- Notez les valeurs actuelles de Search, Training et Agent avant toute modification.
- Réglez Search sur Allow si la découverte organique compte pour votre activité.
- Réglez Training sur Disallow AI Training si vous souhaitez refuser l’entraînement sans exclure de la recherche les crawlers à usage mixte classés Accountable.
- Choisissez la politique Agent selon vos propres besoins. Cloudflare ne propose pas de préférence Disallow pour les Agents, faute de directive Internet reconnue à ce jour.
- Vérifiez que Bot Preference Sync est activé si vous voulez que Cloudflare publie la politique de chaque catégorie dans robots.txt.
- Enregistrez la politique, puis inspectez le résultat public au lieu de considérer le libellé du tableau de bord comme une preuve.
Pour les nouveaux domaines financés par la publicité, le préréglage recommandé par Cloudflare applique déjà cette logique : Preference Sync activé, Search autorisé, Training refusé et Agents bloqués sur les pages publicitaires. Les nouveaux domaines sans monétisation publicitaire démarrent avec les trois usages autorisés.
Comment vérifier l’accès des moteurs de recherche après le changement
Un interrupteur apparemment bien réglé n’est que le premier point de contrôle. Il faut vérifier la politique de l’extérieur vers l’intérieur.
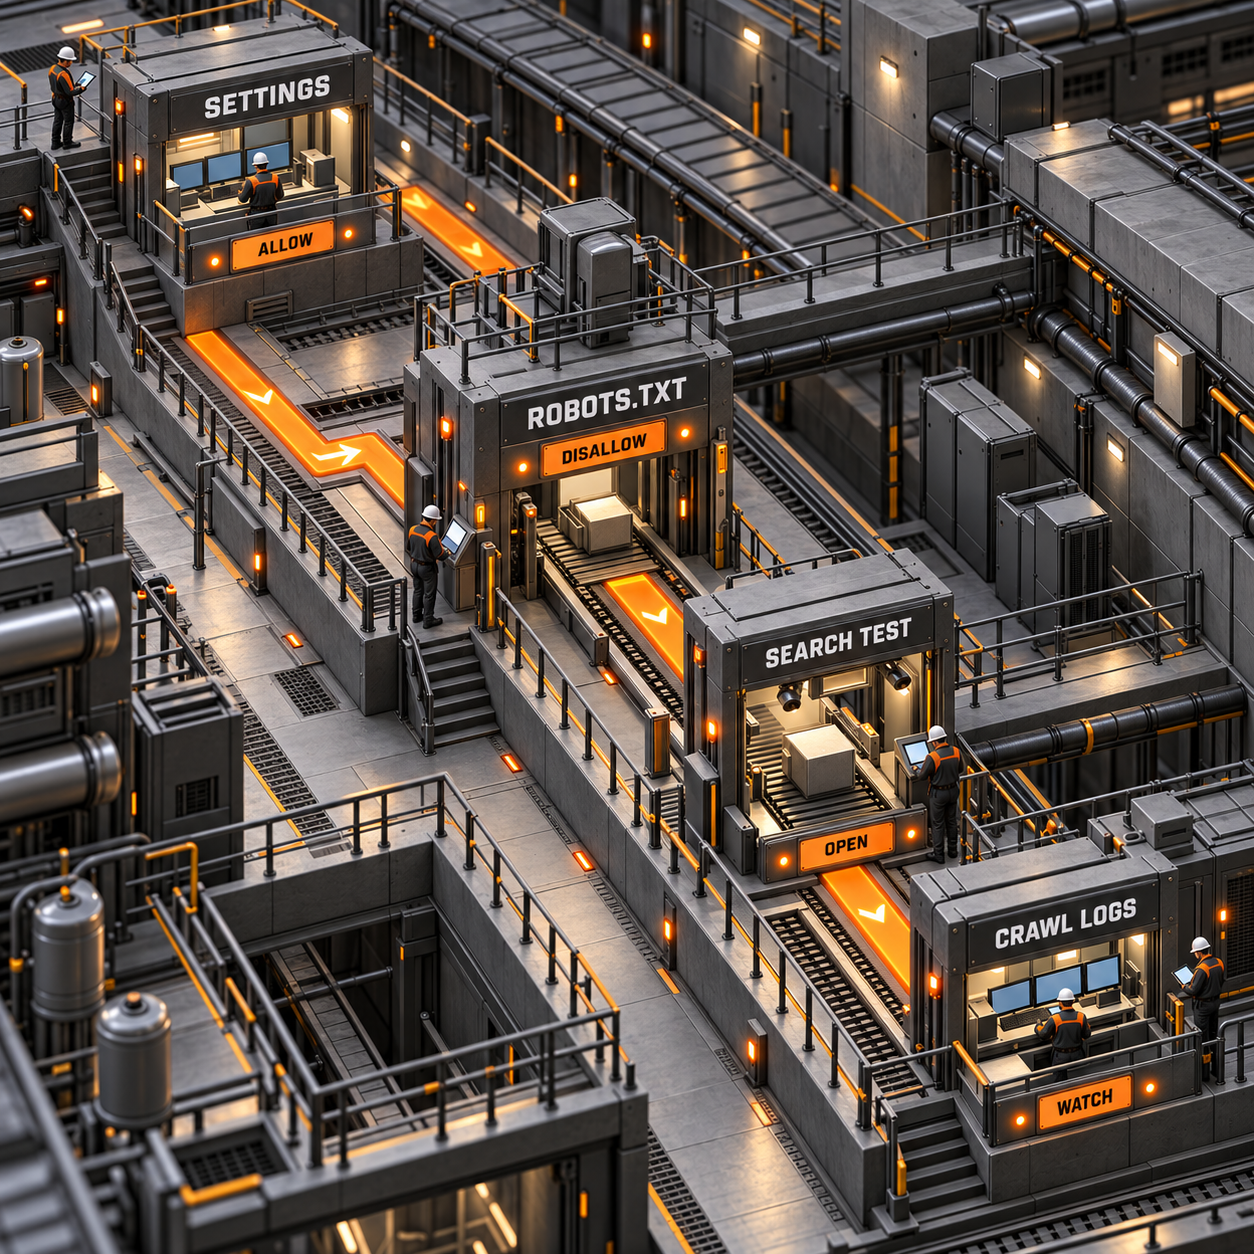
Procédez en quatre temps :
- Paramètres : confirmez que Search affiche Allow et Training, Disallow AI Training. Examinez Agent séparément.
- robots.txt : récupérez le fichier
/robots.txtpublic du domaine. Bot Preference Sync ajoute ses règles générées au début du fichier existant ; vos directives Disallow d’origine restent donc présentes. Recherchez d’éventuels conflits dans les deux parties. - Comportement dans la recherche : utilisez les outils pour webmasters et les rapports du moteur de recherche afin d’inspecter des URL représentatives. Ne déduisez pas l’état de l’accès à partir du seul mot « Disallow ». Il vise l’identité ou la préférence d’entraînement, pas l’usage de recherche traditionnel d’un crawler à usage mixte classé Accountable.
- Activité des crawlers : surveillez dans AI Crawl Control les requêtes, le respect de robots.txt et les blocages inattendus. Cloudflare peut appliquer des actions crawler par crawler et consigne leur activité : c’est donc l’endroit le plus pratique pour repérer une politique qui ne se comporte pas comme prévu.
Les règles personnalisées méritent une vigilance particulière. Bot Preference Sync reflète la politique de toute une catégorie, mais n’intègre pas les règles individuelles complexes au fichier généré. Si vous avez prévu une exception de licence pour un crawler, une logique propre à certains chemins ou une règle WAF personnalisée, comparez manuellement ces différentes couches. Cloudflare permet de désactiver Sync et de gérer le fichier soi-même lorsque la politique par catégorie manque de précision.
Qui gagne le plus à bloquer les bots IA de cette façon
Les premiers bénéficiaires sont les entreprises qui gagnent de l’argent lorsqu’un internaute consulte une page, mais ne souhaitent pas voir leurs archives absorbées dans des données d’entraînement.
L’exemple du commerçant révèle aussi une limite : ces contrôles s’appliquent à l’échelle du domaine. Ils ne constituent pas un système de consentement natif article par article. Des zones distinctes peuvent appliquer des politiques différentes, mais une zone ne dispose que d’une position Search, Training et Agent, sauf à ajouter soi-même des règles plus précises.
Les produits qui valent la peine d’être construits
Le produit le plus solide n’est pas un générateur de robots.txt supplémentaire, mais un outil de surveillance des régressions de politique des crawlers.
1. Moniteur de régression des politiques de crawlers
Construisez pour les agences et les équipes multisites un moniteur qui lit la politique Cloudflare, récupère le robots.txt servi, contrôle l’accès de pages représentatives pour la recherche et donne l’alerte dès que ces couches divergent.
La demande existe autour de ce besoin : robots.txt generator recueille environ 1,000 recherches mensuelles aux États-Unis, et google indexing checker environ 110. Les outils en place montrent aussi qu’un budget est disponible. Un produit de surveillance de robots.txt facture $129 par mois pour une formule limitée à cinq domaines, tandis qu’un logiciel de bureau qui suit les modifications SEO est proposé à $179 en achat unique.
La plus petite version commercialisable a besoin de quatre fonctions : import des zones Cloudflare, comparaison entre politique et robots.txt, contrôles planifiés, puis alerte par e-mail ou Slack indiquant la modification exacte. Ajoutez l’activité des crawlers et les données pour webmasters une fois que le détecteur de dérive central a gagné la confiance des utilisateurs.
La difficulté tient à la preuve. La configuration et les requêtes observées peuvent démontrer ce que le site a publié et bloqué. Elles ne permettent pas de prouver qu’un fournisseur de modèles a supprimé les données déjà collectées. L’avantage défendable devra venir de preuves fiables sur un grand nombre de domaines, pas d’un interrupteur plus élégant.
2. Auditeur de migration Cloudflare
Construisez un audit ciblé qui repère les zones restées sur des combinaisons risquées après la migration, puis produit un rapport correctif pour une agence, un groupe de médias ou un réseau de franchises.
cloudflare block ai bots attire environ 50 recherches mensuelles aux États-Unis, avec un CPC de $13.19 ; google indexing checker ajoute 110 recherches mensuelles autour de la conséquence redoutée. La demande est plus faible que sur le marché des générateurs, mais le coût du clic suggère que les personnes qui lancent cette recherche font face à un problème opérationnel immédiat.
Le MVP peut lire via l’API les champs Search, Training, Agent et Bot Preference Sync, récupérer le robots.txt public, puis classer chaque zone comme sûre pour la recherche, volontairement bloquée ou incohérente. Il doit aussi exporter un dossier de preuves prêt à remettre au client, où le réglage et le fichier observé figurent côte à côte.
Le principal risque vient de la plateforme. Cloudflare peut ajouter le même rapport à l’échelle d’un portefeuille, et le besoin connaît des pics lors des migrations. Le meilleur modèle économique consiste à utiliser l’audit comme produit d’entrée, puis à vendre une surveillance continue des régressions chez Cloudflare et d’autres fournisseurs de périphérie réseau.
Ce que ce contrôle ne résout pas
La frontière de politique est plus nette, mais elle ne règle pas tout ce qui concerne l’utilisation des contenus par l’IA.
- Elle n’efface pas les contenus déjà collectés. Cloudflare décrit des préférences de crawl et des contrôles de requêtes, pas une suppression rétroactive.
- Elle ne garantit pas que chaque opérateur respecte robots.txt. Cloudflare ajoute un blocage au niveau du réseau pour les crawlers hors du parcours Accountable, mais celui-ci repose toujours sur le respect de la préférence par l’opérateur.
- Elle ne permet pas de refuser tous les résumés générés par l’IA. Les contrôles de résumé sont distincts, et Cloudflare présente un dispositif centralisé plus large comme un chantier futur.
- Elle n’ajoute pas d’état Disallow pour les Agents.
- Elle ne traduit pas les règles personnalisées complexes, crawler par crawler, dans Bot Preference Sync.
- Elle ne transmet pas encore automatiquement à Bing la préférence de refus d’entraînement via robots.txt. Contrôlez séparément les outils actuels
NOARCHIVEet pour webmasters de Bing. - Elle ne correspond pas à l’indexation de fichiers R2 par Cloudflare AI Search. Il s’agit d’un autre produit et d’un autre workflow.
Choisissez Block si vous voulez réellement bannir le crawler. Choisissez Disallow AI Training si votre modèle économique dépend encore de la visibilité dans les moteurs de recherche. Toute l’évolution de septembre tient dans cette distinction.
À faire dès lundi
La semaine prochaine, sélectionnez trois domaines représentatifs : un site financé par la publicité, un site porté par la recherche et un domaine doté de règles personnalisées pour les crawlers. Consignez les valeurs migrées de Search, Training et Agent, ne modifiez que les sites dont l’objectif métier est clair, puis archivez le robots.txt public et le rapport sur les crawlers avec le ticket de changement. Si ces trois tests réussissent, déployez le même contrôle fondé sur des preuves dans tout le portefeuille.
Comment désactiver l’entraînement de l’IA ?
Sur un domaine géré par Cloudflare, réglez Training sur Disallow AI Training pour publier une préférence de refus d’entraînement tout en conservant l’accès des crawlers à usage mixte classés Accountable pour la recherche. N’utilisez Block que si vous acceptez aussi son impact sur l’exploration destinée au référencement.
Peut-on bloquer tous les contenus liés à l’IA ?
Vous pouvez bloquer des catégories ou des crawlers individuels, mais « tous les contenus liés à l’IA » recouvre plusieurs tâches différentes. Cloudflare sépare les trafics Search, Training et Agent afin de laisser choisir les usages automatisés autorisés. Bloquer Training ne retire pas les contenus générés par l’IA des produits de recherche et n’efface pas les données déjà collectées.
Comment désactiver le mode IA dans la recherche ?
Le réglage des crawlers de Cloudflare ne désactive pas une expérience de recherche IA pour les utilisateurs. Il régit l’accès à votre domaine. Google et d’autres opérateurs proposent des contrôles séparés pour les résumés génératifs ; indexation traditionnelle et préférences d’entraînement restent des décisions distinctes.
Pour faire construire ce type de couche d’audit et de surveillance des politiques de crawlers pour votre entreprise, découvrez les systèmes d’IA en production.
- Dernière mise à jour
- 16 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Dictée vocale hors ligne : faut-il installer Murmure ?
Murmure propose une dictée vocale gratuite et hors ligne. Notre test évalue sa précision, ses règles de correction, sa confidentialité et ses limites.14 sept. 2026Build
Tarifs RenderIO : le vrai coût de cette API FFmpeg
Découvrez les tarifs RenderIO, le coût réel des crédits FFmpeg et les seuils à partir desquels Starter, Growth ou Business devient le choix le plus rentable.14 sept. 2026Build
Logiciel de dictée vocale Dictare : le vrai coût du gratuit
Dictare est un logiciel de dictée vocale gratuit et local. Voici son prix réel, les coûts à prévoir et son intérêt face à Spokenly et Wispr Flow.13 sept. 2026Build
Plugins Claude Code : mesurer leur impact avec les evals natives
Apprenez à tester les plugins Claude Code avec les evals natives, mesurer leur impact réel et bloquer les régressions grâce à un garde-fou CI.12 sept. 2026Build
Agent vocal IA Cloudflare : diagnostiquer chaque latence
Identifiez l’étape qui ralentit ou bloque un agent vocal IA Cloudflare grâce aux métriques de tour, avant de changer de modèle ou de fournisseur.12 sept. 2026Build
Sous-titrer une vidéo avec Rendi : incruster un fichier SRT
Sous-titrer une vidéo avec un fichier SRT via l’API Rendi : préparez les fichiers, lancez FFmpeg, contrôlez le rendu et maîtrisez les coûts.11 sept. 2026Build
Agent IA OpenAI : Agents API ou Agents SDK, lequel choisir ?
Agents API ou Agents SDK pour votre agent IA ? Comparez contrôle, sessions, coûts et exigences sur les données avant de choisir l’architecture OpenAI.11 sept. 2026Build