LLM observability en 2026 : quel outil choisir selon votre équipe et votre budget ?
Comparez six outils d’observabilité LLM : coûts selon la taille de votre équipe, limites gratuites, licences et hébergement pour choisir en production.


En matière de LLM observability, Langfuse, une plateforme de traçage et d’évaluation, constitue le meilleur point de départ pour une petite équipe en production : le scénario de 100,000 exécutions détaillé ci-dessous revient à $69.80/mois avec Core, hors calcul des modèles et des évaluateurs. Le choix change si vos mises en production reposent sur les évaluations, si vous cherchez une gateway ou un hébergement privé, ou si vous devez analyser les incidents dans un environnement Datadog existant.
LLM observability : les outils à retenir
Partez sur Langfuse pour un tableau de bord de production partagé, LangSmith pour améliorer vos agents dans un workflow centré sur LangChain, Helicone pour suivre les requêtes via une gateway, Arize Phoenix pour un déploiement privé que vous exploitez, Braintrust pour décider des mises en production à partir d’évaluations, et Datadog Agent Observability pour les incidents de production qui traversent la pile applicative. La taille de l’équipe pèse surtout lorsque chaque personne qui doit examiner un échec devient un utilisateur facturé.
Une trace conserve le déroulement d’une exécution de l’application. Un span représente une opération dans cette trace : appel de modèle, récupération de données ou invocation d’un outil, par exemple. Une évaluation, souvent abrégée en eval, vérifie que le résultat respecte une règle ou un niveau de qualité. Ces trois éléments sont nécessaires pour comprendre pourquoi un agent a fourni une réponse plausible après avoir effectué la mauvaise action.
Tarifs vérifiés le 5 octobre 2026 sur la page de tarification officielle de chaque fournisseur. Tous les montants sont en USD. Sauf mention explicite, les prix de départ excluent la consommation supplémentaire et les frais des fournisseurs de modèles. Ce comparatif s’appuie sur les tarifs et la documentation en vigueur ; il ne prétend pas classer les performances à partir de tests pratiques.
Sources : tarifs Langfuse, tarifs LangSmith, tarifs Helicone, tarifs Arize, tarifs Braintrust et tarifs Datadog.
Le point décisif est l’unité facturée en supplément. Une plateforme qui compte les traces applicatives ne mesure pas le même volume qu’une autre qui compte chaque appel de modèle, observation, score ou gigaoctet. Estimez d’abord les enregistrements que produit votre application, puis comparez les abonnements.
Quel budget mensuel pour 100,000 exécutions d’agent ?
Pour le même agent et une équipe de cinq personnes, la facture peut être de $69.80 chez Langfuse ou de $645 chez LangSmith, selon les hypothèses ci-dessous. Aucun de ces montants ne mesure la qualité du produit. L’écart vient du décompte des événements, des volumes inclus et des frais par utilisateur.
Voici le scénario de production retenu pour le calcul :
- 100,000 exécutions complètes d’agent par mois, avec une trace par exécution.
- Cinq opérations observées par exécution : un workflow racine, deux appels de modèle, une récupération de données et un appel d’outil.
- 200,000 appels de modèle et 500,000 opérations observées au total.
- 10,000 scores d’évaluation par code calculés à l’extérieur de la plateforme, à raison d’un score par exécution échantillonnée. Les appels de modèle ou traces d’évaluateur supplémentaires sont exclus du scénario.
- Cinq utilisateurs qui ont besoin d’accéder au tableau de bord.
- 5 GB de données traitées dans Braintrust et, séparément, 5 GB de stockage comptabilisé dans Helicone. Ces hypothèses sont indépendantes : les compteurs d’octets des fournisseurs ne sont pas interchangeables.
Ce scénario ressemble à un agent de support qui lit une demande, récupère une commande, appelle un outil de gestion des commandes, puis sollicite un modèle pour préparer la réponse finale. Les chiffres servent à établir un budget ; ils ne proviennent pas de mesures sur une application déployée. Un agent qui réessaie, emprunte plusieurs branches ou exécute ses évaluateurs dans la plateforme produit d’autres enregistrements.
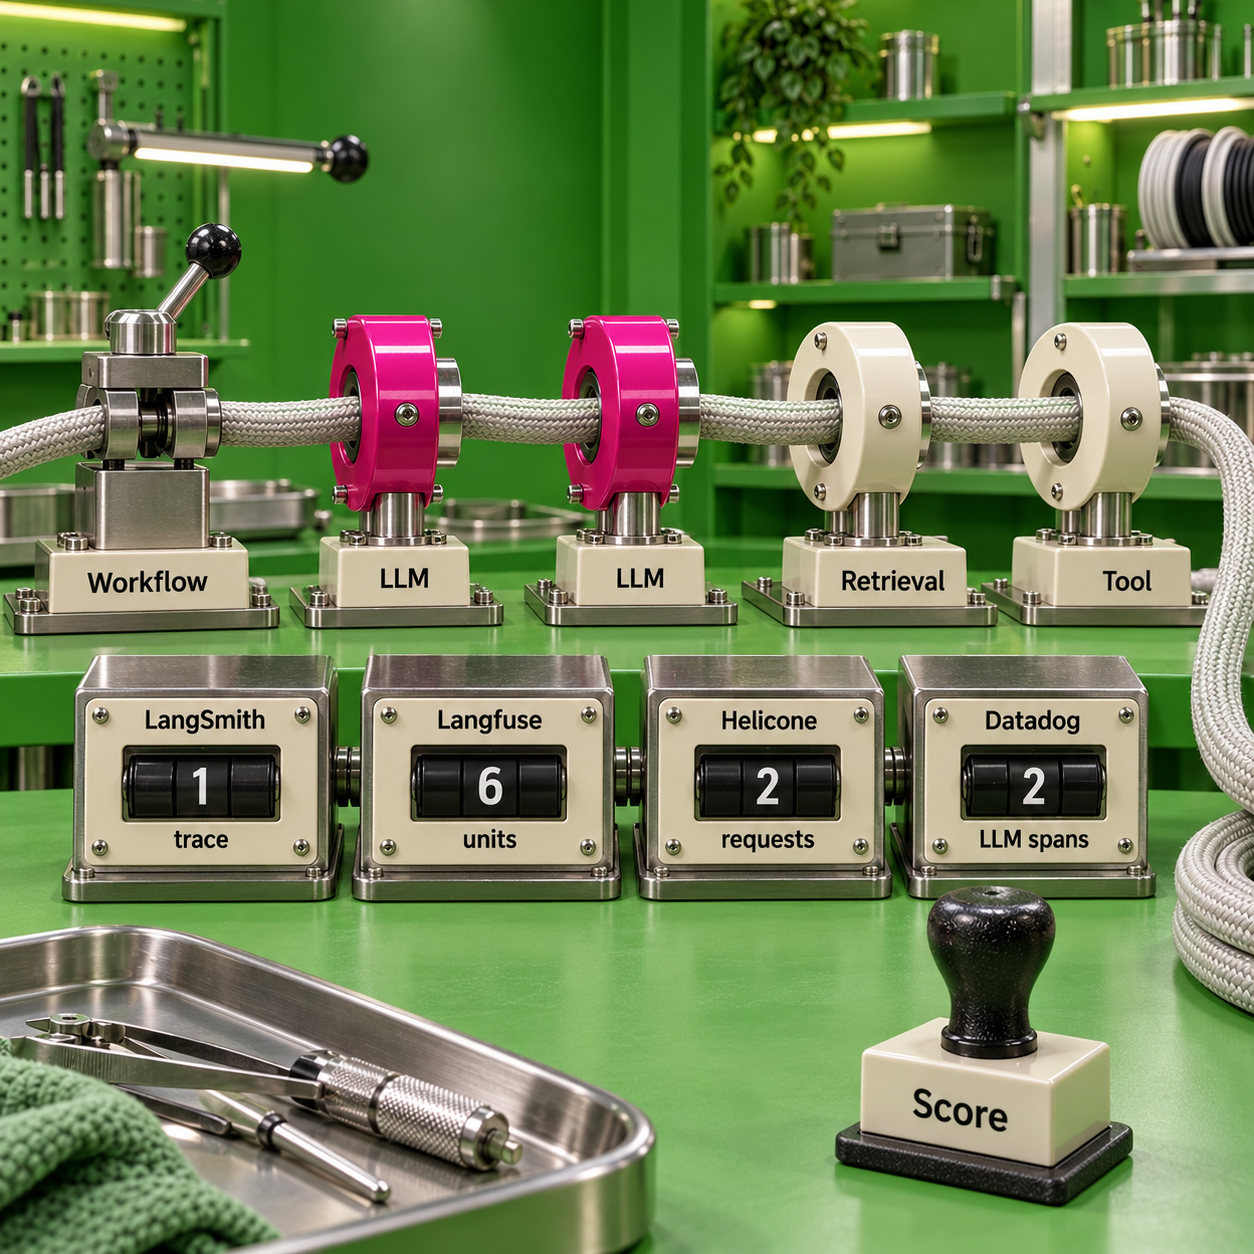
Ces montants sont calculés à partir des tarifs en vigueur accessibles via les liens précédents. Le total LangSmith utilise le prix de $0.005 par trace de base indiqué dans l’infobulle actuelle, avec 10,000 traces incluses pour l’ensemble de l’organisation. La fourchette Helicone conserve une divergence présente sur sa propre page : le tableau de l’offre inclut 1 GB gratuit, mais le calculateur facture le stockage dès le premier gigaoctet. Phoenix ne facture pas le volume au titre de la licence ; le coût d’exploitation de son infrastructure dépend du dimensionnement réel de votre déploiement.
Ces totaux ne constituent pas un devis universel pour un agent dont les traces seraient plus longues. Si votre workflow passe de deux appels de modèle à une boucle de raisonnement répétée, Datadog et Helicone comptabilisent davantage d’opérations de modèle. Si vous ajoutez des observations et des scores stockés, Langfuse compte davantage d’unités. Si vous envoyez des documents plus volumineux sans changer le nombre de traces, Braintrust compte davantage d’octets traités. Le comparatif des outils de suivi des tokens d’agents approfondit l’attribution des dépenses fournisseur à un client ou à une fonctionnalité.
Comment les outils ont-ils été sélectionnés ?
Le classement commence par un achat qu’une petite équipe en production peut justifier, puis présente des outils dont l’intérêt dépend d’un mode de fonctionnement particulier. Des développeurs et un responsable IA doivent comprendre les mauvais résultats, suivre le coût par client et transformer les échecs en contrôles avant mise en production. Un produit qui ne répond qu’à l’un de ces besoins peut néanmoins être le bon spécialiste.
Chaque recommandation repose sur cinq critères :
- Un compteur compréhensible. L’acheteur doit pouvoir déterminer si la facture dépend des traces, des opérations, des utilisateurs, des scores ou du volume de données, en tenant compte du quota gratuit et de la limite suivante.
- Des traces de production exploitables. Une réponse erronée doit pouvoir être reliée aux opérations de modèle, de récupération de données et d’outil qui l’ont produite.
- Un workflow d’amélioration. Les enregistrements doivent alimenter une évaluation, un jeu de données, une expérience ou une décision de revue, plutôt que rester des logs isolés.
- Un périmètre de déploiement explicite. L’auto-hébergement gratuit, la licence commerciale Enterprise et le plan de données exploité par le client sont décrits séparément.
- Une instrumentation documentée. La prise en charge d’OpenTelemetry est évaluée à partir des instructions d’intégration actuelles du fournisseur, y compris le protocole et la correspondance des champs lorsqu’ils sont précisés.
Ces six produits couvrent des choix distincts : une plateforme de traçage généraliste, un workflow de développement centré sur un framework, une gateway, une plateforme privée conçue pour fonctionner localement, une plateforme d’évaluation et une suite d’exploitation. Allonger la liste ajouterait des options sans éclairer davantage cette décision de budget et de responsabilité. Ce comparatif ne revendique aucune mesure de vitesse d’ingestion, d’ergonomie, de disponibilité ou de précision des évaluations.
La gratuité s’apprécie au regard du quota utilisable ; elle ne garantit pas une facture nulle. Braintrust Starter et LangSmith Developer peuvent entraîner des frais d’usage. La licence Phoenix peut ne rien coûter alors que la maintenance de la base de données et les astreintes restent des postes significatifs. La bonne offre gratuite est celle dont les limites permettent de terminer l’expérimentation visée.
Six outils classés selon leur intérêt en production
1. Langfuse : le choix par défaut pour une petite équipe en production
Langfuse réunit traçage partagé, suivi des tokens et des coûts, gestion des prompts et évaluation, sans frais par utilisateur sur Core. Un assistant de support SaaS peut associer un client, un workflow et une version à ses appels de modèle, puis examiner les échecs coûteux aux côtés des exécutions réussies. La principale contrainte budgétaire est le nombre d’enregistrements stockés : une exécution d’agent peut générer une trace, plusieurs observations et des scores. Choisissez-le pour réunir le déroulement de l’exécution et ses coûts, avec une voie crédible vers l’auto-hébergement ultérieur.
Pour qui : Une petite équipe produit, ou une équipe en croissance, dont les développeurs et le responsable IA doivent examiner les mêmes exécutions de production
Point fort : Utilisateurs illimités sur Core, coûts associés aux traces et socle auto-hébergé sous licence MIT
Tarifs : Core débute à $29/mois ; les offres Cloud payantes ajoutent une consommation facturée en unités
Essai gratuit : Hobby ne demande pas de carte bancaire ; c’est un quota gratuit permanent, pas un essai limité dans le temps
Les offres actuelles et les limites qui font changer de palier
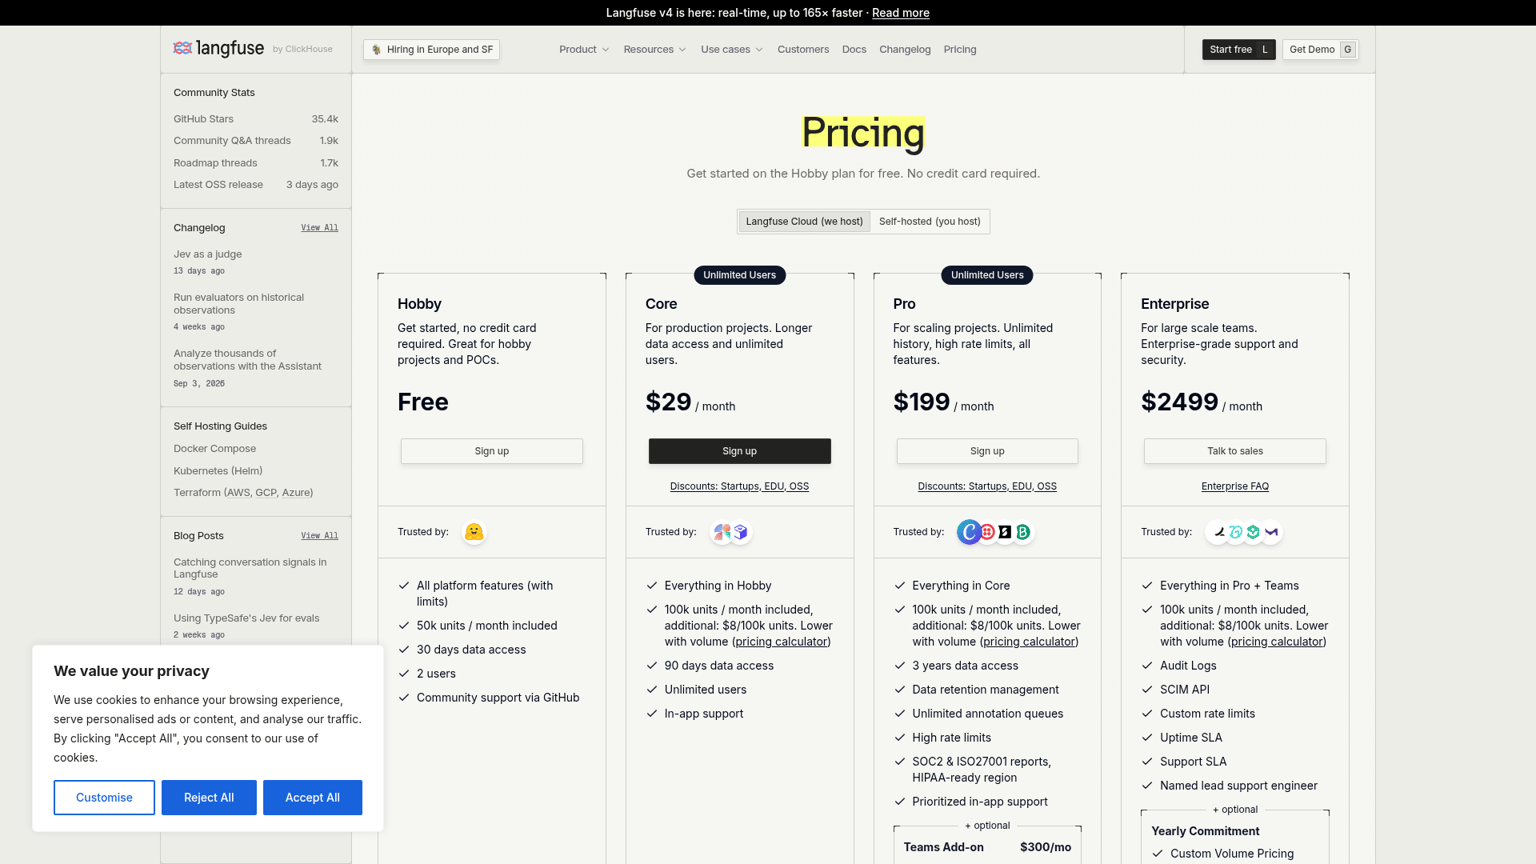
La page de tarification officielle affiche Hobby à $0, avec 50,000 unités/mois, deux utilisateurs et 30 jours d’accès aux données. Core coûte $29/mois, avec 100,000 unités, des utilisateurs illimités et 90 jours d’accès aux données. Pro coûte $199/mois, avec le même quota d’unités, trois ans d’accès aux données, une gestion de la conservation et des limites de débit plus élevées. L’option Teams de Pro coûte $300/mois et ajoute le SSO d’entreprise, son application obligatoire et des contrôles d’accès plus fins. Enterprise coûte $2,499/mois, avec 100,000 unités incluses, des journaux d’audit, SCIM et des engagements de service contractuels ; un engagement annuel peut donner accès à une tarification de volume sur mesure.
L’usage des offres Cloud payantes est facturé par tranches. De 100,000 à un million d’unités, le tarif est de $8 par 100,000 ; d’un million à dix millions, il est de $7 par 100,000 ; de dix millions à cinquante millions, il est de $6.50 par 100,000. Chaque tarif s’applique aux unités de sa tranche. Franchir un seuil ne réduit pas rétroactivement le prix des unités de la tranche précédente.
Core limite l’ingestion à 4,000 requêtes/minute, contre 20,000 requêtes/minute pour Pro. Il s’agit de requêtes d’ingestion, pas de la définition des unités facturables. Un lot peut contenir plusieurs événements stockés. Vérifiez à la fois le budget mensuel d’unités et les pics de trafic générés par votre exportateur.
Traces Langfuse : comptez aussi les observations et les scores
Une trace Langfuse décrit une exécution, mais la formule de facturation est traces + observations + scores. Dans notre scénario, cela donne 100,000 + 500,000 + 10,000 = 610,000 unités. Core revient donc à $29 + 5.1 × $8 = $69.80/mois. Le même volume stocké sur Pro coûte $239.80/mois.
Cette formule doit guider les choix d’instrumentation. Une récupération de données ou un appel d’outil de remboursement apporte des éléments utiles au diagnostic, même s’il augmente le nombre d’enregistrements. Les supprimer pour réduire la facture peut empêcher d’expliquer un échec. Préférez une politique d’échantillonnage délibérée des exécutions réussies à faible valeur diagnostique, tout en conservant les éléments nécessaires pour comprendre les résultats coûteux ou dommageables.
Hébergement, licence et OpenTelemetry
L’offre Open Source auto-hébergée n’a aucun frais de licence sous MIT. L’usage est illimité et les API du socle couvrent traçage, évaluation, jeux de données et gestion des prompts. Enterprise auto-hébergé relève d’une licence commerciale et d’un tarif sur mesure. Sa page de tarification actuelle précise que le prix Enterprise de Langfuse s’ajoute à l’offre commerciale ClickHouse correspondante. Un abonnement cloud et un devis Enterprise auto-hébergé sont deux achats différents.
La documentation OpenTelemetry prend en charge OTLP sur HTTP/JSON ou HTTP/protobuf et indique l’absence de prise en charge de gRPC. Le point d’entrée de base est /api/public/otel, avec authentification Basic à partir des clés publique et secrète du projet. L’ingestion directe via le chemin v4 actuel exige l’en-tête x-langfuse-ingestion-version: 4 pour un traitement en temps réel ; sans cet en-tête, la documentation annonce un délai pouvant atteindre dix minutes. Les attributs de trace — utilisateur, session, version et autres — doivent aussi être propagés aux spans que vous souhaitez filtrer et agréger.
C’est une contrainte d’intégration réelle pour une équipe plateforme qui exporte déjà en gRPC vers un Collector. Celui-ci peut recevoir un protocole et en exporter un autre, mais le dernier envoi vers Langfuse doit respecter le point d’entrée HTTP et la correspondance des attributs documentés. Un envoi accepté sans les métadonnées client ne constitue pas une intégration terminée.
Langfuse Python : partez du SDK documenté
Le fournisseur recommande son SDK Python, qui gère les champs Langfuse, leur propagation et l’export. Suivez le guide de démarrage du traçage actuel, configurez les identifiants du projet et LANGFUSE_HOST pour la région choisie ou votre propre déploiement, puis placez toute l’opération métier dans le contexte d’observation actuel. Conservez les récupérations de données et les appels d’outils dans ce contexte pour que la trace permette de retrouver la cause d’une mauvaise réponse.
Utilisez si possible les données d’usage renvoyées par le fournisseur. Le suivi des coûts Langfuse donne priorité au coût ingéré sur le prix du modèle déduit, et Project Settings > Models accepte des définitions personnalisées. C’est utile si votre contrat prévoit un tarif négocié ou si un modèle interne n’a pas de prix public. L’estimation affichée doit correspondre au tarif commercial que vous cherchez à piloter.
Langfuse et LangChain : gardez toute la requête dans le même contexte
L’intégration LangChain utilise un gestionnaire de callbacks fourni via les callbacks de l’invocation. Donnez un contexte de trace à la requête englobante, puis placez la chaîne sous ce contexte. La documentation attire aussi l’attention sur les événements placés en file d’attente en arrière-plan : un processus de courte durée doit vider la file ou arrêter l’exportateur avant de se terminer. Dans les environnements JavaScript serverless, attendez les callbacks d’arrière-plan comme l’indique le guide.
Un premier déploiement doit rester assez limité pour être inspecté manuellement :
Créez un projet de traçage de production
Choisissez la région Cloud ou l’adresse auto-hébergée, créez les clés du projet et configurez l’hôte à partir du guide de démarrage actuel. Les enregistrements de production doivent rester identifiables par rapport à ceux du développement.
Tracez une opération métier complète
Instrumentez la racine de la requête, les appels de modèle, les récupérations de données et les outils. Associez les métadonnées client, workflow, version et résultat aux spans appropriés ; vérifiez la propagation des attributs de trace requis.
Comparez le coût à la réponse du fournisseur
Ouvrez une trace terminée et vérifiez l’identité du modèle, l’usage et le coût. Définissez un prix de modèle personnalisé si le tarif public déduit ne reflète pas votre accord.
Stockez un score et vérifiez le compteur
Évaluez un exemple connu, vérifiez que le score se rattache à la bonne exécution, puis comparez le nombre de traces, d’observations et de scores avec le tableau de bord Usage Management. Videz la file de l’exportateur avant la fin d’un worker de courte durée.
- Core permet à toutes les personnes concernées de participer à la revue sans abonnement utilisateur supplémentaire
- Les enregistrements réunissent appels de modèle, outils, récupérations de données, coûts et scores d’évaluation
- Les coûts ingérés et les définitions de modèles personnalisées couvrent les tarifs négociés ou privés
- Le socle MIT auto-hébergé permet un déploiement dont vous exploitez l’infrastructure
- Traces, observations et scores stockés consomment tous le quota Cloud
- Pro et son option Teams peuvent augmenter le coût fixe avant même que l’usage évolue
- Le récepteur OTel exige un export HTTP et une propagation correcte des attributs
2. LangSmith : pour améliorer les agents dans un workflow LangChain
LangSmith est une plateforme de traçage et d’évaluation destinée aux équipes qui développent et révisent déjà leurs agents avec LangChain ou LangGraph ; elle documente aussi l’instrumentation d’autres frameworks. Un responsable du développement peut relier un échec de production à un jeu de données, une évaluation en ligne ou hors ligne, une revue humaine et une révision du prompt. Le frein à l’achat tient à la double facturation des utilisateurs et des traces : chaque personne invitée à la revue augmente l’abonnement, tandis que le volume de traces entraîne ses propres frais. Choisissez-le si ce workflow de développement et d’évaluation apporte assez de valeur pour justifier un accès payant par personne chargée de la revue.
Pour qui : Une équipe de développement qui organise déjà l’amélioration des agents autour de LangChain ou LangGraph
Point fort : Traçage, jeux de données, files d’annotation et évaluations en ligne ou hors ligne dans le même produit
Tarifs : Plus à $39/utilisateur/mois, puis consommation de traces et des autres produits
Essai gratuit : Developer offre un quota gratuit permanent pour un utilisateur, avec des frais d’usage au-delà des traces incluses
Les offres actuelles et le quota de traces partagé
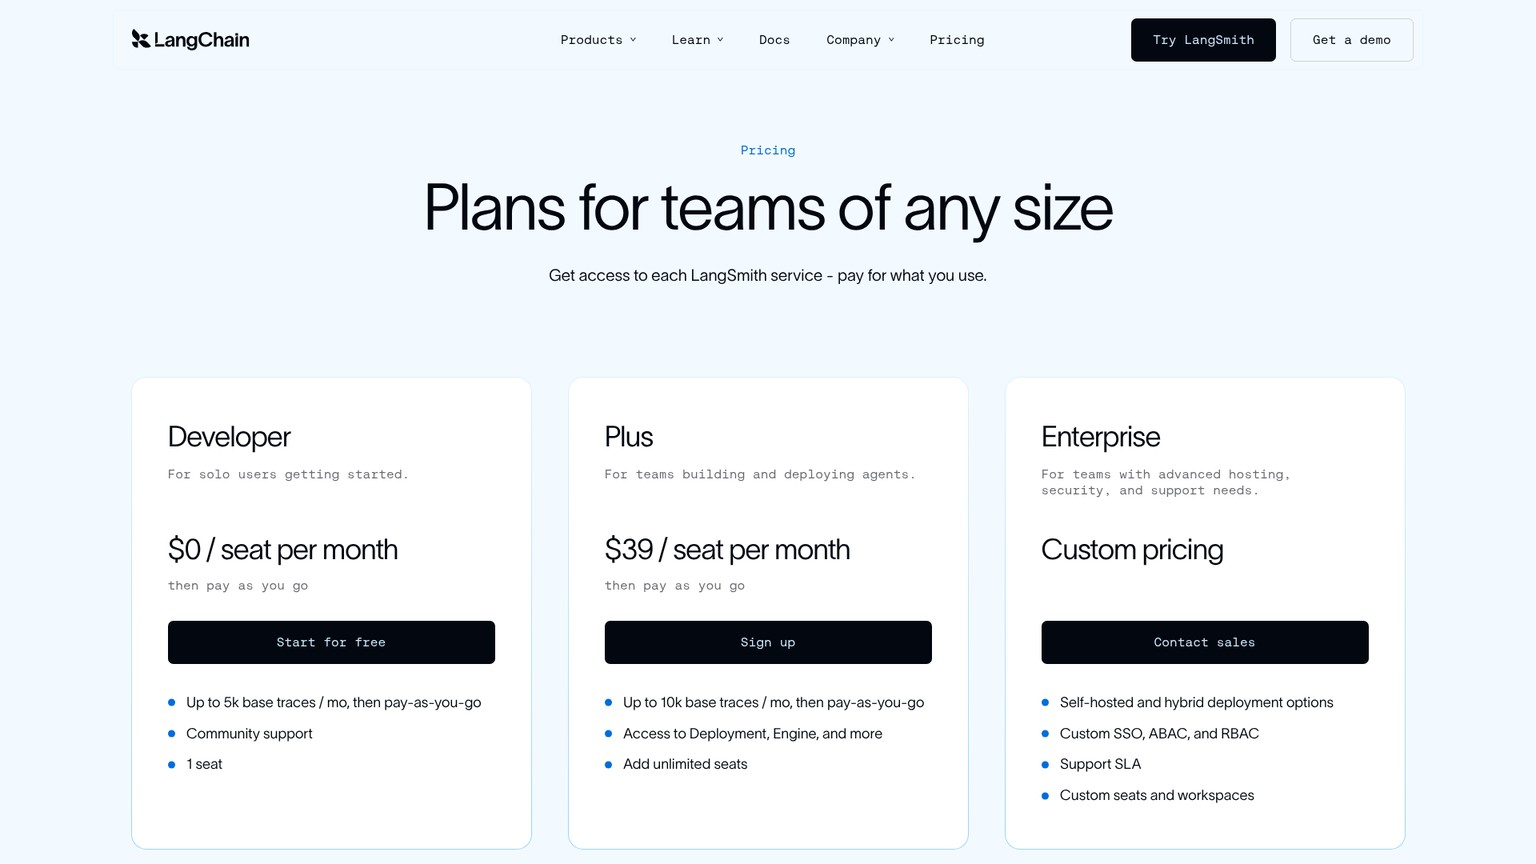
Developer coûte $0 par utilisateur et par mois, autorise un utilisateur et inclut 5,000 traces de base/mois, puis une facturation à l’usage. Plus coûte $39 par utilisateur et par mois, permet d’ajouter des utilisateurs payants et inclut 10,000 traces de base par mois au total. Le calculateur de prix traite explicitement ce quota comme partagé par toute l’organisation. Enterprise est sur devis et donne accès aux options hybrides et auto-hébergées, aux contrôles de sécurité et aux modalités de support.
L’infobulle de tarification actuelle indique 0.005 LangChain Standard Units par trace de base et 0.0025 par passage d’une trace à la conservation étendue. Une LSU vaut $1, soit $0.005 par trace de base et $0.0025 pour cette extension. La conservation de base est de 14 jours ; la conservation étendue, de 180 jours. Un ancien prix par trace gardé en mémoire n’est pas une base valable pour un budget vérifié aujourd’hui.
Avec cinq utilisateurs Plus et 100,000 traces de base, la facture est de $195 d’accès utilisateurs + $450 de traces supplémentaires = $645/mois. Prolonger la conservation de 10,000 traces ajoute $25, soit $670 avant calcul des évaluateurs ou consommation d’autres produits. L’extension conserve les enregistrements plus longtemps ; elle n’est pas automatiquement offerte avec Plus.
Les Tuned Evaluators ont un autre compteur publié : 0.015 LSU par exécution réussie d’une évaluation Perceived Error. L’infobulle précise qu’un Tuned Evaluator qui ajoute un retour d’évaluation fait aussi passer la trace à la conservation étendue. Deployment, Engine, Fleet et Sandboxes ont leurs propres règles d’usage. Si vous achetez uniquement l’observabilité, limitez votre budget à ce service : l’accès utilisateur ne constitue pas une offre tout compris d’exécution d’agents.
Pourquoi le nombre d’utilisateurs change la recommandation
Cinq développeurs qui inspectent des traces ne constituent pas le même groupe que cinq développeurs accompagnés d’une équipe produit et qualité plus large. À volume constant de 100,000 traces de base, quinze utilisateurs Plus coûtent $1,035/mois : la part utilisateurs passe à $585, tandis que les traces supplémentaires restent à $450. Ajouter des utilisateurs ne multiplie pas le quota gratuit de traces partagé.
La dépense se justifie si chaque personne transforme régulièrement les traces en prompts corrigés, en jeux de données ou en décisions de mise en production. Elle est plus difficile à défendre si la plupart des utilisateurs n’ont besoin que d’un accès ponctuel à un tableau de bord des coûts. Déterminez qui doit consulter les enregistrements bruts, qui peut travailler à partir d’un résultat exporté et quel workflow rend l’abonnement utile.
Auto-hébergement commercial et OpenTelemetry
LangSmith auto-hébergé est une option Enterprise qui exige une clé de licence commerciale. L’installation comprend les services frontend et backend, ainsi que ClickHouse, PostgreSQL et Redis ; le guide recommande des services de stockage externes en production. C’est une installation Enterprise à exploiter, pas une licence serveur gratuite que l’on pourrait déduire du caractère open source du framework.
Le guide OpenTelemetry décrit l’envoi de traces depuis des applications compatibles, la correspondance des attributs standard et la distribution via un Collector d’un même flux de spans vers plusieurs backends. Les utilisateurs LangChain et LangGraph peuvent activer l’intégration avec LANGSMITH_OTEL_ENABLED=true en complément du traçage. Un exportateur HTTP standard utilise le point d’entrée de base https://api.smith.langchain.com/otel, avec une authentification x-api-key et un en-tête facultatif Langsmith-Project.
Attention à la forme du point d’entrée. La variable OTLP de base partagée permet à l’exportateur HTTP d’ajouter /v1/traces ; une variable propre au signal de traces contient le chemin complet. Ajouter ce chemin aux deux endroits produit une URL incorrecte. Retrouvez la même trace dans le projet choisi et vérifiez le modèle, les entrées, les sorties et la structure parent-enfant avant de considérer l’export OTel comme terminé.
- LangChain et LangGraph disposent d’une intégration de traçage documentée
- Jeux de données, files d’annotation et évaluations en ligne ou hors ligne soutiennent un workflow d’amélioration explicite
- L’ingestion OTel et la distribution via Collector ouvrent la plateforme à des applications utilisant d’autres frameworks
- Enterprise offre une voie sous licence pour exploiter le backend dans votre infrastructure
- Chaque utilisateur Plus chargé de la revue coûte $39/mois, y compris les utilisateurs invités comptés comme accès facturables
- Le quota de traces inclus est partagé et n’est pas attribué à chaque utilisateur
- La conservation prolongée des traces et les évaluateurs spécialisés entraînent des frais distincts
3. Helicone : quand la gateway fait partie de l’achat
Helicone associe l’observabilité des requêtes à une gateway IA, un service qui transmet les requêtes aux modèles en appliquant des règles de routage et des contrôles associés. Une petite application qui doit surtout examiner les requêtes fournisseur, gérer les solutions de repli et regrouper les dépenses de modèles peut obtenir des enregistrements utiles à cet endroit. La limite tient à la différence entre la gateway et l’agent complet : un enregistrement de requête de modèle a encore besoin du contexte applicatif pour expliquer la récupération de données et les outils métier. Choisissez-le si la gateway fait déjà partie de votre architecture et si le suivi des requêtes est votre besoin immédiat.
Pour qui : Une équipe produit qui achète le suivi des requêtes avec les fonctions de gateway
Point fort : Une gateway compatible OpenAI, avec un chemin distinct de journalisation asynchrone
Tarifs : Pro à $79/mois, plus les frais de requêtes journalisées par tranches et de stockage
Essai gratuit : Hobby est gratuit ; Pro et Team affichent un essai gratuit de 7 jours
Les offres actuelles, y compris les limites de débit
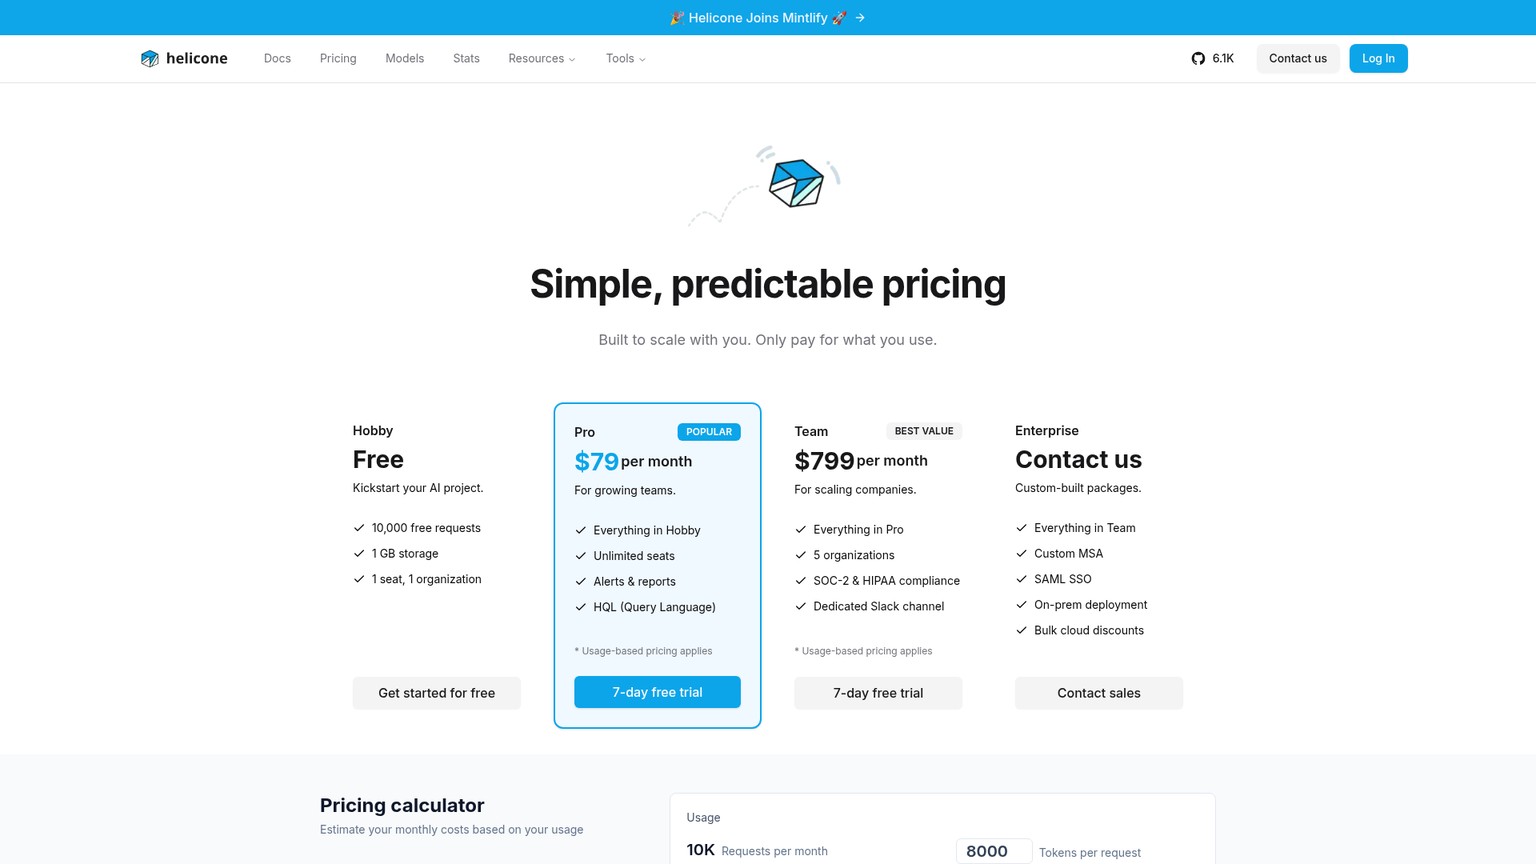
La page de tarification actuelle affiche Hobby à $0, avec 10,000 requêtes/mois, 1 GB de stockage, un utilisateur, une organisation et sept jours de conservation. Pro coûte $79/mois, ajoute des utilisateurs illimités, des alertes, des rapports et HQL, son langage de requête, et conserve les données pendant un mois. Team coûte $799/mois, ajoute cinq organisations, trois mois de conservation, un canal Slack dédié et l’offre de conformité indiquée. Enterprise est sur devis, avec SAML SSO, déploiement sur site et options contractuelles personnalisées.
Le tableau des offres payantes inclut 10,000 requêtes gratuites et 1 GB de stockage gratuit, puis des frais d’usage. Hobby publie une limite d’ingestion de 10 logs/minute, contre 1,000 sur Pro, 15,000 sur Team et 30,000 sur Enterprise. Le quota mensuel peut sembler suffisant alors qu’un pic dépasse déjà la limite d’ingestion. Un traitement documentaire alimenté par une file d’attente et qui envoie de nombreux enregistrements en lot exige un contrôle du débit, en plus du volume mensuel.
Passer de Pro à Team ajoute $720/mois avant usage. Ce palier répond à des besoins d’organisation, de conservation et de support. La seule croissance du nombre de requêtes ne rend pas ce surcoût inévitable.
Frais de requêtes et divergence sur le stockage
Le calculateur de la page de tarification utilise des prix par tranches : les 10,000 premières requêtes sont gratuites, les 20,000 suivantes coûtent $0.0007 chacune, les 60,000 suivantes coûtent $0.00035 chacune, puis les requêtes 90,001 à 250,000 coûtent $0.000175 chacune. Les tranches suivantes publiées descendent à $0.0000875, $0.00004375 et $0.00002 par requête à mesure que le volume augmente. Ces chiffres viennent du calculateur d’Helicone, pas du comparatif d’un autre fournisseur.
Pour 200,000 requêtes de modèle journalisées, la part requêtes est de $14 + $21 + $19.25 = $54.25. Avec Pro, le total atteint $133.25 avant stockage. Comptez bien les deux appels de modèle de l’agent de référence : présenter l’application comme générant 100,000 « requêtes » sous-estimerait ce compteur.
Les tranches de stockage du calculateur commencent à $3.25/GB pour les 30 premiers GB, puis passent à $2/GB, $1.25/GB, $0.75/GB et $0.50/GB dans les tranches supérieures. Or le calculateur facture la première tranche dès zéro, malgré le gigaoctet gratuit annoncé dans le tableau de l’offre. Avec 5 GB de stockage comptabilisé, déduire le quota gratuit donne $13 de stockage ; suivre le calculateur donne $16.25. Le total illustratif sur Pro est donc de $146.25-$149.50.
Gateway, mode asynchrone et périmètre OTel documenté
Le guide de démarrage de la gateway utilise un client compatible OpenAI pointant vers https://ai-gateway.helicone.ai, avec journalisation automatique et solutions de repli. Vous pouvez aussi utiliser vos propres clés fournisseur. Les dépenses des fournisseurs de modèles sont distinctes de l’abonnement d’observabilité et des frais de requêtes journalisées.
Le guide Proxy versus Async expose directement le compromis architectural. L’intégration proxy place Helicone sur le chemin de la requête et fournit des fonctions de gateway : cache, contrôles des nouvelles tentatives et limites de débit personnalisées. La journalisation asynchrone reste hors de ce chemin critique, mais ne fournit pas les mêmes contrôles. Décidez d’abord si vous souhaitez faire transiter les requêtes ou les observer en arrière-plan, puis comparez l’effort de mise en place.
Pour OpenTelemetry, Helicone documente une intégration OpenLLMetry Async. Les exemples actuels utilisent les outils de journalisation @helicone/async et helicone-async. Cela établit le chemin d’intégration documenté ; le guide cité ne fournit pas de configuration générique de récepteur OTLP pour un Collector. Si votre exigence est de « modifier uniquement l’exportateur du Collector », validez précisément ce chemin. Une intégration liée à OTel ne suffit pas à établir qu’il s’agit d’un backend OTLP interchangeable.
L’auto-hébergement prend en charge l’installation manuelle, Docker Compose, Kubernetes et le déploiement cloud. Le dépôt est sous licence Apache 2.0. Le support dédié et les services Enterprise restent à discuter séparément. Pour une petite équipe, le coût récurrent d’exploitation de la pile peut dépasser la facture de télémétrie, même si la licence logicielle est gratuite.
Le déploiement doit répondre à une question sur l’application, au-delà du simple affichage d’une requête. Associez les identifiants du workflow et du client, envoyez un appel de modèle connu, examinez l’enregistrement et confirmez que la session relie les appels que vous vouliez regrouper. Refaites ensuite le contrôle avec une nouvelle tentative ou une réponse en échec. La vue gateway devient une preuve utile en production lorsque vous pouvez déterminer quelle opération métier a entraîné le travail supplémentaire du modèle.
- Pro inclut des utilisateurs illimités pour un suivi partagé des requêtes
- Les chemins gateway et asynchrone permettent de choisir le compromis sur le chemin des requêtes
- Les frais de requêtes par tranches se calculent à partir de la page actuelle du fournisseur
- La licence Apache 2.0 et les options de déploiement documentées permettent l’auto-hébergement
- Les requêtes de modèle et les exécutions complètes d’agent sont des unités différentes
- Le quota de stockage publié et le calculateur doivent être rapprochés
- La journalisation asynchrone ne fournit pas le cache, les nouvelles tentatives et les contrôles de débit de la gateway
- Le guide d’intégration cité n’établit pas un chemin générique d’ingestion OTLP depuis un Collector
4. Arize Phoenix : pour un traçage privé avec un responsable de l’infrastructure
Arize Phoenix est une plateforme de traçage, d’évaluation et d’expérimentation conçue pour fonctionner localement, que vous pouvez exploiter dans votre infrastructure sans frais de licence. Un ingénieur plateforme qui examine un assistant de recherche documentaire peut inspecter les appels de modèle, le contexte récupéré et les opérations d’outils, puis rassembler les échecs dans un jeu de données pour comparer une version révisée de l’application. La contrainte est la responsabilité d’exploitation : quelqu’un doit gérer le service et comprendre les limites de la licence. Choisissez-le si un déploiement privé et maîtrisé du traçage et de l’évaluation justifie de nommer un responsable de l’infrastructure.
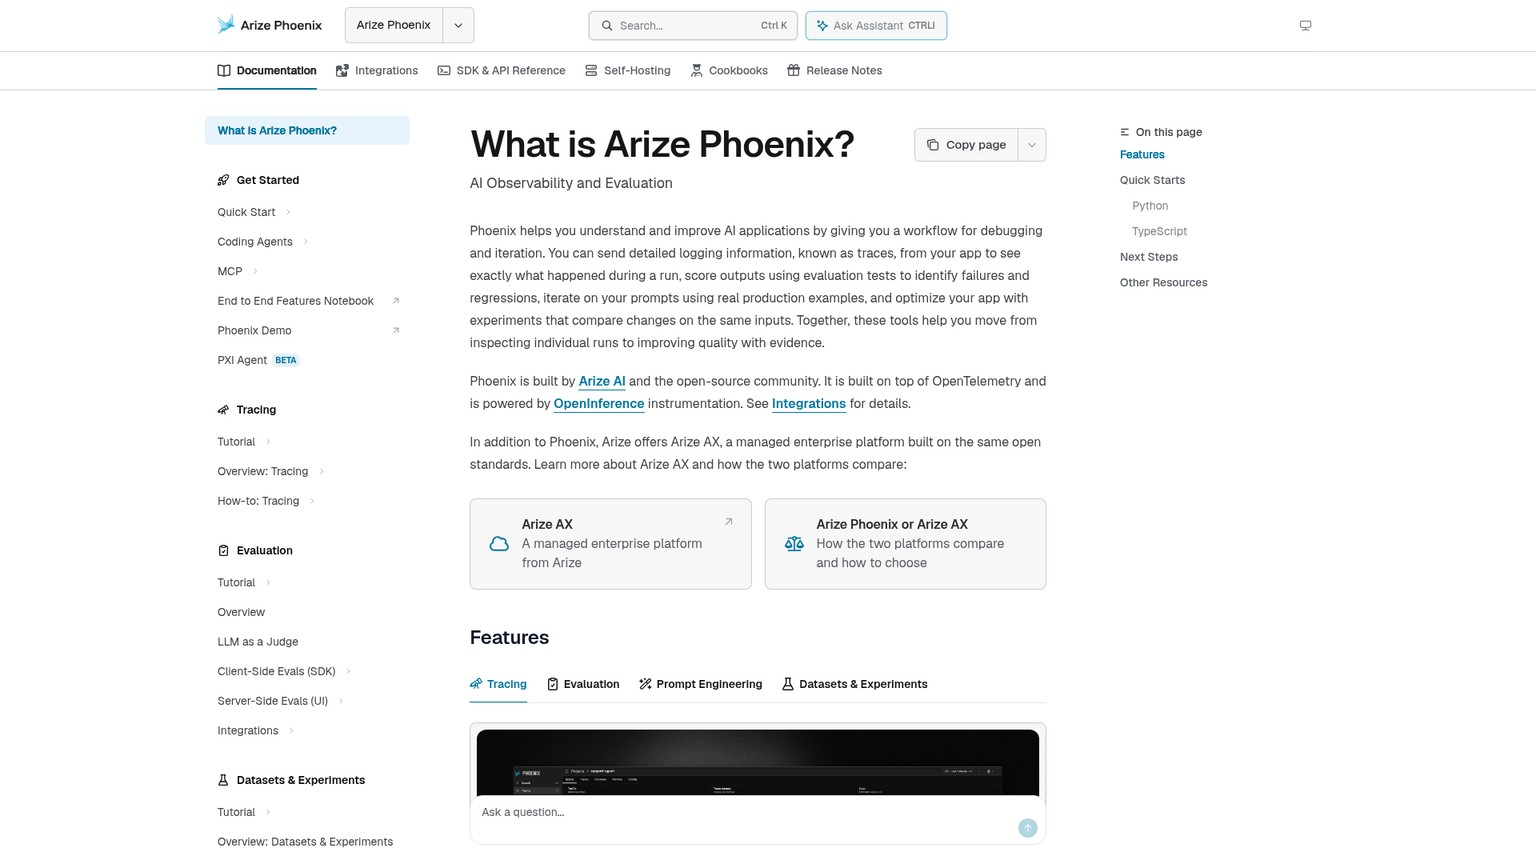
Pour qui : Une équipe technique qui souhaite exploiter son backend de traçage et d’évaluation
Point fort : Traces OTLP et instrumentation OpenInference, avec jeux de données et expériences en local
Tarifs : Aucun frais de licence pour Phoenix auto-hébergé ; aucun palier Phoenix payant n’est publié sur la page de tarification actuelle d’Arize
Essai gratuit : Phoenix auto-hébergé s’utilise gratuitement dans les limites de sa licence ; Arize AX dispose d’une offre gratuite distincte
Phoenix est distinct de l’offre AX à $50
La page de tarification actuelle d’Arize donne les prix d’AX et présente séparément Phoenix comme sa plateforme conçue pour fonctionner localement. AX Free inclut 25,000 spans de trace/mois, 1 GB d’ingestion/mois, 15 jours de conservation, ainsi que des utilisateurs et des évaluations illimités. AX Pro coûte $50/mois, avec 50,000 spans, 10 GB d’ingestion/mois, 30 jours de conservation, ainsi que des utilisateurs et des évaluations illimités. AX Enterprise est sur devis, avec volume et conservation personnalisés, et déploiement SaaS ou auto-hébergé.
Cette page ne publie aucun tarif d’instance Phoenix payante ni barème de dépassement Phoenix. Annoncer Phoenix à « $50/mois » reviendrait à confondre deux produits. Pour un achat Arize géré par le fournisseur, évaluez AX selon ses propres limites de spans et d’octets ; pour Phoenix, budgétez l’infrastructure que vous exploiterez.
Dans l’application de référence, les 500,000 spans représentent dix fois le volume de spans inclus dans AX Pro. La page publique ne donne pas de tarif de dépassement pour ce cas : il faut donc un devis, plutôt qu’un prix extrapolé. À cinq spans par exécution, le quota de spans d’AX Free correspond à 5,000 exécutions et celui de Pro à 10,000, à condition de respecter aussi les limites d’octets et les autres conditions.
Pour Phoenix auto-hébergé, les frais de licence logicielle restent nuls au volume de référence. Cela ne signifie pas que conserver 500,000 spans stockés ne coûte rien. Choisissez une politique de stockage, estimez la taille de vos données, incluez les sauvegardes et désignez la personne chargée des mises à jour et de la reprise. « Nous exploitons déjà cette infrastructure » et « nous avons besoin d’une nouvelle plateforme privée » conduisent à des coûts totaux différents.
Licence : lisez les conditions du backend
Le backend Phoenix est actuellement sous Elastic License 2.0 dans son dépôt. Cette licence autorise l’utilisation sous réserve de ses restrictions et interdit de proposer une part substantielle des fonctionnalités du produit à des tiers sous forme de service hébergé ou géré. Elle restreint aussi le contournement des mécanismes de clé de licence et la suppression des mentions de licence. Ce régime d’autorisation diffère du socle MIT de Langfuse et de la licence Apache 2.0 d’Helicone.
Employez cette distinction dans les échanges d’achat. « Le code est disponible », « notre déploiement est gratuit » et « la licence permet de reconditionner le produit en service » sont des affirmations différentes. La recommandation de cet article porte sur l’exploitation de Phoenix pour le traçage et l’évaluation de votre application ; elle ne présume aucun droit de revendre Phoenix comme produit hébergé.
Le guide d’auto-hébergement indique que Phoenix auto-hébergé n’a ni frais de licence, ni limites d’usage, ni fonctionnalités réservées à un palier payant, et peut fonctionner dans un environnement entièrement isolé du réseau. Il documente les déploiements via terminal, Docker/Compose, Kubernetes/Helm et cloud. Une installation privée exige néanmoins une configuration et un plan de reprise adaptés aux données stockées.
OpenTelemetry et workflow d’évaluation
Phoenix accepte les traces OTLP et repose sur OpenTelemetry et l’instrumentation OpenInference. Les enregistrements documentés couvrent les appels de modèle, les récupérations de données, les outils et la logique personnalisée. Les évaluations peuvent utiliser des modèles juges, des contrôles par code ou des annotations humaines. Les jeux de données et les expériences permettent de réexécuter plusieurs versions de l’application sur les mêmes entrées, tandis que les outils de prompts prennent en charge la gestion des versions et le rejeu.
Le guide de configuration du traçage propose phoenix.otel pour Python et @arizeai/phoenix-otel pour TypeScript, ainsi qu’une organisation par projet et session. Une équipe utilisant un Collector doit vérifier dans Phoenix les mêmes champs sémantiques réels que dans ses autres outils. Conserver un identifiant de trace est utile ; savoir quelle opération a récupéré le mauvais contexte permet d’agir.
Pour un assistant de recherche documentaire, commencez par un échec connu : le modèle a répondu avec assurance à partir d’un document sans rapport avec la demande. Vérifiez si le span de récupération contient les éléments permettant de distinguer un problème de recherche d’un problème de génération de réponse. Conservez cette entrée et le comportement attendu dans un jeu de données, modifiez un paramètre de recherche ou de prompt, puis comparez le résultat. Un exemple reproductible relie le constat d’un problème à la prévention de sa réapparition.
- Le guide n’annonce ni frais de licence logicielle ni plafond d’usage pour l’auto-hébergement
- La documentation prévoit un déploiement entièrement isolé du réseau
- OTLP et OpenInference relient le traçage aux chemins d’instrumentation courants
- Jeux de données, expériences et plusieurs types d’évaluation facilitent les contrôles de non-régression
- ELv2 comporte des restrictions que l’étiquette « licence permissive » masquerait
- Votre organisation assume l’infrastructure, la conservation, les mises à jour et la reprise
- Les limites et tarifs payants d’AX ne décrivent pas un abonnement Phoenix payant
5. Braintrust : quand les évaluations décident des mises en production
Braintrust est une plateforme d’évaluation et d’observabilité pour les équipes qui décident des mises en production à partir d’exemples notés, de jeux de données et d’expériences. Un responsable IA produit qui compare une révision de prompt peut inspecter les traces et déterminer si la nouvelle sortie passe les mêmes contrôles que l’ancienne version. La contrainte budgétaire combine données traitées et scores, auxquels s’ajoutent le calcul des modèles et une conservation plus longue. Choisissez-le si le workflow d’évaluation a un responsable et influe sur ce que vous mettez en production ; commencez avec Starter si ses limites et ses fonctionnalités conviennent.
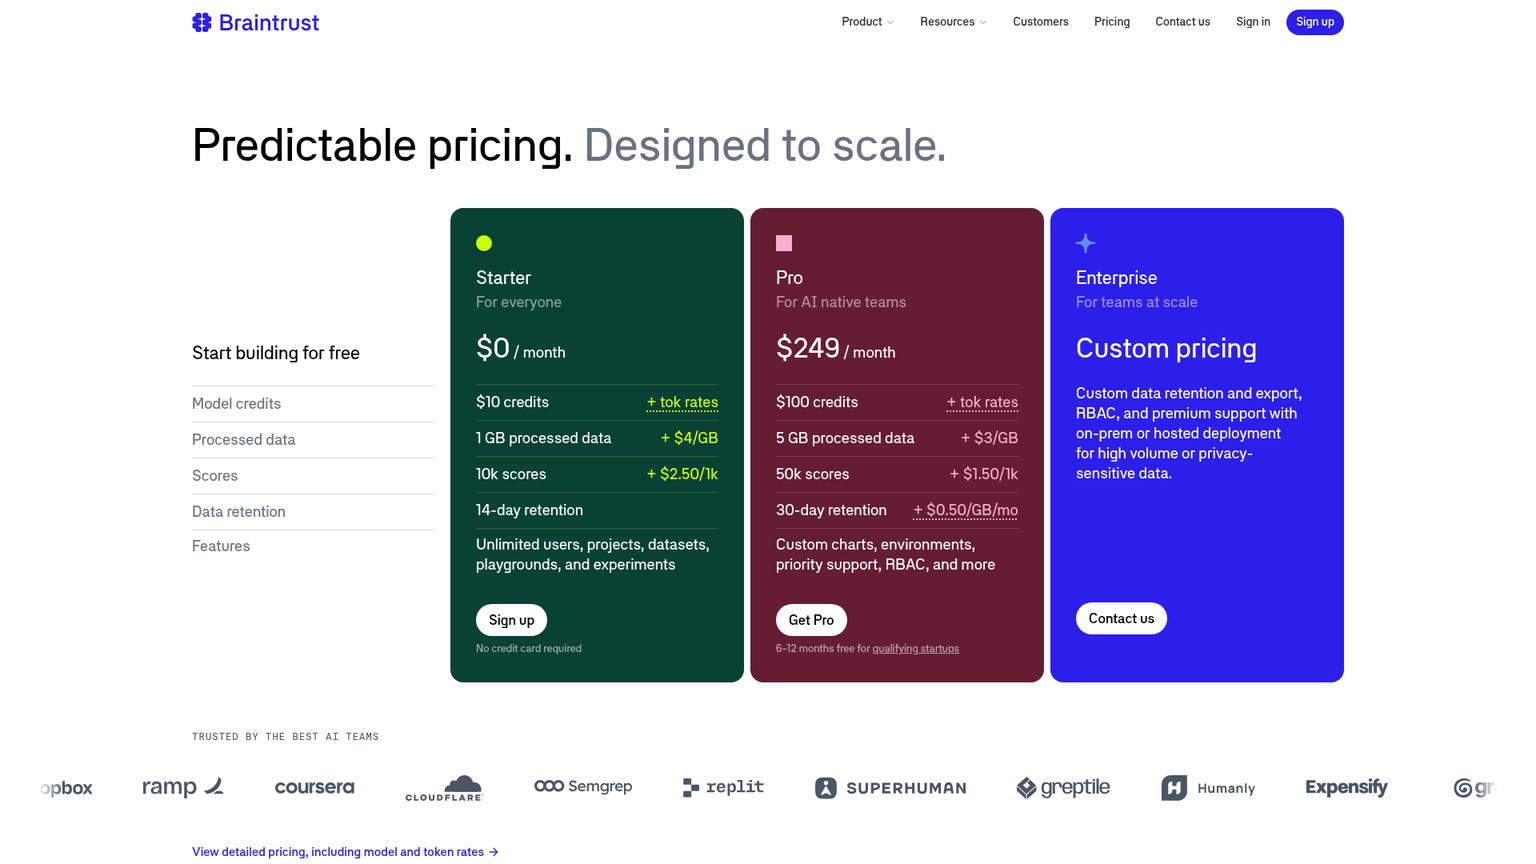
Pour qui : Une équipe produit IA qui entretient des jeux de données d’évaluation et des critères de mise en production
Point fort : Utilisateurs, projets, jeux de données, playgrounds et expériences illimités sur Starter
Tarifs : Starter a un abonnement plateforme de $0 avec consommation payante ; Pro coûte $249/mois, plus l’usage
Essai gratuit : Starter offre un quota gratuit permanent, sans carte bancaire pour commencer
Les offres actuelles et les deux compteurs d’usage
Starter a un abonnement plateforme de $0 par mois, avec 1 GB de données traitées/mois, puis $4/GB ; 10,000 scores/mois, puis $2.50 par 1,000 ; 14 jours de conservation ; et $10 de crédits modèles mensuels. Utilisateurs, projets, jeux de données, playgrounds et expériences sont illimités. Une équipe peut donc disposer d’un espace d’évaluation partagé sans avoir immédiatement besoin de Pro.
Pro coûte $249/mois, avec 5 GB de données traitées, puis $3/GB ; 50,000 scores, puis $1.50 par 1,000 ; 30 jours de conservation, avec conservation supplémentaire facturée $0.50/GB/mois ; et $100 de crédits modèles mensuels. Cette offre ajoute des graphiques personnalisés, des environnements, des contrôles d’accès fondés sur les rôles et un support prioritaire. Enterprise est sur devis, avec conservation et export personnalisés, support et modalités de déploiement sur site ou hébergé.
Un score est une sortie évaluée, qu’il provienne d’un modèle juge, d’une évaluation automatisée ou d’une fonction de notation personnalisée par code. Le prix du stockage ou du traitement de ce score est distinct du calcul qui l’a produit. Les crédits modèles inclus ont leur propre périmètre ; ils ne remboursent pas la facture fournisseur de toutes les applications.
Avec les 5 GB et 10,000 scores du scénario, la facture Starter est de $16 de dépassement de données, sans dépassement de scores. Pro revient à $249 avant tout usage supplémentaire. Si le besoin immédiat est de partager un jeu de données, des expériences et des traces dans les limites fonctionnelles de l’offre gratuite, le passage à $249 doit répondre à un besoin de fonctionnalités ou de conservation.
À partir de quand les tarifs d’usage plus bas comptent-ils ?
À 100,000 scores/mois, avec les mêmes 5 GB de données traitées, Starter coûte $241 et Pro $324, avant usage des modèles et prolongation de la conservation. Le tarif unitaire inférieur de Pro ne compense pas automatiquement son abonnement fixe.
Avec la même hypothèse de volume de données, le seuil d’équilibre fondé uniquement sur l’usage est de 183,000 scores/mois, où les deux offres atteignent $448.50. Ce calcul exclut les différences de crédits modèles, de conservation et de fonctionnalités, qui peuvent justifier une évolution plus tôt. C’est un seuil budgétaire, pas une recommandation de retarder des contrôles d’accès utiles.
La question opérationnelle est de savoir quels contrôles valent leur coût. Un workflow de support peut nécessiter un contrôle déterministe des arguments d’outil sur chaque exécution et une revue de la qualité des réponses par un modèle sur un échantillon. Ces contrôles ont des objectifs et des coûts de calcul différents. Entretenez un jeu de données connu pour les mises en production, puis échantillonnez la production afin de découvrir les échecs que ce jeu n’avait pas anticipés.
Ne faites pas d’un score moyen élevé un critère de mise en production suffisant. Regroupez les exemples par workflow et résultat, afin qu’une amélioration des réponses faciles ne masque pas une régression sur l’action difficile qui compte pour vos clients. C’est une méthode de travail pour l’évaluation, pas l’affirmation qu’une plateforme fournit automatiquement une grille correcte.
Ingestion OTel et hébergement commercial du plan de données
L’intégration OpenTelemetry documente un exportateur de traces OTLP, un processeur de spans Braintrust, un exportateur de logs et le transfert des logs par un Collector. Le point d’entrée API de base est https://api.braintrust.dev/otel ; l’authentification et l’en-tête x-bt-parent=project_id:... ciblent le projet voulu. Les points d’entrée propres aux signaux comprennent le chemin de traces ou de logs. Le package distinct @braintrust/otel prend en charge l’intégration JavaScript documentée.
Suivez les instructions de correspondance des champs pour vérifier les entrées, les sorties et les métadonnées après ingestion. L’acceptation d’une ligne de log et d’un span applicatif n’en fait pas des enregistrements d’évaluation équivalents. Confirmez quel objet servira d’entrée à l’expérience que vous voulez exécuter.
Les offres de déploiement réservent BYOC et l’auto-hébergement à Enterprise. C’est l’achat d’une plateforme commerciale, pas une licence de backend open source. Plus précisément, le guide d’architecture conserve le plan de contrôle, qui comprend l’interface, l’authentification et les métadonnées de gestion, dans le SaaS Braintrust. Le plan de données, où résident les traces, les jeux de données et les autres données IA, peut fonctionner dans votre propre compte cloud. Le navigateur communique directement avec ce plan de données.
Cette distinction peut décider d’un achat. Maîtriser l’emplacement des prompts et des sorties peut satisfaire une exigence de localisation des données, tout en maintenant une dépendance au plan de contrôle du fournisseur. Une organisation qui exige que tous les composants fonctionnent hors connexion doit comparer cette architecture à l’option entièrement isolée documentée par Phoenix avant de signer.
- Starter permet un espace d’évaluation partagé sans frais par utilisateur
- Les quotas de données traitées et de scores rendent visibles les différents postes du budget
- Pro ajoute clairement des fonctionnalités de graphiques, d’environnements, d’accès et de conservation
- Les chemins OTel documentés peuvent recevoir un flux d’instrumentation existant
- La taille des données envoyées et le volume de scores sont deux sources distinctes de frais d’usage
- Les tarifs unitaires plus bas de Pro ne compensent pas toujours l’abonnement de $249
- Le calcul des modèles juges et la conservation prolongée exigent leur propre budget
- Auto-héberger les données ne déplace pas le plan de contrôle SaaS dans votre infrastructure
6. Datadog Agent Observability : pour une équipe d’exploitation déjà sur Datadog
Datadog Agent Observability est le nom actuel du produit couramment recherché sous « Datadog LLM Observability » ; il convient surtout aux équipes qui analysent déjà leurs incidents applicatifs dans Datadog. Un dépassement de délai d’un agent de support peut provenir d’un appel de modèle, d’un service lent ou d’un problème de session utilisateur. L’intérêt de la plateforme est de relier l’exécution de l’agent à ce contexte opérationnel plus large. Ses contraintes sont le choix d’engagement et de conservation, ainsi que le coût des autres produits Datadog nécessaires. Choisissez-le si les responsables de l’incident travaillent déjà dans Datadog et si le contexte partagé change la manière de mener l’enquête.
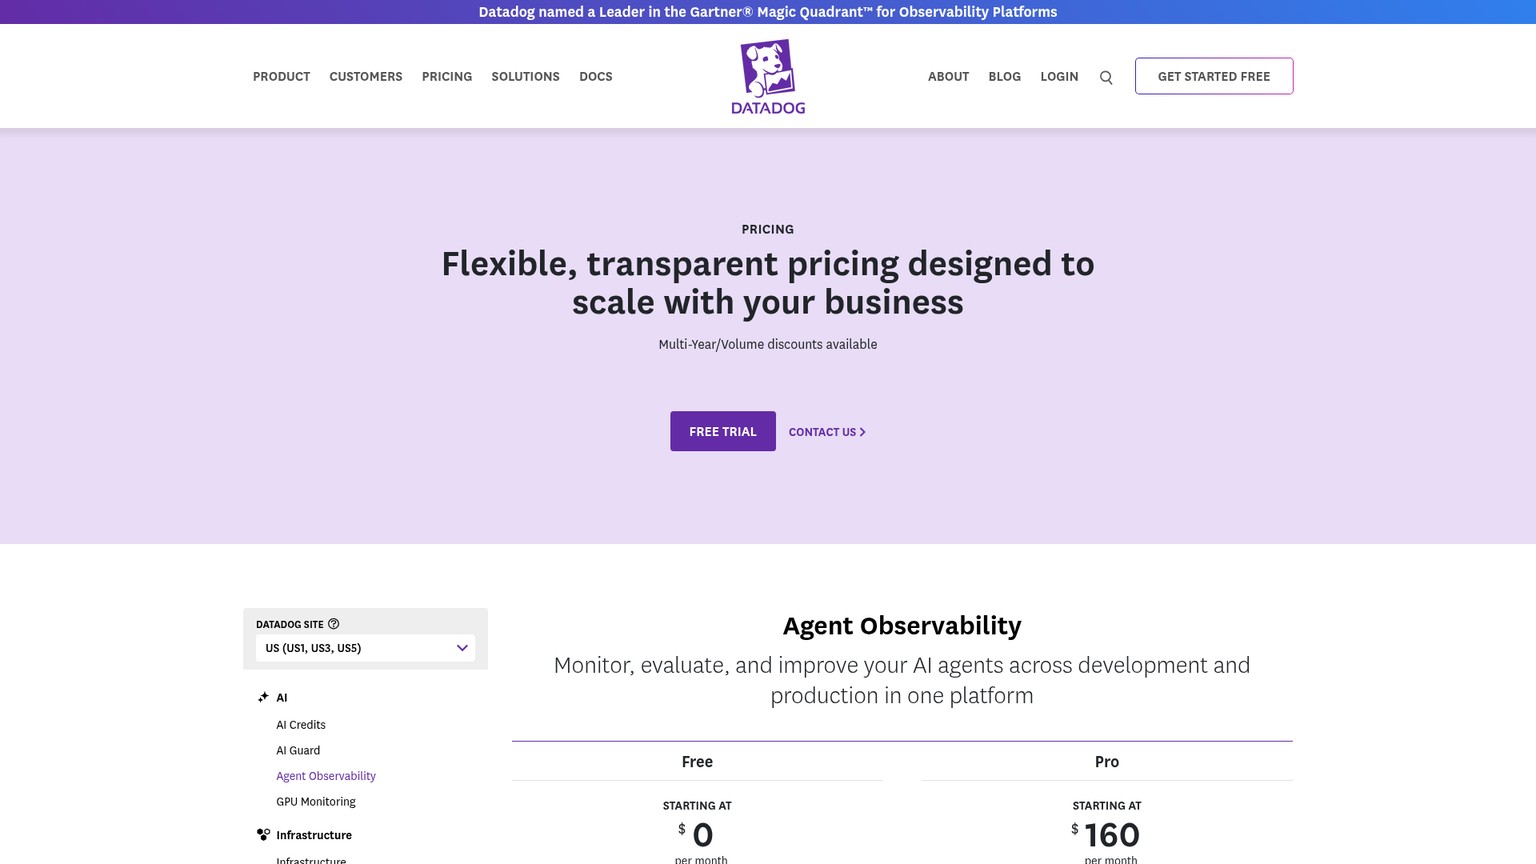
Pour qui : Une équipe SRE ou plateforme qui relie les échecs IA aux incidents applicatifs et d’infrastructure
Point fort : Une facturation des spans LLM, plutôt que de chaque opération de récupération, d’outil ou de workflow
Tarifs : Pro à $160/mois avec engagement annuel, $200 au mois ou $240 à la demande, puis spans LLM supplémentaires
Essai gratuit : Free inclut 40,000 spans LLM/mois ; la page de tarification propose aussi une inscription à un essai
Quels sont les tarifs de Datadog LLM Observability ?
La page de tarification actuelle affiche Free à $0, avec 40,000 spans LLM/mois, 15 jours de conservation des traces, contexte et évaluations illimités, et accès à toutes les fonctionnalités. Pro inclut 100,000 spans LLM/mois, également avec 15 jours de conservation des traces. Son prix de base est de $160/mois avec facturation annuelle, $200 au mois ou $240 à la demande.
Les spans LLM supplémentaires coûtent $3.50 par 10,000 au tarif annuel, $4.20 au mois ou $5 à la demande. Pour 200,000 spans LLM, les totaux calculés sont respectivement $195, $242 et $290. Comparez explicitement les engagements : le prix mis en avant pour l’offre annuelle ne correspond pas à la facture au mois.
L’unité facturable est un appel de modèle, pas chaque opération de la trace. Le fournisseur précise que les spans d’outils, de récupération de données et du workflow englobant ne sont pas facturés comme spans LLM. Avec deux appels de modèle par exécution, le quota Free correspond à 20,000 exécutions complètes, sous réserve des autres conditions de l’offre. Instrumenter davantage d’outils n’augmente donc pas nécessairement les spans LLM facturables, contrairement à une boucle de raisonnement qui appelle le modèle à répétition.
Une conservation prolongée est disponible, mais la page publique n’en donne pas le tarif pour ce comparatif. Faites chiffrer ce besoin si vous devez analyser des incidents anciens. Même complète, une trace déjà expirée ne peut plus étayer un litige client ultérieur.
Observabilité IA Datadog et environnement d’exploitation existant
Agent Observability peut s’acheter seul ; le fournisseur indique qu’aucun autre abonnement Datadog n’est requis. La page de tarification décrit aussi l’intérêt supplémentaire des corrélations avec APM, la supervision d’infrastructure et Real User Monitoring lorsque vous utilisez ces produits. Une équipe qui part de zéro doit les budgéter séparément, sans supposer que l’abonnement d’observabilité comprend le reste de Datadog.
Les offres publiées incluent jeux de données, expériences, évaluations, annotations et tableaux de bord. La vue des coûts détaille l’usage par fournisseur, modèle et identité ou version de prompt, avec les coûts accessibles dans les traces et les spans. Le responsable de l’incident peut ainsi distinguer une hausse de trafic d’un changement du travail de modèle effectué par l’application.
Un responsable plateforme doit vérifier concrètement cette corrélation lors d’un essai d’adéquation au besoin. Partez d’une exécution d’agent en échec et suivez la requête jusqu’au service responsable de la réponse de l’outil. Vérifiez que l’identité de la trace traverse cette frontière et que l’opérateur peut distinguer la latence du modèle du temps passé ailleurs. C’est ce workflow qui justifie l’achat ; un graphique de dépenses isolé n’en établirait pas la valeur.
Licence SaaS et OpenTelemetry
Datadog fournit ce produit comme service SaaS commercial dans le cadre de son contrat d’abonnement. Ses conditions indiquent que le MSA régit le service hébergé. La page de tarification actuelle du produit ne propose aucun backend Agent Observability auto-hébergé. Exploiter vous-même un Datadog Agent ou un OTel Collector ne signifie pas que vous hébergez le stockage, l’interface et la plateforme d’évaluation.
Le guide OpenTelemetry accepte les traces qui suivent les conventions sémantiques GenAI 1.37 ou ultérieures, ou les conventions OpenInference prises en charge. Il documente l’ingestion directe sans imposer Datadog Agent ni le SDK Agent Observability. L’exportateur présenté utilise OTLP/HTTP protobuf, avec les en-têtes dd-api-key et dd-otlp-source=llmobs.
Les évaluations externes ont une exigence d’intégration précise : pour les spans OTel, la documentation demande le tag source:otel et des identifiants de trace et de span représentés comme chaînes décimales. Les identifiants OTel natifs sont hexadécimaux et doivent donc être convertis avant l’envoi. Validez une évaluation sur une trace connue ; la compatibilité du traçage ne rend pas automatiquement le rattachement des évaluations opérationnel.
- Seuls les spans LLM alimentent le compteur de volume publié ; les spans d’outils et de récupération en sont exclus
- Les équipes déjà sur Datadog peuvent relier les exécutions d’agents au contexte de production plus large
- Free et Pro incluent les fonctionnalités d’évaluation et d’expérimentation indiquées
- L’ingestion OTel directe est documentée sans imposer Datadog Agent
- Le tarif affiché le plus bas exige un engagement annuel
- Les deux offres publiées incluent une conservation des traces de 15 jours
- Les autres services Datadog restent des achats distincts
- Le produit est un backend commercial hébergé, sans serveur d’observabilité auto-hébergé proposé
Quel outil choisir selon la taille de l’équipe ?
Commencez par identifier qui doit agir sur les enregistrements, puis quel compteur augmente avec l’application. L’effectif sert au calcul du budget ; il ne remplace pas l’identification du responsable, qu’il s’agisse d’un développeur, d’un responsable produit IA ou d’une personne chargée des incidents.
Un ou deux développeurs : Choisissez d’abord le quota gratuit qui permet de terminer la première revue de production. Langfuse Hobby donne une vue partagée à deux personnes, mais ses 50,000 unités s’épuisent vite quand une exécution produit plusieurs opérations. LangSmith Developer convient à un utilisateur. Braintrust Starter est intéressant si l’objectif est déjà d’entretenir un jeu de données et de noter les contrôles de mise en production. Phoenix convient si vous choisissez délibérément d’exploiter le backend.
Trois à dix personnes : Langfuse Core est le choix par défaut lorsque plusieurs développeurs et un responsable produit ont besoin d’un accès régulier. Braintrust Starter peut coûter moins cher si ses limites de données, de scores, de conservation et de fonctionnalités correspondent à un workflow centré sur l’évaluation. Helicone Pro justifie son prix quand la gateway et le suivi des requêtes font partie de l’achat. LangSmith Plus justifie ses frais par utilisateur lorsque les personnes chargées de la revue utilisent activement son workflow d’amélioration.
Un groupe de revue plus large, réunissant plusieurs métiers : Comptez chaque utilisateur LangSmith payant avant d’ajouter des fonctions qualité, produit ou support à l’espace de travail. Les offres à utilisateurs illimités peuvent stabiliser l’abonnement pendant que la participation augmente. Les volumes de traces, d’octets et de scores restent toutefois à maîtriser. Le choix change lorsqu’un workflow propre à une plateforme économise plus d’effort de revue ou évite davantage d’échecs répétés que ne coûte l’écart d’abonnement.
Une équipe SRE ou plateforme déjà sur Datadog : Privilégiez Datadog si un incident d’agent doit être analysé avec les services et les sessions utilisateur. Les responsabilités existantes et le contexte des traces peuvent réduire l’intérêt d’une console spécialisée distincte. Son compteur plus restreint, limité aux spans LLM, mérite aussi l’attention lorsque l’agent effectue de nombreuses opérations sans modèle.
Une exigence d’hébergement privé : Phoenix et Langfuse présentent des choix de licence et de déploiement sensiblement différents ; Helicone ajoute une option sous licence Apache. L’auto-hébergement de LangSmith et de Braintrust relève d’accords commerciaux Enterprise. Le plan de données Braintrust exploité par le client utilise toujours le plan de contrôle du fournisseur. Déterminez ce qui doit rester dans votre infrastructure avant de décider quel palier est économique.
La règle est simple : payez pour le workflow qui change une décision de production, puis prévoyez les enregistrements et les accès utilisateurs qu’il génère. Si vous ne pouvez pas nommer cette décision, commencez par un déploiement plus limité.
OpenTelemetry : vérifiez le chemin d’ingestion et les champs
La prise en charge d’OpenTelemetry n’est utile que si les champs importants de votre application sont préservés après ingestion. OTel est un système d’instrumentation standard ; OTLP est le protocole qui transmet sa télémétrie. Un flux de spans peut être acheminé correctement alors que le backend perd l’identité du modèle, l’usage, le contexte client ou la relation entre un outil et son appelant.
Les chemins documentés diffèrent. Langfuse accepte HTTP JSON ou protobuf sur son point d’entrée OTLP et précise que gRPC n’est pas pris en charge. LangSmith accepte le traçage OTel avec correspondance des attributs GenAI, OpenInference et d’autres formats, et documente la distribution vers plusieurs backends via Collector. Phoenix accepte OTLP et utilise l’instrumentation OpenInference. Braintrust documente des chemins d’ingestion de traces, de processeur de spans et de logs. Datadog précise les conventions GenAI ou OpenInference compatibles. Helicone documente son intégration asynchrone OpenLLMetry ; le guide cité n’établit pas l’existence d’un récepteur OTLP générique pour un Collector.
Pour vérifier l’adéquation au besoin, conservez une exécution représentative tout au long du parcours. Confirmez les relations parent-enfant, le nom du modèle, les tokens, le coût, la politique d’entrées et de sorties, et les métadonnées de version. Si deux services interviennent, vérifiez que le contexte traverse leur frontière. Si la plateforme regroupe les conversations en sessions, contrôlez l’identifiant de session au lieu de supposer qu’un identifiant de trace commun couvre toute la conversation.
Vérifiez soigneusement la variable du point d’entrée. Un point d’entrée de base partagé et un point d’entrée propre au signal de traces correspondent à deux formes de configuration différentes. Respectez les instructions du fournisseur concernant la région, l’authentification et le chemin. Examinez ensuite l’enregistrement dans le projet de destination : une réponse HTTP réussie confirme l’acceptation, pas l’exactitude de l’attribution métier.
Enfin, comptez les chemins d’export qui se doublonnent. Un callback de framework et une bibliothèque d’auto-instrumentation distincte peuvent observer le même appel de modèle. Avant de conclure à une hausse des coûts, vérifiez si vous avez augmenté le travail du modèle ou simplement enregistré ce travail deux fois. Le comparatif des outils d’analyse des échecs aide à relier la trace obtenue à une question concrète de débogage.
Les achats à éviter
Évitez un achat mal adapté au besoin, même si le produit figure dans la sélection. Voici des cas précis où la facturation ou le mode d’exploitation documenté ne correspondent pas au travail à accomplir.
- LangSmith Plus pour un simple écran de coûts partagé : Le scénario de cinq personnes coûte $645 avant conservation prolongée et calcul des évaluations. Cette dépense se justifie si le workflow d’amélioration fait partie du besoin ; élargir le groupe de revue doit répondre à un objectif clair.
- Braintrust Pro pour un faible usage d’évaluation couvert par Starter : La facture Starter du scénario est de $16, contre $249 sur Pro. Choisissez délibérément l’évolution des fonctionnalités, de la conservation ou du support.
- Les budgets d’achat annonçant « Phoenix à $50 » : Ce prix est celui d’AX Pro. Au volume de référence, le quota public de spans d’AX est insuffisant et aucun tarif de dépassement n’est publié. L’infrastructure Phoenix que vous exploitez relève d’un autre budget.
- Helicone Hobby pour un worker de production soumis à de forts pics : Le quota mensuel de 10,000 requêtes ne supprime pas la limite d’ingestion publiée de 10 logs/minute. Vérifiez le profil de trafic avant de compter sur l’offre gratuite.
- Le tarif annuel mis en avant par Datadog pour faire approuver un budget au mois : $160 est le prix de base au tarif annuel ; la base au mois est de $200, et le total calculé au tarif mensuel est de $242.
- Toute option d’auto-hébergement sans responsable : Une licence gratuite n’attribue pas la responsabilité de restaurer les sauvegardes, de mettre à jour le service ou de gérer les accès aux données. Un « plan de données auto-hébergé » commercial ne déplace pas non plus automatiquement tout le produit dans votre environnement.
Un graphique de coûts apparemment précis, mais auquel il manque de l’usage, contrôle mal le budget. Comparez l’usage fournisseur d’une requête connue à l’enregistrement stocké, puis rapprochez les totaux de la facture réellement payée. Une plateforme d’observabilité explique les dépenses ; une politique d’arrêt doit agir sur la prochaine action de l’application.
Dès lundi : transformez un échec en test de mise en production
Instrumentez un workflow utile et rendez un échec connu reproductible avant d’élargir le déploiement. Un assistant de support qui réessaie de retrouver une commande, sélectionne le mauvais document ou propose un remboursement injustifié est un bon candidat : son responsable peut décrire le comportement attendu.
Identifiez le responsable du workflow, l’identifiant de version et le résultat métier. Capturez l’exécution complète, inspectez les opérations de modèle et d’outil, puis vérifiez les champs d’usage. Examinez ce qui se passe lorsque l’exportateur ralentit ou qu’un worker de courte durée se termine. Le premier test d’adoption consiste à vérifier que les enregistrements arrivent avec assez de contexte pour répondre à la question du responsable.
Placez ensuite l’échec connu dans un jeu de données, avec un résultat attendu explicite. Ce résultat peut être « ne pas promettre de remboursement sans l’accord de l’outil » ou « citer la règle récupérée qui s’applique à ce client ». Utilisez un contrôle par code lorsque la règle est déterministe, et une grille de qualité validée lorsqu’un jugement est nécessaire. Conservez l’entrée et la règle pour soumettre ultérieurement les changements de prompt ou de modèle au même test.
Définissez clairement le critère d’autorisation de mise en production. Une moyenne satisfaisante ne doit pas masquer un échec sur l’action que vous cherchez à protéger. Examinez le résultat du cas difficile identifié et inspectez la trace lorsqu’il échoue. Échantillonnez ensuite la production pour repérer de nouveaux cas à ajouter au jeu de données.
Avant de choisir le prochain abonnement, relevez vos nombres réels de traces, d’opérations par trace, d’appels de modèle et de scores stockés, les octets traités ou conservés, les personnes chargées de la revue et le besoin de conservation. Recalculez la facture avec ces données. Le résultat utile de la première semaine est un workflow corrigé et un budget défendable, chacun confié à un responsable identifié.
Questions fréquentes
Quel est le meilleur outil d’observabilité IA ?
Langfuse est le choix par défaut pour une petite équipe en production qui a besoin de partager les traces et les coûts. Braintrust convient aux mises en production pilotées par les évaluations, Phoenix à un backend privé que vous exploitez, et Datadog à un workflow d’exploitation existant. Le responsable et le périmètre de déploiement déterminent quel spécialiste doit remplacer ce choix par défaut.
Quelles métriques suivre pour l’observabilité des LLM ?
Suivez les tokens et les coûts fournisseur, la latence, les erreurs, les nouvelles tentatives, les résultats de récupération de données et d’outils, ainsi que les évaluations. Regroupez-les par client, workflow et version. Le coût par résultat métier réussi est plus utile que le total des tokens lorsque les échecs et les nouvelles tentatives représentent une dépense significative.
Quels sont les 3 meilleurs outils d’observabilité ?
Pour les trois rôles de production de ce comparatif, retenez Langfuse pour le traçage partagé généraliste, Braintrust pour le travail produit piloté par les évaluations et Datadog pour le contexte d’exploitation. Cette sélection correspond à des rôles ; elle ne revendique aucune supériorité mesurée sur l’ensemble des fonctionnalités ou des déploiements.
Quels outils open source permettent l’observabilité des LLM ?
Le socle Langfuse est sous licence MIT et le dépôt Helicone sous Apache 2.0. Phoenix peut être auto-hébergé gratuitement, mais son backend utilise Elastic License 2.0, avec des restrictions sur les services hébergés. Vérifiez la licence réelle du backend : tous les produits présentés comme open source ne sont pas sous licence permissive.
À quoi servent les outils d’observabilité des LLM ?
Ils enregistrent le déroulement d’une application de grand modèle de langage : appels de modèle, outils, récupération de données, durées, usage et contrôles des sorties. Leur résultat utile est une exécution en échec que l’on peut expliquer, corriger et transformer en test reproductible avant mise en production.
Combien coûte Langfuse ?
Tarifs vérifiés le 5 octobre 2026 : Hobby est gratuit, Core coûte $29/mois, Pro $199/mois et Enterprise $2,499/mois. L’option Teams de Pro coûte $300/mois. Les offres payantes ajoutent la consommation de traces, d’observations et de scores ; le scénario de 610,000 unités revient à $69.80 sur Core.
Peut-on utiliser Langfuse gratuitement ?
Oui. Hobby inclut 50,000 unités par mois, deux utilisateurs et 30 jours d’accès aux données. Vous pouvez aussi auto-héberger le socle sous licence MIT sans frais de licence logicielle, tout en finançant et en exploitant vous-même l’infrastructure. Les fonctionnalités commerciales Enterprise ont des conditions distinctes.
Quelles sont les alternatives à Langfuse ?
LangSmith convient à un workflow d’amélioration LangChain ou LangGraph ; Helicone au suivi des requêtes via une gateway ; Phoenix à un backend privé ; Braintrust aux jeux de données et aux mises en production pilotées par les évaluations ; Datadog aux incidents d’agents dans un environnement d’exploitation existant. Comparez le compteur réel et le besoin de conservation avant de changer de plateforme.
Peut-on exécuter Langfuse en local ?
Oui. Langfuse documente l’auto-hébergement avec Docker et fournit des guides de déploiement pour son socle sous licence MIT. Un démarrage local ne fournit pas les sauvegardes de production, la disponibilité ni un responsable des mises à jour. Définissez ces exigences si l’installation doit devenir votre service de traçage de production.
Recevez la checklist d’audit des workflows IA en entreprise pour identifier le workflow, son responsable, le résultat attendu et le point de contrôle avant d’élargir vos outils de production.
- Dernière mise à jour
- 5 oct. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

OpenCode : le guide pour coder avec le modèle de votre choix
Installez OpenCode, connectez votre modèle, corrigez un vrai bug et configurez AGENTS.md et les plugins. Comprenez les coûts de l’API et de Zen.4 oct. 2026Build
Netlify Pricing : quel budget prévoir pour vos projets ?
Netlify Pricing : comparez Free, Personal et Pro, calculez vos crédits et estimez le budget mensuel d’un site vitrine, d’une app Next.js ou d’une agence.4 oct. 2026Build
Softr Airtable : avis, tarifs et limites pour un portail client
Softr Airtable, portail client ou outil interne : découvrez les tarifs, les droits d’accès, les limites de données et l’IA pour choisir la bonne offre.4 oct. 2026Build
OpenCode et les alternatives à Claude Code : quel budget prévoir en 2026 ?
Comparez OpenCode, Codex CLI, Pi et Gemini CLI : coûts des modèles, abonnements, limites du gratuit et conseils pour choisir selon votre budget.4 oct. 2026Build
Cloudflare MCP, Docker ou Lasso : quelle passerelle choisir ?
Comprenez le rôle d’une passerelle MCP, comparez Cloudflare, Docker et Lasso, puis chiffrez l’accès, l’hébergement et l’exploitation pour votre équipe.4 oct. 2026Build
OpenAI API pricing : quels budgets pour GPT-6.1 Sol ?
Tarifs de l’API OpenAI vérifiés en octobre 2026 : budgets GPT-6.1 Sol, Luna et Astra, coûts de recherche, de conteneurs, d’audio et d’images.3 oct. 2026Build
Pi Coding Agent : installer et prendre en main Pi 1.0
Installez Pi 1.0, connectez votre compte de modèle et lancez une première tâche. Un guide avec AGENTS.md, les coûts des fournisseurs et les limites de Pi.3 oct. 2026Build