Transcription audio : Grok Voice Transcribe 2.0 garde ses tarifs, mais change de modèle par défaut
Grok Voice Transcribe 2.0 maintient la transcription audio à $0.10 par heure en batch et à $0.20 par heure en streaming, mais change de modèle par défaut.
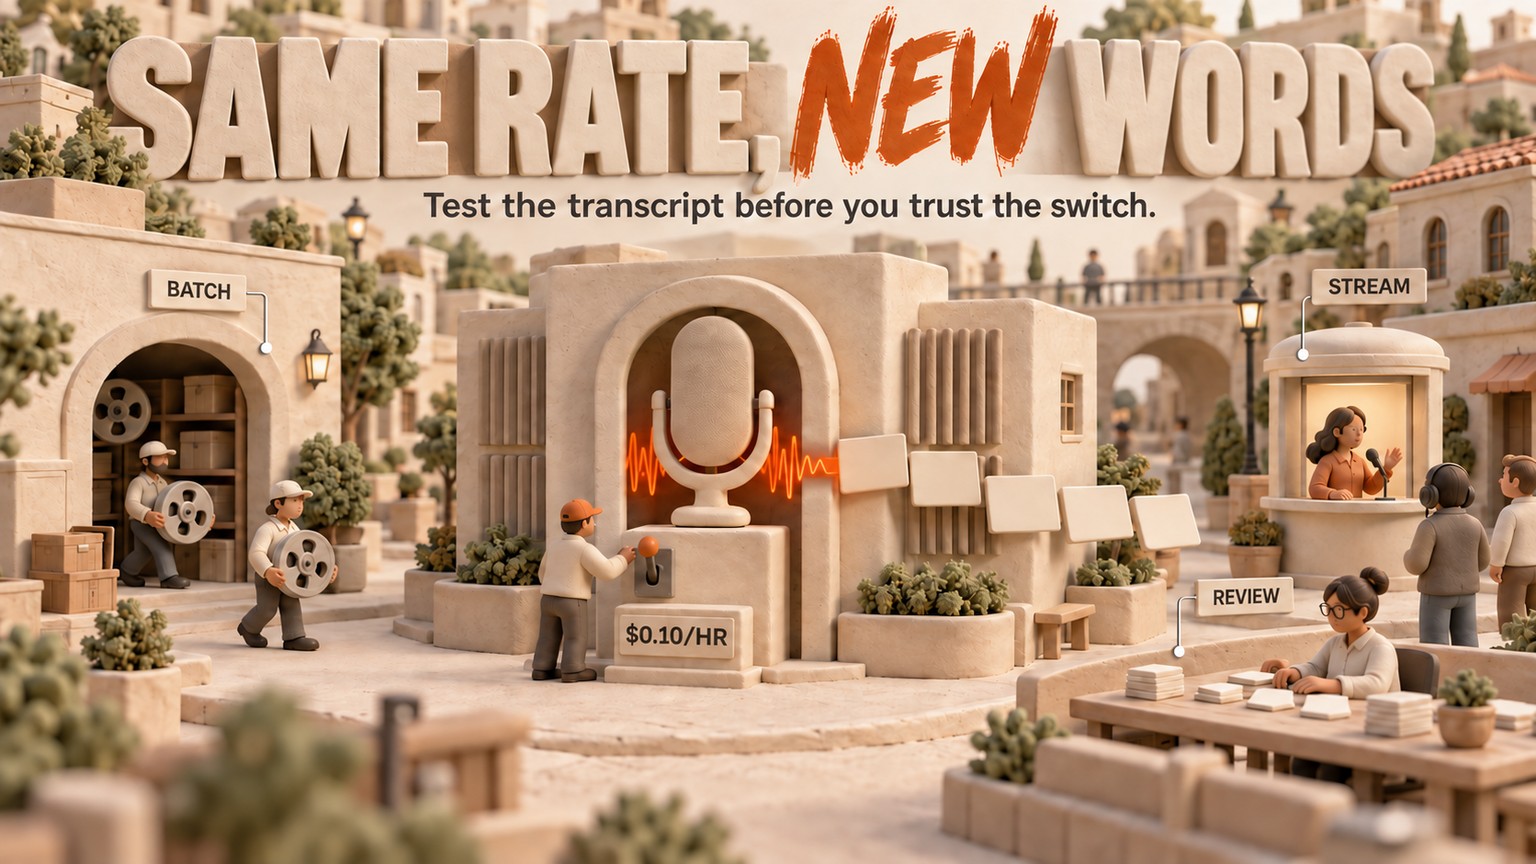
Grok Voice Transcribe 2.0 maintient la facture de transcription audio à $0.10 par heure en batch et à $0.20 par heure en streaming. Mais le modèle par défaut a changé dans la documentation en ligne : un même appel API sans version verrouillée peut désormais produire un texte différent et modifier tout le travail effectué en aval.
Ce qui a réellement changé
xAI a lancé Grok Voice Transcribe 2.0 le 18 septembre 2026. Il remplace Grok Voice Transcribe 1.0 comme modèle de reconnaissance vocale actuel : son rôle est de convertir une parole enregistrée ou en direct en texte exploitable par un autre produit ou workflow.
Les deux modes de fonctionnement sont simples. En batch, un fichier ou une URL audio est envoyé à un endpoint REST une fois l’enregistrement terminé. En streaming, l’audio transite par WebSocket pendant que la personne parle encore. Les sous-titres, les réponses d’un agent ou l’assistance en direct peuvent ainsi réagir avant la fin de l’appel.
La page de lancement indique que les intégrations existantes peuvent recevoir le modèle 2.0 sans aucune modification du code. Cela paraît indolore, mais c’est précisément ce qui doit alerter les équipes d’exploitation. Si la requête ne précise aucun modèle, c’est le fournisseur qui décide du moment où le résultat change.
La grille tarifaire, elle, ne bouge pas. Le batch reste à $0.10 par heure audio et le streaming à $0.20. La diarisation des locuteurs, qui attribue les mots à chaque intervenant, ainsi que les horodatages au niveau du mot et le biaisage par termes clés sont inclus dans ces tarifs.
Transcription audio : la facture API reste stable, pas forcément le coût du workflow
Au niveau de l’API, le calcul est limpide :
Le streaming coûte deux fois plus cher que le batch. Sur 1,000 heures audio, le surcoût atteint $100. Il se justifie lorsque l’attente de l’enregistrement final compromettrait le produit, par exemple pour des sous-titres en direct, l’assistance téléphonique en temps réel ou un agent vocal qui doit décider immédiatement de sa prochaine réponse.
Si l’audio se trouve déjà dans un espace de stockage, le streaming ne rend pas, à lui seul, la transcription plus utile. Une médiathèque, un stock de podcasts, une interview enregistrée ou un traitement nocturne d’appels devrait généralement rester en batch pour conserver le tarif le plus bas.
Le poste API ne représente qu’une partie du budget. L’équation opérationnelle utile est la suivante :
Coût total de transcription = dépense API audio + coût de correction humaine + reprises en aval
Le premier terme est connu grâce à la grille tarifaire. Le deuxième dépend du temps de relecture et du coût horaire complet du correcteur. Le troisième apparaît lorsqu’une modification des mots, des étiquettes de locuteur, des horodatages ou des nombres formatés altère un fichier de sous-titres, un score qualité, une note CRM, un index de recherche ou une action automatisée.
Voilà la conséquence métier de cette sortie. Les dépenses audio peuvent rester parfaitement stables tandis que le coût total nécessaire pour obtenir une transcription exploitable évolue dans un sens ou dans l’autre. Tant qu’un échantillon audio représentatif n’a pas été testé, la baisse du temps de correction reste une possibilité, pas une économie à inscrire dans les prévisions.
À qui s’adresse le modèle, et qu’est-ce qui change concrètement ?
Un responsable du support client disposant d’appels enregistrés
Une équipe support peut traiter ses appels enregistrés en batch à $0.10 par heure audio, activer la diarisation et transmettre les noms de produits comme termes clés. Le coût direct de l’API reste prévisible. Pour la migration, il faut déterminer si 2.0 réduit ou augmente le nombre de minutes que le correcteur consacre aux noms, aux informations de compte et à l’attribution des locuteurs.
Le bénéfice ne se résume pas à un score de précision abstrait. Il se mesure à une file de corrections plus courte, sans hausse des erreurs en aval. Mesurez ces deux dimensions avant de modifier le modèle verrouillé en production.
Une équipe produit qui exploite un agent vocal en direct
Avec un agent vocal, attendre la fin de l’appel viderait le produit de son intérêt. Le streaming à $0.20 par heure audio justifie son tarif supérieur, car la transcription fait partie de la boucle de contrôle en direct. L’équipe doit comparer le traitement des pauses, des nombres, des interruptions et des termes clés par les deux modèles, puis examiner les actions déclenchées à partir de ces transcriptions.
Une transcription peut sembler plus propre à la lecture tout en cassant un workflow : il suffit qu’une valeur formatée différemment fausse une recherche, ou qu’une limite de tour pousse l’agent à répondre trop tôt. Le test d’acceptation doit donc porter sur l’action en aval, et pas seulement sur le texte.
Un responsable média chargé de livrer des sous-titres
Une agence qui traite des interviews ou des vidéos client devrait privilégier le batch, conserver les horodatages dans le comparatif et soumettre aux deux modèles verrouillés les mêmes noms difficiles ainsi que les mêmes chevauchements de voix. Le gain se juge au temps de correction et à la qualité des sous-titres livrés, pas au benchmark global du fournisseur.
Une API est un composant, pas un espace de montage. Si l’équipe a besoin d’un éditeur dans le navigateur, d’un bot de réunion, d’un workflow de sous-titrage ou d’un circuit de recours à un humain, consultez plutôt le comparatif complet des outils de transcription.
Une équipe support SaaS multilingue
Selon xAI, 2.0 est deux fois plus précis que 1.0 sur l’ensemble de ses évaluations. Le fournisseur indique également que le taux d’erreur sur les mots, mesuré sur son propre jeu de phrases courtes multilingues, est passé de 20.6% à 6.8%. Il s’agit de comparaisons réalisées par le fournisseur, et non de tests menés pour cet article.
Une équipe support multilingue devrait échantillonner son véritable éventail de langues, d’accents, de lignes téléphoniques, de noms et d’alternances de langues. Un gain global ne permet pas de savoir si les langues qui génèrent l’essentiel des tickets se sont améliorées, ni si le temps de correction a suffisamment baissé pour influer sur les effectifs.
Verrouillez le modèle, puis testez le résultat
L’appel batch minimal tient en quelques lignes. Cet exemple cURL reprend la requête xAI documentée et précise explicitement le modèle 2.0 :
curl -X POST https://api.x.ai/v1/stt \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -F model=grok-voice-transcribe-2.0 \
  -F file=@audio.mp3
La ligne essentielle est celle du modèle. En verrouillant explicitement grok-voice-transcribe-2.0, vous gardez la maîtrise du choix. Pour établir provisoirement une base de comparaison, la documentation actuelle autorise encore grok-voice-transcribe-1.0. Dans une requête multipart, placez le champ du fichier en dernier : xAI avertit que les champs d’option situés après lui risquent d’être ignorés.
Utilisez exactement les mêmes paramètres de requête des deux côtés du test de migration. Si vous changez simultanément le modèle, la diarisation, le formatage, le traitement des mots de remplissage et les termes clés, il devient impossible d’identifier la cause d’une différence dans le résultat.
Repérez toutes les requêtes sans modèle verrouillé
Recherchez, dans les parcours batch et streaming, les appels qui omettent
model. Pensez aux tâches d’arrière-plan, aux outils internes, au staging et aux intégrations tierces susceptibles d’encapsuler l’endpoint. La documentation en ligne dirige désormais toute requête sans modèle vers 2.0.Constituez un jeu audio représentatif
Sélectionnez des exemples réels des conditions rencontrées par le système : enregistrements propres, appels bruités, locuteurs qui se chevauchent, accents, noms de produits, adresses e-mail, codes de compte et langues qui concentrent réellement le volume. Supprimez ou protégez les données sensibles selon la politique déjà en vigueur.
Exécutez 1.0 et 2.0 avec les mêmes réglages
Verrouillez explicitement chaque modèle et ne modifiez aucune autre option. Conservez le texte transcrit, les horodatages, l’attribution des locuteurs et le résultat de tout résumé, recherche, score ou action automatisée qui les exploite.
Mesurez les écarts humains et système
Relevez le temps de correction par heure audio. Signalez les erreurs dans les noms, les nombres, l’attribution des locuteurs et les horodatages. Comparez ensuite le résultat en aval : une modification de transcription ne compte que si elle améliore ou dégrade la tâche à laquelle le texte est destiné.
Choisissez le modèle à verrouiller en production
Verrouillez 2.0 une fois les critères d’acceptation remplis. Ne conservez 1.0 que comme solution de repli temporaire et documentée tant qu’il reste disponible, sans fonder un plan de long terme sur une date de retrait non publiée.
Ce que l’on peut affirmer honnêtement
Le prix est vérifié. Les économies de main-d’œuvre ne le sont pas.
Les affirmations de xAI sur la précision donnent de bonnes raisons de tester le modèle, mais elles ne constituent pas un modèle de planification des effectifs. Chaque composition audio peut produire des résultats différents, et un taux d’erreur sur les mots inférieur ne réduit pas automatiquement le temps de relecture ni les risques liés à l’automatisation.
La formulation de la transition a également évolué plus vite que l’annonce. La page du 18 septembre présente le changement de modèle par défaut comme imminent, alors que la documentation actuelle désigne déjà 2.0 lorsque le modèle est omis. Ce décalage justifie d’autant plus un modèle explicite en production, plutôt qu’un alias mouvant.
Enfin, les tarifs de $0.10 et $0.20 couvrent le traitement audio. Ils n’incluent ni la file de relecture, ni le travail d’intégration, ni le stockage, ni les nouvelles tentatives, ni le coût d’une action erronée en aval. Séparez ces postes pour éviter qu’une API bon marché ne masque un workflow coûteux.
Que faut-il faire maintenant ?
Agissez cette semaine si une requête xAI de reconnaissance vocale omet le modèle, ou si la production est verrouillée sur 1.0. Recensez les appels, exécutez le jeu représentatif et choisissez explicitement le modèle de production.
Réservez le streaming aux cas où recevoir la transcription pendant la prise de parole change le résultat du produit. Pour les enregistrements qui peuvent attendre, utilisez le batch : la diarisation, les horodatages et les options de termes clés inclus coûtent alors moitié moins cher au niveau audio.
Attendez si vous en êtes seulement à comparer les fournisseurs et qu’aucune transcription xAI n’alimente encore un workflow en production. Gardez 2.0 dans votre sélection, mais comparez sur vos propres fichiers le coût total de correction et les conséquences en aval avant de migrer.
Vous n’êtes pas concerné si votre système n’utilise pas la reconnaissance vocale xAI, ou si 2.0 est déjà verrouillé et son résultat validé. Une intégration verrouillée sur 1.0 reste stable pour le moment, mais ce n’est pas une raison de repousser le test de migration : xAI a déjà annoncé sa dépréciation.
L’action à mener lundi est simple : prenez un échantillon audio représentatif, exécutez 1.0 et 2.0 avec les mêmes réglages, mesurez le temps de correction et les différences en aval, puis verrouillez le modèle qui réussit le test. La grille tarifaire inchangée simplifie le budget API. Le contrôle de la transcription protège tout le workflow qui l’entoure.
Pour recevoir une analyse concrète lorsqu’un prix ou un workflow d’IA change réellement, inscrivez-vous à la newsletter.
- Dernière mise à jour
- 20 sept. 2026
- Catégorie
- Explained
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Débogage Cloudflare Browser Run : analysez l’échec avant de relancer
Cloudflare Browser Run permet désormais d’inspecter les logs, les requêtes réseau et le DOM après un échec, afin de corriger le problème avant toute relance.19 sept. 2026Explained
Design system privé : v0 réutilise enfin vos composants
v0 installe désormais vos packages npm privés. Découvrez comment connecter votre design system, protéger les identifiants et préparer la mise en production.19 sept. 2026Explained
Prix Claude Code : quand le mode auto évite le surcoût
Claude Code 2.1.278 supprime les frais du classificateur pour les sessions éligibles. Vérifiez /status et le repli de la passerelle avant de revoir le budget.19 sept. 2026Explained
Vercel pricing : Turbo à la carte pour un seul déploiement
Le Vercel pricing permet désormais d’activer Turbo sur un seul déploiement urgent, sans toucher au réglage du projet. Voici comment chiffrer le surcoût.18 sept. 2026Explained
ChatGPT Word : rédiger et réviser sans changer d’application
ChatGPT Word permet de rédiger, résumer et réviser un document depuis une barre latérale. Accès, coûts, limites et méthode pour le tester sur un vrai fichier.18 sept. 2026Explained
Google Antigravity : migrer les jobs locaux avant le 5 octobre
Préparez vos jobs Google Antigravity avant le 5 octobre : identifiez ceux qui exigent un nouvel adaptateur d’outils et ceux où changer l’ID suffit.18 sept. 2026Explained
Durable Objects Cloudflare : le tracing RPC révèle le service qui ralentit la requête
Le tracing Cloudflare Workers suit désormais les appels JavaScript RPC jusque dans les Durable Objects pour repérer le service qui ralentit une requête.17 sept. 2026Explained