Bloccare l’addestramento AI su Cloudflare senza penalizzare la SEO
Configura Cloudflare per negare l’addestramento AI senza perdere l’indicizzazione: verifica la migrazione, il robots.txt e l’accesso dei crawler.



Per bloccare l’addestramento AI senza fermare i crawler dei motori di ricerca, imposta Search su Allow e Training su Disallow AI Training. Poi verifica sia le impostazioni migrate sia il file robots.txt servito da Cloudflare. Oggi questa distinzione è decisiva: dal 15 settembre 2026 Cloudflare ha cambiato il significato di Block, che può impedire anche ai crawler multiuso come Googlebot, Applebot e Bingbot di accedere al sito per l’indicizzazione.
Bloccare l’addestramento AI: la configurazione sicura
Per la maggior parte dei siti che dipendono dalla ricerca, la scelta è lineare: consentire Search, negare Training e decidere separatamente come gestire gli Agent.
Nella spiegazione del 15 settembre, Cloudflare è esplicita: per fermare l’addestramento senza rinunciare alla ricerca bisogna usare Disallow AI Training. Le guide meno recenti che consigliano Training: Block non sono più affidabili. Prima della modifica, il blocco escludeva i crawler multiuso; ora li include.
Il controllo è disponibile su tutti i piani Cloudflare, quindi non occorre acquistare un upgrade dedicato. Il costo non è più quello di un altro prodotto di blocco, ma quello di verificare che policy e comportamento coincidano. Come riferimento, negli Stati Uniti una licenza di Screaming Frog SEO Spider costa $279 all’anno, mentre un prodotto dedicato al monitoraggio di robots.txt pubblicizza un piano da $129 al mese. Cloudflare fornisce il controllo; resta comunque necessario un ciclo di verifica.
Che cosa fa davvero Disallow AI Training
Disallow esprime una preferenza accompagnata da un’applicazione selettiva; Block, invece, chiude la porta.
Un crawler multiuso è come un furgone che trasporta due ordini di lavoro. Il primo dice: “indicizza questa pagina per la ricerca”. Il secondo: “usa questa pagina per addestrare un modello”. Bloccare il furgone interrompe entrambi i lavori. Con Disallow AI Training, un operatore ritenuto responsabile può continuare a svolgere il primo, ma deve rinunciare al secondo.
Cloudflare divide il traffico automatizzato in tre comportamenti:
- Search crea un indice di ricerca.
- Training addestra o perfeziona un modello.
- Agent visita il sito per conto di una persona, per esempio come sistema di recupero contenuti per una chat o agente che usa il browser.
La nuova opzione di Training indica a Bot Preference Sync di pubblicare in robots.txt le istruzioni pertinenti contro l’addestramento. I crawler multiuso responsabili possono continuare ad accedere per la ricerca. I crawler di Amazon, Anthropic, Meta e OpenAI dedicati esclusivamente al training vengono invece bloccati, senza trascinare con sé i rispettivi crawler separati per la ricerca.
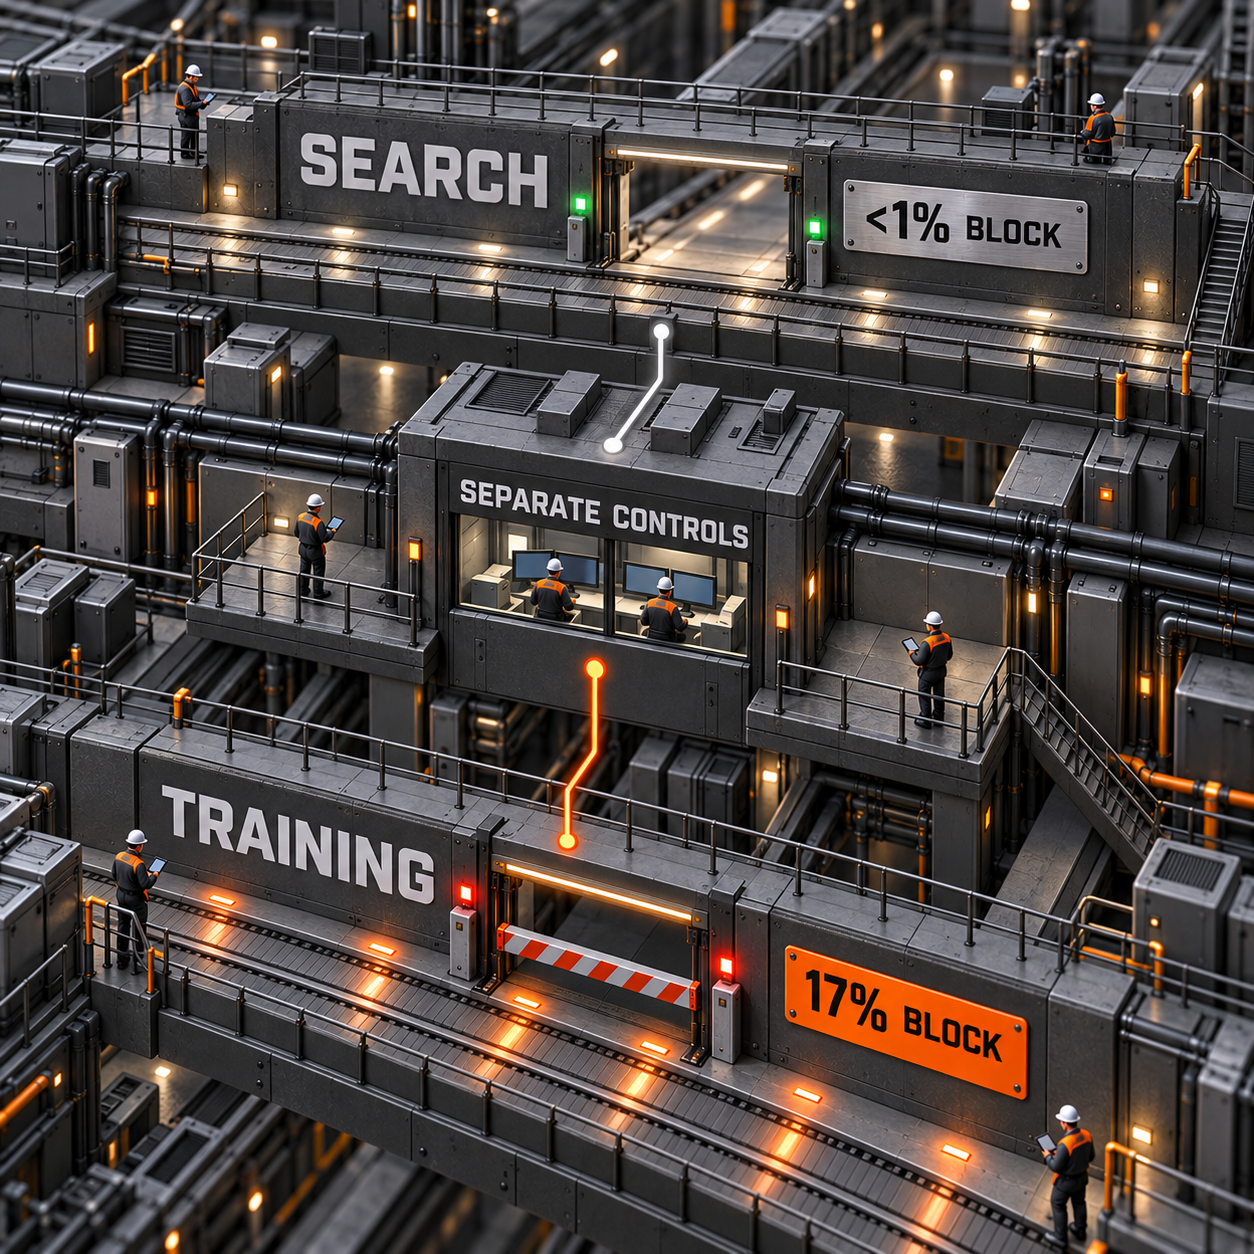
Secondo Cloudflare, meno dell’1% dei suoi siti blocca i bot di Search, mentre il 17% attiva un meccanismo per bloccare Training. Questa distanza spiega il design del prodotto: un unico interruttore Block AI era troppo rigido rispetto a ciò che i proprietari dei siti vogliono davvero.
C’è però una distinzione essenziale. Un’istruzione in robots.txt non è un campo di forza. Da sola non può riconoscere chi sta effettuando il crawling, stabilire perché lo sta facendo o fermare chi decide di ignorarla. Cloudflare abbina la preferenza pubblicata alla classificazione di rete e al blocco dei crawler che non soddisfano i requisiti del percorso responsabile.
“Accountable” non significa sempre “disponibile oggi”
L’etichetta Accountable di Cloudflare va letta come uno stato sostenuto da una roadmap, non come prova che ogni controllo promesso sia già operativo.
Per qualificarsi, un operatore deve soddisfare o impegnarsi a soddisfare requisiti che comprendono l’opt-out dall’addestramento, l’opt-out dai riepiloghi AI, la visibilità a livello di URL e la garanzia che il rifiuto dell’addestramento non penalizzi la ricerca tradizionale. La formulazione è importante.
- Google: Google-Extended può essere escluso in robots.txt e Google dichiara che questa scelta non incide sul posizionamento nei risultati. Offre inoltre un controllo per webmaster relativo alla ricerca generativa e alla reportistica. Una maggiore trasparenza di Google-Extended a livello di URL era ancora indicata come in arrivo nelle settimane successive all’annuncio.
- Apple: Applebot-Extended supporta l’opt-out dall’addestramento tramite robots.txt. Apple supporta anche
nosnippetper i riepiloghi AI e l’etichettatura dei paywall. Al momento dell’annuncio non era disponibile un’ispezione a livello di URL, descritta come un lavoro previsto per l’anno successivo. - Microsoft: per Bing, oggi, il percorso è diverso. I proprietari dei siti possono usare
NOARCHIVEinsieme agli strumenti Block URLs o Content Removal di Bing. Microsoft punta all’inizio del 2027 perché Bingbot rispetti una preferenza di dominio contro l’addestramento in robots.txt. Fino ad allora, l’impostazione Disallow AI Training di Cloudflare non trasmette automaticamente a Bing quella preferenza tramite robots.txt.
La promessa corretta, quindi, è più circoscritta di “un solo interruttore controlla ogni uso ovunque”. La nuova impostazione rende molto più chiara la scelta tra ricerca e addestramento, ma oggi Bing richiede ancora un controllo separato.
Verificare che cosa ha migrato Cloudflare
La maggior parte delle impostazioni viene trasferita automaticamente. Tuttavia, etichette ed effetti sono cambiati abbastanza da rendere necessario un audit del risultato.
Se un dominio non aveva mai usato i controlli granulari Search, Training e Agent, Cloudflare converte la vecchia impostazione Block AI Bots in questo modo:
Se il dominio usava già i controlli granulari, Search e Agent mantengono il loro stato effettivo. Training: Allow resta Allow. Training: Block e Training: Block on pages with ads diventano entrambi Disallow AI Training.
Ecco il controllo da eseguire dopo la migrazione:
- Apri il dominio in Cloudflare, vai in Security Settings e poi in Configure AI bot policies.
- Prima di modificare qualsiasi cosa, annota i valori correnti di Search, Training e Agent.
- Se la scoperta organica è importante, imposta Search su Allow.
- Per applicare l’opt-out dall’addestramento senza escludere dalla ricerca i crawler multiuso responsabili, imposta Training su Disallow AI Training.
- Scegli la policy degli Agent in base alle sue conseguenze specifiche. Cloudflare non offre una preferenza Disallow per gli Agent perché non esiste ancora una direttiva Internet consolidata.
- Se vuoi che Cloudflare pubblichi in robots.txt la policy per categoria, verifica che Bot Preference Sync sia attivo.
- Salva la policy e controlla il risultato pubblico: l’etichetta nella dashboard, da sola, non è una prova.
Per i nuovi domini sostenuti dalla pubblicità, il preset consigliato da Cloudflare segue già questo schema: Preference Sync attivo, Search su Allow, Training su Disallow AI Training e Agent bloccati sulle pagine con annunci. Nei nuovi domini senza monetizzazione pubblicitaria, invece, tutti e tre i comportamenti sono inizialmente consentiti.
Come verificare l’accesso dei crawler di ricerca
Un interruttore apparentemente corretto è solo il primo punto di controllo. La policy va verificata dall’esterno verso l’interno.
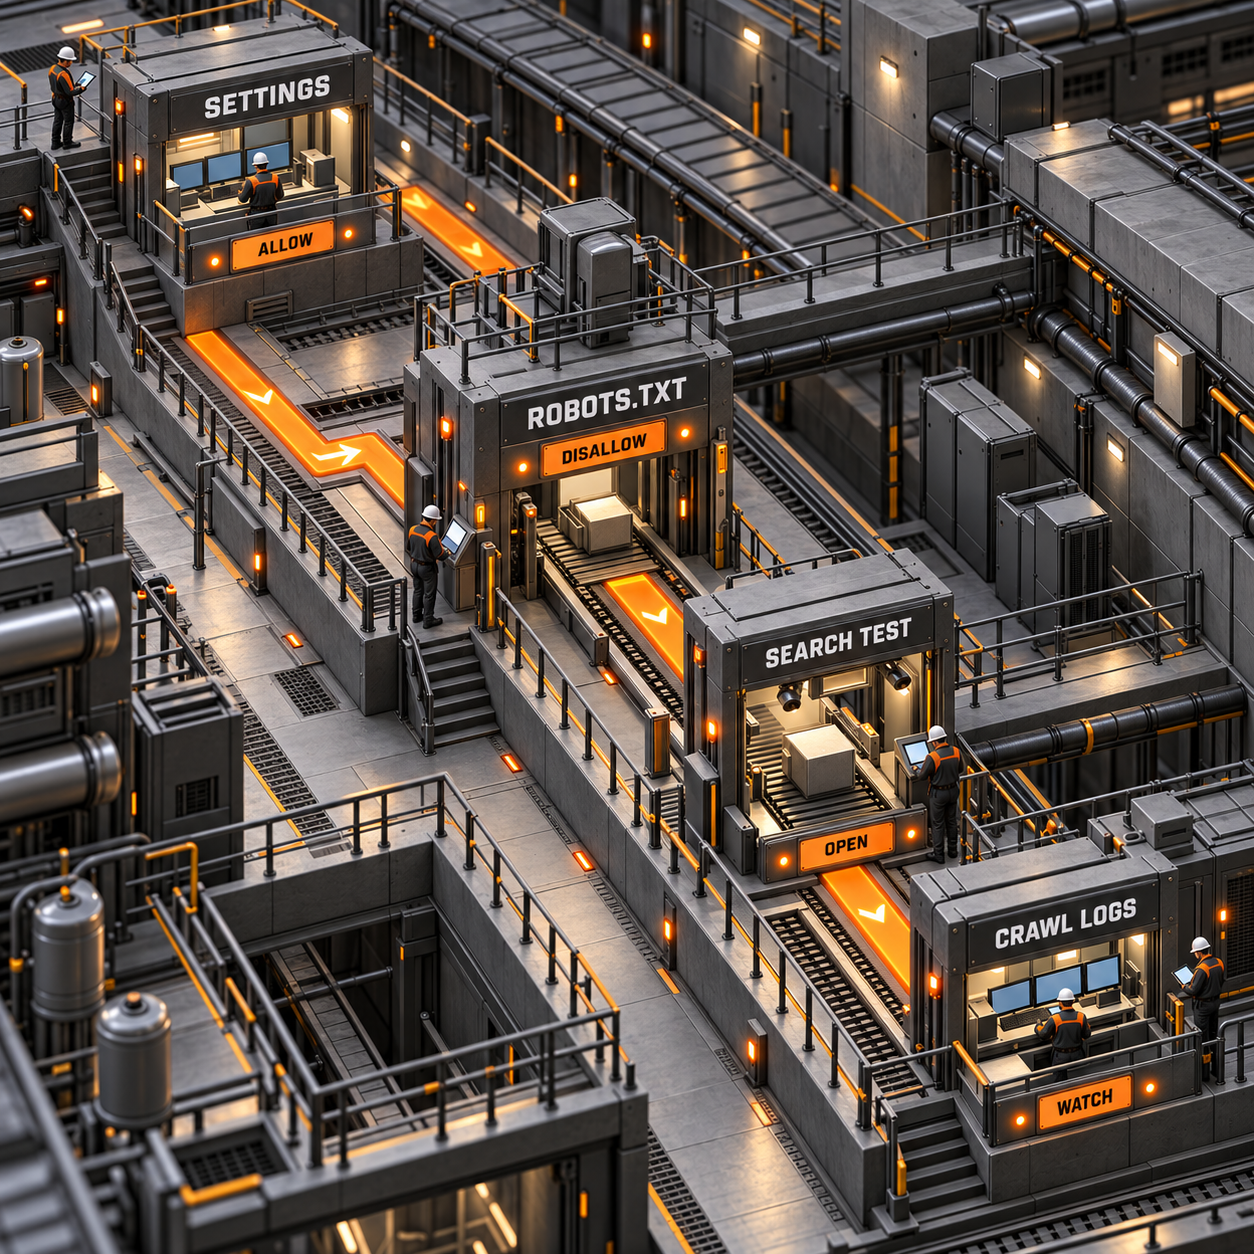
Il controllo si articola in quattro parti:
- Impostazioni: verifica che Search riporti Allow e Training riporti Disallow AI Training. Valuta Agent a parte.
- robots.txt: recupera il file
/robots.txtdal dominio pubblico. Bot Preference Sync antepone le regole generate a un file esistente, quindi le direttive Disallow originali rimangono. Cerca eventuali conflitti in entrambe le sezioni. - Comportamento nella ricerca: usa gli strumenti per webmaster e i report del motore di ricerca per esaminare URL rappresentativi. Non dedurre lo stato dell’accesso dalla sola parola “Disallow”: si riferisce all’identità o alla preferenza di addestramento, non allo scopo di ricerca tradizionale di un crawler multiuso responsabile.
- Attività dei crawler: monitora in AI Crawl Control le richieste, il rispetto di robots.txt e i blocchi inattesi. Cloudflare può applicare azioni a singoli crawler e ne registra l’attività: è quindi il punto più pratico per scoprire una policy che si comporta diversamente dalle intenzioni.
Le regole personalizzate richiedono ancora più attenzione. Bot Preference Sync rispecchia una policy valida per l’intera categoria, ma non traduce le regole individuali complesse nel file generato. In presenza di un’eccezione di licenza per un crawler, di logiche specifiche per percorso o di una regola WAF personalizzata, confronta manualmente questi livelli. Se una policy per categoria è troppo generica, Cloudflare consente di disattivare Sync e gestire il file in autonomia.
Chi guadagna di più dalla nuova separazione
Il vantaggio maggiore va alle attività che monetizzano quando una persona visita la pagina, ma non vogliono che il proprio archivio venga inglobato nei dati di addestramento.
L’esempio del retailer evidenzia anche un limite: questi controlli agiscono a livello di dominio, non costituiscono un sistema integrato di consenso per singolo articolo. Zone separate possono adottare policy diverse; all’interno di una zona, invece, Search, Training e Agent mantengono una sola configurazione, a meno di aggiungere autonomamente regole più specifiche.
Che cosa vale la pena costruire
Il prodotto più solido non è un altro generatore di robots.txt, ma un sistema che rileva le regressioni nelle policy dei crawler.
1. Monitoraggio delle regressioni nelle policy dei crawler
Per agenzie e team multisito, costruisci un monitor che legga la policy Cloudflare, recuperi il robots.txt effettivamente servito, verifichi l’accesso alla ricerca su URL rappresentativi e segnali ogni divergenza fra questi livelli.
La domanda attorno a questo lavoro è visibile: robots.txt generator registra circa 1,000 ricerche mensili negli Stati Uniti, mentre google indexing checker ne registra circa 110. Anche gli strumenti esistenti dimostrano che c’è un budget: un prodotto per il monitoraggio di robots.txt propone un piano da $129 al mese per cinque domini, mentre un monitor desktop delle modifiche SEO costa $179 una tantum.
La versione minima vendibile richiede quattro elementi: importazione delle zone Cloudflare, confronto tra policy e robots.txt, controlli programmati e un avviso via email o Slack che mostri la modifica esatta. Attività dei crawler e dati per webmaster possono arrivare dopo, quando il rilevatore principale delle divergenze si sarà dimostrato affidabile.
Il punto critico è la prova. Configurazione e richieste osservate possono mostrare che cosa il sito ha pubblicato e bloccato; non possono dimostrare che il fornitore di un modello abbia eliminato dati già raccolti. Il vantaggio competitivo deve quindi essere una catena di evidenze affidabile su molti domini, non un interruttore più gradevole.
2. Audit della migrazione Cloudflare
Costruisci un audit mirato che individui le zone rimaste su combinazioni rischiose dopo la migrazione e produca un report con le correzioni per un’agenzia, un gruppo editoriale o una rete in franchising.
cloudflare block ai bots registra circa 50 ricerche mensili negli Stati Uniti con un CPC di $13.19; google indexing checker aggiunge altre 110 ricerche mensili legate all’esito più temuto. La domanda è più contenuta rispetto al mercato dei generatori, ma il costo dei clic suggerisce che chi effettua la ricerca ha un problema operativo concreto.
L’MVP può leggere via API i campi Search, Training, Agent e Bot Preference Sync, recuperare il robots.txt pubblico e classificare ogni zona come sicura per la ricerca, bloccata intenzionalmente o incoerente. Il risultato è un pacchetto di evidenze pronto per il cliente, con impostazione e file osservato affiancati.
Il rischio è la dipendenza dalla piattaforma. Cloudflare potrebbe aggiungere lo stesso report di portafoglio e la necessità tende a concentrarsi intorno alle migrazioni. Il modello più robusto usa l’audit come prodotto d’ingresso, per poi vendere il monitoraggio continuo delle regressioni su Cloudflare e altri provider edge.
Che cosa non risolve questo controllo
Il confine della policy è più chiaro, ma non rappresenta una soluzione completa all’uso dei contenuti da parte dell’AI.
- Non cancella i materiali già raccolti. Cloudflare descrive preferenze dei crawler e controlli sulle richieste, non un’eliminazione retroattiva.
- Non garantisce che ogni operatore rispetti robots.txt. Cloudflare aggiunge l’applicazione a livello di rete per i crawler esterni al percorso responsabile, ma quest’ultimo dipende comunque dal rispetto della preferenza da parte dell’operatore.
- Non effettua l’opt-out da ogni riepilogo AI. I controlli sui riepiloghi sono separati e Cloudflare indica come lavoro futuro un controllo centralizzato più ampio.
- Non offre uno stato Disallow per gli Agent.
- Non traduce in Bot Preference Sync le regole personalizzate complesse per singolo crawler.
- Non comunica ancora automaticamente a Bing la preferenza contro l’addestramento tramite robots.txt. I controlli
NOARCHIVEe per webmaster attualmente disponibili in Bing vanno verificati a parte. - Non è l’indicizzazione dei file R2 con Cloudflare AI Search. Quello è un prodotto distinto, con un workflow diverso.
Scegli Block quando vuoi davvero escludere il crawler. Scegli Disallow AI Training quando la visibilità nei motori di ricerca resta parte del modello di business. È questa la distinzione centrale introdotta dal cambiamento di settembre.
La mossa da fare lunedì
La prossima settimana scegli tre domini rappresentativi: una proprietà finanziata dalla pubblicità, un sito che acquisisce traffico dalla ricerca e un dominio con regole personalizzate per i crawler. Registra i valori migrati di Search, Training e Agent, modifica solo i siti per cui l’obiettivo aziendale è chiaro, quindi salva il robots.txt pubblico e il report dei crawler insieme al ticket della modifica. Se tutti e tre superano il controllo, estendi la stessa verifica basata sulle evidenze a tutto il portafoglio.
Come si disattiva l’addestramento AI?
Su un dominio gestito da Cloudflare, imposta Training su Disallow AI Training per pubblicare una preferenza contro l’addestramento mantenendo disponibili per la ricerca i crawler multiuso responsabili. Usa Block solo se accetti anche le conseguenze che il loro blocco può avere sulla ricerca.
Si possono bloccare tutti i contenuti AI?
È possibile bloccare categorie o singoli crawler, ma “tutti i contenuti AI” riunisce attività molto diverse. Cloudflare separa il traffico Search, Training e Agent per consentire di scegliere quali usi automatizzati ammettere. Bloccare Training non rimuove i materiali generati dall’AI dai prodotti di ricerca e non cancella i dati già raccolti.
Come si disattiva la modalità AI nei motori di ricerca?
L’impostazione dei crawler di Cloudflare non disattiva per gli utenti un’esperienza di ricerca basata sull’AI: controlla l’accesso al dominio. Google e altri operatori offrono controlli separati per i riepiloghi generativi, mentre indicizzazione tradizionale e preferenze di addestramento restano decisioni distinte.
Se vuoi costruire per la tua azienda un audit delle policy dei crawler e il relativo livello di monitoraggio, scopri i sistemi AI in produzione.
- Ultimo aggiornamento
- 16 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
App dettatura vocale offline: Murmure alla prova
Murmure offre dettatura vocale offline e gratuita su desktop. Testiamo dizionario, regole, privacy, LLM, limiti e costi per capire a chi conviene.14 set 2026Build
FFmpeg API di RenderIO: prezzi, crediti e soglie di upgrade
Scopri i prezzi della FFmpeg API di RenderIO, il costo reale dei crediti e le soglie esatte oltre le quali conviene passare a Growth o Business.14 set 2026Build
Dettatura vocale gratis: quanto costa davvero Dictare
Dictare offre dettatura vocale gratis e locale per i coding agent. Scopri quali costi restano: hardware, configurazione, consumi e piano dell’agente.13 set 2026Build
Claude Code evals: misurare davvero l’effetto di un plugin
Scopri come i Claude Code evals confrontano un plugin con un controllo, misurano il delta, stimano i costi e trasformano una regressione in un gate CI.12 set 2026Build
Voice agent AI: diagnosticare la latenza con Cloudflare
Scopri come usare VoiceTurnMetrics di Cloudflare per isolare latenza, silenzi ed errori di un voice agent AI prima di cambiare modello o provider.12 set 2026Build
Inserire sottotitoli in un video con Rendi e un file SRT
Scopri come inserire sottotitoli in un video con Rendi: prepara l'SRT, invia il job FFmpeg e verifica l'MP4 prima di automatizzare il rendering.11 set 2026Build
OpenAI Agents SDK o Agents API: quale runtime scegliere
OpenAI Agents SDK o Agents API? Confronta controllo del runtime, sessioni gestite, costi, vincoli ZDR e migrazione per scegliere l’architettura giusta.11 set 2026Build