Claude Code MCP nei job automatici: il timeout giusto all’avvio
Configura l’attesa iniziale dei server in Claude Code MCP, separa i diversi timeout e verifica gli strumenti obbligatori prima che parta il job.


Nei job Claude Code MCP, imposta CLAUDE_CODE_MCP_STARTUP_WAIT_MS sul numero massimo di millisecondi da attendere perché i server MCP siano pronti prima del primo turno non interattivo. Con 0 l’attesa viene saltata. In questo modo i job pianificati hanno una finestra di disponibilità ben definita, senza modificare il timeout di connessione MCP, il timeout degli strumenti MCP o la scadenza complessiva del job.
Risposta in una riga
Usa CLAUDE_CODE_MCP_STARTUP_WAIT_MS=5000 claude -p "Run the scheduled check" per concedere fino a cinque secondi all’avvio MCP nel primo turno. Scegli CLAUDE_CODE_MCP_STARTUP_WAIT_MS=0 quando il job può partire anche se nessun server MCP è ancora pronto.
Claude Code 2.1.274 ha introdotto questa variabile il 17 settembre 2026. La nota di rilascio chiarisce due aspetti: il valore limita in millisecondi l’attesa del primo turno non interattivo e 0 significa non attendere. Non indica invece un valore predefinito per la nuova variabile. Nei job senza supervisione conviene quindi impostarla esplicitamente, così un futuro valore di default o una variabile d’ambiente a livello di macchina non cambieranno silenziosamente la policy di avvio.
Per non interattiva si intende un’esecuzione avviata con -p o --print, per esempio un controllo CI, un job cron o un’attività pilotata da SDK. Questa opzione non è pensata per le sessioni interattive nel terminale.
La regola pratica è semplice:
Questi intervalli sono raccomandazioni operative, non valori predefiniti di Anthropic. Prima di standardizzarli, misura i tuoi server.
Che cosa regola davvero l’attesa iniziale di Claude Code MCP
Immagina il primo turno come la partenza di un treno e ogni server MCP come una coincidenza. CLAUDE_CODE_MCP_STARTUP_WAIT_MS stabilisce per quanto tempo il treno resta in stazione ad aspettare i passeggeri in arrivo. Non decide per quanto tempo ciascun passeggero può tentare di raggiungere la stazione, quanto dura il lavoro dopo la partenza né quando deve concludersi l’intero viaggio.
È proprio questa delimitazione a renderla utile. Prima della 2.1.274, chi gestiva questi flussi ricorreva spesso a MCP_TIMEOUT, che governa un altro timer. Ora un job pianificato può scegliere una breve finestra di disponibilità per il primo turno senza fingere che ogni connessione al server o ogni successiva chiamata a uno strumento debba rispettare la stessa scadenza.
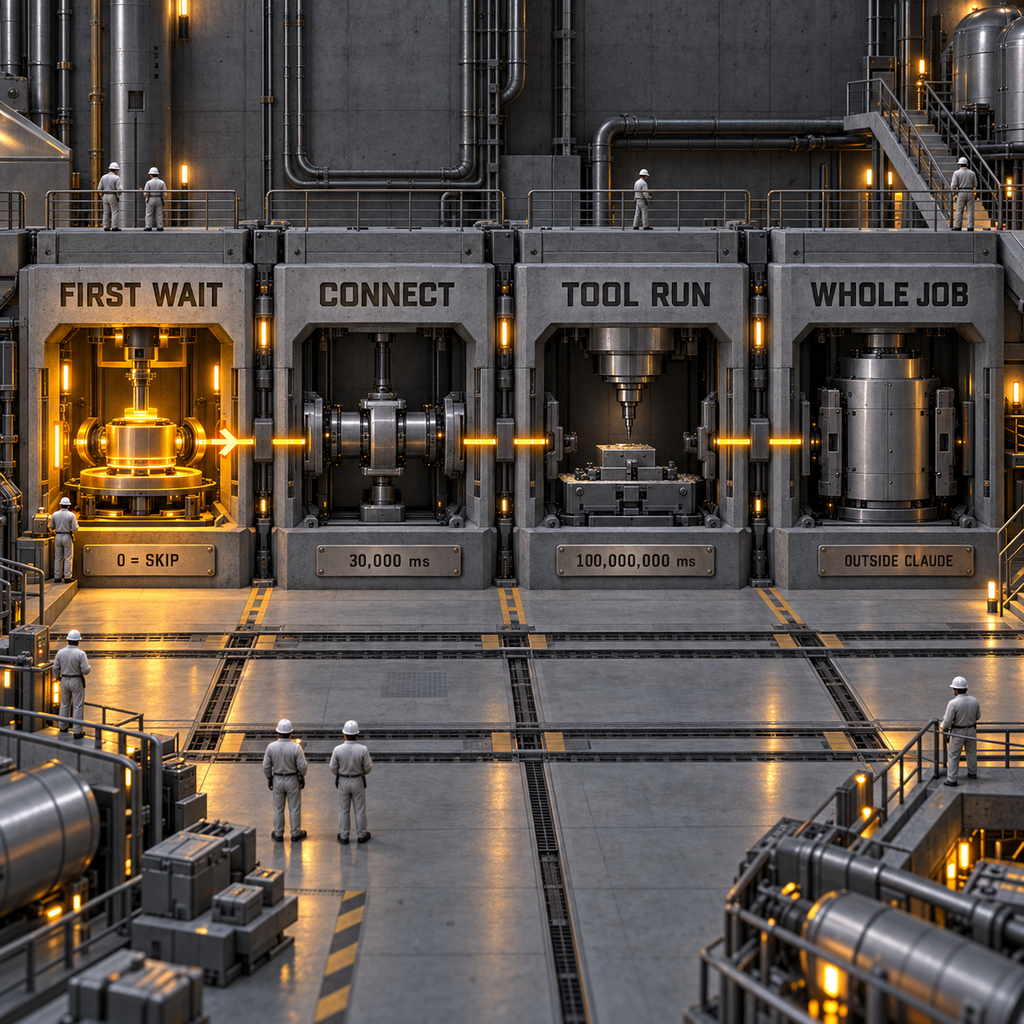
Quattro timer, quattro decisioni diverse in caso di errore
La configurazione più sicura assegna un nome a ogni timer e una sola responsabilità.
Esiste anche MCP_CONNECT_TIMEOUT_MS, il cui valore predefinito è 5,000 ms per un gruppo di connessioni di avvio bloccanti. Si applica ai comportamenti di avvio bloccante, per esempio MCP_CONNECTION_NONBLOCKING=0 o un server contrassegnato con alwaysLoad: true. La documentazione sulle variabili d’ambiente di Anthropic lo distingue esplicitamente da MCP_TIMEOUT.
Per le chiamate agli strumenti, il campo timeout di un singolo server in .mcp.json sostituisce MCP_TOOL_TIMEOUT per quel server. È utile quando una query al data warehouse può ragionevolmente richiedere più tempo di una consultazione del sistema di ticket. Anche in questo caso, la nuova attesa del primo turno non cambia.
Questa distinzione spiega anche perché 0 non sia un acceleratore universale. Se la ricerca degli strumenti è attiva e il prompt richiede in seguito un server ancora in connessione, Claude Code attende dentro ToolSearch. Se la ricerca è disattivata, usa WaitForMcpServers. Saltare l’attesa all’ingresso può semplicemente spostarla più avanti nel job.
Un test eseguibile con un server lento
Puoi riprodurre il limite con un server stdio locale che ritarda soltanto la risposta di inizializzazione MCP. Salva il seguente codice come slow-mcp.mjs:
import readline from "node:readline";

const delay = Number(process.env.SLOW_MCP_DELAY_MS || 5000);
const lines = readline.createInterface({ input: process.stdin });
const send = message => process.stdout.write(JSON.stringify(message) + "\n");

lines.on("line", line => {
  const request = JSON.parse(line);
  if (request.method === "initialize") {
    setTimeout(() => send({
      jsonrpc: "2.0",
      id: request.id,
      result: {
        protocolVersion: request.params.protocolVersion,
        capabilities: { tools: {} },
        serverInfo: { name: "slow-ready", version: "1.0.0" }
      }
    }), delay);
  } else if (request.method === "tools/list") {
    send({ jsonrpc: "2.0", id: request.id, result: { tools: [] } });
  }
});
Indicalo a Claude Code tramite slow-mcp.json:
{
  "mcpServers": {
    "slow-ready": {
      "type": "stdio",
      "command": "node",
      "args": ["./slow-mcp.mjs"],
      "env": { "SLOW_MCP_DELAY_MS": "5000" }
    }
  }
}
Avvialo con CLAUDE_CODE_MCP_STARTUP_WAIT_MS=1000 MCP_TIMEOUT=10000 claude -p "Reply with OK." --mcp-config ./slow-mcp.json --strict-mcp-config --output-format stream-json --verbose.
L’opzione --strict-mcp-config esclude dal test i server utente e di progetto non pertinenti. Il formato stream rende visibile l’evento iniziale system/init, inclusi nome e stato di ogni server MCP. Mostra anche mcp_server_errors quando una configurazione fornita non è valida.
Che cosa ha mostrato il controllo locale
Un controllo di avvio eseguito prima dell’autenticazione su Claude Code 2.1.274 ha usato quel server da 5,000 ms. Poiché l’ambiente non aveva una sessione attiva, l’esecuzione si è fermata all’autenticazione. La misurazione riguarda solo l’avvio, cioè esattamente il confine sottoposto al test.
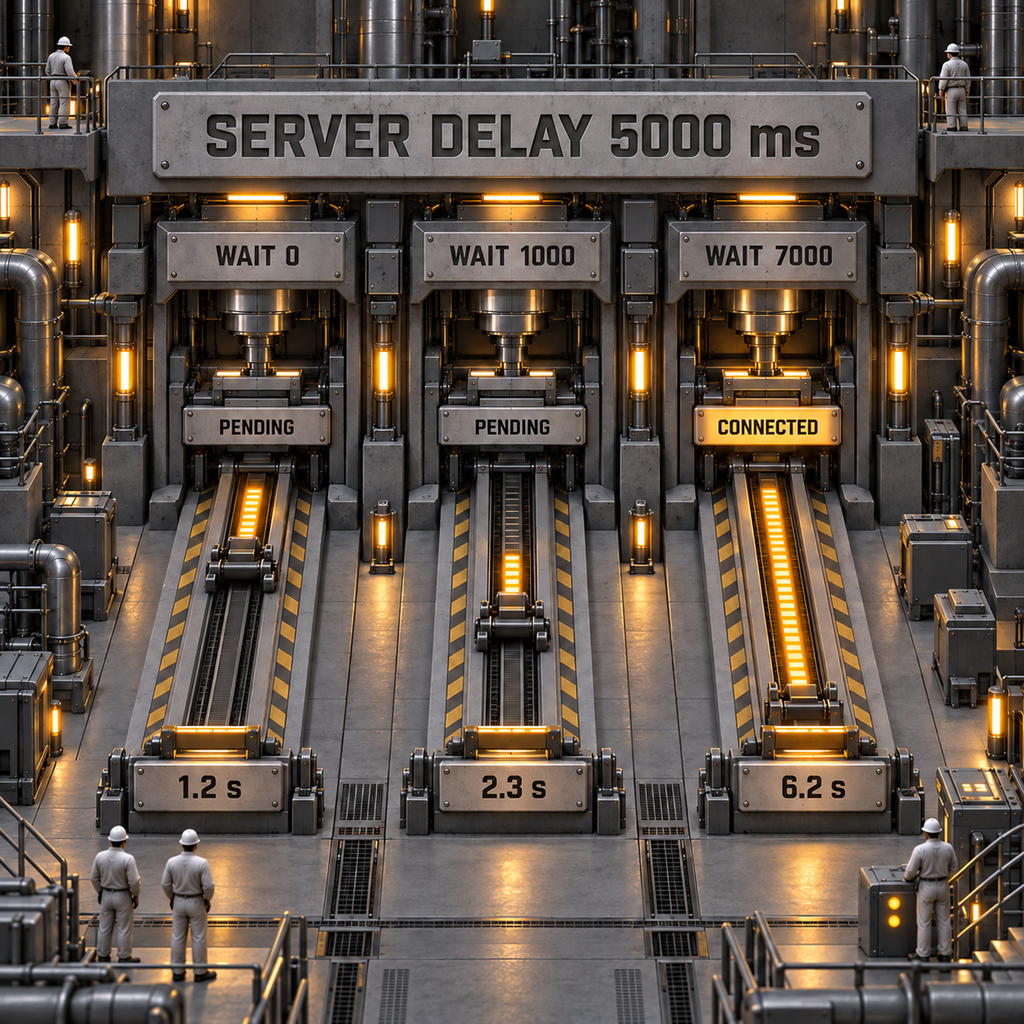
I tempi complessivi includono l’overhead di avvio di Claude Code e npx, quindi non vanno copiati in un obiettivo di servizio. Il risultato utile è qualitativo: con 0 e 1,000 ms il controllo del primo turno ha lasciato proseguire l’esecuzione mentre il server era ancora in attesa; con 7,000 ms lo stesso server è risultato connesso. Il test non misura né la latenza del modello né la durata totale del job.
Verificare la disponibilità prima del lavoro effettivo
Un timeout risponde soltanto alla domanda: «Quanto aspettiamo?». In produzione serve anche stabilire quali strumenti sono obbligatori.
Applica un controllo in due parti:
- Prima di avviare l’attività effettiva, esegui un health check di ogni endpoint remoto o comando server locale necessario. Per i server configurati e approvati,
claude mcp listriporta stati come connesso, autenticazione necessaria o connessione non riuscita. - Nel flusso di Claude Code, controlla
system/init.mcp_servers. Il server richiesto deve averestatus: "connected"e non deve comparire in una voce non vuota dimcp_server_errors. Gestisci i server memorizzati nella cache o facoltativi secondo una allowlist esplicita.
Se il server necessario è in attesa, termina l’esecuzione prima di accettare qualsiasi risultato operativo. Se è facoltativo, registra la modalità degradata e prosegui. Così il valore di attesa diventa un parametro della policy, non la policy stessa.
La cache del rilevamento richiede particolare attenzione. Un server remoto con un elenco di strumenti memorizzato nella cache può apparire in attesa durante l’inizializzazione e connettersi alla prima chiamata di uno strumento. È un comportamento utile per gli strumenti facoltativi, ma non soddisfa una garanzia rigida di disponibilità. Il controllo di uno strumento obbligatorio deve esigere una connessione attiva o svolgere un proprio health check.
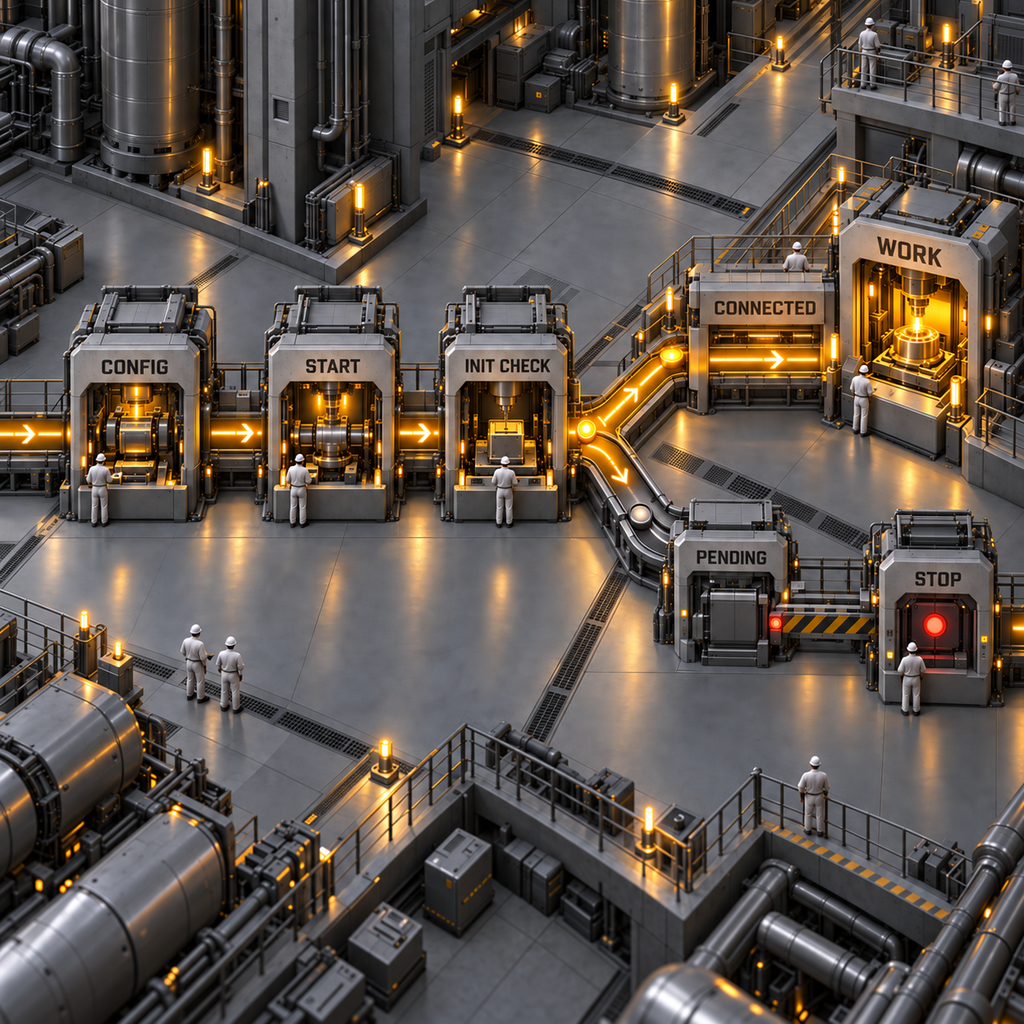
Infine, applica all’intero processo una scadenza gestita dallo scheduler. L’attesa di avvio non può impedire a una richiesta al modello, a un comando Bash, a un hook o a una successiva chiamata MCP di consumare il resto della finestra di esecuzione.
Il vero vantaggio economico è fallire prima
Il risparmio di calcolo esiste, ma è facile sovrastimarlo. Immagina 10,000 job mensili che altrimenti attenderebbero tutti i 30 secondi e una finestra del primo turno impostata a 3 secondi. La capacità massima recuperata sarebbe di 4,500 minuti di runner.
GitHub indica attualmente $0.006 al minuto per un runner Linux hosted standard a 2 core e $0.062 al minuto per un runner macOS. A queste tariffe, 4,500 minuti equivalgono a $27 di tempo Linux o $279 di tempo macOS prima dei minuti inclusi. GitHub arrotonda inoltre il consumo di ogni job al minuto intero, quindi un miglioramento di 27 secondi potrebbe non ridurre affatto il costo se la durata totale rimane nella stessa fascia di fatturazione.
Il beneficio maggiore è operativo. Se il controllo di disponibilità fallisce in tre secondi, lo scheduler ha il tempo di riprovare, avvisare il responsabile corretto o passare a un’alternativa. Un job che parte senza accesso al database o al sistema di ticket può invece produrre un risultato plausibile ma incompleto, più costoso da individuare e correggere del tempo del runner.
Se devi anche gestire risposte molto voluminose, la guida ai limiti dell’output degli strumenti di Claude Code tratta l’altro lato del flusso. Per installazioni senza supervisione e policy di rete, abbina questo controllo di disponibilità all’accesso di rete per singolo comando.
Sette flussi di lavoro che ne traggono più vantaggio
1. Report pianificati per finanza e operations
Un responsabile finanziario esegue alle 6 a.m. un report che richiede un server MCP per il data warehouse. Contrassegna quel server come obbligatorio, aggiungi un piccolo margine al suo avvio a freddo misurato e interrompi il job se non risulta connesso. Il vantaggio non è soltanto un’esecuzione più rapida: si evita un report dall’aspetto impeccabile ma costruito sui file del repository mentre i dati aggiornati erano inaccessibili.
2. Controlli automatici del rischio nelle pull request
Un team di piattaforma esegue Claude Code su ogni pull request ad alto rischio e si aspetta di usare strumenti di GitHub, di un sistema di ticket e di uno scanner di sicurezza. Il controllo può rendere obbligatori GitHub e lo scanner, lasciando facoltativo il sistema di ticket. Gli sviluppatori ottengono un errore rapido e comprensibile, invece di una revisione che omette silenziosamente le prove più importanti.
3. Job di coordinamento delle release
Un release manager usa un agente pianificato per confrontare il lavoro integrato, gli incidenti aperti e lo stato del deployment. Ogni fonte può avere una regola di disponibilità specifica. Se il server MCP del deployment non funziona, il job si ferma prima di redigere note di rilascio che lascerebbero intendere che la release è sicura.
4. Triage notturno dell’assistenza
Un team di supporto affida a un job il raggruppamento dei ticket, la consultazione dello storico degli account e la preparazione delle risposte. I server dell’help desk e dei dati cliente sono obbligatori; Slack può essere facoltativo. Un’attesa limitata mantiene scorrevole la coda, mentre la regola di disponibilità impedisce di inventare il contesto privato del cliente quando una fonte non è disponibile.
5. Assistenti per la risposta agli incidenti
Un tecnico reperibile avvia da un alert un’esecuzione diagnostica non interattiva. Una breve finestra di avvio mostra subito se log e metriche sono davvero raggiungibili. Se uno dei due server obbligatori non è disponibile, il wrapper può passare immediatamente al runbook manuale, invece di sprecare la finestra dell’incidente in una diagnosi parziale.
6. Runner effimeri con scalabilità automatica
Un team avvia container nuovi per ogni job dell’agente. I server stdio locali possono sostenere costi di avvio a freddo dovuti al caricamento dei pacchetti, agli helper di autenticazione o al rilevamento dello schema. Misurare questi avvii permette di distinguere una finestra realistica di sette secondi da una soluzione tampone permanente per un server malfunzionante.
7. Prodotti agentici multi-tenant
Un prodotto serve clienti con connessioni MCP diverse. Un tenant può richiedere Salesforce, un altro Linear e un altro ancora nessuno strumento esterno. Un elenco per esecuzione dei server obbligatori consente allo stesso livello di orchestrazione di scegliere per ogni tenant un’attesa breve, senza imporre a tutti come valore predefinito l’integrazione più lenta.
Tre prodotti che vale la pena costruire
1. Controllo di disponibilità MCP per Claude Code in CI
È l’opportunità più solida. Il prodotto è un piccolo wrapper per runner che legge la policy dei server obbligatori, avvia Claude Code con un’attesa esplicita, registra system/init e restituisce un errore di disponibilità strutturato prima di accettare il risultato dell’agente.
La domanda è circoscritta ma ha valore commerciale: claude code automation registra circa 140 ricerche mensili negli Stati Uniti, una crescita annua del 200% nei dati dei suggerimenti e un CPC di $10.88. Le persone chiedono anche come eseguire Claude Code automaticamente e come configurare Claude Code con MCP. Sono segnali diretti di un problema di configurazione reale.
La versione minima vendibile è una CLI con un file di policy, annotazioni per GitHub Actions e prove in formato JSON per ogni esecuzione. La criticità è la distribuzione. Anthropic può introdurre policy di disponibilità native più ricche, quindi il valore duraturo deve risiedere nello storico trasversale delle esecuzioni, negli avvisi e nel supporto di più runtime per agenti.
2. Linter per le policy di timeout
Questo strumento analizzerebbe script shell, file CI, impostazioni e .mcp.json, segnalando timer incoerenti: un’attesa di avvio pari a zero con strumenti obbligatori, una scadenza breve del job abbinata a un timeout dello strumento di 28 ore oppure un’integrazione facoltativa senza limite.
La keyword esatta mcp server timeout conta circa 10 ricerche mensili negli Stati Uniti e una tendenza annua dichiarata del -67%. Una ricerca correlata è MCP_TOOL_TIMEOUT, mentre gli utenti chiedono come aumentare il timeout di Claude Code. È una domanda sufficiente per una funzione interna al controllo di disponibilità, non per un’azienda indipendente.
Un MVP richiede parser per GitHub Actions, la sintassi shell più comune e la configurazione MCP di Claude Code, oltre a correzioni prescrittive. Il limite è il rischio di falsa sicurezza: una configurazione statica non può conoscere la distribuzione reale dei tempi di avvio a freddo di un server senza misurazioni durante l’esecuzione.
3. Telemetria di avvio per agenti pianificati
Questo prodotto trasformerebbe gli eventi system/init in una timeline di latenza di connessione, stati in attesa, configurazioni non valide ed esecuzioni degradate. I team di piattaforma pagherebbero per avere tendenze e avvisi su molti repository, invece di leggere a mano file JSONL.
Si rivolge alle stesse 140 ricerche mensili di claude code automation, mentre claude code browser automation ne aggiunge altre 40 e mostra anch’essa una crescita annua del 200% nei dati dei suggerimenti. Il segnale più ampio è il passaggio di Claude Code a job ripetibili, dove le prove di avvio diventano un problema operativo.
L’MVP è composto da un sistema di raccolta degli eventi, una mappa dei server obbligatori e facoltativi e avvisi quando la disponibilità supera un obiettivo di servizio. La criticità è la sensibilità dei dati. I nomi MCP e i metadati degli strumenti possono rivelare sistemi interni, quindi oscuramento dei dati e self-hosting fanno parte del prodotto fin dall’inizio, non sono rifiniture enterprise da rimandare.
Limiti e valutazione realistica
Questo controllo risolve una parte piccola ma preziosa dell’automazione affidabile. Non ripara un server MCP guasto, non rinnova l’autenticazione scaduta di un connettore, non abbrevia una chiamata successiva a uno strumento e non arresta l’intero processo Claude Code.
Non usare 0 in un job la cui prima azione utile richiede MCP. All’inizializzazione può comparire lo stato pending e l’attesa può ripresentarsi quando viene cercato lo strumento. Evita anche di aumentare il valore finché i server instabili sembrano funzionare. I server HTTP e SSE riprovano dopo errori transitori della prima connessione, ma gli errori di autenticazione e di risorsa non trovata richiedono modifiche alla configurazione. Un’attesa più lunga ritarda soltanto la scoperta del problema.
I server stdio, inoltre, non si riconnettono automaticamente dopo una disconnessione a metà sessione. Una finestra di avvio generosa non dice nulla sulla loro salute dieci minuti più tardi.
La policy migliore è rigorosa e poco spettacolare: una breve attesa esplicita per il primo turno, server obbligatori nominati, un controllo dello stato, un timeout separato per gli strumenti e una scadenza esterna del job. Questa combinazione produce errori utili invece di ritardi inspiegabili.
Come si aumenta il timeout di Claude Code?
Scegli il timeout in base alla fase lenta. Usa CLAUDE_CODE_MCP_STARTUP_WAIT_MS per l’attesa della disponibilità MCP nel primo turno non interattivo, MCP_TIMEOUT per l’avvio del server, MCP_TOOL_TIMEOUT o un timeout specifico del server per l’esecuzione degli strumenti e il limite del runner per l’intero job.
Come si esegue Claude Code automaticamente?
Avvia Claude Code in modalità non interattiva con -p o --print, definisci come gestire le autorizzazioni degli strumenti nelle esecuzioni senza supervisione, imposta una scadenza esterna nello scheduler e rendi esplicita la disponibilità MCP. La sola attesa di avvio non rende sicuro un job automatico.
Perché Claude Code continua ad andare in timeout?
Per prima cosa individua nei log la fase interessata. Un ritardo prima di system/init indica probabilmente un problema di avvio o di disponibilità della connessione. Un errore durante una chiamata a uno strumento MCP rimanda ai limiti dello strumento, di inattività o della richiesta di rete. Un processo terminato dalla CI indica invece la scadenza esterna del job.
Come si configura Claude Code con MCP?
Aggiungi la configurazione MCP di progetto o utente, oppure passa un file con --mcp-config. Per job ripetibili, aggiungi --strict-mcp-config, imposta un’attesa esplicita per il primo turno e verifica in system/init che i server obbligatori siano connessi, senza presumere che configurato significhi anche disponibile.
Lunedì scegli un job Claude Code pianificato, misura l’avvio a freddo dei server MCP necessari, imposta l’attesa minima realistica e fai fallire il job se un server obbligatorio è ancora in attesa prima che il risultato venga considerato attendibile. Se vuoi realizzare questo livello di affidabilità per tutti i tuoi flussi agentici, posso aiutarti a costruire il sistema di produzione.
- Ultimo aggiornamento
- 17 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Bloccare l’addestramento AI su Cloudflare senza penalizzare la SEO
Configura Cloudflare per negare l’addestramento AI senza perdere l’indicizzazione: verifica la migrazione, il robots.txt e l’accesso dei crawler.16 set 2026Build
App dettatura vocale offline: Murmure alla prova
Murmure offre dettatura vocale offline e gratuita su desktop. Testiamo dizionario, regole, privacy, LLM, limiti e costi per capire a chi conviene.14 set 2026Build
FFmpeg API di RenderIO: prezzi, crediti e soglie di upgrade
Scopri i prezzi della FFmpeg API di RenderIO, il costo reale dei crediti e le soglie esatte oltre le quali conviene passare a Growth o Business.14 set 2026Build
Dettatura vocale gratis: quanto costa davvero Dictare
Dictare offre dettatura vocale gratis e locale per i coding agent. Scopri quali costi restano: hardware, configurazione, consumi e piano dell’agente.13 set 2026Build
Claude Code evals: misurare davvero l’effetto di un plugin
Scopri come i Claude Code evals confrontano un plugin con un controllo, misurano il delta, stimano i costi e trasformano una regressione in un gate CI.12 set 2026Build
Voice agent AI: diagnosticare la latenza con Cloudflare
Scopri come usare VoiceTurnMetrics di Cloudflare per isolare latenza, silenzi ed errori di un voice agent AI prima di cambiare modello o provider.12 set 2026Build
Inserire sottotitoli in un video con Rendi e un file SRT
Scopri come inserire sottotitoli in un video con Rendi: prepara l'SRT, invia il job FFmpeg e verifica l'MP4 prima di automatizzare il rendering.11 set 2026Build