Claude Opus 5.5: vale il passaggio da Opus 5?
Claude Opus 5.5 costa meno, ma cinque modifiche API possono davvero bloccare la migrazione. Prezzi, benchmark e percorso di test rispetto a Opus 5.


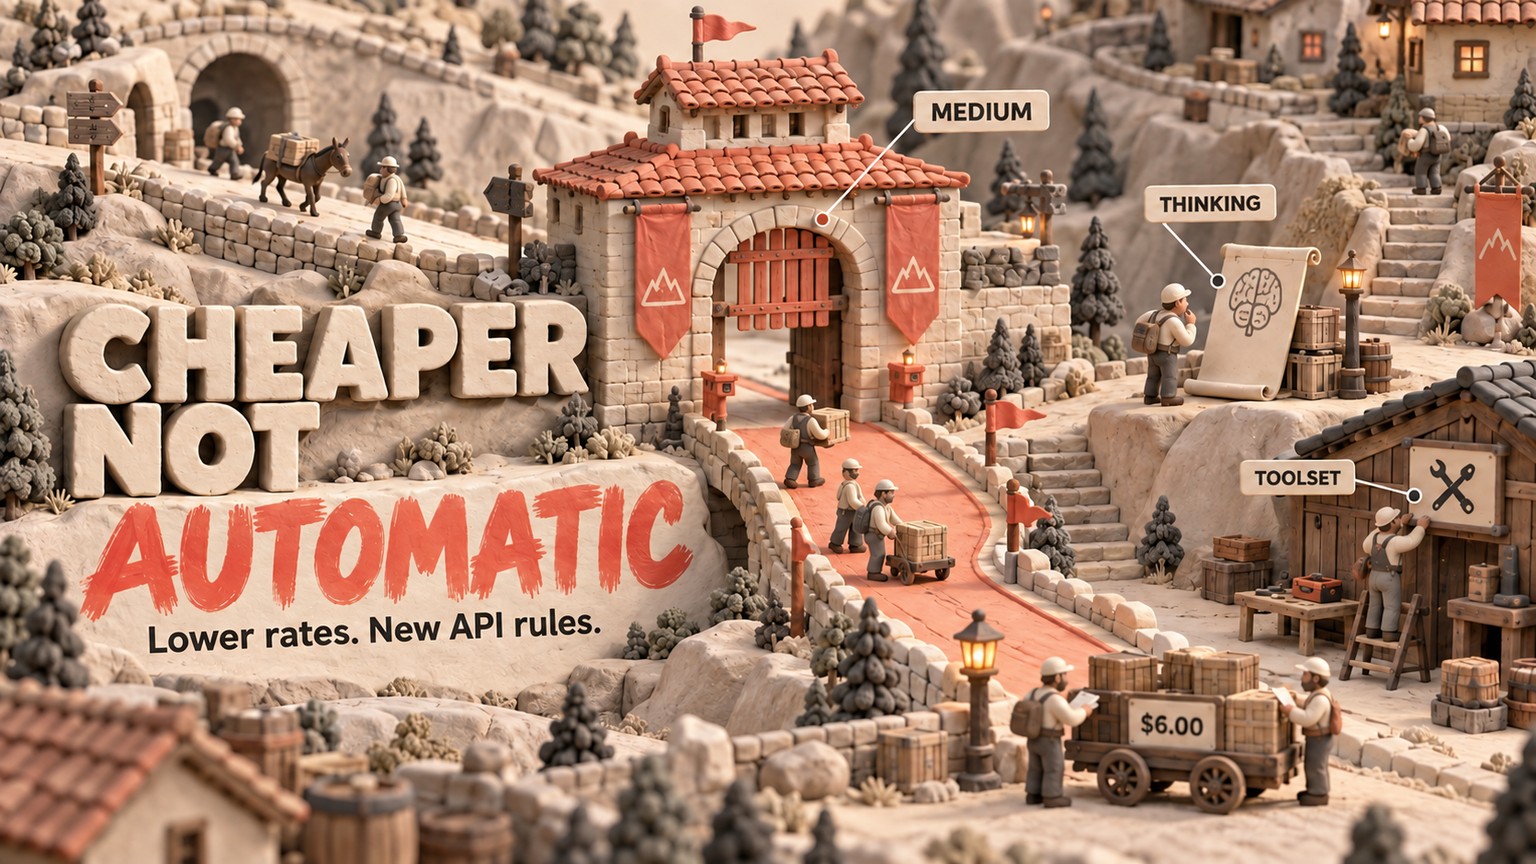
Claude Opus 5.5 è l’upgrade da provare per la maggior parte dei carichi di lavoro oggi affidati a Opus 5: 1 milione di token di input non memorizzati nella cache più 100,000 token di output fatturati costano $6.00 invece di $7.50. La scelta tra Claude Opus 5.5 e Opus 5 dipende però ancora da cinque modifiche all’integrazione, perché il modello più economico non può sostituire automaticamente quello precedente in ogni agente.
Claude Opus 5.5 vs Opus 5: quale conviene scegliere?
Per i nuovi lavori premium conviene scegliere Claude Opus 5.5 e valutarlo come sostituto della maggior parte delle route esistenti basate su Opus 5. È invece opportuno mantenere temporaneamente Opus 5 quando l’integrazione disattiva il thinking, impone uno strumento specifico o usa ancora il precedente computer tool nella Claude API o su Google Cloud. Sono decisioni che riguardano il percorso del codice, non semplici preferenze tra modelli.
Claude Opus 5.5 è la scelta migliore per un founder con capitali da investire, se il suo agente di coding genera una spesa tale da rendere significative le letture dalla cache e i retry. Anche un CTO di un’azienda di medie dimensioni dovrebbe preferirlo, ma solo dopo che il team di piattaforma avrà risolto le modifiche alla struttura delle richieste. Un responsabile operativo esperto che esegue estrazioni circoscritte dovrebbe prima verificare se Claude Sonnet 5 supera già la soglia di accettazione a una tariffa inferiore. Chi sviluppa da solo dovrebbe spostare su 5.5 il lavoro complesso sui repository e tenere del tutto lontane da Opus le attività più semplici.
La scelta torna a favore di Opus 5 quando il lavoro di migrazione costa più del risparmio previsto e la route precedente è già affidabile. Si tratta di un vantaggio temporaneo in termini di compatibilità, non di un motivo per avviare nuovi sviluppi sul modello meno recente.
Anthropic ha presentato Opus 5.5 il 22 settembre 2026. Nella sua guida ai modelli ora consiglia agli sviluppatori indecisi di partire da Opus 5.5 per la maggior parte dei carichi di lavoro, mentre il modello precedente resta utile come opzione di rollback durante la migrazione.
Claude Opus 5.5: prezzo e confronto dei costi
Claude Opus 5.5 costa meno a parità di token standard. I prezzi, verificati nella documentazione tariffaria live di Anthropic il 23 settembre 2026, sono pari a $4 per milione di token di input e $20 per milione di token di output per 5.5, contro $5 e $25 per Opus 5. È una riduzione del 20% rispetto al listino. Una lettura dalla cache riutilizza contenuti già presenti nel prompt: la relativa tariffa scende da $0.50 a $0.20 per milione, con un taglio del 60%.
Su scala più piccola, 1,000 token di input non memorizzati nella cache costano $0.004 con 5.5 e $0.005 con 5. L’output costa rispettivamente $0.020 e $0.025 ogni 1,000 token. In questo confronto tra API, nessuno dei due modelli prevede un punto di pareggio legato a un abbonamento mensile per postazione o a un prezzo fisso per immagine. Il conto dipende dai token: mantenendo identica la composizione dei token fatturati, 5.5 non diventa mai più costoso.
Il calcolo senza cache è diretto: Opus 5 costa $5 per l’input più $2.50 per l’output. Opus 5.5 costa $4 più $2. Il calcolo con cache già calda addebita 100,000 token di input non memorizzati, 900,000 token letti dalla cache e 100,000 token di output. Sono volutamente esclusi la creazione della cache, gli strumenti, i nuovi tentativi, gli sconti batch, la fast mode e i moltiplicatori per la residenza dei dati.
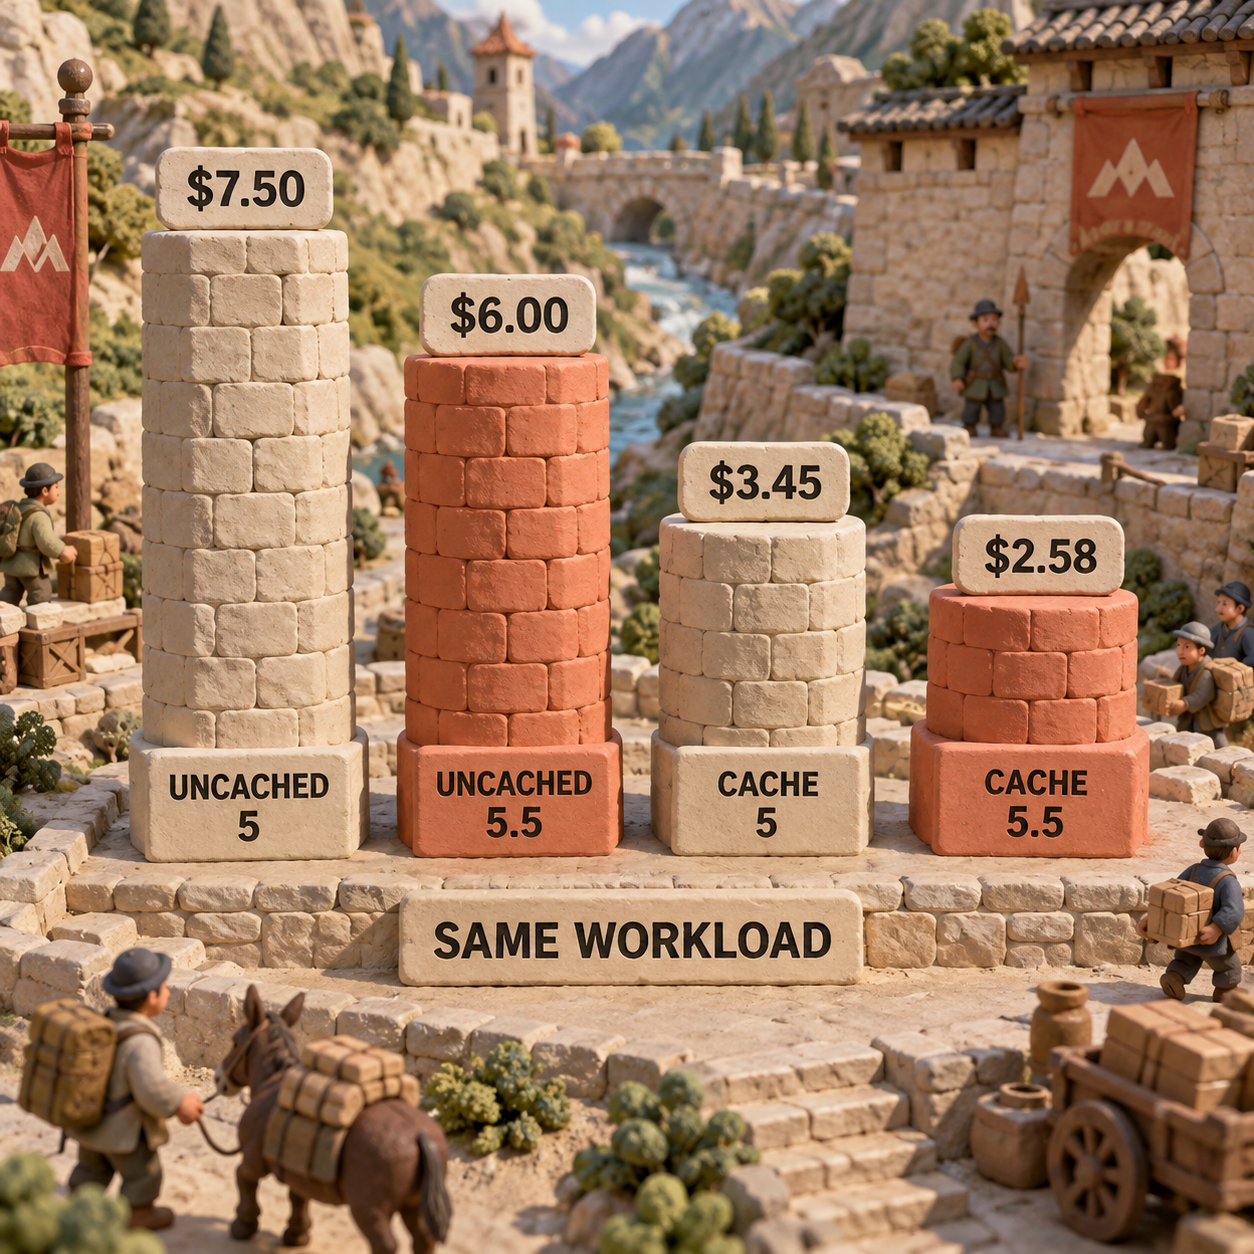
L’affermazione separata di Anthropic, secondo cui 5.5 costerebbe il 40% in meno sui carichi tipici, è una misurazione del vendor e non un altro calcolo basato sui prezzi di listino. Anthropic sostiene che il modello abbini tariffe inferiori a un minor numero di token per attività con le impostazioni predefinite. È importante tenere distinta questa dichiarazione dai calcoli a token fissi, invece di applicare uno sconto del 40% a ogni stima.
Il vero punto di pareggio dipende dal comportamento dei token. Nel calcolo senza cache, 5.5 potrebbe produrre 175,000 token di output, il 75% in più rispetto alla base di 100,000 token di Opus 5, prima di raggiungere lo stesso conto di $7.50. Nel caso con cache già calda potrebbe arrivare a 143,500 token di output, il 43.5% in più, prima di eguagliare $3.45. Se una migrazione supera questi limiti senza migliorare il tasso di accettazione, la tariffa inferiore non offre più un vantaggio.
Vincitore sul prezzo: Claude Opus 5.5. Il vantaggio tariffario è incondizionato a parità di utilizzo. Il vantaggio sul carico di lavoro deve comunque reggere alla misurazione dei token consumati e dei nuovi tentativi.
Claude Opus 5.5 nel coding: cosa dimostrano i dati pubblicati
Claude Opus 5.5 presenta il caso documentato più convincente per il coding, ma per questo confronto non è stata eseguita alcuna prova sui modelli. Non era disponibile una credenziale di esecuzione, quindi non viene avanzata alcuna affermazione su riparazioni di repository, attività di estrazione, ID del modello restituito, latenza o risultati di validazione prodotti durante questa analisi.
Recensione di Claude Opus 5.5 vs Opus 5: i limiti delle prove
Nelle valutazioni di lancio di Anthropic, Opus 5.5 con l’effort predefinito medium ha ottenuto il 52.5% su CursorBench 4.0, un test di attività di coding ambigue e distribuite su più file, ricavate da sessioni Cursor; Opus 5 con max si è fermato al 46.6%. Anthropic dichiara inoltre una generazione dell’output più veloce di oltre il 30%. Sono dati che giustificano una valutazione, ma le impostazioni di effort non coincidono e il confronto è stato condotto dal vendor.
AutomationBench offre un segnale misurato separatamente. Nella nota al lancio, Anthropic precisa che il benchmark è stato eseguito e riportato da Zapier: Opus 5.5 ha raggiunto il 40.0%, contro il 26.9% di Opus 5. Il test riguarda workflow tra applicazioni connesse, non qualsiasi codebase o processo aziendale, e non indica come si comporteranno il modello di autorizzazione, gli strumenti o il validatore di uno specifico sistema.
Per un agente di coding, i criteri di accettazione vanno definiti prima dell’esecuzione: i test devono passare, il diff deve restare nel perimetro previsto e la revisione non deve richiedere interventi correttivi. Per un’estrazione, occorrono uno schema esatto, valori ancorati alle fonti e un validatore deterministico. Vanno quindi registrati token di input, token nella cache, token di output, latenza, chiamate agli strumenti, nuovi tentativi ed errori. Un benchmark più alto non ripaga la spesa se il proprio harness produce più lavoro respinto.
Vincitore per i dati pubblicati sul coding: Claude Opus 5.5. Il livello di confidenza basta a giustificare una valutazione controllata, non un passaggio alla produzione alla cieca.
Claude Opus 5.5 API: le modifiche che impediscono una sostituzione diretta
Cinque controlli sull’integrazione contano più della modifica alla stringa del modello. La documentazione aggiornata sulle novità di Opus 5.5 di Anthropic segnala quattro modifiche che possono rendere incompatibili le richieste e una modifica alla struttura delle risposte che può causare un problema silenzioso nell’interfaccia.
1. Il thinking non può essere disattivato
Opus 5.5 usa sempre il thinking adattivo. Una richiesta con thinking:{"type":"disabled"} restituisce HTTP 400, così come un budget di thinking manuale impostato tramite thinking:{"type":"enabled","budget_tokens":N}. Il campo va omesso oppure bisogna inviare il thinking adattivo e regolarne la profondità con output_config.effort.
Opus 5 consentiva di disattivare il thinking con effort high o inferiore. Un percorso stabile e a bassa latenza costruito attorno a quell’opzione richiede quindi una riprogettazione, non soltanto un nuovo ID modello.
2. La selezione forzata di uno strumento genera un errore
Opus 5.5 rifiuta tool_choice quando è impostato su any o su un tool specifico, anche in questo caso con HTTP 400. auto e none restano supportati. Per ottenere output conformi a uno schema, Anthropic consiglia l’uso rigoroso degli strumenti con auto oppure gli output strutturati.
È una modifica sostanziale del contratto. Indicare nel prompt che il modello deve chiamare uno strumento non equivale a imporre la scelta a livello di API. Se un workflow dipende dall’esecuzione di una e una sola funzione, il percorso sostitutivo va validato prima di spostare il traffico.
3. I thinking block sono vincolati al modello e alla conversazione
I thinking block sono record della risposta che conservano il ragionamento del modello tra più turni con uso di strumenti. Opus 5.5 può leggere i blocchi prodotti da Opus 5, quindi una conversazione in sola append può proseguire senza perdere quel ragionamento precedente. Il limite è che 5.5 non può leggere i blocchi di qualsiasi modello e che modifiche successive al prompt di sistema, agli strumenti o ai messaggi precedenti possono invalidare i thinking block che ha conservato.
Per gli account API creati a partire dal 31 agosto 2026 alle 00:00 UTC, per impostazione predefinita la riproduzione di un blocco vincolato dopo una simile modifica al prefisso restituisce HTTP 400. La cronologia deve restare in sola append. Se l’applicazione modifica i turni precedenti o sostituisce sul posto le definizioni degli strumenti, occorre usare i controlli di binding documentati da Anthropic e verificare esplicitamente il comportamento in caso di scarto.
4. Il computer use cambia in base alla piattaforma
Nella Claude API e su Google Cloud, Opus 5.5 rifiuta il precedente strumento computer_20251124 e richiede computer_toolset_20260801. La migrazione non si limita a cambiare la stringa del tipo: il loop dell’agente deve gestire i blocchi tool_use dei membri, le azioni batch e toolset_name nei risultati. La documentazione di Anthropic sul computer use afferma che Amazon Bedrock continua ad accettare il precedente strumento con 5.5.
Questa differenza tra piattaforme può far sì che lo stesso deployment multi-cloud funzioni su un provider e restituisca un errore su un altro. Provider e corpo della richiesta vanno verificati insieme.
5. Il testo di avanzamento può sparire senza errori
Opus 5.5 restituisce brevi note tra le chiamate agli strumenti sotto forma di blocchi thinking di aggiornamento dell’avanzamento, anziché come normali blocchi text. Con il valore predefinito display:"omitted", il testo del thinking è vuoto. Un’interfaccia che usava quei blocchi di testo per mostrare l’avanzamento può quindi diventare silenziosa, anche se le richieste e le chiamate agli strumenti continuano ad andare a buon fine.
Vincitore per la compatibilità dell’integrazione: Claude Opus 5. Il codice esistente per Opus 5 richiede meno modifiche. Opus 5.5 prevale dopo che tali modifiche sono state implementate e validate.
Thinking di Claude Opus 5.5: ricalibrare effort, token e interfaccia
Il confronto più sicuro imposta esplicitamente l’effort, perché i valori predefiniti sono cambiati. Opus 5.5 parte da medium; per Opus 5 il valore predefinito era high. Anthropic afferma inoltre che 5.5 tende a dedicare più thinking a ogni turno a parità di effort, soprattutto con xhigh e max. Un test tra valori predefiniti misura l’esperienza fornita così com’è. Un test high contro high isola meglio le differenze tra i modelli.
Secondo la panoramica dei modelli di Anthropic, il modello dispone di una finestra di contesto da 1 milione di token e di un output massimo di 128,000 token. Thinking e testo visibile condividono il budget della risposta: bisogna quindi lasciare spazio sufficiente per completare il lavoro e registrare l’output fatturato, senza trattare l’etichetta dell’effort come se fosse un budget.
Utilizzo di Opus 5.5 vs Opus 5
Va acquisito l’intero oggetto usage, non soltanto la lunghezza della risposta visibile. Come minimo occorre conservare input non memorizzato nella cache, creazione della cache, letture dalla cache, output, latenza, chiamate agli strumenti, nuovi tentativi, motivo di arresto e risultato del validatore. I valori predefiniti devono restare separati dai test a effort equivalente, perché mescolare medium e high può far sembrare un vantaggio di costo una differenza di pura capacità.
La precedente analisi dell’effort dial di Opus 5 resta un riferimento storico utile per capire il significato dei livelli. La lezione per la migrazione è più circoscritta: non bisogna ereditare un vecchio livello o un’impostazione omessa senza ripetere il test sul carico di lavoro.
Vincitore sul controllo della spesa: risultato diviso. Opus 5 consente esplicitamente di disattivare il thinking. Opus 5.5 offre un valore predefinito e tariffe unitarie inferiori, ma il thinking è sempre attivo e va misurato.
Migrazione a Claude Opus 5.5: quanto costa davvero il passaggio
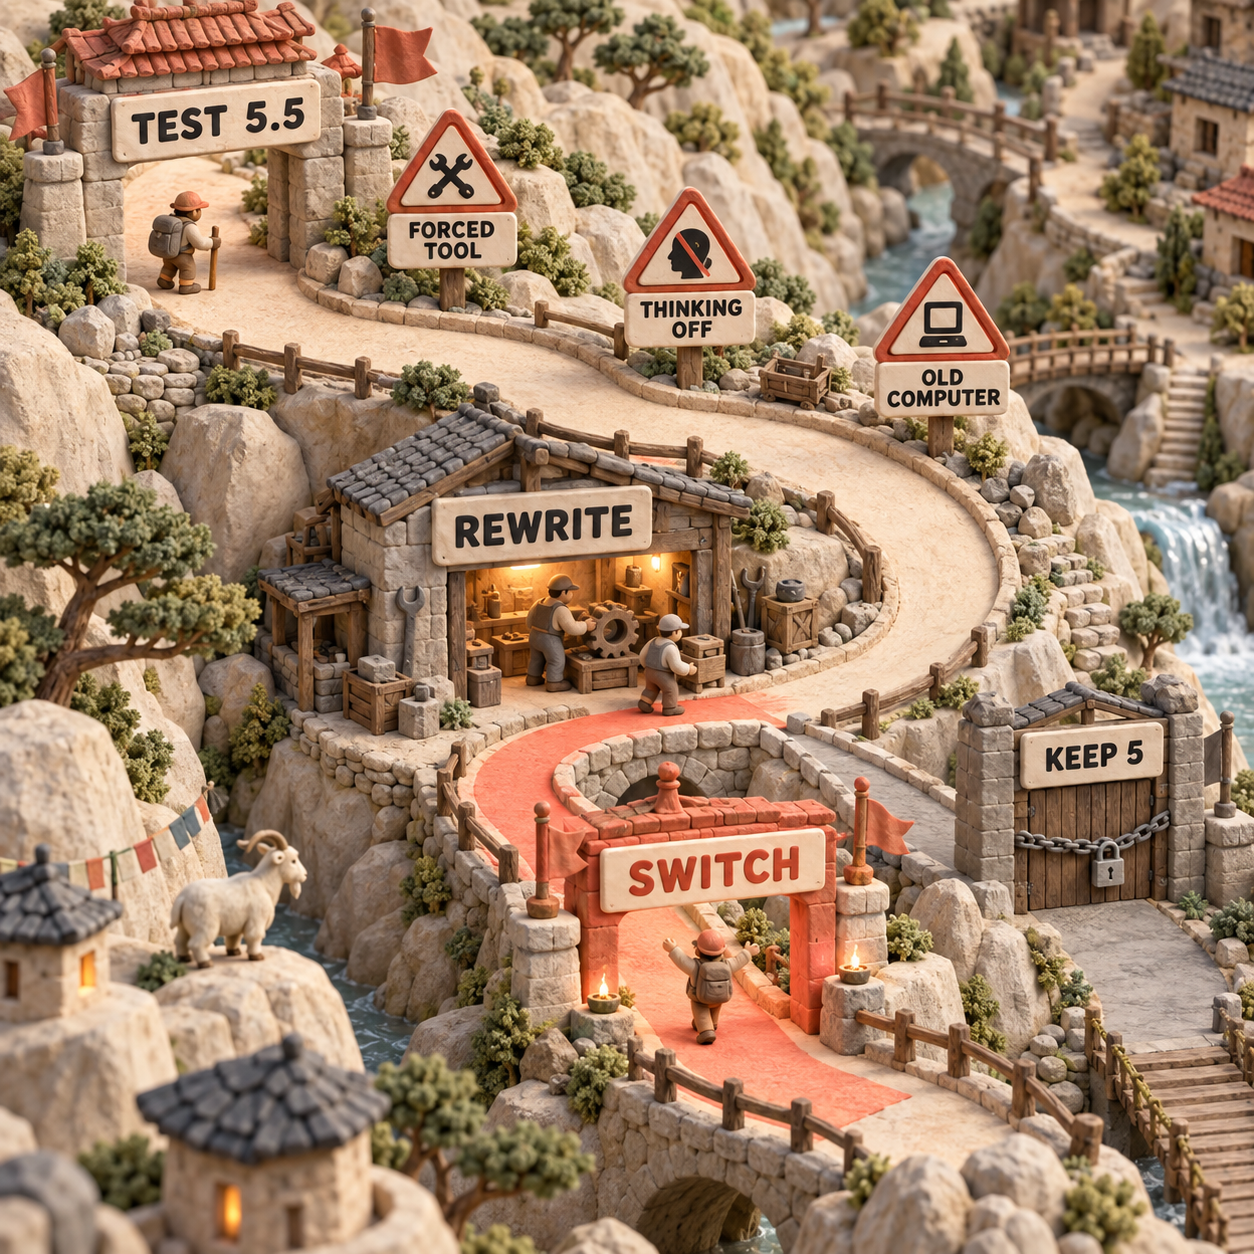
Il costo della migrazione risiede nel lavoro attorno alla chiamata del modello: audit delle richieste, modifiche al loop dell’agente, regole per il contesto conservato, rendering dello stream, valutazione e rollback. Sostituire la stringa del modello è sufficiente soltanto se la route usa già thinking adattivo, scelta automatica degli strumenti, un computer toolset supportato, cronologia in sola append e parsing dello stream sensibile ai tipi.
Non è ancora il momento di effettuare il passaggio se si verifica una di queste condizioni:
- Uno strumento specifico deve essere imposto a livello di API e il workflow non può adottare tool in modalità strict o output strutturati.
- Il contratto della route richiede che il thinking sia disattivato.
- Un agente di computer use nella Claude API o su Google Cloud usa ancora
computer_20251124e il suo loop non è ancora in grado di gestire il toolset. - L’applicazione riscrive messaggi precedenti o definizioni degli strumenti mentre riproduce thinking block conservati.
- Non esiste una base di riferimento per l’accettazione, quindi non è possibile distinguere un conto più basso da un lavoro di qualità inferiore.
Censire ogni struttura di richiesta per Opus 5
Cerca nella configurazione e nei builder delle richieste l’ID modello,
thinking,output_config.effort,tool_choice, i thinking block conservati e i tipi di computer tool. Controlla separatamente ogni cloud provider. Registra quale route gestisce il rollback.Eseguire due attività a parità di effort
Usa una riparazione circoscritta su codice pubblico, con test eseguibili, e un’estrazione sintetica con un validatore di schema deterministico. Invia a entrambi i modelli gli stessi prompt, strumenti e contesto, oltre a un effort
highe a un limite di output espliciti. Salva gli ID modello restituiti, l’utilizzo completo, la latenza, i risultati della validazione e ogni errore.Confrontare separatamente i valori predefiniti
Ripeti il test omettendo l’effort. In questo modo si isola Opus 5.5 con il valore predefinito
mediumda Opus 5 con il valore predefinitohighe si osserva l’effetto in produzione di una semplice modifica all’ID modello.Correggere i percorsi incompatibili
Elimina il thinking disattivato o con budget manuale, sostituisci la scelta forzata degli strumenti, migra il computer tool precedente dove necessario, conserva una cronologia in sola append e verifica il rendering dell’avanzamento. Mantieni ogni modifica visibile durante la revisione, senza nasconderla nell’upgrade del modello.
Portare in staging, misurare e promuovere
Indirizza verso 5.5 una quota limitata di lavoro rappresentativo. Confronta il costo per risultato accettato, non soltanto il prezzo per token. Promuovi una classe di attività solo quando il tasso di accettazione resta stabile o migliora e il costo totale scende; mantieni Opus 5 come rollback finché non termina il periodo di osservazione.
Un founder con capitali da investire può eseguire questo harness prima della prossima release del proprio agente. Un CTO dovrebbe trattarlo come una modifica al layer dei modelli, assegnando responsabilità per API, osservabilità e interfaccia di prodotto. Un responsabile operativo esperto dovrebbe aggiungere una revisione umana alle azioni irreversibili, indipendentemente dal vincitore. Chi sviluppa da solo può mantenere ridotta la valutazione, ma deve comunque salvare utilizzo e risultato del validatore, così da fondare la scelta sui dati anziché sulle sensazioni.
La mossa da fare lunedì
Lunedì prossimo, scegli un’attività Opus 5 costosa e ripetibile e crea una route ombra verso claude-opus-5-5. Esegui prima entrambi i modelli con effort high esplicito, quindi confronta i rispettivi valori predefiniti, ora diversi. Non modificare la produzione finché i controlli su strumenti forzati, thinking, computer, contesto conservato e stream di avanzamento non saranno tutti superati.
La decisione finale è semplice: adotta 5.5 quando il risultato accettato costa meno e il contratto d’integrazione continua a essere rispettato. Mantieni Opus 5 soltanto in presenza di un’incompatibilità precisa o di una regressione misurata. La generica preferenza per ciò che è già familiare non è un requisito di produzione.
Qual è la versione migliore di Claude Opus?
Claude Opus 5.5 è il punto di partenza migliore per i nuovi progetti, perché le tariffe standard e le letture dalla cache costano meno e i risultati pubblicati delle valutazioni sono superiori. Opus 5 va usato temporaneamente come opzione di compatibilità o rollback quando un’impostazione incompatibile dell’integrazione non è ancora stata migrata.
Claude Opus 5 è migliore di GPT 5.6 Sol?
Questo confronto dedicato alla migrazione tra due versioni non permette di stabilirlo. Una decisione tra vendor diversi richiede lo stesso harness, gli stessi strumenti e controlli dell’effort, gli stessi criteri per prezzi e accettazione su entrambi i vendor, non un punteggio copiato dalla pagina di un lancio.
Claude Opus 5 è davvero migliore?
Opus 5 non è la scelta predefinita migliore di Opus 5.5 per prezzo o nei confronti pubblicati da Anthropic. È preferibile soltanto come soluzione temporanea quando sono indispensabili il thinking disattivato, la selezione forzata di uno strumento o un’integrazione di computer use lasciata invariata.
Esiste qualcosa di migliore di Claude Opus?
Anthropic presenta Claude Fable 5.1 come modello a cui passare per attività di ragionamento complesse o di lungo periodo che continuano a non superare le valutazioni con Opus 5.5 a un effort superiore. Costa $10 per milione di token di input e $50 per milione di token di output, quindi dovrebbe risolvere un errore misurato anziché sostituire Opus per impostazione predefinita.
Perché Claude Opus costa così tanto?
Opus appartiene alla fascia premium di Anthropic per il lavoro, quindi la spesa è giustificata soltanto se evita abbastanza tentativi falliti, errori degli strumenti o revisione umana da superare il costo per risultato accettato di un modello più economico. Opus 5.5 riduce questo sovrapprezzo, ma non elimina la necessità di assegnare altrove i lavori semplici.
Fable è davvero migliore di Opus?
Non per ogni carico di lavoro. Fable è il percorso di escalation per un’attività che con Opus 5.5 non raggiunge la soglia di accettazione; il prezzo unitario superiore deve produrre su quella specifica attività un miglioramento misurabile.
Qual è la differenza di prezzo tra Opus 5 e Fable 5?
Claude Opus 5 costa $5 per milione di token di input e $25 per milione di token di output. Claude Fable 5 costa $10 e $50, esattamente il doppio delle tariffe standard.
Qual è la differenza tra Opus 5 e Fable 5?
Opus 5 è il modello premium per il lavoro dal costo inferiore, mentre Fable 5 è la fascia di escalation più costosa per le attività più difficili. La differenza pratica è se Fable supera un test di accettazione fallito da Opus con un margine sufficiente a coprire tariffe per token pari a 2x.
Opus 5 usa più token?
Non esiste un rapporto tra token valido in ogni caso. Anthropic afferma che Opus 5.5 usa meno token per un’attività tipica, ma può dedicare più thinking a ogni turno a parità di effort e il thinking non può essere disattivato. Occorre misurare l’intero utilizzo fatturato sullo stesso carico di lavoro accettato.
Ti serve una selezione più chiara dei modelli prima di investire una settimana nelle valutazioni? Consulta la mappa degli strumenti di IA per imprenditori.
- Ultimo aggiornamento
- 23 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Quale modello GPT-6 scegliere: Sol o Luna?
Confronta GPT-6 Sol e Luna per prezzi API, qualità nel coding e costi di revisione. Scopri quando conviene partire da Luna e quando passare a Sol.23 set 2026AI
GPT-6 Luna gratis: dove usarlo e quanto costa davvero
GPT-6 Luna è gratis nell’app desktop per gli utenti Free e Go. Scopri dove funziona, quali piani lo includono e quanto costa davvero usare l’API.22 set 2026AI
MiMo AI V2.6: dalla prova in Studio alla prima API
Scopri come provare MiMo AI V2.6 in Studio, configurare chiavi e API corrette e portare in produzione un primo flusso di lavoro verificabile.22 set 2026AI
AI per programmare: MiMo V2.6 Pro o Flash?
Confronto tra MiMo V2.6 Pro e Flash per coding, agenti e UI: prezzi, benchmark e una regola pratica per scegliere il modello più conveniente.22 set 2026AI
MiMo V2.6 gratis? Accessi, licenza e costi reali
MiMo V2.6 è gratis solo in alcuni casi: ecco cosa offre OpenCode, cosa copre la licenza MIT e quanto costano le API Flash, Pro e UltraSpeed.22 set 2026AI
Grok API: confronto tra Grok 4.7 e Grok 4.6
Grok API, confronto tra Grok 4.7 e 4.6: benchmark, prezzi, limiti e un test in tre attività per scegliere il modello giusto senza migrazioni alla cieca.21 set 2026AI
Agenti AI in produzione: quando le metriche premiano il fallimento
Un caso reale mostra come gli agenti AI possano superare ogni controllo e mancare l’obiettivo: numeri, cause e guardrail per fermare la deriva.21 set 2026AI