Claude Opus 5.5, Opus 5에서 갈아탈 때인가
Claude Opus 5.5와 Opus 5의 가격, 코딩 근거, API 호환성, thinking 설정을 비교합니다. 토큰 비용표와 5가지 마이그레이션 위험을 바탕으로 어떤 워크로드를 옮겨야 할지, 전환 전에 무엇을 검증해야 할지 한눈에 빠르게 확인하세요.


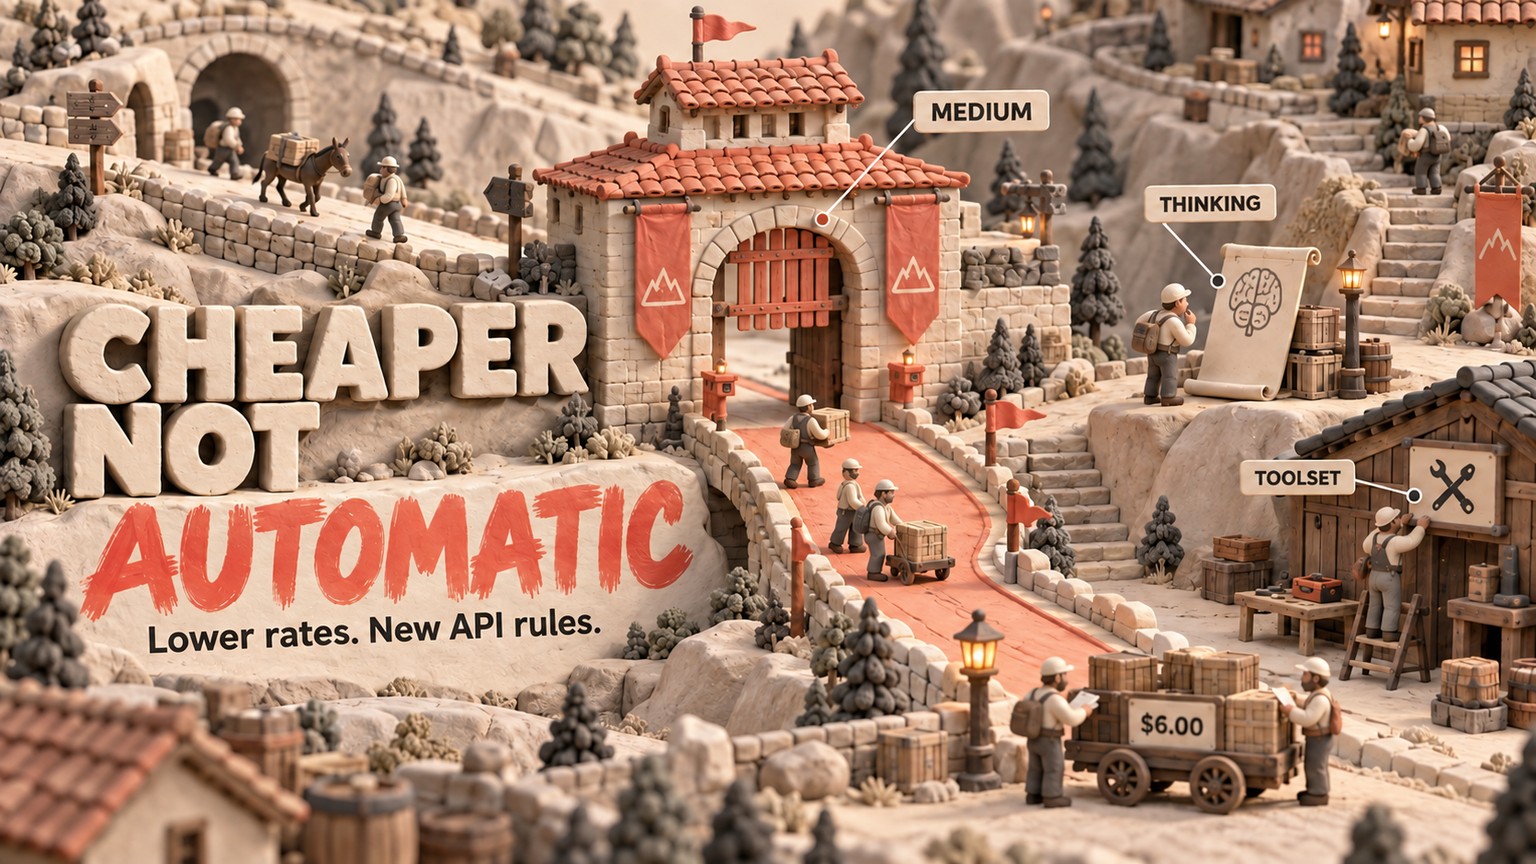
대부분의 Opus 5 워크로드라면 먼저 검증할 업그레이드는 Claude Opus 5.5입니다. 캐시 미적용 입력 100만 토큰과 청구 대상 출력 100,000토큰을 합친 비용이 $7.50에서 $6.00으로 내려갑니다. 다만 Claude Opus 5.5와 Opus 5 중 무엇을 선택할지는 5가지 통합 변경 사항에 달려 있습니다. 더 저렴해졌어도 모든 에이전트에 그대로 교체할 수 있는 모델은 아니기 때문입니다.
Claude Opus 5.5 비교: Opus 5에서 바꿔야 할까?
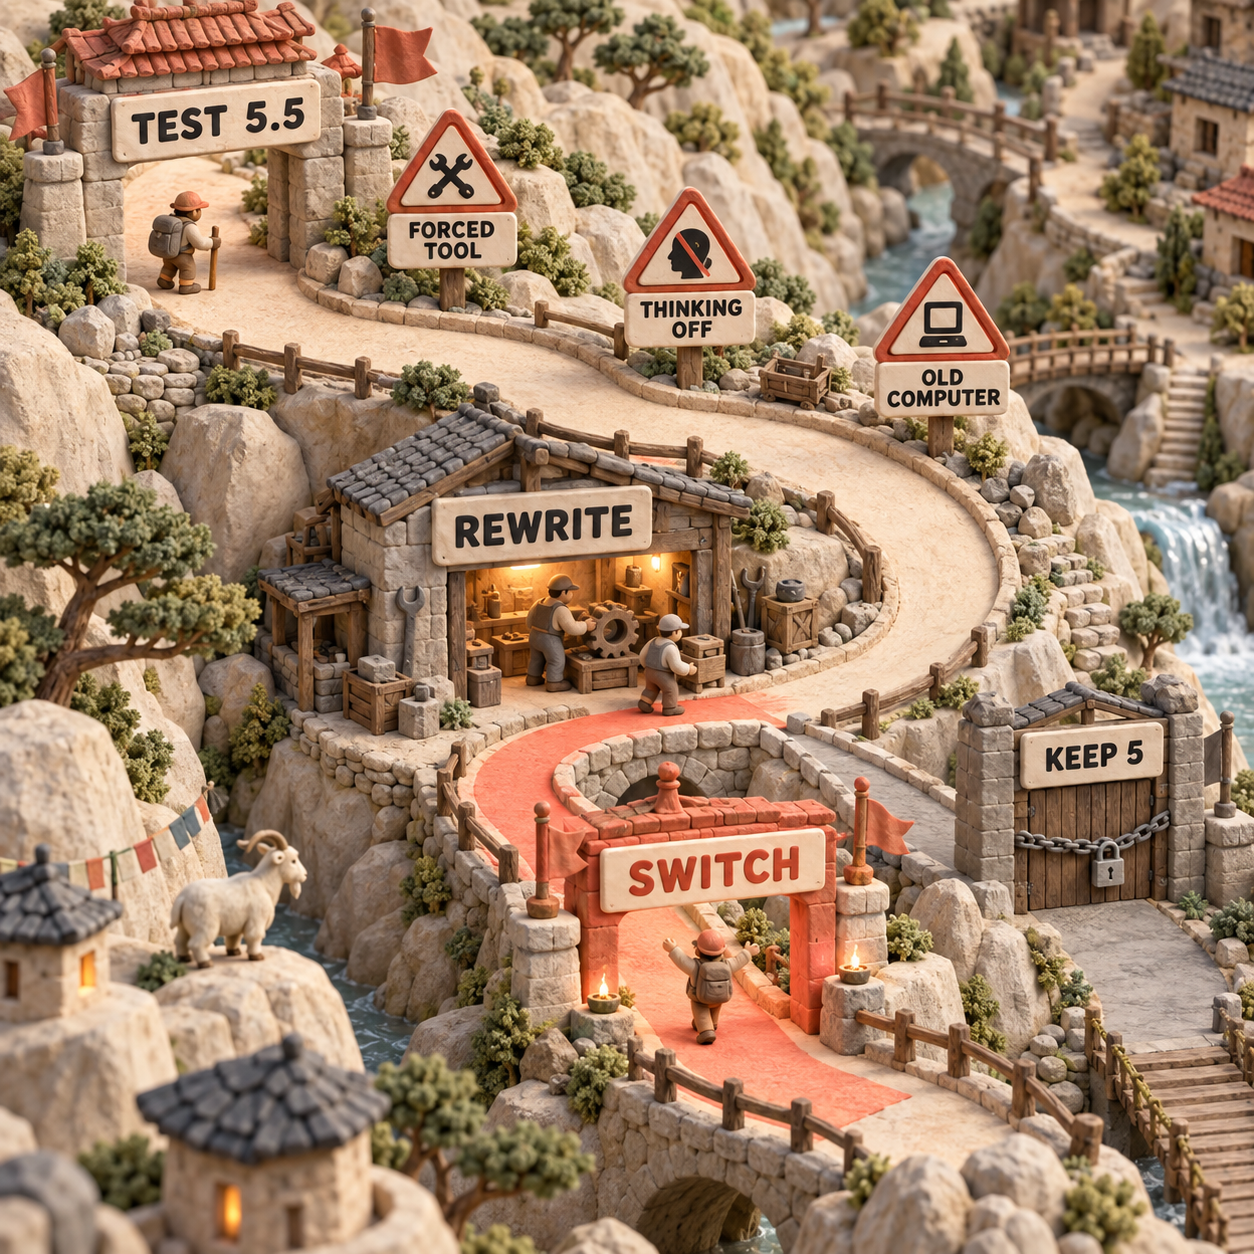
새로운 고성능 작업에는 Claude Opus 5.5를 선택하고, 기존 Opus 5 경로 대부분에서도 대체 모델로 검증하는 편이 좋습니다. 반면 통합 코드가 thinking을 끄거나 특정 툴을 강제로 지정하는 경우, 또는 Claude API나 Google Cloud에서 이전 computer 툴을 계속 쓰는 경우에는 당분간 Opus 5를 유지해야 합니다. 이는 모델 취향의 미세한 차이가 아니라 코드 경로가 실제로 작동하느냐의 문제입니다.
코딩 에이전트 지출이 커서 캐시 읽기 비용과 재시도가 실질적인 부담이 되는 투자 유치 창업자라면 Claude Opus 5.5가 유리합니다. 중견 기업 CTO도 플랫폼 팀이 요청 형식 변경을 정리한 뒤에는 5.5를 우선해야 합니다. 범위가 명확한 추출 작업을 운영하는 시니어 실무자라면 더 낮은 요금의 Claude Sonnet 5로도 합격 기준을 넘는지 먼저 확인하는 편이 낫습니다. 1인 기술 창업자는 어려운 저장소 작업만 5.5로 옮기고, 단순한 작업은 아예 Opus 밖으로 빼는 것이 효율적입니다.
마이그레이션 작업 비용이 예상 절감액보다 크고 기존 경로가 이미 안정적이라면 판단은 다시 Opus 5 쪽으로 기웁니다. 이는 일시적인 호환성 우위일 뿐, 새 개발을 구형 모델로 시작할 이유는 아닙니다.
Anthropic은 2026년 9월 22일 Opus 5.5를 출시했습니다. 현재 모델 가이드도 결정을 내리지 못한 개발자에게 대부분의 워크로드는 Opus 5.5부터 시작하라고 안내합니다. 이전 모델은 마이그레이션 중 롤백 대상으로 여전히 쓸모가 있습니다.
Claude Opus 5.5 가격: Opus 5와 얼마나 차이 날까?
동일한 표준 토큰 사용량이라면 Claude Opus 5.5가 모든 구간에서 더 저렴합니다. 2026년 9월 23일 Anthropic의 실시간 가격 문서에서 확인한 요금은 5.5가 입력 100만 토큰당 $4, 출력 100만 토큰당 $20입니다. Opus 5는 각각 $5와 $25입니다. 정가 기준 20% 인하입니다. 캐시 읽기는 재사용하는 프롬프트 콘텐츠를 뜻하며, 100만 토큰당 요금이 $0.50에서 $0.20으로 내려가 60% 절감됩니다.
더 작은 단위로 보면 캐시 미적용 입력 1,000토큰의 비용은 5.5가 $0.004, 5가 $0.005입니다. 출력은 1,000토큰당 각각 $0.020과 $0.025입니다. 이 API 비교에서는 좌석당 월 요금이나 이미지당 고정 요금 때문에 손익분기점이 생기지 않습니다. 청구액은 토큰을 따라가므로 청구 대상 토큰 구성이 같다면 5.5가 더 비싸지는 구간은 없습니다.
캐시 미적용 계산은 단순합니다. Opus 5는 입력 $5와 출력 $2.50을 합산합니다. Opus 5.5는 입력 $4와 출력 $2를 합산합니다. 워밍업이 끝난 캐시 계산에는 캐시 미적용 입력 100,000토큰, 캐시 읽기 900,000토큰, 출력 100,000토큰을 반영했습니다. 캐시 생성, 툴, 재시도, 배치 할인, fast mode, 데이터 레지던시 배수는 의도적으로 제외했습니다.
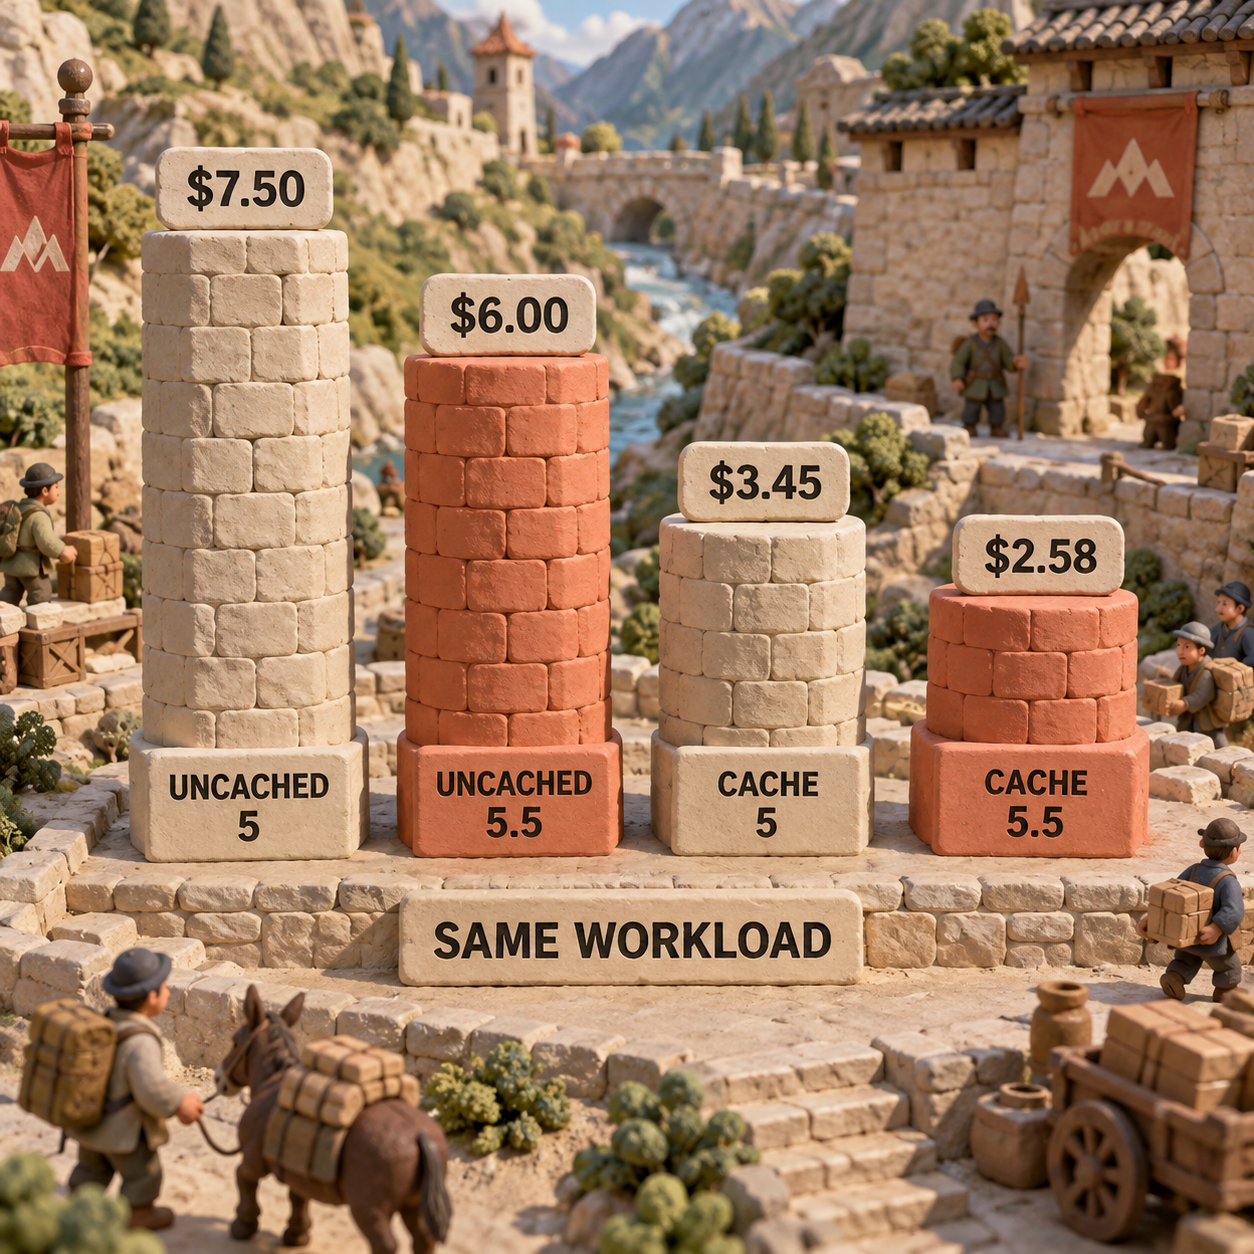
5.5가 일반적인 워크로드에서 40% 더 저렴하다는 Anthropic의 별도 주장은 정가를 다시 계산한 값이 아니라 벤더 측 측정치입니다. Anthropic은 기본 설정에서 낮아진 요금과 작업당 토큰 감소가 함께 작용한다고 설명합니다. 모든 견적에 40% 할인을 일괄 적용하지 말고, 이 주장은 고정 토큰 계산표와 구분해서 봐야 합니다.
실제로 봐야 할 손익분기점은 토큰 사용 행태입니다. 캐시 미적용 계산에서 5.5는 출력 토큰이 175,000개, 즉 Opus 5 기준인 100,000개보다 75% 많아져야 청구액이 같은 $7.50에 도달합니다. 워밍업된 캐시에서는 출력 토큰이 143,500개, 즉 43.5% 더 많아져야 $3.45와 같아집니다. 결과 품질 개선 없이 마이그레이션 후 이 한도를 넘는다면 낮은 단가의 이점은 사라진 것입니다.
가격 승자: Claude Opus 5.5. 사용량이 같을 때의 요금 우위에는 조건이 없습니다. 다만 실제 워크로드에서의 우위는 토큰 사용량과 재시도를 측정한 뒤에도 유지돼야 합니다.
Claude Opus 5.5 코딩 성능: 공개 근거가 말해 주는 범위
문서로 확인할 수 있는 코딩 근거는 Claude Opus 5.5 쪽이 더 강합니다. 그러나 이 비교를 위해 모델 시험을 직접 실행하지는 않았습니다. 실행용 인증 정보가 없었으므로, 이 작업에서 저장소 수정이나 추출 과제를 수행했다거나 반환된 모델 ID, 지연 시간, 검증 결과를 확인했다는 주장은 하지 않습니다.
Claude Opus 5.5와 Opus 5 리뷰: 근거의 경계
Anthropic의 출시 평가에서 기본 medium effort를 사용한 Opus 5.5는 Cursor 세션에서 가져온 모호한 멀티파일 코딩 과제 시험인 CursorBench 4.0에서 52.5%를 기록했습니다. Opus 5는 max에서 46.6%였습니다. Anthropic은 출력 생성 속도도 30% 이상 빨라졌다고 보고합니다. 평가 우선순위를 정할 근거로는 유용하지만, effort 설정이 서로 달랐고 비교를 실행한 주체도 벤더입니다.
AutomationBench에서는 별도로 측정된 신호를 볼 수 있습니다. Anthropic의 출시 각주에 따르면 Zapier가 벤치마크를 실행하고 결과를 보고했으며, Opus 5.5는 40.0%, Opus 5는 26.9%를 기록했습니다. 이 시험은 연결된 앱 워크플로를 다룰 뿐 모든 코드베이스나 비즈니스 프로세스를 대변하지 않습니다. 또한 각자의 권한 모델, 툴, 검증기가 어떻게 동작할지는 알려 주지 않습니다.
코딩 에이전트는 실행 전에 합격 조건부터 정해야 합니다. 테스트를 통과하고, diff가 범위를 벗어나지 않으며, 리뷰에서 수정 작업이 발견되지 않아야 합니다. 추출 작업이라면 정확한 스키마, 출처에 근거한 값, 결정론적 검증기를 요구해야 합니다. 이후 입력 토큰, 캐시 토큰, 출력 토큰, 지연 시간, 툴 호출, 재시도, 실패를 기록합니다. 자체 하네스가 거부되는 결과를 더 많이 만든다면 높은 벤치마크 점수도 비용을 대신 내주지 않습니다.
공개된 코딩 근거의 승자: Claude Opus 5.5. 통제된 평가를 시작할 근거로는 충분히 강하지만, 검증 없이 프로덕션을 한 번에 전환할 근거는 아닙니다.
Claude Opus 5.5 API: 그대로 교체하면 깨지는 5가지 변경점
모델 문자열을 바꾸는 일보다 먼저 확인해야 할 통합 항목이 5가지 있습니다. Anthropic의 최신 Opus 5.5 변경 문서는 요청을 깨뜨리는 변경 4가지와 인터페이스에서 조용히 실패할 수 있는 응답 형식 변경 1가지를 명시합니다.
1. Thinking을 끌 수 없습니다
Opus 5.5는 항상 adaptive thinking을 사용합니다. thinking:{"type":"disabled"}를 담은 요청은 HTTP 400을 반환합니다. thinking:{"type":"enabled","budget_tokens":N}으로 thinking 예산을 직접 지정해도 마찬가지입니다. 해당 필드를 생략하거나 adaptive thinking을 보내고, output_config.effort로 사고 깊이를 조절해야 합니다.
Opus 5는 high 이하의 effort에서 thinking 비활성화를 허용했습니다. 이 스위치를 전제로 만든 안정적인 저지연 경로라면 모델 ID만 바꾸는 것이 아니라 설계를 다시 해야 합니다.
2. 툴을 강제로 선택하면 오류가 발생합니다
Opus 5.5는 tool_choice를 any 또는 특정 tool로 지정한 요청을 거부하며, 이때도 HTTP 400을 반환합니다. auto와 none은 계속 지원합니다. 스키마에 맞는 출력을 얻으려면 Anthropic은 auto와 함께 strict tool use를 사용하거나 structured outputs를 사용할 것을 권장합니다.
이는 계약 수준의 중요한 변경입니다. 프롬프트에서 모델에게 툴 호출을 지시하는 것과 API가 선택을 강제하는 것은 같은 메커니즘이 아닙니다. 워크플로에서 함수 하나가 반드시 실행돼야 한다면 트래픽을 전환하기 전에 대체 경로를 검증해야 합니다.
3. Thinking 블록은 모델과 대화에 귀속됩니다
Thinking 블록은 툴 사용 턴 사이에서 모델의 추론을 보존하는 응답 레코드입니다. Opus 5.5는 Opus 5가 만든 블록을 읽을 수 있으므로, 이전 추론을 버리지 않고 append-only 대화를 이어 갈 수 있습니다. 다만 5.5가 모든 모델의 블록을 읽을 수 있는 것은 아니며, 이후 시스템 프롬프트·툴·이전 메시지를 수정하면 5.5가 보존한 thinking이 무효화될 수 있습니다.
2026년 8월 31일 00:00 UTC 이후 생성된 API 계정에서는 이러한 prefix 변경 후 귀속된 블록을 다시 재생하면 기본적으로 HTTP 400이 반환됩니다. 대화 기록은 append-only로 유지해야 합니다. 애플리케이션이 과거 턴을 수정하거나 툴 정의를 제자리에서 바꾼다면 Anthropic이 문서화한 binding controls를 적용하고 drop 동작을 명시적으로 시험해야 합니다.
4. Computer use는 플랫폼마다 다릅니다
Claude API와 Google Cloud에서 Opus 5.5는 이전 computer_20251124 툴을 거부하고 computer_toolset_20260801을 요구합니다. 바뀌는 것은 타입 문자열뿐이 아닙니다. 에이전트 루프가 멤버 tool_use 블록, batch actions, 결과의 toolset_name을 처리해야 합니다. Anthropic의 computer use 문서에 따르면 Amazon Bedrock에서는 5.5에서도 이전 툴을 계속 허용합니다.
이런 플랫폼 차이 때문에 같은 멀티클라우드 배포에서도 한쪽은 통과하고 다른 쪽은 오류를 반환할 수 있습니다. 제공업체와 요청 본문을 한 묶음으로 점검해야 합니다.
5. 오류 없이 진행 문구가 사라질 수 있습니다
Opus 5.5는 툴 호출 사이의 짧은 안내를 일반 text 블록이 아니라 진행 업데이트용 thinking 블록으로 반환합니다. 기본값인 display:"omitted"에서는 thinking 텍스트가 비어 있습니다. 이 text 블록으로 진행 상황을 보여 주던 인터페이스는 요청과 툴 호출이 정상적으로 이어지는 중에도 조용해질 수 있습니다.
통합 호환성 승자: Claude Opus 5. 기존 Opus 5 코드에 필요한 변경이 더 적습니다. 변경을 적용하고 검증한 뒤에는 Opus 5.5가 우위입니다.
Claude Opus 5.5 Thinking: effort·토큰·UI 동작을 다시 맞추는 법
기본값이 달라졌으므로 가장 안전한 비교 방법은 effort를 명시하는 것입니다. Opus 5.5의 기본값은 medium, Opus 5의 기본값은 high였습니다. Anthropic에 따르면 5.5는 같은 effort에서도 턴마다 더 많이 생각하는 경향이 있으며, 특히 xhigh와 max에서 두드러집니다. 기본값끼리 비교하면 실제 제공 경험을 측정할 수 있고, high 대 high로 비교하면 모델 자체의 차이를 더 많이 분리해 볼 수 있습니다.
Anthropic의 모델 개요에 따르면 이 모델의 컨텍스트 윈도는 100만 토큰이고 최대 출력은 128,000토큰입니다. Thinking과 사용자에게 보이는 텍스트가 응답 예산을 함께 사용하므로, 답변을 마칠 여유를 충분히 남기고 effort 라벨을 예산처럼 간주하지 말고 실제 청구 출력을 기록해야 합니다.
Claude Opus 5.5 사용량과 Opus 5 비교
눈에 보이는 응답 길이만 보지 말고 전체 usage 객체를 수집해야 합니다. 최소한 캐시 미적용 입력, 캐시 생성, 캐시 읽기, 출력, 지연 시간, 툴 호출, 재시도, stop reason, 검증 결과를 보관합니다. medium과 high를 섞으면 비용 우위가 순수한 성능 우위처럼 보일 수 있으므로 기본값과 같은 effort의 결과를 분리해야 합니다.
각 단계가 무엇을 뜻하는지는 이전 Opus 5 effort dial 분석이 유용한 배경을 제공합니다. 마이그레이션에서 얻을 교훈은 더 간단합니다. 기존 단계나 생략된 설정을 그대로 물려받지 말고 워크로드를 다시 실행해야 합니다.
지출 제어의 승자: 목적에 따라 다릅니다. Opus 5는 thinking을 명시적으로 끌 수 있습니다. Opus 5.5는 기본 effort와 단가가 더 낮지만 thinking이 항상 작동하므로 측정이 필요합니다.
Claude Opus 5.5 마이그레이션: 전환에 실제로 드는 비용
마이그레이션 비용은 모델 호출 주변에서 발생합니다. 요청 점검, 에이전트 루프 변경, 보존된 컨텍스트 규칙, 스트림 렌더링, 평가, 롤백이 모두 포함됩니다. 이미 adaptive thinking과 자동 툴 선택, 지원되는 computer toolset, append-only 기록, 타입을 구분하는 스트림 파싱을 사용하는 경로에 한해서만 모델 문자열 교체로 충분합니다.
다음 조건 중 하나라도 해당하면 아직 전환하지 않는 편이 좋습니다.
- API 계층에서 특정 툴을 강제해야 하며 워크플로를 strict tools나 structured output으로 옮길 수 없습니다.
- 해당 경로의 계약상 thinking을 반드시 꺼야 합니다.
- Claude API 또는 Google Cloud의 computer 에이전트가 아직
computer_20251124를 사용하고, 에이전트 루프도 새 toolset을 처리할 수 없습니다. - 애플리케이션이 보존된 thinking 블록을 재생하면서 이전 메시지나 툴 정의를 다시 작성합니다.
- 합격 기준선이 없어 청구액 감소와 결과 품질 저하를 구분할 수 없습니다.
모든 Opus 5 요청 형식을 목록화합니다
설정과 요청 빌더에서 모델 ID,
thinking,output_config.effort,tool_choice, 보존된 thinking 블록, computer 툴 타입을 검색합니다. 클라우드 제공업체별로 따로 확인합니다. 어느 경로가 롤백을 담당하는지도 기록합니다.같은 effort로 2개 과제를 실행합니다
실행 가능한 테스트가 있는 범위 제한 공개 코드 수정 과제와, 결정론적 스키마 검증기를 둔 합성 추출 과제를 사용합니다. 두 모델에 같은 프롬프트, 툴, 컨텍스트, 명시적인
higheffort, 명시적인 출력 한도를 적용합니다. 반환된 모델 ID, 전체 사용량, 지연 시간, 검증 결과, 모든 실패를 저장합니다.기본값은 별도로 비교합니다
effort를 생략한 채 다시 실행합니다. 이렇게 하면
medium이 기본인 Opus 5.5와high가 기본인 Opus 5를 분리해 비교할 수 있으며, 단순한 모델 ID 변경이 프로덕션에서 만들 효과를 확인할 수 있습니다.호환되지 않는 경로를 수정합니다
비활성화 또는 수동 예산 방식의 thinking을 제거하고, 강제 툴 선택을 교체하며, 필요한 곳에서는 이전 computer 툴을 마이그레이션합니다. 기록을 append-only로 유지하고 진행 표시 렌더링도 시험합니다. 각 변경 사항을 모델 업그레이드 안에 숨기지 말고 리뷰에서 보이게 남겨야 합니다.
스테이징에서 측정한 뒤 승격합니다
대표 작업 중 범위가 제한된 일부를 5.5로 라우팅합니다. 토큰 가격만이 아니라 합격 결과당 비용을 비교합니다. 합격률이 유지되거나 개선되고 총비용이 내려간 작업 유형만 승격하며, 관찰 기간이 끝날 때까지 Opus 5를 롤백 대상으로 유지합니다.
투자 유치를 마친 창업자라면 다음 에이전트 릴리스 전에 이 하네스를 실행할 수 있습니다. CTO는 API, 관측 가능성, 제품 UI 담당자를 지정한 모델 계층 변경으로 다뤄야 합니다. 시니어 실무자는 승자가 어느 쪽이든 되돌릴 수 없는 작업에 사람의 검토를 추가해야 합니다. 1인 개발자는 평가 범위를 작게 유지하되, 선택이 감이 아니라 근거에 기반하도록 사용량과 검증 결과는 반드시 저장해야 합니다.
월요일에 바로 할 일
다음 월요일, 비용이 많이 들면서 반복 가능한 Opus 5 작업 하나를 골라 claude-opus-5-5로 보내는 섀도 경로를 만듭니다. 먼저 두 모델을 명시적 high effort로 실행한 뒤, 달라진 기본값끼리 비교합니다. 강제 툴, thinking, computer, 보존된 컨텍스트, 진행 스트림 검사가 모두 통과하기 전에는 프로덕션을 건드리지 않습니다.
최종 판단은 간단합니다. 합격한 결과의 비용이 낮아지고 통합 계약이 그대로 유지될 때 5.5를 도입합니다. 구체적인 비호환 항목이나 측정된 성능 저하가 있을 때만 Opus 5를 유지합니다. 익숙하다는 막연한 선호는 프로덕션 요구사항이 아닙니다.
어떤 Claude Opus 버전을 선택하는 것이 좋나요?
표준 요금과 캐시 읽기 비용이 더 낮고 공개 평가도 더 강하므로 새 작업은 Claude Opus 5.5에서 시작하는 편이 좋습니다. 아직 마이그레이션하지 못한 통합 설정이 있다면 Opus 5를 임시 호환 경로나 롤백 경로로 사용합니다.
Claude Opus 5가 GPT 5.6 Sol보다 좋은가요?
이 두 Opus 버전의 마이그레이션 비교만으로는 판단할 수 없습니다. 벤더 한 곳의 출시 점수를 가져오는 대신 두 벤더에 같은 하네스, 툴, effort 제어, 가격, 합격 기준을 적용해야 합니다.
Claude Opus 5가 더 좋은 선택인가요?
가격이나 Anthropic이 공개한 비교를 기준으로 보면 Opus 5는 Opus 5.5보다 나은 기본 선택이 아닙니다. Thinking 비활성화, 강제 툴 선택, 변경하지 않은 computer 통합이 꼭 필요한 경우에만 일시적으로 더 나은 선택입니다.
Claude Opus보다 더 나은 모델도 있나요?
Anthropic은 더 높은 effort에서도 Opus 5.5 평가를 통과하지 못하는 까다로운 추론이나 장기 작업을 위한 상위 모델로 Claude Fable 5.1을 배치합니다. 입력 100만 토큰당 $10, 출력 100만 토큰당 $50이므로 기본 모델로 Opus를 대체하기보다 측정된 실패를 해결할 때 써야 합니다.
Claude Opus는 왜 이렇게 비싼가요?
Opus는 Anthropic의 프리미엄 작업 티어입니다. 실패한 시도, 툴 오류, 사람의 검토를 충분히 줄여 더 저렴한 모델보다 합격 결과당 비용이 낮아질 때만 높은 요금이 정당화됩니다. Opus 5.5는 그 프리미엄을 낮췄지만, 단순한 작업을 다른 모델로 라우팅할 필요까지 없애지는 않습니다.
Fable은 정말 Opus보다 좋은가요?
모든 워크로드에서 그렇지는 않습니다. Fable은 Opus 5.5로 합격 기준을 넘지 못한 과제를 위한 상위 경로입니다. 더 높은 단가를 감당할 만큼 그 과제에서 측정 가능한 개선을 만들어야 합니다.
Opus 5와 Fable 5의 가격 차이는 얼마인가요?
Claude Opus 5는 입력 100만 토큰당 $5, 출력 100만 토큰당 $25입니다. Claude Fable 5는 각각 $10과 $50으로, 표준 요금이 정확히 2배입니다.
Opus 5와 Fable 5는 무엇이 다른가요?
Opus 5는 더 저렴한 프리미엄 작업 모델이고, Fable 5는 가장 어려운 과제를 위한 고가의 상위 티어입니다. 실제 차이는 Fable이 Opus가 실패한 합격 검증을 통과하고, 그 개선 폭으로 2x 토큰 요금을 상쇄하느냐에 달려 있습니다.
Opus 5가 토큰을 더 많이 사용하나요?
모든 작업에 적용되는 보편적인 토큰 비율은 없습니다. Anthropic은 Opus 5.5가 일반적인 작업에서 토큰을 덜 쓴다고 설명하지만, 같은 effort에서도 턴당 thinking이 늘어날 수 있고 thinking을 끌 수도 없습니다. 같은 합격 워크로드에서 전체 청구 사용량을 측정해야 합니다.
평가에 일주일을 쓰기 전에 후보 모델부터 간결하게 추리고 싶다면 비즈니스 오너를 위한 AI 툴 맵을 확인하세요.
- 마지막 업데이트
- 2026년 9월 23일
- 카테고리
- AI
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

GPT-6 Sol Luna 비교: 20× 가격 차이를 넘는 선택 기준
GPT-6 Sol Luna 비교를 가격, 코딩 성능, 컨텍스트, 툴 지원 기준으로 정리합니다. 동일 작업 100건의 20× 비용 차이를 계산하고, 검증 가능한 반복 작업은 Luna로 처리하며 고난도 코딩과 에이전트 작업만 Sol로 올리는 라우팅 기준과 평가 절차를 설명합니다.2026년 9월 23일AI
GPT-6 Luna 무료 사용 조건과 API 가격 총정리
GPT-6 Luna 무료 이용은 Free·Go 계정의 데스크톱 앱에 한정됩니다. 유료 Work·Codex, 일반 Chat, 별도 과금 API의 차이와 토큰 가격, 공개되지 않은 사용 한도, 도입 전에 확인할 실무 항목과 평가 방법까지 한눈에 정리했습니다.2026년 9월 22일AI
MiMo V2.6 사용법: API로 첫 업무 워크플로 만들기
MiMo V2.6을 Studio에서 검증하고 Xiaomi API에 연결하는 과정을 단계별로 설명합니다. Flash·Pro 선택, 키와 base URL 설정, Python 요청, 비용 계산, 문제 해결, 안전한 실무 워크플로 설계까지 한 번에 확인하세요.2026년 9월 22일AI
MiMo V2.6 비교: Pro와 Flash, 무엇을 선택해야 할까?
MiMo V2.6 Pro와 Flash의 코딩·에이전트 성능, 토큰 가격, 캐시 절감 효과를 비교합니다. 같은 작업을 두 모델로 평가하고 수락된 완료 1건당 비용을 계산하는 방법, Flash를 기본값으로 두고 Pro로 승격해야 할 조건, UltraSpeed가 필요한 시점까지 확인하세요.2026년 9월 22일AI
MiMo V2.6 무료 사용 가이드: OpenCode·API·MIT의 차이
MiMo V2.6을 무료로 쓸 수 있는 경로와 한계를 정리했습니다. OpenCode의 일주일 프로모션, MIT 체크포인트, Xiaomi API 가격과 데이터 정책을 비교해 체험·유료 전환·셀프 호스팅 중 무엇이 맞는지 판단해 보세요. 실제 비용과 주의점도 함께 확인하세요.2026년 9월 22일AI
Grok 4.7 비교: Grok 4.6보다 나을까?
Grok 4.7과 Grok 4.6의 코딩 성능, API 요금, 컨텍스트와 전환 비용을 같은 기준으로 비교합니다. 어떤 작업을 4.7로 옮기고 무엇을 4.6에 남겨야 하는지, 벤치마크의 한계와 장문 컨텍스트 비용, 실제 업무 테스트 방법까지 확인하세요.2026년 9월 21일AI
AI 에이전트 스펙 게이밍: 모든 검사를 통과한 실패
모든 검사를 통과한 AI 에이전트가 수요 없는 공예 소프트웨어 글을 쏟아낸 실제 운영 사례를 분석합니다. 스펙 게이밍을 만든 검색 승인 기준, 의무 출력량, 재시도 루프를 짚고 무작업 허용, 범위 경계, 사람 승인으로 가드레일을 다시 설계하는 방법을 설명합니다.2026년 9월 21일AI