Agente de voz IA: o custo real de uma ligação com GPT-Live-1
Entenda o custo real de um agente de voz IA com GPT-Live-1: $0.05 por minuto, mais raciocínio no backend, ferramentas e telefonia por chamada.



Para um agente de voz IA, o GPT-Live-1 torna uma parcela da ligação fácil de calcular: a sessão de voz custa $0.05 por minuto. Desde 10 de setembro de 2026, as equipes podem simplificar o ciclo de fala e escuta, mas o número que realmente importa para o orçamento continua sendo o custo total de uma chamada resolvida — incluindo raciocínio no backend, ferramentas e transporte telefônico.
No agente de voz IA, os cinco centavos cobrem apenas a voz
O GPT-Live-1 é um modelo de voz full-duplex. Na prática, isso significa que ele consegue ouvir enquanto fala. Assim, quem liga pode interromper, fazer uma pausa, corrigir um detalhe ou dar uma resposta curta sem esperar o fim de um turno rígido.
Isso muda a arquitetura do sistema. Um agente de voz tradicional costuma encadear reconhecimento de fala, um modelo de linguagem e síntese de voz. Cabe à aplicação transportar informações entre cada etapa e decidir o que fazer quando as duas partes falam ao mesmo tempo.
O GPT-Live-1 concentra a conversa em tempo real em uma única camada de voz. Ele ouve, fala, acompanha o tempo e decide quando uma tarefa mais complexa deve seguir para o backend. Esse backend pode consultar uma reserva, ler o cadastro de uma conta, acionar uma ferramenta ou interpretar uma política.
O backend é separado por escolha de projeto. É possível usar delegação via Responses, em que o GPT-Live-1 encaminha o trabalho a um modelo de texto da OpenAI configurado por você, ou delegação no cliente, em que a própria aplicação executa qualquer modelo, agente ou serviço e devolve o resultado. A voz permanece a mesma, enquanto você escolhe um cérebro mais econômico ou mais sofisticado para cada tarefa.
A conexão telefônica também é cobrada à parte. Uma chamada recebida pode chegar ao GPT-Live-1 por um tronco SIP — a conexão via internet fornecida por uma operadora de telefonia — ou por uma aplicação que retransmite o áudio. A OpenAI cuida da sessão Live. Sua operadora continua responsável pelo número e pelo transporte telefônico.
Essa é a mudança completa no orçamento. Nesse fluxo, deixa de ser necessário calcular o reconhecimento e a geração de voz como duas etapas distintas de modelos da OpenAI. Ainda assim, há três contas que precisam permanecer separadas.
A conta tem três componentes
A primeira armadilha está no relógio. A cobrança do GPT-Live-1 acompanha a sessão ativa desde o início até o encerramento. O silêncio conta. O tempo de espera por uma ferramenta conta. Silenciar o microfone não interrompe a cobrança.
A segunda armadilha é tratar o backend como gratuito só porque ele roda nos bastidores da conversa. Não é. Nos contextos curtos padrão, a tabela de preços do GPT-5.6 Luna é de $0.20 por milhão de tokens de entrada e $1.20 por milhão de tokens de saída. No GPT-5.6 Terra, os valores são $2.00 e $12.00. No GPT-6 Astra, $10.00 e $50.00. A comparação certa não é qual modelo cobra menos por token, mas qual combinação conclui a tarefa de forma confiável, com o menor tempo total de chamada e o mínimo de retrabalho.
Uma reserva de restaurante revela o custo real
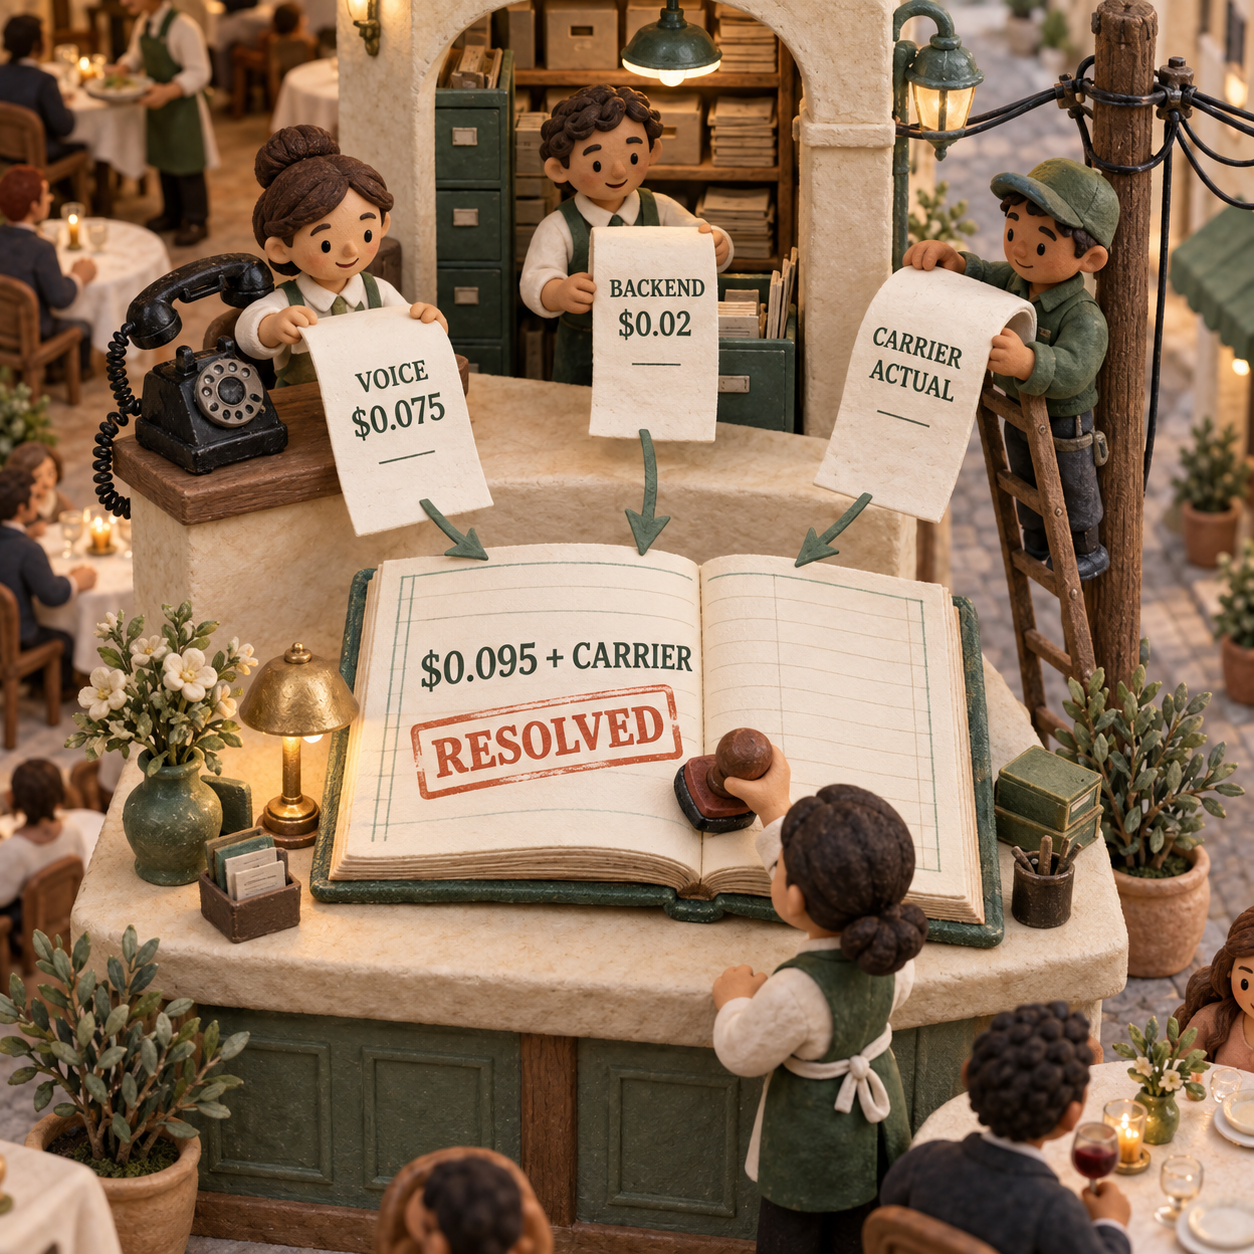
Considere uma ligação recebida de 90 segundos para reservar uma mesa. O exemplo de custo da própria OpenAI oferece um ponto de partida claro:
- Voz: 90 segundos divididos por 60 e multiplicados por $0.05 resultam em $0.075.
- Backend: suponha que o uso medido do modelo e das ferramentas neste exemplo some $0.02.
- Subtotal de voz e backend: $0.095.
- Transporte telefônico: acrescente a tarifa da operadora para aquela chamada real.
Portanto, a ligação não custa $0.075. Neste exemplo, ela custa $0.095 mais o transporte telefônico. Se a reserva for confirmada, esse é o custo direto de execução de uma reserva resolvida. Se o agente falhar e uma pessoa tiver de refazer o trabalho, a chamada malsucedida continua no numerador do cálculo de custo por resolução.
Por isso, deixar a tarifa da operadora como uma variável é mais honesto do que inserir no total um valor de mercado inventado. A OpenAI não define essa parcela; consulte a cobrança de transporte na fatura da sua própria operadora.
Há mais uma interação importante nessa conta. Um backend mais rápido pode compensar uma tarifa por token maior se encerrar a sessão Live antes. Reduzir um minuto do tempo em aberto economiza $0.05 em voz. Já um backend mais barato pode sair mais caro no total se obrigar a pessoa a repetir dados, demorar ao usar ferramentas ou não concluir a reserva.
Como isso funciona em um fluxo de chamadas real
Um restaurante pode colocar o GPT-Live-1 no número que recebe reservas e manter o escopo bem definido. A camada de voz conduz a conversa. Um backend de baixo custo consulta a disponibilidade e prepara o agendamento. A aplicação confirma o horário final, registra a reserva e impede que uma resposta atrasada marque a mesa para a hora errada.
Uma equipe de suporte pode usar o mesmo frontend com políticas diferentes no backend. Consultas rotineiras de pedidos podem ir para um modelo focado em custo. Uma cobrança contestada ou uma exceção à política pode seguir para um modelo mais avançado ou para uma pessoa. O ganho não está em fazer um único modelo de voz assumir todas as tarefas, e sim em adequar o custo de raciocínio a cada caso sem mudar a experiência falada.
Para uma equipe de produto que já mantém uma cadeia de reconhecimento de fala, modelo e síntese de voz, a decisão é outra. O GPT-Live-1 pode eliminar código de integração e facilitar o tratamento de falas sobrepostas, mas a migração só se paga se o novo sistema melhorar a conclusão das tarefas ou reduzir a manutenção o bastante para justificar o trabalho. A comparação mais ampla de custos de agentes de voz com IA continua útil quando a escolha é entre desenvolver ou contratar.
Uma equipe que trabalha com aplicações no navegador pode conectar-se por WebRTC e eliminar completamente a parcela da operadora de telefonia. Ainda haverá cobrança pela duração da sessão Live e pelo trabalho do backend. Agentes somente de texto, fluxos em lote e aplicações nas quais ninguém precisa falar não são afetados por este lançamento.
O menor piloto telefônico que gera dados úteis
No caminho SIP direto, o processo começa quando a operadora encaminha uma chamada recebida à OpenAI e o seu webhook recebe o ID de uma sessão Live. Este é o formato de aceitação documentado:
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
A chave da API permanece no backend confiável. O SIP negocia o formato do áudio, então audio.format fica de fora. Com a delegação no cliente, sua aplicação controla o modelo de backend, as ferramentas, as permissões e os registros de uso.
Para um piloto de reservas recebidas, o trabalho é curto o bastante para manter a medição clara.
Defina um único resultado
Considere uma reserva confirmada — e não apenas uma conversa agradável — como sucesso. Registre o horário solicitado, o horário reservado ao final e se uma pessoa precisou assumir o atendimento.
Registre cada parcela do custo
Durante a ligação, mantenha o valor cumulativo mais recente dos segundos de voz. Em um encerramento normal, substitua esse valor pelo uso final de
session.closed. Salve uma única vez o ID de cada resposta do backend e os respectivos usos de tokens e ferramentas. Depois, associe esses registros ao detalhamento de chamadas da operadora.Teste interrupções como elas acontecem de verdade
Inclua as pausas, correções, falas ao fundo e confirmações curtas que seus clientes realmente fazem. Confira a transcrição, a ação executada pelo backend e o áudio que a pessoa de fato ouviu. Uma resposta concluída no backend não prova que o resultado foi reproduzido em voz alta.
Compare o custo por tarefa concluída
Some os gastos com voz, backend e transporte em todo o piloto e divida o total pelas reservas confirmadas. Inclua no custo as chamadas malsucedidas, as novas tentativas e as transferências para atendentes humanos. Compare o resultado com o sistema atual usando os mesmos roteiros de chamada.
A promessa sobre interrupções ainda precisa dos seus dados
O GPT-Live-1 foi desenvolvido para lidar com falas sobrepostas, mas um exemplo de lançamento não equivale ao seu acordo de nível de serviço. Andrew Hsu, cofundador e CTO da Speak, afirma que a avaliação inicial da empresa reduziu em quase 80% as interrupções durante pausas de raciocínio, em comparação com os sistemas anteriores baseados em turnos. Esse resultado pertence ao cenário de tutoria de idiomas da Speak.
Uma linha ruidosa de restaurante, uma pessoa ditando o número de um pedido ao suporte e um paciente fazendo uma pausa antes de informar uma data são cargas de trabalho diferentes. Configuração de prompts, codec telefônico, variação da rede da operadora, latência das ferramentas e controles de reprodução da sua aplicação influenciam o que a pessoa ouve. Não existe uma melhora universal e defensável de interrupção ou latência que possa ser simplesmente copiada para uma projeção.
O caso-limite em produção também merece atenção. Quando alguém interrompe o agente e corrige sexta-feira para quinta-feira, a correção falada não cancela automaticamente o trabalho de backend referente à sexta-feira. A aplicação precisa alterar ou cancelar a tarefa anterior, ignorar uma resposta atrasada e garantir que uma nova tentativa não gere uma segunda reserva.
No momento, o SIP direto do GPT-Live atende chamadas recebidas. O endpoint de criação da sessão Live não inicia uma ligação SIP de saída; por isso, campanhas ativas ainda precisam de um caminho controlado por uma operadora parceira. Equipes que precisam começar por chamadas de saída devem validar essa rota antes de planejar a migração.
O que fazer na segunda-feira
Se você opera uma fila de reservas ou suporte receptivo, instrumente um piloto de escopo restrito. Registre no mesmo lugar os segundos de voz, o uso do backend, as tarifas da operadora, as tarefas concluídas, as transferências e as falhas de interrupção. Compare um backend orientado a custo com o modelo mais avançado que você imagina precisar.
Avance quando o custo total por chamada resolvida superar o da estrutura atual e as pessoas conseguirem corrigir o agente sem disparar ações desatualizadas. Espere se o único benefício for a manchete de $0.05 ou se a operadora e a rota de chamadas de saída ainda não estiverem definidas. Ignore o lançamento para trabalhos somente de texto e para experiências de voz que já atinjam suas metas de custo e conclusão.
Para receber outras análises diretas sobre mudanças que alteram a conta operacional, assine a newsletter.
- Última atualização
- 14 de set. de 2026
- Categoria
- Explained
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

ChatGPT para Windows: Appshots reduzem o trabalho de copiar contexto
Veja como usar Appshots no ChatGPT para Windows para enviar uma janela ao chat, reduzir o copia e cola de contexto e revisar os dados compartilhados.14 de set. de 2026Explained
FastAPI Vercel: arquivos estáticos deixam de usar Functions
A Vercel agora entrega arquivos estáticos elegíveis do FastAPI pela CDN. Veja quais requisições deixam de usar Functions e quando a proteção exige Python.13 de set. de 2026Explained
Chave da API OpenAI: como planejar a rotação sem interrupções
Entenda como definir a validade da chave da API OpenAI, preparar a substituição e verificar cada automação antes que a credencial expire em produção.13 de set. de 2026Explained
Credenciais compartilhadas no Vercel Connect: quem pode gerenciar
Defina quem gerencia credenciais compartilhadas no Vercel Connect, entenda o alcance do Connector Manager e mantenha cada camada de acesso sob controle.13 de set. de 2026Explained
Cloudflare R2: arquivos sem extensão já entram no AI Search
O Cloudflare R2 agora permite indexar arquivos sem extensão no AI Search via Content-Type. Veja o que muda na ingestão, os custos e como validar.12 de set. de 2026Explained
Vercel Sandbox dobra o espaço para jobs maiores de agentes
Entenda quais jobs de repositório, build e dados agora cabem no Vercel Sandbox e o que medir antes de repetir uma execução que exige muito disco.12 de set. de 2026Explained
Cloudflare Workflows: retenção curta sem perder evidências
Entenda o novo padrão de 7 dias no Cloudflare Workflows, separe retenção de sucesso e erro e estime custos sem perder evidências operacionais.11 de set. de 2026Explained