Agentes de IA gerenciados: o que remover do Cloudflare com o Anthropic SDK 0.100–0.102
Veja o que os agentes de IA gerenciados do Anthropic SDK substituem no Cloudflare, quanto custam e por que a orquestração multiagente ainda não compensa.



O Anthropic Python SDK lançou a versão 0.100.0 em 6 de maio, a 0.101.0 em 11 de maio e a 0.102.0 em 13 de maio — três releases em oito dias que transformaram os agentes de IA gerenciados em um runtime hospedado, com outcomes, webhooks e orquestração multiagente integrados. Revisei minha própria stack de 6 Durable Objects no Cloudflare para descobrir o que client.beta.managed_agents.sessions.create() substitui. A resposta honesta: cerca de 280 linhas de código de retry e polling em duas etapas do workflow. O restante fica.
O que mudou para os agentes de IA no SDK 0.100 a 0.102
Foram três releases em oito dias, e a superfície do Python SDK mudou mais do que nos seis meses anteriores. As datas importam: quem manteve anthropic==0.99.x fixado em produção perdeu todo o runtime de Managed Agents em um único sprint.
v0.100.0 (6 de maio de 2026) adicionou suporte a multiagentes, outcomes, webhooks e validação de vault ao namespace beta. O formato que realmente interessa é este: client.beta.managed_agents.sessions.create(thread=..., outcome=..., metadata=...) devolve um session_id e roda de forma assíncrona na infraestrutura da Anthropic. O loop de orquestração deixa de ser sua responsabilidade.
v0.101.0 (11 de maio de 2026) trouxe o cliente AWS para Claude Platform on AWS e atualizou todos os exemplos do cookbook para claude-sonnet-4-5-20250929. Para quem usa Bedrock, esta é a versão necessária: o suporte à variável de ambiente ANTHROPIC_BEDROCK_SERVICE_TIER (default/flex/priority) chegou aqui, não na 0.100.
v0.102.0 (13 de maio de 2026) adicionou os tipos BetaManagedAgentsSearchResultBlock, diagnósticos de cache para o beta de prompt caching e validação antecipada de iteradores do Pydantic. A superfície dos tipos de bloco ainda está mudando — e esse é o principal motivo para eu ainda não migrar meu código multiagente.
O recurso central são os outcomes. Você define uma rubrica, um agente avaliador separado julga o resultado com base nela, e o agente tenta novamente até ser aprovado. A avaliação interna da Anthropic aponta ganho de até +10 pontos na taxa de sucesso das tarefas em comparação com loops de prompting convencionais, +8.4% na geração de docx e +10.1% na de pptx. Esses números batem com o que observo no meu próprio Critic Durable Object: um único novo prompt com as observações do avaliador vale aproximadamente um salto de categoria na qualidade do modelo.
A outra metade são os webhooks. Oito eventos de sessão são enviados a uma URL cadastrada no Claude Console: session.status_run_started, session.status_idled, session.status_rescheduled, session.status_terminated, session.thread_created, session.thread_idled, session.thread_terminated e, o mais importante, session.outcome_evaluation_ended. O segredo de assinatura começa com whsec_… e aparece uma única vez durante a criação. A verificação é feita com client.webhooks.unwrap(payload, signature, secret).
A orquestração multiagente também chegou, mas exige uma solicitação de acesso ao research preview. Mais adiante explico por que ainda não vou ativá-la.
O que isso muda para fundadores sem perfil técnico
Agora a Anthropic executa o agente por você. Você escreve a rubrica ("o artigo chegou a 2,000 palavras, citou três fontes primárias e passou pela regex de remoção de sinais de IA?"). O agente avaliador da Anthropic julga a saída e executa o agente novamente até a aprovação. Seu engenheiro deixa de programar o loop de retry.
Há dois efeitos no custo. Primeiro, menos loops de retry feitos à mão na base de código — portanto, menos tempo de engenharia sênior gasto com manutenção. Segundo, mais tentativas dentro da sessão da Anthropic, cada uma cobrada a $0.08 por hora de sessão além dos tokens. Se haverá economia líquida depende inteiramente da duração das sessões.
O cenário sem maquiagem é este: se a equipe está lançando a v1 de um produto com agentes, Managed Agents substitui cerca de 40% do código de orquestração que um engenheiro sênior precisaria criar. Se o produto já está em produção, a fatia é menor, mas o webhook elimina o loop de polling que quase certamente existe em algum ponto da stack.
Uma pergunta para fazer ao CTO esta semana: "Ainda fazemos polling para saber quando terminou ou já migramos para session.outcome_evaluation_ended?" Se a resposta for "polling", um refactor de meio dia reduz custo de infraestrutura e latência das requisições de uma só vez.
A stack Cloudflare que uso hoje
Para deixar claro o que pode ser apagado, esta é a arquitetura: um único worker Hono no Cloudflare Workers (target ES2021, binding de Static Assets) fica à frente de seis Durable Objects, um para cada rotina de publicação. Editorial, Discovery, Writer, Distribution, Maintenance e Manager — além de um sétimo, ManualIntake, que sustenta a interface administrativa.
Cada rotina é acionada por um de seis Cloudflare Workflows: PublishWorkflow, WriteArticle, PublishArticle, EnrichIdea, DiscoverIdeas, DistributeArticle. O mais pesado é o PublishWorkflow, com oito etapas idempotentes: validar, fundamentar, gerar, limpar, persistir, indexar, criar a capa e publicar. Cada etapa de I/O usa este wrapper:
const result = await step.do(
  "generate-article",
  { retries: { limit: 3, backoff: "exponential" } },
  async () => env.WRITER.generate(brief)
);
O D1 guarda o estado canônico (transições de editorial_brief.status: dispatched → drafting → published / failed). O Vectorize cuida dos embeddings de cada bloco (Gemini-2 768d, formato de recuperação assimétrica). Toda chamada paga de modelo passa por um único ponto de controle, callAi(env, ctx, runner), que registra em ai_call_log os campos agent_id, workflow_instance_id e idea_id para consolidar custos, além de impor um teto diário de $20 e outro de $1 por instância.
Essa é a configuração com 6 DOs que documentei antes. Na migração para Managed Agents, o ponto decisivo é onde mora a lógica de retry. Ela aparece em dois lugares:
- Retries das etapas do Workflow (baratos, gratuitos quando a chamada subjacente dá certo): falhas breves de rede, limites de taxa e erros 5xx transitórios dos provedores upstream.
- Um loop de "avaliar e tentar novamente" escrito à mão em
clean.ts: executa o Writer, executa o Critic e, sescore < 0.75, envia um novo prompt com as observações do Critic, limitado a 3 tentativas.
O segundo caso é substituído por Managed Agents. O primeiro permanece.
As 280 linhas que o SDK 0.100 me permite apagar
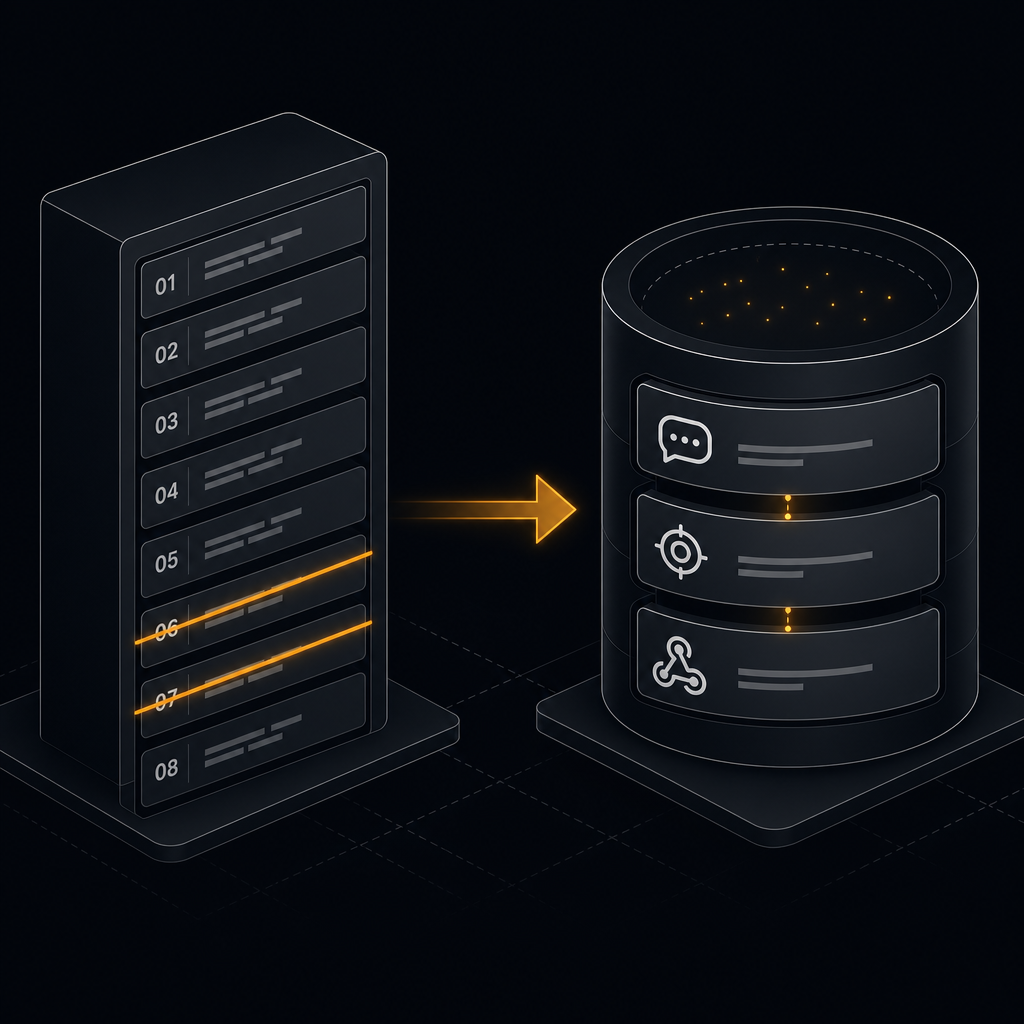
O loop de avaliação e retry em src/worker/workflows/publish/clean.ts é o encaixe mais direto para outcomes. Hoje, são cerca de 120 linhas de orquestração: chamar o Writer, chamar o Critic com uma rubrica armazenada em editorial_brief.rubric_md, interpretar a nota, comparar com o limite, enviar outro prompt com as observações anexadas como bloco de sistema e repetir até três vezes. O próprio Critic ocupa mais 80 linhas de Durable Object (hooks de hibernação, SQLite por instância para o histórico das rubricas e chaves de idempotência por tentativa). A consolidação de ai_call_log por tentativa em callAi.ts consome outras 40 linhas, porque cada tentativa é registrada separadamente e o dashboard precisa agrupá-las.
Os três blocos viram uma única chamada a Managed Agents:
const session = await anthropic.beta.managedAgents.sessions.create({
  thread: { messages: [{ role: "user", content: brief.body_md }] },
  outcome: {
    rubric: brief.rubric_md,
    evaluator: "claude-sonnet-4-5-20250929"
  },
  metadata: { brief_id: brief.id, workflow_instance: ctx.instanceId }
});
return { session_id: session.id, status: "pending" };
Só isso. A sessão roda de forma assíncrona até o fim na infraestrutura da Anthropic. O parâmetro outcome faz o trabalho que antes cabia ao Critic DO: um agente avaliador separado julga a saída com base na rubrica e executa novamente o agente principal até a aprovação.
O código novo é uma rota em /api/admin/webhooks/managed-agents: ela verifica a assinatura whsec_…, testa event.type === "session.outcome_evaluation_ended" e grava o resultado no D1.
app.post("/api/admin/webhooks/managed-agents", async (c) => {
  const raw = await c.req.text();
  const event = await anthropic.webhooks.unwrap(
    raw, c.req.header("anthropic-signature")!, c.env.WEBHOOK_SECRET
  );

  if (event.type !== "session.outcome_evaluation_ended") {
    return c.json({ ok: true });
  }

  await c.env.DB.update(editorial_brief).set({
    status: event.outcome.passed ? "published" : "failed",
    body_md: event.result.body,
    session_cost_usd: event.session.usage.total_cost_usd
  }).where(eq(editorial_brief.id, event.session.metadata.brief_id));

  return c.json({ ok: true });
});
São quarenta linhas, com assinatura verificada e idempotência baseada em brief_id.
Saldo da mudança: menos 240 linhas de orquestração. Menos um binding de Durable Object no wrangler.json. Menos um arquivo de migração. Mais 40 linhas para tratar o webhook. Mais um segredo no Cloudflare Secrets Store.
O endpoint de polling em GET /api/admin/workflows/:id/status continua funcionando. Agora ele lê do D1 o estado da sessão, preenchido pelo webhook, em vez de consultar env.PUBLISH_WORKFLOW.get(id).status(). A interface não muda. Para o dashboard administrativo, a troca é invisível.
Um cuidado importante: os wrappers de retry com step.do continuam em todas as outras etapas de I/O. Geração da imagem de capa, revalidação da Vercel e limpeza do cache do Cloudflare não ganham nada com rubricas de outcome, mas continuam se beneficiando do cache das etapas do Workflows, que é seguro para replays. Não desmonte o que já funciona.
O arquivo que vou manter — e por que a conta muda em escala
callAi.ts fica. Teto diário de $20, limite de $1 por instância. Toda chamada paga de modelo passa por ele, seja direta, via AI Gateway ou via Managed Agents.
O motivo é o modelo de cobrança. Managed Agents cobra em três eixos: tokens pelo preço padrão, mais $0.08 por hora de sessão, mais $10 por 1000 buscas na web. No meu volume — seis rotinas de publicação, um artigo por acionamento e cerca de 3 minutos por sessão — isso equivale a aproximadamente $0.004 por artigo em custo de hora de sessão, além dos tokens. Irrelevante.
O ponto de virada chega quando as sessões se alongam. Uma sessão de Anthropic Skills com 4 horas custa $0.32 só de runtime, além dos tokens. Com 50 sessões assim por dia, são $480 por mês apenas em horas de sessão, antes dos tokens. Uma sessão de pesquisa com várias etapas que passa uma hora ociosa na fila de uma busca web: $0.08 que antes não existia. Tempo ocioso enquanto a sessão aguarda um serviço downstream: também é cobrado (a documentação da Anthropic diz que a medição ocorre por milissegundo, mas o relógio continua correndo).
O ponto de controle impõe um teto rígido que o dashboard de Managed Agents não oferece. O dashboard mostra o custo da sessão depois do fato. callAi.ts lança NonRetryableError no meio do workflow antes de iniciar a sessão caso a estimativa prévia ultrapasse o limite diário.
A estimativa prévia é conservadora:
async function estimateSessionCost(brief: Brief): Promise<number> {
  const tokenEstimate = brief.body_md.length / 3.5;
  const inputCost = (tokenEstimate / 1_000_000) * 3.0;
  const outputCost = (tokenEstimate * 1.5 / 1_000_000) * 15.0;
  const sessionHourEstimate = (brief.expected_minutes / 60) * 0.08;
  const safetyMargin = 1.4;
  return (inputCost + outputCost + sessionHourEstimate) * safetyMargin;
}
A conta por hora de sessão é onde stacks mantidas por um único engenheiro saem do controle mais rápido. Sem o teto, um único agente desgovernado — justamente o comportamento que o loop de retry de outcome pode incentivar quando a rubrica é rigorosa demais — consome o orçamento do dia antes que alguém perceba. Já vi acontecer.
Mantenha o ponto de controle. Faça sessions.create() passar por ele. Registre a estimativa antes de iniciar a sessão. Quando ela terminar, concilie esse valor com event.session.usage.total_cost_usd, recebido no payload do webhook.
A migração que ainda não farei: orquestração multiagente
A orquestração multiagente foi o grande anúncio do Anthropic Dev Day. Um agente líder divide a tarefa e entrega subtarefas a subagentes especialistas, cada um com modelo, prompt e ferramentas próprios. Os subagentes trabalham em paralelo sobre um sistema de arquivos compartilhado. O líder consolida tudo. No papel, é exatamente o que meu Manager DO faz hoje: distribui o trabalho em paralelo para Writer, Discovery e Distribution via DO RPC; cada um mantém seu próprio estado em SQLite, enquanto R2 + D1 funcionam como o "sistema de arquivos" compartilhado.
Tenho três motivos para esperar.
Um: mudanças na API. A orquestração multiagente está em research preview e exige uma solicitação de acesso separada. BetaManagedAgentsSearchResultBlock acabou de chegar na 0.102. A superfície dos tipos de bloco para resultados multiagente continua mudando. Migrar agora significa refazer a integração a cada atualização do SDK nas próximas duas ou três versões. A superfície de webhooks se estabilizou na 0.100; a de multiagentes ainda está em movimento.
Dois: o sistema de arquivos compartilhado pertence à sessão e é efêmero. Dentro de uma sessão de Managed Agents, ele desaparece quando a sessão termina. R2 e D1 persistem entre todas as minhas rotinas, podem ser consultados por qualquer worker e sobrevivem à falha de uma sessão. Enquanto esse sistema de arquivos não for durável — ou enquanto eu não puder montar o R2 diretamente no sandbox da sessão — a mudança representa uma regressão para o meu workload.
Três: a divisão entre líder e subagente da Anthropic é rígida. Existe um papel fixo de agente líder. Meu Editorial DO lidera em alguns dias, quando uma rotina de publicação dispara, e atua como par em outros, quando a interface administrativa envia um briefing e o Editorial entra no pipeline no meio do caminho. Eu teria de eliminar uma assimetria útil para me encaixar em uma abstração hospedada.
O que me faria mudar: o sistema de arquivos compartilhado se tornar durável e funcionar entre sessões — ou o R2 poder ser montado no sandbox. Hoje, é um movimento lateral, não um avanço.
Checklist exato de migração do SDK 0.100 ao 0.102
Fixe a versão do SDK
Bashuv add anthropic@0.102.0Ou
pip install anthropic==0.102.0caso ainda não use uv. Pule a 0.100 e a 0.101, a menos que exista um motivo específico do Bedrock para parar na 0.101.Cadastre o webhook no Claude Console
Claude Console → Settings → Webhooks → New endpoint. Aponte para
https://your-worker.example.com/api/admin/webhooks/managed-agents. Copie o segredowhsec_…, exibido uma única vez durante a criação. Armazene-o no Cloudflare Secrets Store — ou no AWS Secrets Manager, se você usa Claude Platform on AWS por meio do SDK 0.101.Adicione a rota do webhook
Crie
/api/admin/webhooks/managed-agents. Verifique a assinatura comclient.webhooks.unwrap(payload, signature, secret)— o helper chegou na v0.95.x e está estável na 0.100. A chamada a unwrap resolve HMAC, tolerância de timestamp e interpretação do tipo de evento de uma só vez. Não implemente sua própria verificação HMAC: a janela de desvio de timestamp não é óbvia.Converta a etapa de avaliação
Substitua o loop de avaliação e retry por
outcome={rubric: brief.rubric_md, evaluator: "claude-sonnet-4-5-20250929"}emsessions.create(). Remova o Critic DO e a orquestração de retries. Mantenha a rubrica no D1; a coluna de rubrica se torna mais importante, não menos.Troque o polling por consultas ao D1
O endpoint de status passa a ler do D1, usando como chave
event.session.metadata.brief_id— ou qualquer outra chave de correlação definida emmetadataao chamarsessions.create(). O webhook escreve; o endpoint de status lê. Acabaram as idas e vindas deworkflow.status().Mantenha o ponto de controle de custos
callAi.tsfica. Estime o custo da sessão antes de iniciá-la. LanceNonRetryableErrorse a estimativa ultrapassar o teto diário. Registre no handler do webhook os valores reais deevent.session.usageapós a conclusão. Compare semanalmente as estimativas prévias com os valores reais; ajuste a margem de segurança se o desvio passar de 25%.Comece pela rotina de menor risco
No meu caso, foi
Discovery, porque uma falha na migração não produz saída pública. Rode a rotina por 72 horas em paralelo com o caminho antigo. Compare as saídas. Só então migre oWriter.
Posso usar o SDK 0.100 com minha configuração atual do Anthropic Bedrock?
Sim, mas o cliente dedicado para AWS só chegou na 0.101. Se você usa Bedrock, avance além da 0.100. O SDK 0.101 também adicionou suporte à variável de ambiente ANTHROPIC_BEDROCK_SERVICE_TIER (default/flex/priority), ausente na 0.100.
Os webhooks substituem por completo a API de respostas em streaming?
Não. Os webhooks são disparados nos eventos do ciclo de vida da sessão — iniciada, ociosa, encerrada e avaliação de outcome concluída. As respostas em streaming continuam passando por messages.create(stream=True) e pelo protocolo normal de deltas. Webhooks servem para "avise quando esta sessão longa terminar". Streaming serve para "mostre os tokens à medida que chegam".
Qual é o formato do segredo de assinatura e como faço a verificação?
O prefixo é whsec_…, e o segredo aparece uma única vez durante a criação no Console. Verifique com client.webhooks.unwrap(raw_body, signature_header, secret), que resolve HMAC, tolerância de timestamp e interpretação do tipo de evento em uma chamada. Não registre o segredo bruto em logs. Não o envie como parâmetro de query. Use o Cloudflare Secrets Store ou equivalente.
Posso avaliar outcomes sem Managed Agents, usando apenas a Messages API?
Não. outcome={rubric, evaluator} é um parâmetro exclusivo de Managed Agents em sessions.create(). É possível montar um equivalente com a Messages API — exatamente o que meu Critic DO faz hoje —, mas você paga a latência da orquestração e fica responsável por manter o código. A proposta de Managed Agents é justamente eliminar esse trabalho.
O prompt caching continua funcionando dentro de uma sessão de Managed Agents?
Sim, e reduz o custo de entrada em até 90% quando há cache hit. Os diagnósticos de cache para o beta de prompt caching chegaram na 0.102, portanto agora é possível consultar a taxa de acerto do cache no payload da resposta.
A migração leva uma tarde para Discovery, mais uma para Writer, e o restante vem na sequência. Fixe a versão 0.102.0. Cadastre o webhook. Apague o Critic DO. Mantenha o ponto de controle.
- Última atualização
- 5 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Cursor preço: o Rollouts é grátis? Planos, créditos e custos
Cursor Rollouts exige Teams ou Enterprise. Entenda os créditos de lançamento por 10 dias, cerca de 50 ou 500 alterações, e os custos a conferir.24 de set. de 2026Build
Unreal Agent na prática: como avaliar um agente de IA
Veja como testar o Unreal Agent, um agente de IA para repositórios: isole o ambiente, salve a sessão em JSONL e meça custo, segurança e desempenho.24 de set. de 2026Build
Codex JetBrains com Air: do primeiro prompt à revisão
Aprenda a instalar o Air Alpha, conectar o Codex ao JetBrains, fornecer o contexto certo e revisar a primeira alteração de código com segurança.23 de set. de 2026Build
JetBrains Air é grátis? Entenda quem paga cada camada
JetBrains Air é grátis no plugin, mas agente, IDE e uso de API podem gerar custos. Veja as quatro formas de autorização e descubra qual conta paga.23 de set. de 2026Build
Firecrawl API com hospedagem própria: instalação e custos
Entenda como instalar a Firecrawl API em infraestrutura própria, validar scrapes reais e comparar o custo operacional com o Firecrawl Cloud em 30 dias.22 de set. de 2026Build
Agentes de IA: quando um retry pago exige aprovação humana
Entenda por que retries pagos de agentes de IA precisam de aprovação humana no ponto da recompra, mesmo em fluxos que já mantêm pessoas no circuito.22 de set. de 2026Build
Automação com IA no MindStudio: preços, limites e quando vale a pena
Veja como o MindStudio organiza automação com IA, quanto custam os planos e o uso de modelos e quais limites testar antes de adotar a plataforma.22 de set. de 2026Build