Unreal Agent na prática: como avaliar um agente de IA
Veja como testar o Unreal Agent, um agente de IA para repositórios: isole o ambiente, salve a sessão em JSONL e meça custo, segurança e desempenho.

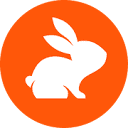

Você pode usar o Unreal Agent para executar uma tarefa de repositório pela linha de comando, preservar a sessão completa em JSONL e decidir se o tratamento assíncrono de ferramentas merece espaço no seu aplicativo. Este é o novo runtime em Go da Unreal Labs para operar um agente de IA para programação, não um assistente para Unreal Engine. Comece com um único resumo do repositório em modo somente leitura, registre modelo, nível de raciocínio, tempo decorrido, status de saída, consumo de tokens e arquivos alterados e, então, compare essas evidências com o agente que você já usa.
Unreal Agent: o que esse agente de IA realmente é
O Unreal Agent ocupa a camada entre o modelo e as ferramentas que executam o trabalho. Pense nessa camada como o encarregado de uma obra: o modelo define o que precisa ser feito, enquanto o runtime distribui os comandos, registra o que aconteceu e determina quando cada resultado deve voltar ao modelo.
Seu diferencial é a execução assíncrona de ferramentas. Quando o modelo chama uma ferramenta, o runtime registra que o trabalho está em andamento e permite que ele continue em segundo plano. Ao final, acrescenta o resultado definitivo à sessão e aciona o modelo novamente. Assim, um comando de configuração demorado não precisa interromper outras tarefas úteis nem impedir uma nova mensagem de direcionamento.
A Unreal Labs lançou o projeto em 22 de setembro de 2026. O SDK inclui uma biblioteca Go, um runner instalável e um runner de benchmarks compatível com Harbor. O repositório adota a MIT License.
A Unreal Labs informa custo até 40% menor que o Codex e até 20% menor que o Pi em suas cargas de produção e nos benchmarks de agentes publicados. Encare esses números como resultados do fornecedor, não como um desconto que se repete em qualquer cenário. O mecanismo alegado é plausível o bastante para ser testado: um prompt menor, resultados de ferramentas compactos, ausência de subagentes e workflows e mais trabalho das ferramentas entre as chamadas ao modelo. O percentual só se torna útil quando modelo, nível de raciocínio, prompt, estado do repositório e critérios de sucesso são equivalentes.
A conta do negócio começa pela tarefa, não pelo benchmark
O runner não cobra licença por usuário porque está sob a MIT License, mas operá-lo tem custo. Ainda entram na conta as chamadas ao modelo, a computação, o sandbox, a integração, os logs e o profissional de engenharia responsável por manter o sistema confiável.
O orçamento que ele pode disputar aparece nos preços de ferramentas de revisão de código. A Graphite oferece o plano Starter por $20 por usuário ao mês e o Team por $40, com cobrança anual. A CodeRabbit lista planos anuais de $24, $48 e $72 por desenvolvedor ao mês. Para uma equipe de 10 desenvolvedores, essa faixa publicada vai de $200 a $720 por mês.
Isso não transforma o Unreal Agent em substituto direto de nenhum dos dois produtos. O que ele oferece a uma equipe de plataforma é um runtime aberto sobre o qual construir um fluxo interno bem específico. O teste econômico é simples: compare o custo mensal completo desse fluxo, incluindo uso do modelo e manutenção, com o orçamento de licenças ou as horas de engenharia que ele substitui. Se não for possível medir o custo por tarefa concluída, a promessa de economia é apenas decorativa.
Como executar uma tarefa delimitada no repositório
Comece pelo runner. A biblioteca faz sentido para equipes que já sabem qual comportamento do agente deve fazer parte do próprio aplicativo.
1. Coloque o repositório atrás de uma barreira de verdade
-workspace define o diretório de trabalho do agente e de sua ferramenta Bash. A documentação não o apresenta como um sandbox de segurança. Use um checkout descartável ou um contêiner, remova credenciais de produção, restrinja o acesso à rede e entregue ao processo apenas os tokens indispensáveis. Incluir “não altere arquivos” no prompt é uma instrução, não um mecanismo de proteção. Se esse terreno for novo para você, comece pelas opções práticas deste guia de sandboxes para agentes de IA.
Verifique também se há um arquivo .env no workspace. O runner carrega esse arquivo a partir do workspace selecionado; portanto, até uma cópia do repositório pode expor credenciais esquecidas.
2. Fixe runner, provedor, modelo e nível de raciocínio
Em 24 de setembro de 2026, a versão atual é a v0.2.0, publicada um dia antes. O README do runner exige Go 1.27 ou mais recente e documenta o uso de @latest; para uma avaliação reproduzível, prefira uma tag de versão.
A execução abaixo usa OpenAI, o padrão atual do código-fonte gpt-6-astra e raciocínio high. Só troque o modelo se também registrar qual foi a substituição. Execute o exemplo em uma cópia descartável de my-project:
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonl
O runner também aceita openai-codex, openrouter, fireworks e ollama. Cada solicitação pode definir modelo, nível de raciocínio, número de novas tentativas, ID da sessão, prompt de sistema e ferramentas a excluir. No estado atual, porém, não é possível acrescentar ferramentas arbitrárias com extra_allowed_tools, pois o campo é aceito, mas ignorado.
3. Trate a execução como evidência
Um bom registro de avaliação reúne seis partes:
A sessão persistida fica em unreal-sessions/repo-summary-v1.session.jsonl. Reutilize o mesmo session_id para continuar a sessão. Quando quiser uma comparação limpa, crie outro ID; do contrário, o contexto anterior pode alterar tanto a qualidade quanto o custo.
Não há aqui um resultado próprio de desempenho, porque nenhuma execução com um provedor ativo foi concluída. O único número de desempenho defensável é aquele obtido no seu próprio repositório.
Runner ou biblioteca: qual escolher?
Use o runner para testar um prompt, avaliar uma tarefa de repositório ou integrar um processo ao CI. Escolha a biblioteca Go quando o agente precisar fazer parte do seu produto e sua equipe estiver preparada para assumir armazenamento de sessões, ciclo de vida, ferramentas, segurança e integração com provedores.
A diferença lembra a de uma ferramenta elétrica e seu motor. O runner entrega a ferramenta pronta, com controles já instalados. A biblioteca fornece o motor e a liberdade para projetar carcaça, controles e sistema de segurança. Se a propriedade da sessão for o fator decisivo, esta comparação entre Agents API e SDK oferece um referencial próximo e útil.
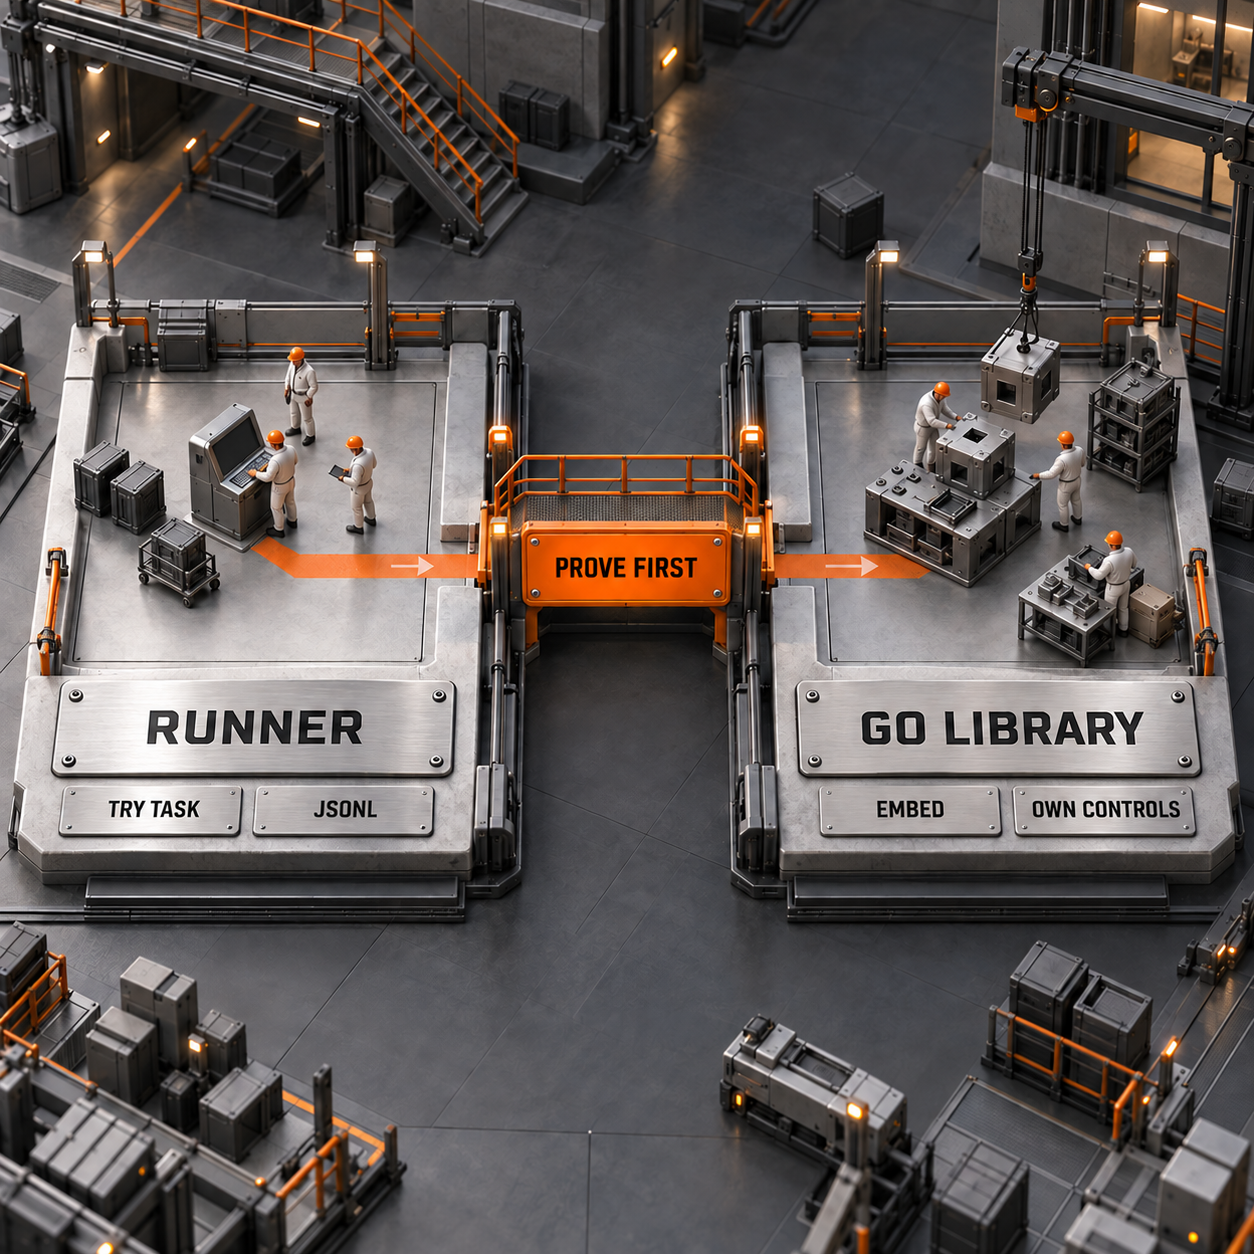
O runner é a escolha inicial mais segura porque o trabalho de integração pode mascarar uma tarefa fraca. Se o mesmo prompt delimitado não produzir duas vezes um resultado útil, um wrapper de API não consertará a ideia do produto.
Seis tarefas que vale a pena testar, em ordem
1. Primeira revisão de pull requests escritos por agentes
Uma equipe de engenharia que recebe pull requests extensos gerados por IA pode entregar ao runner um checkout limpo, o diff e os comandos de teste do repositório. O sistema pode examinar o código afetado, executar verificações direcionadas e devolver um pacote de revisão respaldado por JSONL. O objetivo não é eliminar a revisão humana. É antecipar a inspeção repetitiva do repositório para que a atenção de quem revisa fique concentrada na arquitetura e nos riscos.
2. Orientação de quem acaba de entrar no time
Uma equipe de plataforma pode executar exatamente o prompt de resumo acima sempre que uma pessoa de engenharia chegar a um serviço. A saída mapearia pontos de entrada, comandos de teste, configuração e riscos evidentes, deixando o rastro da sessão disponível para conferência. O ganho é ter uma primeira hora reproduzível sem pedir a uma pessoa sênior que apresente o mesmo repositório desde o início.
3. Triagem de testes com falha
Diante de uma falha ruidosa no CI, uma pessoa desenvolvedora pode pedir ao runner que reproduza um teste com falha, vasculhe os caminhos de código relevantes e separe a causa provável do ruído. O tratamento assíncrono de ferramentas é importante aqui porque a preparação do ambiente, as buscas e a execução dos testes podem se sobrepor. O resultado é um pacote de evidências menor para quem fará a correção.
4. Preparação de atualização de dependência
Uma pessoa responsável pela manutenção pode apontar o agente para um branch com uma única atualização de dependência e solicitar imports afetados, chamadas obsoletas, cobertura de testes e notas de migração. A saída vira um checklist, não um merge automático. O ganho está em dimensionar o trabalho mais rapidamente antes que alguém reserve um bloco inteiro de engenharia.
5. Verificações de prontidão para lançamento
Quem responde por um lançamento pode solicitar as áreas alteradas, migrações ausentes, lacunas na documentação e os comandos de teste pertinentes a uma versão candidata. O registro da sessão preserva o que o agente realmente inspecionou. O ganho é um preflight consistente que complementa o CI determinístico, sem substituí-lo.
6. Pacotes para escalonamento do suporte
Uma pessoa de engenharia de produto pode colocar um problema reproduzível de cliente em um repositório sem dados sensíveis e pedir ao runner que rastreie os caminhos de código prováveis, reproduza o sintoma e liste as questões ainda sem resposta. O ganho é uma passagem estruturada do suporte para a engenharia, sem dar ao agente acesso aos sistemas de produção do cliente.
Dois produtos que vale a pena construir
A aposta mais forte: uma barreira de revisão para código gerado por IA
Crie uma verificação para GitHub ou GitLab que inicialize o Unreal Agent em um workspace isolado, revise o pull request conforme as regras do repositório, execute as verificações permitidas e publique para revisão humana um resumo com links para as evidências. O comprador é a equipe que está produzindo mais código com agentes.
A demanda por revisão de código com IA é direta. ai powered code review platform recebe cerca de 1,900 buscas mensais nos Estados Unidos, enquanto ai code review chega a aproximadamente 1,300 e tem CPC de $55.73. Os produtos existentes confirmam um orçamento de $20 a $72 por desenvolvedor ao mês em planos anuais.
A menor versão comercializável aceita um único host de código, um provedor de modelo, um prompt de revisão fixo, uma lista estrita de comandos permitidos e uma página de resultados construída com o rastro em JSONL. O desafio é a confiança. Falsos positivos, vazamento de segredos, comentários ruidosos e comandos inseguros podem destruir o valor rapidamente. Ainda assim, essa é a melhor oportunidade: trata-se de uma necessidade frequente, mensurável e vinculada a um orçamento que já existe.
Um executor de tarefas de repositório com modelo próprio
Crie um pequeno plano de controle interno no qual a equipe escolhe um repositório, um template de tarefa aprovado, um provedor, um modelo e um teto de custo, recebendo depois o rastro da sessão e um resultado pronto para aprovação. Agências e equipes de plataforma interessadas em um runtime aberto, mas que não querem construir as camadas de fila, isolamento e relatórios, pagariam por isso.
open source ai coding agent recebe cerca de 5,400 buscas mensais nos Estados Unidos, com intenção comercial e CPC de $13.11. É uma demanda mais ampla que a busca sobre revisão, mas o pedido de produto é menos específico.
O MVP inclui um conector de repositório, workspace efêmero, dois templates de tarefa, configuração de provedor, status do trabalho, relatório de tokens e JSONL para download. O desafio é a diferenciação. Um dashboard simples sobre um runtime ainda recente é fácil de copiar, e compradores exigentes vão cobrar controles de identidade, logs de auditoria, política de rede e limpeza confiável. A vantagem deve vir de um fluxo específico e dos controles operacionais, não do nome do produto.
O que o Unreal Agent não resolve
Ele não entrega uma barreira de produção completa. A flag de workspace não é um sandbox, e a ferramenta Bash integrada pode agir dentro do ambiente que você fornecer. Isolamento, política de rede, credenciais, aprovações e limpeza continuam sob sua responsabilidade.
Ele não elimina as diferenças entre provedores. A Unreal Labs relata que o padrão de resultados de ferramentas provisórios e finais foi rejeitado por alguns modelos em determinados provedores de inferência que não eram da OpenAI durante seus testes. Valide exatamente a combinação de provedor e modelo que pretende colocar em produção.
Ele também não traz uma orquestração elaborada. A estrutura enxuta, sem subagentes nem workflows, faz parte do argumento de eficiência. Portanto, não é uma boa escolha para produtos que dependem de um construtor visual de fluxos, de um catálogo amplo de conectores gerenciados ou de agentes especialistas delegados prontos para uso.
Por fim, ele não comprova economia para a sua carga de trabalho. Modelo, esforço de raciocínio, comportamento do cache, saída das ferramentas, novas tentativas e sucesso da tarefa alteram a conta. Compare tarefas concluídas com sucesso, não o total bruto de tokens obtido em configurações diferentes.
O que fazer na segunda-feira
Na segunda-feira, uma pessoa de engenharia de plataforma deve fixar a versão v0.2.0, preparar uma cópia do repositório sem credenciais e executar duas vezes a tarefa de resumo com o mesmo modelo e o mesmo nível de raciocínio. Preserve o JSONL, o arquivo de sessão, o status de saída, o tempo decorrido, o uso de tokens e o diff do repositório. Se as duas execuções forem úteis e não deixarem alterações, repita a mesma tarefa com o agente atual. Só então decida se vale testar um fluxo de revisão ou integrar a biblioteca.
O que é o Unreal Agent?
O Unreal Agent é um runtime de agentes em Go da Unreal Labs, projetado desde o início para operações assíncronas. Ele inclui uma biblioteca Go, um runner instalável para linha de comando e um runner de benchmarks compatível com Harbor. Não tem relação com a Unreal Engine da Epic Games.
O que é necessário para executar o Unreal Agent?
Para instalar a partir do código-fonte, você precisa do Go 1.27 ou mais recente, um workspace, a configuração de um provedor compatível, um modelo e as credenciais exigidas por esse provedor. O runner aceita OpenAI, OpenAI Codex, OpenRouter, Fireworks e Ollama.
O Unreal Agent consegue retomar uma sessão?
Sim. Defina um session_id na solicitação JSON. Reutilizar esse ID retoma a sessão persistida; usar outro ID cria uma sessão nova.
A flag de workspace isola o agente em um sandbox?
Não. Ela apenas seleciona o workspace e o diretório de trabalho do Bash. Execute o processo em um sandbox separado ou em um ambiente descartável e restrinja nele as credenciais e o acesso à rede.
O Unreal Agent é mais barato que o Codex?
A Unreal Labs informa economia de até 40% em relação ao Codex nas cargas e nos benchmarks publicados pela empresa. Esse é um resultado do fornecedor, não uma garantia. Antes de concluir que há economia, compare o mesmo modelo, nível de raciocínio, prompt, estado do repositório e critérios de sucesso.
Se você busca um agente controlado para repositórios, construído em torno do seu próprio fluxo de trabalho, o próximo passo é conhecer o serviço de desenvolvimento de agentes de IA.
- Última atualização
- 24 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Cursor preço: o Rollouts é grátis? Planos, créditos e custos
Cursor Rollouts exige Teams ou Enterprise. Entenda os créditos de lançamento por 10 dias, cerca de 50 ou 500 alterações, e os custos a conferir.24 de set. de 2026Build
Codex JetBrains com Air: do primeiro prompt à revisão
Aprenda a instalar o Air Alpha, conectar o Codex ao JetBrains, fornecer o contexto certo e revisar a primeira alteração de código com segurança.23 de set. de 2026Build
JetBrains Air é grátis? Entenda quem paga cada camada
JetBrains Air é grátis no plugin, mas agente, IDE e uso de API podem gerar custos. Veja as quatro formas de autorização e descubra qual conta paga.23 de set. de 2026Build
Firecrawl API com hospedagem própria: instalação e custos
Entenda como instalar a Firecrawl API em infraestrutura própria, validar scrapes reais e comparar o custo operacional com o Firecrawl Cloud em 30 dias.22 de set. de 2026Build
Agentes de IA: quando um retry pago exige aprovação humana
Entenda por que retries pagos de agentes de IA precisam de aprovação humana no ponto da recompra, mesmo em fluxos que já mantêm pessoas no circuito.22 de set. de 2026Build
Automação com IA no MindStudio: preços, limites e quando vale a pena
Veja como o MindStudio organiza automação com IA, quanto custam os planos e o uso de modelos e quais limites testar antes de adotar a plataforma.22 de set. de 2026Build
Wispr Flow ou Superwhisper: qual app de ditado compensa?
Compare Wispr Flow e Superwhisper em preço, privacidade, uso offline e recursos para equipes antes de escolher seu aplicativo de ditado por voz.22 de set. de 2026Build