Unreal Agent 使用教程:跑通 Runner,用 JSONL 验证效果
这篇 Unreal Agent 使用教程带你配置 Runner,在隔离仓库中运行只读任务,读取 JSONL 会话、退出状态与 Token 用量,并判断异步工具执行是否值得接入产品。文章同时拆解 Runner 与 Go 库的选择、安全边界、成本比较、代码审查场景和可落地的产品方向,帮助团队用同一模型和标准完成可复现评估。


这篇 Unreal Agent 使用教程带你从命令行跑通一个仓库任务,把完整会话保存为 JSONL,并据此判断它的异步工具处理是否值得接入自己的应用。这里说的是 Unreal Labs 新推出的 Go 智能体运行时,不是 Unreal Engine 助手。先做一次只读的仓库概览任务,同时记录模型、推理等级、耗时、退出状态、Token 用量和文件变更,再拿这些证据与现有智能体对比。
Unreal Agent 使用教程:先弄清它是什么
Unreal Agent 位于模型与执行任务的工具之间。可以把它理解为现场负责人:模型判断要做什么,运行时负责下发命令、记录过程,并决定何时把每项结果交还给模型。
它最特别的设计是异步执行工具。模型调用工具后,运行时会先把任务标记为进行中,让它在后台继续执行;任务完成时,运行时再把最终结果追加到会话中,并再次调用模型。这样一来,耗时较长的环境初始化命令不会挡住其他有效工作,也不会妨碍新的引导消息进入。
Unreal Labs 于 2026 年 9 月 22 日发布了该项目。SDK 包含 Go 库、可安装的 Runner,以及兼容 Harbor 的基准测试 Runner。代码仓库采用 MIT License。
Unreal Labs 表示,在其生产工作负载和已发布的智能体基准测试中,成本相较 Codex 最多降低 40%,相较 Pi 最多降低 20%。这些是厂商给出的结果,不能直接当作任何场景都适用的折扣。其解释值得实测:更小的提示词占用、更精简的工具结果、不使用子智能体或工作流,以及在两次模型调用之间完成更多工具操作。只有统一模型、推理等级、提示词、仓库状态和成功标准后,这些百分比才有比较意义。
商业账要从任务算起,而不是从跑分算起
Runner 采用 MIT License,不收按席位计算的软件许可费,但运行它绝非零成本。模型调用、算力、沙箱、集成、日志,以及维护系统可靠性的工程师,都要计入成本。
代码审查产品的定价能直观看出它可能挑战哪部分预算。Graphite 的 Starter 方案为每位用户每月 $20,Team 方案为 $40,按年付费。CodeRabbit 的年付价格为每位开发者每月 $24、$48 和 $72。对于一支由 10 名开发者组成的团队,公开价格对应的月度区间是 $200 至 $720。
这并不意味着 Unreal Agent 可以直接替代其中任何一款产品。它提供的是开放运行时,平台团队可以据此搭建一条范围明确的内部工作流。经济账并不复杂:把这条工作流的全部月度成本——包括模型费用与维护成本——同它节省的席位预算或工程时间进行比较。如果连已完成任务的成本都无法衡量,所谓省钱就只是装饰性说法。
如何运行一个边界清晰的仓库任务
先从 Runner 开始。只有已经明确哪些智能体行为需要嵌入应用的团队,才应该直接使用库。
1. 为仓库建立真正的安全边界
-workspace 只是为智能体及其 Bash 工具指定工作目录,文档并没有把它定义为安全沙箱。请使用一次性检出副本或容器,移除生产凭据,限制网络访问,并且只给进程提供必需的 Token。在提示词里写“不要修改文件”只是指令,不是强制约束。如果此前没有实践过这类隔离,可先参考 AI 智能体代码沙箱 中的实用选项。
还要检查工作区里是否存在 .env 文件。Runner 会加载所选工作区中的这个文件,因此复制出来的仓库仍可能暴露被遗忘的凭据。
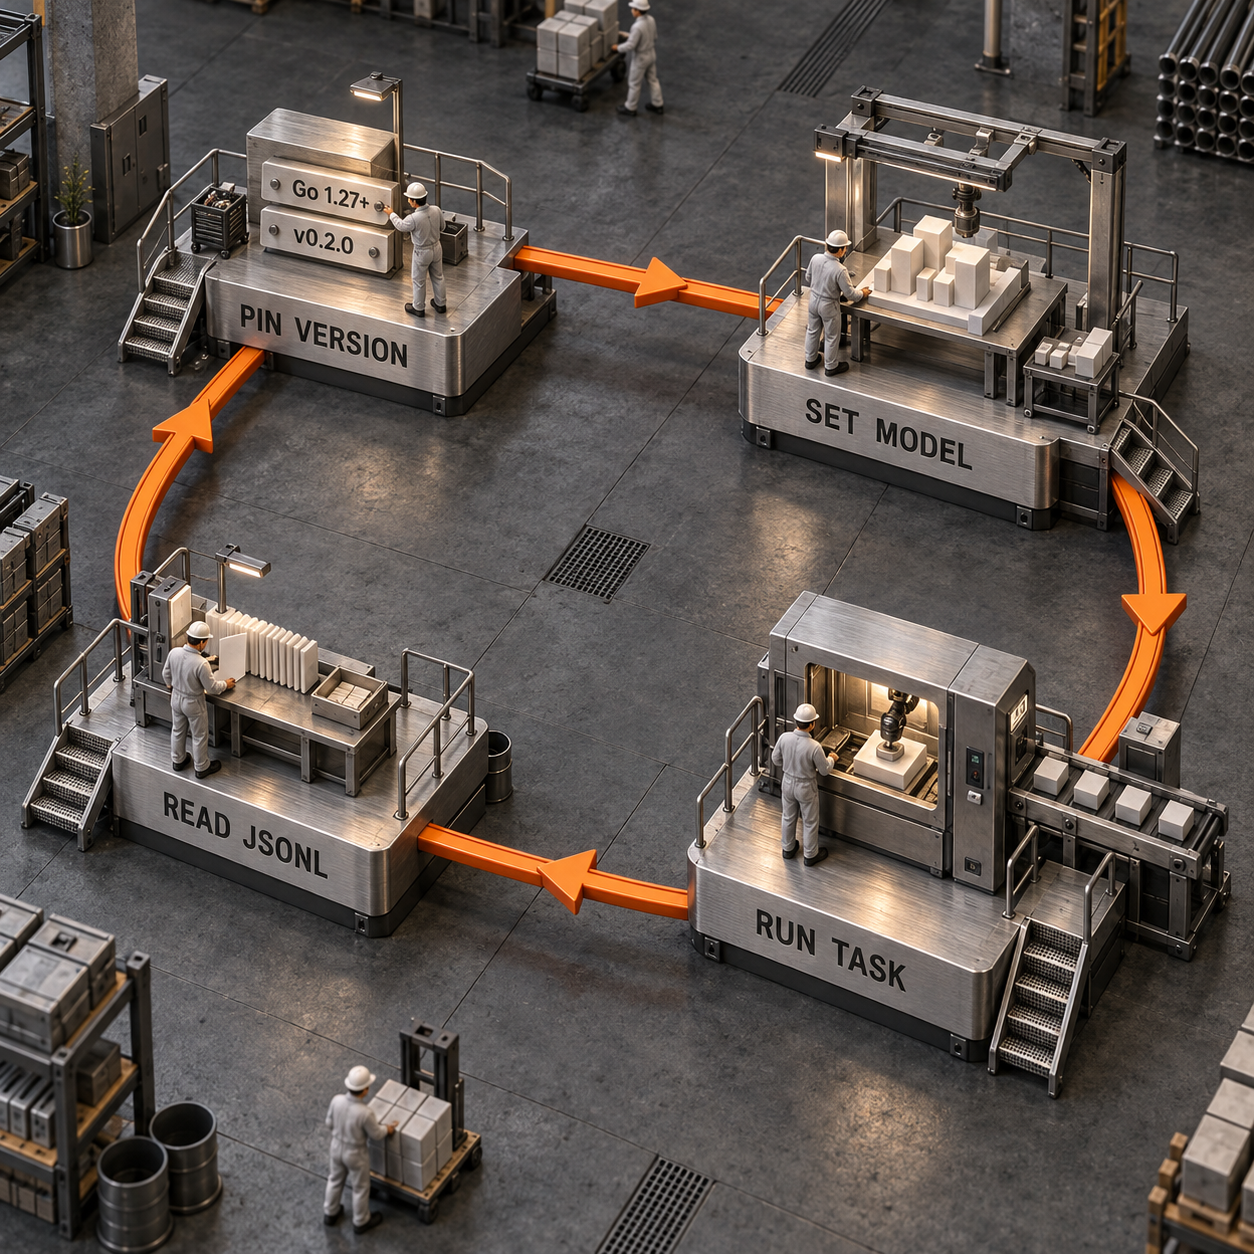
2. 固定 Runner、提供商、模型和推理等级
截至 2026 年 9 月 24 日,当前版本为 v0.2.0,发布于前一天。Runner README 要求 Go 1.27 或更高版本,并在文档中使用 @latest;要做可复现的评估,应改用明确的版本标签。
下面的运行配置选择 OpenAI、当前源码默认模型 gpt-6-astra,并将推理等级设为 high。如果更换模型,务必记录下来。请在 my-project 的一次性副本上运行:
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonl
Runner 还支持 openai-codex、openrouter、fireworks 和 ollama。每次请求都可以指定模型、推理等级、重试次数、会话 ID、系统提示词,以及需要排除的工具。目前无法通过 extra_allowed_tools 添加任意工具,因为该字段虽然会被接收,但实际会被忽略。
3. 把运行结果当作证据来读
一份有用的评估记录应包含六部分:
持久化会话位于 unreal-sessions/repo-summary-v1.session.jsonl。使用相同的 session_id 可以继续该会话;需要做干净对比时则应换一个新 ID,否则此前的上下文可能同时影响质量与成本。
本文没有声称任何一手性能结果,因为并未完成调用真实提供商的运行。唯一可信的性能数字,是你在自己的仓库上实际记录下来的数字。
该选 Runner 还是 Go 库?
测试提示词、评估仓库任务或接入 CI 时,选择 Runner。只有当智能体必须成为产品内部能力,而且团队准备好自行负责会话存储、生命周期、工具、安全与提供商集成时,才选择 Go 库。
两者的区别就像成品电动工具与里面的电机。Runner 已经装好了可直接操作的开关;库则把电机交给你,让你自行设计外壳、控制方式和安全系统。如果关键问题在于会话由谁管理,这篇 Agents API 与 SDK 对比 可以提供相邻领域的判断框架。
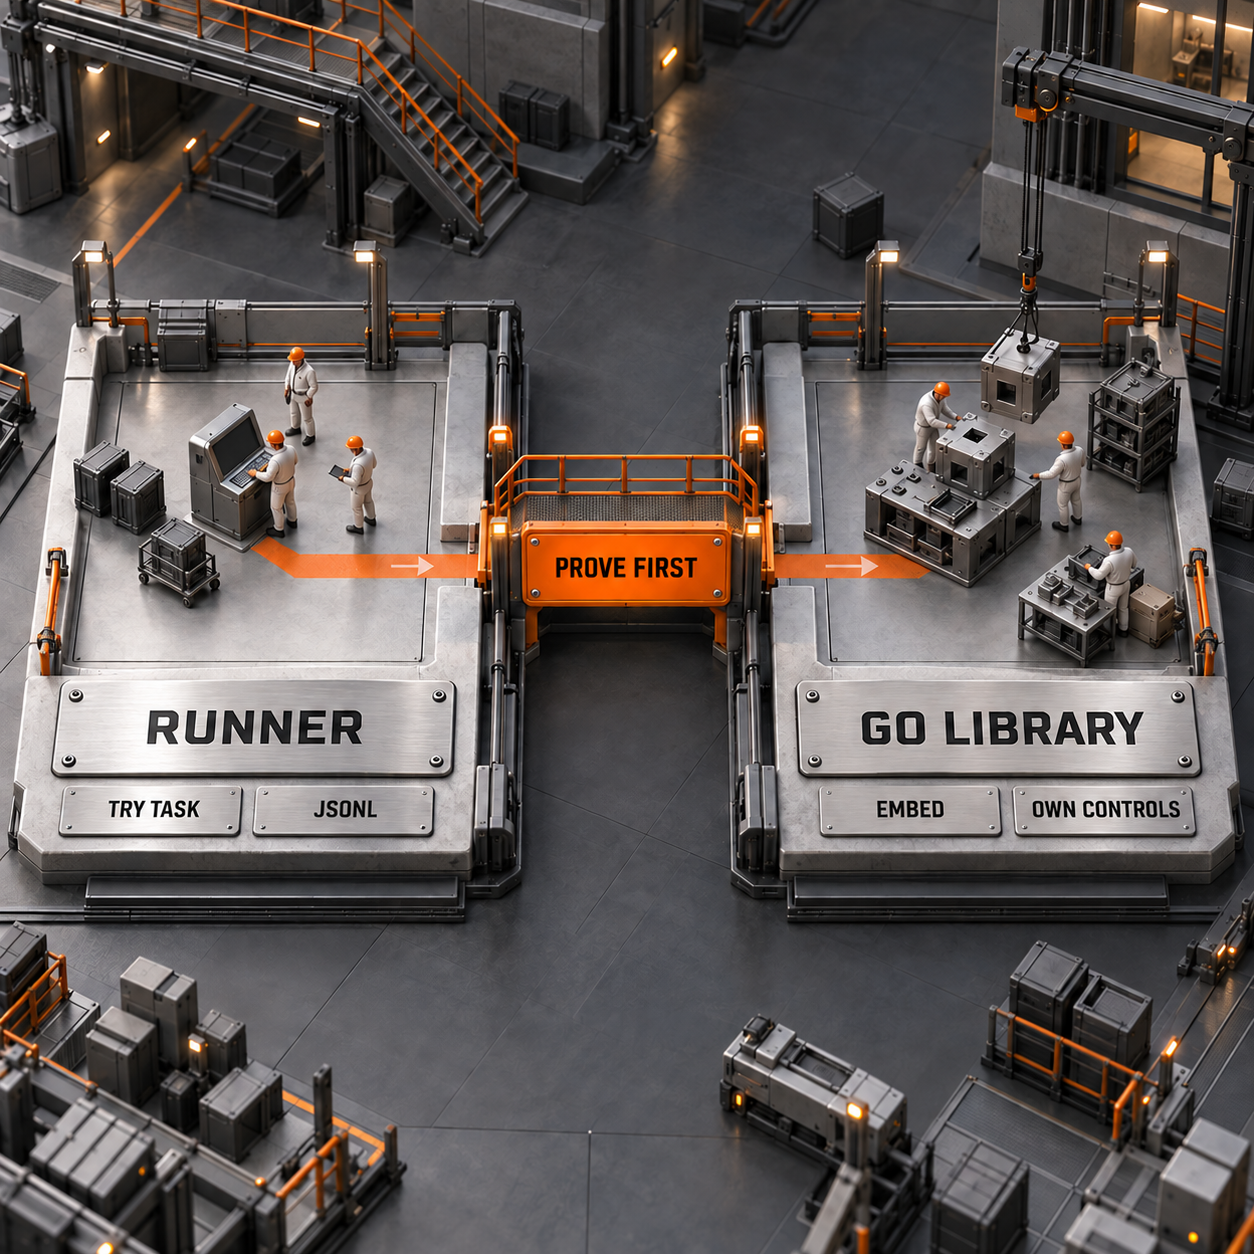
默认应先用 Runner,因为集成工作很容易掩盖任务本身的问题。如果同一条边界明确的提示词连续两次都得不到有用结果,套一层 API 也救不了这个产品思路。
AI 编程智能体最值得测试的六类任务
1. 初审由智能体生成的拉取请求
面对大型 AI 生成拉取请求的工程团队,可以把干净的检出副本、diff 和仓库测试命令交给 Runner。它可以检查受影响的代码、运行有针对性的验证,并返回一份由 JSONL 记录支撑的审查材料。价值不在于取消人工审查,而在于把重复性的仓库检查提前完成,让审查者把注意力留给架构与风险。
2. 帮助新工程师熟悉仓库
每当新工程师加入某项服务时,平台团队都可以运行上面的同一条概览提示词。输出会梳理入口、测试命令、配置和明显隐患,同时保留可供核验的会话轨迹。这样,新人入职后的第一个小时就有了可重复的流程,也不必每次都让资深工程师从头讲解同一个仓库。
3. 定位失败测试
遇到输出嘈杂的 CI 失败时,开发者可以要求 Runner 复现其中一个失败测试,搜索相关代码路径,并把可能的原因与无关输出区分开来。异步工具处理在这里很有价值,因为环境初始化、搜索和测试执行可以重叠进行。最终收益是一份更精炼的证据材料,交给真正负责修复的工程师。
4. 为依赖升级做准备
维护者可以让智能体检查只包含一次依赖版本升级的分支,并要求它列出受影响的导入、已弃用调用、测试覆盖和迁移说明。输出应当成为检查清单,而不是自动合并的依据。这样,在投入完整工程时间之前就能更快评估工作范围。
5. 检查发布就绪度
发布负责人可以要求它检查候选版本中发生变化的范围、缺失的迁移、文档空白,以及相关测试命令。会话记录会保留智能体实际检查过的内容。其价值是一套一致的发布前检查,用来补充确定性的 CI,而不是取代它。
6. 整理支持升级材料
产品工程师可以把可复现的客户问题放入经过脱敏的仓库环境,让 Runner 追踪可能的代码路径、复现现象,并列出尚未解决的问题。这样,无需授予智能体访问客户生产系统的权限,也能生成从支持团队交接给工程团队的结构化材料。
两个值得基于它打造的产品
最强方向:AI 代码审查门禁
可以做成一个 GitHub 或 GitLab 检查:在隔离工作区内启动 Unreal Agent,依据仓库规则审查拉取请求,执行允许的检查,然后向人工审查者发布一份带证据链接的摘要。目标客户是正在用智能体产出更多代码的团队。
需求很直接。ai powered code review platform 在美国每月约有 1,900 次搜索,ai code review 约有 1,300 次,后者 CPC 为 $55.73。现有产品也印证了付费预算的存在:按年付费时,每位开发者每月的席位价格为 $20 至 $72。
最小可售版本只需支持一个代码托管平台、一个模型提供商、一套固定审查提示词、严格的命令允许列表,以及基于 JSONL 轨迹生成的结果页。真正的难点是信任。误报、密钥泄露、噪声评论和不安全命令都可能迅速抵消产品价值。尽管如此,它仍是最佳机会,因为使用频率高、效果可衡量,而且对应现成预算。
可自带模型的仓库任务 Runner
可以搭建一个轻量内部控制面,让团队选择仓库、经过审核的任务模板、提供商、模型与成本上限,然后拿到会话轨迹和可提交审批的结果。对于希望采用开放运行时、但不想自行开发队列、隔离与报告层的代理机构和平台团队,这项服务具备付费价值。
open source ai coding agent 在美国每月约有 5,400 次搜索,具有商业意图,CPC 为 $13.11。这说明“开源 AI 编程智能体”的需求面比代码审查查询更广,但对应的产品诉求也不够具体。
MVP 包括仓库连接器、临时工作区、两套任务模板、提供商配置、任务状态、Token 报告和可下载的 JSONL。难点在于差异化:给一个早期运行时套上简单控制台很容易被复制,而成熟买家会要求身份控制、审计日志、网络策略和可靠的清理机制。竞争优势应来自具体工作流和运营控制,而不是产品名称。
Unreal Agent 解决不了什么
它没有提供完整的生产级安全边界。工作区参数不是沙箱,内置 Bash 工具可以在你提供的环境中执行操作。隔离、网络策略、凭据、审批与清理仍然由使用者负责。
它也无法消除不同提供商之间的差异。Unreal Labs 表示,在测试期间,某些非 OpenAI 推理提供商上的部分模型会拒绝“进行中结果加最终结果”的工具返回模式。上线前必须验证实际要使用的提供商与模型组合。
它不提供复杂编排。没有子智能体或工作流的小体积设计,本来就是其效率论点的一部分。如果产品依赖可视化工作流搭建器、大量托管连接器,或开箱即用的专家智能体委派机制,它就不合适。
它同样无法证明你的工作负载一定能省钱。模型选择、推理强度、缓存行为、工具输出、重试次数和任务成功率都会影响账单。要比较的是成功完成的任务,而不是不同配置下的原始 Token 总数。
周一就做这一步
周一,平台工程师应固定使用 v0.2.0,准备一份不含凭据的仓库副本,并在相同模型与推理等级下把仓库概览任务运行两次。保留 JSONL、会话文件、退出状态、耗时、Token 用量和仓库 diff。如果两次结果都有用且仓库保持干净,再用当前智能体重复同一任务。到这一步之后,再决定是测试代码审查工作流,还是把库嵌入产品。
Unreal Agent 是什么?
Unreal Agent 是 Unreal Labs 推出的异步优先 Go 智能体运行时,包括 Go 库、可安装的命令行 Runner,以及兼容 Harbor 的基准测试 Runner。它与 Epic Games 的 Unreal Engine 无关。
运行 Unreal Agent 需要准备什么?
从源码安装时,需要 Go 1.27 或更高版本、一个工作区、受支持的提供商配置、一个模型,以及提供商要求的凭据。Runner 支持 OpenAI、OpenAI Codex、OpenRouter、Fireworks 和 Ollama。
Unreal Agent 能继续之前的会话吗?
可以。在 JSON 请求中设置 session_id。复用该 ID 会继续已经持久化的会话;使用新 ID 则创建全新会话。
工作区参数能把智能体隔离在沙箱里吗?
不能。它只负责选择工作区和 Bash 工作目录。请把进程放在独立沙箱或一次性环境中,并在那里限制凭据与网络访问。
Unreal Agent 比 Codex 更便宜吗?
Unreal Labs 表示,在其工作负载和已发布的基准测试中,相比 Codex 最多可节省 40%。这是厂商结果,不是保证。得出成本结论前,应在相同模型、推理等级、提示词、仓库状态和成功标准下进行比较。
如果希望围绕自己的工作流构建受控的仓库智能体,可以从 AI 智能体开发 开始。
- 最近更新
- 2026年9月24日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。

Cursor 价格拆解:Rollouts 免费吗,试用额度怎么算?
想弄清 Cursor 价格?Rollouts 并非免费功能,仅 Teams(每位用户每月 $40)和定制报价的 Enterprise 可用。本文拆解 10 天上线额度、Teams 约 50 次与 Enterprise 约 500 次变更、尚未公布的后续单价,以及启用前必须核对的计费字段、遥测条件和支出控制。2026年9月24日Build
JetBrains Air 教程:从首次会话到代码审查
这篇 JetBrains Air 教程带你在 JetBrains IDE 中安装 Air Alpha、连接编码智能体、添加项目上下文,并用 Standard Access 完成首次小改动。逐文件检查 diff、亲自复跑测试,再决定保留、修改、提交或回退,同时看清免费插件与智能体订阅、API 用量和人工审查成本的边界。2026年9月23日Build
JetBrains Air 免费吗?插件、Agent 与 AI 成本详解
JetBrains Air 免费吗?Air Alpha IDE 插件价格为 $0,但宿主 IDE、编程 Agent、第三方 API 与 JetBrains AI Credits 仍可能收费。本文拆解 Junie Lite 免费期、四种授权路径和约 27 Credits 的订阅分界,帮你确认每次会话由哪个账户付费。2026年9月23日Build
Firecrawl 自托管实战:部署、验证与成本账
从固定版本开始完成 Firecrawl 自托管:按 v2.11.162 部署 Docker Compose,用真实抓取和重启复测保存证据,并对照 Firecrawl Cloud 的功能边界与 30 天成本。文中提供可复用的验证脚本、适用团队清单和成本工作表,帮助你判断基础设施控制权是否值得首月 $725.20 的投入。2026年9月22日Build
AI Agent 付费重试怎么管:把购买权限交还给人
一套已有两道人审关卡的视频工作流,仍让 AI Agent 在自检失败后自行重做;等人查看时,所有者密钥下已产生 $5.48 费用。本文拆解漏洞为何出在“再次购买”的权限边界,并给出可执行的控制方案:审查只记录问题,由人批准重试,付费渲染函数在调用前校验并消费许可,防止模型把自己的重做建议变成付款授权。2026年9月22日Build
MindStudio 评测:AI智能体开发平台值不值得用?
这篇 MindStudio 评测拆解其 AI 智能体开发平台的工作流、模型选择、集成、人工审核与测试能力,并核对 Free、Individual 和 Business 方案。文中按 1,000 与 10,000 个任务测算模型、审核和搭建成本,说明个人开发者、团队与自动化场景应如何判断是否值得试用。2026年9月22日Build
Wispr Flow 与 Superwhisper 怎么选:价格、隐私与团队功能对比
Wispr Flow 和 Superwhisper 该怎么选?本文从价格、离线能力、隐私边界、团队协作和平台支持逐项对比,并给出 20 句纠错测试方案。Superwhisper 更适合需要本地处理和灵活模型配置的个人,Wispr Flow 则更适合重视共享词典、集中计费与云端工作流的团队。2026年9月22日Build