Agente de IA para programar: guía práctica de Unreal Agent
Prueba este agente de IA para programar en un repositorio controlado: configura el runner, conserva el JSONL y mide seguridad, costo y resultados.


Unreal Agent permite ejecutar desde la línea de comandos una tarea en un repositorio, guardar la sesión completa en JSONL y decidir si vale la pena incorporar a una aplicación su gestión asíncrona de herramientas. Si está evaluando un agente de IA para programar, conviene aclarar que este es el nuevo runtime de agentes en Go de Unreal Labs, no un asistente de Unreal Engine. La primera prueba debería ser un resumen del repositorio en modo de solo lectura: registre el modelo, el nivel de razonamiento, el tiempo transcurrido, el estado de salida, el consumo de tokens y los archivos modificados; después, compare esas pruebas con los resultados de su agente actual.
Qué es realmente Unreal Agent
Unreal Agent ocupa la capa intermedia entre el modelo y las herramientas que ejecutan el trabajo. Se parece al responsable de una obra: el modelo decide qué hay que hacer, mientras el runtime distribuye los comandos, registra lo ocurrido y determina cuándo debe recibir cada resultado.
Su rasgo distintivo es la ejecución asíncrona de herramientas. Cuando el modelo invoca una herramienta, el runtime deja constancia de que la tarea sigue en curso y permite que continúe en segundo plano. Al terminar, incorpora el resultado definitivo a la sesión y vuelve a llamar al modelo. Así, un comando de configuración lento no tiene por qué bloquear otras tareas útiles ni un nuevo mensaje con instrucciones.
Unreal Labs lanzó el proyecto el 22 de septiembre de 2026. El SDK incluye una biblioteca para Go, un runner instalable y un runner de benchmarks compatible con Harbor. El repositorio utiliza la licencia MIT.
Unreal Labs afirma que sus cargas de trabajo en producción y los benchmarks de agentes publicados reducen el costo hasta un 40% frente a Codex y hasta un 20% frente a Pi. Son resultados del proveedor, no un descuento aplicable a cualquier entorno. El mecanismo propuesto sí merece una prueba: un prompt más compacto, resultados de herramientas resumidos, ausencia de subagentes o workflows y más trabajo con herramientas entre llamadas al modelo. Pero el porcentaje carece de valor hasta comparar el mismo modelo, nivel de razonamiento, prompt, estado del repositorio y criterio de éxito.
La cuenta del negocio empieza por la tarea, no por el benchmark
El runner no cobra una licencia por usuario gracias a la licencia MIT, pero operarlo sí cuesta dinero. Hay que pagar las llamadas al modelo, el cómputo, el aislamiento, la integración, los registros y el trabajo del ingeniero que mantiene el sistema confiable.
Los precios de las herramientas de revisión de código permiten ver el presupuesto al que podría aspirar. Graphite publica su plan Starter a $20 por usuario al mes y Team a $40, con facturación anual. CodeRabbit ofrece precios anuales de $24, $48 y $72 por desarrollador al mes. En un equipo de 10 desarrolladores, ese rango publicado equivale a entre $200 y $720 mensuales.
Eso no convierte a Unreal Agent en un sustituto directo de ninguno de esos productos. Para un equipo de plataforma, ofrece un runtime abierto sobre el cual construir un único flujo interno bien delimitado. La prueba económica es sencilla: compare el costo mensual completo de ese flujo —incluidos el modelo y el mantenimiento— con el presupuesto por usuario o las horas de ingeniería que reemplaza. Si no puede medir el costo por tarea completada, cualquier promesa de ahorro es solo adorno.
Cómo probar un agente de IA para programar en un repositorio
Empiece por el runner. La biblioteca es para equipos que ya saben qué comportamiento del agente necesitan integrar en su aplicación.
1. Aísle el repositorio con una barrera real
-workspace selecciona el directorio de trabajo del agente y de su herramienta Bash. La documentación no lo presenta como un sandbox de seguridad. Use un checkout desechable o un contenedor, elimine las credenciales de producción, limite el acceso a la red y entregue al proceso únicamente los tokens imprescindibles. Un prompt que diga «no modifiques archivos» es una instrucción, no una medida de control. Si es la primera vez que aborda este problema, comience por las opciones prácticas de sandboxes para agentes de IA.
Compruebe también si el espacio de trabajo contiene un archivo .env. El runner carga ese archivo desde el workspace seleccionado, por lo que una copia del repositorio todavía puede exponer credenciales olvidadas.
2. Fije el runner, el proveedor, el modelo y el nivel de razonamiento
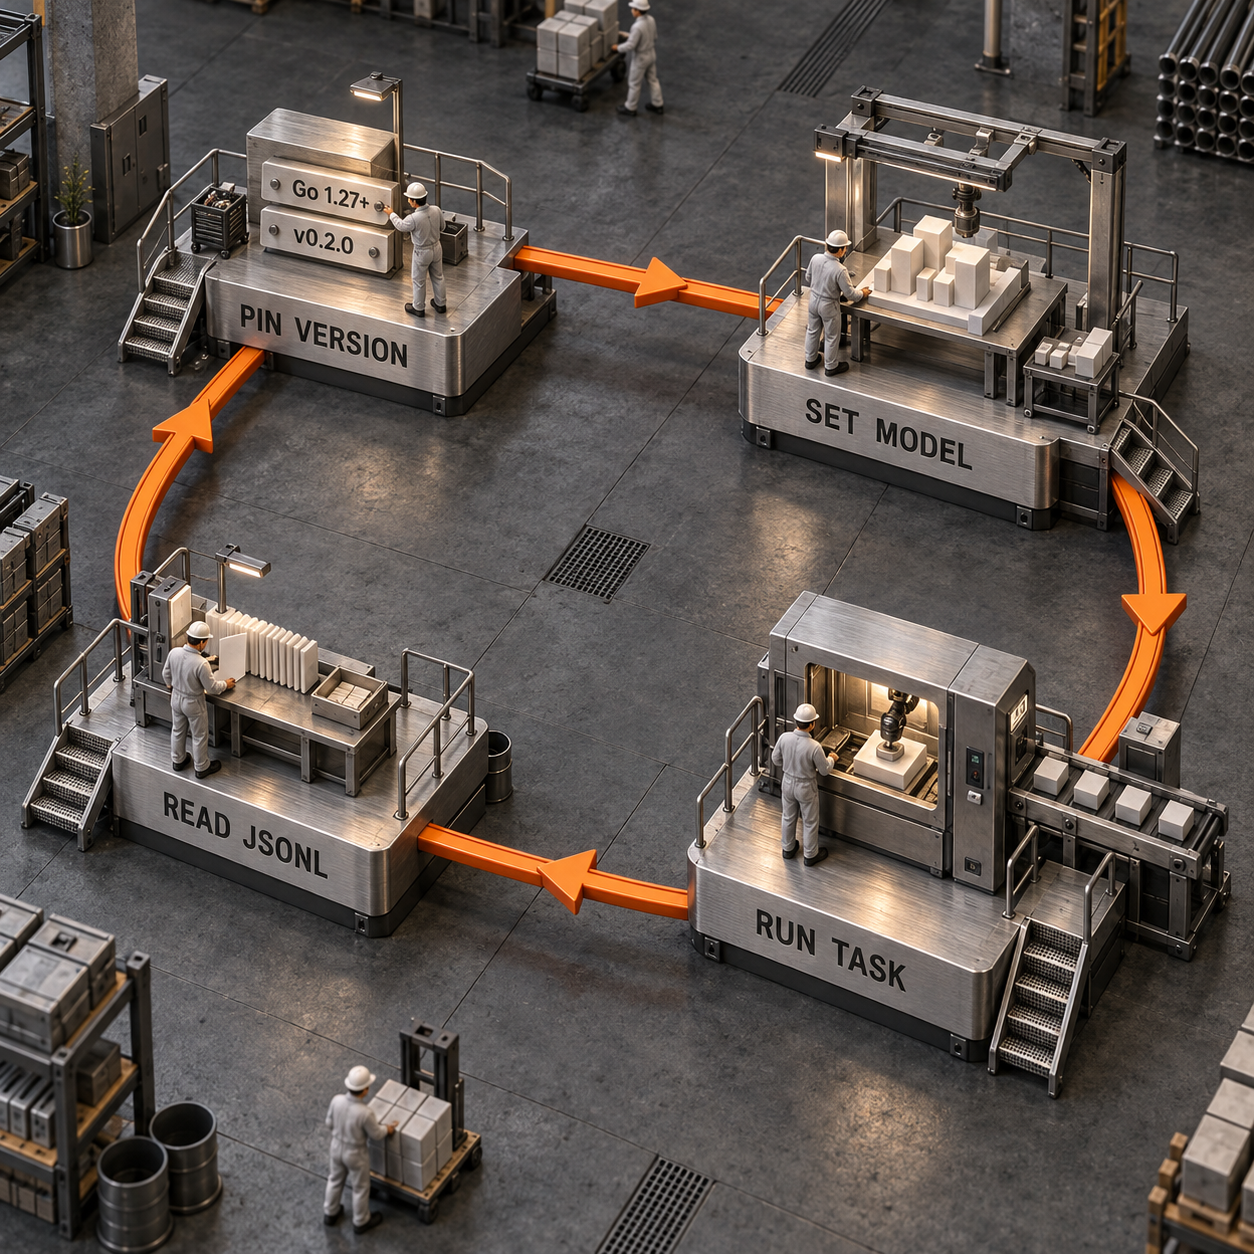
Al 24 de septiembre de 2026, la versión vigente es v0.2.0, publicada un día antes. El README del runner exige Go 1.27 o una versión posterior y documenta @latest; para una evaluación reproducible, use una etiqueta de versión.
La siguiente ejecución utiliza OpenAI, el valor predeterminado actual del código fuente gpt-6-astra y razonamiento high. Si sustituye el modelo, deje registrado cuál utilizó. Ejecute el ejemplo sobre una copia desechable de my-project:
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonl
El runner también admite openai-codex, openrouter, fireworks y ollama. Cada solicitud puede definir el modelo, el nivel de razonamiento, la cantidad de reintentos, el ID de sesión, el prompt del sistema y las herramientas que deben excluirse. Por ahora no puede añadir herramientas arbitrarias mediante extra_allowed_tools, porque el campo se acepta pero se ignora.
3. Trate la ejecución como evidencia
Un registro de evaluación útil reúne seis elementos:
La sesión persistente queda en unreal-sessions/repo-summary-v1.session.jsonl. Para continuarla, reutilice el mismo session_id. Cuando necesite una comparación limpia, use un ID nuevo; de lo contrario, el contexto anterior puede alterar tanto la calidad como el costo.
Aquí no se presenta un resultado de rendimiento propio porque no se completó una ejecución real con un proveedor. La única cifra honesta será la que obtenga en su propio repositorio.
¿Conviene usar el runner o la biblioteca?
Elija el runner para probar un prompt, evaluar una tarea sobre un repositorio o conectar un proceso con CI. Use la biblioteca de Go cuando el agente deba formar parte del producto y el equipo esté dispuesto a responsabilizarse del almacenamiento de sesiones, el ciclo de vida, las herramientas, la seguridad y la integración con proveedores.
La diferencia se parece a la que existe entre una herramienta eléctrica y su motor. El runner entrega una herramienta utilizable con los interruptores ya instalados. La biblioteca entrega el motor y la libertad para diseñar la carcasa, los controles y el sistema de seguridad. Si la propiedad de las sesiones inclina la decisión, esta comparación entre Agents API y SDK ofrece un marco complementario útil.
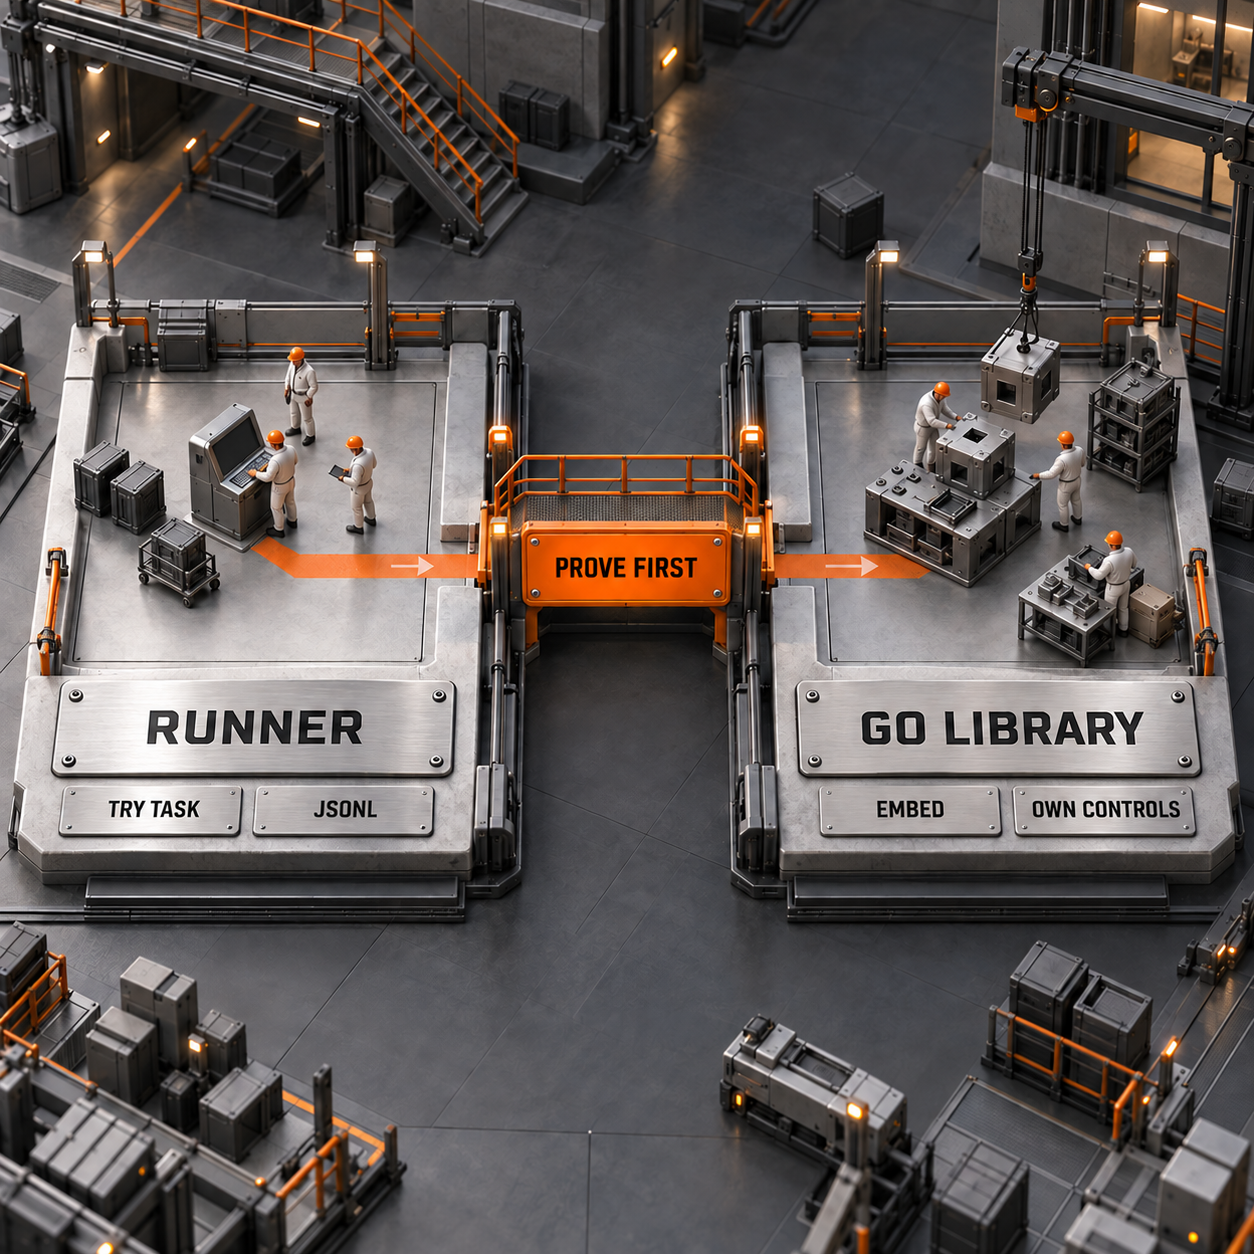
El runner es la opción inicial más sensata porque el trabajo de integración puede ocultar una tarea mal planteada. Si el mismo prompt acotado no logra producir dos veces un resultado útil, envolverlo en una API no corregirá la idea de producto.
Seis tareas que vale la pena probar, ordenadas por prioridad
1. Primera revisión de pull requests generados por agentes
Un equipo de ingeniería que reciba pull requests extensos generados por IA podría entregar al runner un checkout limpio, el diff y los comandos de prueba del repositorio. El agente podría inspeccionar el código afectado, ejecutar comprobaciones específicas y generar un paquete de revisión respaldado por la traza JSONL. El objetivo no es eliminar la revisión humana, sino adelantar la inspección repetitiva del repositorio para que el revisor concentre su atención en la arquitectura y el riesgo.
2. Orientación para ingenieros recién incorporados
Un equipo de plataforma podría ejecutar exactamente el prompt de resumen anterior cada vez que un ingeniero se incorpore a un servicio. El resultado mostraría los puntos de entrada, los comandos de prueba, la configuración y los riesgos evidentes, y conservaría la traza de sesión para poder verificarlo. El beneficio es disponer de una primera hora reproducible sin pedir a un ingeniero sénior que vuelva a explicar el mismo repositorio desde cero.
3. Diagnóstico de pruebas fallidas
Ante un fallo ruidoso de CI, un desarrollador podría pedir al runner que reproduzca una prueba concreta, examine las rutas de código pertinentes y separe la causa probable del ruido irrelevante. La ejecución asíncrona de herramientas resulta útil porque la preparación del entorno, las búsquedas y las pruebas pueden solaparse. El resultado es un paquete de evidencia más manejable para el ingeniero que resolverá el problema.
4. Preparación de actualizaciones de dependencias
Un responsable de mantenimiento podría dirigir el agente a una rama con una única actualización de dependencia y pedirle que identifique las importaciones afectadas, las llamadas obsoletas, la cobertura de pruebas y las notas de migración. El resultado sería una lista de comprobación, no una fusión automática. El beneficio está en acotar más rápido el trabajo antes de asignarle un bloque completo de ingeniería.
5. Comprobaciones previas a una versión
El responsable de una entrega podría solicitar las superficies modificadas, las migraciones ausentes, los vacíos de documentación y los comandos de prueba pertinentes sobre una versión candidata. El registro de sesión conserva lo que el agente inspeccionó realmente. Así se obtiene una comprobación previa coherente que complementa a CI determinista, en lugar de sustituirlo.
6. Paquetes de escalamiento para soporte
Un ingeniero de producto podría colocar un problema reproducible de un cliente en un entorno de repositorio depurado y pedir al runner que rastree las rutas de código probables, reproduzca el síntoma y enumere las dudas pendientes. El beneficio es una entrega estructurada de soporte a ingeniería sin dar al agente acceso a los sistemas de producción del cliente.
Dos productos que sí vale la pena construir
La apuesta más sólida: un control de revisión para código generado por IA
Cree una comprobación para GitHub o GitLab que ejecute Unreal Agent en un espacio aislado, revise el pull request conforme a las reglas del repositorio, ejecute las verificaciones permitidas y publique para un revisor humano un resumen enlazado con sus pruebas. El comprador es el equipo que ya produce más código con agentes.
La demanda es directa. ai powered code review platform registra cerca de 1,900 búsquedas mensuales en Estados Unidos, mientras que ai code review alcanza unas 1,300 y tiene un CPC de $55.73. Los productos actuales demuestran que existe un presupuesto anual equivalente a entre $20 y $72 por desarrollador al mes.
La versión vendible más pequeña admite un único alojamiento de código, un proveedor de modelos, un prompt de revisión fijo, una lista estricta de comandos permitidos y una página de resultados construida a partir de la traza JSONL. El reto es la confianza: los falsos positivos, la filtración de secretos, los comentarios ruidosos y los comandos inseguros pueden destruir el valor con rapidez. Aun así, sigue siendo la mejor oportunidad porque resuelve una tarea frecuente y medible vinculada a un presupuesto existente.
Un runner para tareas en repositorios con el modelo elegido por el cliente
Cree un pequeño plano de control interno donde el equipo elija un repositorio, una plantilla de tarea aprobada, un proveedor, un modelo y un límite de costo, y reciba después una traza de sesión y un resultado listo para aprobación. Las agencias y los equipos de plataforma que quieren un runtime abierto sin desarrollar las capas de colas, aislamiento e informes pagarían por este servicio.
open source ai coding agent registra cerca de 5,400 búsquedas mensuales en Estados Unidos, con intención comercial y un CPC de $13.11. Refleja una demanda más amplia que la consulta sobre revisión, aunque la necesidad del producto es menos concreta.
El MVP incluye un conector de repositorios, un workspace efímero, dos plantillas de tareas, la configuración del proveedor, el estado del trabajo, el informe de tokens y la descarga del JSONL. El reto es diferenciarse: un panel sencillo sobre un runtime nuevo es fácil de copiar, y los compradores serios exigirán controles de identidad, registros de auditoría, políticas de red y una limpieza confiable. La ventaja debe estar en un flujo concreto y en los controles operativos, no en el nombre del producto.
Lo que Unreal Agent no resuelve
No proporciona por sí solo una barrera completa para producción. El indicador de workspace no es un sandbox, y la herramienta Bash integrada puede actuar dentro del entorno asignado. El aislamiento, la política de red, las credenciales, las aprobaciones y la limpieza siguen siendo responsabilidad de quien lo opera.
Tampoco elimina las diferencias entre proveedores. Unreal Labs informa que, durante sus pruebas, algunos modelos de ciertos proveedores de inferencia distintos de OpenAI rechazaron el patrón que entrega primero un resultado de herramienta en curso y después el definitivo. Valide la combinación exacta de proveedor y modelo que pretende llevar a producción.
No ofrece una orquestación sofisticada. Su tamaño reducido, sin subagentes ni workflows, forma parte del argumento de eficiencia. Encaja mal cuando el producto depende de un editor visual de flujos, un catálogo amplio de conectores administrados o agentes especialistas delegados listos para usar.
Tampoco demuestra que su carga de trabajo vaya a ahorrar dinero. El modelo, el esfuerzo de razonamiento, el comportamiento de la caché, la salida de las herramientas, los reintentos y el éxito de la tarea afectan la factura. Compare tareas completadas con éxito, no totales brutos de tokens obtenidos con configuraciones diferentes.
Qué hacer el lunes
El lunes, un ingeniero de plataforma debería fijar v0.2.0, preparar una copia del repositorio sin credenciales y ejecutar dos veces la tarea de resumen con el mismo modelo y nivel de razonamiento. Debe conservar el JSONL, el archivo de sesión, el estado de salida, el tiempo transcurrido, el consumo de tokens y el diff del repositorio. Si ambas ejecuciones son útiles y no provocan cambios, repita la misma tarea con el agente actual. Solo entonces conviene decidir si se prueba un flujo de revisión o se integra la biblioteca.
¿Qué es Unreal Agent?
Unreal Agent es un runtime de agentes en Go de Unreal Labs diseñado desde el inicio para trabajar de forma asíncrona. Incluye una biblioteca de Go, un runner instalable para la línea de comandos y un runner de benchmarks compatible con Harbor. No tiene relación con Unreal Engine de Epic Games.
¿Qué se necesita para ejecutar Unreal Agent?
La instalación desde el código fuente requiere Go 1.27 o una versión posterior, un workspace, la configuración de un proveedor compatible, un modelo y las credenciales necesarias para ese proveedor. El runner admite OpenAI, OpenAI Codex, OpenRouter, Fireworks y Ollama.
¿Puede Unreal Agent reanudar una sesión?
Sí. Defina un session_id en la solicitud JSON. Si reutiliza el ID, el runner reanudará la sesión persistente; con un ID nuevo, iniciará otra sesión desde cero.
¿El indicador de workspace aísla al agente en un sandbox?
No. Solo selecciona el workspace y el directorio de trabajo de Bash. Ejecute el proceso dentro de un sandbox independiente o un entorno desechable, y restrinja allí las credenciales y el acceso a la red.
¿Unreal Agent es más barato que Codex?
Unreal Labs informa de un ahorro de hasta el 40% frente a Codex en sus cargas de trabajo y benchmarks publicados. Es un resultado del proveedor, no una garantía. Antes de sacar conclusiones sobre el costo, compare el mismo modelo, nivel de razonamiento, prompt, estado del repositorio y criterio de éxito.
Si necesita un agente de repositorio controlado y adaptado a su propio flujo de trabajo, el servicio de desarrollo de agentes de IA es el punto de partida adecuado.
- Última actualización
- 24 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Cursor gratis: cuánto cuesta Rollouts en realidad
¿Cursor gratis incluye Rollouts? No. Comparamos acceso, créditos de 10 días y costos de Teams y Enterprise para saber qué pagar después, sin sorpresas.24 sept 2026Build
JetBrains Air: guía práctica para usar Air Alpha
Instala JetBrains Air Alpha, conecta un agente, añade contexto del proyecto y revisa tu primer cambio de código con un flujo seguro y verificable.23 sept 2026Build
JetBrains Air gratis: qué incluye y quién paga el agente
El plugin JetBrains Air es gratis. Compara Junie Lite, suscripciones de agentes, cobro por API y créditos de JetBrains AI antes de elegir quién paga.23 sept 2026Build
Firecrawl Docker: cómo autohospedarlo y cuánto cuesta
Aprende a desplegar Firecrawl con Docker, verificar un scraping real y comparar el costo de autohospedarlo frente a Firecrawl Cloud durante 30 días.22 sept 2026Build
Agentes de IA: cuándo un reintento necesita aprobación humana
Un agente rechazó resultados y compró nuevas renderizaciones antes de la revisión humana. Así se impone aprobación en cada reintento de pago.22 sept 2026Build
MindStudio AI bajo la lupa: precios, funciones y límites
Analizamos MindStudio, sus precios y límites, y calculamos el costo real de crear agentes de IA sin código para flujos de trabajo empresariales.22 sept 2026Build
Superwhisper o Wispr Flow: qué herramienta de dictado conviene más
Compara Superwhisper y Wispr Flow en precio, privacidad, plataformas y correcciones para elegir la herramienta de dictado que mejor se adapta a cada trabajo.22 sept 2026Build