Unreal Agent : mettre un agent IA open source à l’épreuve
Installez et évaluez Unreal Agent, un agent IA open source en Go, sur une tâche de dépôt ciblée avant de l’intégrer à vos workflows de développement.


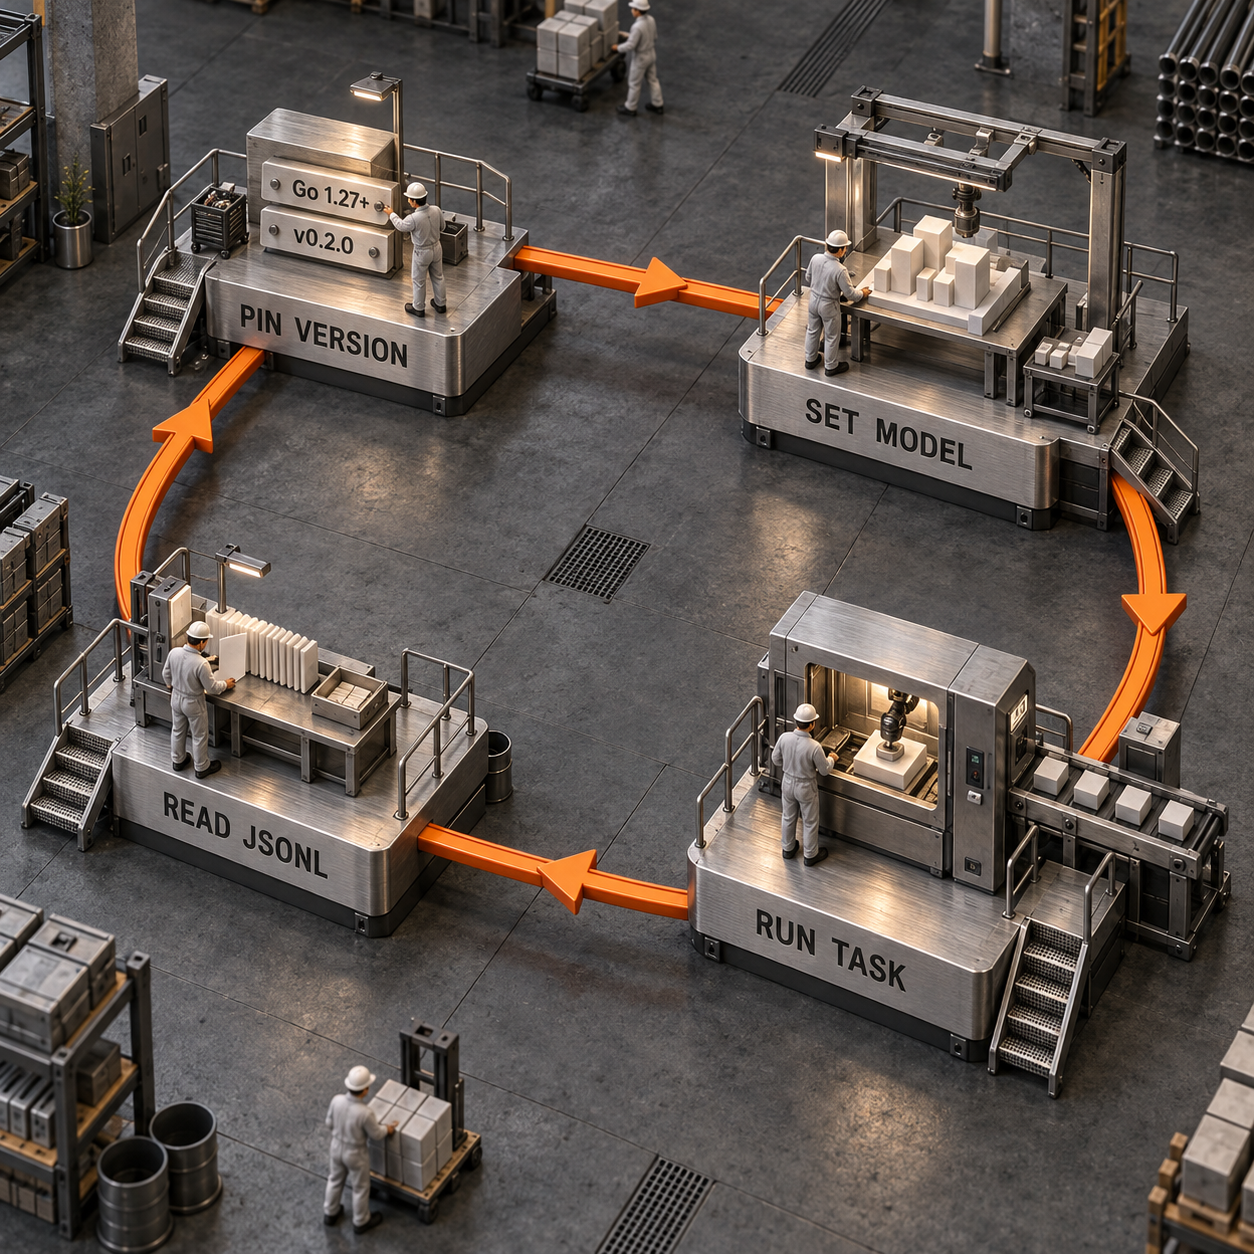
Unreal Agent permet de confier à un agent IA open source une tâche sur un dépôt depuis la ligne de commande, de conserver toute la session au format JSONL et de déterminer si sa gestion asynchrone des outils mérite d’être intégrée à votre propre application. Il s’agit du nouveau runtime d’agent en Go d’Unreal Labs, pas d’un assistant pour Unreal Engine. Commencez par produire un résumé du dépôt en lecture seule ; relevez le modèle, le niveau de raisonnement, la durée, le code de sortie, la consommation de tokens et les fichiers modifiés, puis confrontez ces éléments aux résultats de votre agent actuel.
À quoi sert réellement Unreal Agent ?
Unreal Agent fait le lien entre un modèle et les outils qui exécutent le travail. Imaginez un chef de chantier : le modèle décide de ce qu’il faut faire, tandis que le runtime distribue les commandes, consigne leur déroulement et choisit à quel moment présenter chaque résultat au modèle.
Sa particularité tient à l’exécution asynchrone des outils. Lorsqu’un modèle appelle un outil, le runtime indique que la tâche est en cours et la laisse s’exécuter en arrière-plan. Une fois l’opération terminée, il ajoute le résultat final à la session, puis sollicite de nouveau le modèle. Une longue commande de préparation ne bloque donc ni les autres travaux utiles ni l’arrivée de nouvelles instructions.
Unreal Labs a lancé le projet le 22 septembre 2026. Le SDK comprend une bibliothèque Go, un runner installable et un runner de benchmark compatible avec Harbor. Le dépôt est distribué sous licence MIT.
Unreal Labs annonce un coût inférieur jusqu’à 40% à celui de Codex et jusqu’à 20% à celui de Pi dans ses charges de production et les benchmarks d’agents publiés. Ce sont des résultats fournisseur, pas des économies transposables telles quelles. Le mécanisme avancé mérite néanmoins un test : un prompt plus compact, des résultats d’outils condensés, aucun sous-agent ni workflow, et davantage de travail effectué par les outils entre deux appels au modèle. Ces pourcentages ne signifient rien tant que le modèle, le niveau de raisonnement, le prompt, l’état du dépôt et les critères de réussite ne sont pas identiques.
Le calcul économique part de la tâche, pas du benchmark
Le runner n’impose aucun abonnement par utilisateur grâce à la licence MIT. Son exploitation n’est pas gratuite pour autant : il faut toujours financer les appels au modèle, le calcul, le sandboxing, l’intégration, les logs et le temps de l’ingénieur qui veille à la fiabilité du système.
Les tarifs des outils de revue de code donnent une idée du budget qu’il peut concurrencer. Graphite affiche l’offre Starter à $20 par utilisateur et par mois, et l’offre Team à $40, avec une facturation annuelle. CodeRabbit annonce des tarifs annuels de $24, $48 et $72 par développeur et par mois. Pour une équipe de 10 développeurs, cette fourchette publiée représente $200 à $720 par mois.
Unreal Agent ne devient pas pour autant un substitut immédiat à l’un ou l’autre de ces produits. Il fournit à une équipe plateforme un runtime ouvert sur lequel construire un workflow interne bien ciblé. Le test économique est simple : comparez le coût mensuel complet de ce workflow, dépenses de modèle et maintenance comprises, au budget des licences ou aux heures d’ingénierie qu’il remplace. Sans mesure du coût par tâche accomplie, l’argument d’économie reste décoratif.
Comment tester cet agent IA open source sur un dépôt
Commencez par le runner. La bibliothèque s’adresse aux équipes qui savent déjà quel comportement d’agent doit être intégré à leur application.
1. Placez le dépôt derrière une vraie barrière
-workspace définit le répertoire de travail de l’agent et de son outil Bash. La documentation ne le présente pas comme une sandbox de sécurité. Utilisez un checkout jetable ou un conteneur, retirez les identifiants de production, limitez l’accès réseau et ne transmettez au processus que les tokens indispensables. Demander dans un prompt de « ne modifier aucun fichier » reste une consigne, pas une protection. Si le sujet est nouveau pour vous, commencez par les solutions concrètes présentées dans ce comparatif des sandboxes pour agents IA.
Vérifiez aussi si l’espace de travail contient un fichier .env. Le runner charge celui du workspace sélectionné ; la copie d’un dépôt peut donc encore exposer des identifiants oubliés.
2. Épinglez le runner, le fournisseur, le modèle et le niveau de raisonnement
Au 24 septembre 2026, la version courante est v0.2.0, publiée la veille. Le README du runner exige Go 1.27 ou une version ultérieure et documente @latest ; pour une évaluation reproductible, préférez un tag de version.
L’exécution ci-dessous utilise OpenAI, le modèle actuellement défini par défaut dans le code source, gpt-6-astra, ainsi que le niveau de raisonnement high. Si vous changez de modèle, consignez cette modification. Lancez la commande sur une copie jetable de my-project :
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonl
Le runner prend également en charge openai-codex, openrouter, fireworks et ollama. Une requête peut définir le modèle, le niveau de raisonnement, le nombre de nouvelles tentatives, l’identifiant de session, le prompt système et les outils à exclure. À ce jour, elle ne peut pas ajouter d’outils arbitraires avec extra_allowed_tools, car ce champ est accepté mais ignoré.
3. Traitez chaque exécution comme un ensemble de preuves
Une évaluation exploitable comporte six volets :
La session persistée se trouve dans unreal-sessions/repo-summary-v1.session.jsonl. Réutilisez le même session_id pour poursuivre cette session. Choisissez un nouvel identifiant pour repartir de zéro lors d’une comparaison ; sinon, le contexte antérieur peut modifier à la fois la qualité et le coût.
Aucun résultat de performance de première main n’est avancé ici, car aucun test en direct auprès d’un fournisseur n’a été mené. Les seules mesures sincères sont celles relevées sur votre propre dépôt.
Faut-il choisir le runner ou la bibliothèque ?
Optez pour le runner afin de tester un prompt, d’évaluer une tâche sur un dépôt ou d’intégrer un processus à la CI. Choisissez la bibliothèque Go si l’agent doit vivre dans votre produit et si vous êtes prêt à prendre en charge le stockage des sessions, le cycle de vie, les outils, la sécurité et l’intégration du fournisseur.
La différence ressemble à celle qui sépare un outil électroportatif de son moteur. Le runner fournit un outil utilisable, déjà équipé de ses commandes. La bibliothèque livre le moteur et la liberté de concevoir le boîtier, les contrôles et le dispositif de sécurité. Si la maîtrise des sessions détermine votre choix, ce comparatif entre Agents API et SDK apporte un cadre complémentaire utile.
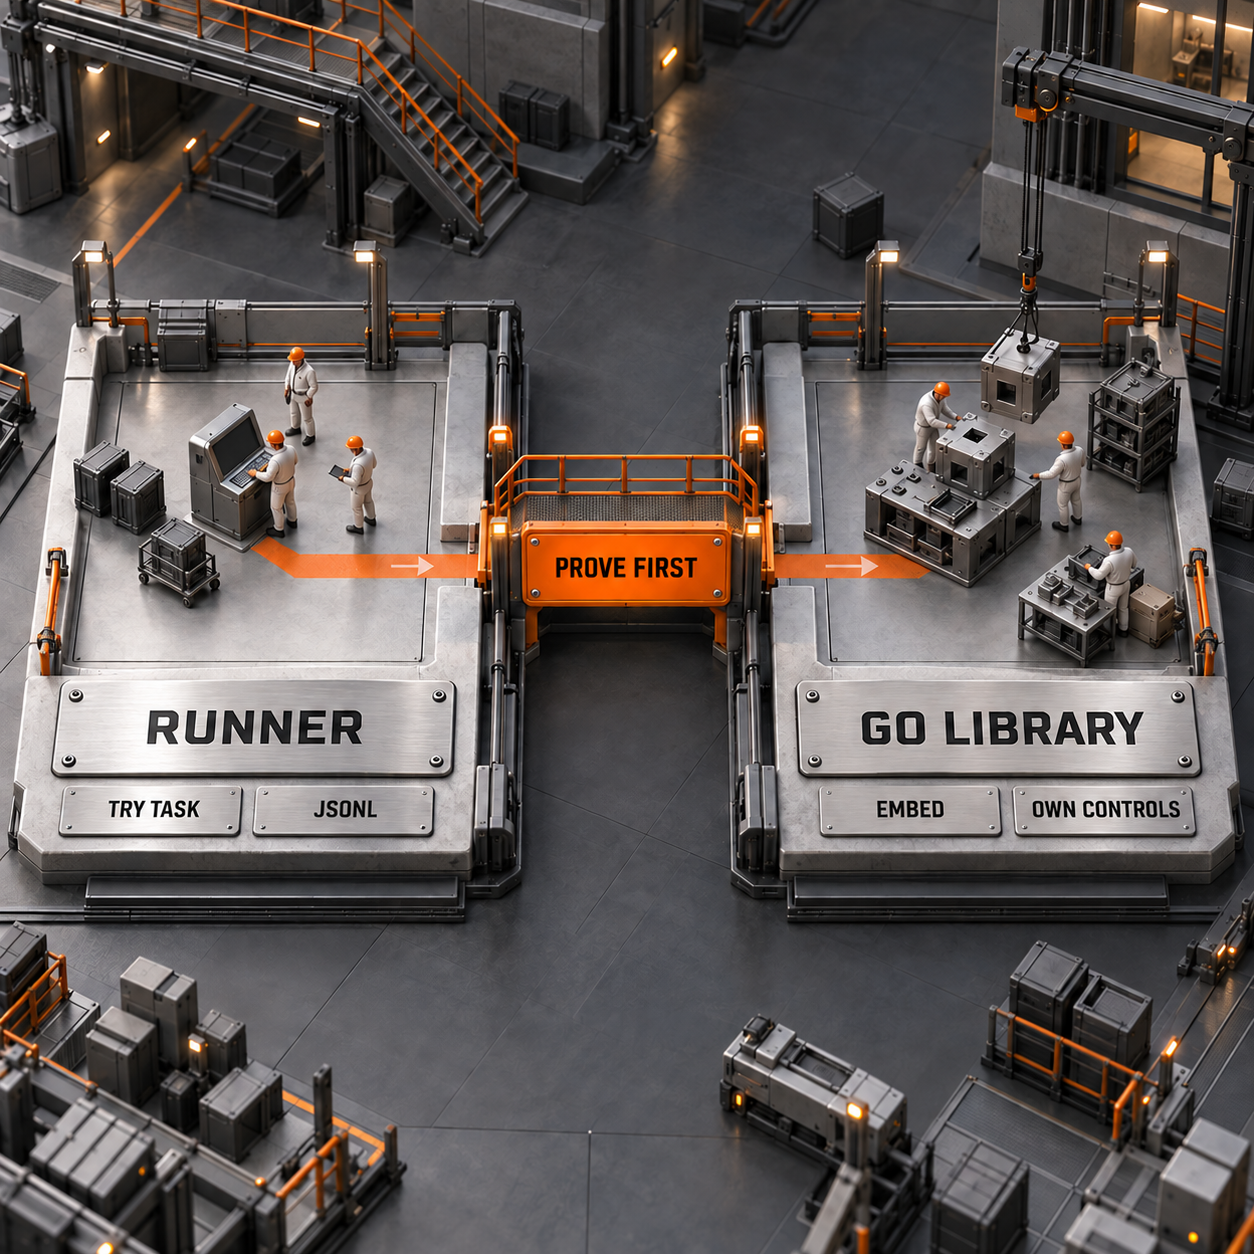
Le runner constitue le meilleur point de départ, car le travail d’intégration peut masquer une tâche mal choisie. Si un même prompt bien délimité ne produit pas deux fois un résultat utile, une surcouche API ne sauvera pas l’idée de produit.
Six cas d’usage à tester, classés par priorité
1. Première revue des pull requests écrites par des agents
Une équipe d’ingénierie confrontée à de volumineuses pull requests générées par IA pourrait fournir au runner un checkout propre, le diff et les commandes de test du dépôt. Il examinerait le code touché, lancerait les contrôles ciblés et produirait un dossier de revue adossé à une trace JSONL. Il ne s’agit pas de supprimer la revue humaine, mais d’effectuer en amont l’inspection répétitive du dépôt afin que le reviewer se concentre sur l’architecture et les risques.
2. Prise en main du dépôt par un nouvel ingénieur
Une équipe plateforme pourrait exécuter exactement le prompt de synthèse ci-dessus à chaque arrivée sur un service. Le résultat cartographierait les points d’entrée, les commandes de test, la configuration et les dangers évidents, avec la trace de session disponible pour vérification. Le bénéfice : une première heure reproductible, sans obliger un ingénieur senior à présenter le même dépôt depuis le début.
3. Diagnostic d’un test en échec
Face à un échec de CI particulièrement bruyant, un développeur pourrait demander au runner de reproduire un test précis, d’explorer les chemins de code concernés et de distinguer la cause probable du bruit sans rapport. La gestion asynchrone prend ici tout son sens, car la préparation de l’environnement, les recherches et l’exécution des tests peuvent se chevaucher. Le développeur chargé de corriger le problème reçoit ainsi un dossier de preuves plus concis.
4. Préparation d’une mise à niveau de dépendance
Un mainteneur pourrait diriger l’agent vers une branche qui ne contient qu’une mise à jour de dépendance, puis lui demander les imports touchés, les appels obsolètes, la couverture de tests et les notes de migration. Le résultat devient une checklist, pas une fusion automatique. Le gain se situe dans le cadrage rapide, avant de mobiliser un bloc complet de temps d’ingénierie.
5. Contrôles avant publication d’une version
Le responsable d’une release pourrait demander, sur une version candidate, les surfaces modifiées, les migrations absentes, les lacunes documentaires et les commandes de test pertinentes. L’historique de session conserve précisément ce que l’agent a inspecté. On obtient un contrôle préalable homogène qui complète la CI déterministe au lieu de la remplacer.
6. Dossiers d’escalade pour le support
Un ingénieur produit pourrait placer un incident client reproductible dans un environnement de dépôt expurgé, puis demander au runner de suivre les chemins de code probables, de reproduire le symptôme et de lister les questions non résolues. Le support transmet alors un dossier structuré à l’ingénierie, sans donner à un agent l’accès aux systèmes de production du client.
Deux produits qui méritent d’être construits
Le meilleur pari : un sas de revue pour le code généré par IA
Construisez un contrôle GitHub ou GitLab qui lance Unreal Agent dans un espace de travail isolé, examine la pull request à l’aune des règles du dépôt, exécute les vérifications autorisées et publie une synthèse reliée aux preuves à destination d’un reviewer humain. Les acheteurs sont les équipes qui produisent toujours plus de code avec des agents.
La demande est tangible. ai powered code review platform totalise environ 1,900 recherches mensuelles aux États-Unis, tandis que ai code review en compte environ 1,300, avec un CPC de $55.73. Les produits existants confirment l’existence d’un budget de $20 à $72 par développeur et par mois sur leurs abonnements annuels.
La plus petite version commercialisable prend en charge un hébergeur de code, un fournisseur de modèle, un prompt de revue fixe, une liste stricte de commandes autorisées et une page de résultats construite à partir de la trace JSONL. Le point critique reste la confiance. Faux positifs, fuites de secrets, commentaires parasites et commandes dangereuses peuvent rapidement anéantir la valeur. C’est malgré tout la meilleure piste : son usage est fréquent, mesurable et rattaché à un budget existant.
Un runner de tâches sur dépôt compatible avec le modèle de votre choix
Construisez un petit plan de contrôle interne où une équipe sélectionne un dépôt, un modèle de tâche validé, un fournisseur, un modèle et un plafond de coût, puis récupère une trace de session et un résultat prêt à être approuvé. Les agences et les équipes plateforme qui recherchent un runtime ouvert, sans vouloir bâtir elles-mêmes la file d’attente, l’isolation et le reporting, seraient prêtes à payer.
open source ai coding agent génère environ 5,400 recherches mensuelles aux États-Unis, avec une intention commerciale et un CPC de $13.11. La demande est plus large que pour la requête liée à la revue, mais le besoin produit est moins précis.
Le MVP comprend un connecteur de dépôt, un espace de travail éphémère, deux modèles de tâche, la configuration du fournisseur, le statut des jobs, le suivi des tokens et le téléchargement du JSONL. La différenciation est le principal écueil. Un simple tableau de bord posé sur un runtime encore jeune se copie facilement, tandis que les acheteurs sérieux exigeront la gestion des identités, des journaux d’audit, des règles réseau et un nettoyage fiable. La victoire passera par un workflow précis et des contrôles d’exploitation solides, pas par le nom du produit.
Ce qu’Unreal Agent ne résout pas
Il ne fournit pas à lui seul une barrière de production complète. Le paramètre de workspace n’est pas une sandbox, et l’outil Bash intégré peut agir dans l’environnement mis à sa disposition. L’isolation, les règles réseau, les identifiants, les approbations et le nettoyage restent à votre charge.
Il n’efface pas les différences entre fournisseurs. Unreal Labs indique que, durant ses tests, certains modèles servis par des fournisseurs d’inférence autres qu’OpenAI ont rejeté le schéma qui associe un résultat d’outil « en cours » à son résultat final. Validez exactement le couple fournisseur-modèle que vous envisagez de déployer.
Il ne propose pas d’orchestration sophistiquée. Son faible encombrement, sans sous-agents ni workflows, fait partie de son argument d’efficacité. Il convient mal aux produits qui dépendent d’un éditeur visuel de workflows, d’un vaste catalogue de connecteurs gérés ou d’agents spécialistes délégués disponibles immédiatement.
Enfin, il ne démontre aucune économie pour votre propre charge de travail. Le choix du modèle, l’effort de raisonnement, le comportement du cache, les sorties d’outils, les nouvelles tentatives et la réussite de la tâche influent tous sur la facture. Comparez le coût des tâches accomplies avec succès, pas des totaux bruts de tokens obtenus avec des réglages différents.
L’action à mener lundi
Lundi, un ingénieur plateforme devrait épingler v0.2.0, préparer une copie de dépôt sans identifiants et lancer deux fois la tâche de synthèse avec le même modèle et le même niveau de raisonnement. Conservez le JSONL, le fichier de session, le code de sortie, la durée, la consommation de tokens et le diff du dépôt. Si les deux résultats sont utiles et propres, reproduisez la même tâche avec l’agent actuel. Vous pourrez alors décider s’il vaut la peine de tester un workflow de revue ou d’intégrer la bibliothèque.
Qu’est-ce qu’Unreal Agent ?
Unreal Agent est un runtime d’agent en Go, conçu autour de l’asynchronisme par Unreal Labs. Il comprend une bibliothèque Go, un runner en ligne de commande installable et un runner de benchmark compatible avec Harbor. Il n’a aucun lien avec Unreal Engine d’Epic Games.
De quoi ai-je besoin pour exécuter Unreal Agent ?
Pour l’installer depuis le code source, il faut Go 1.27 ou une version ultérieure, un workspace, la configuration d’un fournisseur pris en charge, un modèle et les identifiants éventuellement requis par ce fournisseur. Le runner accepte OpenAI, OpenAI Codex, OpenRouter, Fireworks et Ollama.
Unreal Agent peut-il reprendre une session ?
Oui. Définissez un session_id dans la requête JSON. Réutiliser cet identifiant reprend la session persistée ; un nouvel identifiant crée une session vierge.
Le paramètre de workspace isole-t-il l’agent ?
Non. Il sélectionne le workspace et le répertoire de travail de Bash. Exécutez le processus dans une sandbox séparée ou un environnement jetable, puis limitez-y les identifiants et l’accès réseau.
Unreal Agent coûte-t-il moins cher que Codex ?
Unreal Labs annonce jusqu’à 40% d’économie par rapport à Codex dans ses charges de travail et benchmarks publiés. Il s’agit d’un résultat fournisseur, pas d’une garantie. Avant toute conclusion sur les coûts, comparez le même modèle, le même niveau de raisonnement, le même prompt, le même état du dépôt et les mêmes critères de réussite.
Pour faire construire un agent de dépôt contrôlé autour de votre propre workflow, découvrez notre service de développement d’agents IA.
- Dernière mise à jour
- 24 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Cursor gratuit ? Rollouts reste payant après les crédits
Cursor Rollouts n’est pas gratuit : accès dès Teams à $40 par utilisateur, crédits de 10 jours et tarif d’usage encore non publié. Voici quoi vérifier.24 sept. 2026Build
JetBrains Air : prendre en main le plugin Alpha pas à pas
Découvrez comment installer JetBrains Air Alpha, connecter un agent de codage, cibler le bon contexte et valider chaque modification dans votre IDE.23 sept. 2026Build
JetBrains Air à $0 : qui paie vraiment les agents ?
Le plugin JetBrains Air est gratuit, mais chaque agent suit sa propre facturation. Comparez Junie Lite, abonnements, API et crédits JetBrains AI.23 sept. 2026Build
Firecrawl Docker : auto-hébergement, vérification et coûts réels
Déployez Firecrawl avec Docker, validez un vrai scrape et comparez sur 30 jours le coût réel de l’auto-hébergement à celui de Firecrawl Cloud.22 sept. 2026Build
Agent IA : pourquoi un retry payant exige une validation humaine
Un agent IA a relancé des rendus payants sans accord humain. Voici où placer le contrôle qui sépare diagnostic, autorisation et décision de dépense.22 sept. 2026Build
MindStudio : créer un agent IA no code, à quel prix ?
MindStudio vaut-il le détour pour créer un agent IA ? Analyse des workflows, tarifs, limites et coûts réels pour 1,000 ou 10,000 tâches terminées.22 sept. 2026Build
Logiciel de dictée vocale : Superwhisper ou Wispr Flow ?
Superwhisper ou Wispr Flow ? Comparez prix, confidentialité, plateformes et fonctions d’équipe pour choisir le logiciel de dictée vocale adapté.22 sept. 2026Build