KI Agenten mit Unreal Agent ausführen: Praxisleitfaden
So lassen sich KI Agenten mit Unreal Agent testen: Runner einrichten, Repository absichern, JSONL-Spuren auswerten und Kosten belastbar vergleichen.


Mit Unreal Agent lassen sich KI Agenten für eine Repository-Aufgabe über die Kommandozeile starten, vollständige Sitzungen als JSONL sichern und die asynchrone Tool-Verarbeitung daraufhin prüfen, ob sie sich für die eigene Anwendung lohnt. Gemeint ist die neue Go-Agentenlaufzeit von Unreal Labs, nicht ein Assistent für Unreal Engine. Der beste Einstieg ist eine einzige schreibgeschützte Repository-Zusammenfassung: Erfassen Sie Modell, Reasoning-Stufe, Laufzeit, Exit-Status, Token-Nutzung und geänderte Dateien und vergleichen Sie diese Belege anschließend mit dem aktuell eingesetzten Agenten.
Wie KI Agenten mit Unreal Agent arbeiten
Unreal Agent bildet die Schicht zwischen einem Modell und den Werkzeugen, die die eigentliche Arbeit erledigen. Diese Schicht funktioniert wie die Bauleitung: Das Modell entscheidet, was zu tun ist; die Laufzeitumgebung verteilt Befehle, protokolliert den Ablauf und bestimmt, wann das Modell ein Ergebnis zu sehen bekommt.
Das besondere Merkmal ist die asynchrone Tool-Ausführung. Ruft das Modell ein Tool auf, hält die Laufzeitumgebung den laufenden Vorgang fest und lässt ihn im Hintergrund weiterarbeiten. Sobald das Tool fertig ist, ergänzt sie das Endergebnis in der Sitzung und ruft das Modell erneut auf. Ein langsamer Einrichtungsbefehl muss dadurch weder andere sinnvolle Arbeit noch eine neue steuernde Nachricht blockieren.
Unreal Labs hat das Projekt am 22. September 2026 veröffentlicht. Das SDK umfasst eine Go-Bibliothek, einen installierbaren Runner und einen Harbor-kompatiblen Benchmark-Runner. Das Repository steht unter der MIT-Lizenz.
Unreal Labs meldet in eigenen Produktions-Workloads und veröffentlichten Agenten-Benchmarks bis zu 40% niedrigere Kosten als Codex und bis zu 20% niedrigere Kosten als Pi. Das sind Herstellerergebnisse, kein übertragbarer Rabatt. Der angegebene Mechanismus ist plausibel genug für einen Test: ein kleinerer Prompt-Umfang, kompakte Tool-Ergebnisse, keine Subagenten oder Workflows und mehr Tool-Arbeit zwischen den Modellaufrufen. Aussagekräftig wird der Prozentsatz erst dann, wenn Modell, Reasoning-Stufe, Prompt, Repository-Zustand und Erfolgskriterien übereinstimmen.
Die Wirtschaftlichkeit beginnt bei der Aufgabe, nicht beim Benchmark
Für den Runner selbst fällt unter der MIT-Lizenz keine Lizenzgebühr pro Nutzer an. Kostenlos ist der Betrieb trotzdem nicht: Modellaufrufe, Rechenleistung, Sandboxing, Integration, Protokolle und die Arbeitszeit für einen zuverlässigen Betrieb bleiben zu bezahlen.
Welches Budget er infrage stellen kann, zeigt die Preisgestaltung von Code-Review-Produkten. Graphite listet Starter für $20 pro Nutzer und Monat und Team für $40, jeweils bei jährlicher Abrechnung. CodeRabbit nennt Jahrespreise von $24, $48 und $72 pro Entwickler und Monat. Für ein Team aus 10 Entwicklern ergibt die veröffentlichte Spanne $200 bis $720 pro Monat.
Damit wird Unreal Agent nicht automatisch zum direkten Ersatz für eines der beiden Produkte. Eine Plattformgruppe erhält vielmehr eine offene Laufzeitumgebung, auf deren Basis sich ein eng umrissener interner Workflow entwickeln lässt. Die wirtschaftliche Prüfung ist einfach: Vergleichen Sie die vollständigen Monatskosten dieses Workflows einschließlich Modellausgaben und Wartung mit dem eingesparten Lizenzbudget oder den ersetzten Entwicklungsstunden. Ohne messbare Kosten pro erfolgreich abgeschlossener Aufgabe bleibt jedes Sparversprechen reine Dekoration.
So führen Sie eine klar begrenzte Repository-Aufgabe aus
Beginnen Sie mit dem Runner. Die Bibliothek ist für Teams gedacht, die bereits wissen, welches Agentenverhalten in ihre Anwendung gehört.
1. Das Repository braucht eine echte Grenze
-workspace legt das Arbeitsverzeichnis des Agenten und seines Bash-Tools fest. Als Sicherheitssandbox ist diese Option nicht dokumentiert. Verwenden Sie einen kurzlebigen Checkout oder Container, entfernen Sie produktive Zugangsdaten, begrenzen Sie den Netzwerkzugriff und geben Sie dem Prozess nur die tatsächlich benötigten Tokens. Ein Prompt mit der Anweisung „keine Dateien verändern“ ist eine Vorgabe, aber keine technische Durchsetzung. Wer damit Neuland betritt, findet unter Code-Sandboxes für KI-Agenten praxistaugliche Optionen.
Prüfen Sie den Workspace außerdem auf eine .env-Datei. Der Runner lädt sie aus dem ausgewählten Workspace; auch ein kopiertes Repository kann deshalb unbemerkt Zugangsdaten preisgeben.
2. Runner, Anbieter, Modell und Reasoning-Stufe fixieren
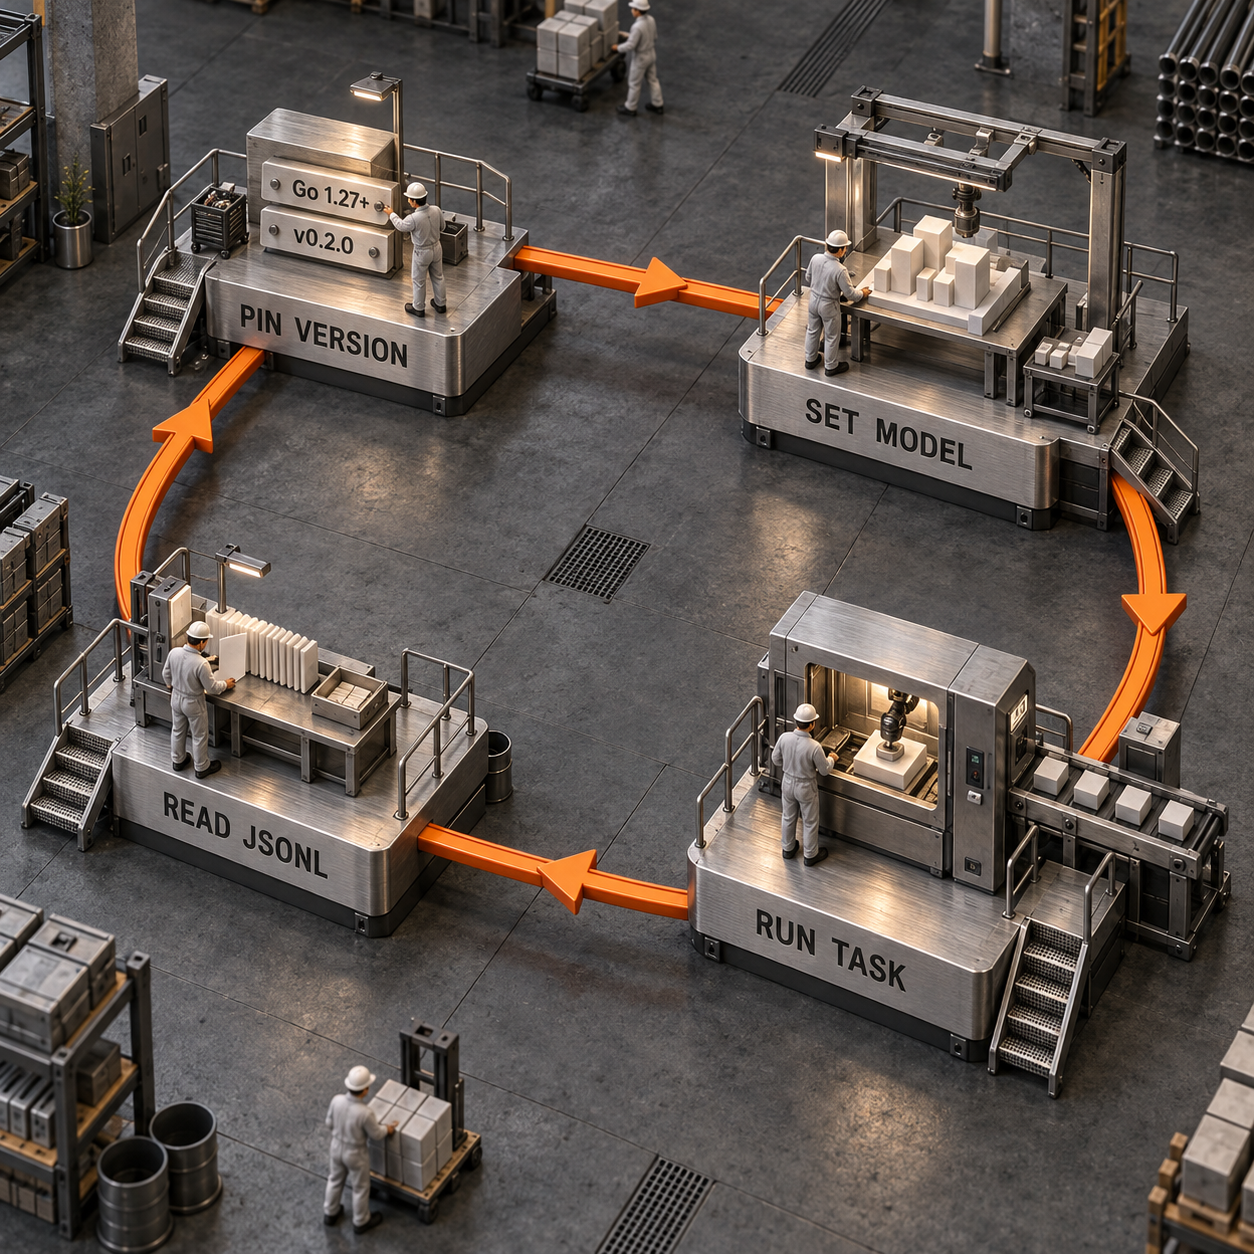
Am 24. September 2026 ist v0.2.0 die aktuelle Version; sie wurde einen Tag zuvor veröffentlicht. Die README des Runners verlangt Go 1.27 oder neuer und dokumentiert @latest. Für einen reproduzierbaren Test sollte stattdessen ein Release-Tag verwendet werden.
Der folgende Lauf verwendet OpenAI, den aktuellen Standardwert gpt-6-astra aus dem Quellcode und die Reasoning-Stufe high. Ein anderes Modell ist möglich, sollte dann aber protokolliert werden. Führen Sie den Befehl gegen eine kurzlebige Kopie von my-project aus:
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonl
Der Runner unterstützt außerdem openai-codex, openrouter, fireworks und ollama. In einer Anfrage lassen sich Modell, Reasoning-Stufe, Anzahl der Wiederholungsversuche, Sitzungs-ID, System-Prompt und auszuschließende Tools wählen. Beliebige Tools können derzeit nicht über extra_allowed_tools ergänzt werden, weil das Feld zwar akzeptiert, aber ignoriert wird.
3. Den Lauf als Beleg auswerten
Ein belastbarer Testdatensatz besteht aus sechs Teilen:
Die gespeicherte Sitzung liegt unter unreal-sessions/repo-summary-v1.session.jsonl. Mit derselben session_id wird diese Sitzung fortgesetzt. Für einen unabhängigen Vergleich ist eine neue ID nötig, weil früherer Kontext sowohl Qualität als auch Kosten verändern kann.
Hier wird kein eigener Leistungswert behauptet, weil kein Live-Lauf mit einem Anbieter abgeschlossen wurde. Ehrlich ist nur die Kennzahl, die im eigenen Repository tatsächlich gemessen wird.
Runner oder Bibliothek?
Der Runner eignet sich zum Testen eines Prompts, Bewerten einer Repository-Aufgabe oder Einbinden eines Prozesses in CI. Die Go-Bibliothek ist die richtige Wahl, wenn der Agent Teil des eigenen Produkts werden soll und das Team Sitzungsverwaltung, Lebenszyklus, Tools, Sicherheit und Anbieterintegration selbst verantworten kann.
Der Unterschied ähnelt dem zwischen einem Elektrowerkzeug und seinem Motor. Der Runner ist ein einsatzbereites Werkzeug mit montierten Schaltern. Die Bibliothek liefert den Motor und damit die Freiheit, Gehäuse, Bedienung und Sicherheitssystem selbst zu entwerfen. Wenn die Zuständigkeit für Sitzungen den Ausschlag gibt, bietet dieser Vergleich von Agents API und SDK einen hilfreichen benachbarten Bezugsrahmen.
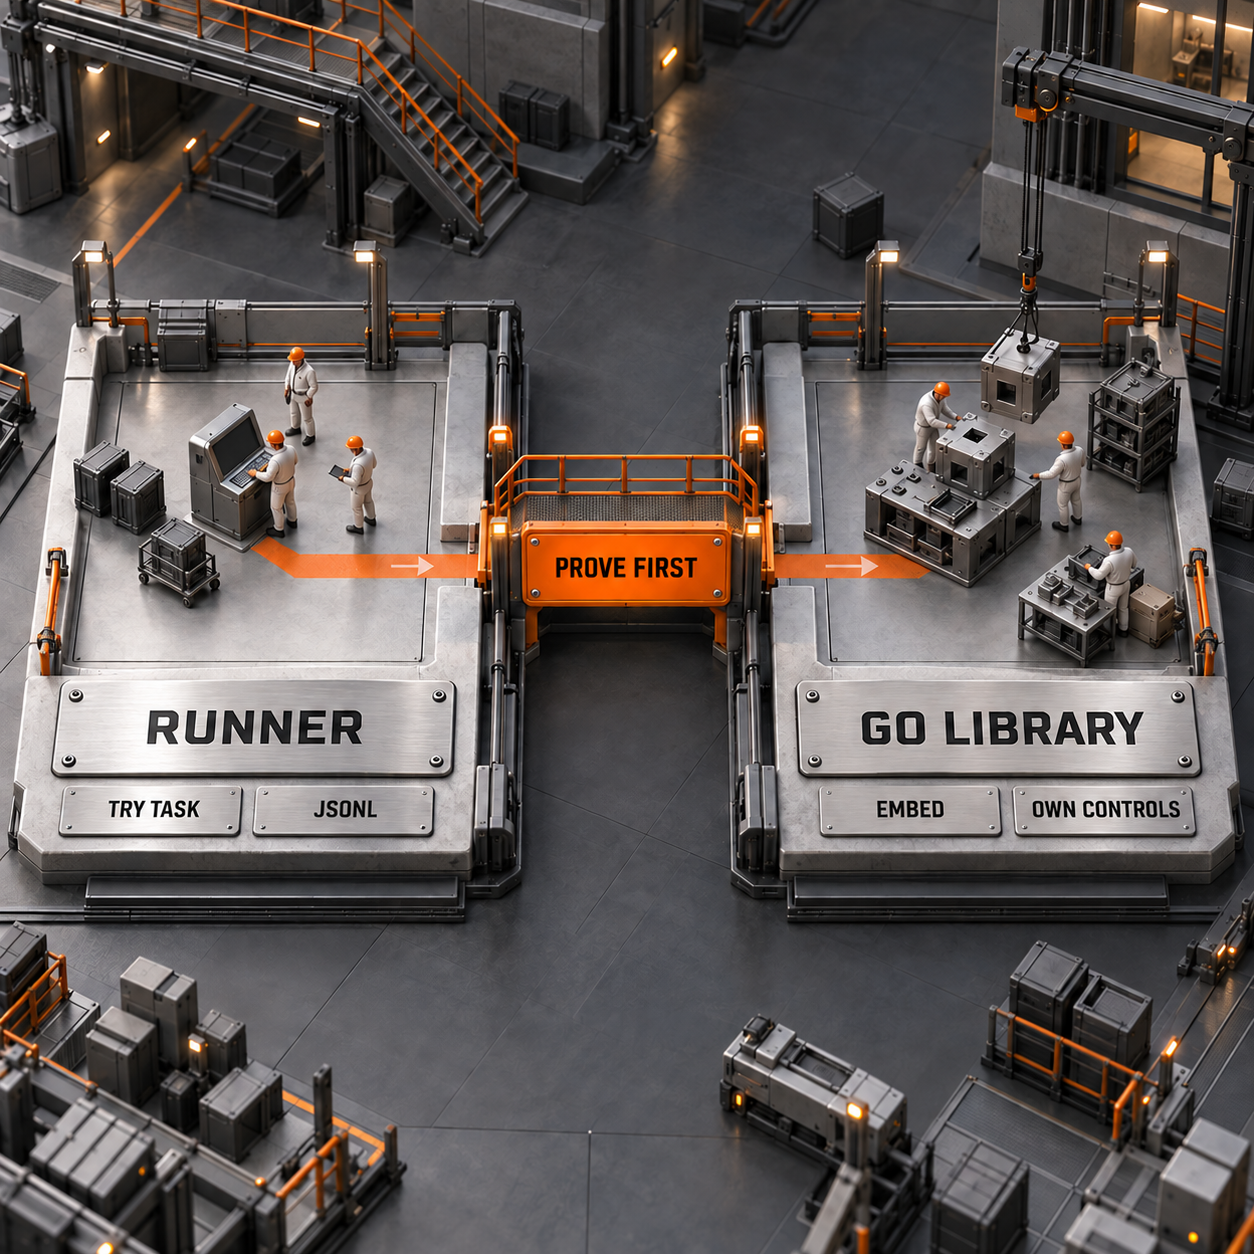
Der Runner ist die sinnvollere Voreinstellung, denn Integrationsarbeit kann eine schwache Aufgabe kaschieren. Wenn derselbe begrenzte Prompt nicht zweimal ein brauchbares Ergebnis liefert, wird auch ein API-Wrapper die Produktidee nicht retten.
Sechs Aufgaben, die einen Test wert sind
1. Erste Prüfung agentengeschriebener Pull Requests
Ein Entwicklungsteam mit großen, KI-generierten Pull Requests könnte dem Runner einen sauberen Checkout, den Diff und die Testbefehle des Repositorys bereitstellen. Er könnte den betroffenen Code untersuchen, gezielte Prüfungen ausführen und ein durch JSONL belegtes Review-Paket liefern. Der Nutzen besteht nicht darin, die menschliche Prüfung abzuschaffen. Wiederkehrende Repository-Analysen werden vielmehr vorgezogen, damit sich Reviewer auf Architektur und Risiken konzentrieren können.
2. Repository-Einstieg für neue Entwickler
Eine Plattformgruppe könnte den oben gezeigten Zusammenfassungs-Prompt jedes Mal ausführen, wenn ein neuer Entwickler zu einem Service stößt. Das Ergebnis bildet Einstiegspunkte, Testbefehle, Konfiguration und offensichtliche Gefahren ab; die Sitzungsspur bleibt zur Kontrolle verfügbar. So entsteht eine wiederholbare erste Stunde, ohne dass ein Senior-Entwickler dasselbe Repository immer wieder von Grund auf erklären muss.
3. Triage fehlgeschlagener Tests
Bei einem unübersichtlichen CI-Fehler könnte ein Entwickler den Runner einen einzelnen fehlgeschlagenen Test reproduzieren, die relevanten Codepfade durchsuchen und die wahrscheinliche Ursache von nebensächlicher Ausgabe trennen lassen. Hier zählt die asynchrone Tool-Verarbeitung, weil Umgebungseinrichtung, Suchvorgänge und Testausführung parallel laufen können. Das Ergebnis ist ein kompakteres Belegpaket für den Entwickler, der den Fehler anschließend behebt.
4. Vorbereitung von Abhängigkeitsaktualisierungen
Ein Maintainer könnte den Agenten auf einen Branch mit genau einer angehobenen Abhängigkeit ansetzen und nach betroffenen Imports, veralteten Aufrufen, Testabdeckung und Migrationshinweisen fragen. Das Resultat dient als Checkliste, nicht als automatische Freigabe. Dadurch lässt sich der Umfang schneller bestimmen, bevor jemand einen vollständigen Entwicklungsblock einplant.
5. Prüfungen vor der Veröffentlichung
Ein Release-Verantwortlicher könnte auf einem Release Candidate nach geänderten Bereichen, fehlenden Migrationen, Dokumentationslücken und den passenden Testbefehlen fragen. Das Sitzungsprotokoll hält fest, was der Agent tatsächlich untersucht hat. Der Vorteil ist ein einheitlicher Vorabcheck, der die deterministische CI ergänzt, statt sie zu ersetzen.
6. Übergabepakete für Support-Eskalationen
Ein Produktentwickler könnte ein reproduzierbares Kundenproblem in einer bereinigten Repository-Umgebung ablegen und den Runner wahrscheinliche Codepfade verfolgen, das Verhalten reproduzieren und offene Fragen auflisten lassen. So entsteht eine strukturierte Übergabe vom Support an die Entwicklung, ohne einem Agenten Zugriff auf produktive Kundensysteme zu geben.
Zwei lohnende Produktideen
Stärkste Option: ein Review-Gate für KI-generierten Code
Entwickeln Sie einen GitHub- oder GitLab-Check, der Unreal Agent in einem isolierten Workspace startet, den Pull Request anhand der Repository-Regeln prüft, erlaubte Checks ausführt und für einen menschlichen Reviewer eine mit Belegen verknüpfte Zusammenfassung veröffentlicht. Käufer sind Teams, deren Agenten immer mehr Code produzieren.
Die Nachfrage ist unmittelbar erkennbar. ai powered code review platform erreicht ungefähr 1,900 Suchanfragen pro Monat in den USA, während ai code review auf etwa 1,300 kommt und einen CPC von $55.73 aufweist. Bestehende Produkte bestätigen bei jährlicher Abrechnung ein Lizenzbudget von $20 bis $72 pro Entwickler und Monat.
Die kleinste verkaufbare Version unterstützt einen Code-Host, einen Modellanbieter, einen festen Review-Prompt, eine strikte Befehlsfreigabeliste und eine aus der JSONL-Spur erzeugte Ergebnisseite. Die entscheidende Hürde ist Vertrauen: Falschmeldungen, offengelegte Geheimnisse, störende Kommentare und unsichere Befehle können den Nutzen schnell zunichtemachen. Dennoch ist dies die beste Chance, weil die Aufgabe häufig anfällt, messbar ist und bereits über ein eigenes Budget verfügt.
Ein Repository-Job-Runner mit frei wählbarem Modell
Bauen Sie eine kleine interne Steuerungsebene, in der ein Team Repository, geprüfte Aufgabenvorlage, Anbieter, Modell und Kostenobergrenze auswählt und anschließend eine Sitzungsspur sowie ein freigabefertiges Ergebnis erhält. Agenturen und Plattformgruppen, die eine offene Laufzeitumgebung wünschen, ohne Warteschlange, Isolation und Berichtsschicht selbst zu entwickeln, könnten dafür bezahlen.
open source ai coding agent erreicht ungefähr 5,400 Suchanfragen pro Monat in den USA, hat eine kommerzielle Suchabsicht und einen CPC von $13.11. Damit ist die Nachfrage breiter als bei der Review-Suchanfrage, der konkrete Produktbedarf aber weniger eindeutig.
Das MVP besteht aus einem Repository-Konnektor, einem kurzlebigen Workspace, zwei Aufgabenvorlagen, Anbieterkonfiguration, Jobstatus, Token-Bericht und herunterladbarer JSONL-Datei. Die Hürde ist die Differenzierung: Ein schmales Dashboard auf Basis einer jungen Laufzeitumgebung lässt sich leicht kopieren. Professionelle Käufer werden zudem Identitätskontrollen, Audit-Protokolle, Netzwerkrichtlinien und verlässliche Bereinigung verlangen. Gewinnen lässt sich über einen konkreten Workflow und belastbare Betriebskontrollen, nicht über den Produktnamen.
Was Unreal Agent nicht löst
Unreal Agent liefert keine vollständige Produktionsgrenze. Das Workspace-Flag ist keine Sandbox, und das integrierte Bash-Tool kann innerhalb der bereitgestellten Umgebung handeln. Isolation, Netzwerkrichtlinien, Zugangsdaten, Freigaben und Bereinigung bleiben in eigener Verantwortung.
Auch Unterschiede zwischen Anbietern verschwinden nicht. Unreal Labs berichtet, dass einige Modelle bei bestimmten Nicht-OpenAI-Inferenzanbietern das Muster aus Zwischenstatus und abschließendem Tool-Ergebnis in den eigenen Tests abgelehnt haben. Deshalb muss genau die Kombination aus Anbieter und Modell geprüft werden, die später zum Einsatz kommen soll.
Eine ausgefeilte Orchestrierung gehört ebenfalls nicht zum Paket. Der kleine Footprint ohne Subagenten oder Workflows ist Teil des Effizienzarguments. Ungeeignet ist die Laufzeitumgebung daher für Produkte, die standardmäßig einen visuellen Workflow-Builder, einen großen Katalog verwalteter Konnektoren oder delegierte Spezialagenten benötigen.
Und sie beweist keine Einsparungen für den eigenen Workload. Modellwahl, Reasoning-Aufwand, Cache-Verhalten, Tool-Ausgaben, Wiederholungsversuche und Aufgabenerfolg verändern allesamt die Rechnung. Verglichen werden sollten erfolgreich abgeschlossene Aufgaben, nicht bloße Token-Summen aus unterschiedlichen Konfigurationen.
Der nächste Schritt am Montag
Am Montag sollte ein Plattformingenieur v0.2.0 fixieren, eine Repository-Kopie ohne Zugangsdaten vorbereiten und die Zusammenfassungsaufgabe zweimal mit demselben Modell und derselben Reasoning-Stufe ausführen. Aufzubewahren sind JSONL, Sitzungsdatei, Exit-Status, Laufzeit, Token-Nutzung und Repository-Diff. Sind beide Läufe brauchbar und sauber, folgt dieselbe Aufgabe mit dem derzeitigen Agenten. Erst danach steht die Entscheidung an, ob ein Review-Workflow getestet oder die Bibliothek eingebettet werden soll.
Was ist Unreal Agent?
Unreal Agent ist eine auf asynchrone Abläufe ausgelegte Go-Agentenlaufzeit von Unreal Labs. Sie umfasst eine Go-Bibliothek, einen installierbaren Kommandozeilen-Runner und einen Harbor-kompatiblen Benchmark-Runner. Mit Unreal Engine von Epic Games hat sie nichts zu tun.
Was wird für Unreal Agent benötigt?
Für die Installation aus dem Quellcode werden Go 1.27 oder neuer, ein Workspace, die Konfiguration eines unterstützten Anbieters, ein Modell und die jeweils erforderlichen Anbieterzugangsdaten benötigt. Der Runner unterstützt OpenAI, OpenAI Codex, OpenRouter, Fireworks und Ollama.
Kann Unreal Agent eine Sitzung fortsetzen?
Ja. Dazu wird in der JSON-Anfrage eine session_id gesetzt. Dieselbe ID setzt die gespeicherte Sitzung fort; eine neue ID beginnt eine frische Sitzung.
Erzeugt das Workspace-Flag eine Sandbox für den Agenten?
Nein. Es wählt den Workspace und das Bash-Arbeitsverzeichnis aus. Der Prozess gehört in eine getrennte Sandbox oder kurzlebige Umgebung, in der Zugangsdaten und Netzwerkzugriff begrenzt sind.
Ist Unreal Agent günstiger als Codex?
Unreal Labs meldet für eigene Workloads und veröffentlichte Benchmarks Einsparungen von bis zu 40% gegenüber Codex. Das ist ein Herstellerergebnis, keine Garantie. Vor einer Kostenaussage müssen Modell, Reasoning-Stufe, Prompt, Repository-Zustand und Erfolgskriterien übereinstimmen.
Wenn ein kontrollierter Repository-Agent für den eigenen Workflow entstehen soll, ist die Entwicklung von KI-Agenten der passende Ausgangspunkt.
- Zuletzt aktualisiert
- 24. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Cursor Rollouts kostenlos? Was Zugang und Nutzung kosten
Ist Cursor Rollouts kostenlos? Nur Teams und Enterprise erhalten Zugang. Was die 10-Tage-Credits abdecken und welche Kosten danach offenbleiben.24. Sept. 2026Build
JetBrains Air einrichten: Sicher mit Coding-Agenten starten
JetBrains Air installieren, Coding-Agenten sicher verbinden und Änderungen im IDE-Diff prüfen: So gelingt der erste kleine, testbare Workflow.23. Sept. 2026Build
JetBrains Air: Was kostenlos ist – und wer die Nutzung bezahlt
JetBrains Air kostet als Plugin $0. Welche Kosten für IDE, Agenten, API und JetBrains AI trotzdem entstehen und welcher Zugang sich wirklich lohnt.23. Sept. 2026Build
Firecrawl Docker selbst hosten: Setup, Belege und echte Kosten
Firecrawl mit Docker selbst hosten: versioniertes Setup, belastbare Scrape-Prüfung und ein 30-Tage-Kostenvergleich mit Firecrawl Cloud im Detail.22. Sept. 2026Build
KI-Agenten: Warum bezahlte Retries eine Freigabe brauchen
Wenn KI-Agenten fertige Renderings selbst verwerfen, wird Qualitätskontrolle zur Kaufentscheidung. So stoppt menschliche Freigabe bezahlte Retries.22. Sept. 2026Build
KI Agent erstellen mit MindStudio: Kosten und Grenzen
Mit MindStudio einen KI Agent erstellen: Die Analyse erklärt Funktionen, Preise, Modellkosten, Teamgrenzen und den belastbaren 20-Datensatz-Prüfplan.22. Sept. 2026Build
Wispr Flow oder Superwhisper: Welche Diktier-App passt?
Wispr Flow oder Superwhisper? Der Vergleich zeigt Preise, Datenschutz, Offline-Modi und Teamfunktionen – samt klarem Entscheidungsweg für den Arbeitsalltag.22. Sept. 2026Build