AI code review con Unreal Agent: guida pratica al runner
Scopri come usare Unreal Agent in sicurezza, conservare le sessioni JSONL e valutarne costi, prestazioni e casi d’uso concreti per l’AI code review.


Con Unreal Agent puoi eseguire dal terminale un’attività su un repository, conservare l’intera sessione in JSONL e capire se la gestione asincrona dei tool merita un posto nella tua applicazione, anche per un flusso di AI code review. È il nuovo runtime per agenti scritto in Go da Unreal Labs, non un assistente per Unreal Engine. Parti da un unico riepilogo read-only del repository; registra modello, livello di reasoning, durata, stato di uscita, consumo di token e file modificati; poi confronta queste evidenze con quelle del tuo agente attuale.
Che cos’è davvero Unreal Agent
Unreal Agent è lo strato che collega un modello ai tool incaricati di svolgere il lavoro. È un po’ come il capocantiere di un progetto: il modello stabilisce che cosa fare, mentre il runtime smista i comandi, registra gli eventi e decide quando mostrare al modello ciascun risultato.
La scelta che lo distingue è l’esecuzione asincrona dei tool. Quando il modello richiama un tool, il runtime annota che l’operazione è in corso e la lascia proseguire in background. Al termine, aggiunge il risultato definitivo alla sessione e interroga di nuovo il modello. In questo modo, un comando di configurazione lento non blocca necessariamente altre attività utili o nuove istruzioni inviate durante l’esecuzione.
Unreal Labs ha presentato il progetto il 22 settembre 2026. L’SDK comprende una libreria Go, un runner installabile e un benchmark runner compatibile con Harbor. Il repository adotta la licenza MIT.
Unreal Labs dichiara costi fino al 40% inferiori rispetto a Codex e fino al 20% inferiori rispetto a Pi nei propri carichi di produzione e benchmark pubblicati sugli agenti. Sono risultati del fornitore, non uno sconto trasferibile a qualunque contesto. Il meccanismo dichiarato è abbastanza plausibile da meritare una prova: prompt più compatti, risultati dei tool ridotti, assenza di sub-agent o workflow e più lavoro svolto dai tool tra una chiamata al modello e l’altra. La percentuale non dice nulla finché non si allineano modello, livello di reasoning, prompt, stato del repository e criteri di successo.
I conti partono dal lavoro, non dal benchmark
Grazie alla licenza MIT, il runner non prevede un canone per postazione. Gestirlo, però, ha comunque un costo: chiamate al modello, capacità di calcolo, sandbox, integrazione, log e il tempo dell’ingegnere che deve mantenerlo affidabile.
Un riferimento concreto viene dai prezzi dei servizi di code review. Graphite propone il piano Starter a $20 per utente al mese e il piano Team a $40, con fatturazione annuale. CodeRabbit indica prezzi annuali di $24, $48 e $72 per sviluppatore al mese. Per un team di 10 sviluppatori, la fascia pubblicata va quindi da $200 a $720 al mese.
Questo non rende Unreal Agent un sostituto immediato di uno dei due prodotti. Offre invece a un platform team un runtime aperto su cui costruire un singolo workflow interno ben delimitato. La verifica economica è semplice: confronta il costo mensile complessivo di quel workflow, inclusi modello e manutenzione, con il budget per postazione o con le ore di lavoro che permette di risparmiare. Se non puoi misurare il costo per attività completata, il vantaggio economico resta soltanto una formula promozionale.
Come eseguire un’attività circoscritta su un repository
Comincia dal runner. La libreria è destinata ai team che hanno già stabilito quale comportamento dell’agente debba entrare nella propria applicazione.
1. Metti il repository dietro un confine reale
-workspace seleziona la directory di lavoro dell’agente e del relativo tool Bash. La documentazione non lo presenta come una sandbox di sicurezza. Usa un checkout usa e getta o un container, rimuovi le credenziali di produzione, limita l’accesso alla rete e assegna al processo soltanto i token indispensabili. Un prompt che dice «non modificare i file» è un’istruzione, non una misura di protezione. Se è la prima volta che affronti il problema, parti dalle soluzioni pratiche raccolte in sandbox per agenti AI.
Controlla anche se nel workspace è presente un file .env. Il runner ne carica uno dalla directory selezionata, quindi persino la copia di un repository può esporre credenziali dimenticate.
2. Fissa runner, provider, modello e livello di reasoning
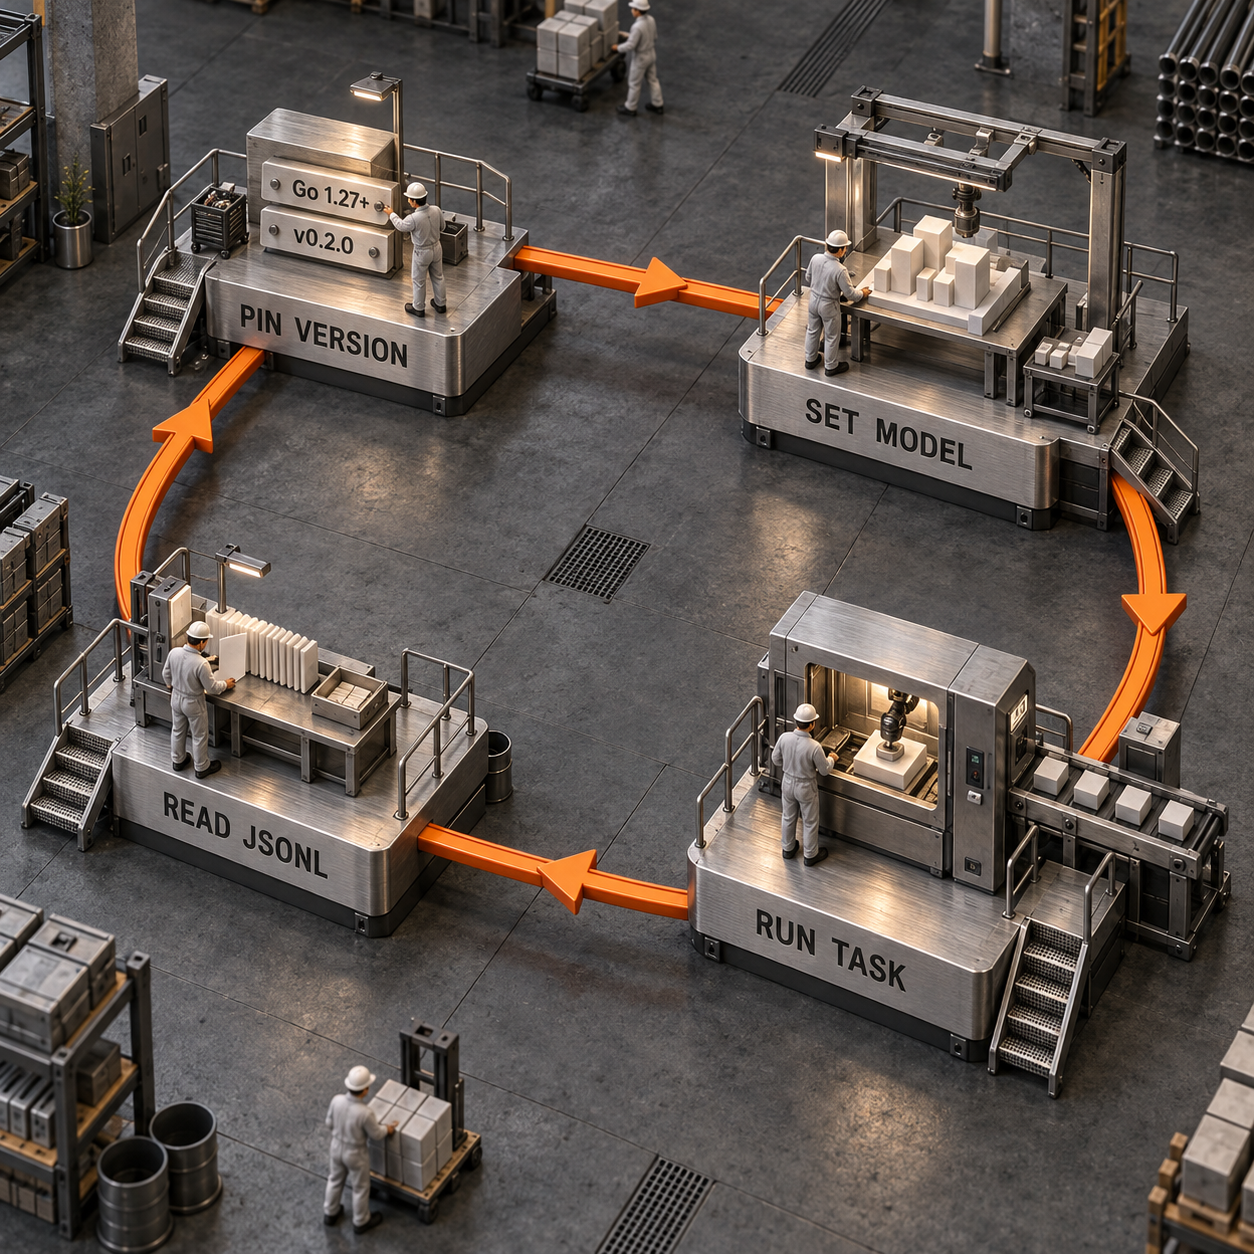
Al 24 settembre 2026, la release corrente è v0.2.0, pubblicata il giorno precedente. Il README del runner richiede Go 1.27 o versioni successive e documenta l’uso di @latest; per una valutazione ripetibile, scegli invece un tag di release.
L’esecuzione seguente usa OpenAI, il modello predefinito corrente nel codice sorgente gpt-6-astra e il livello di reasoning high. Se cambi modello, registra la sostituzione. Esegui il test su una copia usa e getta di my-project:
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonl
Il runner supporta anche openai-codex, openrouter, fireworks e ollama. Ogni richiesta può specificare modello, livello di reasoning, numero di tentativi, ID della sessione, prompt di sistema e tool da escludere. Al momento non può aggiungere tool arbitrari tramite extra_allowed_tools, perché il campo viene accettato ma ignorato.
3. Leggi l’esecuzione come un insieme di evidenze
Una valutazione utile deve registrare sei elementi:
La sessione salvata è unreal-sessions/repo-summary-v1.session.jsonl. Riutilizza lo stesso session_id per proseguirla; quando vuoi un confronto pulito, usa invece un nuovo ID, altrimenti il contesto precedente può alterare sia la qualità sia il costo.
Qui non vengono dichiarati risultati prestazionali di prima mano, perché non è stata completata un’esecuzione con un provider attivo. L’unico dato credibile sulle prestazioni è quello raccolto sul tuo repository.
Runner o libreria?
Scegli il runner per provare un prompt, valutare un’attività sul repository o collegare un processo alla CI. Passa alla libreria Go quando l’agente deve vivere nel tuo prodotto e sei pronto a gestire direttamente archiviazione delle sessioni, ciclo di vita, tool, sicurezza e integrazione con il provider.
La differenza ricorda quella tra un elettroutensile e il suo motore. Il runner fornisce uno strumento pronto all’uso, con i comandi già montati; la libreria offre il motore e la libertà di progettare involucro, controlli e sistemi di sicurezza. Se il punto decisivo è la proprietà delle sessioni, questo confronto tra Agents API e SDK offre un quadro complementare utile.
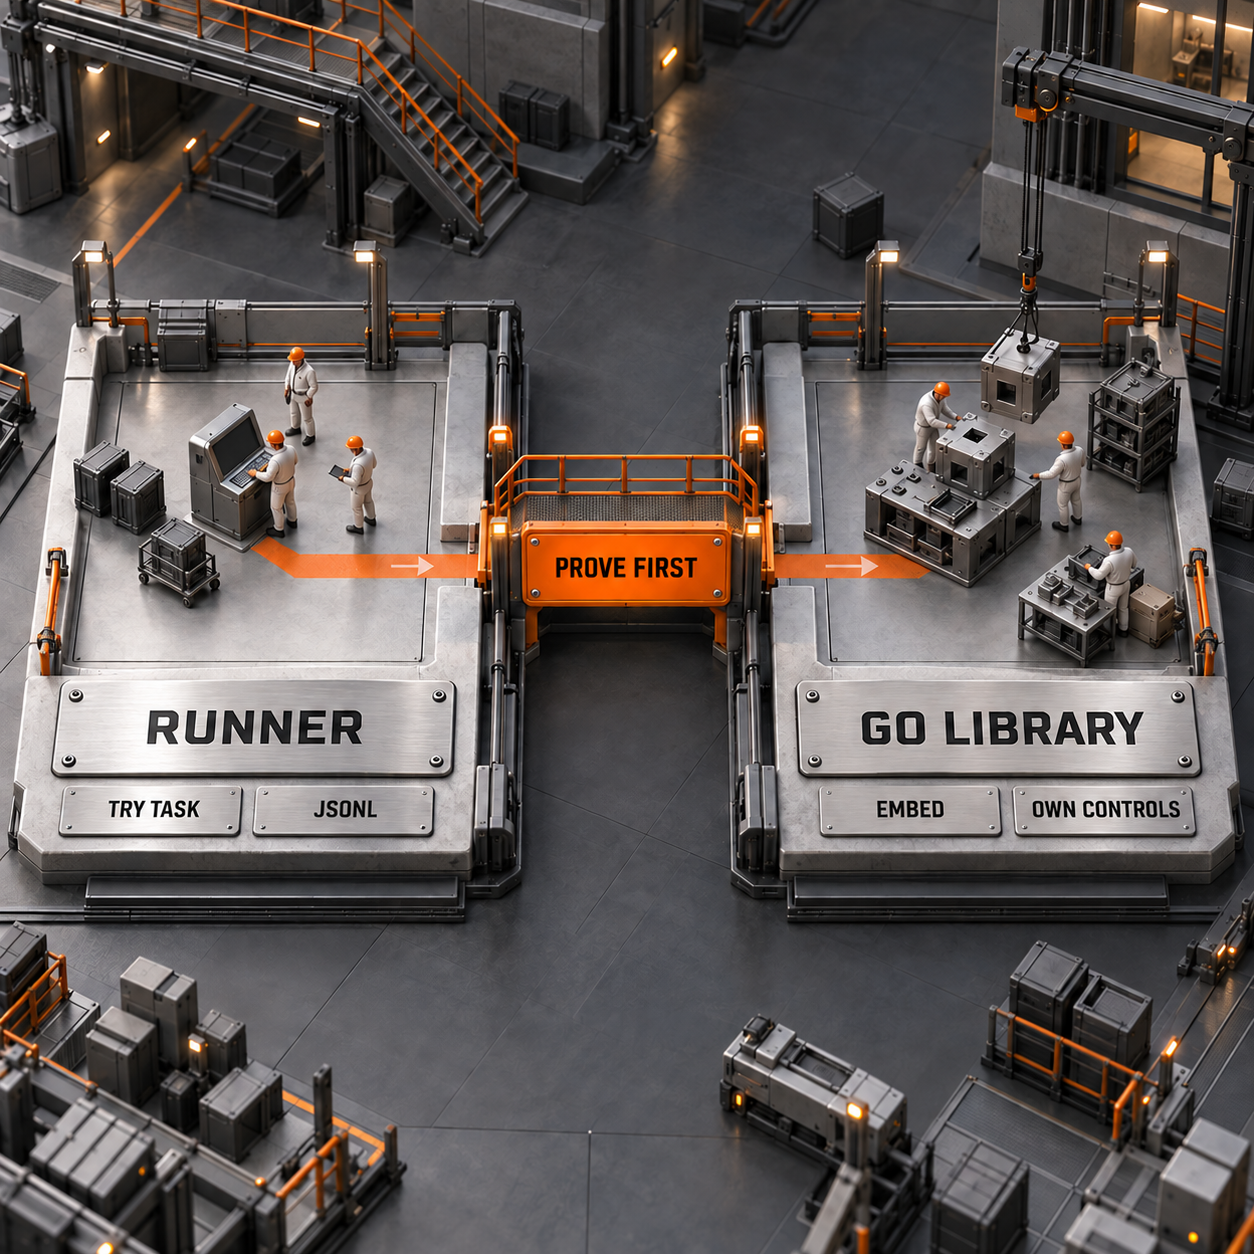
Il runner è la scelta iniziale più sensata, perché il lavoro di integrazione può nascondere un’attività debole. Se lo stesso prompt circoscritto non produce due volte un risultato utile, un wrapper API non correggerà l’idea di prodotto.
Sei attività che vale la pena testare, in ordine di priorità
1. Prima revisione delle pull request scritte dagli agenti
Un team di sviluppo che riceve pull request molto ampie generate dall’AI potrebbe fornire al runner un checkout pulito, il diff e i comandi di test del repository. Il runner potrebbe esaminare il codice interessato, avviare controlli mirati e restituire un pacchetto di revisione supportato dalla traccia JSONL. Il vantaggio non sta nell’eliminare la revisione umana, ma nell’anticipare l’ispezione ripetitiva del repository, così che il reviewer possa concentrarsi su architettura e rischi.
2. Orientamento nel repository per i nuovi sviluppatori
Un platform team potrebbe eseguire lo stesso prompt di riepilogo ogni volta che un nuovo sviluppatore entra nel gruppo che gestisce un servizio. L’output traccerebbe entry point, comandi di test, configurazione e pericoli evidenti, lasciando disponibile la sessione per le verifiche. Il risultato è una prima ora ripetibile, senza chiedere ogni volta a uno sviluppatore senior di raccontare il repository da zero.
3. Triage dei test non riusciti
Di fronte a un errore CI molto rumoroso, uno sviluppatore potrebbe chiedere al runner di riprodurre un singolo test fallito, cercare nei percorsi di codice pertinenti e separare la causa probabile dall’output irrilevante. Qui la gestione asincrona dei tool è importante, perché preparazione dell’ambiente, ricerche ed esecuzione dei test possono sovrapporsi. Il vantaggio è un pacchetto di evidenze più compatto per chi dovrà intervenire.
4. Preparazione degli aggiornamenti delle dipendenze
Un maintainer potrebbe indirizzare l’agente verso un branch che contiene l’aggiornamento di una singola dipendenza e chiedergli import interessati, chiamate deprecate, copertura dei test e note di migrazione. L’output diventa una checklist, non un merge automatico. Il vantaggio è definire più rapidamente il perimetro prima di impegnare un intero blocco di lavoro ingegneristico.
5. Controlli di preparazione alla release
Il responsabile di una release potrebbe richiedere, su un candidato al rilascio, l’elenco delle aree modificate, delle migrazioni mancanti, delle lacune nella documentazione e dei relativi comandi di test. La registrazione della sessione conserva ciò che l’agente ha effettivamente esaminato. Il vantaggio è un controllo preliminare coerente, complementare alla CI deterministica e non sostitutivo.
6. Pacchetti per le escalation dal supporto
Un product engineer potrebbe inserire un problema cliente riproducibile in un ambiente repository bonificato e chiedere al runner di seguire i probabili percorsi di codice, riprodurre il sintomo ed elencare le domande ancora aperte. Il risultato è un passaggio di consegne strutturato dal supporto all’ingegneria, senza concedere a un agente l’accesso ai sistemi di produzione dei clienti.
Due prodotti da costruire, a partire dall’AI code review
La scelta migliore: un gate di revisione per il codice generato dall’AI
Costruisci un controllo per GitHub o GitLab che avvii Unreal Agent in un workspace isolato, verifichi la pull request rispetto alle regole del repository, esegua i controlli consentiti e pubblichi per un reviewer umano un riepilogo collegato alle evidenze. I potenziali acquirenti sono i team che producono sempre più codice con gli agenti.
La domanda è concreta. ai powered code review platform registra circa 1,900 ricerche al mese negli Stati Uniti, mentre ai code review ne conta circa 1,300 e ha un CPC di $55.73. I prodotti esistenti confermano un budget per postazione compreso tra $20 e $72 per sviluppatore al mese con piani annuali.
La versione minima vendibile supporta un solo servizio di hosting del codice, un provider di modelli, un prompt di revisione fisso, una allowlist rigorosa di comandi e una pagina dei risultati costruita dalla traccia JSONL. Il punto critico è la fiducia: falsi positivi, segreti esposti, commenti rumorosi e comandi non sicuri possono azzerare rapidamente il valore. Resta comunque l’opportunità migliore, perché è frequente, misurabile e collegata a un budget già esistente.
Un job runner per repository con modello scelto dal cliente
Costruisci un piccolo control plane interno in cui il team seleziona repository, template di attività approvato, provider, modello e tetto di spesa, per poi ricevere una traccia di sessione e un risultato pronto per l’approvazione. Agenzie e platform team disposti a pagare per un runtime aperto, ma non a costruire code di esecuzione, isolamento e reporting, sono il pubblico naturale.
open source ai coding agent registra circa 5,400 ricerche mensili negli Stati Uniti, con intento commerciale e un CPC di $13.11. È una domanda più ampia rispetto alla query sulla revisione, ma l’esigenza di prodotto è meno specifica.
L’MVP comprende un connettore per repository, un workspace effimero, due template di attività, configurazione del provider, stato dei job, report sui token e JSONL scaricabile. Il punto debole è la differenziazione: una semplice dashboard costruita attorno a un runtime ancora giovane è facile da copiare, mentre i clienti più esigenti pretenderanno controlli di identità, audit log, policy di rete e pulizia affidabile. Per emergere servono un workflow preciso e controlli operativi solidi, non il solo nome del prodotto.
Che cosa non risolve Unreal Agent
Non fornisce un confine di produzione completo. Il flag per il workspace non è una sandbox e il tool Bash integrato può operare all’interno dell’ambiente che gli assegni. Isolamento, policy di rete, credenziali, approvazioni e pulizia restano una tua responsabilità.
Non elimina le differenze tra provider. Unreal Labs riferisce che, durante i propri test, alcuni modelli serviti da provider di inferenza diversi da OpenAI hanno rifiutato lo schema che prevede prima un risultato del tool in corso e poi quello definitivo. Valida l’esatta combinazione di provider e modello che intendi distribuire.
Non offre un’orchestrazione elaborata. L’ingombro ridotto, senza sub-agent o workflow, fa parte dell’argomento a favore dell’efficienza. È poco adatto ai prodotti che richiedono un workflow builder visuale, un ampio catalogo di connettori gestiti o agenti specialisti delegati già pronti.
Inoltre, non dimostra alcun risparmio per il tuo carico di lavoro. Modello, intensità del reasoning, comportamento della cache, output dei tool, tentativi e successo dell’attività incidono tutti sul conto. Confronta attività completate con successo, non totali grezzi di token prodotti da configurazioni diverse.
Che cosa fare lunedì
Lunedì, un platform engineer dovrebbe fissare la versione v0.2.0, preparare una copia del repository priva di credenziali ed eseguire due volte l’attività di riepilogo con lo stesso modello e lo stesso livello di reasoning. Deve conservare JSONL, file della sessione, stato di uscita, durata, consumo di token e diff del repository. Se entrambe le esecuzioni risultano utili e pulite, può ripetere la stessa attività con l’agente in uso. Solo a quel punto ha senso decidere se provare un workflow di revisione o integrare la libreria.
Che cos’è Unreal Agent?
Unreal Agent è un runtime per agenti async-first scritto in Go da Unreal Labs. Comprende una libreria Go, un runner da riga di comando installabile e un benchmark runner compatibile con Harbor. Non ha alcun legame con Unreal Engine di Epic Games.
Che cosa serve per eseguire Unreal Agent?
Per l’installazione dal codice sorgente servono Go 1.27 o una versione successiva, un workspace, la configurazione di un provider supportato, un modello e le eventuali credenziali richieste dal provider. Il runner supporta OpenAI, OpenAI Codex, OpenRouter, Fireworks e Ollama.
Unreal Agent può riprendere una sessione?
Sì. Imposta un session_id nella richiesta JSON. Riutilizzando quell’ID riprendi la sessione salvata; con un nuovo ID ne crei una da zero.
Il flag del workspace isola l’agente in una sandbox?
No. Seleziona il workspace e la directory di lavoro di Bash. Esegui il processo in una sandbox separata o in un ambiente usa e getta, limitando credenziali e accesso alla rete.
Unreal Agent costa meno di Codex?
Unreal Labs dichiara risparmi fino al 40% rispetto a Codex nei propri carichi di lavoro e benchmark pubblicati. È un risultato del fornitore, non una garanzia. Prima di trarre conclusioni sui costi, confronta lo stesso modello, livello di reasoning, prompt, stato del repository e criteri di successo.
Se vuoi un agente controllato per repository, costruito attorno al tuo workflow, il punto di partenza giusto è lo sviluppo di agenti AI.
- Ultimo aggiornamento
- 24 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Cursor gratis? Quanto costa davvero Rollouts
Cursor gratis non include Rollouts: servono Teams o Enterprise. Scopri cosa coprono i crediti di 10 giorni, i costi ancora ignoti e quando provarlo.24 set 2026Build
JetBrains Air: guida pratica al plugin Alpha
Scopri come installare JetBrains Air Alpha, collegare un agente, aggiungere il contesto del progetto e verificare ogni modifica senza perdere il controllo.23 set 2026Build
JetBrains Air gratis: cosa costa davvero e chi paga
JetBrains Air è gratis solo come plugin. Scopri chi paga agenti, API, IDE e crediti JetBrains AI, più quando convengono i piani Pro o Ultimate.23 set 2026Build
Firecrawl self host: guida a Docker, verifica e costi
Come installare Firecrawl self host con Docker Compose, verificare uno scrape reale e confrontare costi e limiti con Firecrawl Cloud in 30 giorni.22 set 2026Build
Agenti AI: perché i retry a pagamento richiedono approvazione umana
Un agente ha speso $5.48 prima della verifica umana. Ecco perché i retry a pagamento degli agenti AI richiedono un’autorizzazione indipendente.22 set 2026Build
Agenti AI con MindStudio: quanto costa e quando conviene
MindStudio conviene davvero per creare agenti AI? Analisi di workflow, prezzi, limiti e costi operativi, con un piano di prova su 20 record.22 set 2026Build
Wispr Flow o Superwhisper: confronto tra app di dettatura AI
Wispr Flow o Superwhisper? Confronto su prezzi, privacy, dettatura offline e funzioni per team, con un protocollo pratico per scegliere senza slogan.22 set 2026Build