AIエージェント基盤「Unreal Agent」を実務で評価する方法
AIエージェント実行基盤「Unreal Agent」をコマンドラインで安全に試す手順を解説します。リリース、モデル、推論レベルを固定し、JSONL、実行時間、終了ステータス、トークン使用量、差分を記録して、既存エージェントとの品質・コスト比較や、ランナーとGoライブラリの選び分けまで判断できる実践ガイドです。


AIエージェント「Unreal Agent」を使えば、コマンドラインからリポジトリのタスクを実行し、セッション全体をJSONLで保存したうえで、非同期のツール処理を自社アプリケーションに組み込む価値があるかを判断できます。これはUnreal Labsが公開した新しいGo製エージェントランタイムであり、Unreal Engine向けのアシスタントではありません。まずは読み取り専用のリポジトリ要約を1回実行し、モデル、推論レベル、所要時間、終了ステータス、トークン使用量、変更ファイルを記録して、現在利用しているエージェントと比較します。
AIエージェント基盤「Unreal Agent」とは
Unreal Agentは、モデルと、実際に作業するツールの間を取り持つレイヤーです。現場監督のような役割だと考えると分かりやすいでしょう。何をすべきかはモデルが判断し、ランタイムはコマンドを振り分け、経過を記録し、各結果をいつモデルに返すかを決めます。
大きな特徴は、ツールを非同期で実行する設計です。モデルがツールを呼び出すと、ランタイムは処理中であることを記録し、その作業をバックグラウンドで継続させます。ツールが完了した時点で最終結果をセッションに追記し、再びモデルを呼び出します。時間のかかるセットアップコマンドが動いていても、ほかの有用な作業や新しいステアリングメッセージまで止める必要がありません。
Unreal Labsは2026年9月22日にこのプロジェクトを公開しました。SDKにはGoライブラリ、インストール可能なランナー、Harbor互換のベンチマークランナーが含まれます。リポジトリのライセンスはMIT Licenseです。
Unreal Labsは、本番ワークロードと公開ベンチマークにおいて、Codex比で最大40%、Pi比で最大20%のコスト削減を報告しています。ただし、これはベンダーによる結果であり、どの環境でも同じ割引率になるわけではありません。検証に値する仕組みではあります。プロンプトのフットプリントを小さくし、ツール結果をコンパクトに保ち、サブエージェントやワークフローを持たず、モデル呼び出しの間により多くのツール処理を進める設計です。それでも、モデル、推論レベル、プロンプト、リポジトリの状態、成功条件を揃えなければ、この削減率を判断材料にはできません。
ベンチマークより先に、対象業務の採算を計算する
ランナー自体はMIT Licenseのためユーザー単位のライセンス料がかかりませんが、運用コストがゼロになるわけではありません。モデル呼び出し、計算資源、サンドボックス、統合、ログ、システムの信頼性を維持するエンジニアには、引き続き費用が発生します。
比較対象となる予算は、コードレビュー製品の価格から把握できます。Graphiteは年額契約でStarterを1ユーザーあたり月額$20、Teamを$40としています。CodeRabbitの年額契約は、開発者1人あたり月額$24、$48、$72です。開発者10人のチームなら、公表価格の範囲は月額$200〜$720になります。
だからといって、Unreal Agentがどちらの製品にもそのまま置き換わるわけではありません。プラットフォームチームが、対象を絞った社内ワークフローを構築するためのオープンなランタイムを得られる、ということです。採算の見方は明快です。モデル費用と保守費用を含めた限定ワークフローの月間総コストを、置き換えられるシート予算またはエンジニアの工数と比較します。完了タスク当たりのコストを測れないなら、コスト削減という主張は飾りにすぎません。
リポジトリで範囲を絞ったタスクを実行する方法
最初はランナーを使います。ライブラリを選ぶのは、自社アプリケーションに組み込むべきエージェント動作がすでに明確なチームです。
1. リポジトリを実効性のある境界内に置く
-workspaceは、エージェントとBashツールが使う作業ディレクトリを指定します。セキュリティサンドボックスとしては説明されていません。破棄できるチェックアウトまたはコンテナを用意し、本番用の認証情報を取り除き、ネットワークアクセスを制限し、プロセスには必要なトークンだけを渡してください。プロンプトに「ファイルを変更しない」と書くのは指示であって、強制力のある制御ではありません。初めて取り組む場合は、AIエージェント向けコードサンドボックスの実践的な選択肢から確認するとよいでしょう。
ワークスペース内に.envファイルがないかも確認してください。ランナーは選択したワークスペースからこのファイルを読み込むため、コピーしたリポジトリにも、存在を忘れていた認証情報が残っている可能性があります。
2. ランナー、プロバイダー、モデル、推論レベルを固定する
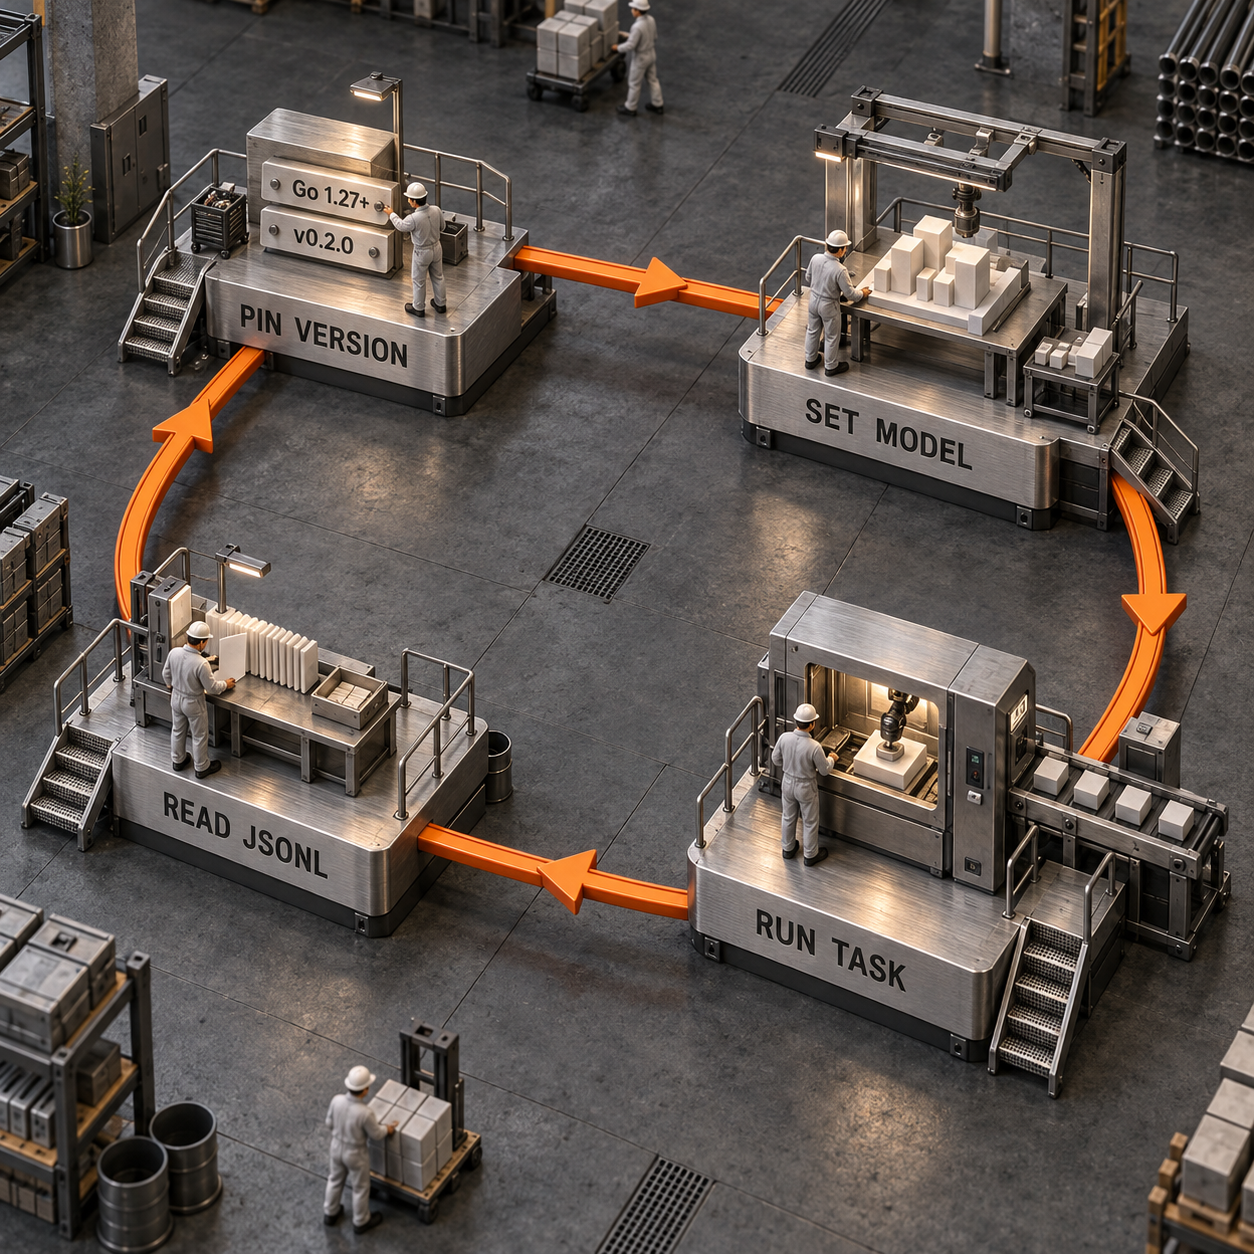
2026年9月24日時点の最新リリースはv0.2.0で、公開はその前日です。ランナーのREADMEではGo 1.27以降が必須とされ、@latestが案内されていますが、再現可能な評価にはリリースタグを使います。
次の実行例では、OpenAI、現行ソースのデフォルトであるgpt-6-astra、highの推論レベルを使用します。モデルを変更する場合は、その変更を必ず記録してください。my-projectの破棄可能なコピーを対象に実行します。
go version
go install github.com/unreallabsai/unreal-agent/cmd/unreal-agent-runner@v0.2.0

export OPENAI_API_KEY="..."
export UNREAL_HARNESS_LLM_PROVIDER="openai"
export UNREAL_HARNESS_LLM_MODEL="gpt-6-astra"

started_at=$(date +%s)
set +e
unreal-agent-runner \
  -workspace ./my-project \
  -session-directory ./unreal-sessions \
  '{"prompt":"Read this repository. Return its purpose, entry points, test command, and three concrete risks. Do not modify files.","model":"gpt-6-astra","thinking_level":"high","session_id":"repo-summary-v1","disallowed_tools":["ViewImage"]}' \
  > run.jsonl
run_status=$?
set -e
elapsed_seconds=$(( $(date +%s) - started_at ))
printf 'exit_status=%s elapsed_seconds=%s\n' "$run_status" "$elapsed_seconds"
jq -c 'select(.Kind=="model_response") | .Data.Response.Usage' run.jsonlランナーはopenai-codex、openrouter、fireworks、ollamaにも対応しています。リクエストでは、モデル、推論レベル、再試行回数、セッションID、システムプロンプト、除外するツールを指定できます。一方、現在はextra_allowed_toolsフィールドが受理されても無視されるため、任意のツールを追加することはできません。
3. 実行結果を証跡として読む
評価記録として役立つのは、次の6項目です。
保存されたセッションはunreal-sessions/repo-summary-v1.session.jsonlです。同じセッションを続けるときは同じsession_idを再利用します。条件を初期化して比較する場合は新しいIDを使ってください。そうしないと、それまでのコンテキストが品質とコストの両方に影響します。
ライブプロバイダーでの実行を完了していないため、ここでは筆者自身による性能結果を提示していません。信頼できる性能値は、自分のリポジトリで実測したものだけです。
ランナーとライブラリ、どちらを選ぶべきか
プロンプトを試す場合、リポジトリ作業を評価する場合、またはCIにプロセスとして組み込む場合は、ランナーを選びます。エージェントを自社プロダクトの内部で動かし、セッション保存、ライフサイクル動作、ツール、セキュリティ、プロバイダー統合を自ら担う準備ができているなら、Goライブラリが適しています。
電動工具と、その中のモーターの違いに似ています。ランナーはスイッチまで取り付けられ、すぐに使える工具です。ライブラリはモーターに当たり、外装、操作系、安全機構を自由に設計できます。セッションの所有権が判断軸になる場合は、関連する整理としてAgents APIとSDKの比較も参考になります。
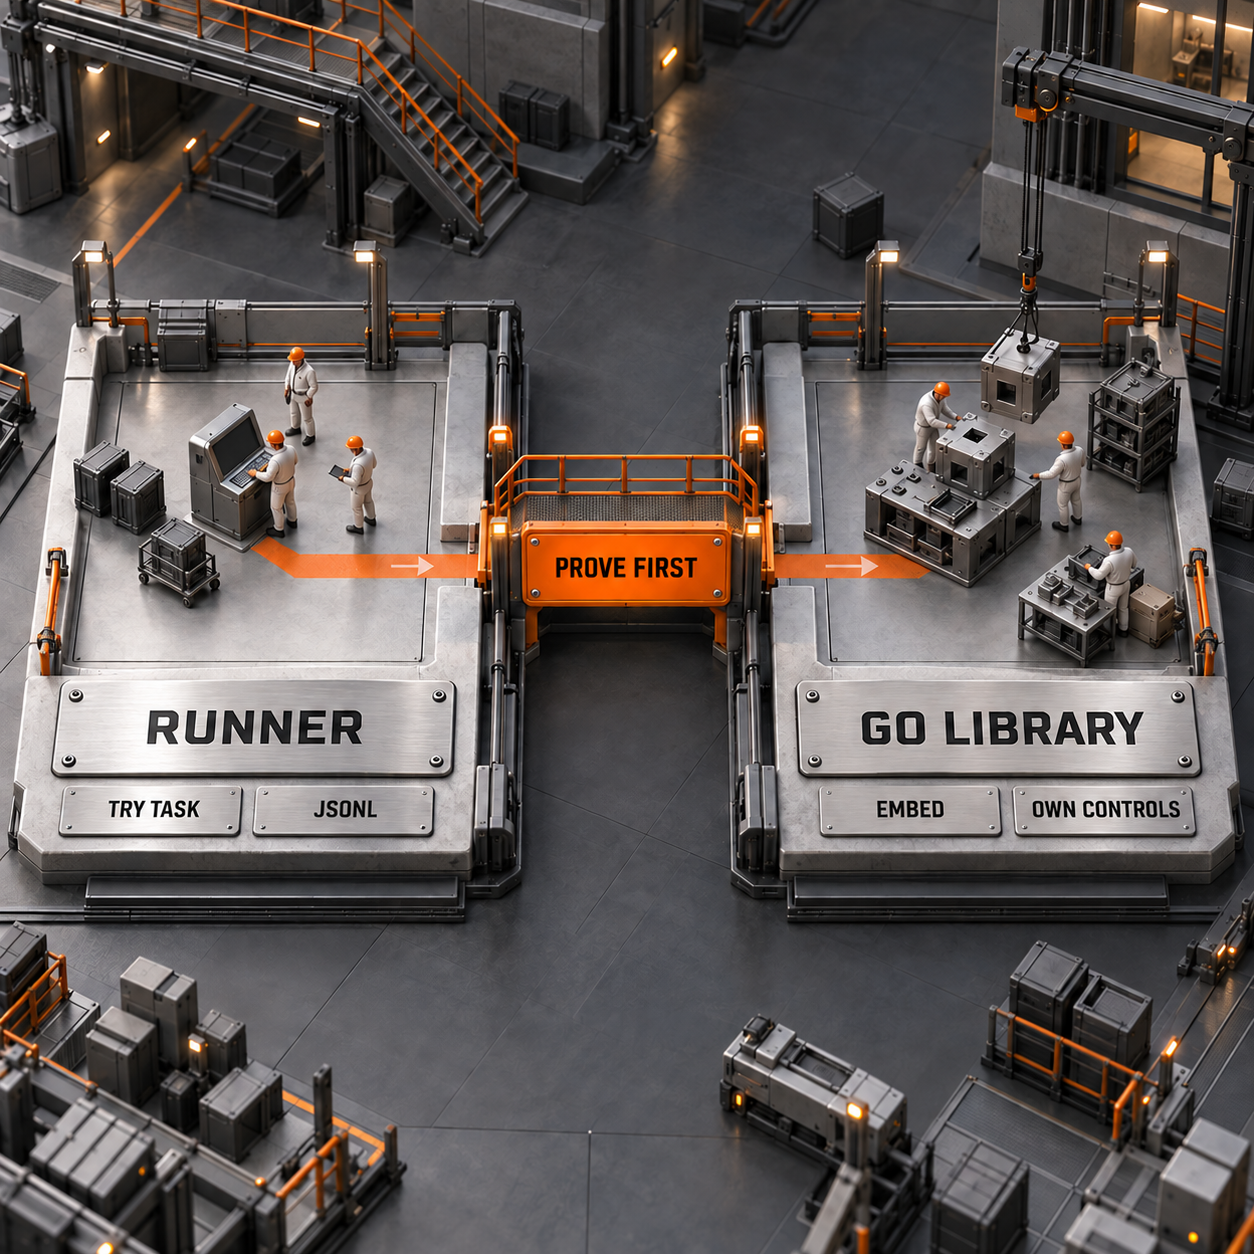
原則としてはランナーが適しています。統合作業を始めると、タスク自体の弱さが見えにくくなるためです。同じ範囲限定プロンプトで有用な結果を2回出せないなら、APIラッパーを加えてもプロダクトの構想は改善しません。
試す価値のある6つの業務を優先順に整理
1. AIが書いたプルリクエストの一次レビュー
大量のAI生成プルリクエストを受け取る開発チームなら、クリーンなチェックアウト、差分、リポジトリのテストコマンドをランナーに渡せます。変更されたコードを調べ、対象を絞ったチェックを実行し、JSONLの証跡を添えたレビューパケットを返す使い方です。目的は、人によるレビューをなくすことではありません。定型的なリポジトリ調査を先に済ませ、レビュアーがアーキテクチャとリスクに集中できるようにします。
2. 新しく参加したエンジニア向けのリポジトリ案内
新しいエンジニアがサービスに参加するたびに、プラットフォームチームが前述の要約プロンプトをそのまま実行できます。出力にはエントリーポイント、テストコマンド、設定、明らかな注意点が整理され、検証用のセッショントレースも残ります。シニアエンジニアが毎回同じリポジトリを最初から説明しなくても、再現可能な最初の1時間を用意できます。
3. 失敗したテストの切り分け
情報量の多いCIエラーに直面した開発者は、失敗したテストを1つ再現し、関連するコード経路を調べ、考えられる原因と無関係な出力を分けるようランナーに依頼できます。環境セットアップ、検索、テスト実行を並行させられるため、ここでは非同期のツール処理が有効です。修正を担当するエンジニアに、絞り込んだ証跡を渡せます。
4. 依存関係アップグレードの事前調査
メンテナーは、1つの依存関係を更新したブランチをエージェントに渡し、影響するimport、非推奨の呼び出し、テストカバレッジ、移行上の注意点を確認できます。出力は自動マージではなく、チェックリストとして使います。本格的な開発時間を確保する前に、作業範囲を素早く見積もれます。
5. リリース準備状況の確認
リリース担当者は、リリース候補に含まれる変更箇所、欠けているマイグレーション、ドキュメントの不足、関連するテストコマンドの確認を依頼できます。セッション記録には、エージェントが実際に調べた内容が残ります。決定論的なCIを置き換えるのではなく、それを補完する一貫した事前確認になります。
6. サポート案件のエスカレーション資料
プロダクトエンジニアは、再現可能な顧客事象を機密情報除去済みのリポジトリ環境に置き、関連しそうなコード経路の追跡、症状の再現、未解決事項の一覧化をランナーに依頼できます。エージェントに顧客の本番システムへのアクセスを与えず、サポートから開発への引き継ぎを構造化できます。
構築候補となる2つのプロダクト
最有力:AI生成コード向けのレビューゲート
隔離されたワークスペースでUnreal Agentを起動し、リポジトリのルールに照らしてプルリクエストをレビューし、許可されたチェックを実行して、人間のレビュアー向けに証跡リンク付きの要約を投稿するGitHubまたはGitLabチェックを構築します。エージェントによるコード生成量が増えているチームが購入者です。
需要は明確です。ai powered code review platformは米国で月間約1,900回、ai code reviewは約1,300回検索され、CPCは$55.73です。既存製品の年額プランは、開発者1人当たり月額$20〜$72のシート予算が成立することを示しています。
販売可能な最小構成は、1つのコードホスト、1つのモデルプロバイダー、固定レビュー用プロンプト、厳格なコマンド許可リスト、JSONLトレースから生成する結果ページです。課題は信頼性にあります。誤検知、機密情報の漏えい、ノイズの多いコメント、安全でないコマンドがあれば、価値はすぐに失われます。それでも、利用頻度が高く、効果を測定でき、既存予算に結び付くため、これが最も有望です。
モデル持ち込み型のリポジトリジョブランナー
チームがリポジトリ、審査済みタスクテンプレート、プロバイダー、モデル、コスト上限を選び、セッショントレースと承認可能な結果を受け取れる、小規模な社内コントロールプレーンを構築します。キュー、隔離、レポート機能を一から作らずにオープンなランタイムを使いたい制作会社やプラットフォームチームが顧客になります。
open source ai coding agentは米国で月間約5,400回検索され、商用意図があり、CPCは$13.11です。レビュー関連の検索語より需要は広い一方、求められるプロダクト像はそれほど具体的ではありません。
MVPは、リポジトリ接続、エフェメラルなワークスペース、2つのタスクテンプレート、プロバイダー設定、ジョブステータス、トークンレポート、ダウンロード可能なJSONLで構成します。課題は差別化です。初期段階のランタイムに薄いダッシュボードを載せるだけなら簡単に模倣されます。本格的な導入企業は、ID管理、監査ログ、ネットワークポリシー、確実なクリーンアップを求めます。製品名ではなく、特定のワークフローと運用上の制御で優位性を築く必要があります。
Unreal Agentだけでは解決できないこと
完全な本番環境の境界は提供されません。ワークスペースフラグはサンドボックスではなく、組み込みのBashツールは与えられた環境内で操作できます。隔離、ネットワークポリシー、認証情報、承認、クリーンアップは利用側の責任です。
プロバイダー間の違いもなくなりません。Unreal Labsによると、テストした一部の非OpenAI推論プロバイダーでは、一部のモデルが処理中結果と最終結果を組み合わせるツール結果パターンを拒否しました。実際に提供するプロバイダーとモデルの組み合わせをそのまま検証してください。
複雑なオーケストレーションも備えていません。サブエージェントやワークフローを持たない小さなフットプリントは、効率性の根拠でもあります。そのため、視覚的なワークフロービルダー、大規模なマネージドコネクター群、すぐに使える専門エージェントへの委任がプロダクトに欠かせない場合には不向きです。
自社ワークロードでの削減効果も証明してくれません。モデルの選択、推論量、キャッシュ動作、ツール出力、再試行、タスクの成否はいずれも請求額を変えます。設定が異なる生のトークン総数ではなく、正常に完了したタスク同士を比較してください。
月曜日に着手すること
月曜日にプラットフォームエンジニアが行うべきことは、v0.2.0を固定し、認証情報を含まないリポジトリのコピーを1つ用意して、同じモデルと推論レベルでリポジトリ要約タスクを2回実行することです。JSONL、セッションファイル、終了ステータス、所要時間、トークン使用量、リポジトリの差分を保存します。両方の実行結果が有用で、変更もなければ、現在のエージェントでも同じタスクを試します。その結果を見て初めて、レビューワークフローの検証に進むか、ライブラリを組み込むかを判断します。
Unreal Agentとは何ですか?
Unreal Agentは、Unreal Labsが開発した非同期処理を中核とするGo製エージェントランタイムです。Goライブラリ、インストール可能なコマンドラインランナー、Harbor互換のベンチマークランナーが含まれます。Epic GamesのUnreal Engineとは関係ありません。
Unreal Agentの実行には何が必要ですか?
ソースからインストールする場合は、Go 1.27以降、ワークスペース、対応プロバイダーの設定、モデル、必要なプロバイダー認証情報を用意します。ランナーはOpenAI、OpenAI Codex、OpenRouter、Fireworks、Ollamaに対応しています。
Unreal Agentはセッションを再開できますか?
はい。JSONリクエストにsession_idを設定します。同じIDを再利用すると保存済みセッションが再開され、新しいIDを使うと新規セッションが作成されます。
ワークスペースフラグはエージェントをサンドボックス化しますか?
いいえ。このフラグが指定するのは、ワークスペースとBashの作業ディレクトリです。プロセスは別のサンドボックスまたは破棄可能な環境内で動かし、そこで認証情報とネットワークアクセスを制限してください。
Unreal AgentはCodexより安いですか?
Unreal Labsは、自社ワークロードと公開ベンチマークでCodex比最大40%のコスト削減を報告しています。これはベンダーによる結果であり、保証ではありません。結論を出す前に、同じモデル、推論レベル、プロンプト、リポジトリの状態、成功条件で比較してください。
自社ワークフローに合わせた制御可能なリポジトリエージェントを構築したい場合は、AIエージェント開発をご覧ください。
- 最終更新
- 2026年9月24日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Cursor 料金を検証:Rolloutsは無料で使えるのか
Cursor Rolloutsは無料ではなく、Teamsは1ユーザー月額$40、Enterpriseは個別見積もりです。10日間のローンチクレジットでTeamsは約50件、Enterpriseは約500件の変更を試せますが、その後の単価は未公表。料金の仕組みと導入判断を整理します。2026年9月24日Build
JetBrains Airの使い方:Alphaプラグイン導入・設定・レビュー手順
JetBrains Airの使い方を、Air Alphaの導入からエージェント接続、@file:でのコンテキスト指定、差分レビュー、テスト、元に戻す判断まで実践的に解説します。Standard Accessで小さな修正から安全に始める手順に加え、料金、互換性、具体的な活用例も分かりやすくまとめました。2026年9月23日Build
JetBrains Airは無料?料金の仕組みと支払元を徹底整理
JetBrains AirのAir Alphaプラグインは無料ですが、IDE本体や接続するAIエージェント、API利用料まで無料とは限りません。Junie Lite、既存アカウント、APIキー、JetBrains AIという4つの認証経路ごとに、誰が料金を負担するのかを公開情報と具体的な料金比較で整理します。2026年9月23日Build
Firecrawl APIをセルフホストする方法:Docker導入と料金比較
Firecrawl APIをセルフホストする手順を、v2.11.162への固定、実スクレイプと再起動後の検証、証跡保存まで詳しく解説します。さらにFirecrawl Cloudとの機能差と30日間の費用を比較し、セルフホストを選ぶべき条件、運用負荷、導入前に確認すべきセキュリティと本番要件を整理します。2026年9月22日Build
生成AI ガバナンスの盲点:有料リトライを人が承認する設計
AIエージェントが自らの品質判定で有料レンダリングを再実行し、人が確認する前に$5.48を消費した事例を解説します。生成AI ガバナンスで見落としやすいのは、レビュー権限と購入権限の違いです。人だけが承認を書き込めるフィールドを設け、有料ツール呼び出しの直前で再購入を拒否する実装と、その適用範囲を具体的に整理します。2026年9月22日Build
AIエージェント 作り方ガイド:MindStudioの料金・機能・運用コストを検証
MindStudioでAIエージェントをどう作るのか。ノーコードのワークフロー設計、料金、モデル利用料、レビュー工数、競合ツールとの違いを公開情報から検証します。1,000件・10,000件のコスト試算、Businessプランの壁、導入前に実施すべき20件の合成データテストまで、購入判断に必要な条件を解説します。2026年9月22日Build
音声文字起こしツール比較:SuperwhisperとWispr Flow、どちらを選ぶ?
SuperwhisperとWispr Flowを、ローカル/クラウド処理、対応デバイス、チーム管理、修正作業、料金で比較。業務向けの音声文字起こし・音声入力ではどちらを選ぶべきか、検証済みの仕様と価格、20発話の修正プロトコルから判断します。速度や精度を断定せず、用途別の選び方と長期コストを整理します。2026年9月22日Build