Claude Opus 5.5 vs Opus 5: qual vale mais a pena?
Claude Opus 5.5 reduz preços e avança nos benchmarks publicados, mas traz mudanças na API. Compare custos, desempenho e riscos antes de migrar.


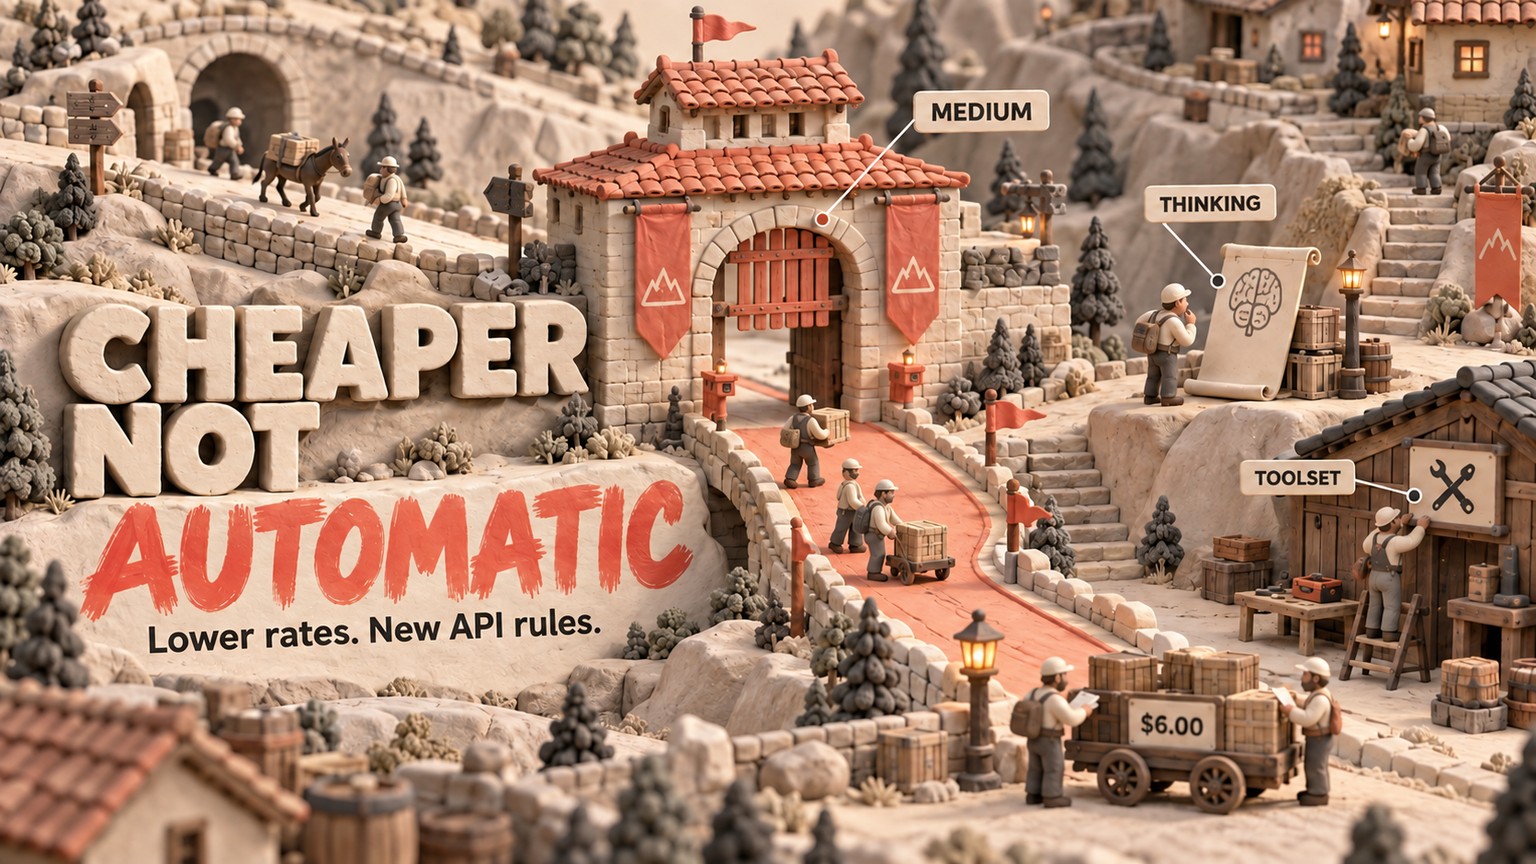
Claude Opus 5.5 é a atualização que vale testar na maioria das cargas hoje executadas com o Opus 5: 1 milhão de tokens de entrada sem cache mais 100,000 tokens de saída faturados custam $6.00, em vez de $7.50. A escolha entre Claude Opus 5.5 e Opus 5 ainda depende de cinco mudanças de integração, porque o modelo mais barato não substitui diretamente o anterior em todos os agentes.
Claude Opus 5.5 vs Opus 5: qual escolher?
Para novos trabalhos premium, comece com o Claude Opus 5.5 e teste-o como substituto na maioria das rotas que usam Opus 5. Mantenha o Opus 5 temporariamente quando a integração desativa o raciocínio, força uma ferramenta específica ou ainda usa a ferramenta de computador anterior na Claude API ou no Google Cloud. São decisões de arquitetura do código, não meras diferenças de preferência entre modelos.
O Claude Opus 5.5 é a melhor escolha para um fundador com capital cujo agente de programação gasta o bastante para que leituras de cache e novas tentativas pesem no orçamento. Um CTO de empresa de médio porte também deve preferi-lo, mas só depois que a equipe de plataforma resolver as mudanças no formato das requisições. Um profissional sênior de operações que execute extrações bem delimitadas deve primeiro verificar se o Claude Sonnet 5 já alcança o nível de aceitação exigido por um preço menor. Para quem desenvolve sozinho, vale direcionar ao 5.5 os trabalhos difíceis em repositórios e manter as tarefas mais baratas fora da linha Opus.
A decisão volta a favorecer o Opus 5 quando o trabalho de migração custa mais que a economia esperada e a rota antiga já é confiável. Trata-se de uma vantagem temporária de compatibilidade, não de um motivo para começar um projeto novo com o modelo anterior.
A Anthropic lançou o Opus 5.5 em 22 de setembro de 2026. O guia de modelos da empresa agora orienta desenvolvedores indecisos a começar pelo Opus 5.5 na maioria das cargas, enquanto o modelo anterior continua útil como opção de rollback durante a migração.
Preço do Claude Opus 5.5 vs Opus 5
O Claude Opus 5.5 custa menos em qualquer volume idêntico de tokens padrão. Os preços verificados na documentação de preços da Anthropic em 23 de setembro de 2026 são de $4 por milhão de tokens de entrada e $20 por milhão de tokens de saída no 5.5, contra $5 e $25 no Opus 5. É uma redução de 20% na tarifa de tabela. A leitura de cache corresponde ao conteúdo de prompt reutilizado; seu preço cai de $0.50 para $0.20 por milhão, uma redução de 60%.
Em uma unidade menor, 1,000 tokens de entrada sem cache custam $0.004 no 5.5, contra $0.005 no 5. A saída custa $0.020, contra $0.025 por 1,000 tokens. Nenhum dos modelos tem, nesta comparação de API, um ponto de equilíbrio baseado em mensalidade por licença ou preço fixo por imagem. A cobrança acompanha os tokens; portanto, o 5.5 nunca fica mais caro quando o perfil de tokens faturados permanece idêntico.
A conta sem cache é direta: o Opus 5 cobra $5 pela entrada e mais $2.50 pela saída. No Opus 5.5, são $4 mais $2. O cálculo com cache aquecido considera 100,000 tokens de entrada sem cache, 900,000 tokens lidos do cache e 100,000 tokens de saída. Foram excluídos de propósito a criação de cache, as ferramentas, as novas tentativas, os descontos por processamento em lote, o modo rápido e os multiplicadores de residência de dados.
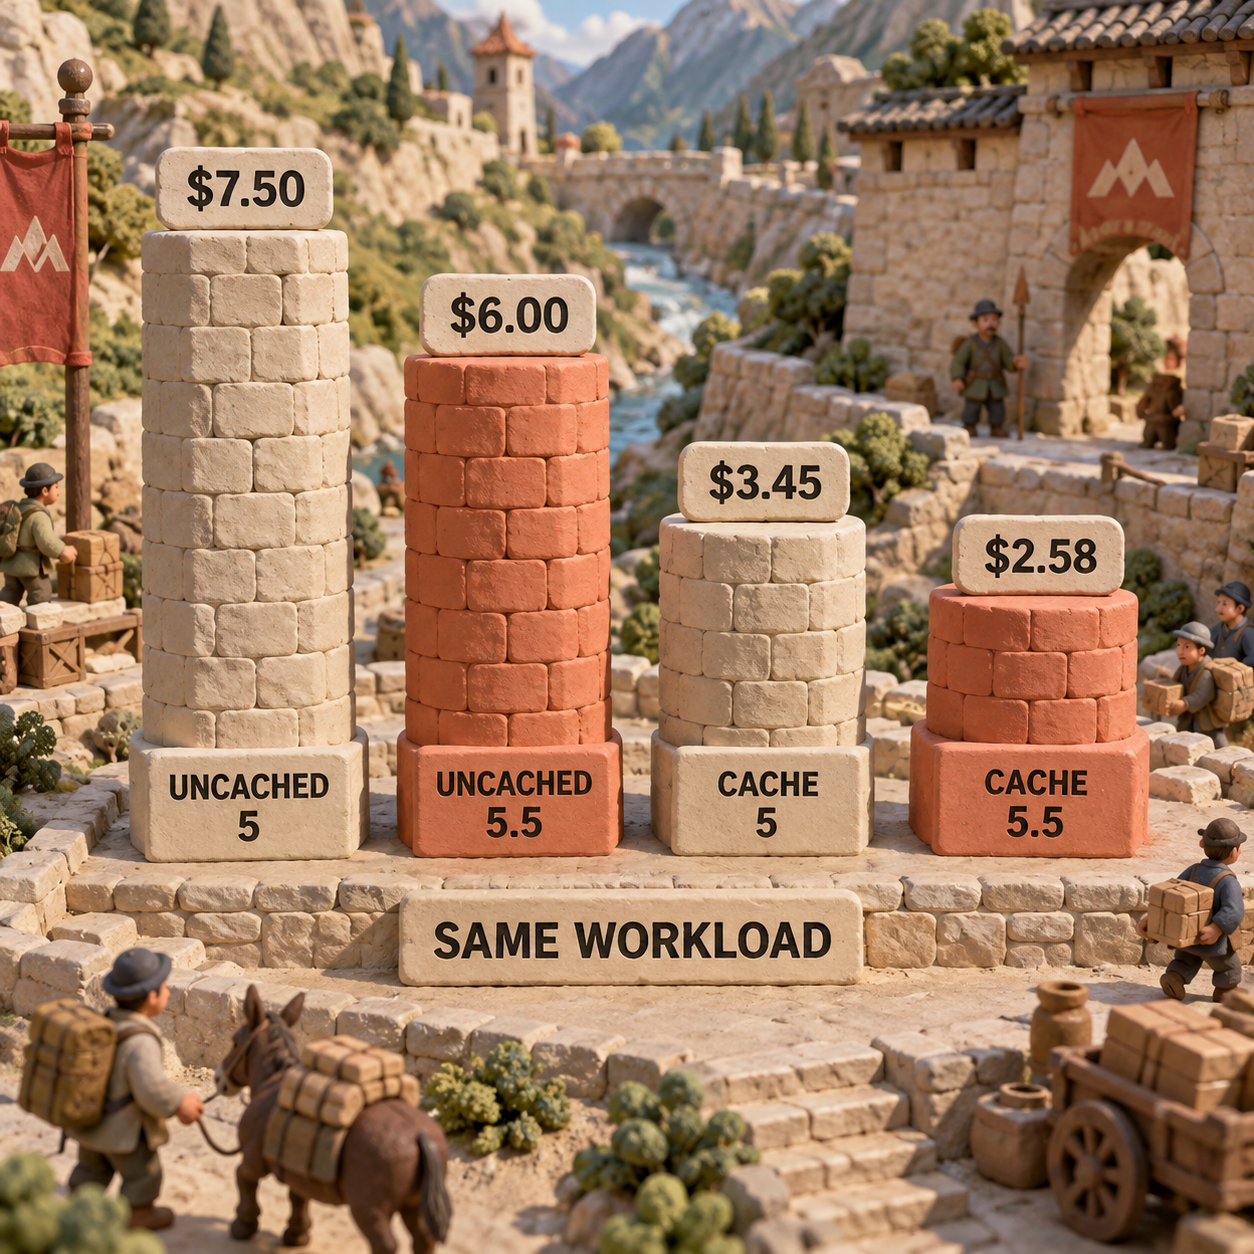
A afirmação separada da Anthropic de que o 5.5 custa 40% menos em cargas típicas é uma medição do fornecedor, não outro cálculo com a tarifa de tabela. Segundo a empresa, o modelo combina preços menores com menos tokens por tarefa nas configurações padrão. Mantenha essa afirmação separada das planilhas de tokens fixos, em vez de aplicar um desconto de 40% a toda estimativa.
O verdadeiro ponto de equilíbrio está no comportamento de consumo dos tokens. No cálculo sem cache, o 5.5 poderia gerar 175,000 tokens de saída, 75% a mais que a referência de 100,000 tokens do Opus 5, antes de a conta chegar aos mesmos $7.50. No cenário com cache aquecido, poderia chegar a 143,500 tokens de saída, 43.5% a mais, antes de igualar os $3.45. Se uma migração ultrapassar esses limites sem melhorar a aceitação, a tarifa menor terá deixado de gerar vantagem.
Vencedor em preço: Claude Opus 5.5. A vantagem tarifária é incondicional quando o uso é igual. Já a vantagem na carga real ainda precisa se sustentar diante do consumo medido de tokens e das novas tentativas.
Claude Opus 5.5 em programação: o que as evidências publicadas sustentam
O Claude Opus 5.5 tem o caso documentado mais forte para programação, mas nenhum teste de modelo foi executado nesta comparação. Como não havia credencial de execução disponível, este artigo não afirma ter produzido, nesta rodada, um reparo de repositório, uma tarefa de extração, um ID de modelo retornado, dados de latência ou um resultado de validação.
Análise do Claude Opus 5.5 vs Opus 5: os limites das evidências
Nas avaliações de lançamento da Anthropic, o Opus 5.5 com o esforço padrão medium alcançou 52.5% no CursorBench 4.0, teste de tarefas ambíguas de programação em vários arquivos extraídas de sessões do Cursor, enquanto o Opus 5 em max marcou 46.6%. A Anthropic também informa geração de saída mais de 30% mais rápida. Esses dados são bons motivos para avaliar o modelo, mas as configurações de esforço são diferentes e a comparação foi conduzida pelo fornecedor.
O AutomationBench oferece um sinal medido separadamente. A nota de rodapé do lançamento da Anthropic informa que a Zapier executou e divulgou o benchmark: o Opus 5.5 marcou 40.0%, e o Opus 5, 26.9%. O teste cobre fluxos de trabalho com aplicativos conectados, não todos os códigos ou processos de negócio, e não revela como seu modelo de permissões, suas ferramentas ou seu validador vão se comportar.
Para um agente de programação, defina a aceitação antes da execução: os testes precisam passar, o diff deve permanecer dentro do escopo e a revisão não pode encontrar trabalho corretivo. Em extrações, exija um esquema exato, valores fundamentados nas fontes e um validador determinístico. Depois, registre tokens de entrada, tokens de cache, tokens de saída, latência, chamadas de ferramentas, novas tentativas e falhas. Uma pontuação maior em benchmark não paga a conta se o seu sistema de avaliação gerar mais trabalho rejeitado.
Vencedor nas evidências documentadas de programação: Claude Opus 5.5. O nível de confiança é suficiente para justificar uma avaliação controlada, mas não uma migração cega para produção.
Cinco mudanças na API do Claude Opus 5.5 que podem impedir uma troca direta
Cinco verificações de integração importam mais que a simples alteração da string do modelo. A documentação atual de mudanças do Opus 5.5 da Anthropic descreve quatro mudanças que quebram requisições e uma alteração no formato da resposta capaz de falhar silenciosamente na interface.
1. O raciocínio não pode ser desativado
O Opus 5.5 sempre usa raciocínio adaptativo. Uma requisição com thinking:{"type":"disabled"} retorna HTTP 400, assim como um orçamento manual de raciocínio com thinking:{"type":"enabled","budget_tokens":N}. Omita o campo ou envie raciocínio adaptativo e controle a profundidade com output_config.effort.
O Opus 5 aceitava raciocínio desativado em high ou abaixo. Uma rota estável e de baixa latência construída em torno dessa opção exige, portanto, uma reformulação — não apenas um novo ID de modelo.
2. Forçar a escolha de ferramenta gera erro
O Opus 5.5 rejeita tool_choice definido como any ou como uma tool específica, também com HTTP 400. auto e none continuam compatíveis. Para produzir saídas válidas segundo um esquema, a Anthropic recomenda uso estrito de ferramentas com auto ou saídas estruturadas.
Essa é uma mudança relevante de contrato. Instruir o modelo no prompt a chamar uma ferramenta não equivale ao mecanismo de imposição no nível da API. Se um fluxo depende da execução de exatamente uma função, valide o caminho substituto antes de redirecionar o tráfego.
3. Blocos de raciocínio ficam vinculados ao modelo e à conversa
Blocos de raciocínio são registros da resposta que preservam o raciocínio do modelo entre turnos com uso de ferramentas. O Opus 5.5 consegue ler blocos produzidos pelo Opus 5; assim, uma conversa em que apenas se acrescentam mensagens pode avançar sem descartar o raciocínio anterior. A restrição é que o 5.5 não lê blocos de todos os modelos, e alterações posteriores no prompt de sistema, nas ferramentas ou nas mensagens anteriores podem invalidar o raciocínio que ele próprio preservou.
Em contas da API criadas em ou após 31 de agosto de 2026 às 00:00 UTC, repetir um bloco vinculado depois de uma dessas alterações no prefixo retorna HTTP 400 por padrão. Mantenha o histórico somente para acréscimos. Se o aplicativo editar turnos anteriores ou substituir definições de ferramentas durante a execução, use os controles de vinculação documentados pela Anthropic e teste explicitamente o comportamento de descarte.
4. O uso do computador varia conforme a plataforma
Na Claude API e no Google Cloud, o Opus 5.5 rejeita a ferramenta anterior computer_20251124 e exige computer_toolset_20260801. A migração vai além da string de tipo: o loop do agente precisa tratar blocos tool_use emitidos pelos membros do toolset, ações em lote e toolset_name nos resultados. A documentação de uso do computador da Anthropic informa que o Amazon Bedrock continua aceitando a ferramenta anterior no 5.5.
Essa diferença entre plataformas pode fazer a mesma implantação multicloud funcionar em uma delas e retornar erro em outra. Audite em conjunto o provedor e o corpo da requisição.
5. O texto de progresso pode sumir sem erro
O Opus 5.5 devolve notas curtas entre chamadas de ferramentas como blocos thinking de atualização de progresso, em vez de blocos text comuns. Com o padrão display:"omitted", o texto de raciocínio fica vazio. Uma interface que usava esses blocos de texto para exibir progresso pode ficar silenciosa mesmo que as requisições e chamadas de ferramentas continuem funcionando.
Vencedor em compatibilidade de integração: Claude Opus 5. O código existente do Opus 5 exige menos mudanças. O Opus 5.5 vence depois que elas forem implementadas e validadas.
Raciocínio no Opus 5.5: recalibre esforço, tokens e interface
A comparação mais segura define o esforço explicitamente, pois os padrões mudaram. O Opus 5.5 começa em medium; o padrão do Opus 5 era high. A Anthropic também afirma que o 5.5 tende a raciocinar mais por turno no mesmo nível de esforço, sobretudo em xhigh e max. Uma execução padrão contra padrão mede a experiência entregue. Uma execução high contra high isola melhor a diferença entre os modelos.
O modelo tem uma janela de contexto de 1 milhão de tokens e saída máxima de 128,000 tokens, segundo a visão geral dos modelos da Anthropic. O raciocínio e o texto visível compartilham o orçamento da resposta; portanto, reserve espaço suficiente para a conclusão e registre a saída faturada, em vez de tratar o nível de esforço como orçamento.
Uso do Opus 5.5 vs Opus 5
Registre o objeto completo de uso, não apenas o tamanho visível da resposta. No mínimo, guarde entrada sem cache, criação de cache, leituras de cache, saída, latência, chamadas de ferramentas, novas tentativas, motivo de parada e resultado do validador. Separe as configurações padrão das execuções com esforço equivalente, pois misturar medium e high pode fazer uma redução de custo parecer um ganho puro de capacidade.
A análise anterior do seletor de esforço do Opus 5 continua sendo uma referência histórica útil sobre o significado dos níveis. Para a migração, a lição é mais específica: não herde um nível antigo nem deixe a configuração ausente sem executar novamente a carga.
Vencedor em controle de gastos: decisão dividida. O Opus 5 permite desativar explicitamente o raciocínio. O Opus 5.5 traz um padrão mais baixo e tarifas menores, mas o raciocínio está sempre presente e precisa ser medido.
Migração para o Opus 5.5: qual é o custo real da troca?
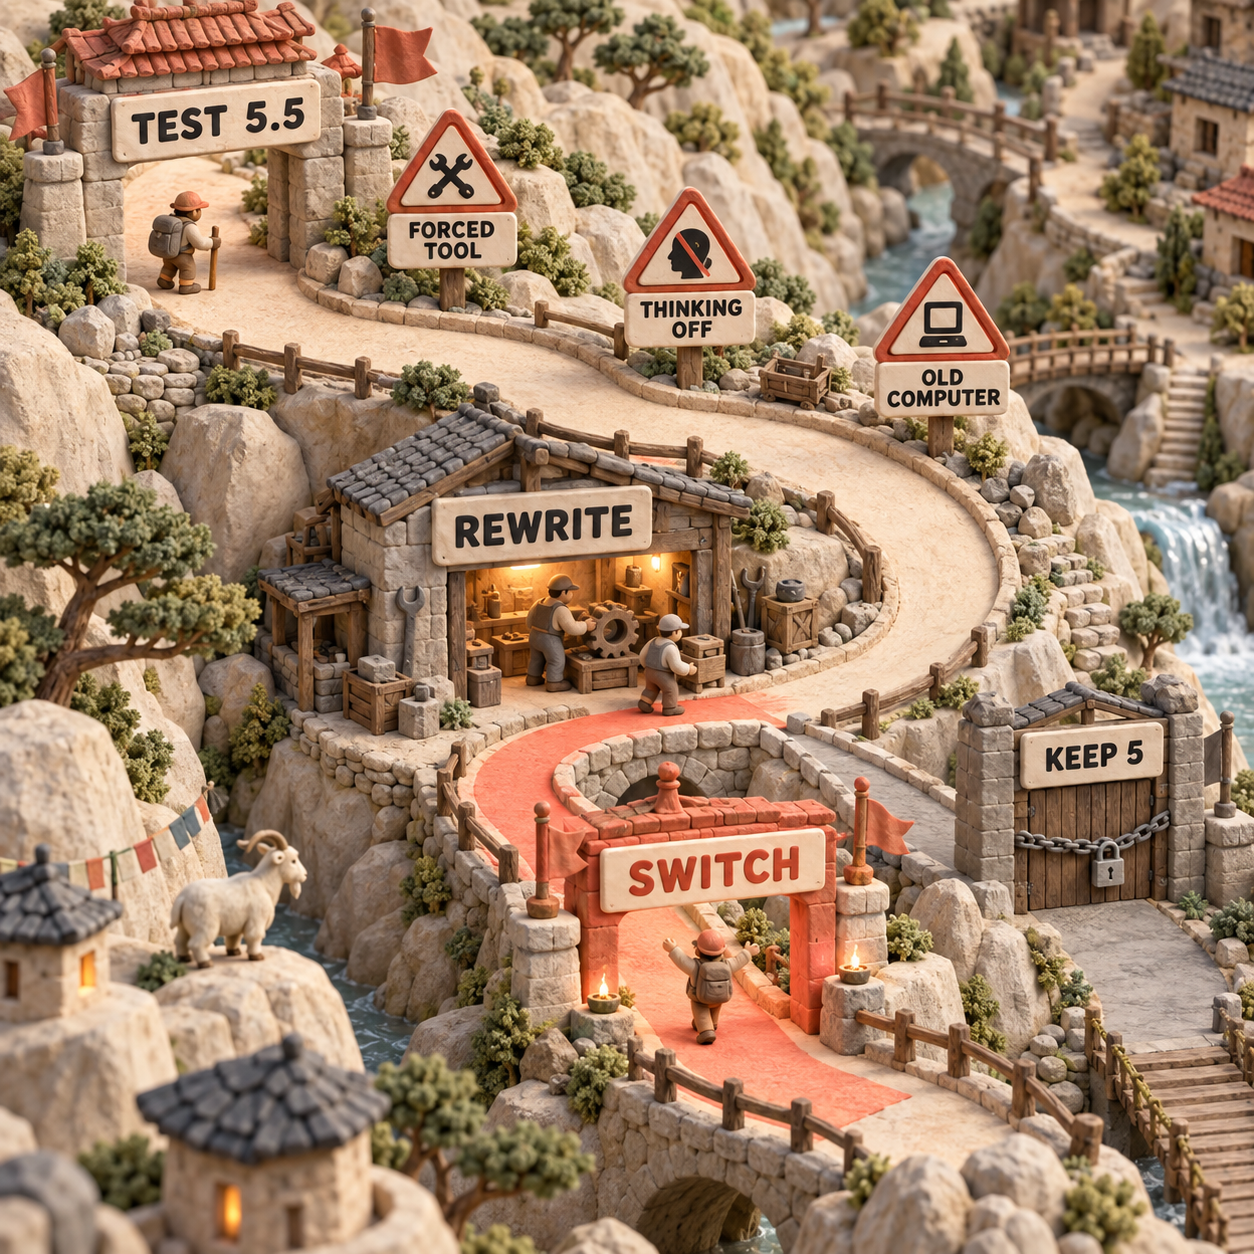
O custo da migração está no trabalho ao redor da chamada ao modelo: auditoria das requisições, alterações no loop do agente, regras para contexto preservado, renderização do stream, avaliação e rollback. Trocar apenas a string do modelo basta somente quando a rota já usa raciocínio adaptativo, seleção automática de ferramentas, um conjunto de ferramentas de computador compatível, histórico somente para acréscimos e interpretação do stream sensível aos tipos de bloco.
Ainda não migre se qualquer uma destas condições se aplicar:
- Uma ferramenta específica precisa ser imposta no nível da API, e o fluxo não pode migrar para o uso estrito de ferramentas ou para saídas estruturadas.
- O contrato da rota exige que o raciocínio seja desativado.
- Um agente de computador na Claude API ou no Google Cloud ainda usa
computer_20251124, e seu loop ainda não consegue lidar com o conjunto de ferramentas. - O aplicativo reescreve mensagens anteriores ou definições de ferramentas ao repetir blocos de raciocínio preservados.
- Não existe uma referência de aceitação; portanto, não é possível distinguir uma conta menor de trabalho com qualidade inferior.
Inventarie todos os formatos de requisição do Opus 5
Procure nas configurações e nos construtores de requisições pelo ID do modelo,
thinking,output_config.effort,tool_choice, blocos de raciocínio preservados e tipos de ferramenta de computador. Verifique cada provedor de nuvem separadamente. Registre qual rota controla o rollback.Execute duas tarefas com esforço equivalente
Use um reparo bem delimitado em código público com testes executáveis e uma extração sintética com validador de esquema determinístico. Envie aos dois modelos o mesmo prompt, as mesmas ferramentas, o mesmo contexto, esforço
highexplícito e limite de saída explícito. Salve os IDs de modelo retornados, o uso completo, a latência, os resultados de validação e todas as falhas.Compare os padrões separadamente
Repita com o esforço omitido. Isso isola o Opus 5.5 em seu padrão
mediumdo Opus 5 em seu padrãohighe revela o efeito em produção que uma simples troca de ID do modelo provocaria.Corrija os caminhos incompatíveis
Remova o raciocínio desativado ou com orçamento manual, substitua a escolha forçada de ferramenta, migre a ferramenta de computador anterior quando necessário, preserve um histórico somente para acréscimos e teste a exibição do progresso. Mantenha cada mudança visível na revisão, em vez de escondê-la dentro da atualização do modelo.
Faça o staging, meça e promova
Direcione uma parcela limitada do trabalho representativo ao 5.5. Compare o custo por resultado aceito, não apenas o preço por token. Promova uma categoria de tarefa somente quando a aceitação se mantiver ou melhorar e o custo total cair; preserve o Opus 5 como rollback até o fim da janela de observação.
Um fundador com capital pode executar esse sistema de avaliação antes do próximo lançamento do agente. Um CTO deve tratá-lo como uma mudança na camada de modelos, com responsáveis por API, observabilidade e interface do produto. Um profissional sênior de operações deve acrescentar revisão humana às ações irreversíveis, independentemente do vencedor. Quem desenvolve sozinho pode manter a avaliação pequena, mas ainda deve salvar o uso e o resultado do validador para que a escolha se apoie em evidências, não em impressão.
Sua ação para segunda-feira
Na próxima segunda-feira, escolha uma tarefa cara e repetível do Opus 5 e crie uma rota paralela para claude-opus-5-5. Primeiro, execute os dois com esforço high explícito; depois, compare os novos padrões. Não altere a produção antes que as verificações de ferramenta forçada, raciocínio, computador, contexto preservado e stream de progresso estejam verdes.
A decisão final é simples: adote o 5.5 quando o resultado aceito custar menos e o contrato de integração continuar válido. Mantenha o Opus 5 apenas diante de uma incompatibilidade específica ou de uma regressão medida. Uma preferência vaga pelo que já é conhecido não é requisito de produção.
Qual versão do Claude Opus é melhor?
O Claude Opus 5.5 é o melhor ponto de partida para novos trabalhos porque suas tarifas padrão e leituras de cache custam menos, e suas avaliações publicadas são superiores. Use o Opus 5 como rota temporária de compatibilidade ou rollback enquanto uma configuração incompatível ainda não tiver sido migrada.
Claude Opus 5 é melhor que GPT 5.6 Sol?
Esta comparação de migração entre dois modelos não permite essa conclusão. Uma decisão entre fornecedores exige o mesmo sistema de avaliação, as mesmas ferramentas, os mesmos controles de esforço, preços e critérios de aceitação nos dois fornecedores — não uma pontuação copiada da página de lançamento de um deles.
Claude Opus 5 é melhor?
O Opus 5 não é a melhor opção padrão quando comparado ao Opus 5.5 em preço ou nas avaliações publicadas pela Anthropic. Ele só é a melhor escolha temporária quando for obrigatório desativar o raciocínio, forçar a seleção de ferramenta ou preservar sem mudanças uma integração de computador.
Existe algo melhor que Claude Opus?
A Anthropic posiciona o Claude Fable 5.1 como o modelo de escalonamento para raciocínios exigentes ou trabalhos de longo prazo que ainda falham nas avaliações do Opus 5.5 com esforço maior. Ele custa $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída; portanto, deve resolver uma falha medida, e não substituir o Opus por padrão.
Por que Claude Opus é tão caro?
O Opus ocupa a faixa premium de trabalho da Anthropic. A conta só se justifica quando ele evita tentativas malsucedidas, erros de ferramentas ou revisão humana em quantidade suficiente para superar o custo por resultado aceito de um modelo mais barato. O Opus 5.5 reduz esse adicional, mas não elimina a necessidade de encaminhar tarefas simples a outros modelos.
Fable é realmente melhor que Opus?
Não em toda carga. O Fable é um caminho de escalonamento para uma tarefa que não alcança o nível de aceitação no Opus 5.5; o preço unitário maior precisa comprar uma melhoria mensurável nessa tarefa.
Qual é a diferença de preço entre Opus 5 e Fable 5?
O Claude Opus 5 custa $5 por milhão de tokens de entrada e $25 por milhão de tokens de saída. O Claude Fable 5 custa $10 e $50, exatamente o dobro dessas tarifas padrão.
Qual é a diferença entre Opus 5 e Fable 5?
O Opus 5 é o modelo premium de trabalho com menor custo, enquanto o Fable 5 é a opção mais cara para escalar as tarefas mais difíceis. Na prática, a diferença está em saber se o Fable passa por um teste de aceitação no qual o Opus falha, com vantagem suficiente para cobrir as tarifas de tokens 2x maiores.
Opus 5 usa mais tokens?
Não existe uma proporção universal de tokens. A Anthropic afirma que o Opus 5.5 usa menos tokens por tarefa típica, mas ele pode raciocinar mais por turno no mesmo nível de esforço, e esse raciocínio não pode ser desativado. Meça o uso total faturado na mesma carga aceita.
Precisa de uma seleção mais enxuta de modelos antes de gastar uma semana em avaliações? Conheça o Mapa de Ferramentas de IA para Donos de Negócios.
- Última atualização
- 23 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

GPT-6 Sol ou Luna: qual escolher e quando pagar mais
Compare GPT-6 Sol e Luna em preço, programação e adequação à tarefa — e veja quando a qualidade do Sol realmente compensa o custo 20× maior.23 de set. de 2026AI
GPT-6 Luna grátis: onde usar e quanto custa
O GPT-6 Luna é grátis no app para desktop, mas Work, Codex e API seguem regras diferentes. Veja acesso, preços, limites e quando vale pagar.22 de set. de 2026AI
Xiaomi MiMo: como usar o MiMo-V2.6 na prática
Aprenda a testar o Xiaomi MiMo no Studio, configurar a API do MiMo-V2.6, escolher entre Flash e Pro e levar o fluxo à produção com segurança.22 de set. de 2026AI
Xiaomi MiMo V2.6: Pro ou Flash? O custo decide
Compare Xiaomi MiMo V2.6 Pro e Flash em preço, benchmarks, cache e qualidade. Veja quando pagar pelo Pro e quando manter o Flash como padrão.22 de set. de 2026AI
MiMo V2.6 grátis: o que custa zero e o que é pago
Entenda onde o MiMo V2.6 é grátis, quando a promoção termina, o que a licença MIT cobre e quanto custam as APIs Flash, Pro e UltraSpeed na prática.22 de set. de 2026AI
Grok 4.7 vs Grok 4.6: qual modelo escolher?
Grok 4.7 vs Grok 4.6: compare desempenho, preços da API, contexto e custos de migração para decidir qual modelo usar em cada carga de trabalho.21 de set. de 2026AI
Agentes de IA em produção: quando cumprir regras vira o problema
Um editor de IA tirou 50 de 96 artigos do foco. Entenda os custos medidos, as regras que premiaram o desvio e os controles adotados para corrigi-lo.21 de set. de 2026AI