Claude Code 推理强度上限:团队策略与实测方法
Claude Code 2.1.267 新增 maxEffortLevel,可在用户、项目或托管设置中为推理强度设定硬上限。本文讲清最低上限优先规则、按模型例外与验证方法,并用同一任务对照质量、token 消耗和成本,帮助平台团队稳妥落地可执行的 effort 策略,避免配置看似生效却被更低作用域覆盖。


现在可以给日常 Claude Code 任务锁住 Claude Code 推理强度,不再让它悄悄升档。Claude Code 2.1.267 新增了 maxEffortLevel:无论开发者、命令、环境变量还是模型默认值要求投入更多推理,它都会把每次请求压在你允许的最高级别以内。
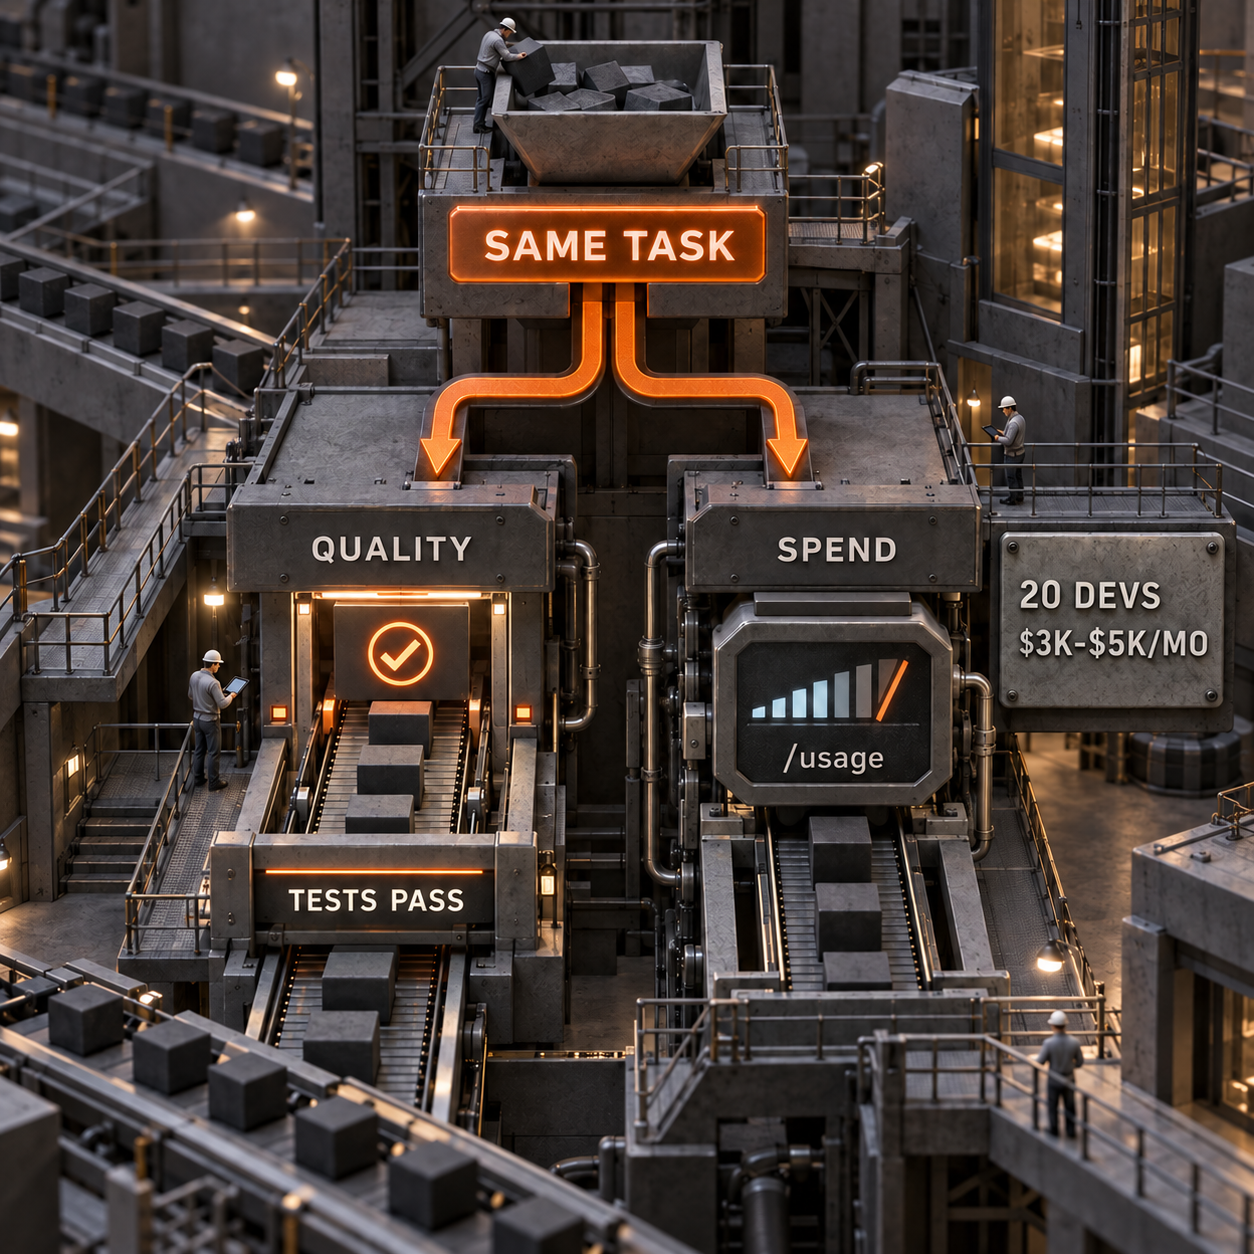
这样一来,effort 不再只是个人偏好,而是可以执行的运行策略。Anthropic 表示,按 API 计费的企业部署平均每位开发者每月约花费 $150 到 $250;如果有 20 名活跃开发者,每月基准成本就是 $3,000 到 $5,000。设置上限并不能承诺节省某个固定比例,却能让团队在扩大使用规模之前,在受控条件下验证质量与 token 开销的关系。
先说结论:如何设置推理上限
先升级到 Claude Code 2.1.267 或更高版本,再根据需要约束的人员和项目,把 "maxEffortLevel": "medium" 写入相应设置文件。个人全局上限放在 ~/.claude/settings.json;单个仓库的共享规则放在 .claude/settings.json;需要覆盖整个组织时,则使用托管设置。
这个配置项接受 low、medium、high、xhigh 或 max。值为 max,表示该配置来源不对 effort 设限;完全不设置这个键,同样代表没有上限。
可以把它理解成限速器,而不是预算卡。它限制的是 Claude 在单次请求上能投入多深的推理,并不会设定 token 配额、金额预算或订阅用量上限。后几项仍需通过 /usage、Claude Console 或 Claude Code OpenTelemetry 单独衡量。
Claude Code 推理强度:maxEffortLevel 到底改变了什么
effortLevel 与 maxEffortLevel 分工不同:前者是会话或模型请求使用的 effort 级别,后者则是这次请求绝不能越过的边界。
假设上限是 medium,开发者仍可选择 low 或 medium;即使请求 high、xhigh 或 max,实际也只会按 medium 运行。通过 /effort、/model 选择器、--effort、CLAUDE_CODE_EFFORT_LEVEL 或模型默认值提出的 effort 请求,也都受这一上限约束。Claude Code 会在每次请求发出前于客户端执行该策略,因此无论模型流量走 Anthropic、Amazon Bedrock、Google Cloud's Agent Platform 还是 Microsoft Foundry,都能采用同一套规则。
最容易被忽略的一条是:所有已加载配置作用域中,最低的上限生效。Claude Code 的普通设置通常遵循优先级,托管设置高于命令行设置、项目文件和用户设置;但 maxEffortLevel 是一个从严处理的例外。即使托管配置或用户配置允许更高 effort,项目里的更低上限依旧优先。
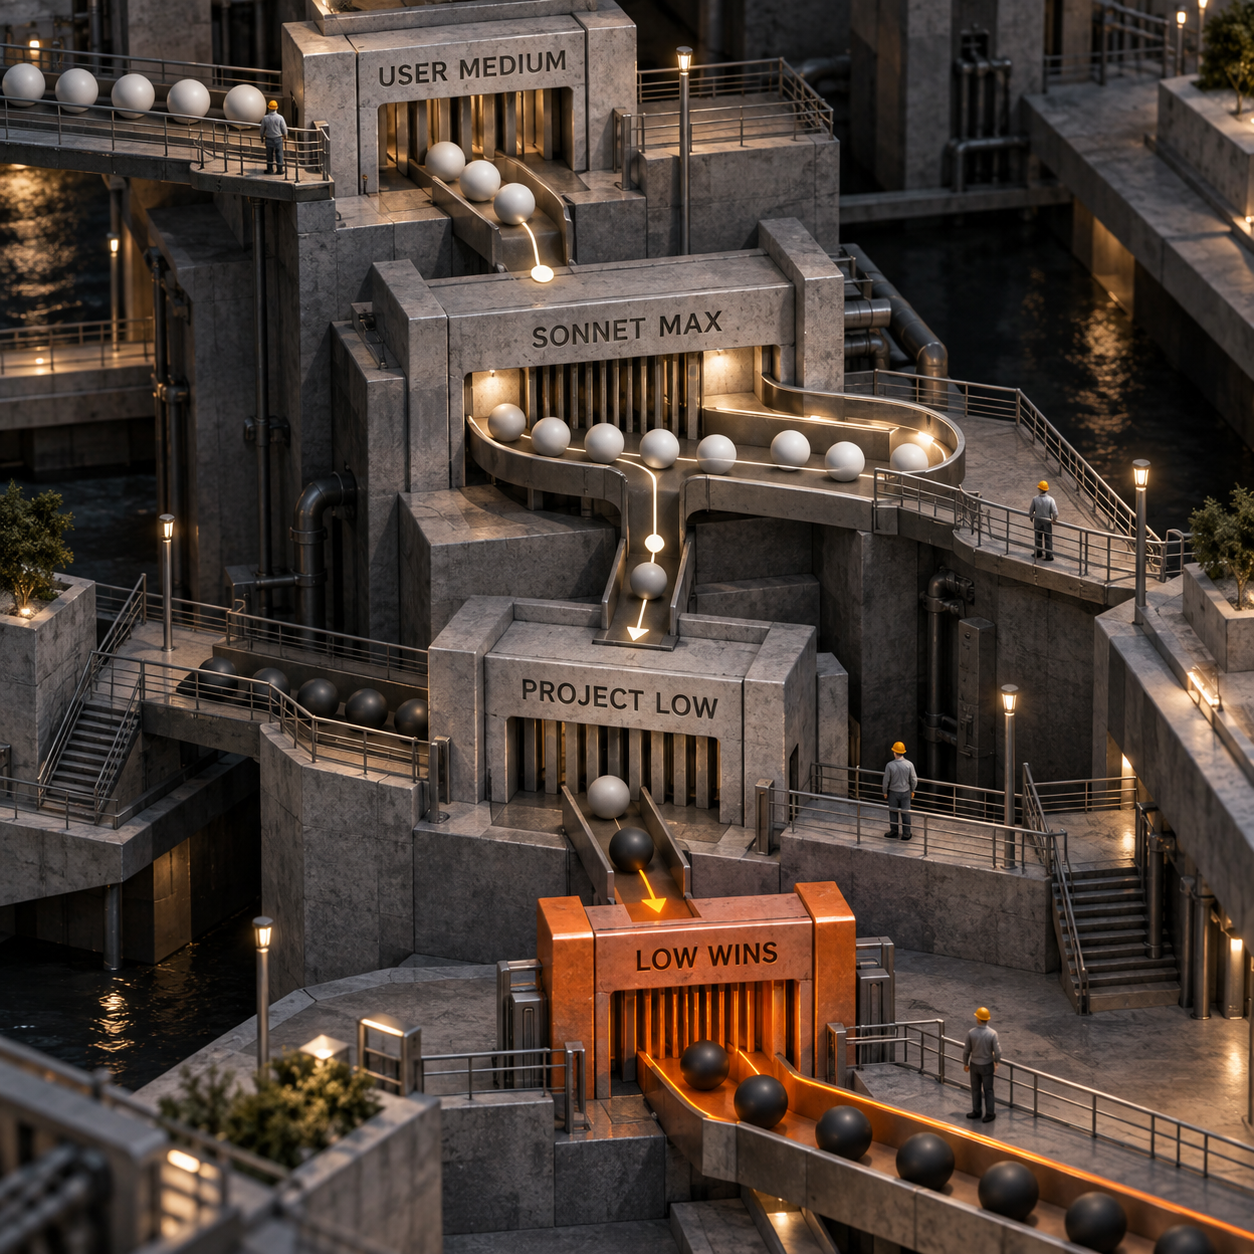
同时配置全局上限、模型例外与更严格的项目上限
先运行 claude --version 查看版本。如果早于 2.1.267,请先执行 claude update,再添加新配置项。
若要为所有仓库设置个人上限,请在 ~/.claude/settings.json 中写入:
{
  "maxEffortLevel": "medium",
  "modelSettings": {
    "claude-sonnet-4-6": {
      "maxEffortLevel": "max"
    }
  }
}
顶层配置会把所有支持 effort 的模型限制在 medium。Sonnet 4.6 的单独条目,只在这个用户配置文件内覆盖顶层值。这里的 max 并不会强制 Sonnet 以最高 effort 运行,而是表示这一个配置来源不再限制该模型。
接着,在某个仓库的 .claude/settings.json 中加入更严格的规则:
{
  "maxEffortLevel": "low"
}
最终结果会严格按下表执行:
模型例外无法穿透项目规则。它只是取消用户配置中针对 Sonnet 的 medium 上限。把这一点理解错,最容易让人误以为例外已经全局生效。
若要实施公司级策略,可通过托管设置下发同一个顶层配置项。这样,无论使用哪一家受支持的提供商,属于该托管来源覆盖范围的人员都会应用这一上限。如果 Enterprise 角色本身也设置了 effort 限制,Claude Code 会采用其中更低的一项。
信任配置前,先验证真正生效的上限
JSON 文件格式正确,并不代表预期的上限一定胜出。配置来源是否加载、最终级别是否应用,都要分别验证。
- 在 Claude Code 中运行
/status。Setting sources一行会确认 User settings、Project settings 以及任何 Managed settings 是否已加载,但不会指出每个配置项具体来自哪个来源。 - 如果某个来源没有出现,或者新配置项像是被忽略了,运行
claude doctor。它会列出被拒绝的设置条目。公开的 JSON schema 可能落后于新版 CLI,因此编辑器告警本身不能作为最终判断。 - 查看模型名称旁的会话标题栏。Claude Code 会在那里显示当前 effort,并在变更时短暂显示于底部状态区。
- 在上述示例仓库中请求
/effort max。项目级low上限仍会生效,更高请求无法将其抬升。 - 对非交互式集群,检查
claude_code.cost.usage和claude_code.token.usage上的effort属性。它会连同模型与查询来源,记录每次请求实际采用的级别。
最后一项对 Bedrock、Google Cloud 和 Foundry 尤其重要:策略在提供商收到请求前由 Claude Code 执行,而遥测数据会告诉你 Claude Code 实际应用了什么。
质量与成本要分开测试
不要因为 medium 或 low 听起来更省,就直接全量推行。应选用团队已经熟悉的日常任务,做条件一致的对照运行。
一个实用的测试样本,是存在一项失败解析器测试的小型仓库。每次运行都保持模型、commit、prompt、权限和工具访问一致,并给出同一任务:修复边界情况、添加回归测试、运行测试套件,再报告改动文件。先完成无上限基线,恢复干净样本,然后在设有上限的条件下运行。
先评估结果,再看成本:
真正值得比较的是每个验收通过任务的成本,而不是每次响应用了多少 token。低 effort 运行如果还要追加评审或返修,总成本可能高于一次干净完成的高 effort 运行。更完整的 Claude effort 级别横向测试 也遵循同样逻辑;新配置的价值在于,它终于能在 Claude Code 中强制执行选定的上界。
推理上限最值得用在这七类场景
以下场景按能够获得最明确运营回报的角色排序。
1. 管理日常开发的平台团队
为 20 或 200 名开发者提供支持的平台团队,可以在托管设置中配置 medium,保留更低级别,并只为经过验证的例外调整策略。收益不只是少用 token,更在于为笔记本、IDE 会话和云提供商路由建立一致的默认边界,让成本与质量对比真正可用。
2. 管理 API 计费 Claude Code 的 FinOps 负责人
FinOps 负责人可以把托管上限与 OpenTelemetry 结合,按 effort、模型、团队和成本中心分组。流程很直接:观察无上限基线,把上限引入试点组,再比较每个验收通过任务的成本。这样,讨论依据就不再是“哪个 effort 感觉更贵”,而是与交付成果直接关联的报告。
3. 使用 Bedrock、Google Cloud 或 Foundry 的企业
受监管企业可能因采购或数据管控要求,通过指定云平台调用模型。Claude Code 客户端会在每次请求之前应用 maxEffortLevel,因此企业可以跨这些提供商使用同一套 effort 策略,无需等待各家控制台提供完全相同的开关。
4. 执行重复修复任务的 CI 维护者
如果团队调用 Claude Code 处理依赖升级、格式修复、测试维护或文档变更,可以在相应仓库把上限设为 low 或 medium。具体级别应由任务样本决定;一旦质量达标,上限就能阻止某个 flag、skill 或模型默认值把日常自动化升级到更深的推理模式。
5. 为不同工作区分强度的 Monorepo 负责人
Monorepo 负责人可以保留个人 medium 上限,在文档或生成代码仓库提交更低的共享上限,同时让难度更高的系统仓库沿用更宽松的限制。每个仓库都携带自己的边界,成本策略由工作本身决定,不再依赖每位开发者记住某条命令。
6. 在多个客户仓库间切换的咨询团队
顾问可以把个人 medium 上限作为基线,再允许各客户仓库通过共享设置施加更严格的限制。同一台笔记本在小型内容站、成熟应用与成本敏感的维护项目间切换时,配置漂移会更少;项目文件也能向后来者清楚说明预期运行方式。
7. 需要保留有限模型例外的 Staff 工程师
Staff 工程师可以用 modelSettings 让某个模型免受当前来源的全局上限限制,同时在安全关键仓库保留另一项更低上限。模型在配置允许的地方拥有发挥空间,但例外不会变成通用绕过通道;严格程度更高的项目或组织策略仍然优先。
围绕这一配置,哪些产品值得做
1. Effort 回归门禁:机会最明确
可以做一套 CLI 与 CI 检查:在允许的各 effort 级别下运行仓库的验收任务集,再汇总通过率、评审缺陷、耗时、token 和成本。工程平台团队愿意为此付费,因为上限会立刻带来一个质量问题:日常任务能降到多低,才不会让返修成本吃掉节省额?
需求信号很有商业价值。ai code review 在美国的月搜索量估算为 1,300,CPC 为 $62.38。最小可售版本只需一个本地运行器加一项 GitHub 检查:在同一个干净样本上对比两套 effort 配置,并在必要测试或评审规则退化时阻止策略变更。
难点在于基准数据。通用编码分数容易复制,也很难对应买家的真实仓库。真正形成壁垒的是团队私有任务集、评审标准,以及跨模型更新积累的历史记录。没有这些数据,它就只是另一块仪表盘。
2. Claude Code effort 策略检查器
可以开发一个只读策略检查器,将用户、共享项目、项目本地、命令行与托管来源整理成按模型划分的上限表。平台与安全团队可借此发现:原以为全局生效的 max 例外、意外胜出的更低项目上限,或仍在运行 2.1.267 之前版本的设备。
claude code 在美国的月搜索量估算为 550,000,实际问题列表中还包括“Claude Code 应该使用哪个 effort 级别?”。这个流量很宽泛,购买意愿未必明确,但配置困惑是真实存在的。MVP 只需完成配置来源发现、版本检测、JSON 校验,并解释最终由哪个最低上限胜出。
风险来自平台本身:Anthropic 可能会加入原生的有效设置检查器。产品若想长期成立,就不能只是做一个更漂亮的设置界面,还需要提供策略漂移告警、设备清单和审计证据。
3. 支持 effort 维度的 Claude Code 成本监控
可以做一套聚焦型 OpenTelemetry 仪表盘,把实际应用的 effort 属性与 token、成本、模型、查询来源、仓库和质量检查连接起来,并覆盖 Anthropic 及云提供商部署。FinOps 和开发者体验团队愿意买单的,是策略与结果之间的联系,而不是又一个 token 总数。
llm observability 在美国的月搜索量估算为 590,CPC 为 $37.45。现有定价也证明了预算确实存在:Datadog Agent Observability 可免费处理 40,000 条 LLM span,Pro 则以每月 $160 起步,可处理 100,000 条 span。一个聚焦型 MVP 可以由 OpenTelemetry collector 预设、上限清单和三个视图组成:实际 effort、每个验收通过任务的成本,以及模型或策略变更后的回归。
难点是竞争与因果关系。可观测性厂商已经在采集 token 和成本,而设置上限后账单变低,并不能证明变化由上限造成。产品需要对照评估或变化点证据,才能赢得信任。
这三个方向中,effort 回归门禁最佳。它对应的需求最接近真实付费决策,而且每当 Anthropic 调整模型或 effort 标定时,私有评估历史都会变得更有价值。
推理上限解决不了什么
effort 上限并不保证账单一定下降。effort 会影响输出 token、工具行为和思考过程,但模型选择、代码库规模、缓存方式以及并行自动化同样重要。Claude Max 与 Pro 订阅用户的用量已包含在套餐中,因此 /usage 显示的会话成本并不等于他们的账单。
它也不能让 low 自动适合所有编码任务。Anthropic 明确建议按实际工作负载测试,而且同一个 effort 名称在不同模型上的标定并不相同。一个模型的 medium 并不是可与另一模型的 medium 机械比较的固定推理量。
它不会为某个模型创造绝对绕过能力。按模型配置的 max 只会取消同一来源中的顶层上限,其他来源仍可能施加更低上限,组织级 effort 限制还可能更低。
最后,/status 只确认加载了哪些文件,并不会告诉你每个配置项最终由哪个文件胜出。对于自动化任务,遥测中的 effort 属性更适合作为实际记录。
下周一就做这件事
下周选一个日常仓库任务:先记录无上限基线,添加用户级 medium 上限和文中所述的 Sonnet 例外,再在共享项目文件中设为 low。确认配置来源已加载,并检查会话标题栏中的 effort;随后从同一个干净样本重跑任务,在查看 /usage 成本之前先比较验收质量。如果质量保持稳定,就把经过测试的上限推广到合适的共享或托管作用域;如果失败,则为该工作负载提高或移除最严格的上限,并保留证据。
Claude Code 应该使用哪个 effort 级别?
对日常且成本敏感的编码任务,可以把 medium 作为候选,而不是把它当成通用答案。困难任务可保留 high 或经测试后更高的上限,并依据同条件任务结果做选择。Anthropic 的建议是:用自己的工作负载测试 effort。
怎样让 Claude Code 停止思考?
maxEffortLevel 无法关闭推理。low 上限会要求受支持模型采用最节省的 effort 级别,但自适应推理仍可能发生。这个设置限制的是深度,并非“完全不思考”模式。
为什么 Claude Code 这么快就达到用量限制?
effort 上限与用量限制是两套不同的控制机制。更高 effort 可能消耗更多输出 token,但套餐窗口、长上下文、模型选择、重试和并行 agent 同样会影响用量。先查看 /usage,不要预设 effort 是唯一原因。
怎样减少 Claude 的 token 用量?
先为日常任务设置经过测试的较低 effort 上限,再确认实际应用级别,并对比 /usage 或 OpenTelemetry 中的 token 字段。保持模型、任务、仓库状态和工具不变,比较结果才有意义。
如果希望围绕工程工作流搭建 effort 策略、评估门禁和成本遥测,可了解 AI 生产系统。
- 最近更新
- 2026年9月10日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。

Shopify WebMCP 结账实战:让 AI 安全完成下单
本文拆解 Shopify WebMCP Checkout 的完整流程:如何发现并调用结账工具、在每次更新前读取最新状态、保留 Shop Pay 授权、处理浏览器导航与错误分支,并在买家明确确认商品、支付方式和总额后才提交订单。还会说明哪些结账场景受支持、实现限制、测试重点,以及最值得落地的 QA 与用户同意产品方向。2026年9月29日Build
Cloudflare Worker 实战:用 cf CLI 管理与部署
从安装认证到命令搜索,掌握 Cloudflare cf CLI 的 JSON 输出、Cloudflare Worker 创建与迁移,并看清 Vite 和 Wrangler 的适用边界。本文还提供只读验证、最小权限与本地测试方法,帮助团队安全使用 3,000 多项 Cloudflare API 操作,减少脚本封装成本。2026年9月29日Build
Krisp Review:通话降噪值不值得付费?
这篇 Krisp Review 核对实时通话降噪、虚拟音频路由、会议录音与转写的数据路径,并拆解 Core 和 Advanced 的真实席位成本。文章不对未实测的音质作结论,而是提供可复现的三路线测试方法,帮助团队判断原生降噪是否已经够用、Krisp 是否值得付费,以及云端会议数据控制能否满足业务要求。2026年9月29日Build
SaneBox 价格详解:Snack、Lunch 与 Dinner 怎么选
完整拆解 SaneBox 价格:对比 Snack、Lunch 与 Dinner 的月付、年付和两年付成本,说明账户与功能限制、隐藏支出、7 天试用判断标准,并与 Clean Email、Fyxer、Superhuman 按真实用途比较,帮你在预付前选出合适套餐,或确认现有邮件规则已经够用。2026年9月29日Build
Marblism 价格详解(2026):按任务量选套餐,不按席位
Marblism 价格从月付 $44 起,年付折合每月 $24。本文按固定任务扣时、共享小时池、月付/季付/年付规则和额度归零后的影响,逐项计算50、70与100小时套餐的实际成本,帮你判断该选哪一档、何时升级,以及这款 AI 员工平台是否适合你的工作流,并说明未用小时过期和不能一次性加购的风险。2026年9月28日Build
Fyxer 价格详解:套餐、年付成本与回本门槛
Fyxer 价格从每位用户每月 $30 起,Professional 为 $50。本文拆解月付与年付成本、单收件箱与多收件箱的套餐边界、席位计费风险,并用可复现的回本测试判断何时该买 Starter、升级 Professional、继续月付,或直接跳过,同时比较 Superhuman、Copilot 与 Gemini。2026年9月28日Build
Cloudflare Workers 价格详解:Worker Previews 免费吗?
Worker Previews 已包含在 Workers Free 中,但分支测试并非全程零成本。本文拆解 Cloudflare Workers 价格、Preview 数量与部署上限,说明请求、CPU、构建、存储、AI 推理和 Containers 的计费边界,帮助团队判断何时继续用 Free、何时升级 Paid。2026年9月28日Build