构建日志、指南与一线笔记
什么发布了、什么坏掉了、真实成本是多少——来自生产级 AI 系统的运营一线。
最新文章什么发布了、什么坏掉了、真实成本是多少——来自生产级 AI 系统的运营一线。

企业 AI 使用规范:小企业可直接套用的一页模板
面向 5 至 200 人小企业的 AI 使用规范模板,用一页讲清获批账号、禁用数据、客户信息审批、人工审核和 AI 使用披露。文中梳理 ChatGPT、Claude、Copilot 与 Gemini 企业服务的数据条款,并提供日常工作示例和 20 分钟团队会议安排,帮助员工判断哪些任务可以继续、哪些情况必须先问负责人。Oct 19, 2026AI
Julius AI、ChatGPT 怎么选?2026 年 5 款 AI 数据分析工具对比
Julius AI、ChatGPT、Claude、Gemini 和 Copilot,哪款适合你的数据分析工作?本文依据官方文档,对比 CSV、Excel、共享表格与报告场景,梳理美元价格、文件限制、数据库连接、模型训练及数据保留政策,帮你按数据来源和交付方式选工具,并核查计算与输出。Oct 19, 2026AI
Langflow 是什么?AI 智能体、RAG 与部署选型指南
Langflow 适合用来搭建什么样的 AI 应用?本文梳理可视化智能体、RAG 知识库与 MCP 工具连接,带你理解入门模板和模型配置,并说明 IBM 与 DataStax 的关系、云服务现状、自托管部署及租户隔离限制,再对比 Flowise 和 n8n 的适用场景,帮助你判断该选哪种工具、如何安排后续维护。
Oct 19, 2026Build
Brand24 评测:社交媒体监测与 AI 分析值得付费吗?
Brand24 评测:从社交媒体监测、竞品分析到客户报告,梳理数据来源、情感分析、AI 功能与提醒流程,比较 Pro 和 Team 套餐的美元价格、采集频率和使用权限。了解 Facebook、Instagram 的导出限制与 LinkedIn 的接入要求,再用免费试用验证关键讨论是否能被发现,并转化为实际行动。Oct 19, 2026Business
Microsoft 365 Copilot 价格怎么算?订阅、组合套餐与智能体费用
Microsoft 365 Copilot 价格不能只看席位费。梳理免费 Chat、Business 附加许可、Basic、Standard、Premium 组合套餐与企业版价格,说明年付合约、月付选项、试用限制及 Copilot Studio 用量收费,并对比 ChatGPT 和 Claude,帮助企业算清总成本。Oct 19, 2026AI
多模态 AI(Multimodal AI):模型选型与企业应用指南
多模态 AI 能处理图像、录音和视频,但理解与生成是不同的能力。本文对比 GPT-6、Gemini 4 Argon、Claude 与 Muse Spark Open 的输入输出,拆解发票录入、会议记录、产品视频和实时语音服务的落地条件,说明文件解析、采样与人工审核如何影响结果,帮助企业从可核查的任务开始试点。Oct 19, 2026AI
Adobe Firefly 评测:小品牌值得订阅吗?先看工作流,再算积分
Adobe Firefly 值得订阅吗?本文围绕小品牌的真实制作需求,梳理图像、视频、音频与可编辑设计流程,对比 Standard 和 Pro 的美元价格及积分预算,说明 Adobe 与合作伙伴模型的使用差异、商用许可和赔偿保障边界,帮你判断套餐里的应用是否用得上,以及视频尝试次数会怎样影响实际成本。Oct 19, 2026Design
AWS Bedrock pricing 详解:模型价格与 $1,270 月度预算
AWS Bedrock 价格怎么计算?本文梳理 Claude、Nova、Llama 和 Mistral 的模型单价,对比 Bedrock 与厂商直连 API,讲清缓存、批处理、跨区域推理和承诺容量的计费差异,并用每月 100,000 次客服回答、$1,270 的预算,拆解知识库、检索、Guardrails 等附加费用。Oct 19, 2026Build
ChatGPT Business 价格与选型:团队何时该从 Plus 升级?
ChatGPT Business 价格怎么算,企业何时该从 Plus 升级?本文梳理 Standard 与 Premium 席位、Work 和 Codex 的分工、共享项目、数据隐私及管理员权限,并解释哪些管控需求值得考虑 Enterprise,帮助团队从一项可审核的日常任务开始试点。Oct 19, 2026AI
Claude Code 价格:Opus 5.5 快速模式怎么开,值不值?
Claude Code 价格不能只看订阅费:Opus 5.5 快速模式按标准 Token 单价的 2 倍收费,即使套餐还有额度,也会单独消耗用量点数。本文说明终端与 API 的开启方法、缓存切换成本,并用同一组用量对比标准与快速模式,帮你判断实时调试、代码审查何时值得加速,后台任务何时该保持标准模式。Oct 19, 2026Build栏目。选你为之而来的那个。
232 篇
AI
Models, agents and coding assistants, image, video and voice tools: reviewed, priced and compared.279 篇Build
Ship software with AI, whether or not you write code: coding agents, app builders, automation, MCP and the infra under it.122 篇Design
AI as a craft tool for designers, brand owners and creative directors: image, video, type, and the prompts behind the work.201 篇Business
Voice and phone agents, customer service, sales and marketing, operations and AI search visibility, for the people who run a business.8 篇Playbooks
AI for your niche: the workflows that actually move, tool by tool, priced52 篇Explained
What shipped, explained: every real release, decoded for the people who use it0 篇Lab
The agent journey, entry by entry: what shipped, what broke, what was decided, in the ventures I run60–83 / 894
ChatGPT Projects 使用指南:项目设置、记忆与客户周报协作
ChatGPT Projects 如何用于客户周报?本文以 Northstar 为例,讲清资料、项目指令和对话如何分工,如何选择记忆范围、设置共享权限并维护报告范例,同时梳理各套餐的文件与协作者上限、数据使用规则和实际限制,帮助团队减少重复交代需求,把每周的资料更新、报告起草、人工审核与交接串成可复用的工作流程。Oct 16, 2026AI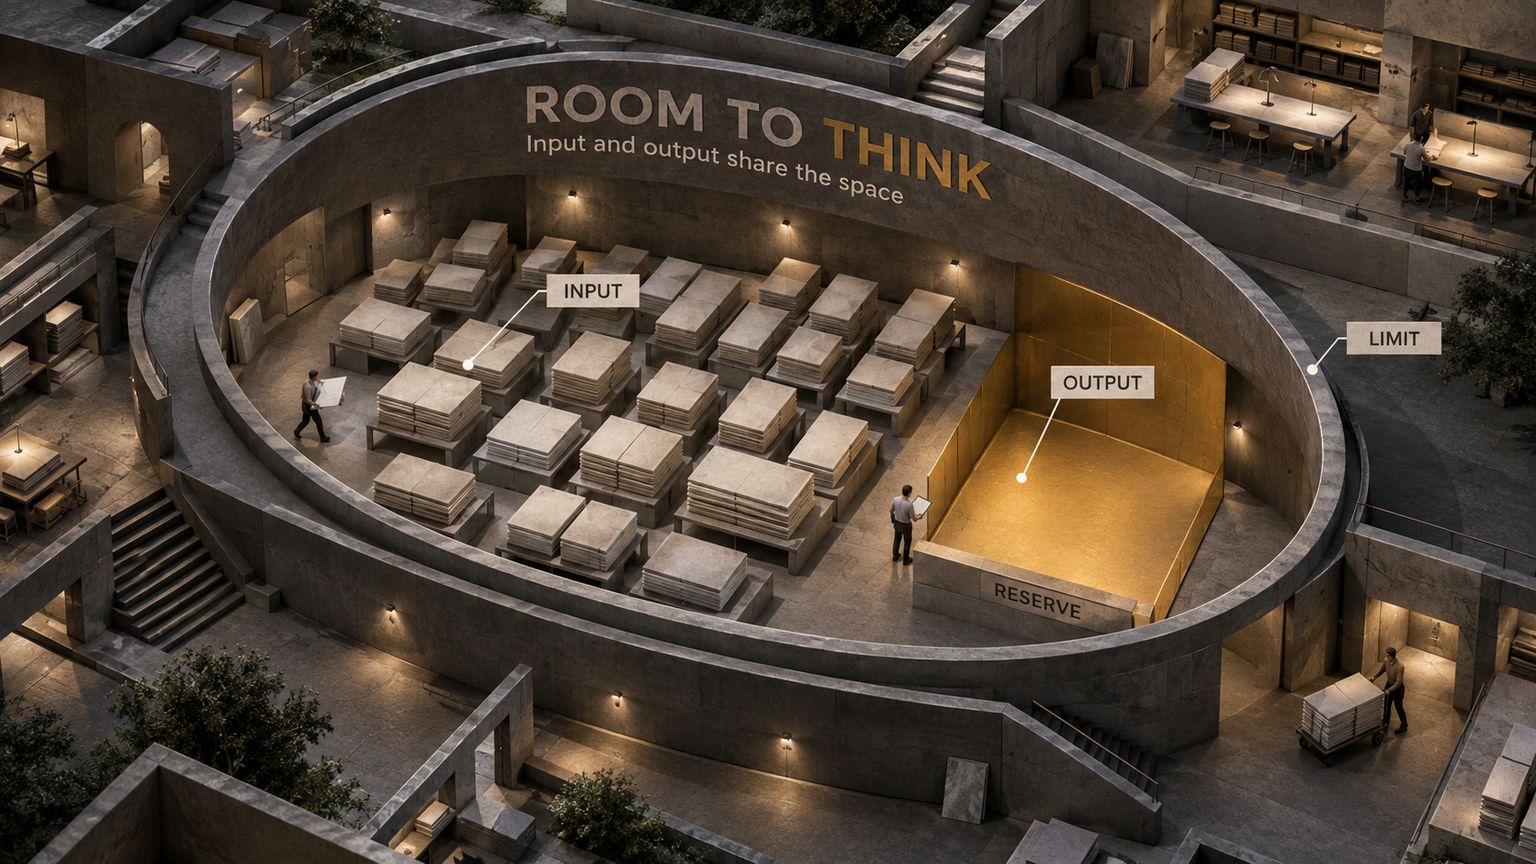
上下文窗口有多大才够用?读懂 token 限制与长上下文
上下文窗口有多大,决定了模型一次能容纳多少输入与输出,却不保证它能准确利用所有信息。本文解释 token 限制与上下文长度的区别,对照 Claude、GPT-6 和 Gemini 4 的窗口及输出规则,并用预算示例说明为何提示词放得下、回答却可能超限,再介绍检索、摘要、压缩和缓存各自能解决什么问题。Oct 16, 2026Build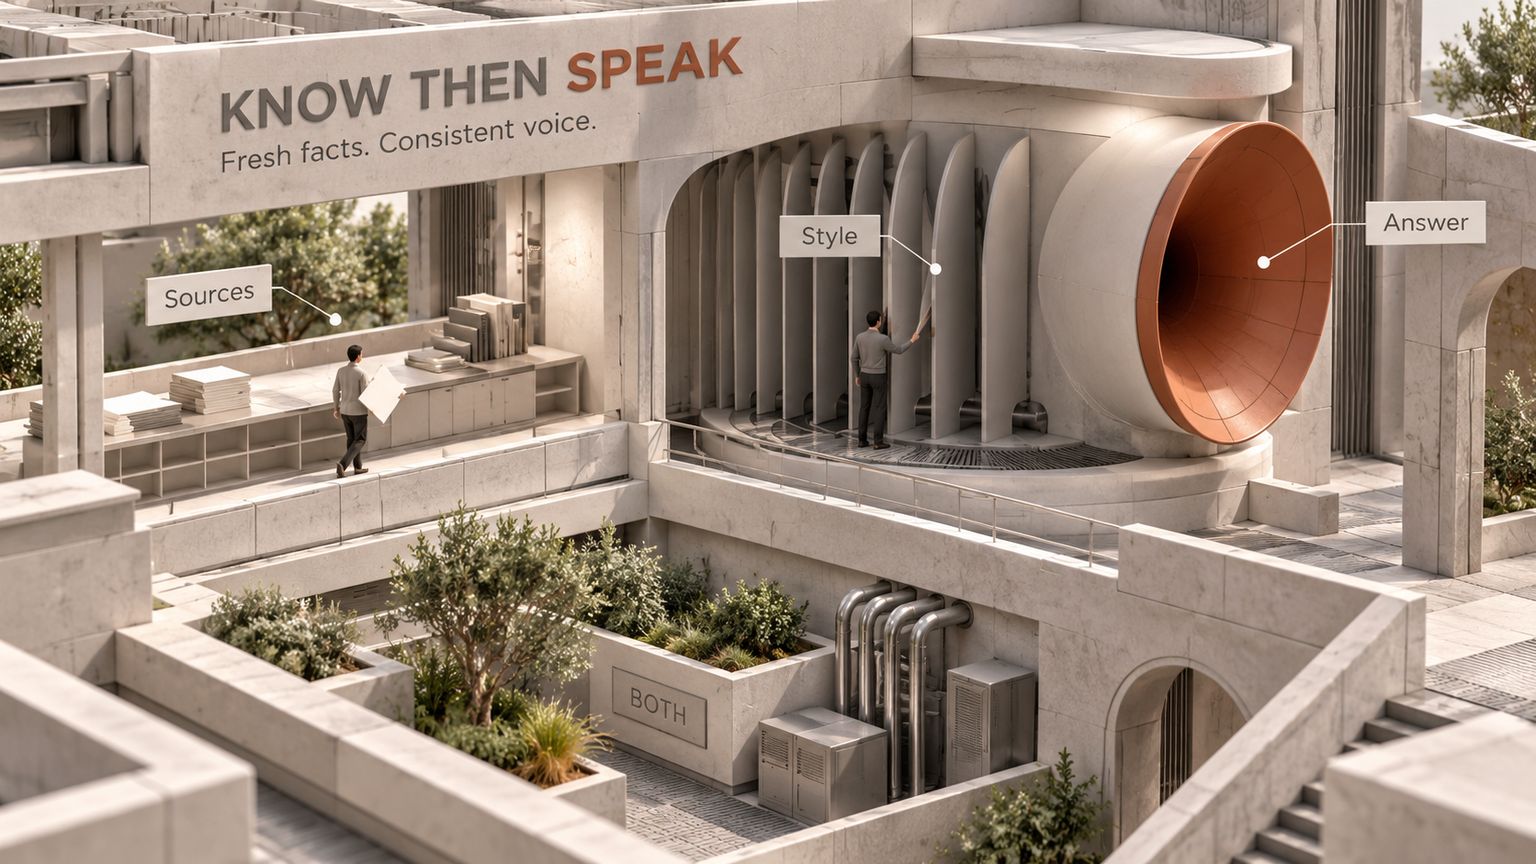
RAG 与微调怎么选?企业知识、模型行为与成本对比
RAG 与微调该怎么选?先分清模型缺少企业知识,还是反复出现行为问题。本文通过客服问答、品牌文案和工单分类三个案例,拆解搭建方式、训练与推理费用,并说明提示词工程、长上下文和缓存如何改变成本比较。结合模型支持、部署端点、文档权限与评估要求,帮助团队判断何时检索、何时微调,以及何时值得将两者结合。Oct 16, 2026Build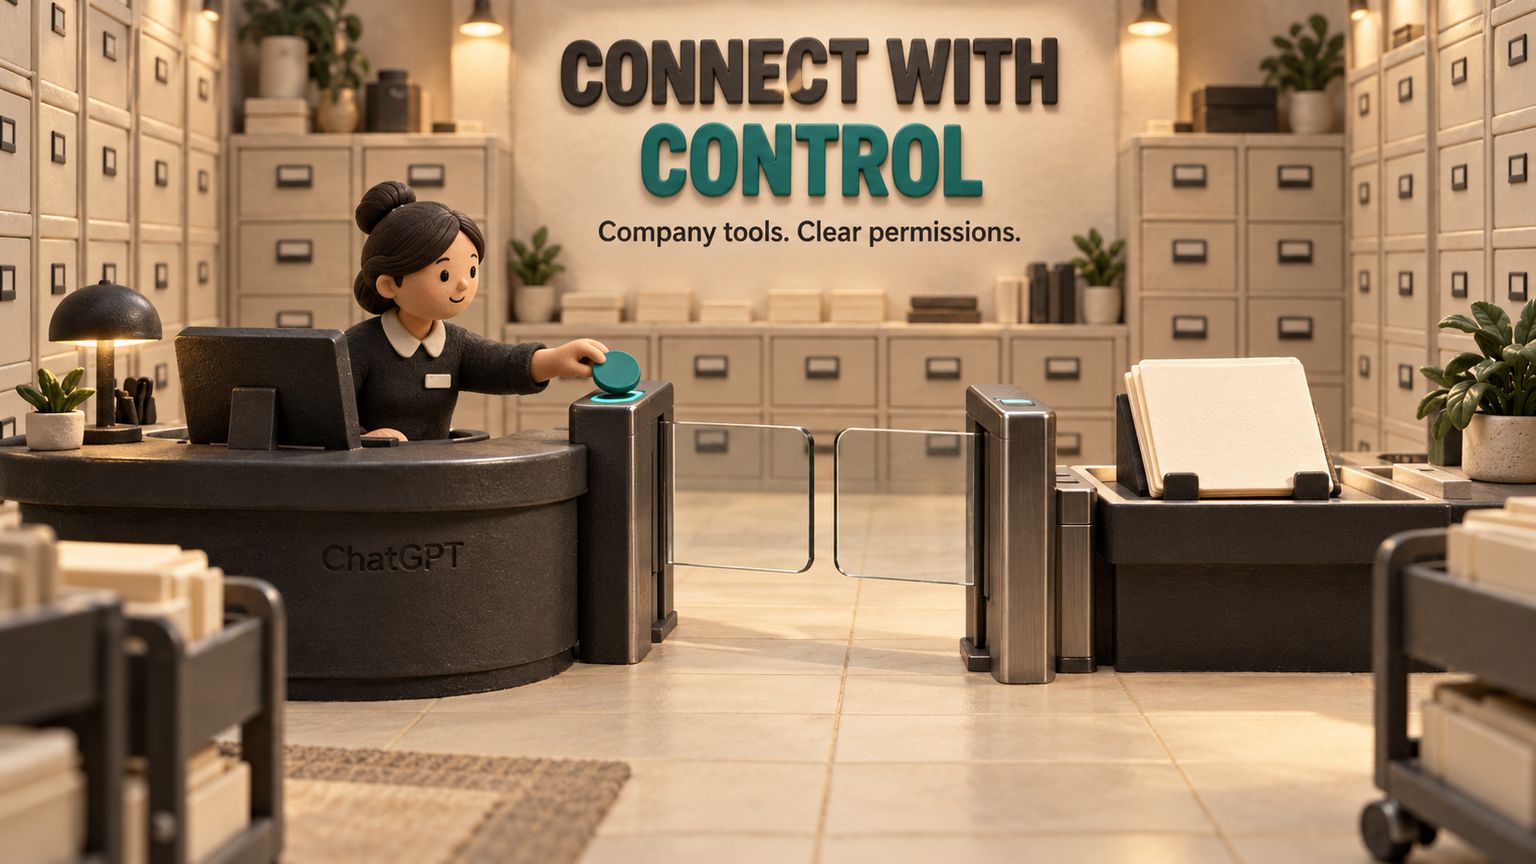
ChatGPT MCP 与连接器:企业应用接入与权限管理指南
ChatGPT MCP 与连接器如何接入企业工具?本文梳理应用、Plugins、实时访问、管理员同步与深度研究的区别,对照各套餐支持范围,说明账号授权、操作权限、审批提示和数据保留规则,并给出 HubSpot、Google Drive、GitHub 的试点步骤,帮助团队先验证来源与权限,再扩大使用。Oct 16, 2026AI
AEO 答案引擎优化怎么做?从页面改写到效果衡量
AEO 答案引擎优化,具体该改页面上的哪些内容?本文结合 Google、OpenAI 与 Perplexity 的官方说明,通过改写前后对照,讲清如何直接回答客户问题、保留适用条件并补齐依据;再用一个月的执行计划,分别记录曝光、来源引用、有效访问和咨询,帮助团队核查实际变化,避免把曝光增长误当成业务增长。Oct 16, 2026Business
Monday vs Asana:AI 项目管理工具怎么选,费用怎么算?
Monday vs Asana 怎么选?面向 10-50 人团队,比较两款工具的套餐价格、席位购买规则、AI 额度与请求上限,以及 Slack、Google Workspace、HubSpot 集成和迁移成本。分清灵活运营、跨项目协同与客户审批的需求,用真实流程试运行,判断哪款适合团队、总费用该怎么算。Oct 16, 2026Business
Aider AI 评测:安装教程、模型配置与 API 费用
Aider AI 适合谁?本文梳理终端编程、Git 自动提交、仓库映射与模型配置,提供安装和首个任务教程,对比 Claude Code、Codex CLI 与 Cursor 的工作流,并按明确的 token 预算计算 API 费用,说明测试、上下文和兼容性限制,帮你判断是否值得为这套灵活但需要自己把关的工具投入时间。Oct 16, 2026Build
Claude Code GitHub Actions 实战:配置、费用与权限控制
用 Claude Code GitHub Actions 在 GitHub 中按需审查 PR、修复 Issue。本文讲清 API 与订阅计费、安装配置、工具权限、轮数和超时限制,提供可复制的工作流示例,并解释 fork 安全边界、常见故障与自动审查的启用时机,帮助小团队逐步落地,保留人工合并决策。Oct 15, 2026Build
AI token 是什么?读懂大模型的用量、计费与限制
AI token 是什么,为什么消息不多,用量却不少?本文用 OpenAI 官方分词器的实际例子,讲清 token 与单词、字符的关系,区分输入、输出和缓存用量,解释 API 计费、上下文窗口、速率限制与套餐额度,并说明如何借助厂商工具统计真实请求,避免把回答长度当成全部消耗,或把订阅费误当成 API 费用。Oct 15, 2026AI
Claude 连接器怎么用:办公工具接入、MCP 配置与权限指南
Claude 连接器怎么用?本文梳理目录连接器与远程 MCP 的配置步骤、各套餐限制和团队授权流程,并以 Google Workspace、Microsoft 365、Notion、Slack 与 CRM 为例,说明如何准备可审核的业务简报、设置工具权限,以及在开放写入前检查凭据、来源和具体改动。Oct 15, 2026AI
SWE-bench 与大模型评测:五分钟看懂跑分,选对测试方向
SWE-bench 高分能说明什么,又不能证明什么?本文梳理编程、推理、智能体、长上下文与语音评测,用 Gemini 4 Argon 成绩表讲清版本、工具、运行框架和评分规则的差别。掌握五分钟读表流程,分清准确率、F1 与部分得分,再结合自己的数据、政策和真实案例,判断哪些模型值得测试、何时需要自建评估。Oct 15, 2026AI
Zed Editor 评测:原生编辑、AI 智能体与迁移取舍
Zed Editor 值得替代 VS Code 或 Cursor 吗?本文梳理原生编辑、多缓冲区、多人协作及 3 种 AI 智能体接入方式,说明套餐价格、安装配置、扩展迁移、调试和团队管理的限制。以官方公开文档为依据,帮助个人开发者和团队在真实项目中判断该换编辑器,还是继续保留现有工具链。Oct 15, 2026Build
OpenCode vs Claude Code 2026:模型、订阅与工作流怎么选?
OpenCode vs Claude Code 怎么选?本文从模型自由度、本地运行、Claude 订阅接入、子智能体、MCP、插件和编辑器审查入手,梳理两款 AI 编程智能体的优势与限制,并说明费用差异、凭据使用边界,以及从 Claude Code 迁移到 OpenCode 时需要处理的指令、集成和恢复问题。Oct 15, 2026Build
Figma Make 评测:从交互原型到 Web 应用,设计如何交付
Figma Make 能把设计稿变成可交互原型,也能发布连接后端的 Web 应用。本文围绕预约流程,讲清提示词、设计系统、AI 积分、数据存储与工程交付的边界,并比较 Lovable、v0 和 Claude Design 的适用场景,帮助已有 Figma 设计资源的团队判断:如何验证体验,以及后续该由谁接手。Oct 15, 2026Design
大模型裁判(LLM as a Judge):让 AI 智能体的每日评估更可靠
如何让大模型裁判可靠地评估 AI 智能体?本文从单点评估、成对比较和评分准则出发,讲清人工标注校准、预留集验证、位置偏差与提示词注入,并比较 Promptfoo、DeepEval、Langfuse 和 LangSmith 的适用场景,帮助你保留工具证据、识别误放行,并建立有人工审核参与的每日自动评估流程。Oct 15, 2026Build
KV Cache 原理:提示词缓存如何省钱,长上下文为何占内存
KV Cache 为什么能降低大模型推理成本,却不能消除长上下文的内存压力?本文从预填充与解码讲起,拆解提示词缓存的计费逻辑、KV 内存估算公式,以及 Anthropic、OpenAI、Google Gemini 的读写与保留规则,并介绍 vLLM 的前缀复用、量化和卸载方法,帮助你排查命中率、延迟与成本问题。Oct 15, 2026Build
DSPy 教程:用评估驱动提示词优化,读懂签名、模块与优化器
DSPy 值不值得用,关键在于任务能否评估。本文梳理签名、模块与优化器,给出可直接运行的 Python 示例,并用工单分流说明训练、验证和最终测试如何划分、调用次数与模型费用如何估算。读懂 DSPy 提示词优化的边界,比较手写提示词与微调,再判断团队是否具备样例、评分规则和维护能力,适合从哪里开始试验。Oct 15, 2026Build
Agent Skills 实战:一套技能如何在不同 AI 工具间复用
Agent Skills 如何让一套流程在不同 AI 工具间复用?本文讲清 SKILL.md 规范,对照 Claude Code、Codex、Cursor、Gemini CLI 与 GitHub Copilot 的支持方式,用运营周报示例演示部署检查,并拆解上下文成本、MCP 的分工和权限边界。Oct 15, 2026Build
Julius AI 评测:数据分析、价格与选购建议
Julius AI 适合把业务数据反复整理成可核对的图表与报告吗?本文依据官方文档,梳理数据连接、分析与报表功能、月付和年付价格,并比较 ChatGPT、Claude 的适用场景。重点说明 Notebooks 下线、七天文件存储、积分消耗和数据处理限制,帮助你判断现有工作流程是否值得迁移,以及购买前该验证什么。Oct 15, 2026AI
2026 嵌入模型选型指南:OpenAI、Gemini、Voyage 与开源方案怎么选
嵌入模型怎么选,才能让 RAG 和客服机器人稳定找到答案?本文对比 OpenAI、Voyage、Gemini、Cohere、Qwen、BGE 与 EmbeddingGemma,梳理价格、向量维度、输入限制、多语言与多模态能力、部署方式和许可证,并说明如何用自己的数据评估检索效果、核算存储成本,以及规划模型和索引迁移。Oct 15, 2026Build
Napkin AI 中文指南:文字转图表、操作教程与套餐选择
Napkin AI 能把提案、文章和报告中的文字变成图解,但是否适合工作,还要看逻辑、品牌一致性与交付后的可编辑性。本文讲清操作步骤、Effects 与导出限制、Slides 的适用场景,以及 Free、Plus、Pro 的价格和积分规则,并比较 Gamma、Canva、draw.io,帮助你按交付需求选工具。Oct 15, 2026Design
SLM 小语言模型怎么选?从适用场景到本地部署
SLM 小语言模型适合哪些工作,何时仍需大模型?本文梳理分类、抽取、路由、端侧助手和模板写作五类场景,对比 Gemma、Phi、Qwen、Llama 与 Ministral 的参数规模和许可证,说明内存预算、Ollama 与 LM Studio 本地部署、托管 API,以及如何用同一批样例评估质量、延迟和审核成本。Oct 14, 2026AI
llms.txt 是什么?AI 爬虫会读取吗,网站值不值得做?
llms.txt 值得做吗?本文梳理 OpenAI、Anthropic、Google 和 Perplexity 官方文档中的承诺与边界,说明文档索引的实际用途,提供小企业可用的模板、发布步骤和服务器日志核验方法,帮助你区分文件被抓取与内容被 AI 引用,判断这项可选的网站维护工作是否值得投入。Oct 14, 2026Business
LangSmith vs Langfuse:链路追踪、评估与自部署怎么选
LangSmith 和 Langfuse 怎么选?本文对比链路追踪、在线与离线评估、数据集、提示词管理、监控和自部署,结合 LangChain、LangGraph 与多框架团队的实际流程,说明云服务计费、开源许可、Enterprise 部署条件及迁移要点,帮助工程团队按审核协作方式和运维责任做出选择。Oct 14, 2026Build在 Google 中优先显示本站
 在 Google 上添加为首选来源
把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
订阅通讯
每周日,一封信。写运转中的系统,不写热评。
每周一期。无垃圾邮件。随时退订。