ChatGPT Work: Deep Research teilt das Budget mit Codex
Deep Research in ChatGPT Work teilt sich das Budget mit Codex. Was das für Credits, Kostenkontrolle und den passenden Einsatzbereich bedeutet.





Seit dem 9. September 2026 ist Deep Research in ChatGPT Work und Codex verfügbar. Entscheidend ist jedoch nicht ein weiterer Recherche-Button. Ein Recherchebriefing in Work greift jetzt auf dasselbe Work-/Codex-Kontingent beziehungsweise denselben Credit-Pool zu wie die Agentenaufgaben, mit denen ein Team entwickelt, analysiert und Ergebnisse ausliefert.
ChatGPT Work und Deep Research: die Änderung in einem Satz
Innerhalb von ChatGPT wird Deep Research jetzt über zwei verschiedene Zähler erfasst.
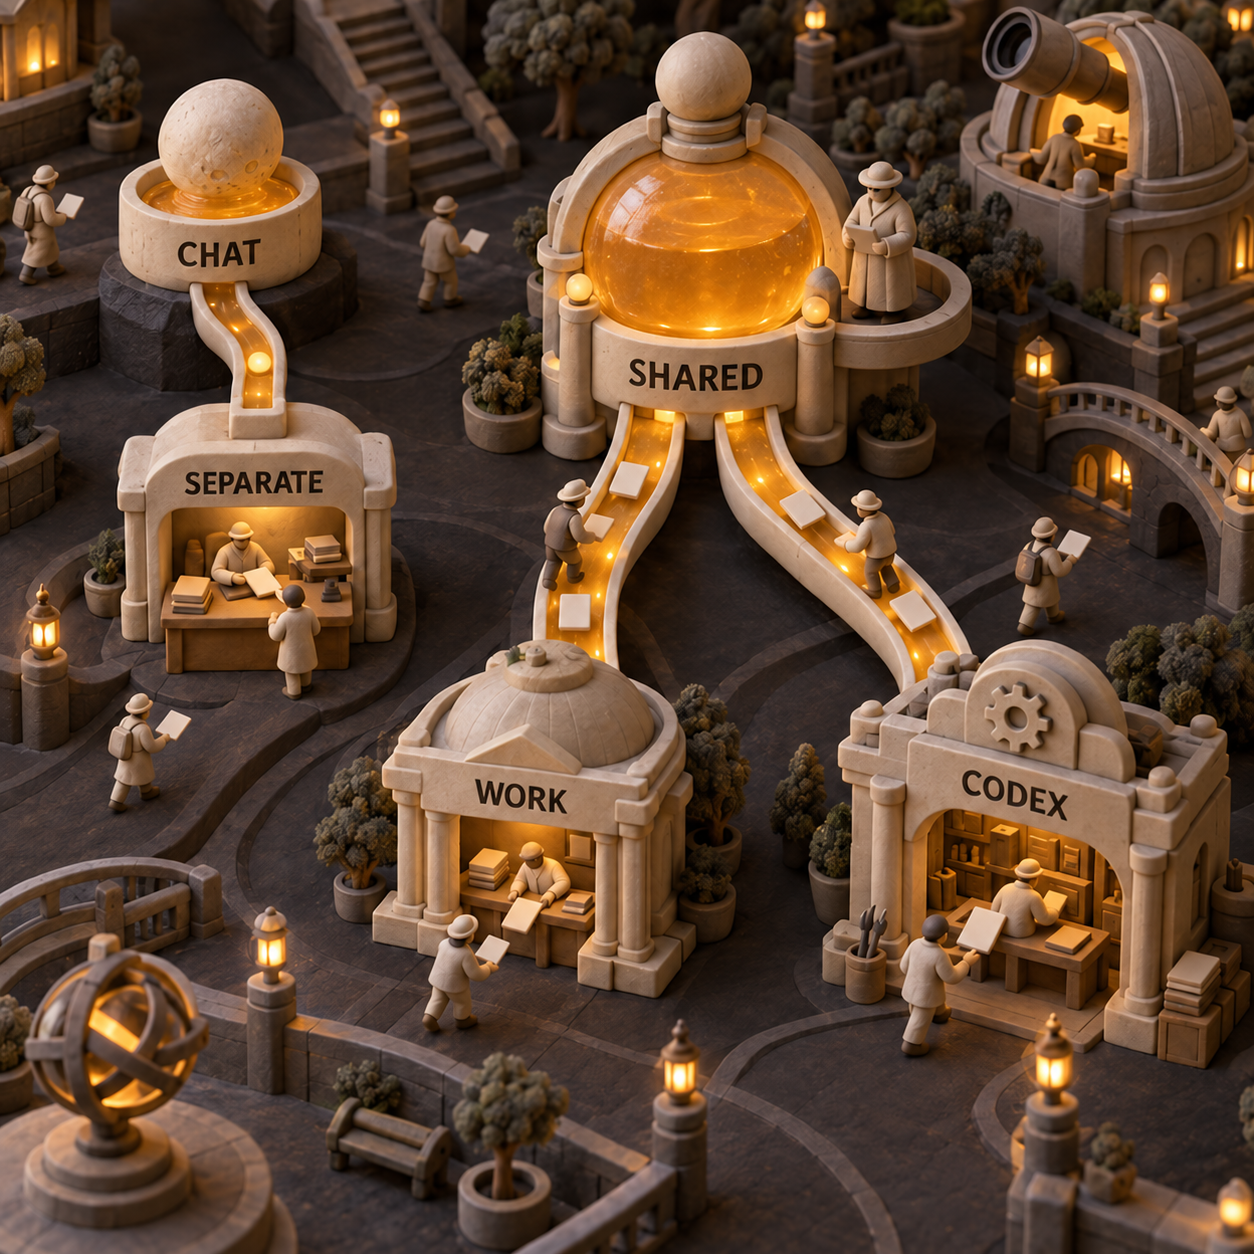
Wer die Funktion im normalen Chat startet, nutzt das separate, tarifabhängige Kontingent für Rechercheaufgaben in Chat. Ein Start in Work oder Codex belastet dagegen das Kontingent oder die Credits, die sich Work und Codex bereits teilen. Eine Rechercheaufgabe in Work wird nicht vom Recherchekontingent in Chat abgezogen – und umgekehrt ebenso wenig.
Damit ist die Budgetfrage im Kern beantwortet: Dieselbe Recherchefunktion kann je nach Startpunkt über einen anderen Zähler laufen.
OpenAI nennt in der Versionsnotiz vom 9. September Plus-, Pro-, Business-, Enterprise- und Edu-Nutzer mit Zugriff auf Work als berechtigt. Die Funktion läuft im Web, auf dem Desktop sowie unter iOS und Android, sofern Konto und Arbeitsbereich sie unterstützen.
Was Deep Research in Work konkret leistet
Deep Research ist für Fragen gedacht, die mehrere Quellen, einen Vergleich und ein dokumentiertes Ergebnis erfordern. Das Briefing beschreibt Ziel, Zielgruppe, Rahmenbedingungen, Dateien und zulässige Quellen. Die Funktion kann Rückfragen stellen, Belege zusammentragen und ein strukturiertes Ergebnis mit Zitaten oder Quellenlinks erstellen. Während die Aufgabe läuft, lässt sie sich steuern oder unterbrechen.
Die Work-Variante ist relevant, weil das Ergebnis direkt Teil eines Arbeitsergebnisses werden kann. Wenn die verfügbaren Tools das gewünschte Format unterstützen, kann daraus ein bearbeitbares Dokument, eine Präsentation, eine Tabelle oder eine Site entstehen. In Codex lässt sich dieselbe Recherche mit technischer Arbeit verbinden – etwa für ein Migrationsbriefing, eine Abhängigkeitsprüfung oder eine Implementierungsentscheidung vor den ersten Codeänderungen.
Wer Work noch nicht kennt, findet im Test von ChatGPT Work die Unterschiede zwischen Chat, Work und Codex. Kurz gesagt: Chat liefert eine Antwort, Work übernimmt ein umfangreicheres Arbeitsergebnis und Codex arbeitet an Software und technischen Systemen.
Die Grenzen des Quellenzugriffs bleiben bestehen. Deep Research kann das öffentliche Web, bereitgestellte Dateien, zugängliche Dateien im Arbeitsbereich, eine verfügbare Websuche sowie unterstützte und für das aktuelle Konto autorisierte Apps verwenden. Der Start einer Rechercheaufgabe gewährt keinen Zugriff auf einen anderen Ordner, den Drive-Speicher einer anderen Person oder eine vom Arbeitsbereich gesperrte App.
Eine App-Verbindung ist daher keine pauschale Zusage. Nicht jede App und nicht jedes Plugin unterstützt Deep Research. Selbst wenn Unterstützung besteht, entscheiden weiterhin die Berechtigungen des Anbieters und die Vorgaben des Arbeitsbereichs darüber, was die Aufgabe lesen oder schreiben darf. Der Leitfaden zu Deep Research weist ausdrücklich auf diese Grenzen hin.
Das gemeinsame Budget ist die eigentliche Neuerung
Recherche und Ausführung konkurrieren in Work und Codex nun um dieselbe Agentenkapazität.
Bei Plus- und Pro-Konten verbrauchen unterstützte Agentenfunktionen zunächst das enthaltene Kontingent und anschließend – sofern diese Option verfügbar ist – gekaufte Credits. Bei Standardplätzen in ChatGPT Business gelten ebenfalls zuerst die im Tarif enthaltenen Limits; berechtigte Aufgaben können danach aus gekauften Credits des Arbeitsbereichs weiterlaufen. Enterprise- und Edu-Arbeitsbereiche mit flexibler Abrechnung skalieren über Credits. Ohne flexible Abrechnung gelten weiterhin die jeweiligen Tariflimits.
Eine seriöse, allgemeingültige Zahl für monatliche Rechercheaufgaben in Work gibt es nicht. Der Verbrauch hängt vom Modell, dem Quellenumfang, zwischengespeichertem Kontext, der Ausgabelänge, dem Reasoning, den Tools und weiteren Aufgaben ab, die denselben Pool nutzen. Die persönliche Nutzungsübersicht liefert die kontospezifische Antwort.
Die aktuelle ChatGPT-Preisliste für Business, Enterprise und Edu enthält eine leicht zu übersehende Unterscheidung. Für die abgedeckten creditbasierten Tarife führt sie Deep Research in Chat mit ungefähr 50 Credits pro Aufgabe auf. Dieser feste Wert für Chat ist nicht der Preis für Deep Research in Work oder Codex. Dort richtet sich die Abrechnung nach dem tatsächlichen Token-Verbrauch.
Für GPT-5.6 Sol gelten aktuell in Work und Codex 100 Credits pro 1 Million Input-Tokens, 10 Credits pro 1 Million zwischengespeicherter Input-Tokens und 500 Credits pro 1 Million Output-Tokens. Die Formel lautet:
Verbrauchte Credits = Input-Anteil + Anteil des zwischengespeicherten Inputs + Output-Anteil.
Ein bewusst hypothetisches Beispiel für ein Team in einem Arbeitsbereich mit dieser Preisliste: Das Team reserviert für einen Monat 1,000 Credits und plant 20 Recherchebriefings. Angenommen, jedes Briefing verbraucht mit GPT-5.6 Sol 100,000 Input-Tokens, 200,000 zwischengespeicherte Input-Tokens und 20,000 Output-Tokens.
Der Input kostet 10 Credits, der zwischengespeicherte Input 2 und der Output 10. Das ergibt 22 Credits pro Briefing. Zwanzig Briefings verbrauchen 440 Credits; für alle anderen Aufgaben in Work und Codex bleiben aus dieser Planungsreserve 560 Credits übrig.
Diese Token-Mengen sind ein Beispiel, keine Prognose. Ein kurzes Recherche-Memo kann weniger benötigen. Ein breit angelegtes Briefing mit vielen Quellen und einer umfangreichen bearbeitbaren Präsentation kann mehr verbrauchen. Sinnvoll ist, Recherche und Ausführung gemeinsam zu budgetieren und die hypothetischen Werte anschließend durch die Verbrauchsdaten der ersten eigenen Aufgaben zu ersetzen.
Gekaufte Nutzungsguthaben sind von API-Credits getrennt. Zusätzliche Credits für Work oder Codex finanzieren kein API-Projekt, und ein API-Guthaben vergrößert diesen Pool nicht. Der Leitfaden zu persönlichen Credits stellt außerdem klar, dass die Kaufoptionen je nach Konto, Region und Tarif variieren.
Wer das ab morgen nutzen kann
Rechercheleitung in einer kleinen Agentur
Die Rechercheleitung kann Work damit beauftragen, die Kategorie eines Kunden anhand freigegebener Recherche-Websites, hochgeladener Interviewnotizen und eines verbundenen Dokumentenspeichers zu vergleichen. Das Ergebnis ist ein bearbeitbares Marktbriefing mit Quellenangaben – kein weiteres Chatprotokoll.
Der Vorteil liegt in der reibungsloseren Übergabe an Strategie und Kreation. Der Budgetnachteil: Jedes ausführliche Briefing lässt weniger gemeinsame Kapazität für Präsentationen, Tabellen und Produktionsaufgaben übrig, die dasselbe Team in Work erledigt.
Produktmanagement in einem SaaS-Unternehmen
Das Produktmanagement kann Kundennotizen, Richtlinienseiten, Wettbewerbsdokumentation und eine interne Anforderungsdatei in einem Entscheidungsmemo zusammenführen. Gewichtet die Aufgabe eine Quelle zu stark, lässt sie sich nachsteuern. Anschließend kann das Ergebnis als Dokument angefordert werden, das Produkt- und Rechtsteam gemeinsam bearbeiten können.
Der Gewinn ist eine durchgehend nachvollziehbare Belegkette. Die Entscheidung bleibt beim Produktmanagement, und jede folgenreiche Aussage muss weiterhin an ihrer Quelle geprüft werden, bevor sie in eine Roadmap oder ein Kundenversprechen einfließt.
Technische Leitung vor einer Migration
Die technische Leitung kann Deep Research in Codex starten, um aktuelle Anbieterdokumentation, Kompatibilitätshinweise und Einschränkungen des Repositorys zu vergleichen, bevor Codex den Code ändert. Recherche und Implementierung bleiben in einem Arbeitskontext.
Das reduziert Kontextwechsel. Die Kostenwirkung ist unmittelbar: Untersuchung und spätere Implementierung werden aus demselben Work-/Codex-Budget bezahlt. Ein zu weit gefasster Rechercheumfang kann daher die verbleibende Kapazität für die eigentliche Migration verkleinern.
Administration mit Verantwortung für Teamrichtlinien
Die Administration kann eine einheitliche Regel dafür festlegen, wo Recherche stattfindet. Chat eignet sich für eine recherchierte Antwort, wenn das separate Aufgabenkontingent von Chat genutzt werden soll. Work oder Codex sind richtig, wenn das Ergebnis zu einem bearbeitbaren Team-Artefakt werden oder in die Ausführung einfließen muss.
So entsteht ein Budget, das sich verständlich erklären lässt. In Enterprise und Edu müssen Administratoren zusätzlich die Berechtigung für Deep Research erteilen und die Websuche aktivieren. Ohne diese Freigaben sehen selbst berechtigte Mitglieder die Funktion möglicherweise nicht.
Ein sicherer Arbeitsablauf
1. Den Zähler bewusst wählen
Chat ist der richtige Startpunkt für eine recherchierte Antwort. Work passt zu einem bearbeitbaren geschäftlichen Arbeitsergebnis. Codex empfiehlt sich, wenn die Recherche unmittelbar neben der technischen Umsetzung stattfinden soll. Die drei Einstiegspunkte sind finanziell nicht gleichzusetzen.
2. Den Belegrahmen abstecken
Websites, Dateien, Zeitraum, Zielgruppe und die zu unterstützende Entscheidung gehören ins Briefing. Ebenso wichtig ist eine Ausschlussliste für unerwünschte Quellen. Eine kleinere Belegmenge lässt sich leichter prüfen und verbraucht in der Regel weniger Kontext.
3. Das Ausgabeformat benennen
Gefragt wird nach einem unterstützten Format und einem eindeutigen Ablageort. Eine bearbeitbare Ausgabe entsteht nur, wenn die Aufgabe über die nötigen Tools und Berechtigungen verfügt. Deshalb sollte das Briefing eine Ausweichlösung nennen, etwa einen strukturierten Bericht direkt in der Unterhaltung.
4. Frühzeitig nachsteuern
Der Fortschritt sollte während der Ausführung beobachtet werden. Folgt die Aufgabe schwachen Quellen oder weitet sie die Fragestellung aus, ist Unterbrechen und Eingrenzen sinnvoll. Mehr Recherche ist nicht automatisch bessere Recherche.
5. Die Verbrauchsdifferenz protokollieren
Vor und nach der Aufgabe lohnt sich ein Blick in die Nutzungsübersicht für Work und Codex. Modell, Umfang, Ausgabeformat, verbrauchte Credits und Prüfzeit sollten dokumentiert werden. Nach einigen wiederkehrenden Briefings sind diese Belege aussagekräftiger als eine pauschale Aufgabenschätzung.
6. Das Arbeitsergebnis prüfen
Die ausgelieferte Datei oder der Link muss geöffnet werden. Stichproben der Quellen hinter entscheidungsrelevanten Aussagen zeigen, ob die Belege tatsächlich das Behauptete stützen. Fehlen Nachweise oder das angeforderte Ausgabeformat, ist eine Überarbeitung nötig.
Die ehrlichen Grenzen
Deep Research in Work bedeutet keine unbegrenzte Recherche. Die Funktion verbraucht das vorhandene Work-/Codex-Kontingent oder entsprechende Credits. Ihre Verfügbarkeit hängt weiterhin von Konto, Arbeitsbereich und Oberfläche ab. Eine Aufgabe verliert ihren Nutzen, wenn sie die Kapazität für die anschließende Umsetzung verdrängt.
Eine bearbeitbare Ausgabe ist noch keine geprüfte Ausgabe. Eine Datei kann gut gegliedert sein und dennoch eine schwache Seite zitieren, einen Widerspruch übersehen oder die Fragestellung verfehlen. OpenAI rät dazu, zu prüfen, ob Zitate die Aussagen tragen und ob eine angeforderte Datei oder ein Link tatsächlich erstellt wurde und sich öffnen lässt.
Teams, die Deep Research ausschließlich im normalen Chat einsetzen, sind vom neuen gemeinsamen Zähler für Work und Codex nicht betroffen. Ihr separates Chat-Kontingent bleibt unverändert. Auch Personen ohne Work-Zugriff oder Mitglieder, deren Administratoren Deep Research oder die Websuche deaktiviert haben, erhalten durch diese Veröffentlichung keinen neuen Arbeitsablauf.
Was jetzt sinnvoll ist
Ein zeitnaher Start lohnt sich, wenn ein Team bereits regelmäßig ein quellenintensives Arbeitsergebnis erstellt und den Work-/Codex-Verbrauch einsehen kann. Dafür reichen zunächst eine verantwortliche Person, ein Ausgabeformat und eine Freigabestufe.
Abwarten ist sinnvoll, wenn sich die Quellen nicht prüfen lassen, unklar ist, welches Konto oder welcher Arbeitsbereich zahlt, oder eine benötigte App Deep Research nicht unterstützt. Diese Grenzen sollten geklärt werden, bevor daraus eine wiederkehrende Aufgabe wird.
Bei Chat zu bleiben ist richtig, wenn lediglich eine recherchierte Antwort benötigt wird und kein Arbeitsergebnis für Work oder Codex entstehen soll. Genau für diesen Fall ist das separate Chat-Kontingent gedacht.
Der Schritt für Montag
Ein bereits vorhandenes Team-Briefing sollte zunächst einmalig und nicht nach Zeitplan ausgeführt werden. Vor dem Start wird der Work-/Codex-Verbrauch notiert; anschließend eignet sich diese klar eingegrenzte Anfrage:
@Deep Research. Erstellen Sie für unsere Produktleitung ein bearbeitbares Entscheidungsmemo dazu, ob der Vertrag mit Anbieter A verlängert werden soll. Verwenden Sie ausschließlich den beigefügten Vertrag, unsere letzten beiden Quartalsberichte, die aktuellen Preis- und Sicherheitsseiten von Anbieter A sowie drei namentlich genannte Alternativen. Trennen Sie geprüfte Fakten von der Analyse, belegen Sie jede Preis- und Sicherheitsaussage, führen Sie offene Punkte auf und empfehlen Sie Verlängerung, Neuverhandlung oder Wechsel. Kontaktieren Sie keinen Anbieter und ändern Sie außerhalb dieses Berichts keine Datei.
Nach Abschluss wird das gelieferte Memo geöffnet und jeder Beleg angeklickt, auf dem die Empfehlung beruht. Die Quelle muss den jeweiligen Satz stützen; zudem ist zu prüfen, ob die angeforderte Datei vorhanden ist und sich öffnen lässt. Danach werden Verbrauchsdifferenz und Prüfzeit gemeinsam festgehalten. Bestehen die Zitate oder das Arbeitsergebnis diese Prüfung nicht, ist die Aufgabe nicht abgeschlossen.
Weitere verständliche Praxisleitfäden zu Änderungen an der Kostenlogik von KI-Produkten gibt es im Newsletter.
- Zuletzt aktualisiert
- 10. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained