Code Sandbox mit 64 GB: Was Vercels Speicherplus bringt
Vercels Code Sandbox bietet jetzt 64 GB lokalen Speicher. Welche Repository-, Build- und Datenjobs profitieren – und was vor dem Umstieg zu messen ist.


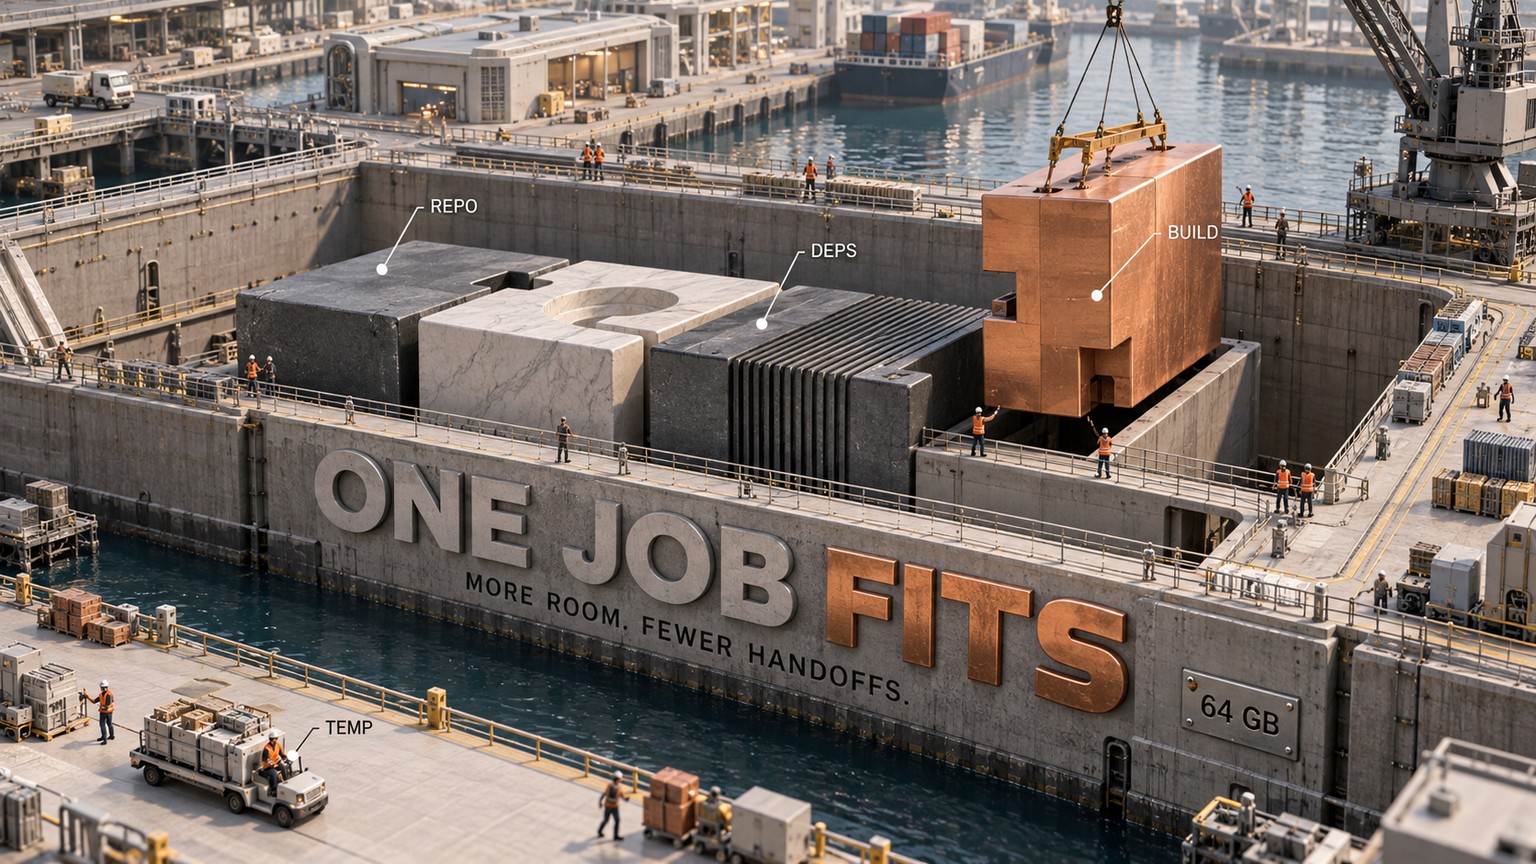
Entscheidend sind nicht die 64 GB allein. Entscheidend ist, dass ein Repository-Job in der Code Sandbox von Vercel, der bislang an der 32-GB-Grenze scheiterte, nun in einer einzigen Maschine durchlaufen kann – statt verschlankt, aufgeteilt oder auf eine andere Infrastruktur verlagert zu werden.
Am 11. September 2026 hat Vercel den standardmäßig verfügbaren Speicherplatz jeder Sandbox von 32 GB auf 64 GB verdoppelt.
Doppelt so viel Platz in einer Code Sandbox
Vercel Sandbox ist eine isolierte Linux-MicroVM – eine kleine virtuelle Maschine mit eigenem Kernel, Dateisystem und Netzwerk. Darin lassen sich ein Repository bereitstellen, Code durch einen Agenten bearbeiten, Pakete installieren und Tests ausführen. Anschließend wird ein Build erzeugt und das Ergebnis ausgegeben.
Alle diese Schritte greifen auf dieselbe lokale Festplatte zu. Wenn der Abhängigkeitsbaum hinzukommt, liegt der Checkout womöglich noch dort. Build-Caches und kompilierte Ausgaben teilen sich den Platz mit temporären Dateien. Das fertige Artefakt kann klein sein, obwohl der Job während seiner Erstellung kurzzeitig deutlich mehr Speicher benötigt.
Genau diesen Spitzenbedarf verändert die neue Freigabe. Vercel stellt der Sandbox nun 64 GB statt 32 GB lokalen Speicher zur Verfügung – 32 GB mehr und damit die doppelte bisherige Kapazität. Das gilt für Sandboxes auf Basis eines Vercel Managed Image oder eines benutzerdefinierten Images ebenso wie für solche mit der veralteten Eigenschaft runtime.
Es geht um Kapazität innerhalb der Sandbox, nicht um ein neues Kontingent für Datenbanken oder Objektspeicher. Vercel bezeichnet sie als flüchtigen NVMe-Speicher. Sollen Dateien den Job überdauern, bleibt die Entscheidung über ihre dauerhafte Speicherung davon getrennt.
Entscheidend ist, ob der gesamte Job hineinpasst
Die hilfreiche Frage lautet nicht: „Wie hoch ist Vercels Speicherlimit?“ Sondern: „Kann dieser komplette Job ohne besondere Bereinigung oder Übergaben in einer einzigen Sandbox laufen?“
Dafür genügt ein einfaches Speicherplatzbudget:
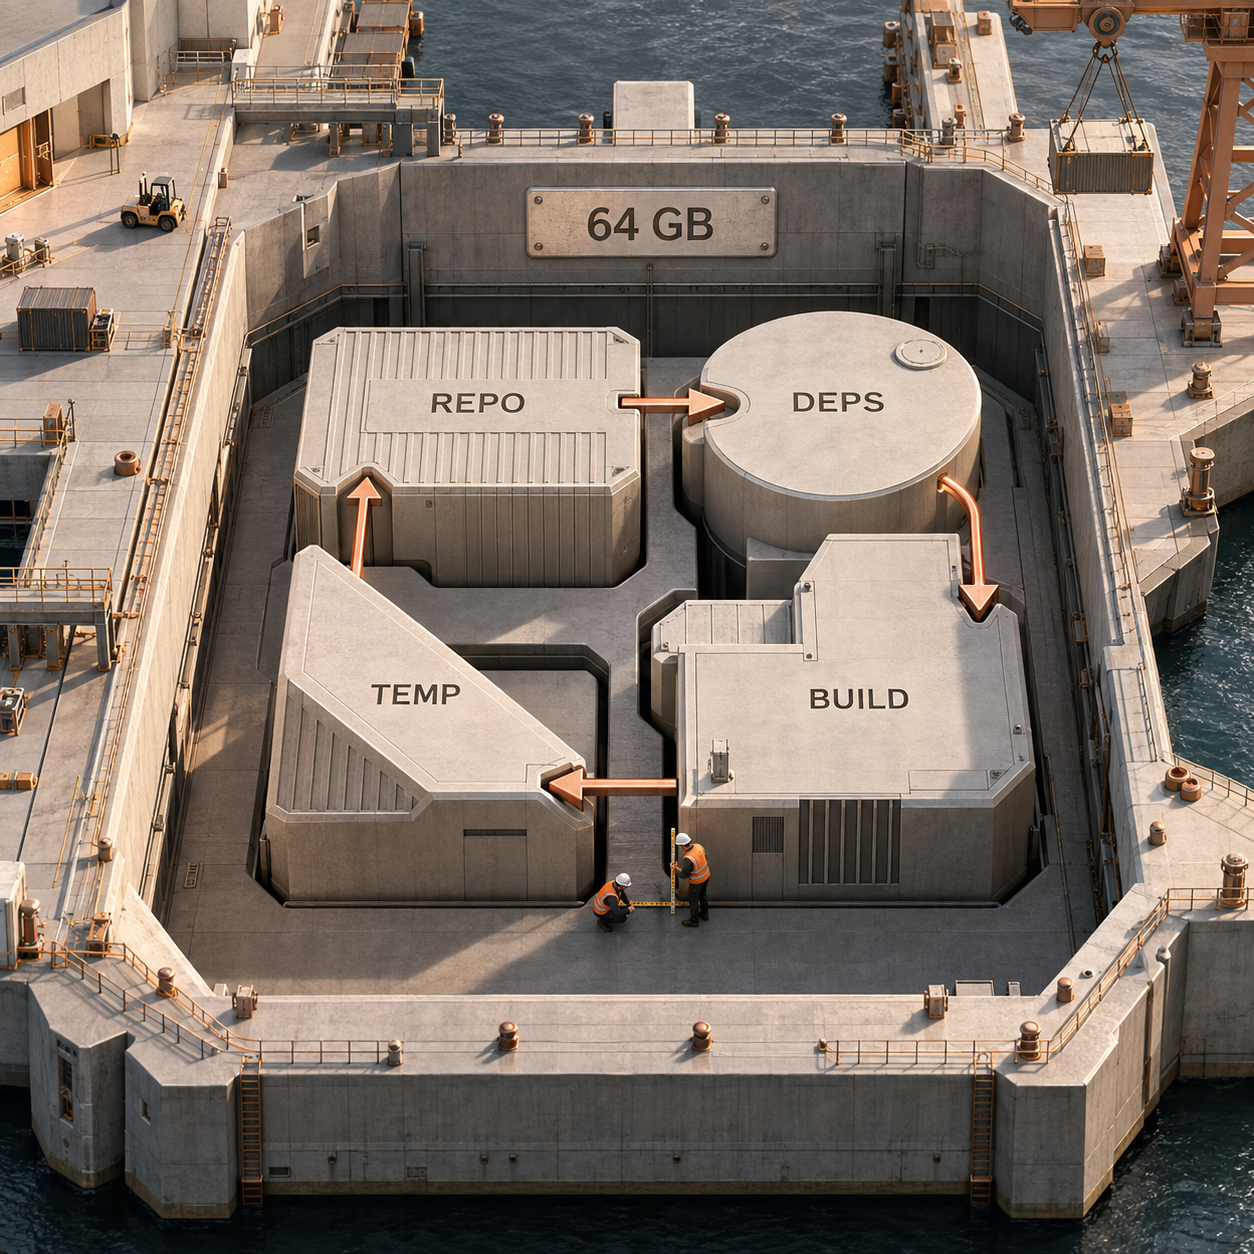
Maximaler Speicherbedarf = Repository und Checkout + installierte Abhängigkeiten + Build-Artefakte + maximale temporäre Datenmenge
Gemessen wird der Höchststand während der Ausführung – nicht die Größe der abschließenden ZIP-Datei. Paketentpackung, Kompilierung, Test-Fixtures, Browser-Binärdateien, Caches und ausgelagerte Daten überschneiden sich womöglich nur für wenige Minuten. Doch genau diese Minuten entscheiden, ob der Lauf erfolgreich endet.
In Vercels aktueller Preis- und Kontingentübersicht erscheinen die Speicherebenen als getrennte Budgetposten:
Diese Trennung verändert die Kostenrechnung. Die Verdopplung des lokalen Speicherplatzes verdoppelt nicht den Preis für Rechenleistung. In Vercels aktuellem Beispiel für iad1 kostet ein 30-minütiger Build- und Testlauf mit 4 vCPUs und 8 GB Arbeitsspeicher bei voller CPU-Auslastung etwa $0.34.
Ein größerer Job kann dennoch teurer werden, wenn er länger läuft oder mehr CPU und Arbeitsspeicher benötigt. Downloads wie Pakete, Repositorys, Artefakte und Datensätze sind kostenlos; Daten, die aus der Sandbox übertragen werden, sind dagegen kostenpflichtig.
Erst die Persistenz kann aus zusätzlichen Dateien eine neue Speicherrechnung machen. Würde ein Lauf die gesamten neu verfügbaren 32 GB nutzen und einen vollen Monat lang aufbewahren, ergäbe die Preisliste 32 × $0.08 = $2.56 pro Snapshot-Monat. Das ist ein Rechenbeispiel, keine automatische Gebühr. Ein nicht persistenter Lauf, der sein Ergebnis exportiert und den Arbeitsbereich anschließend verwirft, vermeidet diesen Snapshot-Posten.
Wer vom zusätzlichen Speicher profitiert
Staff Engineer mit großem Monorepo
Ein Staff Engineer muss derzeit möglicherweise Pakete aussortieren, Test-Fixtures entfernen oder einen Build aufteilen, weil Repository, Abhängigkeitsbaum und Build-Ausgabe unter der bisherigen Obergrenze nicht gleichzeitig Platz finden.
Bleibt der gemessene Spitzenbedarf nun innerhalb des verfügbaren 64-GB-Dateisystems, kann das Team Checkout, Installation, Test und Build wieder in einem Job bündeln. Der operative Gewinn: weniger Übergaben, weniger Teil-Artefakte und ein einziger Punkt für einen Neustart, falls der Build scheitert.
Damit ist Vercel nicht automatisch der richtige Sandbox-Anbieter. Wer die Ausführungsebene noch auswählt, findet im umfassenderen Vergleich von Code Sandboxes für KI-Agenten die Unterschiede bei Isolation und Abrechnung. Diese Änderung verschiebt lediglich Vercels Speichergrenze.
Agent-Plattform-Engineer bei Repository-Reparaturen
Während seiner Arbeit belegt ein Coding-Agent oft immer mehr Speicher. Er klont das Repository, installiert Tools, ändert Dateien, führt die Testsuite aus und verpackt das Ergebnis. Probiert ein Agent mehrere Lösungswege aus, können außerdem Caches und Zwischenergebnisse zurückbleiben.
Die zusätzlichen 32 GB geben diesem gesamten Ablauf mehr Raum, um in einer einzigen Sandbox zum Abschluss zu kommen. Dadurch kann ein Neustart wegen einer vollen Festplatte oder ein eigenes Bereinigungs-Tool aus dem Agenten-Workflow entfallen. Der Vorteil greift vor allem dann, wenn der Speicher tatsächlich die Fehlerursache war. Blockieren Arbeitsspeicher, CPU, Netzwerkrichtlinien oder Sitzungsdauer den Job, hilft ein größeres Dateisystem nicht.
Data Engineer mit festplattenintensiver Transformation
Ein Data Engineer kann das lokale Dateisystem als temporären Arbeitsbereich nutzen, wenn eine Transformation heruntergeladene Daten sortiert, verknüpft oder erweitert. Die größere Festplatte kann diese Zwischenarbeit lokal halten, statt eine frühe Aufteilung oder ein entfernt eingebundenes Laufwerk zu erzwingen.
Für die Ausgabe braucht es weiterhin einen klaren Zielort. Das dauerhafte Ergebnis muss herauskopiert, in den passenden Objektspeicher geschrieben oder über ein Drive bereitgestellt werden, wenn spätere Läufe dasselbe Verzeichnis benötigen. Eine 64-GB-Arbeitsfestplatte ist gerade deshalb nützlich, weil sie sich anschließend verwerfen lässt. Sie als dauerhaften Speicher zu behandeln, vermischt zwei verschiedene Aufgaben und zwei verschiedene Rechnungen.
Team mit bestehender runtime-Konfiguration
Die Freigabe vom 11. September schließt ausdrücklich Sandboxes ein, die mit der veralteten Eigenschaft runtime konfiguriert sind. Bestehender Code sollte die größere Festplatte erhalten, ohne auf ein Image migriert werden zu müssen.
Die Plattform entwickelt sich dennoch in Richtung Images. Ab Version 3 des Sandbox SDK verwendet eine Sandbox ohne runtime und ohne image automatisch vercel/sandbox/universal:latest. Verwaltete Images werden jede Nacht aktualisiert; die Bindung an einen Digest schafft eine unveränderliche Umgebung, wenn reproduzierbare Builds entscheidend sind.
Vor der Workflow-Änderung einen echten Job messen
Die Freigabe beseitigt eine Obergrenze. Wie viel Platz das eigene Image und der konkrete Job tatsächlich haben, lässt sich daraus nicht ablesen. Deshalb sollte zunächst ein realer Lauf gemessen werden, bevor Bereinigungsschritte entfallen oder getrennte Builds wieder zusammengeführt werden.
Den Job auswählen, der die Entscheidung belegt
Geeignet ist ein Job, dem kürzlich der Speicher ausging, oder ein Job, der derzeit nur wegen der bisherigen Grenze aufgeteilt wird. Repository, Lockfile, Build-Befehl und Eingabedaten müssen dem Produktivpfad entsprechen. Ein Spielzeug-Repository beantwortet die geschäftliche Frage nicht.
Eine frische Image-basierte Sandbox starten
Der aktuelle Weg über CLI und Image erleichtert die Reproduzierbarkeit. Die folgende Befehlsfolge orientiert sich am dokumentierten Ablauf der Vercel Sandbox CLI und deaktiviert die Persistenz, damit bei der Messung nicht automatisch ein Snapshot entsteht.
Bashnpm i -g sandbox sandbox login sandbox create --name workspace-check --image vercel/sandbox/node:24 --timeout 30m --non-persistent tar -czf app.tgz -C ./my-app . sandbox copy ./app.tgz workspace-check:/tmp/app.tgz sandbox exec workspace-check -- sh -c "mkdir -p /app && tar -xzf /tmp/app.tgz -C /app"Jede Speicherphase protokollieren
Die Speicherprüfung läuft nach dem Checkout, nach der Installation der Abhängigkeiten, möglichst während des aufwendigsten Build-Abschnitts und nach Fertigstellung des Artefakts.
.nextunddistwerden durch die tatsächlichen Ausgabepfade des Projekts ersetzt.Bashsandbox exec --workdir /app workspace-check -- sh -lc 'df -h /; du -sh .git node_modules .next dist /tmp 2>/dev/null || true' sandbox exec --workdir /app workspace-check -- npm install sandbox exec --workdir /app workspace-check -- sh -lc 'df -h /; du -sh .git node_modules .next dist /tmp 2>/dev/null || true' sandbox exec --workdir /app workspace-check -- npm run build sandbox exec --workdir /app workspace-check -- sh -lc 'df -h /; du -sh .git node_modules .next dist /tmp 2>/dev/null || true'df -h /zeigt, wie viel Platz in der Sandbox noch frei ist. Diedu-Zeilen machen sichtbar, welcher Teil des Arbeitsbereichs ihn belegt. Wer erst nach dem fertigen Build misst, kann den Spitzenwert übersehen.Den Job einmal ohne den bisherigen Umweg wiederholen
Bleibt der gemessene Höchststand innerhalb des ausgewiesenen freien Speicherplatzes, folgt ein erneuter Lauf desselben Jobs – diesmal ohne das Beschneiden der Abhängigkeiten oder die Übergabe zwischen geteilten Builds. Zu protokollieren sind Erfolg, Laufzeit, Active CPU, bereitgestellter Arbeitsspeicher, Übertragung sowie alle angelegten Snapshots oder Drive-Speicher. Danach wird die Sandbox gestoppt.
Bashsandbox stop workspace-check
Wo die neue Kapazität nicht hilft
Mehr Festplattenspeicher bedeutet nicht mehr Arbeitsspeicher, CPU oder Zeit. Eine Sandbox-Sitzung dauert standardmäßig weiterhin 5 Minuten. Hobby-Sitzungen können bis zu 45 Minuten laufen, Pro- und Enterprise-Sitzungen bis zu 24 Stunden.
Die Freigabe garantiert auch nicht, dass jede Arbeitslast unter 64 GB problemlos hineinpasst. Das Ausgangs-Image belegt einen Teil des Dateisystems, und fortlaufend aktualisierte Image-Tags können sich mit Vercels nächtlichen Veröffentlichungen ändern. Der tatsächlich freie Platz sollte direkt nach dem Start geprüft werden. Muss derselbe Build immer in derselben Umgebung beginnen, ist das Image an einen Digest zu binden.
Benötigt ein Job dauerhaft gemeinsam genutzte Daten, ist ein Drive oder ein anderer persistenter Speicher die richtige Wahl. Braucht er mehr Arbeitsraum, als die Sandbox ausweist, bleibt er aufgeteilt, erhält ein gemountetes Laufwerk für die große temporäre Datenmenge oder läuft auf einer anderen Infrastruktur. Die neue Grenze verschiebt den Schwellenwert, nicht die Art dieser Optionen.
Was am Montag zu tun ist
Handlungsbedarf besteht diese Woche, wenn ein echter Repository-, Agenten- oder Datenjob an der bisherigen Speichergrenze gescheitert ist oder nur deshalb Bereinigungscode enthält. Ohne Messung des Spitzenbedarfs ist Abwarten sinnvoll: Eine funktionierende Aufteilung auf Verdacht zu entfernen, verschiebt den nächsten Fehler lediglich nach hinten. Keine Auswirkung hat die Änderung, wenn ein Job bereits deutlich unter der bisherigen Kapazität bleibt oder sein tatsächlicher Engpass bei CPU, Arbeitsspeicher, Netzwerkzugriff, Sitzungsdauer oder dauerhaftem Speicher liegt.
Am Montag wird ein repräsentativer Job ausgewählt, mit dem obigen Verfahren in einer frischen Image-basierten Sandbox mit 64 GB vermessen und einmal ohne den bisherigen Speicher-Workaround wiederholt. Der einfachere Ein-Job-Pfad bleibt nur dann bestehen, wenn der gemessene Lauf erfolgreich endet und die Gesamtkosten für Rechenleistung plus Persistenz weiterhin sinnvoll sind.
Weitere verständliche Einordnungen zu Änderungen, die die Betriebsrechnung verschieben, liefert der Newsletter.
- Zuletzt aktualisiert
- 12. Sept. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained