Precios de Gemini 3.8 TTS: cuánto cuesta por minuto y hora
Consulta los precios de Gemini 3.8 TTS por minuto y hora, compara Flash con Flash-Lite y calcula el cambio de tarifas previsto para enero de 2027.



El precio de Gemini 3.8 TTS parte de $0.0135 por minuto generado con el modelo Flash en Standard, mientras que Flash-Lite cuesta $0.009 por minuto. Son tarifas calculadas solo para la salida hasta el 31 de diciembre de 2026; Google tiene previsto duplicarlas el 1 de enero de 2027, por lo que un presupuesto de producción debe contemplar desde ahora ambos importes.
Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS se lanzaron el 23 de septiembre de 2026. Verifiqué todas las tarifas que aparecen a continuación en la página activa de precios de Gemini Developer API de Google el 24 de septiembre de 2026 y después convertí los 25 tokens de audio por segundo documentados por Google en minutos y horas generados.
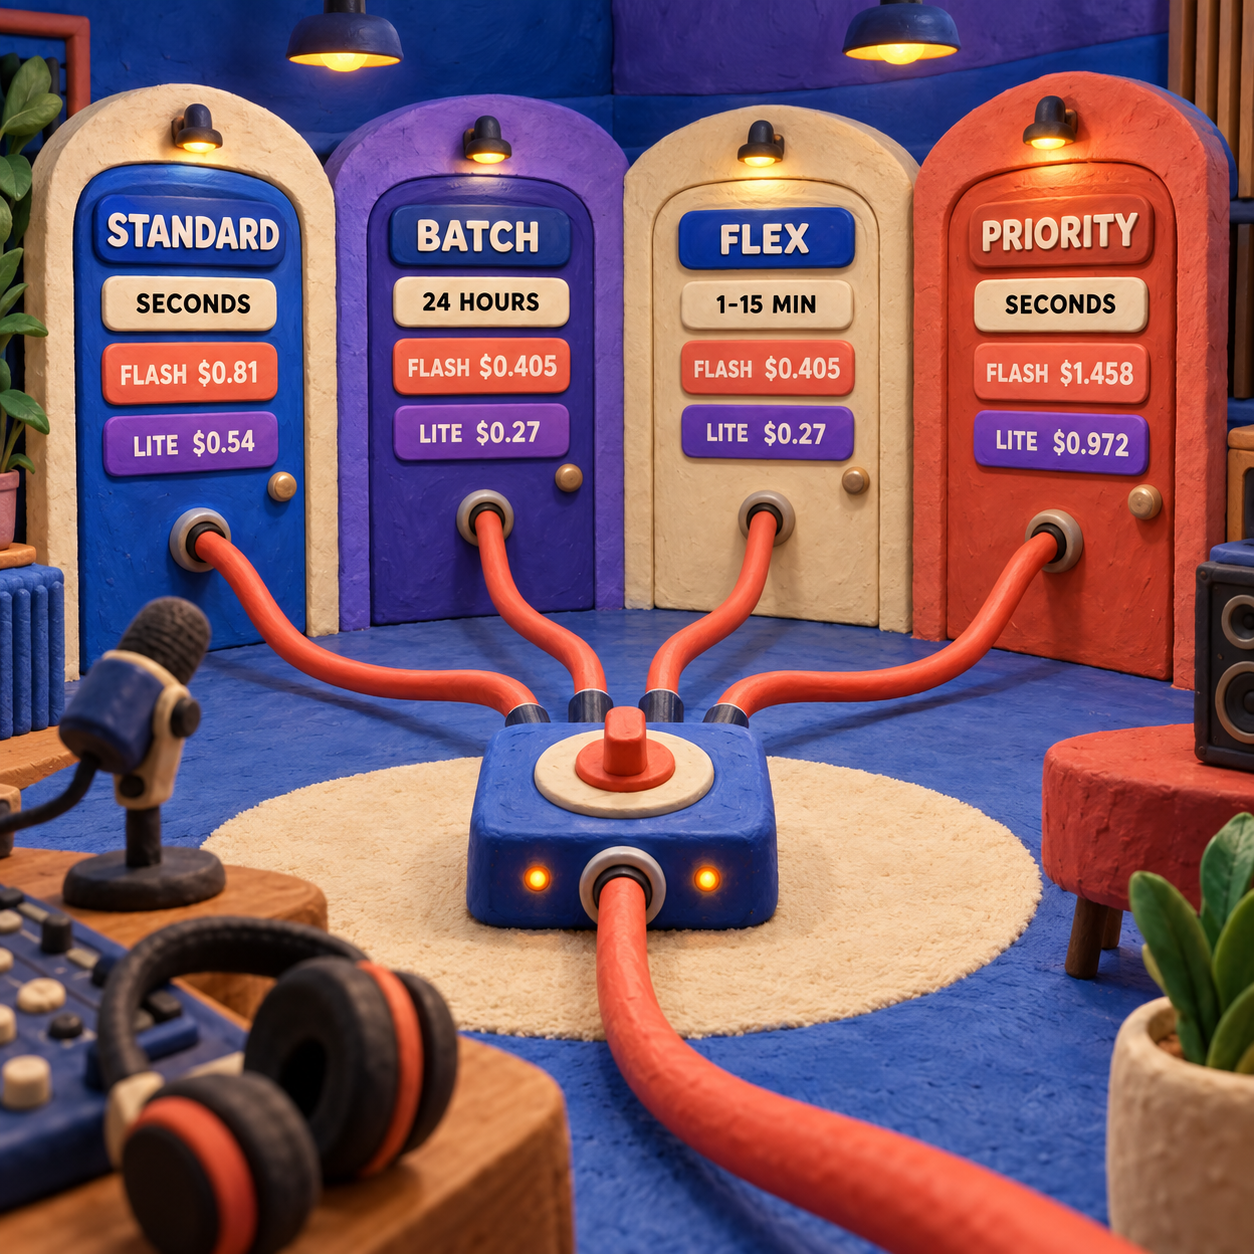
Precios de Gemini 3.8 TTS en resumen
La opción más barata es Flash-Lite con Batch o Flex: $0.0045 por minuto generado hasta el 31 de diciembre de 2026. Para un flujo de producción interactivo, la elección sensata por defecto es Flash-Lite Standard a $0.009 por minuto. Conviene pagar por Flash completo cuando la fidelidad, una pronunciación difícil, la cobertura de dialectos o la dirección interpretativa justifican la diferencia.
Todas las cifras de duración de la tabla son cálculos, no cargos medidos en una factura. Cubren únicamente la salida de audio generada. La factura también puede incluir tokens de texto de entrada, lecturas de caché y almacenamiento en caché.
Coste de Gemini 3.8 TTS por minuto y hora
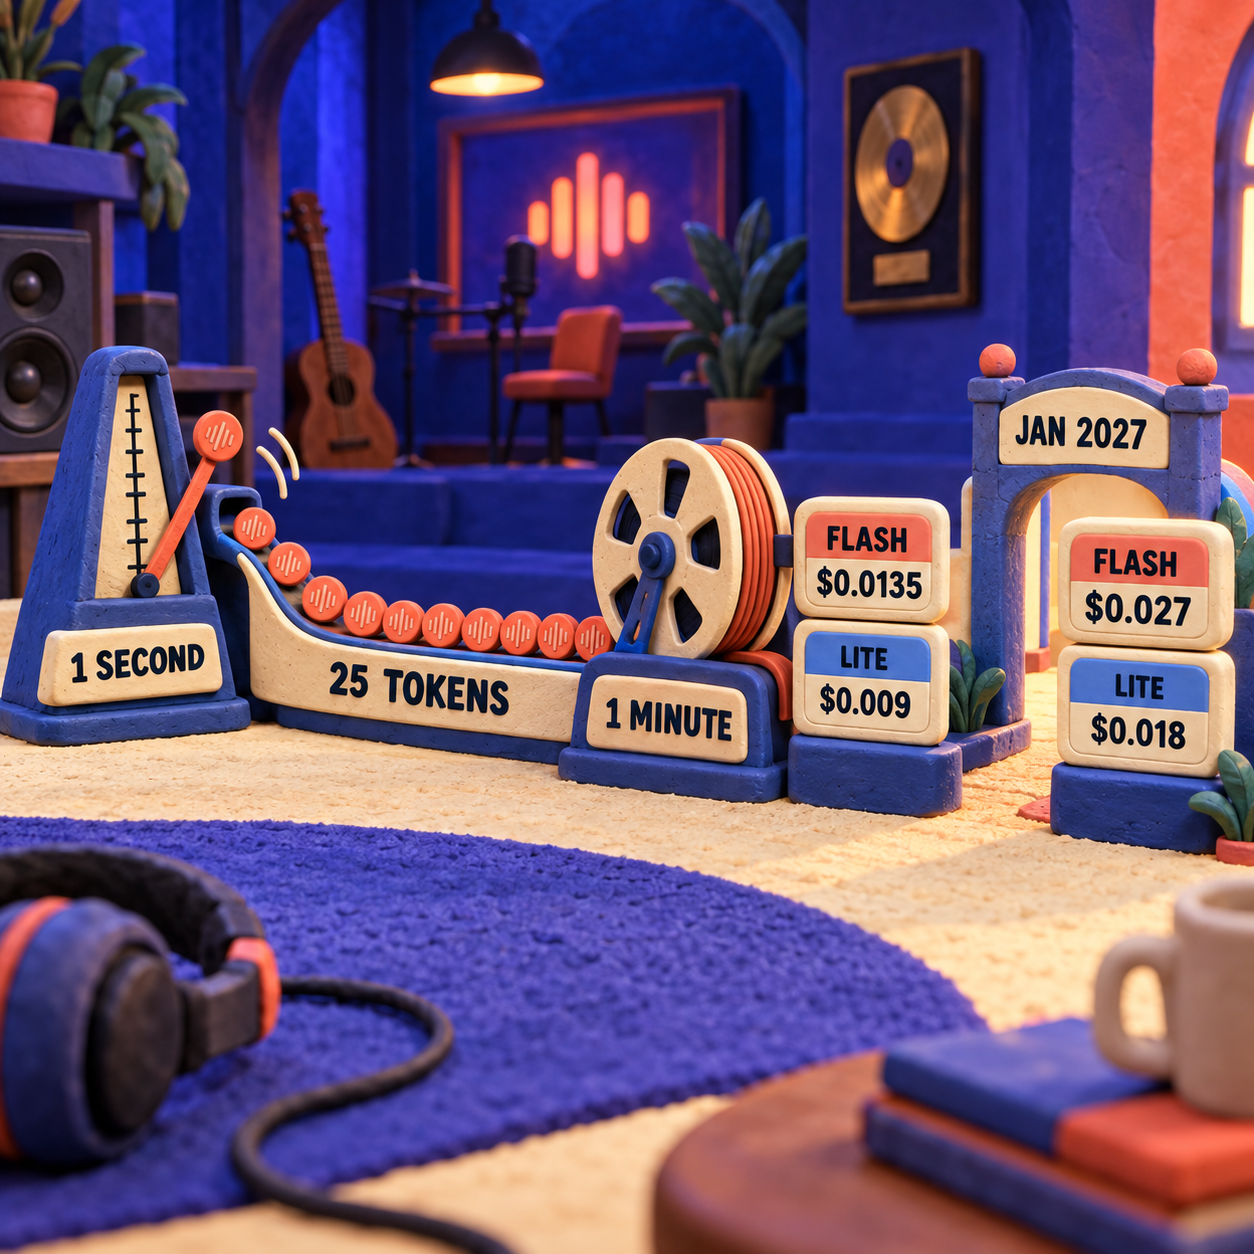
El cálculo por duración es sencillo cuando se conoce la unidad de facturación: Google cuenta 25 tokens de audio por segundo, de modo que un minuto generado equivale a 1,500 tokens de audio y una hora generada, a 90,000.
Para Flash Standard hasta el 31 de diciembre:
- Un minuto: 1,500 dividido entre 1,000,000 y multiplicado por $9.00 = $0.0135.
- Una hora: 90,000 dividido entre 1,000,000 y multiplicado por $9.00 = $0.81.
- Mil horas generadas: $0.81 multiplicado por 1,000 = $810.
Para Flash-Lite Standard, sustituya la tarifa de audio de $9.00 por $6.00. El resultado es $0.009 por minuto, $0.54 por hora y $540 por 1,000 horas. Desde el 1 de enero de 2027, esas mismas cargas pasan a costar $0.018 por minuto, $1.08 por hora y $1,080 por 1,000 horas.
Esta es la hoja de cálculo reproducible:
- Salida de audio: segundos generados multiplicados por 25, divididos entre 1,000,000 y multiplicados por la tarifa de salida de audio.
- Texto de entrada: número real de tokens de entrada devuelto por la solicitud, dividido entre 1,000,000 y multiplicado por la tarifa de texto de entrada.
- Lecturas de caché: tokens de entrada realmente almacenados en caché, divididos entre 1,000,000 y multiplicados por la tarifa de lectura de caché.
- Almacenamiento en caché: tokens almacenados multiplicados por las horas de almacenamiento, divididos entre 1,000,000 y multiplicados por la tarifa de almacenamiento.
No estime los tokens de texto a partir de la duración del audio. Registre el recuento de entrada que devuelve la API. Si el registro de uso muestra exactamente 1,000,000 de tokens de texto de entrada junto con 100 horas generadas en Standard, Flash cuesta ahora $81.50: $81 de audio más $0.50 de texto. Flash-Lite cuesta $54.50. Desde el 1 de enero, esos totales pasan a $163 y $109.
La distinción importa porque un guion corto puede dar lugar a una interpretación lenta y cargada de pausas, mientras que uno denso puede leerse deprisa. Google mide por separado el guion y el audio resultante.
Precios de Gemini Flash-Lite TTS: cuándo conviene Lite
Flash-Lite gana cuando la voz es un componente de producción y no la interpretación principal. La guía de modelos TTS de Google lo presenta para producción de gran volumen, funciones de lectura en voz alta, cascadas de agentes de voz, réplica de voz y locuciones cotidianas de un solo hablante. Admite 101 idiomas y utiliza el mismo esquema de API que Flash completo.
Flash completo es el nivel creativo. Google lo posiciona para obtener la máxima fidelidad, una interpretación con matices, pronunciaciones difíciles, dialectos regionales, diálogos complejos con varios hablantes y narraciones largas estables en 130 idiomas. Su salida Standard cuesta $0.27 más por hora generada que Lite hasta el 31 de diciembre, y $0.54 más desde el 1 de enero.
La regla para decidir es un fallo audible, no el prestigio. Pruebe primero en Lite el mismo guion aprobado y las mismas indicaciones de voz. Si la pronunciación, el dialecto, la interpretación de un personaje o una escena larga no alcanzan el nivel creativo exigido, cambie el parámetro del modelo y vuelva a generar ese segmento con Flash. Como la estructura de prompting es compartida, no hacen falta dos sistemas de producción.
- El coste bruto del audio generado es lo bastante bajo como para probar capítulos, cursos o lotes de localización completos.
- Flash y Flash-Lite comparten un esquema, lo que facilita escalar solo los segmentos necesarios.
- Ambos modelos admiten las opciones de consumo Standard, Batch, Flex y Priority.
- La tabla de tarifas separa texto, audio, lecturas de caché y almacenamiento en lugar de ocultarlos en créditos.
- La página pública de Google no especifica una asignación gratuita fija exclusiva para TTS.
- Está previsto que todas las tarifas de pago de TTS indicadas se dupliquen el 1 de enero de 2027.
- Flex puede descartar solicitudes y fallar cuando la capacidad es escasa.
- El coste por token no incluye la escucha humana, la edición, la masterización ni la revisión de derechos necesarias para entregar el audio.
Cómo elegir entre Standard, Batch, Flex y Priority
Elija el nivel de servicio según el plazo y la tolerancia a fallos. El nivel cambia la forma en que se programa y factura una misma solicitud al modelo.
Standard es la opción predeterminada para la producción diaria. Es síncrono, suele responder en segundos o minutos y aplica la tarifa completa. Úselo cuando un editor prueba líneas, un diseñador ajusta la dirección de voz o una aplicación necesita responder mientras el usuario sigue presente.
Batch es la vía fiable más barata para una cola que puede dejarse trabajando durante la noche. Cuesta la mitad que Standard, se ejecuta de forma asíncrona y tiene un plazo objetivo de hasta 24 horas. Una editorial que genera un audiolibro terminado o una plataforma educativa que regenera un catálogo debería empezar aquí.
Flex cuesta lo mismo que Batch, pero sigue siendo síncrono. Google fija como objetivo entre 1 y 15 minutos y utiliza capacidad descartable según disponibilidad. Una solicitud puede recibir un error de capacidad y Google no la subirá silenciosamente a Standard. Flex encaja en un flujo en segundo plano cuyo siguiente paso necesita la respuesta, pero puede reintentarlo más tarde.
Priority está pensado para los casos en que una respuesta de voz tardía perjudica al producto. Envía el tráfico síncrono por capacidad de mayor criticidad. Si se superan los límites de Priority, Google puede bajar la solicitud a Standard y facturarla a la tarifa Standard. En la tabla actual de TTS, Priority cuesta 1.8 veces Standard: Flash-Lite pasa de $0.54 a $0.972 por hora de salida y Flash, de $0.81 a $1.458.
El texto de entrada, el audio de salida y la caché se cobran por separado
La línea de audio domina la mayoría de las facturas de TTS, pero no representa todo el coste de generar voz.
Coste de la API de Gemini TTS: una factura en cuatro partes
El texto de entrada es la transcripción. Ambos modelos aplican la misma tarifa Standard de entrada: $0.50 por 1 millón de tokens hasta el 31 de diciembre y $1.00 después. Batch y Flex reducen esa tarifa a la mitad. Priority la eleva a $0.90 ahora y a $1.80 desde el 1 de enero.
El audio de salida es la interpretación generada. Aquí divergen Flash y Flash-Lite: Standard cuesta ahora $9 frente a $6 por 1 millón de tokens de audio y después, $18 frente a $12.
Las lecturas de caché se cobran cuando se reutiliza una entrada almacenada. Standard cuesta ahora $0.125 por 1 millón de tokens en caché; Batch, $0.0625; Flex, $0.025; y Priority, $0.225. Todos los importes se duplican en enero.
El almacenamiento en caché se factura por tiempo. Todos los niveles de servicio indican $0.50 por 1 millón de horas-token almacenadas hasta el 31 de diciembre y $1.00 desde el 1 de enero. Por tanto, guardar 8,000 tokens durante 24 horas cuesta ahora $0.096. Una lectura Standard de ese bloque añade $0.001. Desde enero, ambos importes pasan a $0.192 y $0.002.
La caché resulta útil cuando se repite un contexto importante de instrucciones o pronunciación. No es automáticamente rentable para un guion corto y único. Calcule la duración del almacenamiento y las lecturas previstas antes de considerar la tarifa de lectura más baja como un ahorro.
Esta tabla de tarifas no contempla una suscripción mensual o anual de TTS. El uso de pago de la API se mide por consumo, así que no existe un descuento anual que conseguir ni una asignación mensual incluida que rebasar. El riesgo de dependencia aparece en otro punto: los créditos prepagados de Gemini API que no se usan caducan al cabo de un año y, por lo general, no son reembolsables.
Nivel gratuito de Gemini TTS: qué documenta Google
Google indica que el texto de entrada, el audio de salida y el almacenamiento de contexto en caché son gratuitos en el nivel gratuito de ambos modelos Gemini 3.8 TTS. No publica en la página de precios una asignación específica de tokens para TTS ni un número garantizado de minutos de audio gratis.
Eso convierte el nivel gratuito en una opción útil para probar voces, comprobar la estructura de los prompts y crear prototipos pequeños, pero no en un plan de capacidad seguro para lanzar un producto. Google explica que los límites activos dependen del nivel de uso del proyecto, se muestran en AI Studio, se actualizan con el estado de la cuenta y no están garantizados. Consulte el proyecto en lugar de copiar una cuota de un blog.
La contrapartida de privacidad también cambia con la facturación. La página de precios de Google señala que el contenido del nivel gratuito puede usarse para mejorar sus productos, mientras que el contenido del nivel de pago no se utiliza con ese fin conforme a las condiciones enlazadas. La voz de un cliente, un guion aún no publicado o un módulo formativo sensible deben formar parte de esa decisión antes de entrar en la herramienta.
¿Quién puede no necesitar pagar nunca? Un diseñador que solo prueba unas cuantas voces y se mantiene dentro de los límites activos del proyecto podría seguir en el nivel gratuito. Quien prometa volumen de entregas, rendimiento o trabajo de producción confidencial debería presupuestar el nivel de pago en vez de tratar una asignación sin especificar como infraestructura.
El mismo brief de voz, presupuestado antes y después
Una biblioteca formativa de 100 horas con un solo narrador muestra con claridad la decisión entre modelos. En Standard hasta el 31 de diciembre, el subtotal calculado de salida es de $54 con Flash-Lite y $81 con Flash. Desde el 1 de enero pasa a $108 y $162. El texto de entrada, la caché y cualquier toma regenerada se suman aparte.
La primera pasada debería utilizar Flash-Lite, porque la mayor parte de una narración rutinaria no necesita el modelo insignia en cada línea. En la revisión, solo debería pasarse a Flash el material que falle una comprobación creativa concreta: un nombre regional mal pronunciado, una escena emotiva que suena plana, un diálogo con varios hablantes que pierde separación o un audio largo cuya voz o ambiente acústico deriva.
Fije un brief representativo
Elija un guion que contenga el material difícil que afrontará la producción: nombres, números, pausas, giros emocionales y, cuando corresponda, más de un hablante. Mantenga la misma transcripción en ambos modelos.
Dirija bien la interpretación
Gemini 3.8 TTS trata el texto de la transcripción como palabras que debe recitar. Coloque las indicaciones sostenidas en metadatos de voz estructurados y reserve las etiquetas en línea para eventos vocales puntuales, así evitará que una instrucción se pronuncie en voz alta por error.
Pruebe primero Flash-Lite
Genere un piloto controlado y guarde después el uso de tokens de entrada devuelto y la duración real del audio. Este artículo no generó una muestra, por lo que sus cifras de duración siguen siendo costes calculados solo para la salida, no cargos medidos en una factura.
Escale únicamente los segmentos fallidos
Conserve la salida aceptable de Lite. Cambie el parámetro del modelo a Flash en los pasajes que no alcancen el nivel exigido de pronunciación, dialecto, interpretación, separación de hablantes o coherencia a lo largo del audio.
Elija la cola
Use Standard mientras una persona dirige el trabajo. Envíe a Batch el volumen pendiente ya aprobado, elija Flex solo si dispone de gestión de reintentos y compre Priority únicamente cuando la espera perjudique la experiencia del usuario.
No confunda TTS con Gemini Live ni con Flash solo de texto
Gemini 3.8 Flash TTS recibe texto y devuelve una interpretación de audio. El modelo general gemini-3.8-flash es un endpoint distinto con otra tabla de tarifas, por lo que los conocidos precios de entrada y salida del modelo de texto no sirven para estimar TTS. El desglose general de precios de Gemini explica por qué los planes para consumidores y la facturación de Developer API siguen separados, mientras que el análisis de Gemini 3 recorre la familia general de modelos.
Gemini Live vuelve a ser distinto. La guía de voz de Google describe TTS como una recitación exacta con estilo y sonido controlados, mientras que Live gestiona audio interactivo no estructurado y conversaciones multimodales. Un curso narrado, un audiolibro o el guion aprobado de un anuncio corresponden a TTS. Un agente de voz que escucha, razona, llama a una herramienta y mantiene al interlocutor involucrado utiliza un flujo Live con otro modelo de costes. El análisis del flujo de Gemini 3.8 Live explica esa decisión operativa.
Esta distinción evita el error más caro de una hoja de cálculo: usar una cifra barata de tokens de texto para presupuestar voz generada o aplicar la tarifa de salida de TTS a una sesión Live persistente.
Gemini TTS frente a ElevenLabs y Deepgram
Gemini es más barato por duración bruta generada que dos alternativas habituales de API con las tarifas introductorias de Standard, pero las unidades de cobro no son idénticas y el precio no determina la calidad de la voz.
Los precios de la API de ElevenLabs fijan Flash/Turbo y v3 Conversational en $0.05 por 1,000 caracteres y lo muestran como aproximadamente $0.05 por minuto, o unos $3 por hora. Su modelo creativo v3 cuesta aproximadamente $0.10 por minuto, o $6 por hora. Frente a esa estimación publicada por minuto, Gemini Flash-Lite Standard cuesta ahora $0.54 por hora y Flash, $0.81.
Deepgram publica $0.030 por 1,000 caracteres para Aura-2 y $0.015 para Aura-1. Con el supuesto de planificación declarado de 1,000 caracteres por minuto hablado, los importes normalizados son de unos $1.80 y $0.90 por hora. Ese supuesto es el punto débil: la velocidad del habla, las pausas y el audio no verbal alteran la duración, pero Deepgram sigue facturando por caracteres.
La comparación honesta es una prueba de pago con su propio guion. Normalice los proveedores a la misma hora aprobada, incluya las tomas descartadas y puntúe pronunciación, interpretación, coherencia, latencia y tiempo de edición. La ventaja bruta de Gemini en tokens es relevante, pero una voz más barata que genera más trabajo de revisión no abarata la producción.
Costes ocultos y el cambio de presupuesto de enero de 2027
El cambio de tarifa programado es el riesgo para el presupuesto. Un volumen pendiente de 1,000 horas en Flash-Lite Standard tiene un coste calculado de salida de audio de $540 si se completa antes del 31 de diciembre y de $1,080 desde el 1 de enero. Flash pasa de $810 a $1,620. Batch o Flex después del aumento tienen el mismo subtotal de salida que Standard hoy.
Los demás costes son operativos:
- Regeneración: las tomas rechazadas generan más salida de audio facturable.
- Control de calidad humano: todo nombre propio, número, voz sujeta a consentimiento y edición final requiere revisión.
- Almacenamiento en caché: un contexto guardado sigue facturándose por hora-token hasta que se libera.
- Caducidad del prepago: los créditos prepagados de Gemini API que no se usan caducan al cabo de un año y, por lo general, no son reembolsables. Los fondos de pospago no utilizados podrían reunir los requisitos para un reembolso, pero los créditos promocionales no.
- Separación de aplicaciones: una suscripción de consumo a Gemini no convierte TTS de Developer API en una función incluida.
La acción concreta para el lunes es procesar una hora representativa con Flash-Lite Standard, guardar el uso real de texto de entrada y la duración de salida, marcar cada segmento que no alcance el nivel creativo y volver a generar solo esos segmentos con Flash. Lleve la combinación resultante a dos columnas de presupuesto: una con las tarifas actuales y otra con las de enero. Después, traslade el volumen pendiente aprobado a Batch si el objetivo de 24 horas resulta aceptable.
Preguntas frecuentes sobre los precios de Gemini 3.8 TTS
¿Cuánto cuesta Gemini Audio TTS?
Hasta el 31 de diciembre de 2026, la salida de audio Standard cuesta $0.009 por minuto para Gemini 3.8 Flash-Lite TTS y $0.0135 por minuto para Gemini 3.8 Flash TTS. Estas cifras calculadas excluyen el texto de entrada, las lecturas de caché y el almacenamiento en caché.
¿Cuánto cuestan 1000 tokens?
Depende del tipo de token. Hoy, en Standard, 1,000 tokens de texto de entrada cuestan $0.0005 con cualquiera de los modelos. Mil tokens de audio de salida cuestan $0.009 en Flash o $0.006 en Flash-Lite y corresponden a 40 segundos de audio generado. Todos los importes se duplican el 1 de enero de 2027.
¿La API de Google TTS es gratis?
Google indica que la entrada, la salida y la caché de Gemini 3.8 Flash TTS y Flash-Lite TTS son gratuitas en el nivel gratuito. No publica una cuota fija de tokens o minutos específica para TTS, así que compruebe el límite activo en AI Studio.
¿Cómo conseguir TTS gratis?
Cree o seleccione un proyecto activo en Google AI Studio, abra el espacio de generación de voz y use uno de los dos modelos Gemini 3.8 TTS dentro de los límites gratuitos del proyecto. No dé por sentado que esa capacidad gratuita está garantizada para producción.
¿TTS cuesta dinero?
Sí, cuando se utiliza el nivel de pago de Gemini API. Google factura por separado el texto de entrada, el audio de salida, las lecturas de caché y el almacenamiento en caché; las tarifas Standard solo de salida empiezan actualmente en $0.009 por minuto generado.
¿Qué tan caro es TTS?
Gemini Flash-Lite Standard cuesta actualmente $0.54 por hora generada en salida de audio, mientras que Flash cuesta $0.81. Batch y Flex reducen esos importes a la mitad; Priority los eleva a $0.972 y $1.458.
¿Cuál es el mejor software FreeTTS?
Gemini TTS es una API en la nube, no la biblioteca de software FreeTTS. Si el objetivo es evaluar sin coste, el nivel gratuito de Gemini resulta útil, pero su página pública de precios no promete una cantidad concreta de minutos gratis.
¿Cómo se activa Google TTS?
Abra el espacio de generación de voz de Google AI Studio o llame a gemini-3.8-flash-tts o gemini-3.8-flash-lite-tts mediante la Gemini API con un proyecto activo y una clave de API.
¿Gemini 3.8 Flash TTS ofrece descuento para estudiantes?
La página de precios de Developer API de Google no indica ninguna tarifa específica para estudiantes en Gemini TTS. Los estudiantes utilizan los mismos niveles gratuitos o de pago que se muestran para cualquier desarrollador.
¿Puedo obtener un reembolso por cargos de Gemini TTS API?
Google señala que los fondos no utilizados de una cuenta de pagos de pospago vinculada podrían reunir los requisitos para un reembolso. Los créditos prepagados de Gemini API que no se usan caducan un año después de la compra y, por lo general, no son reembolsables; los créditos promocionales también quedan excluidos.
¿Cambiaron los precios de Gemini 3.8 Flash TTS en 2026?
Los modelos se lanzaron el 23 de septiembre de 2026 con tarifas de pago introductorias. Esas tarifas se aplican hasta el 31 de diciembre y está previsto que se dupliquen el 1 de enero de 2027.
Use la lista de comprobación para auditar flujos de trabajo de IA y decidir dónde encaja la voz generada antes de comprometer un presupuesto de producción. Consígala con el boletín.
- Última actualización
- 24 sept 2026
- Categoría
- Design
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Software para hacer patrones de frivolité: qué opción conviene
Comparamos Inkscape, Amaziograph, Affinity y TattingCAD para crear diagramas de frivolité editables, claros y listos para imprimir sin pagar de más.20 sept 2026Design
Software para tejido con tablillas: cuatro programas que sí llegan al telar
Comparamos cuatro programas para crear patrones de tejido con tablillas: enhebrado, giros, torsión y esquemas imprimibles listos para el telar.20 sept 2026Design
Convertir foto en punto de cruz: PCStitch frente a WinStitch
Comparamos PCStitch 11 y WinStitch 2026 para convertir fotografías en patrones de punto de cruz: color, limpieza, símbolos, PDF, precios y límites.20 sept 2026Design
QuiltAssistant: patrones de patchwork gratis bajo la lupa
Probamos QuiltAssistant para convertir fotos en patrones de patchwork. Descubre qué ofrece gratis, sus límites en Windows y cuándo conviene usarlo.20 sept 2026Design
Software de punto de cruz WinStitch: cuánto cuesta de verdad
Descubre cuánto cuesta el software de punto de cruz WinStitch, qué extras encarecen el carrito y cuándo compensan el paquete y las mejoras de por vida.20 sept 2026Design
Videos de demostración de producto: ngram o Demosmith
Comparamos ngram y Demosmith para crear videos de demostración de producto: captura, revisiones, exportaciones y costos para el mismo encargo.19 sept 2026Design
Patrones de costura PDF: cómo dividirlos en A4 con Seamly2D
Aprende a dividir patrones de costura PDF en hojas A4 o Letter con Seamly2D, imprimirlos al 100% y comprobar la escala antes de cortar tela.19 sept 2026Design