Agent vocal IA : le vrai coût d’un appel avec GPT-Live-1
GPT-Live-1 facture la voix $0.05 par minute, mais le budget réel inclut aussi le backend et le transport téléphonique. Voici comment le calculer.



Avec GPT-Live-1, une ligne du budget d’un agent vocal IA devient simple à chiffrer : la session vocale coûte $0.05 par minute. Depuis le 10 septembre 2026, les équipes peuvent réunir l’écoute et la parole dans une même boucle, mais le chiffre vraiment utile reste le coût complet d’un appel résolu, backend, outils et transport téléphonique compris.
Les cinq centimes couvrent uniquement la couche vocale
GPT-Live-1 est un modèle vocal full duplex. Autrement dit, il continue d’écouter pendant qu’il parle : l’appelant peut l’interrompre, marquer une pause, corriger une information ou acquiescer brièvement sans attendre la fin d’un tour de parole rigide.
Cette capacité change l’architecture du système. Un agent téléphonique IA classique enchaîne souvent reconnaissance vocale, modèle de langage et synthèse vocale. L’application doit alors faire circuler l’information entre chaque étape et arbitrer les moments où les deux interlocuteurs parlent en même temps.
GPT-Live-1 prend en charge la conversation en direct dans une seule couche vocale. Il écoute, répond, gère le rythme de l’échange et détermine quand confier une tâche plus complexe au backend. Celui-ci peut vérifier une réservation, consulter un compte, appeler un outil ou interpréter une règle.
Le backend reste volontairement distinct. Avec la délégation Responses, GPT-Live-1 transmet le travail à un modèle de texte OpenAI configuré par vos soins. Avec la délégation côté client, votre application exécute le modèle, l’agent ou le service de son choix, puis renvoie le résultat. La même voix peut donc s’appuyer sur un moteur moins cher ou plus puissant selon la tâche.
La connexion téléphonique constitue encore une couche séparée. Un appel entrant peut rejoindre GPT-Live-1 par un trunk SIP, c’est-à-dire la connexion internet fournie par un opérateur téléphonique, ou par une application qui relaie l’audio. OpenAI gère la session Live ; l’opérateur continue de gérer le numéro et l’acheminement de l’appel.
Voilà ce qui change dans le budget. Pour ce parcours, il n’est plus nécessaire de chiffrer la reconnaissance et la synthèse vocales comme deux étapes OpenAI distinctes. En revanche, trois postes de coûts doivent rester clairement séparés.
Quel budget prévoir pour un agent vocal IA ?
Premier piège : le chronomètre. La facturation de GPT-Live-1 couvre toute la session active, de son ouverture à sa fermeture. Les silences comptent. L’attente d’un outil aussi. Couper le microphone n’interrompt pas la facturation.
Second piège : considérer le backend comme gratuit parce qu’il travaille en coulisses. Il ne l’est pas. Pour un contexte court standard, la tarification de GPT-5.6 Luna est de $0.20 par million de tokens en entrée et de $1.20 par million en sortie. Pour GPT-5.6 Terra, les tarifs sont de $2.00 et $12.00 ; pour GPT-6 Astra, de $10.00 et $50.00. La bonne question n’est donc pas de savoir quel modèle affiche le tarif au token le plus bas, mais quelle combinaison termine la tâche de manière fiable avec le moins de temps d’appel et de reprises.
Un appel de réservation révèle le vrai calcul
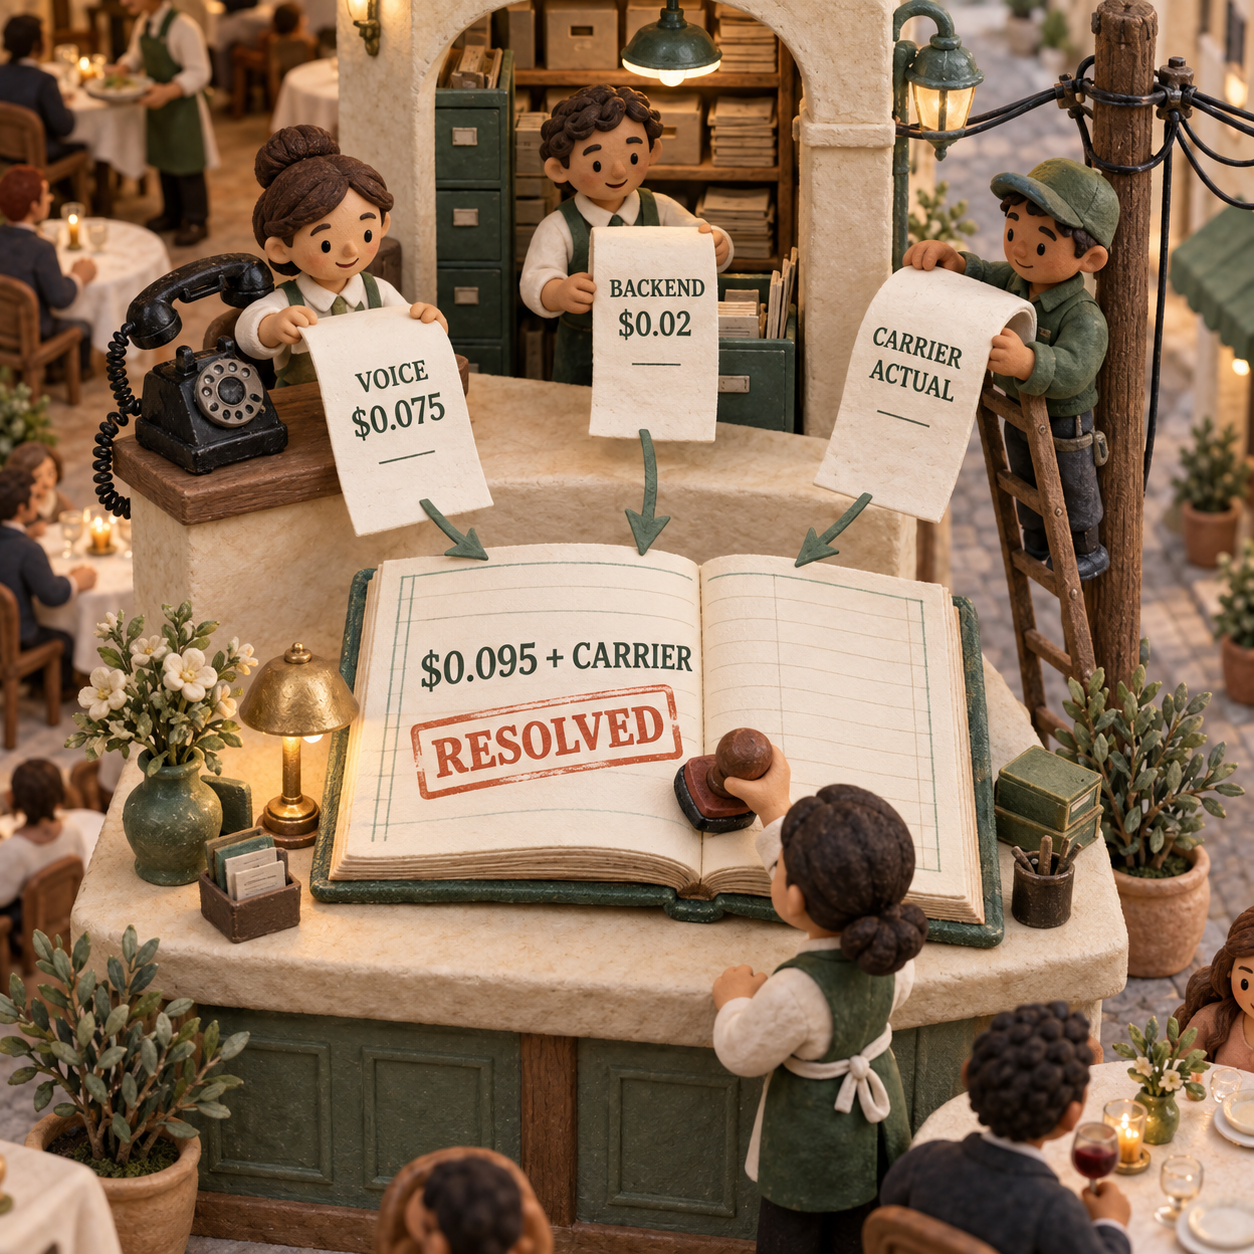
Prenons un appel entrant de 90 secondes pour réserver une table. L’exemple de coût fourni par OpenAI offre un point de départ clair :
- Voix : 90 secondes divisées par 60, puis multipliées par $0.05, soit $0.075.
- Backend : supposons que le modèle et les outils mesurés dans cet exemple totalisent $0.02.
- Sous-total voix et backend : $0.095.
- Transport téléphonique : ajoutez le coût réellement facturé par l’opérateur pour cet appel.
L’appel ne coûte donc pas $0.075, mais $0.095 plus le transport téléphonique dans cet exemple. Si la réservation est confirmée, cette somme correspond au coût d’exécution direct d’une réservation aboutie. Si l’agent échoue et qu’une personne doit recommencer, l’appel raté reste au numérateur dans le calcul du coût par résolution.
Conserver une ligne symbolique pour l’opérateur est plus honnête que d’inventer un tarif de marché dans le total. OpenAI ne fixe pas ce coût : il faut le relever sur la facture de votre propre fournisseur.
Un autre effet entre en jeu. Un backend plus rapide peut justifier un tarif au token supérieur s’il permet de fermer la session Live plus tôt. Une minute de session en moins économise $0.05 sur la voix. À l’inverse, un backend moins cher peut alourdir la facture totale s’il oblige l’appelant à répéter, attend trop longtemps les outils ou ne mène pas la réservation à terme.
Comment l’intégrer dans un parcours d’appel réel
Un restaurateur peut affecter GPT-Live-1 à son numéro de réservation entrant et limiter précisément sa mission. La couche vocale mène la conversation. Un backend économique consulte les disponibilités et prépare la réservation. L’application confirme ensuite le créneau final, enregistre la table et empêche un résultat tardif de réserver le mauvais horaire.
Pour un service client, le même front-end peut appliquer plusieurs politiques backend. Les recherches de commande courantes peuvent être confiées à un modèle optimisé pour le coût. Une contestation de paiement ou une exception aux règles peut être transmise à un modèle plus puissant ou à une personne. L’intérêt n’est pas de demander à un seul modèle vocal de tout faire, mais d’adapter le coût du raisonnement à chaque tâche sans rompre l’expérience orale.
Une équipe produit qui dispose déjà d’une chaîne reconnaissance vocale–modèle–synthèse vocale doit raisonner autrement. GPT-Live-1 peut supprimer du code de liaison et mieux gérer les paroles simultanées, mais la migration ne se justifie que si les gains sur l’accomplissement des tâches ou la maintenance compensent le travail nécessaire. Le comparatif du coût des agents vocaux IA reste pertinent pour arbitrer entre développement interne et solution prête à l’emploi.
Dans une application web, une connexion WebRTC permet de supprimer entièrement le poste opérateur téléphonique. La durée Live et le travail du backend restent facturés. Cette avancée de l’IA vocale ne change rien aux agents textuels, aux traitements batch ni aux applications sans interaction vocale.
Le plus petit pilote téléphonique vraiment utile
Dans le parcours SIP direct, le fournisseur envoie d’abord un appel entrant à OpenAI, puis votre webhook reçoit l’identifiant de la session Live. Voici la requête d’acceptation documentée :
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
La clé API reste sur votre backend de confiance. Comme SIP négocie le format audio, ne renseignez pas audio.format. Avec la délégation côté client, votre application garde la maîtrise du modèle backend, des outils, des autorisations et des données d’usage.
Pour un pilote de réservation entrante, le périmètre est assez limité pour obtenir des mesures lisibles.
Choisissez un résultat concret
Le succès doit être une réservation confirmée, pas simplement une conversation agréable. Enregistrez l’horaire demandé, l’horaire finalement réservé et l’éventuelle reprise par une personne.
Consignez chaque poste de coût
Pendant l’appel, conservez la dernière valeur cumulative des secondes de voix. Lors d’une fermeture normale, remplacez-la par la valeur finale de
session.closed. Enregistrez une seule fois l’identifiant de chaque réponse backend, ainsi que son usage de tokens et d’outils. Rapprochez ces données du relevé détaillé de l’opérateur.Testez de vraies interruptions
Reproduisez les pauses, corrections, bruits de fond et brefs acquiescements de vos appelants. Vérifiez la transcription, l’action exécutée par le backend et l’audio effectivement entendu. Une réponse backend terminée ne prouve pas que son résultat a été prononcé.
Comparez le coût par tâche aboutie
Additionnez les dépenses de voix, de backend et de transport sur tout le pilote, puis divisez-les par le nombre de réservations confirmées. Incluez les appels ratés, les nouvelles tentatives et les transferts vers une personne. Comparez ce résultat à celui du système actuel avec les mêmes scénarios d’appel.
Les interruptions doivent encore être validées sur vos appels
GPT-Live-1 est conçu pour gérer les paroles simultanées, mais une démonstration de lancement ne constitue pas un engagement de service. Andrew Hsu, cofondateur et CTO de Speak, indique que les premières évaluations de Speak ont réduit de près de 80% les interruptions pendant les pauses de réflexion par rapport à ses précédents systèmes fondés sur des tours de parole. Ce résultat appartient au contexte du tuteur de langues de Speak.
Une ligne de restaurant bruyante, un client qui dicte un numéro de commande et un patient qui hésite avant une date constituent des charges de travail différentes. Le prompt, le codec téléphonique, la gigue du réseau de l’opérateur, la latence des outils et vos propres contrôles de lecture influencent tous l’expérience de l’appelant. Il n’existe pas d’amélioration universelle et honnête des interruptions ou de la latence à reprendre telle quelle dans une prévision.
Le cas limite en production est tout aussi important. Si l’appelant interrompt l’agent et remplace vendredi par jeudi, cette correction orale n’annule pas automatiquement le travail backend lancé pour vendredi. Votre application doit modifier ou annuler l’ancienne tâche, ignorer tout résultat tardif et empêcher qu’une nouvelle tentative ne crée une seconde réservation.
À l’heure actuelle, la connexion SIP directe de GPT-Live couvre les appels entrants. L’endpoint de création d’une session Live ne lance pas d’appel SIP sortant : les campagnes sortantes nécessitent donc toujours un parcours partenaire géré par un fournisseur. Les équipes qui ont d’abord besoin d’appels sortants doivent valider cette voie avant de planifier une migration.
Ce qu’il faut faire lundi
Si vous gérez une file d’appels entrants pour des réservations ou du support, instrumentez un pilote au périmètre étroit. Réunissez dans un même enregistrement les secondes de voix, l’usage du backend, les frais de l’opérateur, les tâches abouties, les transferts et les échecs liés aux interruptions. Comparez un backend optimisé pour le coût au modèle plus puissant que vous pensez nécessaire.
Passez à l’étape suivante lorsque le coût complet par appel résolu bat celui de votre stack actuelle et que les appelants peuvent corriger l’agent sans déclencher d’actions obsolètes. Attendez si le seul avantage est le prix d’appel de $0.05, ou si l’opérateur et le parcours sortant ne sont pas encore définis. Ignorez cette version pour les usages exclusivement textuels et les expériences vocales qui atteignent déjà leurs objectifs de coût et de résolution.
Pour recevoir d’autres analyses claires des nouveautés qui changent réellement l’équation économique, abonnez-vous à la newsletter.
- Dernière mise à jour
- 14 sept. 2026
- Catégorie
- Explained
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

ChatGPT Windows : ce qu’Appshots change dans vos workflows
ChatGPT Windows reçoit Appshots pour joindre une fenêtre en un raccourci. Voici comment gagner du temps tout en maîtrisant le contexte réellement partagé.14 sept. 2026Explained
Vercel Functions : les fichiers statiques FastAPI passent au CDN
Les fichiers statiques FastAPI éligibles passent par le CDN de Vercel : moins d’invocations de Vercel Functions, sans supprimer les coûts de transfert.13 sept. 2026Explained
Clé API OpenAI : anticiper l’expiration sans coupure
Une clé API OpenAI peut désormais expirer. Voici comment budgéter sa rotation, déployer sa remplaçante et vérifier vos agents avant toute coupure.13 sept. 2026Explained
Vercel Connect : à qui confier les identifiants partagés ?
Vercel Connect permet aux équipes Pro et Enterprise de limiter la gestion des connecteurs. Voici comment nommer un responsable sans bloquer les projets.13 sept. 2026Explained
Cloudflare R2 : indexer des fichiers sans extension dans AI Search
Cloudflare R2 permet à AI Search d’indexer des fichiers sans extension grâce au Content-Type HTTP. Découvrez les coûts et les contrôles à prévoir.12 sept. 2026Explained
Stockage Vercel Sandbox : 64 GB pour les jobs d’agents IA
Le stockage Vercel Sandbox passe de 32 GB à 64 GB : ce que cela change pour les builds, les agents IA, les coûts et les données persistantes.12 sept. 2026Explained
Cloudflare Workflows : comment adapter la rétention
Cloudflare Workflows passe à sept jours de rétention par défaut pour les nouveaux Workflows Paid. Ajustez les délais d’enquête et le budget de stockage.11 sept. 2026Explained