Gemini Flash TTS 3.8 : prix à la minute et tarifs API
Comparez les tarifs de Gemini 3.8 Flash TTS et Flash-Lite, du coût par minute aux niveaux Standard, Batch, Flex et Priority avant la hausse de 2027.



Dans la gamme Gemini 3.8, Gemini Flash TTS démarre à $0.0135 par minute générée en Standard, contre $0.009 par minute pour Flash-Lite. Ces montants, calculés pour la sortie audio seule, s'appliquent jusqu'au 31 décembre 2026. Google prévoit de les doubler le 1er janvier 2027 : tout budget de production doit donc intégrer les deux grilles dès maintenant.
Gemini 3.8 Flash TTS et Gemini 3.8 Flash-Lite TTS ont été lancés le 23 septembre 2026. J'ai vérifié tous les tarifs ci-dessous le 24 septembre 2026 sur la page officielle des prix de l'API Gemini Developer, puis converti la règle publiée par Google — 25 tokens audio par seconde — en coûts par minute et par heure générées.
Gemini Flash TTS 3.8 : les tarifs en un coup d'œil
L'option la moins chère est Flash-Lite en Batch ou Flex, à $0.0045 par minute générée jusqu'au 31 décembre 2026. Pour un workflow de production interactif, Flash-Lite Standard constitue le choix raisonnable par défaut à $0.009 par minute. Le modèle Flash complet se justifie lorsque la fidélité, les prononciations difficiles, la couverture des dialectes ou la direction d'acteur comptent suffisamment pour absorber l'écart de prix.
Tous les montants liés à une durée dans ce tableau sont calculés ; ils ne proviennent pas d'une facture mesurée. Ils couvrent uniquement la sortie audio générée. La facture peut aussi inclure les tokens de texte entrant, les lectures du cache et son stockage.
Coût de Gemini 3.8 TTS par minute et par heure
Le calcul devient simple une fois l'unité de facturation connue : Google compte 25 tokens audio par seconde. Une minute générée représente donc 1,500 tokens audio, et une heure 90,000 tokens audio.
Pour Flash Standard jusqu'au 31 décembre :
- Une minute : 1,500 divisé par 1,000,000, puis multiplié par $9.00 = $0.0135.
- Une heure : 90,000 divisé par 1,000,000, puis multiplié par $9.00 = $0.81.
- Mille heures générées : $0.81 multiplié par 1,000 = $810.
Pour Flash-Lite Standard, remplacez le tarif audio de $9.00 par $6.00. On obtient $0.009 par minute, $0.54 par heure et $540 pour 1,000 heures. À partir du 1er janvier 2027, les mêmes charges de travail coûteront $0.018 par minute, $1.08 par heure et $1,080 pour 1,000 heures.
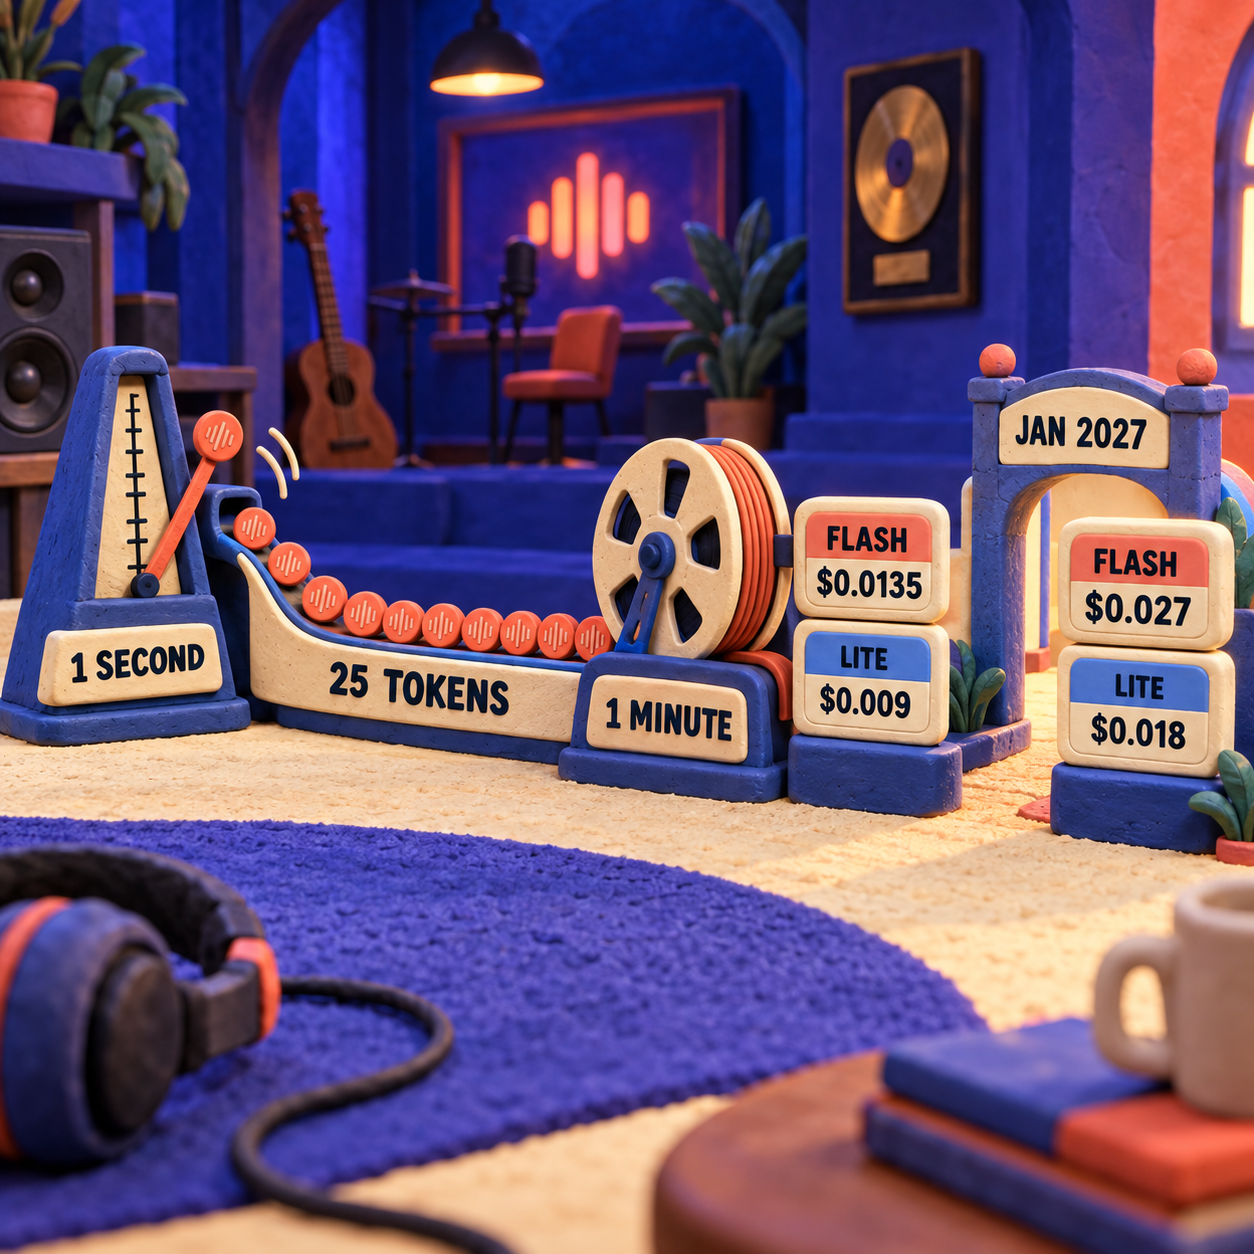
Voici la méthode de calcul reproductible :
- Sortie audio : secondes générées multipliées par 25, divisées par 1,000,000, puis multipliées par le tarif de sortie audio.
- Texte entrant : nombre réel de tokens d'entrée renvoyé par la requête, divisé par 1,000,000, puis multiplié par le tarif du texte entrant.
- Lectures du cache : nombre réel de tokens d'entrée mis en cache, divisé par 1,000,000, puis multiplié par le tarif de lecture du cache.
- Stockage du cache : tokens mis en cache multipliés par le nombre d'heures de stockage, divisés par 1,000,000, puis multipliés par le tarif de stockage.
N'estimez pas les tokens de texte à partir de la durée audio. Relevez le nombre de tokens d'entrée retourné par l'API. Si le relevé d'usage affiche exactement 1,000,000 tokens de texte entrant et 100 heures générées en Standard, Flash coûte actuellement $81.50 : $81 d'audio et $0.50 de texte. Flash-Lite revient à $54.50. À partir du 1er janvier, ces totaux passent à $163 et $109.
Cette distinction compte : un script court peut produire une interprétation lente, riche en pauses, tandis qu'un texte dense peut être lu rapidement. Google mesure séparément le script et l'audio qui en résulte.
Prix de Gemini Flash-Lite TTS : quand Lite suffit
Flash-Lite est le meilleur choix lorsque la voix est un composant de la production plutôt que sa performance centrale. Le guide Google des modèles TTS le destine à la production en volume, aux fonctions de lecture à voix haute, aux cascades d'agents vocaux, à la réplication de voix et aux prises de parole courantes avec un seul locuteur. Il prend en charge 101 langues et utilise le même schéma d'API que Flash complet.
Flash complet est le modèle créatif. Google le positionne sur la fidélité maximale, les nuances de jeu, les prononciations difficiles, les dialectes régionaux, les dialogues complexes à plusieurs voix et la stabilité des narrations longues dans 130 langues. En Standard, sa sortie coûte $0.27 de plus par heure générée que Lite jusqu'au 31 décembre, puis $0.54 de plus à compter du 1er janvier.
La règle de décision repose sur les défauts audibles, pas sur le prestige du modèle. Testez d'abord le même script validé et les mêmes indications vocales avec Lite. Si la prononciation, le dialecte, l'interprétation d'un personnage ou une longue scène n'atteint pas le niveau attendu, changez le paramètre du modèle et relancez uniquement ce passage avec Flash. La structure des prompts étant commune, nul besoin de maintenir deux systèmes de production.
- Le coût brut de l'audio généré est assez bas pour tester des chapitres, des cours ou des lots de localisation entiers.
- Flash et Flash-Lite partagent le même schéma, ce qui facilite le passage sélectif au modèle supérieur.
- Les deux modèles proposent les options Standard, Batch, Flex et Priority.
- La grille distingue le texte, l'audio, les lectures du cache et son stockage au lieu de les masquer derrière des crédits.
- La page publique de Google n'indique aucun quota gratuit propre au TTS.
- Tous les tarifs TTS payants affichés doivent doubler le 1er janvier 2027.
- Flex repose sur une capacité interruptible et peut échouer lorsqu'elle est saturée.
- Le coût des tokens n'inclut ni l'écoute humaine, ni le montage, ni le mastering, ni la vérification des droits nécessaires avant diffusion.
Standard, Batch, Flex ou Priority : quel niveau choisir ?
Le niveau de service dépend du délai et de la tolérance à l'échec. Il modifie la planification et la facturation d'une même requête au modèle.
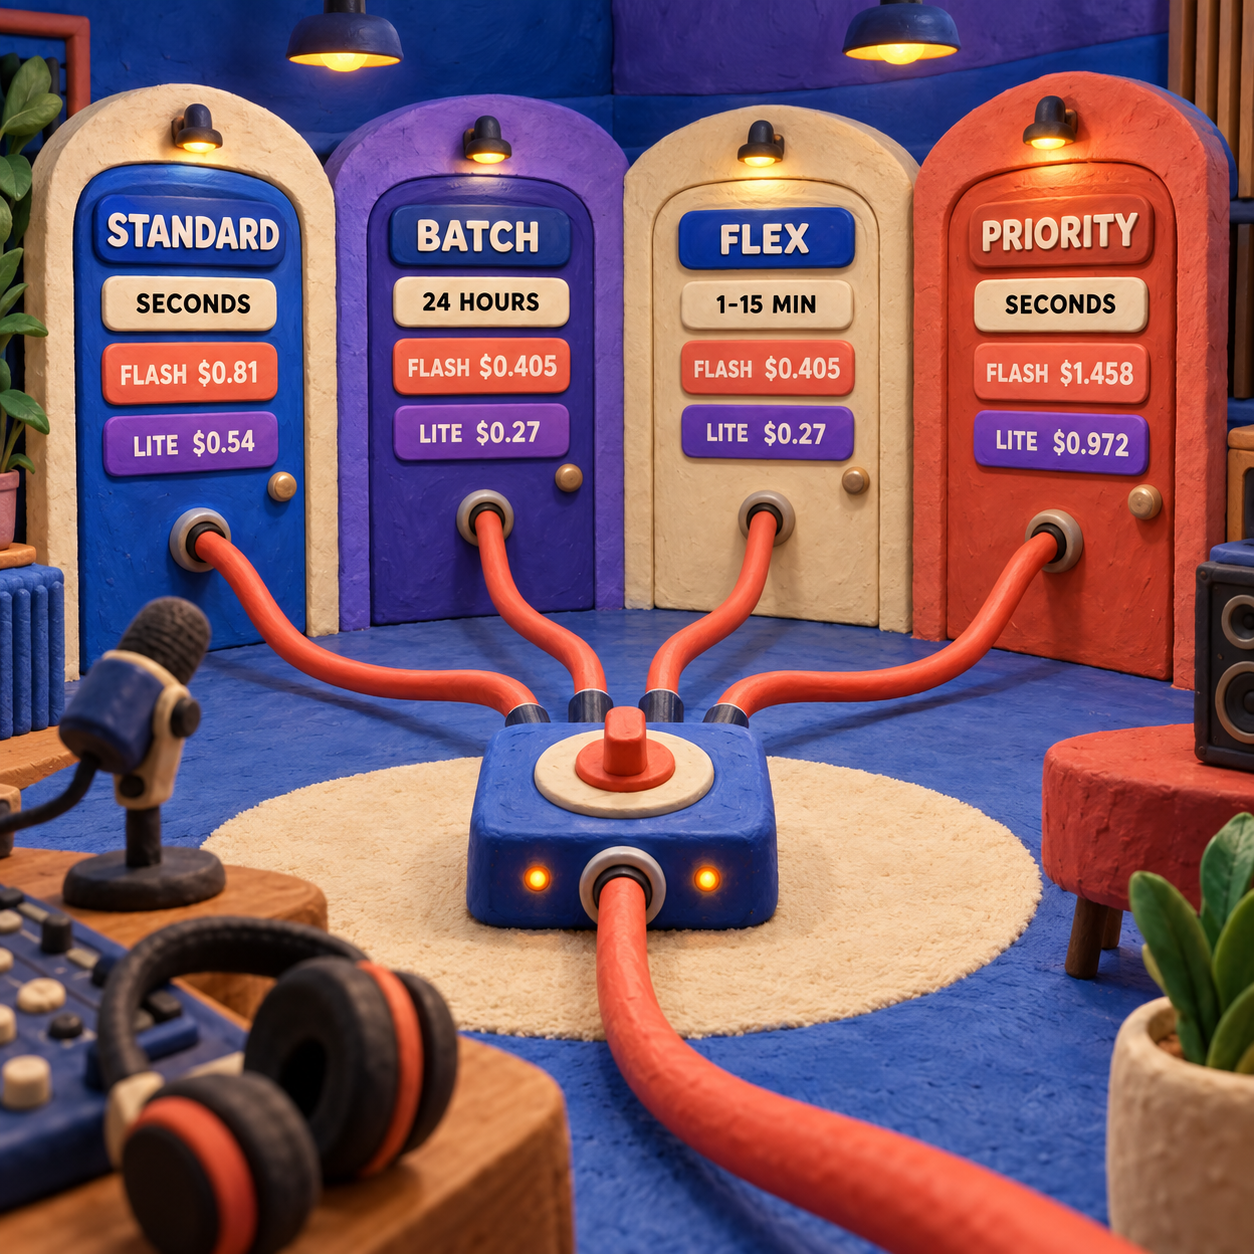
Standard est le choix par défaut pour la production quotidienne. Synchrone, il répond normalement en quelques secondes à quelques minutes et applique le plein tarif. Utilisez-le lorsqu'un monteur teste des répliques, qu'un designer affine la direction vocale ou qu'une application doit répondre pendant que l'utilisateur est encore présent.
Batch est l'option fiable la moins chère pour une file d'attente qui peut tourner la nuit. Son tarif correspond à la moitié de Standard, son exécution est asynchrone et son délai cible peut atteindre 24 heures. Un éditeur qui génère un livre audio finalisé ou une plateforme pédagogique qui renouvelle un catalogue devrait commencer ici.
Flex coûte autant que Batch tout en restant synchrone. Google vise un délai de 1 à 15 minutes sur une capacité best effort et interruptible. Une requête peut recevoir une erreur de capacité, sans bascule automatique vers Standard. Flex convient à un workflow en arrière-plan dont l'étape suivante exige la réponse, mais peut attendre et réessayer.
Priority s'adresse aux situations où un retard de la réponse vocale dégrade le produit. Le trafic synchrone passe par une capacité de criticité supérieure. Si les limites Priority sont dépassées, Google peut ramener la requête en Standard et la facturer au tarif Standard. Dans la grille TTS actuelle, Priority coûte 1.8 fois Standard : Flash-Lite passe ainsi de $0.54 à $0.972 par heure de sortie, et Flash de $0.81 à $1.458.
Texte entrant, audio sortant et cache sont facturés séparément
La ligne audio domine la plupart des factures TTS, mais elle ne représente pas toute la facture de génération vocale.
Coût de l'API Gemini TTS : les quatre postes
Le texte entrant correspond à la transcription. Les deux modèles appliquent le même tarif Standard : $0.50 pour 1 million de tokens jusqu'au 31 décembre, puis $1.00. Batch et Flex divisent ce tarif par deux. Priority le porte à $0.90 aujourd'hui et à $1.80 dès le 1er janvier.
La sortie audio est l'interprétation générée. C'est ici que Flash et Flash-Lite divergent : en Standard, ils coûtent respectivement $9 et $6 pour 1 million de tokens audio aujourd'hui, puis $18 et $12.
Les lectures du cache sont facturées lorsque des entrées déjà mises en cache sont réutilisées. En Standard, le prix actuel est de $0.125 pour 1 million de tokens mis en cache ; il est de $0.0625 en Batch, $0.025 en Flex et $0.225 en Priority. Tous doublent en janvier.
Le stockage du cache dépend du temps. Chaque niveau de service affiche $0.50 pour 1 million de tokens-heures mis en cache jusqu'au 31 décembre, puis $1.00 à partir du 1er janvier. Mettre 8,000 tokens en cache pendant 24 heures coûte donc actuellement $0.096. Une lecture Standard de ce bloc ajoute $0.001. En janvier, ces deux montants passeront à $0.192 et $0.002.
Le cache devient utile lorsqu'un contexte conséquent d'instructions ou de prononciations est réutilisé. Il n'est pas automatiquement rentable pour un script court et unique. Chiffrez la durée de stockage et le nombre attendu de lectures avant de considérer la baisse du tarif de lecture comme une économie.
Cette grille ne propose aucun abonnement TTS mensuel ou annuel. L'usage payant de l'API est mesuré : il n'existe donc ni remise annuelle à obtenir, ni allocation mensuelle incluse à dépasser. Le risque d'engagement se situe ailleurs : les crédits prépayés Gemini API non utilisés expirent au bout d'un an et ne sont généralement pas remboursables.
Offre gratuite de Gemini TTS : ce que Google indique vraiment
Google affiche le texte entrant, la sortie audio et le cache comme gratuits dans la colonne de l'offre gratuite pour les deux modèles Gemini 3.8 TTS. En revanche, la page tarifaire ne publie ni quota de tokens propre au TTS ni nombre garanti de minutes audio gratuites.
L'offre gratuite est donc adaptée aux essais de voix, à la validation de la structure des prompts et aux petits prototypes, mais pas au dimensionnement d'un lancement en production. Google précise que les limites actives dépendent du niveau d'usage du projet, s'affichent dans AI Studio, évoluent avec l'état du compte et ne sont pas garanties. Vérifiez le projet au lieu de recopier le quota cité dans un article.
Le compromis sur la confidentialité change lui aussi avec la facturation. D'après la page de prix de Google, les contenus de l'offre gratuite peuvent servir à améliorer ses produits ; ceux de l'offre payante ne sont pas utilisés à cette fin, conformément aux conditions liées. Une voix de client, un script inédit ou un module de formation sensible doit entrer dans cette décision avant d'être envoyé à l'outil.
Qui peut ne jamais payer ? Un designer qui se contente d'essayer quelques voix tout en restant dans les limites actives du projet peut conserver l'offre gratuite. Dès qu'il faut garantir un volume, un débit ou la confidentialité d'une production, mieux vaut budgéter l'offre payante que traiter une allocation non précisée comme une infrastructure fiable.
Un même brief vocal, chiffré avant et après la hausse
Une bibliothèque de formation de 100 heures avec un seul narrateur montre clairement l'effet du choix de modèle. En Standard jusqu'au 31 décembre, le sous-total calculé pour la sortie est de $54 avec Flash-Lite et de $81 avec Flash. À partir du 1er janvier, il passe à $108 et $162. Le texte entrant, le cache et les nouvelles prises s'ajoutent à ces montants.
Le premier passage devrait employer Flash-Lite, car une narration courante n'exige généralement pas le modèle phare sur chaque ligne. Au stade des corrections, ne passez au modèle supérieur que les éléments qui échouent à un critère artistique explicite : un nom régional mal prononcé, une scène émotive livrée sans relief, un échange à plusieurs voix où les locuteurs se confondent, ou un long enregistrement dont la voix ou l'ambiance sonore dérive.
Figer un brief représentatif
Choisissez un script qui rassemble les difficultés réelles de la production : noms, nombres, pauses, inflexions émotionnelles et plusieurs locuteurs lorsque le projet l'exige. Gardez une transcription identique pour les deux modèles.
Diriger correctement l'interprétation
Gemini 3.8 TTS traite le texte de la transcription comme les mots à prononcer. Placez les indications durables dans des métadonnées vocales structurées et réservez les balises inline aux événements vocaux ponctuels, afin d'éviter qu'une consigne soit lue à voix haute par erreur.
Tester Flash-Lite en premier
Générez un pilote contrôlé, puis enregistrez l'usage des tokens d'entrée renvoyé et la durée audio réelle. Aucun échantillon n'a été généré pour cet article : les montants liés à une durée restent donc des coûts calculés pour la sortie seule, et non des relevés de facture.
Ne basculer que les passages insuffisants
Conservez les sorties Lite satisfaisantes. Passez le paramètre du modèle à Flash pour les extraits qui échouent sur la prononciation, le dialecte, le jeu, la séparation des locuteurs ou la cohérence dans la durée.
Choisir la file de traitement
Utilisez Standard pendant qu'une personne assure la direction. Envoyez le volume déjà validé à Batch, ne choisissez Flex qu'avec un mécanisme de relance, et ne payez Priority que lorsque l'attente nuit à l'expérience utilisateur.
Ne confondez pas TTS, Gemini Live et Flash textuel
Gemini 3.8 Flash TTS reçoit du texte et renvoie une interprétation audio. Le modèle général gemini-3.8-flash correspond à un autre endpoint et à une autre grille tarifaire : les prix familiers des entrées et sorties du modèle textuel n'ont rien à faire dans une estimation TTS. Notre analyse complète des prix de Gemini explique la séparation entre les abonnements grand public et la facturation de l'API Developer, tandis que le test de Gemini 3 revient sur la famille de modèles généralistes.
Gemini Live est encore différent. Le guide vocal de Google présente le TTS comme une récitation fidèle dont le style et le son sont contrôlés, tandis que Live gère des conversations audio et multimodales interactives et non structurées. Un cours narré, un livre audio ou un script publicitaire validé relève du TTS. Un agent vocal qui écoute, raisonne, appelle un outil et maintient l'attention d'un interlocuteur utilise un workflow Live, avec un autre modèle de coûts. L'analyse du workflow en arrière-plan de Gemini 3.8 Live détaille ce choix opérationnel.
Cette distinction évite l'erreur la plus coûteuse dans un tableur : budgéter une voix générée avec un tarif bon marché de tokens textuels, ou appliquer le prix de sortie du TTS à une session Live persistante.
Gemini TTS face à ElevenLabs et Deepgram
Gemini revient moins cher à la durée générée que deux API souvent présélectionnées, selon ses tarifs Standard de lancement. Les unités facturées ne sont toutefois pas identiques, et le prix ne dit rien de la qualité vocale.
La tarification de l'API ElevenLabs affiche Flash/Turbo et v3 Conversational à $0.05 pour 1,000 caractères, soit environ $0.05 par minute ou $3 par heure. Son modèle créatif v3 coûte environ $0.10 par minute, soit $6 par heure. À titre de comparaison avec cette estimation publiée à la minute, Gemini Flash-Lite Standard revient aujourd'hui à $0.54 par heure et Flash à $0.81.
Deepgram facture Aura-2 $0.030 pour 1,000 caractères et Aura-1 $0.015. Avec une hypothèse de planification explicite de 1,000 caractères prononcés par minute, ces montants équivalent à environ $1.80 et $0.90 par heure. C'est précisément la faiblesse de l'hypothèse : le débit, les pauses et les sons non verbaux modifient la durée, alors que Deepgram continue de compter les caractères.
La comparaison rigoureuse consiste à réaliser un essai payant sur votre propre script. Ramenez chaque fournisseur à la même heure validée, incluez les prises rejetées, puis notez la prononciation, l'interprétation, la cohérence, la latence et le temps de montage. L'avantage brut de Gemini sur le coût des tokens est réel, mais une voix moins chère qui multiplie les corrections n'est pas la production la plus économique.
Coûts cachés et bascule budgétaire de janvier 2027
Le changement de tarif programmé constitue le principal risque budgétaire. Un volume de 1,000 heures en Flash-Lite Standard coûte $540 en sortie audio calculée s'il est terminé avant le 31 décembre, contre $1,080 à partir du 1er janvier. Flash passe de $810 à $1,620. Après la hausse, Batch ou Flex auront le même sous-total de sortie que Standard aujourd'hui.
Les autres coûts sont opérationnels :
- Régénération : les prises rejetées produisent de nouvelles sorties audio facturées.
- Contrôle qualité humain : chaque nom propre, nombre, voix soumise au consentement et montage final doit être vérifié.
- Stockage du cache : un contexte enregistré reste facturé à l'heure-token tant qu'il n'est pas libéré.
- Expiration du prépaiement : les crédits prépayés Gemini API inutilisés expirent au bout d'un an et ne sont généralement pas remboursables. Les fonds postpayés inutilisés peuvent être remboursables, mais les crédits promotionnels sont exclus.
- Séparation des offres : un abonnement Gemini grand public n'inclut pas le TTS de l'API Developer.
L'action à mener lundi est simple : faites passer une heure représentative dans Flash-Lite Standard, conservez l'usage réel du texte entrant et la durée de sortie, identifiez chaque passage qui ne satisfait pas le niveau créatif, puis ne relancez que ces passages avec Flash. Reportez ce mix dans deux colonnes budgétaires, l'une aux tarifs actuels et l'autre aux tarifs de janvier. Enfin, transférez le volume validé vers Batch si un délai cible de 24 heures convient.
FAQ sur les prix de Gemini 3.8 TTS
Combien coûte Gemini Audio TTS ?
Jusqu'au 31 décembre 2026, la sortie audio en Standard coûte $0.009 par minute pour Gemini 3.8 Flash-Lite TTS et $0.0135 par minute pour Gemini 3.8 Flash TTS. Ces montants calculés excluent le texte entrant, les lectures du cache et son stockage.
Combien coûtent 1000 tokens ?
Tout dépend du type de token. En Standard aujourd'hui, 1,000 tokens de texte entrant coûtent $0.0005 avec l'un ou l'autre modèle. Mille tokens de sortie audio coûtent $0.009 avec Flash ou $0.006 avec Flash-Lite et correspondent à 40 secondes d'audio généré. Chaque montant double le 1er janvier 2027.
L'API Google TTS est-elle gratuite ?
Google indique que les entrées, les sorties et le cache de Gemini 3.8 Flash TTS et Flash-Lite TTS sont gratuits dans l'offre gratuite. Aucun quota fixe propre au TTS, en tokens ou en minutes, n'est publié : consultez la limite active dans AI Studio.
Comment utiliser gratuitement un service TTS ?
Créez ou sélectionnez un projet actif dans Google AI Studio, ouvrez l'espace de génération vocale et utilisez l'un des deux modèles Gemini 3.8 TTS dans les limites gratuites du projet. Ne considérez pas cette capacité comme garantie pour une production.
La synthèse vocale est-elle payante ?
Oui, dès que vous utilisez l'offre payante de l'API Gemini. Google facture séparément le texte entrant, la sortie audio, les lectures du cache et son stockage ; la sortie seule en Standard commence actuellement à $0.009 par minute générée.
Quel budget prévoir pour le TTS ?
La sortie audio de Gemini Flash-Lite Standard coûte actuellement $0.54 par heure générée, contre $0.81 avec Flash. Batch et Flex divisent ces montants par deux ; Priority les porte respectivement à $0.972 et $1.458.
Quel est le meilleur logiciel FreeTTS ?
Gemini TTS est une API cloud, pas la bibliothèque logicielle FreeTTS. Pour une évaluation sans frais, l'offre gratuite de Gemini est utile, mais sa page tarifaire publique ne promet aucun nombre précis de minutes gratuites.
Comment activer Google TTS ?
Ouvrez l'espace de génération vocale de Google AI Studio, ou appelez gemini-3.8-flash-tts ou gemini-3.8-flash-lite-tts via l'API Gemini avec un projet actif et une clé d'API.
Gemini 3.8 Flash TTS propose-t-il un tarif étudiant ?
La page tarifaire de l'API Developer de Google n'affiche aucun prix étudiant propre à Gemini TTS. Les étudiants utilisent les mêmes offres gratuites ou payantes que les autres développeurs.
Puis-je obtenir le remboursement de frais Gemini TTS API ?
Selon Google, les fonds inutilisés d'un compte de paiement postpayé associé peuvent être remboursables. Les crédits prépayés Gemini API inutilisés expirent un an après leur achat et ne sont généralement pas remboursables ; les crédits promotionnels sont eux aussi exclus.
Les prix de Gemini 3.8 Flash TTS ont-ils changé en 2026 ?
Les modèles ont été lancés le 23 septembre 2026 avec des tarifs payants de lancement. Ceux-ci s'appliquent jusqu'au 31 décembre et doivent doubler le 1er janvier 2027.
Utilisez la checklist d'audit des workflows IA en entreprise pour décider où intégrer la voix générée avant d'engager un budget de production. Recevez-la avec la newsletter.
- Dernière mise à jour
- 24 sept. 2026
- Catégorie
- Design
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.
Quel logiciel pour créer un patron de frivolité ?
Inkscape, Amaziograph, Affinity ou TattingCAD : comparez les meilleurs outils pour créer un patron de frivolité clair, modifiable et prêt à imprimer.20 sept. 2026Design
Tissage aux cartes : quel logiciel choisir pour créer ses patrons ?
Comparez les meilleurs logiciels de tissage aux cartes pour gérer l’enfilage, les rotations, la torsion, les inversions et l’export de vos patrons.20 sept. 2026Design
Logiciel point de croix : PCStitch ou WinStitch pour convertir une photo ?
PCStitch ou WinStitch pour transformer une photo en grille de point de croix ? Comparatif complet des couleurs, retouches, symboles, PDF et prix.20 sept. 2026Design
Logiciel patchwork gratuit : QuiltAssistant à l’essai
QuiltAssistant transforme photos et blocs en patrons de patchwork. Testez ses outils gratuits, son ancien logiciel Windows et ses limites avant de choisir.20 sept. 2026Design
Logiciel point de croix : le vrai prix de WinStitch
Prix de WinStitch, taxes, bundle Mac, mises à niveau à vie et options : découvrez le coût réel de ce logiciel de point de croix avant de payer.20 sept. 2026Design
Création vidéo IA : ngram ou Demosmith pour une démo produit ?
ngram ou Demosmith : comparez prix, capture, révisions et formats afin de choisir le bon outil de création vidéo IA pour votre démonstration produit.19 sept. 2026Design
Logiciel patron couture : imprimer un patron Seamly2D en A4
Avec Seamly2D, imprimez un patron en A4 ou Letter à l’échelle 100%, contrôlez le carré test, puis assemblez les pages sans fausser les mesures.19 sept. 2026Design