Sintesi vocale Google: prezzi di Gemini 3.8 Flash TTS
Scopri prezzi e costi della sintesi vocale Google con Gemini 3.8 Flash TTS e Flash-Lite: tariffe al minuto, livelli API e rincaro da gennaio 2027.



Per la sintesi vocale Google, i prezzi di Gemini 3.8 Flash TTS partono da $0.0135 per minuto generato con il livello Standard, mentre Flash-Lite costa $0.009 al minuto. Sono tariffe calcolate sul solo output e valide fino al 31 dicembre 2026; Google ne ha previsto il raddoppio il 1 gennaio 2027, quindi un budget di produzione deve già considerare entrambi gli importi.
Gemini 3.8 Flash TTS e Gemini 3.8 Flash-Lite TTS sono stati lanciati il 23 settembre 2026. Ho verificato tutte le tariffe riportate di seguito sulla pagina ufficiale dei prezzi della Gemini Developer API il 24 settembre 2026, quindi ho convertito il parametro documentato da Google di 25 token audio al secondo in minuti e ore di audio generato.
Prezzi della sintesi vocale Google: Gemini 3.8 a colpo d'occhio
La soluzione più economica è Flash-Lite con Batch o Flex: $0.0045 per minuto generato fino al 31 dicembre 2026. Per un flusso di produzione interattivo, la scelta più equilibrata è Flash-Lite Standard a $0.009 al minuto. Conviene passare a Flash completo quando fedeltà, pronunce difficili, copertura dei dialetti o direzione attoriale giustificano la differenza.
Tutti i valori basati sulla durata sono calcoli, non importi rilevati da una fattura. Coprono esclusivamente l'output audio generato. La fattura può includere anche i token di testo in input, le letture dalla cache e l'archiviazione in cache.
Costo di Gemini 3.8 TTS al minuto e all'ora
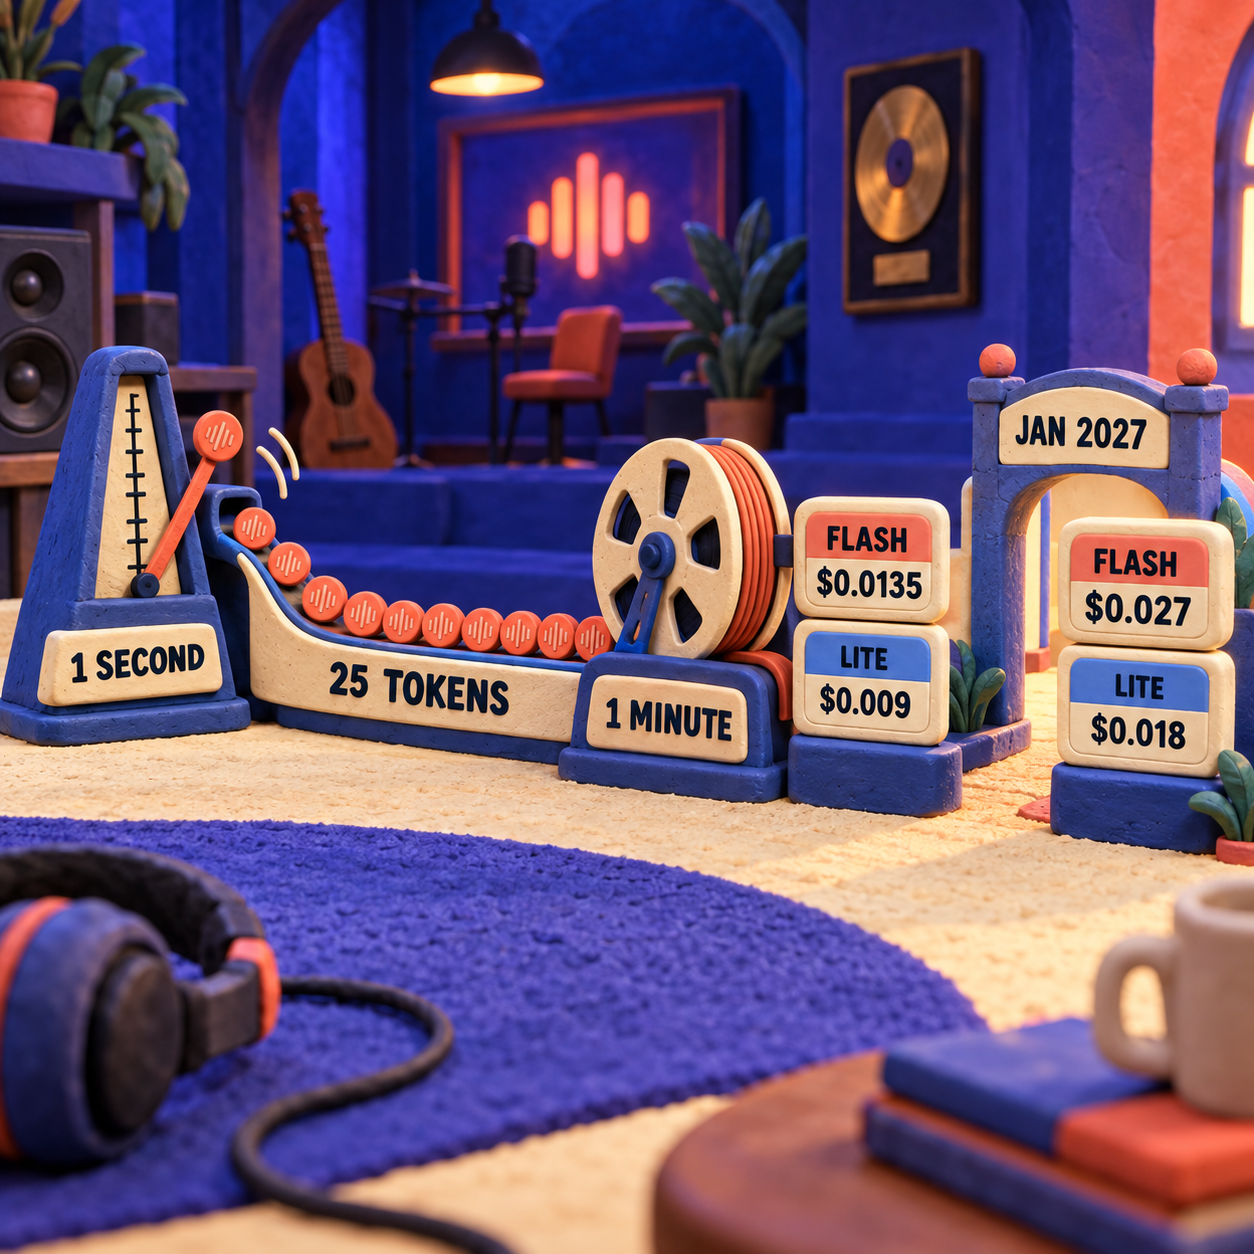
Il calcolo per durata diventa semplice una volta chiarita l'unità di fatturazione: Google conta 25 token audio al secondo, quindi un minuto generato equivale a 1,500 token audio e un'ora a 90,000 token audio.
Per Flash Standard fino al 31 dicembre:
- Un minuto: 1,500 diviso 1,000,000, moltiplicato per $9.00 = $0.0135.
- Un'ora: 90,000 diviso 1,000,000, moltiplicato per $9.00 = $0.81.
- Mille ore generate: $0.81 moltiplicato per 1,000 = $810.
Per Flash-Lite Standard basta sostituire la tariffa audio di $9.00 con $6.00. Il risultato è $0.009 al minuto, $0.54 all'ora e $540 per 1,000 ore. Dal 1 gennaio 2027, gli stessi carichi costeranno $0.018 al minuto, $1.08 all'ora e $1,080 per 1,000 ore.
Il foglio di calcolo riproducibile è questo:
- Output audio: secondi generati moltiplicati per 25, divisi per 1,000,000 e moltiplicati per la tariffa dell'output audio.
- Testo in input: numero effettivo di token in input restituito dalla richiesta, diviso per 1,000,000 e moltiplicato per la tariffa del testo in input.
- Letture dalla cache: token effettivi letti dalla cache, divisi per 1,000,000 e moltiplicati per la tariffa di lettura.
- Archiviazione in cache: token memorizzati moltiplicati per le ore di archiviazione, divisi per 1,000,000 e moltiplicati per la tariffa di storage.
Non stimare i token di testo a partire dalla durata dell'audio: registra il conteggio in input restituito dall'API. Se il record di utilizzo mostra esattamente 1,000,000 di token di testo in input insieme a 100 ore generate con Standard, Flash costa oggi $81.50: $81 per l'audio più $0.50 per il testo. Flash-Lite costa $54.50. Dal 1 gennaio, i totali diventano $163 e $109.
La distinzione conta perché un copione breve può produrre un'interpretazione lenta e ricca di pause, mentre un testo denso può essere letto rapidamente. Google misura separatamente il copione e l'audio risultante.
Prezzi di Gemini Flash-Lite TTS: quando conviene Lite
Flash-Lite vince quando la voce è una componente della produzione, non l'interpretazione principale. La guida Google ai modelli TTS lo propone per produzioni ad alto volume, funzioni di lettura ad alta voce, pipeline di voice agent, replica vocale e parlato quotidiano con un solo speaker. Supporta 101 lingue e utilizza lo stesso schema API di Flash completo.
Flash completo è il livello creativo. Google lo posiziona per la massima fedeltà, una recitazione ricca di sfumature, pronunce difficili, dialetti regionali, dialoghi complessi con più speaker e narrazioni lunghe stabili in 130 lingue. Con Standard, il suo output costa $0.27 in più per ogni ora generata fino al 31 dicembre e $0.54 in più dal 1 gennaio.
La regola decisionale è un difetto che si sente, non il prestigio del modello. Prima esegui lo stesso copione approvato e la stessa direzione vocale con Lite. Se pronuncia, dialetto, interpretazione di un personaggio o una scena lunga non raggiungono lo standard qualitativo, cambia il parametro del modello e rigenera quel segmento con Flash. La struttura dei prompt è condivisa, quindi non servono due sistemi di produzione.
- Il costo grezzo dell'audio generato è abbastanza basso da consentire provini di interi capitoli, corsi o lotti di localizzazione.
- Flash e Flash-Lite condividono lo stesso schema, rendendo pratico il passaggio selettivo al modello superiore.
- Entrambi i modelli supportano le opzioni di consumo Standard, Batch, Flex e Priority.
- Il tariffario separa testo, audio, letture dalla cache e archiviazione, invece di nasconderli dentro crediti generici.
- La pagina pubblica di Google non indica una quota gratuita fissa specifica per TTS.
- Il raddoppio di tutte le tariffe TTS a pagamento elencate è previsto per il 1 gennaio 2027.
- Flex può eliminare richieste e non riuscire quando la capacità è limitata.
- Il costo in token non comprende ascolto umano, editing, mastering e verifica dei diritti necessari per pubblicare l'audio.
Come scegliere tra Standard, Batch, Flex e Priority
Il livello di servizio va scelto in base alla scadenza e alla tolleranza agli errori. È il livello a determinare come viene pianificata e fatturata la stessa richiesta al modello.
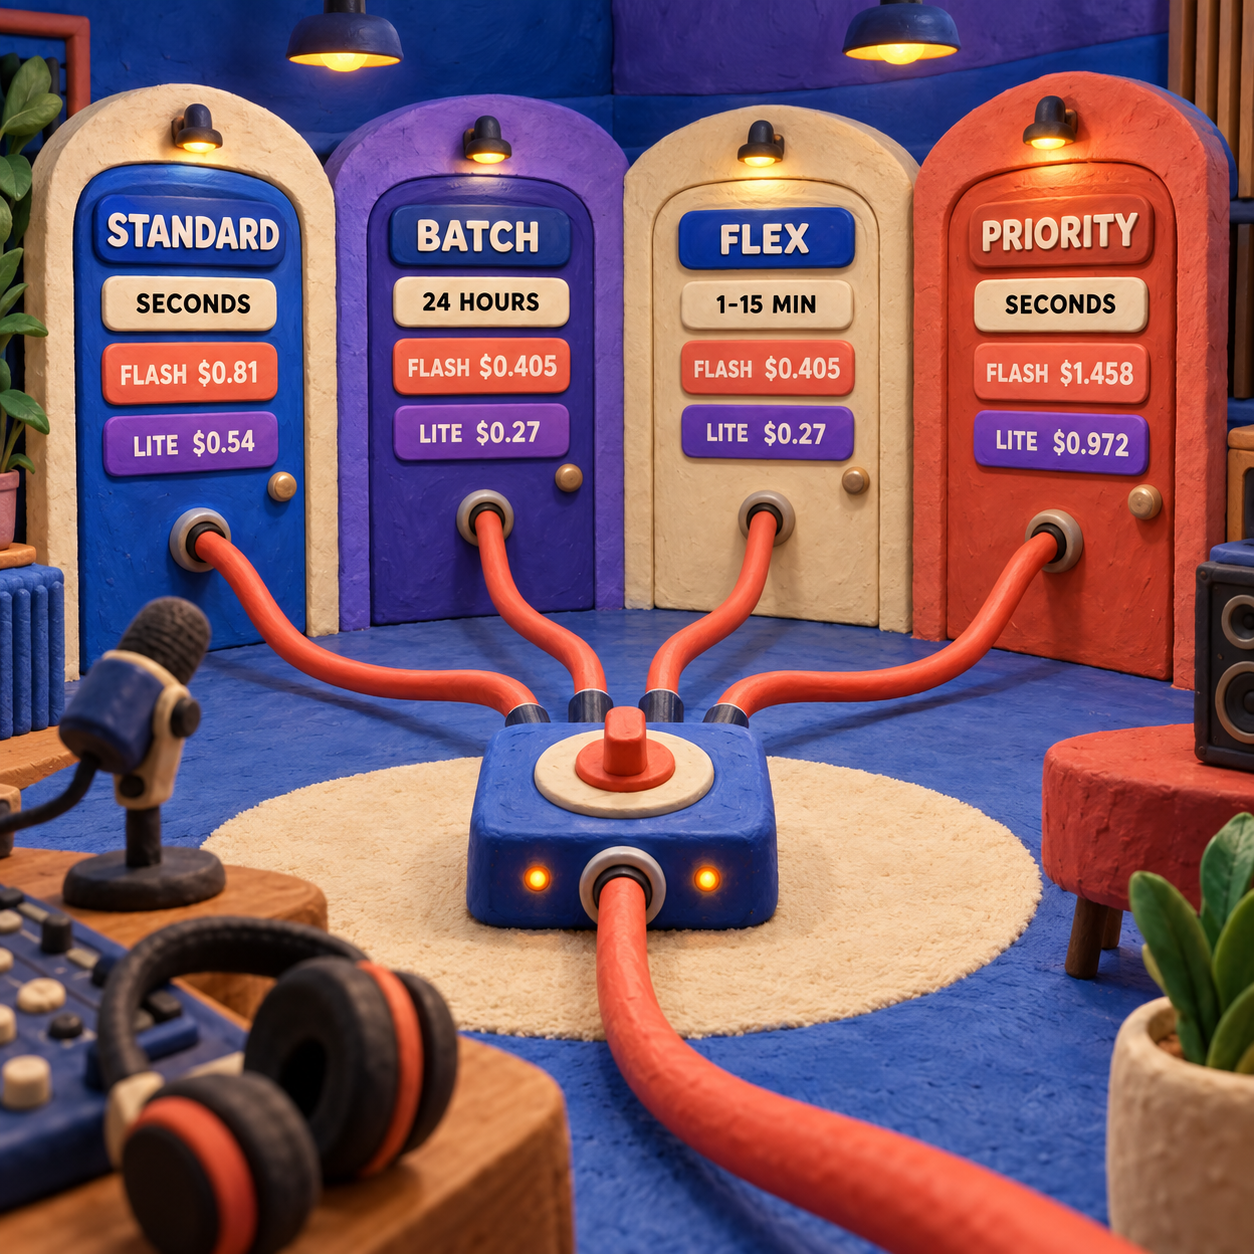
Standard è la scelta predefinita per la produzione quotidiana. È sincrono, normalmente risponde in pochi secondi o minuti e applica la tariffa piena. È adatto a un editor che prova le battute, a un designer che affina la direzione vocale o a un'applicazione che deve rispondere mentre l'utente è ancora presente.
Batch è la soluzione affidabile più economica per una coda che può lavorare durante la notte. Costa la metà di Standard, funziona in modo asincrono e punta a completare il lavoro entro 24 ore. Un editore che genera un audiolibro completato o una piattaforma didattica che rigenera un catalogo dovrebbe partire da qui.
Flex costa quanto Batch, ma resta sincrono. Google indica tempi da 1 a 15 minuti e utilizza capacità best-effort che può essere revocata. Una richiesta può ricevere un errore di capacità e Google non la trasferisce automaticamente a Standard. Flex è adatto a un workflow in background in cui il passaggio successivo richiede la risposta, ma può riprovare più tardi.
Priority serve quando una risposta vocale in ritardo danneggerebbe il prodotto. Instrada il traffico sincrono su capacità a criticità più elevata. Se vengono superati i limiti di Priority, Google può declassare la richiesta a Standard e fatturarla alla tariffa Standard. Nel tariffario TTS attuale, Priority costa 1.8 volte Standard: Flash-Lite passa quindi da $0.54 a $0.972 per ora di output e Flash da $0.81 a $1.458.
Testo in input, audio in output e cache sono voci separate
La componente audio domina la maggior parte delle fatture TTS, ma non esaurisce il costo della generazione vocale.
Costo della Gemini TTS API: le quattro voci in fattura
Il testo in input è la trascrizione. Entrambi i modelli applicano la stessa tariffa Standard: $0.50 per 1 milione di token fino al 31 dicembre, poi $1.00. Batch e Flex la dimezzano. Priority la porta a $0.90 oggi e a $1.80 dal 1 gennaio.
L'audio in output è l'interpretazione generata. È qui che Flash e Flash-Lite si differenziano: con Standard, oggi costano rispettivamente $9 e $6 per 1 milione di token audio, poi $18 e $12.
Le letture dalla cache vengono addebitate quando si riutilizza un input memorizzato. Oggi Standard costa $0.125 per 1 milione di token in cache; Batch $0.0625, Flex $0.025 e Priority $0.225. Ogni importo raddoppia a gennaio.
L'archiviazione in cache dipende dal tempo. Tutti i livelli di servizio indicano $0.50 per 1 milione di token-ora in cache fino al 31 dicembre e $1.00 dal 1 gennaio. Memorizzare 8,000 token per 24 ore costa quindi oggi $0.096. Una lettura Standard dello stesso blocco aggiunge $0.001. Da gennaio, i due importi diventano $0.192 e $0.002.
La cache è utile quando si ripete un ampio contesto di istruzioni o pronunce. Non è automaticamente conveniente per un copione breve e usato una sola volta. Prima di considerare la tariffa di lettura più bassa come un risparmio, calcola la durata dello storage e il numero di accessi previsti.
Questo tariffario non prevede un abbonamento TTS mensile o annuale. L'uso a pagamento dell'API è misurato a consumo: non esiste quindi uno sconto annuale da ottenere né una quota mensile inclusa da superare. Il rischio di lock-in è altrove: i crediti prepagati della Gemini API non utilizzati scadono dopo un anno e, in generale, non sono rimborsabili.
Piano gratuito di Gemini TTS: che cosa dichiara Google
Google indica testo in input, audio in output e context caching come gratuiti nella colonna del piano gratuito per entrambi i modelli Gemini 3.8 TTS. Nella pagina dei prezzi, però, non pubblica una quota di token specifica per TTS né un numero garantito di minuti audio gratuiti.
Il piano gratuito è quindi utile per provare voci, verificare la struttura dei prompt e creare piccoli prototipi, ma non è una base sicura su cui dimensionare un lancio in produzione. Google spiega che i limiti attivi dipendono dal livello d'uso del progetto, sono visibili in AI Studio, cambiano con lo stato dell'account e non sono garantiti. Va controllato il progetto, non copiata una quota trovata in un articolo.
Con la fatturazione cambia anche il compromesso sulla privacy. La pagina dei prezzi di Google afferma che i contenuti del piano gratuito possono essere usati per migliorare i suoi prodotti, mentre quelli del piano a pagamento non vengono impiegati a tale scopo secondo i termini collegati. La decisione va presa prima di caricare nello strumento la voce di un cliente, un copione non ancora pubblicato o un modulo formativo sensibile.
Chi potrebbe non dover mai pagare? Un designer che prova soltanto poche voci e resta entro i limiti attivi del progetto può continuare a usare il piano gratuito. Chiunque prometta volumi, throughput o lavorazioni riservate dovrebbe invece mettere a budget il piano a pagamento, senza trattare una quota non specificata come infrastruttura.
Lo stesso brief vocale, calcolato prima e dopo il rincaro
Una libreria formativa di 100 ore con un solo narratore rende particolarmente chiara la scelta del modello. Con Standard fino al 31 dicembre, il subtotale calcolato per l'output è di $54 con Flash-Lite e $81 con Flash. Dal 1 gennaio diventa rispettivamente $108 e $162. Testo in input, cache ed eventuali rigenerazioni si aggiungono a questi importi.
La prima generazione dovrebbe usare Flash-Lite, perché la maggior parte delle narrazioni ordinarie non richiede il modello di punta per ogni battuta. In revisione, vanno promossi soltanto i passaggi che non superano un controllo qualitativo definito: un nome regionale pronunciato male, una scena emotiva letta senza espressività, un dialogo tra più speaker in cui le voci non restano distinte o un audio lungo in cui cambiano la voce o l'ambiente acustico.
Definisci un brief rappresentativo
Scegli un copione che contenga le difficoltà reali della produzione: nomi, numeri, pause, svolte emotive e, quando serve, più di uno speaker. Mantieni identica la trascrizione per entrambi i modelli.
Imposta correttamente la direzione vocale
Gemini 3.8 TTS tratta il testo della trascrizione come parole da recitare. Inserisci le indicazioni persistenti nei metadati vocali strutturati e riserva i tag inline agli eventi vocali puntuali, evitando così che un'istruzione venga pronunciata per errore.
Prova prima Flash-Lite
Genera un test controllato, quindi salva l'utilizzo dei token in input restituito e la durata effettiva dell'audio. Per questo articolo non è stato generato alcun campione: i dati basati sulla durata restano quindi costi calcolati sul solo output, non importi misurati in fattura.
Passa a Flash solo per i segmenti non riusciti
Conserva l'output Lite che supera il controllo. Cambia il parametro del modello in Flash per i passaggi che non soddisfano i requisiti di pronuncia, dialetto, recitazione, separazione degli speaker o coerenza sulle lunghe durate.
Scegli la coda
Usa Standard mentre interviene una persona. Invia a Batch il lavoro arretrato già approvato, scegli Flex soltanto se hai previsto la gestione dei nuovi tentativi e acquista Priority esclusivamente quando l'attesa compromette l'esperienza utente.
Non confondere TTS con Gemini Live o Flash solo testo
Gemini 3.8 Flash TTS riceve testo e restituisce un'interpretazione audio. Il modello generico gemini-3.8-flash è un endpoint diverso con un tariffario distinto: i consueti prezzi di input e output del modello testuale non vanno usati per stimare TTS. L'analisi più ampia dei prezzi di Gemini spiega la separazione tra piani consumer e fatturazione della Developer API, mentre la recensione di Gemini 3 esamina la famiglia di modelli generici.
Anche Gemini Live è un'altra cosa. La guida Google alla generazione vocale descrive TTS come recitazione fedele del testo, con stile e suono controllati; Live gestisce invece audio interattivo non strutturato e conversazioni multimodali. Un corso narrato, un audiolibro o un copione pubblicitario approvato richiedono TTS. Un voice agent che ascolta, ragiona, chiama un tool e mantiene coinvolta la persona al telefono usa un workflow Live con un modello di costo diverso. L'analisi del workflow Live di Gemini 3.8 chiarisce questa scelta operativa.
Capire la differenza evita l'errore più costoso in un foglio di calcolo: usare una tariffa economica per i token di testo per preventivare il parlato generato, oppure applicare il prezzo dell'output TTS a una sessione Live persistente.
Gemini TTS a confronto con ElevenLabs e Deepgram
Alle tariffe Standard introduttive, Gemini costa meno per durata grezza generata rispetto a due alternative API molto diffuse. Le unità di misura, però, non coincidono e il prezzo non dimostra la qualità della voce.
I prezzi delle API ElevenLabs indicano $0.05 per 1,000 caratteri per Flash/Turbo e v3 Conversational, presentandoli come circa $0.05 al minuto o $3 all'ora. Il modello creativo v3 costa circa $0.10 al minuto, cioè $6 all'ora. Rispetto a quella stima pubblicata al minuto, Gemini Flash-Lite Standard costa oggi $0.54 all'ora e Flash $0.81.
Deepgram misura Aura-2 a $0.030 per 1,000 caratteri e Aura-1 a $0.015. Assumendo esplicitamente, ai soli fini della pianificazione, 1,000 caratteri per ogni minuto parlato, i valori normalizzati sono circa $1.80 e $0.90 all'ora. Il punto debole è proprio l'ipotesi: velocità del parlato, pause e audio non verbale modificano la durata, mentre Deepgram continua a fatturare i caratteri.
Il confronto corretto è un provino a pagamento sul proprio copione. Normalizza i fornitori sulla stessa ora approvata, includi le prove scartate e valuta pronuncia, interpretazione, coerenza, latenza e tempo di editing. Il vantaggio grezzo di Gemini sui token è rilevante, ma una voce più economica che richiede più revisioni non rende più economica la produzione.
Costi nascosti e come preparare il budget per gennaio 2027
La variazione tariffaria programmata è il vero rischio di budget. Un arretrato di 1,000 ore con Flash-Lite Standard costa $540 di output audio calcolato se viene completato entro il 31 dicembre e $1,080 dal 1 gennaio. Flash passa da $810 a $1,620. Dopo l'aumento, Batch o Flex avranno lo stesso subtotale di output che Standard ha oggi.
Gli altri costi sono operativi:
- Rigenerazione: le prove scartate producono altro output audio fatturabile.
- Controllo qualità umano: ogni nome proprio, numero, voce soggetta a consenso e montaggio finale richiede una verifica.
- Archiviazione in cache: un contesto salvato continua a essere fatturato per token-ora finché non viene rilasciato.
- Scadenza del prepagato: i crediti prepagati della Gemini API non utilizzati scadono dopo un anno e, in generale, non sono rimborsabili. I fondi postpagati non utilizzati possono essere rimborsabili, ma i crediti promozionali sono esclusi.
- Separazione dall'applicazione: un abbonamento consumer a Gemini non rende TTS incluso nella Developer API.
La mossa concreta da fare lunedì è questa: esegui un'ora rappresentativa con Flash-Lite Standard, salva l'utilizzo effettivo del testo in input e la durata dell'output, segnala ogni segmento che non supera la soglia qualitativa e rigenera con Flash soltanto quei passaggi. Inserisci il mix risultante in due colonne di budget, una con le tariffe attuali e l'altra con quelle di gennaio. Poi sposta il lavoro arretrato già approvato su Batch, se l'obiettivo di 24 ore è accettabile.
FAQ sui prezzi di Gemini 3.8 TTS
Quanto costa Gemini Audio TTS?
Fino al 31 dicembre 2026, l'output audio Standard costa $0.009 al minuto per Gemini 3.8 Flash-Lite TTS e $0.0135 al minuto per Gemini 3.8 Flash TTS. Questi valori calcolati non includono testo in input, letture dalla cache e archiviazione in cache.
Quanto costano 1000 token?
Dipende dal tipo di token. Oggi, con Standard, 1,000 token di testo in input costano $0.0005 per entrambi i modelli. Mille token audio in output costano $0.009 con Flash o $0.006 con Flash-Lite e corrispondono a 40 secondi di audio generato. Ogni importo raddoppia il 1 gennaio 2027.
L'API Google TTS è gratuita?
Google indica input, output e cache di Gemini 3.8 Flash TTS e Flash-Lite TTS come gratuiti nel piano gratuito. Non pubblica una quota fissa di token o minuti specifica per TTS, quindi occorre controllare il limite attivo in AI Studio.
Come si può usare il TTS gratis?
Crea o seleziona un progetto attivo in Google AI Studio, apri l'area di generazione vocale e utilizza uno dei due modelli Gemini 3.8 TTS entro i limiti gratuiti del progetto. Non dare per scontato che la capacità gratuita sia garantita per la produzione.
Il TTS è a pagamento?
Sì, quando si usa il livello a pagamento della Gemini API. Google fattura separatamente testo in input, audio in output, letture dalla cache e archiviazione in cache; le tariffe Standard per il solo output partono attualmente da $0.009 per minuto generato.
Quanto costa il TTS?
L'output audio di Gemini Flash-Lite Standard costa attualmente $0.54 per ora generata, mentre Flash costa $0.81. Batch e Flex dimezzano questi importi; Priority li porta rispettivamente a $0.972 e $1.458.
Qual è il miglior software FreeTTS?
Gemini TTS è un'API cloud, non la libreria software FreeTTS. Se l'obiettivo è una valutazione a costo zero, il piano gratuito di Gemini è utile, ma la pagina pubblica dei prezzi non promette un numero preciso di minuti gratuiti.
Come si attiva Google TTS?
Apri l'area di generazione vocale di Google AI Studio oppure chiama gemini-3.8-flash-tts o gemini-3.8-flash-lite-tts tramite la Gemini API con un progetto attivo e una chiave API.
Gemini 3.8 Flash TTS prevede uno sconto studenti?
La pagina dei prezzi della Developer API di Google non indica tariffe specifiche per studenti per Gemini TTS. Gli studenti usano gli stessi livelli API gratuiti o a pagamento previsti per tutti gli sviluppatori.
Posso ottenere il rimborso degli addebiti della Gemini TTS API?
Google afferma che i fondi non utilizzati in un account di pagamento postpagato collegato possono essere rimborsabili. I crediti prepagati della Gemini API non utilizzati scadono un anno dopo l'acquisto e, in generale, non sono rimborsabili; anche i crediti promozionali sono esclusi.
I prezzi di Gemini 3.8 Flash TTS sono cambiati nel 2026?
I modelli sono stati lanciati il 23 settembre 2026 con tariffe a pagamento introduttive. Queste tariffe si applicano fino al 31 dicembre e raddoppieranno, come previsto, il 1 gennaio 2027.
Usa la checklist di audit dei workflow AI per decidere dove inserire la voce generata prima di impegnare un budget di produzione. Ricevila con la newsletter.
- Ultimo aggiornamento
- 24 set 2026
- Categoria
- Design
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Tatting design software: i migliori programmi per schemi di chiacchierino
Scopri quale software usare per creare schemi di chiacchierino modificabili, dai bozzetti simmetrici ai file SVG e PDF pronti per la stampa.20 set 2026Design
Software per tessitura a tavolette: quale scegliere
Confronto tra TDD, Twisted Threads, GTT e SeiZenn per scegliere il software per tessitura a tavolette più adatto a schemi, rotazioni ed export.20 set 2026Design
PCStitch o WinStitch: quale converte meglio le foto?
PCStitch o WinStitch per trasformare una foto in uno schema a punto croce? Confronto su colori, pulizia, simboli, PDF, prezzi e prove gratuite.20 set 2026Design
Software per quilting: QuiltAssistant alla prova
QuiltAssistant trasforma foto in blocchi e cartamodelli da cucire. La prova mostra come funziona, cosa offre gratis e quali limiti valutare prima dell'uso.20 set 2026Design
Programma per creare schemi punto croce: quanto costa WinStitch
Quanto costa WinStitch nel 2026? Prezzi verificati, extra al checkout, licenza, demo gratuita, upgrade a vita e confronto con le alternative.20 set 2026Design
Demo software: ngram o Demosmith per i video di prodotto?
Confronto tra ngram e Demosmith per creare demo software: prezzi, acquisizione del prodotto, revisioni, formati di esportazione e limiti reali.19 set 2026Design
Stampare cartamodelli PDF con Seamly2D: guida A4 e Letter
Scopri come stampare cartamodelli PDF da Seamly2D su fogli A4 o Letter, impostare la scala al 100% e verificare il quadrato di controllo prima del taglio.19 set 2026Design