Gemini TTS: preços do Gemini 3.8 Flash e Flash-Lite por minuto
Veja quanto custa o Gemini TTS por minuto, compare Flash e Flash-Lite em cada modalidade e prepare o orçamento para o reajuste de janeiro de 2027.



O preço do Gemini TTS começa em $0.0135 por minuto gerado no Standard com o Gemini 3.8 Flash TTS, enquanto o Flash-Lite custa $0.009 por minuto. Esses valores consideram apenas a saída e valem até 31 de dezembro de 2026. A Google prevê dobrá-los em 1 de janeiro de 2027, então um orçamento de produção já precisa contemplar os dois cenários.
O Gemini 3.8 Flash TTS e o Gemini 3.8 Flash-Lite TTS foram lançados em 23 de setembro de 2026. Conferi cada tarifa abaixo na página oficial de preços da Gemini Developer API em 24 de setembro de 2026 e, depois, converti a regra documentada pela Google de 25 tokens de áudio por segundo em minutos e horas gerados.
Preços do Gemini 3.8 TTS em resumo
A opção mais barata é o Flash-Lite no Batch ou no Flex: $0.0045 por minuto gerado até 31 de dezembro de 2026. Para um fluxo de produção interativo, o ponto de partida mais sensato é o Flash-Lite Standard, a $0.009 por minuto. O Flash completo só compensa quando fidelidade, pronúncias difíceis, variedade de dialetos ou direção de atuação justificam a diferença.
Todos os valores por duração da tabela são cálculos, não medições de uma fatura real. Eles cobrem apenas a saída de áudio gerada. A cobrança também pode incluir tokens de texto na entrada, leituras de cache e armazenamento em cache.
Quanto custa o Gemini TTS por minuto e por hora na versão 3.8
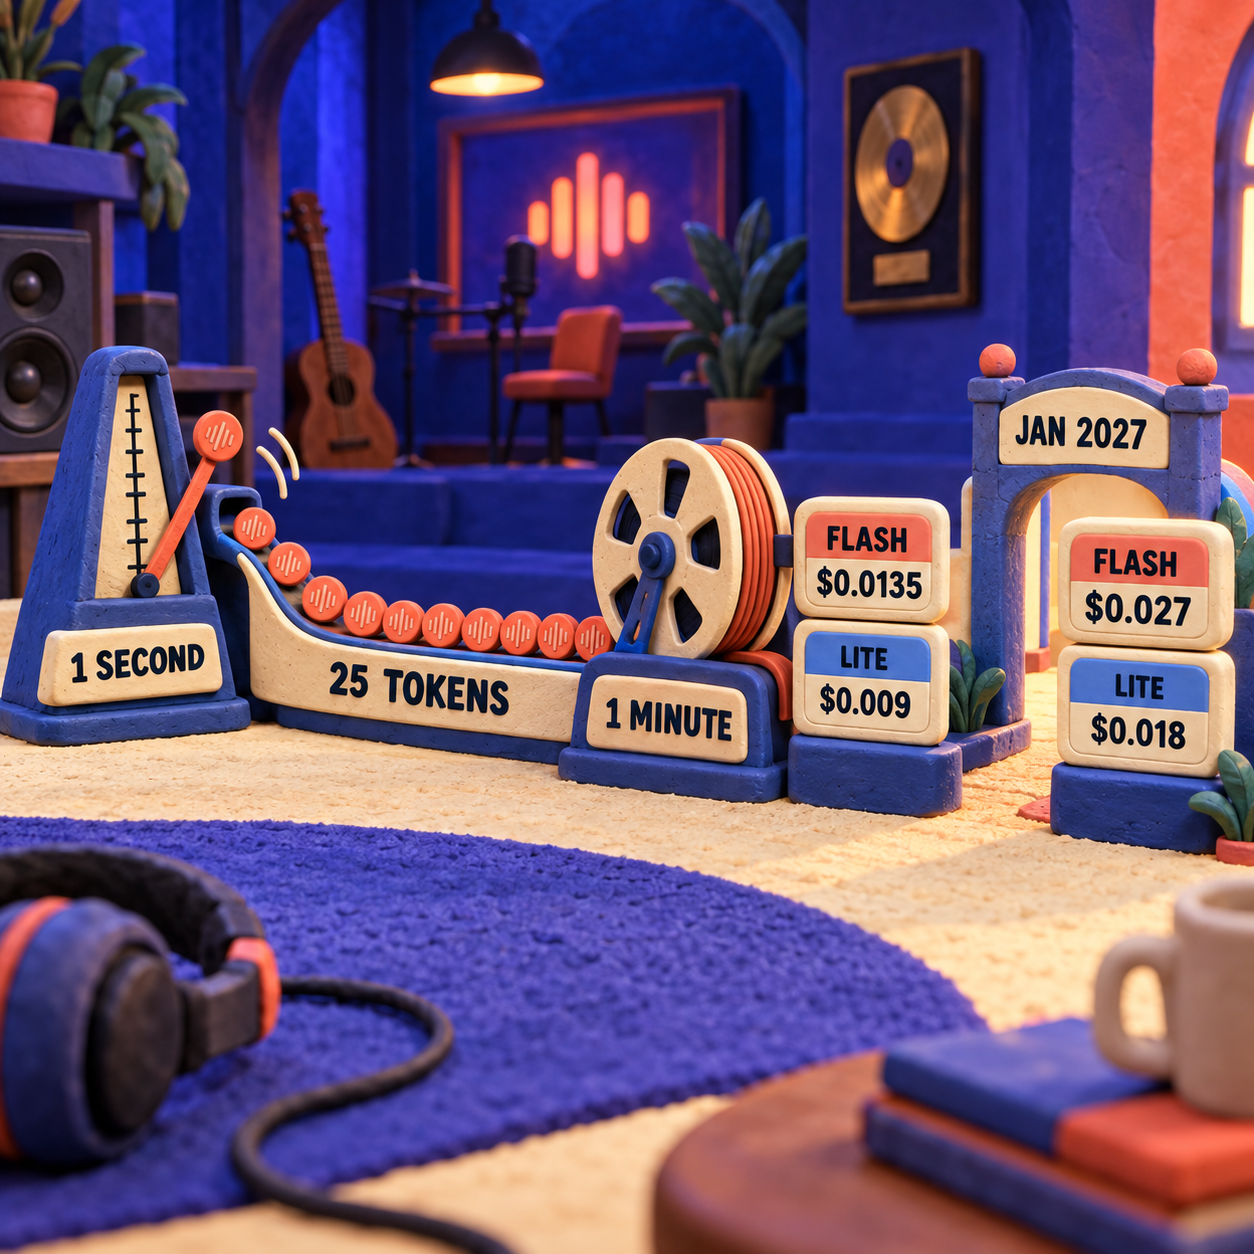
A conta por duração fica simples quando a unidade de cobrança aparece: a Google contabiliza 25 tokens de áudio por segundo. Assim, um minuto gerado corresponde a 1,500 tokens de áudio, e uma hora, a 90,000 tokens.
Para o Flash Standard até 31 de dezembro:
- Um minuto: 1,500 dividido por 1,000,000, multiplicado por $9.00 = $0.0135.
- Uma hora: 90,000 dividido por 1,000,000, multiplicado por $9.00 = $0.81.
- Mil horas geradas: $0.81 multiplicado por 1,000 = $810.
No Flash-Lite Standard, basta trocar a tarifa de áudio de $9.00 por $6.00. O resultado é $0.009 por minuto, $0.54 por hora e $540 por 1,000 horas. A partir de 1 de janeiro de 2027, as mesmas cargas passam a custar $0.018 por minuto, $1.08 por hora e $1,080 por 1,000 horas.
Esta é a planilha reproduzível:
- Saída de áudio: segundos gerados multiplicados por 25, divididos por 1,000,000 e multiplicados pela tarifa de saída de áudio.
- Entrada de texto: contagem real de tokens de entrada retornada pela solicitação, dividida por 1,000,000 e multiplicada pela tarifa de entrada de texto.
- Leituras de cache: tokens de entrada efetivamente lidos do cache, divididos por 1,000,000 e multiplicados pela tarifa de leitura.
- Armazenamento em cache: tokens armazenados multiplicados pelas horas de armazenamento, divididos por 1,000,000 e multiplicados pela tarifa de armazenamento.
Não estime os tokens de texto pela duração do áudio. Registre a contagem de entrada devolvida pela API. Se o registro de uso mostrar exatamente 1,000,000 tokens de texto na entrada e 100 horas geradas no Standard, o Flash custa $81.50 hoje: $81 de áudio mais $0.50 de texto. No Flash-Lite, o total é $54.50. A partir de 1 de janeiro, esses totais passam a $163 e $109.
Essa separação importa porque um roteiro curto pode resultar em uma interpretação lenta e cheia de pausas, enquanto um texto denso pode ser lido depressa. A Google mede o roteiro e o áudio resultante de forma independente.
Preço do Gemini Flash-Lite TTS: quando o Lite vale mais
O Flash-Lite leva vantagem quando a voz é um componente da produção, não a atração principal. O guia de modelos TTS da Google o posiciona para produção em grande escala, recursos de leitura em voz alta, cascatas de agentes de voz, replicação de voz e falas cotidianas com um único locutor. Ele oferece suporte a 101 idiomas e usa o mesmo esquema de API do Flash completo.
O Flash completo é a opção criativa. A Google o apresenta como a escolha para fidelidade máxima, atuação com nuances, pronúncias difíceis, dialetos regionais, diálogos complexos com vários locutores e narração longa e estável em 130 idiomas. Até 31 de dezembro, a saída Standard custa $0.27 a mais por hora gerada que no Lite; a diferença sobe para $0.54 a partir de 1 de janeiro.
A regra de decisão é uma falha audível, não o prestígio do modelo. Rode primeiro no Lite o mesmo roteiro aprovado, com a mesma direção de voz. Se pronúncia, dialeto, interpretação de personagem ou uma cena longa não atingirem o padrão desejado, altere o parâmetro do modelo e refaça apenas esse trecho no Flash. Como a estrutura de prompts é compartilhada, não é necessário manter dois sistemas de produção.
- O custo bruto do áudio gerado é baixo o bastante para testar capítulos, cursos ou lotes de localização completos.
- Flash e Flash-Lite usam o mesmo esquema, o que torna prática a troca seletiva de modelo.
- Os dois modelos oferecem as modalidades Standard, Batch, Flex e Priority.
- A tabela separa texto, áudio, leituras de cache e armazenamento em vez de esconder tudo em créditos.
- A página pública da Google não informa uma franquia gratuita específica e fixa para TTS.
- Todas as tarifas pagas de TTS listadas estão programadas para dobrar em 1 de janeiro de 2027.
- O Flex opera com capacidade descartável e pode falhar quando há pouco recurso disponível.
- O custo de tokens não inclui a escuta humana, edição, masterização e análise de direitos necessárias para publicar o áudio.
Como escolher entre Standard, Batch, Flex e Priority
Escolha a modalidade de serviço pelo prazo e pela tolerância a falhas. É ela que muda a forma de agendar e cobrar a mesma solicitação ao modelo.
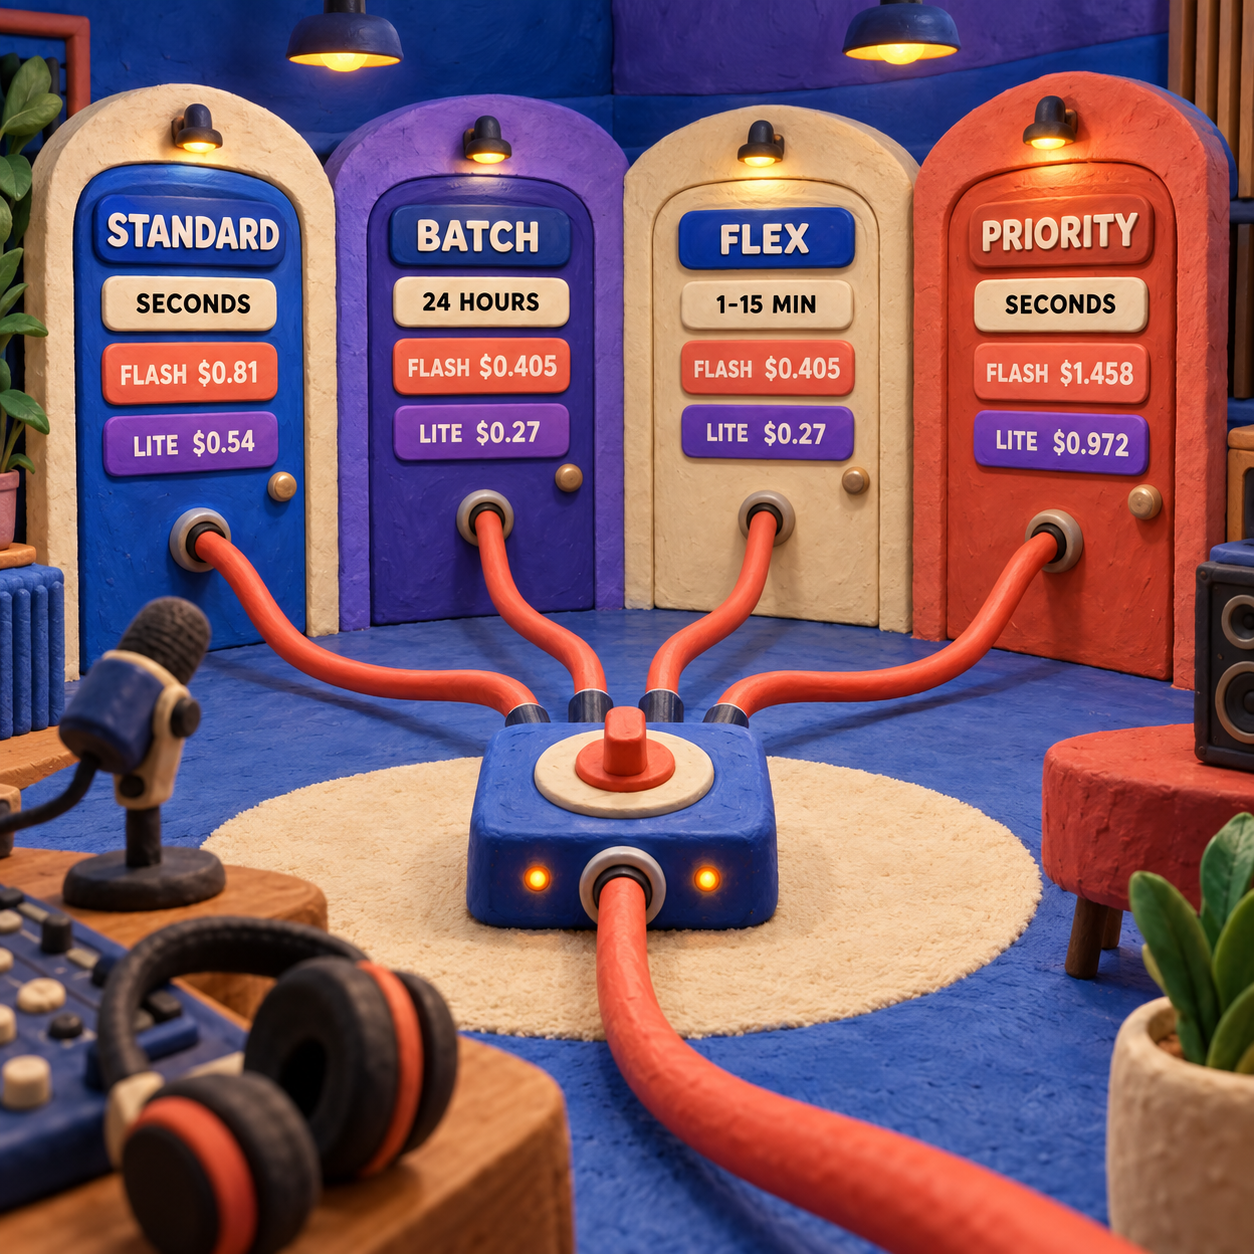
O Standard é a opção padrão para a produção cotidiana. Ele funciona de forma síncrona, normalmente responde em segundos ou minutos e cobra a tarifa integral. Use-o quando um editor estiver testando falas, um designer estiver ajustando a direção de voz ou um aplicativo precisar responder enquanto o usuário ainda estiver presente.
O Batch é o caminho confiável mais barato para uma fila que pode rodar durante a noite. Ele custa metade do Standard, funciona de forma assíncrona e tem prazo-alvo de até 24 horas. Uma editora gerando um audiolivro com o conteúdo já finalizado ou uma plataforma de ensino regenerando seu catálogo deveria começar por aqui.
O Flex custa o mesmo que o Batch, mas continua síncrono. A meta da Google é de 1 a 15 minutos, com capacidade de melhor esforço sujeita a cortes. A solicitação pode receber um erro de capacidade, e a Google não fará uma migração silenciosa para Standard. Flex serve para um fluxo em segundo plano cuja próxima etapa depende da resposta, mas pode tentar novamente mais tarde.
O Priority é indicado quando atrasar uma resposta de voz prejudica o produto. O tráfego síncrono passa por uma capacidade de maior criticidade. Se os limites do Priority forem excedidos, a Google pode rebaixar a solicitação para Standard e cobrar a tarifa do Standard. Na tabela atual de TTS, o Priority custa 1.8 vezes o Standard: por isso, o Flash-Lite sobe de $0.54 para $0.972 por hora de saída, e o Flash, de $0.81 para $1.458.
Entrada de texto, saída de áudio e cache são cobranças separadas
A linha do áudio domina a maioria das faturas de TTS, mas não representa toda a conta da geração de voz.
Custo da API Gemini TTS: as quatro partes da fatura
Entrada de texto é a transcrição. Os dois modelos usam a mesma tarifa Standard: $0.50 por 1 milhão de tokens até 31 de dezembro e $1.00 depois. Batch e Flex reduzem esse valor pela metade. Priority o eleva para $0.90 agora e $1.80 a partir de 1 de janeiro.
Saída de áudio é a interpretação gerada. É aqui que Flash e Flash-Lite se separam: no Standard, as tarifas atuais são $9 e $6 por 1 milhão de tokens de áudio e depois passam a $18 e $12.
Leituras de cache são cobradas quando uma entrada armazenada é reutilizada. No Standard, a tarifa atual é $0.125 por 1 milhão de tokens em cache; no Batch, $0.0625; no Flex, $0.025; e no Priority, $0.225. Todos os valores dobram em janeiro.
Armazenamento em cache é cobrado por tempo. Todas as modalidades listam $0.50 por 1 milhão de tokens-hora armazenados até 31 de dezembro e $1.00 a partir de 1 de janeiro. Manter 8,000 tokens em cache por 24 horas custa, portanto, $0.096 hoje. Uma leitura Standard desse bloco acrescenta $0.001. Em janeiro, os dois valores passam a $0.192 e $0.002.
O cache ajuda quando um bloco relevante de instruções ou contexto de pronúncia se repete. Para um roteiro curto e único, ele não traz economia automaticamente. Calcule o tempo de armazenamento e o número esperado de acessos antes de tratar a leitura mais barata como redução de custo.
Essa tabela não oferece assinatura mensal ou anual de TTS. O uso pago da API é medido, portanto não há desconto anual a conquistar nem franquia mensal incluída a ultrapassar. O risco de dependência aparece em outro ponto: créditos pré-pagos não utilizados da Gemini API expiram após um ano e, em geral, não são reembolsáveis.
O Gemini TTS tem plano gratuito?
A Google marca entrada de texto, saída de áudio e cache como gratuitos na coluna do plano gratuito para os dois modelos Gemini 3.8 TTS. A página de preços não publica uma franquia específica de tokens de TTS nem garante determinada quantidade de minutos de áudio grátis.
Isso torna o plano gratuito útil para testar vozes, conferir a estrutura do prompt e criar protótipos pequenos, mas arriscado como plano de capacidade para um lançamento em produção. Segundo a Google, os limites ativos dependem da faixa de uso do projeto, aparecem dentro do AI Studio, mudam com o status da conta e não são garantidos. Consulte o projeto em vez de copiar uma cota publicada em um blog.
A condição de privacidade também muda com a cobrança. A página de preços da Google informa que o conteúdo do plano gratuito pode ser usado para melhorar seus produtos, enquanto o conteúdo do plano pago não é usado para esse fim segundo os termos vinculados. A decisão precisa considerar a voz de um cliente, um roteiro ainda não lançado ou um módulo de treinamento sensível antes que esse material entre na ferramenta.
Quem pode ficar sem pagar? Um designer que apenas testa algumas vozes e permanece dentro dos limites ativos do projeto talvez continue no plano gratuito. Já quem promete volume de entrega, capacidade de processamento ou produção confidencial deve orçar o plano pago, em vez de tratar uma franquia não especificada como infraestrutura.
O mesmo briefing de voz antes e depois do reajuste
Uma biblioteca de treinamento com 100 horas e um único narrador mostra com clareza o impacto da escolha do modelo. No Standard até 31 de dezembro, o subtotal calculado da saída é $54 no Flash-Lite e $81 no Flash. A partir de 1 de janeiro, passa a $108 e $162. Entrada de texto, cache e novas gerações são cobrados à parte.
A primeira versão deve usar Flash-Lite, pois a maior parte da narração rotineira não precisa do modelo principal em cada frase. Na revisão, promova somente o conteúdo que falhar em um critério técnico definido: nome regional pronunciado incorretamente, cena emotiva sem vida, conversa com vários locutores sem separação ou áudio longo cuja voz ou ambiência varie.
Defina um briefing representativo
Escolha um roteiro que reúna as dificuldades reais da produção: nomes, números, pausas, viradas emocionais e mais de um locutor, quando for relevante. Mantenha a transcrição idêntica nos dois modelos.
Oriente a interpretação do jeito certo
O Gemini 3.8 TTS trata o texto da transcrição como palavras que devem ser faladas. Coloque orientações contínuas nos metadados estruturados de fala e reserve as tags inline para eventos vocais pontuais, evitando que uma instrução seja lida em voz alta por engano.
Teste primeiro no Flash-Lite
Gere um piloto controlado e salve o consumo de tokens de entrada retornado e a duração real do áudio. Este artigo não gerou uma amostra, então os valores por duração continuam sendo custos calculados apenas para a saída, e não medições de fatura.
Leve ao Flash apenas os trechos reprovados
Mantenha a saída aceitável do Lite. Troque o parâmetro do modelo para Flash nos trechos que não atingirem o padrão de pronúncia, dialeto, atuação, separação de locutores ou consistência em conteúdos longos.
Escolha a fila
Use Standard enquanto houver direção humana. Envie o volume já aprovado para Batch, escolha Flex somente com lógica de novas tentativas e compre Priority apenas quando a espera prejudicar a experiência do usuário.
Não confunda TTS com Gemini Live ou Flash somente de texto
O Gemini 3.8 Flash TTS recebe texto e devolve uma interpretação em áudio. O modelo geral gemini-3.8-flash usa outro endpoint e outra tabela de preços; por isso, os valores conhecidos de entrada e saída do modelo de texto não servem para estimar TTS. O panorama mais amplo de preços do Gemini explica por que planos para consumidores e cobranças da Developer API são separados, enquanto a análise do Gemini 3 aborda a família geral de modelos.
O Gemini Live é outra categoria. O guia de voz da Google descreve TTS como recitação exata, com controle de estilo e som, enquanto o Live cuida de áudio interativo não estruturado e conversas multimodais. Curso narrado, audiolivro ou roteiro publicitário aprovado são casos de TTS. Um agente de voz que escuta, raciocina, aciona uma ferramenta e mantém o interlocutor engajado usa um fluxo Live, com outro modelo de custo. A análise do fluxo Gemini 3.8 Live explica essa decisão operacional.
Essa distinção evita o erro mais caro em uma planilha: usar um valor baixo de tokens de texto para orçar fala gerada ou aplicar a tarifa de saída de TTS a uma sessão ao vivo persistente.
Gemini TTS versus ElevenLabs e Deepgram
O Gemini custa menos por duração bruta gerada do que duas APIs frequentemente comparadas nas tarifas introdutórias do Standard. Ainda assim, as unidades de medição não são iguais, e preço não comprova qualidade de voz.
Os preços da API da ElevenLabs apresentam Flash/Turbo e v3 Conversational a $0.05 por 1,000 caracteres e estimam cerca de $0.05 por minuto, ou aproximadamente $3 por hora. O modelo criativo v3 fica em cerca de $0.10 por minuto, ou $6 por hora. Contra essa estimativa publicada por minuto, o Gemini Flash-Lite Standard custa $0.54 por hora hoje, e o Flash, $0.81.
A tabela da Deepgram cobra o Aura-2 a $0.030 por 1,000 caracteres e o Aura-1 a $0.015. Com a premissa explícita de planejamento de 1,000 caracteres por minuto falado, os valores normalizados ficam em torno de $1.80 e $0.90 por hora. A fragilidade está nessa premissa: velocidade de fala, pausas e sons não verbais mudam a duração, mas a Deepgram continua cobrando por caracteres.
A comparação correta exige um teste pago com o seu próprio roteiro. Normalize os fornecedores pela mesma hora aprovada, inclua as versões descartadas e avalie pronúncia, interpretação, consistência, latência e tempo de edição. A vantagem bruta do Gemini em tokens é relevante, mas uma voz mais barata que exige mais retrabalho não reduz o custo final da produção.
Custos ocultos e a mudança no orçamento de janeiro de 2027
O reajuste programado é o principal risco orçamentário. Um volume de 1,000 horas no Flash-Lite Standard custa $540 em saída de áudio calculada se for concluído até 31 de dezembro e $1,080 a partir de 1 de janeiro. No Flash, o valor passa de $810 para $1,620. Depois do aumento, Batch ou Flex terão o mesmo subtotal de saída que o Standard cobra hoje.
Os demais custos são operacionais:
- Nova geração: versões rejeitadas produzem mais saída de áudio cobrável.
- Controle de qualidade humano: todo nome próprio, número, voz sujeita a consentimento e edição final precisa ser revisado.
- Armazenamento em cache: um contexto salvo continua sendo cobrado por token-hora até ser liberado.
- Validade do pré-pago: créditos pré-pagos não utilizados da Gemini API expiram após um ano e, em geral, não são reembolsáveis. Valores pós-pagos não utilizados podem se qualificar para reembolso, mas créditos promocionais ficam de fora.
- Separação entre produtos: uma assinatura do Gemini para consumidores não transforma o TTS da Developer API em recurso incluído.
A ação para segunda-feira é objetiva: rode uma hora representativa no Flash-Lite Standard, salve o consumo real de texto na entrada e a duração da saída, marque cada trecho que não atingir o padrão técnico e refaça somente esses trechos no Flash. Coloque essa combinação em duas colunas de orçamento, uma com as tarifas de hoje e outra com as de janeiro. Depois, envie o volume aprovado para Batch se o prazo-alvo de 24 horas for aceitável.
Perguntas frequentes sobre preços do Gemini 3.8 TTS
Quanto custa o Gemini TTS?
Até 31 de dezembro de 2026, a saída de áudio Standard custa $0.009 por minuto no Gemini 3.8 Flash-Lite TTS e $0.0135 por minuto no Gemini 3.8 Flash TTS. Esses valores calculados não incluem entrada de texto, leituras de cache nem armazenamento em cache.
Quanto custam 1000 tokens?
O tipo de token faz diferença. No Standard hoje, 1,000 tokens de texto na entrada custam $0.0005 em qualquer um dos modelos. Já mil tokens de áudio na saída custam $0.009 no Flash ou $0.006 no Flash-Lite e correspondem a 40 segundos de áudio gerado. Todos os valores dobram em 1 de janeiro de 2027.
A API Google TTS é gratuita?
A Google classifica entrada, saída e cache do Gemini 3.8 Flash TTS e do Flash-Lite TTS como gratuitos no plano gratuito. Como não publica uma cota fixa de tokens ou minutos específica para TTS, consulte o limite ativo no AI Studio.
Como usar TTS de graça?
Crie ou selecione um projeto ativo no Google AI Studio, abra o espaço de geração de voz e use um dos dois modelos Gemini 3.8 TTS dentro dos limites gratuitos do projeto. Não presuma que essa capacidade gratuita seja garantida para produção.
TTS é pago?
Sim, quando o plano pago da Gemini API é usado. A Google cobra separadamente pela entrada de texto, saída de áudio, leituras de cache e armazenamento em cache; as tarifas Standard que consideram apenas a saída começam hoje em $0.009 por minuto gerado.
Quanto custa gerar voz com TTS?
Hoje, a saída de áudio no Gemini Flash-Lite Standard custa $0.54 por hora gerada; no Flash, custa $0.81. Batch e Flex reduzem esses valores pela metade, enquanto Priority os eleva para $0.972 e $1.458.
Qual é o melhor software FreeTTS?
O Gemini TTS é uma API na nuvem, não a biblioteca de software FreeTTS. Para uma avaliação sem custo, o plano gratuito do Gemini é útil, mas sua página pública de preços não promete uma quantidade específica de minutos grátis.
Como ativar o Google TTS?
Abra o espaço de geração de voz no Google AI Studio ou chame gemini-3.8-flash-tts ou gemini-3.8-flash-lite-tts pela Gemini API, usando um projeto ativo e uma chave de API.
O Gemini 3.8 Flash TTS tem desconto para estudantes?
A página de preços da Developer API da Google não lista uma tarifa específica para estudantes no Gemini TTS. Estudantes usam os mesmos planos gratuitos ou pagos exibidos para qualquer desenvolvedor.
Posso receber reembolso por cobranças da API Gemini TTS?
Segundo a Google, valores não utilizados em uma conta de pagamentos pós-paga vinculada podem se qualificar para reembolso. Créditos pré-pagos não utilizados da Gemini API expiram um ano após a compra e, em geral, não são reembolsáveis; créditos promocionais também são excluídos.
Os preços do Gemini 3.8 Flash TTS mudaram em 2026?
Os modelos foram lançados em 23 de setembro de 2026 com tarifas pagas introdutórias. Esses valores valem até 31 de dezembro e estão programados para dobrar em 1 de janeiro de 2027.
Use o AI Business Workflow Audit Checklist para decidir onde a voz gerada deve entrar antes de fechar o orçamento de produção. Receba com a newsletter.
- Última atualização
- 24 de set. de 2026
- Categoria
- Design
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Melhor programa para fazer gráficos de frivolité
Compare Inkscape, Amaziograph, Affinity e TattingCAD e escolha o melhor programa para criar gráficos de frivolité editáveis e prontos para imprimir.20 de set. de 2026Design
Tablet weaving patterns: 4 programas grátis para criar projetos
Compare 4 programas grátis para criar padrões de tecelagem com cartões, com enfiamento, giros, torção e exportação para trabalhar junto ao tear.20 de set. de 2026Design
Transformar foto em ponto cruz: PCStitch ou WinStitch?
Compare PCStitch e WinStitch para transformar foto em ponto cruz: redução de cores, limpeza, símbolos, PDF, preços e o melhor fluxo para cada projeto.20 de set. de 2026Design
Foundation paper piecing com QuiltAssistant: vale a pena?
Testamos o QuiltAssistant para foundation paper piecing: veja o que o software grátis faz, seus limites no Windows e quando ele ainda vale a pena.20 de set. de 2026Design
Programa de ponto cruz WinStitch: preços, licença e custos extras
Veja quanto custa o WinStitch, o que muda no checkout, quando o pacote com MacStitch compensa e se a licença vitalícia realmente vale o investimento.20 de set. de 2026Design
Vídeo de demonstração de produto: ngram ou Demosmith?
Compare ngram e Demosmith para vídeo de demonstração de produto, captura no navegador, revisões e exportações, com custos para o mesmo trabalho.19 de set. de 2026Design
Seamly2D: como dividir e imprimir moldes em A4
Aprenda a dividir um molde de costura em PDF no Seamly2D, imprimir em A4 ou Carta na escala de 100% e conferir o quadrado de teste antes do corte.19 de set. de 2026Design